

Machines that Think, глава 2: Теперь мы говорим
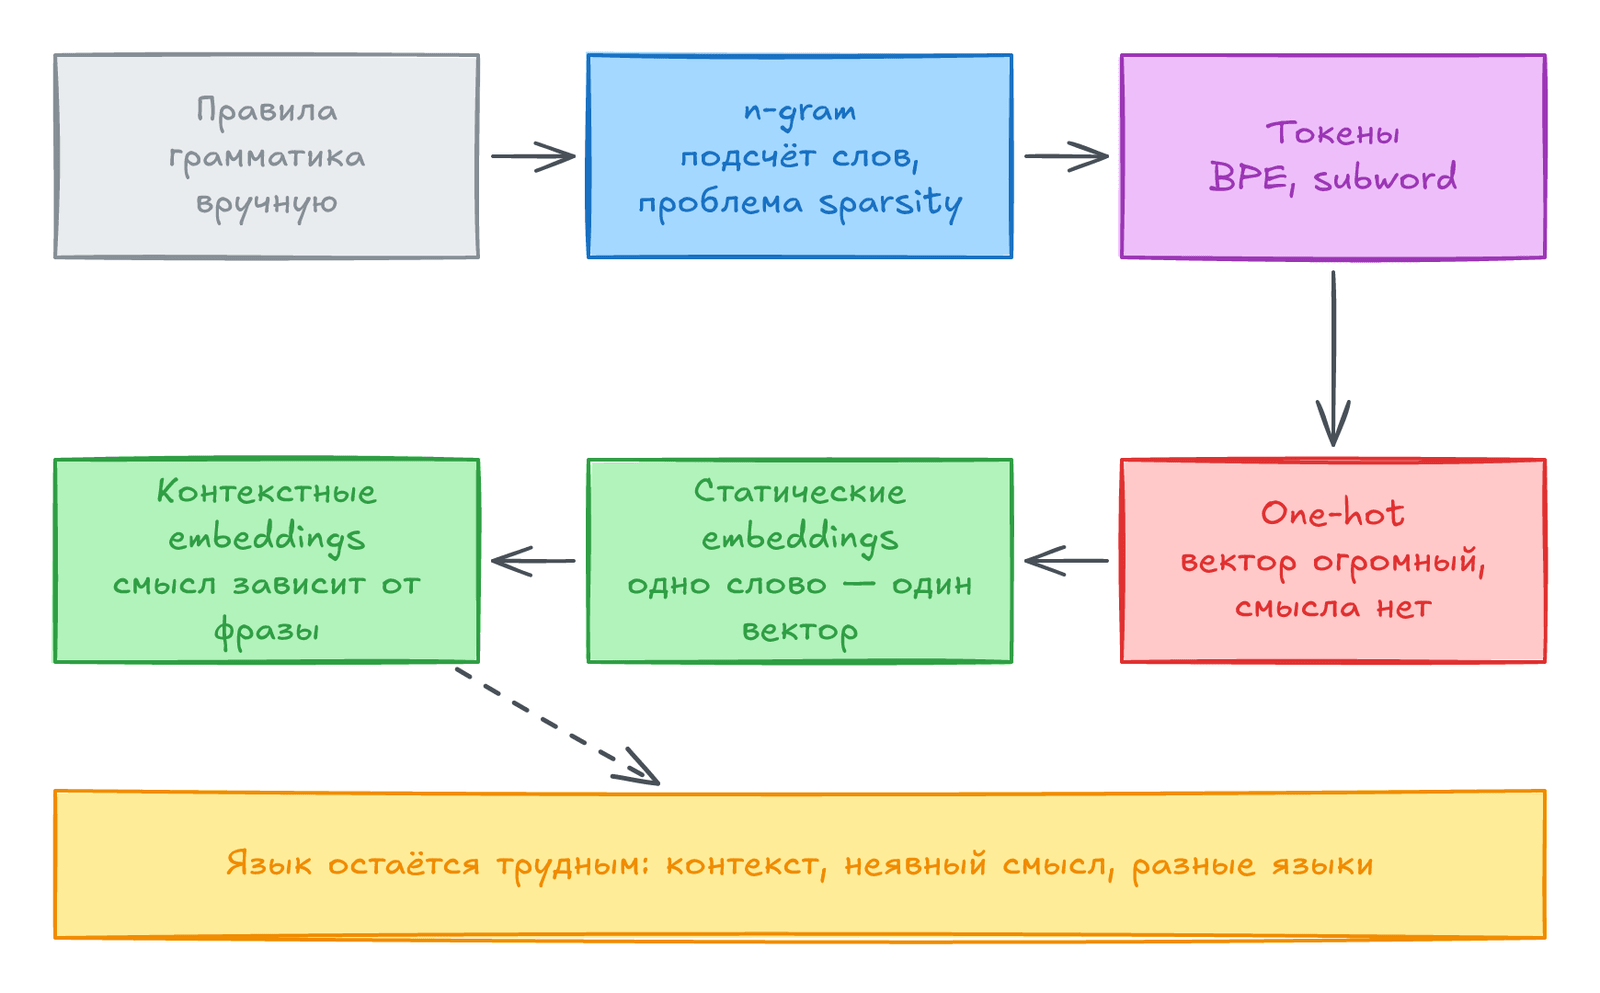
Главная мысль: Машина не понимает язык сразу. Она собирает его по частям: сначала считает слова, потом режет текст на токены, потом превращает токены в векторы. Так получается рабочая замена смысла. Но язык всё равно остаётся одной из самых трудных задач для ИИ.
Язык и интеллект
Заголовок раздела «Язык и интеллект»Люди давно считают речь признаком ума. Кто говорит ясно, того считают умным.
- Язык помогает думать: название выделяет вещь, грамматика связывает идеи.
- Язык влияет на восприятие. В русском есть «голубой» и «синий», и русские различают эти оттенки быстрее носителей английского.
Машины ломают эту связь
Заголовок раздела «Машины ломают эту связь»Когда машина пишет гладкий текст, мы включаем привычку: «говорит хорошо — значит, понимает». Это anthropomorphism.
Но текст модели не пустой. Модель отражает то, как миллионы людей писали и спорили. Автор называет LLM скорее зеркалом, чем мыслителем. Для многих задач этого хватает: резюме, черновик, объяснение.
Мышление шире языка
Заголовок раздела «Мышление шире языка»| Что есть у человека | Что есть у LLM |
|---|---|
| Пространственное мышление | Частично, через текст |
| Планирование на длинный срок | Слабо |
| Работа с физическим миром | Нет |
| Устойчивые причины и следствия | Частично |
| Язык | Очень сильно |
Язык делает мысль видимой, но не равен ей. Книга всё равно про языковые модели: через язык видно много умений сразу.
Первые слова машин
Заголовок раздела «Первые слова машин»Язык стал данными, когда его записали и оцифровали. Так появился NLP (natural language processing).
Правила
Заголовок раздела «Правила»Первая идея: лингвисты описали грамматику, значит, компьютер может её применять.
- Перевод: найти подлежащее и сказуемое, переставить по правилам другого языка. Идиома ломала всё.
- Правила не масштабируются. Новая область (право, медицина) = новые правила и исключения.
Шаблоны
Заголовок раздела «Шаблоны»ELIZA (1960-е) играла роль психотерапевта. Пользователь пишет «я устал от работы». ELIZA видит шаблон «я X» и отвечает «почему вы устали от работы?». Пару реплик это выглядит умно. Потом шаблоны кончаются.
Данные вместо правил
Заголовок раздела «Данные вместо правил»Когда собрали большие корпусы текста, подход сменился. Не «как должно быть», а «как люди реально пишут». Вероятностные модели лучше справлялись с шумом и улучшались с ростом данных.
Считаем слова: n-gram
Заголовок раздела «Считаем слова: n-gram»Человек читает «Солнце встаёт на» и ждёт «востоке». Это опыт. Компьютер получает то же через подсчёт.
Language model даёт вероятность последовательности слов. Посчитать все предложения нельзя: их слишком много. Поэтому используют Markov property: следующее слово зависит только от нескольких предыдущих.
n-gram — это n слов подряд.
| n | Название | Пример из «загрузи данные в хранилище» |
|---|---|---|
| 1 | unigram | «данные» |
| 2 | bigram | «загрузи данные» |
| 3 | trigram | «загрузи данные в» |
Вероятность считается делением: сколько раз встретилось «в хранилище», разделить на сколько раз встретилось «в».
Модель «говорит» так: берёт слово, выбирает самое вероятное следующее, повторяет. Грамматики внутри нет, только статистика. Но текст выглядит похоже на язык.
Мини-пример на Python
Заголовок раздела «Мини-пример на Python»Bigram-модель на четырёх фразах и сходство игрушечных векторов. Только стандартная библиотека.
from collections import Counterimport math
corpus = [    "загрузи данные в хранилище",    "загрузи данные в озеро",    "проверь данные в хранилище",    "загрузи логи в хранилище",]
pairs = Counter()starts = Counter()for line in corpus:    words = line.split()    for a, b in zip(words, words[1:]):        pairs[(a, b)] += 1        starts[a] += 1
def p(next_word, prev_word):    return pairs[(prev_word, next_word)] / starts[prev_word]
print("P(данные | загрузи) =", round(p("данные", "загрузи"), 2))print("P(хранилище | в) =", round(p("хранилище", "в"), 2))print("P(витрину | в) =", round(p("витрину", "в"), 2))
def cos(u, v):    dot = sum(a * b for a, b in zip(u, v))    return dot / (math.sqrt(sum(a * a for a in u)) * math.sqrt(sum(b * b for b in v)))
vec = {    "postgres":  [0.9, 0.8, 0.1],    "snowflake": [0.8, 0.9, 0.2],    "pizza":     [0.1, 0.0, 0.9],}print("postgres ~ snowflake:", round(cos(vec["postgres"], vec["snowflake"]), 2))print("postgres ~ pizza:", round(cos(vec["postgres"], vec["pizza"]), 2))
Результат:
P(данные | загрузи) = 0.67P(хранилище | в) = 0.75P(витрину | в) = 0.0postgres ~ snowflake: 0.99postgres ~ pizza: 0.16«в витрину» — нормальная фраза, но в корпусе её нет. Модель даёт 0. Это и есть проблема sparsity. Вторая часть примера относится к разделу про embeddings ниже.
Sparsity и smoothing
Заголовок раздела «Sparsity и smoothing»Язык огромный. Даже в миллиардах слов большинство сочетаний не встречается ни разу. Модель считает их невозможными.
Решение: smoothing. Не ставить ноль, а дать маленькую вероятность.
| Метод | Идея |
|---|---|
| Laplace | Добавить немного к каждому счётчику |
| Backoff | Нет trigram — взять bigram, нет bigram — взять слово |
| Interpolation | Смешать оценки разной длины |
Контекст против сложности
Заголовок раздела «Контекст против сложности»Чем больше n, тем больше контекста. Но число сочетаний растёт очень быстро, данных не хватает, sparsity сильнее. На практике компромиссом стал trigram.
Для компьютера текст — это байты. Сначала его надо разрезать на единицы. Это tokenization.
Резать по пробелам просто, но плохо. Есть падежи, сокращения, составные слова, языки без пробелов (китайский, японский).
| Уровень | Плюс | Минус |
|---|---|---|
| Слово | Просто | Словарь на миллионы форм. Новое слово неизвестно |
| Символ | Словарь из сотен символов | Последовательности очень длинные. Модель сама учит, что буквы складываются в слово |
| Subword | Компромисс. Новые слова собираются из частей | Нужен алгоритм |
Subword — стандарт сейчас. Слово «перезагрузка» можно разбить на «пере» + «загруз» + «ка», даже если целиком модель его не видела.
BPE и наследники
Заголовок раздела «BPE и наследники»BPE (Byte Pair Encoding) пришёл из сжатия данных.
- Начинаем с отдельных символов.
- Находим самую частую пару соседних символов.
- Склеиваем её в один токен.
- Повторяем, пока словарь не станет нужного размера.
Частые куски становятся одним токеном. Редкие слова остаются разбитыми на части.
| Токенайзер | Чем отличается |
|---|---|
BPE | Склеивает самую частую пару |
WordPiece | Склеивает пару, которая лучше описывает весь корпус, а не самую частую |
SentencePiece | Работает с сырым потоком текста. Пробел — обычный символ. Подходит для любого языка |
Раньше все незнакомые слова превращались в один токен «неизвестно». Subword-токенизация это убрала: новое слово разбивается на знакомые куски, и у модели есть хоть какая-то информация.
Токен задаёт границы
Заголовок раздела «Токен задаёт границы»- Каждый токен занимает место в context window. Мелкие токены дают детали, крупные экономят место.
- Сам по себе токен — изолированный символ. Модель не знает, что «кот» и «кошка» похожи.
Embeddings
Заголовок раздела «Embeddings»Токену дают номер: «кот» = 42, «ложка» = 173. Но номер ничего не значит. 42 не ближе к 43, чем к 173.
One-hot
Заголовок раздела «One-hot»Вектор длиной в словарь. Одна единица, остальные нули. Две проблемы:
- Нет сходства. «Кот» одинаково далёк и от «собаки», и от «ложки».
- Огромные векторы почти из одних нулей.
Плотные векторы
Заголовок раздела «Плотные векторы»Embedding — короткий вектор чисел, где каждое число что-то значит. Его учат так, чтобы слова из похожих контекстов получили похожие векторы.
Основа — distributional hypothesis (Фёрт): слово узнают по его соседям. «Кот» и «собака» стоят рядом с «спит» и «ест». «Ложка» — рядом с «тарелка» и «мешать».
| Метод | Год | Идея |
|---|---|---|
word2vec (CBOW, Skip-gram) | 2013, Google | Предсказать слово по соседям или соседей по слову. Модель очень простая |
GloVe | Stanford | Таблица: как часто каждое слово стоит рядом с каждым. Глобальная статистика по всему корпусу |
ELMo | Позже | Вектор зависит от контекста. Читает фразу в обе стороны |
Геометрия смысла
Заголовок раздела «Геометрия смысла»- Похожие слова лежат рядом: животные в одной области, инструменты в другой.
- Расстояние = мера сходства. В примере выше
postgresиsnowflakeдают 0.99, аpostgresиpizza— 0.16. - Направления тоже значат. «король − мужчина + женщина» ≈ «королева». Переход «идти → шёл» похож на «играть → играл».
- Реальные embeddings имеют сотни измерений. Отдельное измерение обычно ничего понятного не значит.
Контекст меняет вектор
Заголовок раздела «Контекст меняет вектор»У статического embedding слово «ключ» всегда в одной точке. Но «ключ от двери» и «горный ключ» — разные смыслы. Contextual embeddings считают новый вектор каждый раз по окружающим словам. Это убирает главную слабость статических векторов.
Что дали embeddings: язык стал геометрией, текст стал числами для ML (как картинки и звук), появился transfer learning. Минусы: дорого считать и трудно интерпретировать.
Почему язык — последний рубеж
Заголовок раздела «Почему язык — последний рубеж»| Трудность | Суть |
|---|---|
| Бесконечность форм | Почти все возможные фразы модель не видела. «Бесцветные зелёные идеи яростно спят» (Хомский): грамматика верна, смысла нет |
| Дальние связи | Местоимение ссылается на слово из прошлого абзаца. Короткое окно это теряет |
| Недосказанность | Большая часть смысла не сказана. Нужен контекст и знание мира |
| Long tail | Закон Ципфа: частота слова обратно пропорциональна его рангу. Редкие слова (термины, имена) важны, но данных о них мало |
| Разные языки | Порядок слов, морфология, тон, письменность. Решение для английского не подходит всем |
| Оценка | Нет одной метрики. Текст бывает гладким, но ложным. Перевод, резюме и диалог требуют разного качества |
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| NLP | Область ИИ про работу с человеческим языком |
| Language model | Модель, которая даёт вероятность следующего слова или фразы |
| Markov property | Допущение: будущее зависит только от короткого куска прошлого |
n-gram | Последовательность из n слов подряд |
| Sparsity | Большинство сочетаний не встречается в данных |
| Smoothing | Дать маленькую вероятность невиданным сочетаниям вместо нуля |
token | Единица текста, с которой работает модель |
BPE | Токенизация через склейку самых частых пар символов |
| One-hot encoding | Вектор длиной в словарь с одной единицей |
embedding | Плотный вектор, где похожие по употреблению слова лежат рядом |
| Contextual embedding | Вектор слова, который зависит от окружающих слов |
| Zipf’s law | Мало частых слов и очень много редких |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Платите за токены, а не за слова. Цена API и лимит context window считаются в токенах. Русский текст обычно даёт больше токенов, чем английский того же смысла. Замерьте токенайзером модели на своих данных.
- Названия таблиц и колонок тоже токены. Длинная DDL-схема в prompt съедает окно. Давайте модели только нужные таблицы.
- Редкие термины модель знает хуже. Внутренние сокращения компании, коды продуктов — это long tail. Объясните их в prompt или в документах для RAG.
- RAG стоит на embeddings. Поиск по близости векторов находит похожий текст, а не верный ответ. Проверяйте, что попало в контекст.
- Сходство не равно смыслу. У «рост выручки» и «падение выручки» могут быть близкие векторы. Для точных фильтров используйте SQL, а не vector search.
- Гладкий текст не значит правильный. Оценивайте выход модели по нескольким критериям: факты, формат, полнота. Одной метрики мало.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему n-gram модель даёт вероятность 0 нормальной фразе? Как это исправляет smoothing?
- Чем subword-токенизация лучше токенизации по словам и по символам?
- Почему номер токена и one-hot вектор не дают модели понятия сходства, а embedding даёт?
- Зачем нужны contextual embeddings, если уже есть word2vec?
Предыдущая: Старые вопросы, новые машины. Следующая: Как устроены нейросети.