

Data Pipelines with Apache Airflow, глава 13: Проект про транспорт Нью-Йорка
Главная мысль: в реальном проекте нет готового оператора на каждый случай. Вы пишете свою логику на hooks и connections, храните сырые данные и делаете каждый шаг идемпотентным. Тогда любой запуск можно безопасно повторить.
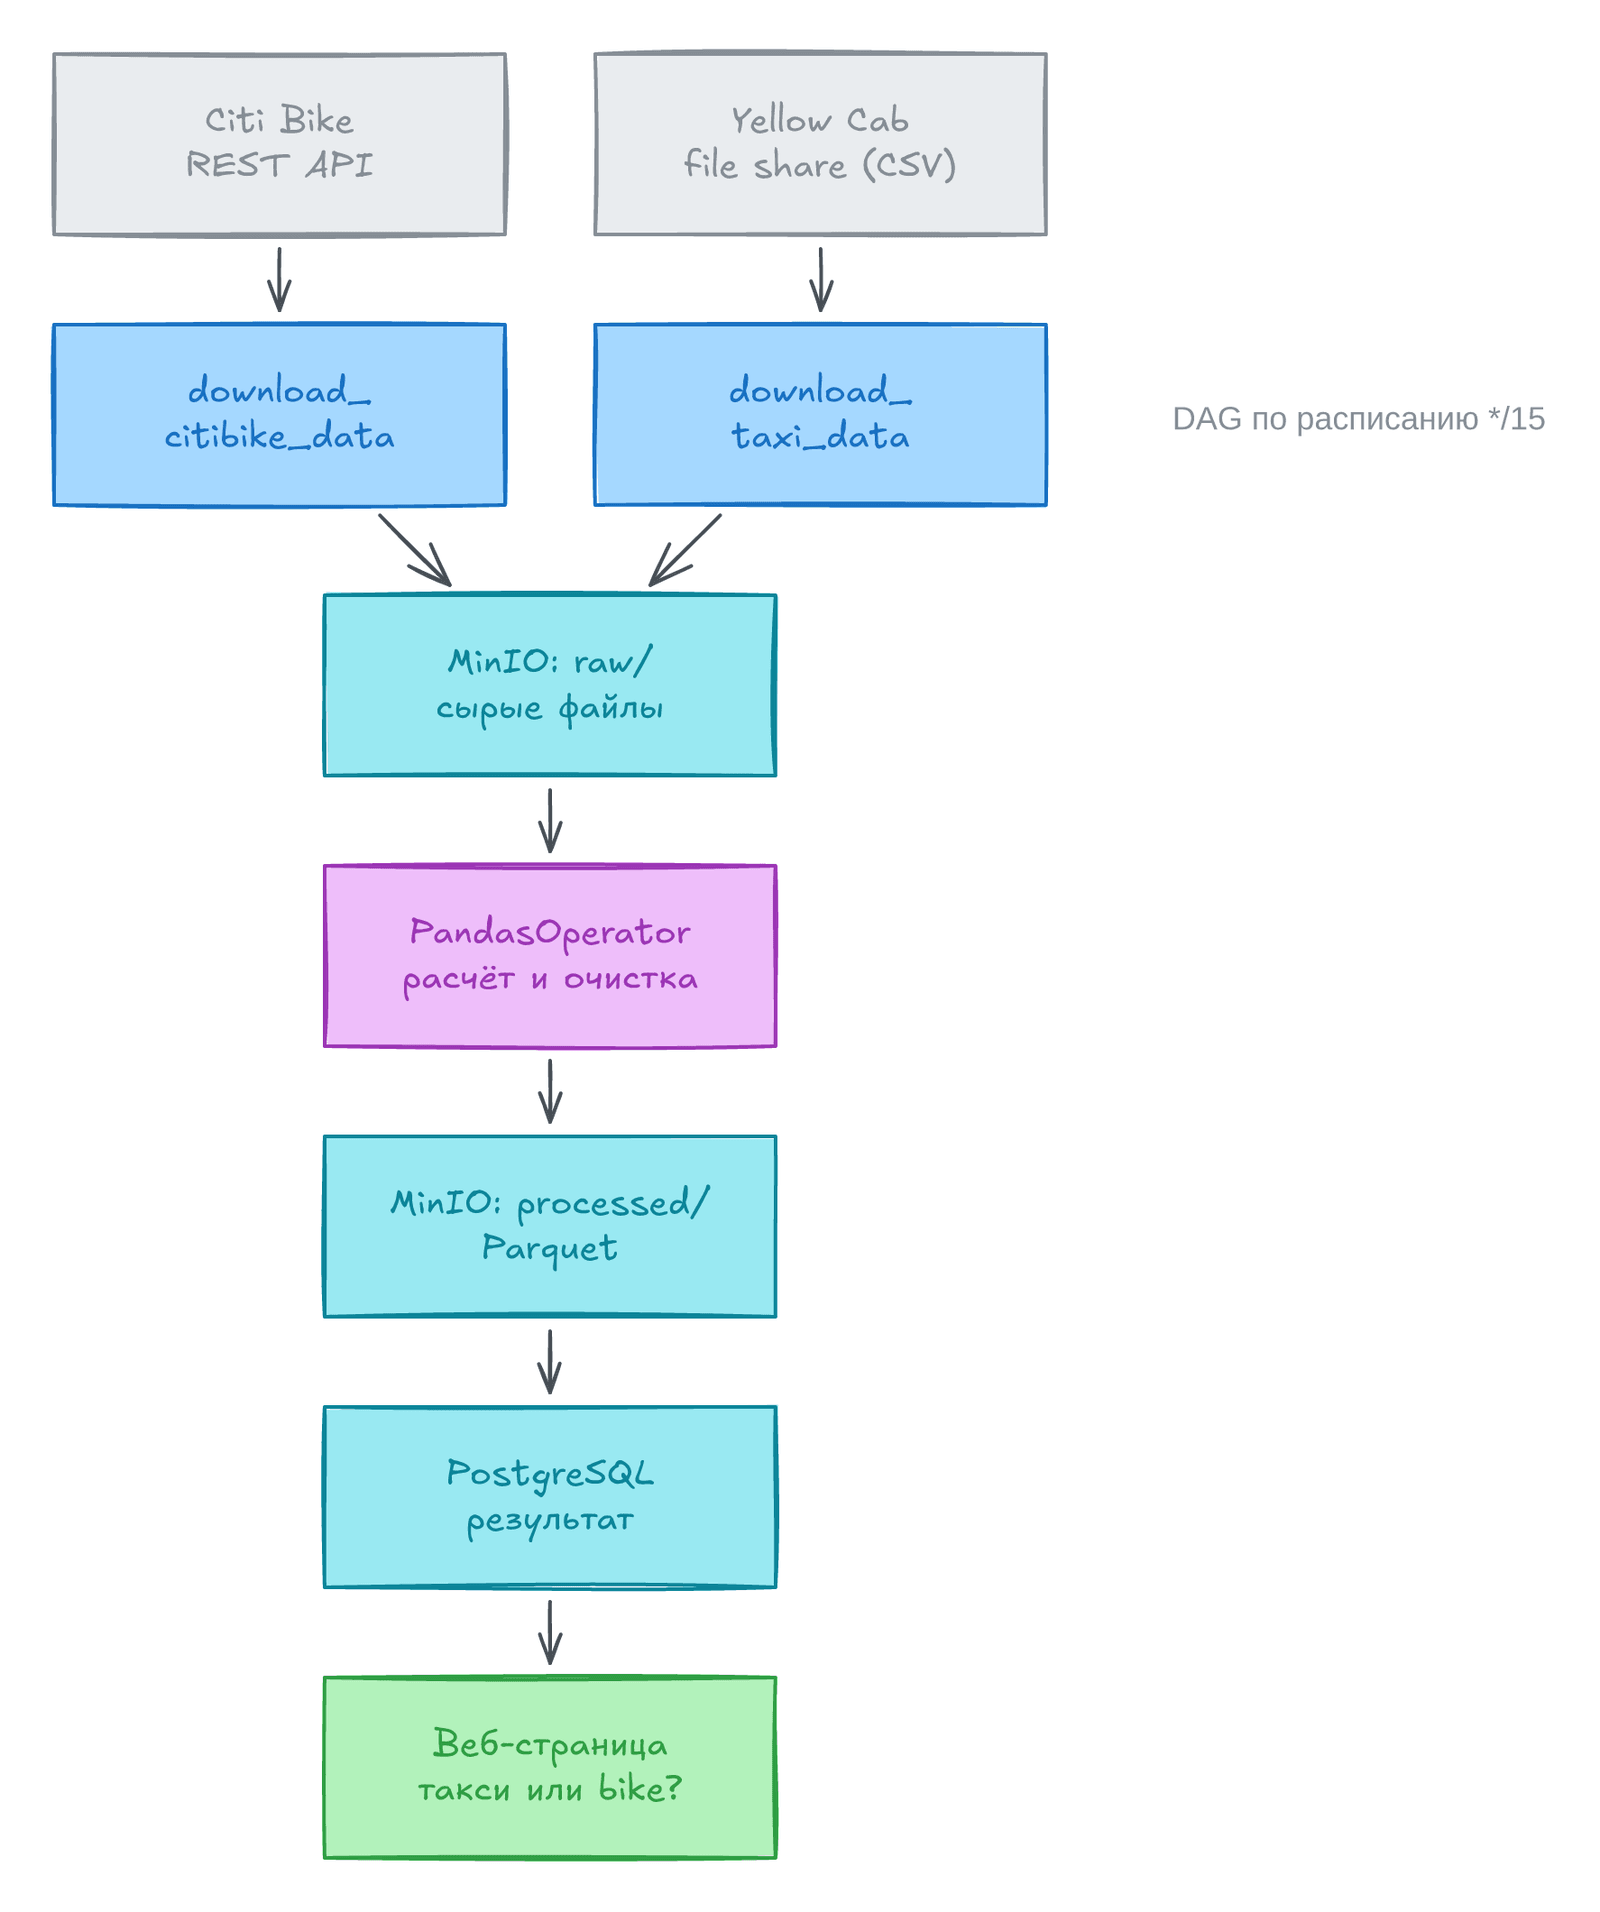
Задача проекта
Заголовок раздела «Задача проекта»Вопрос: что быстрее добраться из точки A в точку B по Нью-Йорку, такси или Citi Bike? Ответ зависит от района и времени суток.
Источники данных:
| Источник | Формат | Особенности |
|---|---|---|
| Citi Bike REST API | JSON | Нужна basic authentication. Период настраивается (минуты, часы, дни) |
| Yellow Cab file share | CSV | Файл на каждые 15 минут. Хранится только последний час |
Всё запускается в Docker Compose: оба API, MinIO (S3-совместимое хранилище), PostgreSQL и веб-страница с результатом.
План подхода
Заголовок раздела «План подхода»- У такси есть ID зон. У Citi Bike есть координаты станций. Чтобы сравнить, координаты станций привязывают к зонам такси.
- Такая привязка грубая. Поездки внутри зоны могут сильно отличаться по длине. Книга принимает эту потерю точности.
- Данные такси живут один час. Поэтому их надо сохранять у себя. Тогда накопится история.
- DAG запускается каждые 15 минут. Оба источника тоже режут данные по 15 минут. Так можно обработать их параллельно в одном DAG.
Извлечение данных
Заголовок раздела «Извлечение данных»Готовый HTTP-оператор не подходит: он делает запрос, но не умеет сохранить ответ. Нужна своя функция в PythonOperator.
- Citi Bike. Функция берёт логин и пароль из connection, делает запрос и пишет JSON в MinIO. Имя файла содержит
data_interval_start. - Yellow Cab. Сначала запрос списка файлов. Потом скачивание каждого CSV и загрузка в MinIO. Имена заранее неизвестны.
- Доступ к MinIO идёт через
S3Hook. Адрес MinIO задают в extras connection, ключendpoint_url. Не в поле host. Это неочевидно, иногда нужно читать код hook. - Connection можно задать переменной окружения
AIRFLOW_CONN_<ID>в формате URI.
Ловушка идемпотентности
Заголовок раздела «Ловушка идемпотентности»load_string в S3Hook не перезаписывает файл. Если ключ уже есть, он падает с ошибкой. Для такси это случается сразу: файлы за последний час повторяются при каждом запуске.
Решение в книге: ловить ValueError и писать в лог, что файл уже есть. Другой вариант: передать replace=True.
Один оператор для похожих преобразований
Заголовок раздела «Один оператор для похожих преобразований»Обработка Citi Bike и такси почти одинакова. Отличаются вход, выход и сами преобразования. Общее у них одно: pandas DataFrame.
Книга пишет свой PandasOperator из трёх функций:
| Функция | Что делает |
|---|---|
input_callable | Читает данные и возвращает DataFrame |
transform_callable | Необязательная. DataFrame на входе, DataFrame на выходе |
output_callable | Записывает DataFrame (например, в Parquet в MinIO) |
- Аргументы функций лежат в
template_fields. Поэтому в них работают шаблоны:{{ data_interval_start | ts_nodash }}в пути файла. - Чтобы сменить формат входа, меняют аргумент:
pd.read_csvнаpd.read_parquet. Код не дублируется. - Совет книги: если пишете одну логику для нескольких случаев, ищите то общее, что есть у всех. Здесь это
DataFrame. - Для больших данных pandas заменяют Spark (
SparkSubmitOperator). Pandas вPythonOperatorработает на машине Airflow. При нехватке памяти он может уронить и Airflow. Тяжёлое выносят в Kubernetes (KubernetesPodOperator) или ECS.
Структура данных: raw, processed, export
Заголовок раздела «Структура данных: raw, processed, export»Можно было написать одну функцию без файлов. Это быстрее. Но книга сохраняет промежуточные файлы по двум причинам:
- Данные нужны и другим людям и pipeline.
- Нужна воспроизводимость. REST API не вернёт состояние двухмесячной давности. Поэтому копию входа хранят почти без правок.
| Слой | Что хранит |
|---|---|
raw | Исходные данные без изменений |
processed | Очищенные и преобразованные данные. Не пересчитываются зря |
export | Наборы, готовые для передачи наружу |
Слоёв может быть больше (raw, preprocessed, enriched, processed, export). Единой схемы нет. Её задаёт проект.
Идемпотентная запись
Заголовок раздела «Идемпотентная запись»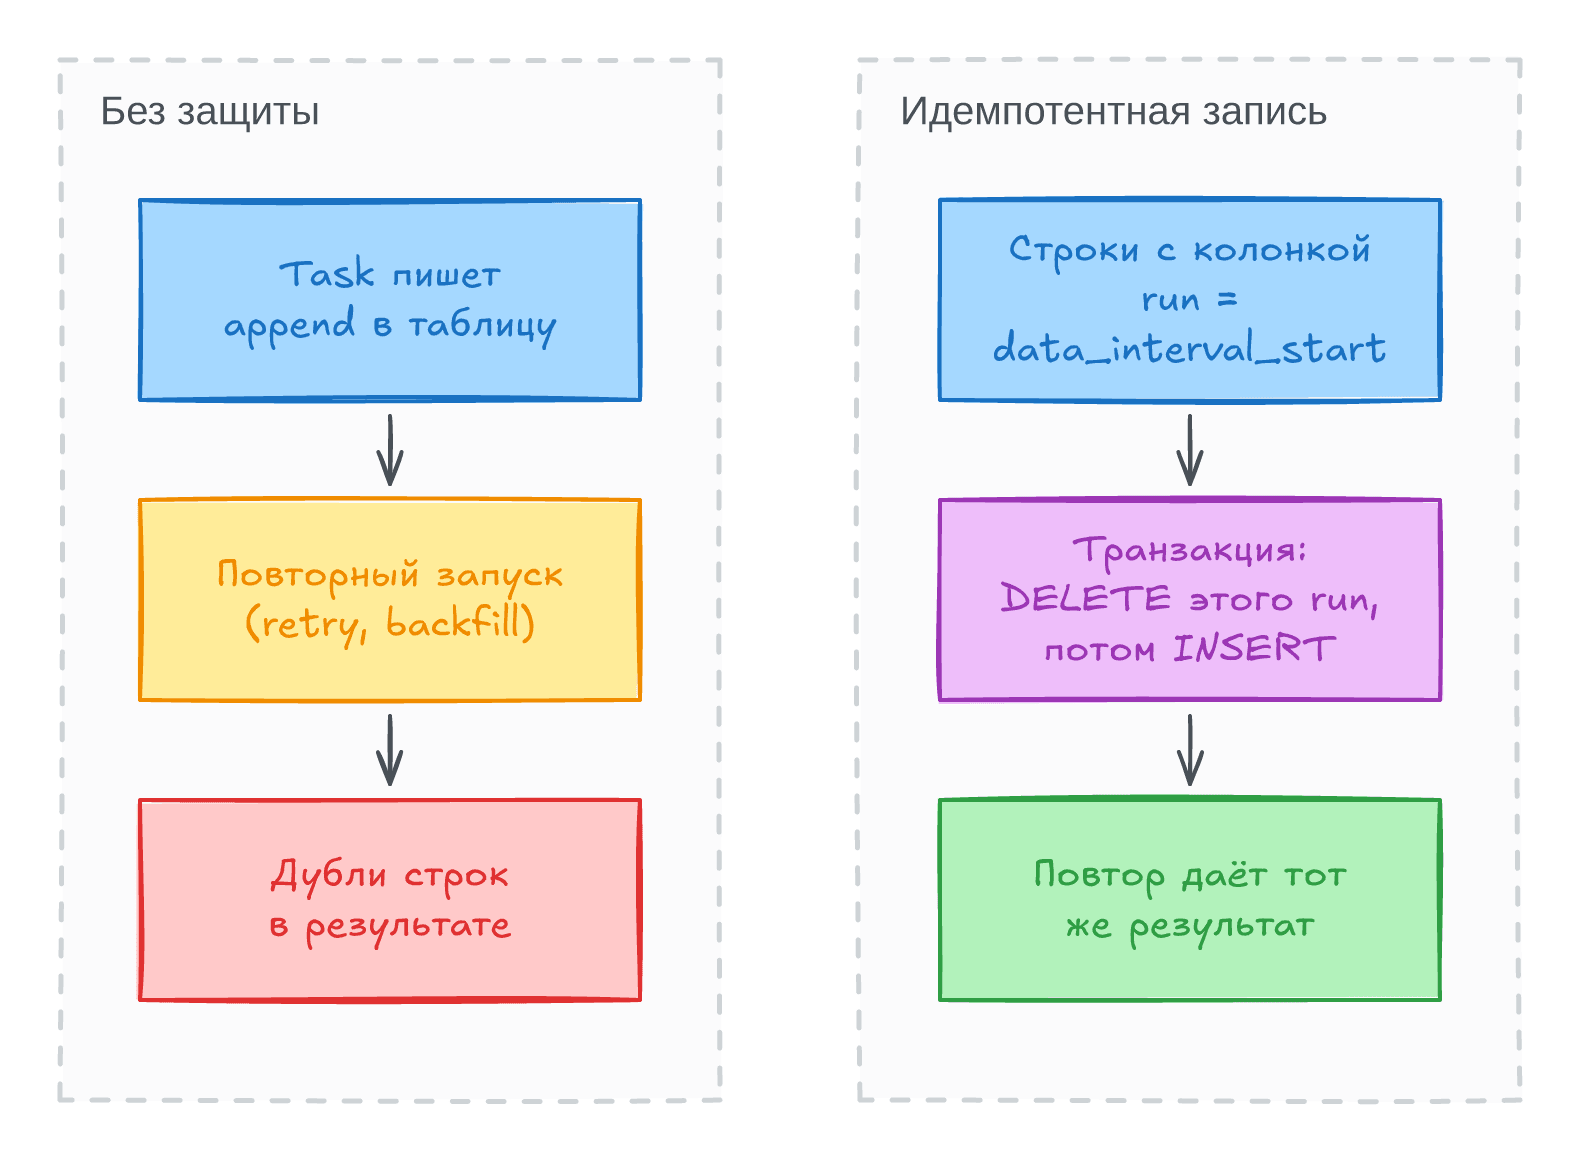
Идемпотентность нужна в двух местах:
- Запись файлов в
processed. Включите перезапись. Тогда повтор не падает. - Запись в базу. Повтор не падает, но даёт дубли строк. Это хуже.
Решение для базы:
- Добавьте в таблицу колонку с временем запуска, например
airflow_execution_date. Туда пишутdata_interval_start. - В одной транзакции сначала удалите строки этого запуска, потом вставьте новые.
- Транзакция атомарна. Либо выполнены оба шага, либо ни один. Остатков при сбое нет.
Пример кода
Заголовок раздела «Пример кода»Проверено на Airflow 3.4: функция проверена в pytest на SQLite (повторный запуск не даёт дублей), DAG проходит airflow dags test.
Идея транзакции в виде функции. Имена таблицы и колонки придуманы для примера. При первом запуске таблицы ещё нет, поэтому DELETE идёт только для существующей таблицы.
import pandas as pdimport sqlalchemy as sa

def save_rides(df: pd.DataFrame, engine: sa.Engine, run_ts: pd.Timestamp) -> None:    """Replace all rows of one run, then insert fresh rows."""    df = df.assign(run_ts=run_ts)    with engine.begin() as conn:  # one transaction        if sa.inspect(conn).has_table("rides"):            delete = sa.text("DELETE FROM rides WHERE run_ts = :ts").bindparams(                sa.bindparam("ts", type_=sa.DateTime)            )            conn.execute(delete, {"ts": run_ts.to_pydatetime()})        df.to_sql("rides", con=conn, index=False, if_exists="append")
А так выглядит DAG с расписанием раз в 15 минут (Airflow 3, SDK). Ключ запуска run_ts берём из logical_date:
import pendulumfrom airflow.sdk import DAG, task
with DAG(    dag_id="nyc_rides",    schedule="*/15 * * * *",    start_date=pendulum.datetime(2026, 1, 1, tz="UTC"),    catchup=False,):
    @task    def load_rides(logical_date=None):        print(f"Загружаем поездки для run_ts={logical_date}")
    load_rides()
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| MinIO | Хранилище с интерфейсом S3. Подходит для локальной работы |
S3Hook | Hook для работы с S3-совместимым хранилищем |
| Connection | Сохранённые параметры доступа. Можно задать через AIRFLOW_CONN_<ID> |
raw / processed / export | Слои данных по жизненному циклу |
PandasOperator | Свой оператор: input, transform, output вокруг DataFrame |
| Idempotency | Повторный запуск даёт тот же результат без ручного сброса |
data_interval_start | Начало интервала запуска. Годится как ключ запуска и часть имени файла |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Если готового оператора нет, пишите функцию на hook и connection. Если логика повторяется, делайте свой оператор.
- Храните сырые данные в
rawбез правок. Тогда можно пересчитать результат после исправления кода. - Ключ запуска (
data_interval_start) кладите в имя файла и в колонку таблицы. Он делает запись идемпотентной. - Для базы используйте
DELETE+INSERTв одной транзакции. В хранилище подойдётMERGEили перезапись партиции. Вспомнитеincrementalмодели вdbt. - Тяжёлую обработку не держите на машине Airflow. Выносите в Spark, Kubernetes или контейнер.
- Проверьте, как инструмент ведёт себя при повторе: падает, пропускает или дублирует.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему для скачивания данных в MinIO нельзя взять готовый HTTP-оператор?
- Зачем хранить
rawиprocessedотдельно, если можно всё сделать в памяти? - Как запись
df.to_sql(..., if_exists="append")ломает идемпотентность? Как это исправить? - Что общего у входов Citi Bike и такси позволило сделать один
PandasOperator?
Предыдущая: Best practices. Следующая: Проект: семейные традиции и GenAI.