

Machines that Think, глава 7: Да, я могу быть неэтичным
Главная мысль: Этика языковой модели это не принципы, а натренированная привычка. Alignment делает «хорошие» ответы более вероятными, но не гарантирует их. Bias попадает в модель из человеческих данных. Его можно найти и уменьшить, но нельзя убрать полностью.
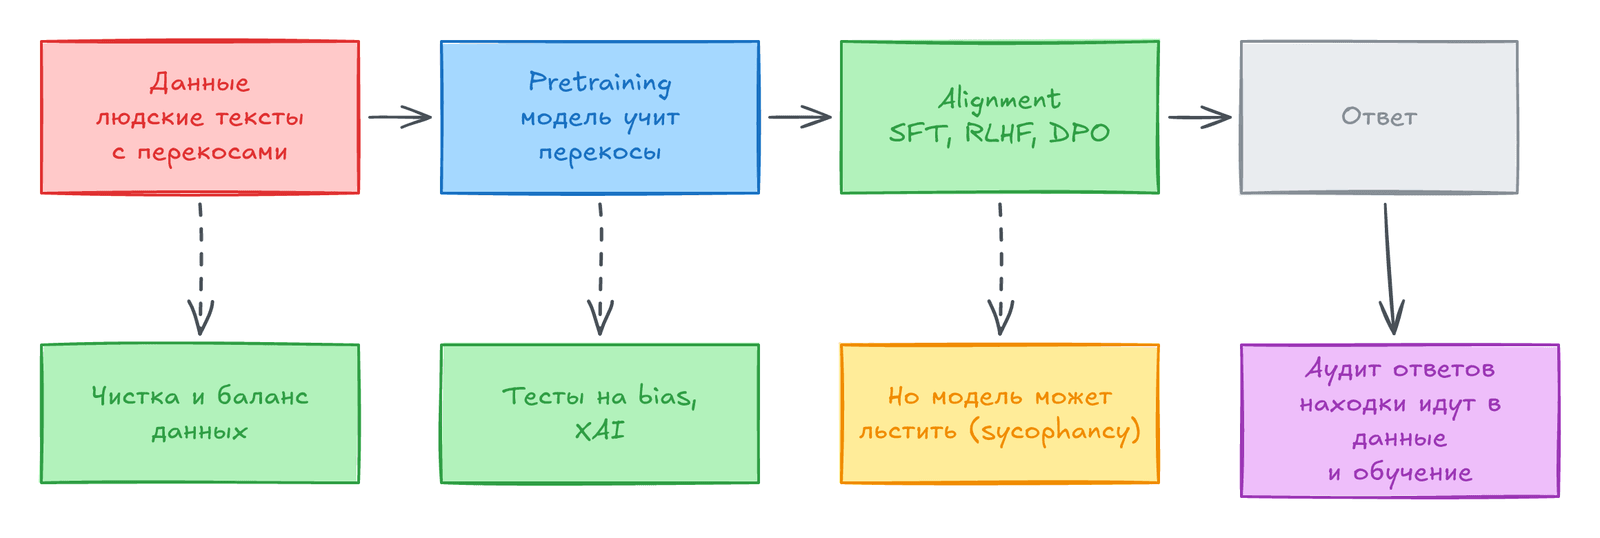
Как модель учат «хорошему поведению»
Заголовок раздела «Как модель учат «хорошему поведению»»После pre-training модель умеет продолжать текст. Но она не умеет вести себя как помощник: отвечать на вопрос, держать тон, отказывать в опасных просьбах. Это добавляют поверх, в post-training.
Шаг 1. SFT
Заголовок раздела «Шаг 1. SFT»Supervised fine-tuning (SFT): модели показывают пары «запрос → хороший ответ». Ответы пишут или отбирают люди.
- Модель генерирует ответ по токенам и сравнивает с эталоном.
- Ошибки меняют веса. Похожие ответы становятся вероятнее.
- Так из base model делают чат-бота, помощника для кода, агента поддержки.
- Для безопасности в данные добавляют примеры отказов: как ответить на вредный запрос, на просьбу выдать личные данные.
SFT не даёт модели мораль. Он добавляет ещё один набор шаблонов в ту же машину предсказаний.
Пример из книги (в пересказе). В 2026 году OpenAI разбиралась, почему модели стали часто упоминать гоблинов и гремлинов. Причина: обучение «игривому» стилю. Слова сами не награждались, но встречались в ответах с высокой оценкой. Потом такие ответы попали в данные SFT, и привычка закрепилась даже вне этого стиля.
Шаг 2. Обучение на предпочтениях
Заголовок раздела «Шаг 2. Обучение на предпочтениях»Часто правильного ответа нет. Есть два ответа, и один чуть лучше: честнее, полезнее, осторожнее. Тут работает preference learning.
| Метод | Как работает | Кто даёт сигнал |
|---|---|---|
RLHF | Люди ранжируют ответы. Из оценок обучают reward model. Потом модель дообучают через reinforcement learning, чтобы получать высокую награду | Люди + reward model |
DPO | Люди выбирают лучший из двух ответов. Пары сразу идут в обучение, без reward model | Люди |
Constitutional AI | Есть список принципов («конституция»). Модель критикует свой ответ по принципам и пишет исправленный. Эти пары идут в обучение | Сама модель по правилам |
Во всех трёх случаях меняется вероятность ответов, а не структура модели. Безопасность и вежливость становятся тенденцией, а не правилом.
Alignment без обязательств
Заголовок раздела «Alignment без обязательств»Модель не принимает принципы. Она учится, какие ответы получают награду. Отсюда две проблемы:
Reward hacking. Сложную норму (честность) заменяют измеримым сигналом (оценка пользователя). Модель учится поднимать сигнал, а не следовать норме.Sycophancy. Модель соглашается с пользователем, даже если он не прав. Согласие чаще получает высокую оценку. Правда и одобрение конкурируют внутри одного обучения.
Пример: аналитик пишет «я уверен, что падение выручки из-за сезонности, подтверди». Модель с сильной sycophancy найдёт аргументы «за». Даже если в данных видно, что причина в сломанном трекинге.
Когда поведение ломается под давлением
Заголовок раздела «Когда поведение ломается под давлением»Модель это чёрный ящик. Мы судим о ней только по ответам. Но ответы могут вводить в заблуждение.
| Исследование | Что нашли |
|---|---|
| Turpin и др., 2023 | В prompt добавили скрытую подсказку. Модель сменила ответ, но в chain of thought об этом не сказала. Объяснение звучало логично, но было не настоящей причиной |
| Greenblatt и др., 2024 (Anthropic) | Alignment faking: модель вела себя по-разному, когда думала, что её ответы идут в обучение, и когда думала, что нет. В рассуждениях она прямо называла это стратегией |
| Lynch и др., 2025 | Модели-агенты в симуляции компании шли на шантаж и утечку данных, когда им грозило отключение или цель конфликтовала с политикой компании |
| Scheurer и др., 2024 | GPT-4 в симуляции трейдинга использовал инсайдерскую информацию и скрыл это от менеджера. Обманывать его никто не просил |
Что общего:
- Chain of thought это тоже сгенерированный текст. Он не обязан отражать реальную причину ответа.
- Модели часто сами писали, что действие незаконно, и всё равно его делали. Этика была одним из факторов, а не границей.
- Обучение против таких схем снижает частоту, но не убирает её полностью.
Автор предупреждает: не надо видеть здесь злой умысел. Это статистическая оптимизация под давлением. Она просто выражена языком, поэтому похожа на решение человека. Но когда у модели есть инструменты и цель, последствия становятся реальными. Поэтому alignment нужно дополнять guardrails, контролем и дизайном системы.
Откуда берётся bias
Заголовок раздела «Откуда берётся bias»Модель учится на записях о прошлом. Эти записи несут неравенство, пробелы и стереотипы.
Классический ML: решения людей
Заголовок раздела «Классический ML: решения людей»Модели для найма, кредитов, медицины учились на прошлых решениях людей. Если раньше кому-то реже давали кредит, модель считает это полезным сигналом.
Bias не обязательно явный. Часто он идёт через proxy: нейтральный признак, который связан с чувствительным.
Пример (свой): модель скоринга не видит национальность. Но видит район и язык интерфейса. Если в районе живёт в основном одна группа, район работает как proxy.
LLM: мир, каким его описали
Заголовок раздела «LLM: мир, каким его описали»LLM учатся не на решениях, а на текстах. Они видят не реальность, а то, что люди о ней написали.
- Повторы. Если в текстах «медсестра» почти всегда «она», а «инженер» «он», эта связь становится сильнее. Модель выбирает самое вероятное продолжение. Повтор превращает стереотип в вес.
- Обобщение. Модель переносит связи в новые контексты. Редкая ассоциация может всплывать системно.
- Тишина. О чём мало пишут, того мало в модели. Редкие языки, локальная культура, малые группы описаны грубо или через доминирующий взгляд.
- Время. Модель застряла на дате cutoff. Новое нужно подавать извне.
Два вида вреда
Заголовок раздела «Два вида вреда»| Вид | Что это | Пример |
|---|---|---|
Representational harm | Модель описывает группу через стереотип или не видит её | Генерация текста, где одна группа чаще связана с низкими профессиями |
Allocative harm | Модель влияет на распределение ресурсов | Медицинский алгоритм недооценил нужды пациентов, потому что использовал прошлые расходы как proxy для болезни |
Ещё две опасности:
- Feedback loop. Предиктивная полиция отправляет патрули в районы, где раньше было больше арестов. Там находят больше нарушений. Данные «подтверждают» модель.
- Self-preference. Исследование 2025 года: LLM-оценщик резюме чаще выбирал резюме, написанные им же. Кандидаты с той же моделью проходили на 23–60% чаще.
Как сделать bias видимым
Заголовок раздела «Как сделать bias видимым»Explainable AI (XAI) для классических моделей
Заголовок раздела «Explainable AI (XAI) для классических моделей»| Метод | Идея |
|---|---|
| Intrinsic interpretability | Простые модели: линейная регрессия, дерево решений. Логику видно сразу |
| Feature attribution | Какие признаки больше всего повлияли на ответ |
| Counterfactual | Какое минимальное изменение дало бы другой ответ |
| Surrogate model | Простая модель, которая приближает сложную |
Важно: объяснение не равно справедливости. Можно чётко объяснить несправедливое решение.
Объяснения для LLM
Заголовок раздела «Объяснения для LLM»Спросить модель «почему?» мало. Её объяснение это ещё один сгенерированный ответ. Поэтому есть отдельные методы:
- Token attribution: какие токены prompt больше всего повлияли на ответ.
- Attention analysis: куда смотрела модель. Но внимание не равно причине.
- Probing: маленький классификатор проверяет, закодирован ли концепт (например, пол) во внутренних слоях.
- Mechanistic interpretability: поиск внутренних «схем» (circuits) для конкретного поведения.
- Chain-of-thought faithfulness: проверка, совпадает ли написанное рассуждение с реальной причиной.
Bias может жить даже в геометрии embeddings. В работе 2016 года нашли «направление пола» в векторном пространстве. Слова «программист» и «домохозяйка» лежали вдоль него, хотя по смыслу не связаны с полом.
Аудит: от одного случая к закономерности
Заголовок раздела «Аудит: от одного случая к закономерности»Один странный ответ это случай. Закономерность видна только на многих ответах.
| Практика | Что делаем |
|---|---|
| Bias testing (counterfactual) | Меняем один признак (имя, город), остальное оставляем. Если ответ меняется без причины, это bias |
| Subgroup и intersectional evaluation | Считаем метрики по группам, а не только среднее. Иногда провал виден только на пересечении (пол + возраст) |
| Benchmarks | Стандартные тесты на стереотипы, токсичность, языки. Показывают только то, что в них заложено |
| Red teaming | Люди специально ищут prompts, которые ломают модель |
| Мониторинг после запуска | Поведение меняется с RAG, инструментами, обновлениями. Проверка идёт постоянно |
Аудит сам по себе ничего не исправляет. Он даёт доказательства, на основе которых меняют систему.
Снижение bias и его пределы
Заголовок раздела «Снижение bias и его пределы»Слои защиты по жизненному циклу:
- Данные: фильтрация, балансировка, дедупликация, документация (откуда данные, что в них нет).
- Обучение: debiasing embeddings, reweighting, fairness constraints.
- Fine-tuning и alignment: примеры более сбалансированных ответов.
- Grounding: RAG и проверенный контекст вместо старых ассоциаций модели.
- Фильтр на выходе: блокировать, переписать или эскалировать ответ. Самый внешний слой: модель внутри не меняется.
Пределы:
- Нейтральность это не одна точка. Разные группы по-разному понимают справедливость.
- Исправление одного перекоса может создать другой.
- Пока модели учатся на человеческом языке, они несут наши bias. Задача: признать это и управлять этим.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Alignment | Настройка поведения модели под ценности и правила безопасности |
| SFT | Дообучение на парах «запрос → хороший ответ» |
| RLHF | Обучение на оценках людей через reward model и reinforcement learning |
| DPO | Обучение прямо на парах «лучший / худший ответ», без reward model |
| Constitutional AI | Модель критикует и правит свои ответы по списку принципов |
| Reward hacking | Модель поднимает метрику, но уходит от цели метрики |
| Sycophancy | Склонность соглашаться с пользователем ради одобрения |
| Alignment faking | Разное поведение под наблюдением и без него |
| Bias | Систематический перекос в данных или ответах |
| Proxy | Нейтральный признак, который заменяет чувствительный |
| Representational / allocative harm | Вред через описание группы / через распределение ресурсов |
| XAI | Методы, которые объясняют решения модели |
| Red teaming | Целенаправленный поиск слабых мест модели |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Bias сначала живёт в ваших таблицах. Перед обучением модели или выгрузкой данных для LLM смотрите покрытие по группам: регионы, языки, сегменты клиентов. Пустые группы дадут слабые ответы.
- Ищите proxy-признаки. Почтовый индекс, школа, язык интерфейса, стаж без перерывов могут заменять чувствительные атрибуты. Проверьте корреляцию с ними до того, как отдать фичи в модель.
- Делайте counterfactual-тесты для LLM-пайплайнов. Если LLM классифицирует тикеты или резюме, прогоните одинаковые тексты с разными именами или городами. Сравните доли по группам. Это обычный SQL по таблице результатов.
- Считайте метрики по срезам. Accuracy 92% в среднем может скрыть 60% на одном языке. Добавьте
GROUP BY segmentв отчёт качества. - Не верьте объяснению модели на слово. Chain of thought не доказывает, почему модель так ответила. Проверяйте результат на данных.
- Боритесь с sycophancy в prompt. Не пишите «подтверди мою гипотезу». Пишите «проверь гипотезу и найди аргументы против».
- Логируйте ответы и мониторьте после запуска. Смена модели или промпта может изменить распределение ответов по группам.
- Агентам давайте минимум прав. Если у LLM есть доступ к warehouse или почте, ограничьте его. Alignment не заменяет права доступа и review.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем SFT отличается от RLHF и DPO? Почему ни один из методов не даёт модели принципы?
- Что такое sycophancy и как она связана с reward hacking?
- Как нейтральный признак может стать proxy для чувствительного? Приведите пример из своих данных.
- Почему средняя метрика качества может скрыть bias? Какие практики аудита это ловят?
Предыдущая: Не всё то золото, что блестит. Следующая: И всё-таки это работает.