

Data Pipelines with Apache Airflow, глава 6: Зависимости между задачами
Главная мысль: порядок задач задают зависимости, а решение “запускать или нет” принимают trigger rules. Ветки и условия лучше показывать в структуре DAG. Тогда по UI видно, что произошло.
Базовые зависимости
Заголовок раздела «Базовые зависимости»- Оператор
>>задаёт порядок:a >> b >> c. - Задача стартует, когда upstream успешно закончился. Это надёжнее, чем cron “на час позже”.
- Сбой upstream не даёт запуститься downstream. Для временных сбоев есть retry.
- Fan-out: одна задача запускает несколько:
start >> [fetch_a, fetch_b]. - Fan-in: несколько задач ведут в одну:
[clean_a, clean_b] >> join. - Независимые ветки идут параллельно, если есть свободные workers.
EmptyOperatorнужен как пустая точка старта или объединения.
Branching
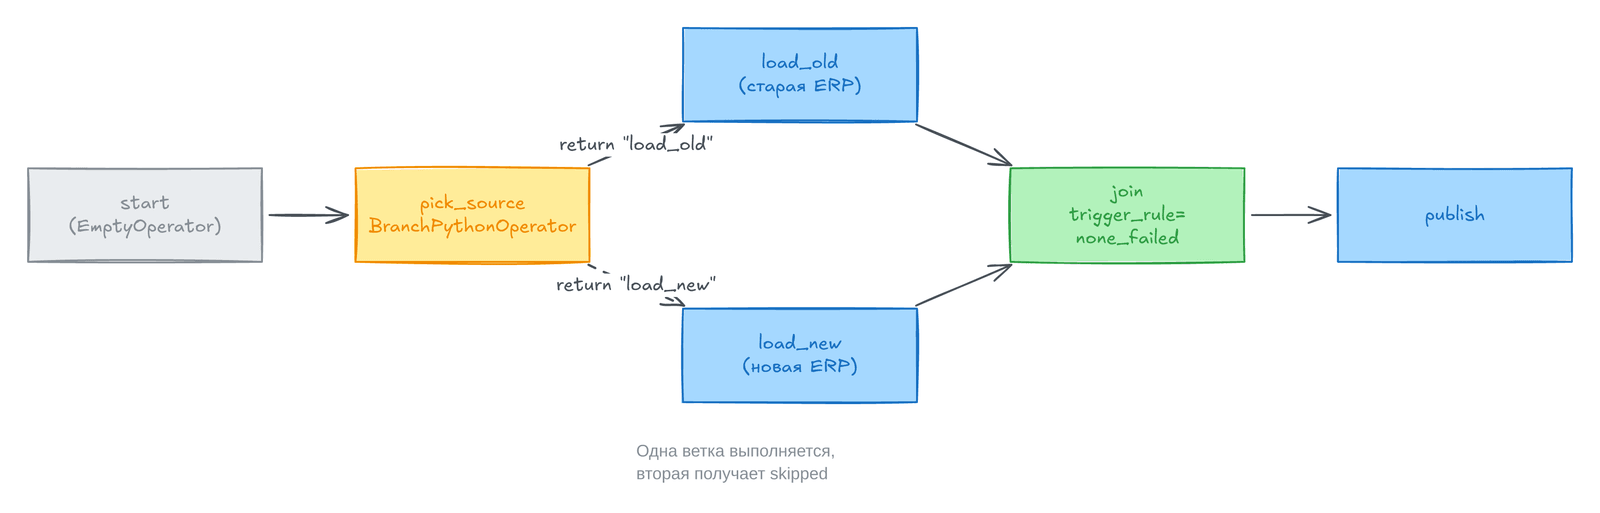
Заголовок раздела «Branching»Пример книги: компания меняет ERP-систему. Старые даты берём из старой системы, новые из новой.
| Подход | Плюс | Минус |
|---|---|---|
if внутри задачи | Структура DAG не меняется | Не видно в UI, какая ветка сработала. Только PythonOperator, нет специальных операторов |
Ветка в DAG через BranchPythonOperator | Видно в графе. Можно брать готовые операторы | Нужно правильно объединять ветки |
BranchPythonOperatorвызывает функцию. Функция возвращаетtask_id(или список) для запуска.- Остальные downstream-задачи получают статус
skipped. - Ловушка:
joinс правилом по умолчаниюall_successтоже будет пропущен. Одна из веток не запускалась, и условие никогда не выполнится. - Решение:
trigger_rule="none_failed"на задаче после ветки. - Чище добавить отдельный пустой join-task после веток. Правило ставят только на нём. Остальные задачи не трогают.
Условные задачи
Заголовок раздела «Условные задачи»Проблема: backfill прогоняет сотни запусков. Деплой модели на каждом из них не нужен.
- Условие внутри задачи работает, но снова скрыто от UI.
- Лучше отдельная задача-условие. Если условие ложно, она бросает
AirflowSkipException. Задачи ниже пропускаются, потому что их правилоall_success. - Для частых случаев есть готовые операторы:
LatestOnlyOperatorпропускает всё, кроме самого свежего запуска.ShortCircuitOperatorпродолжает или пропускает по булеву результату функции.
Trigger rules
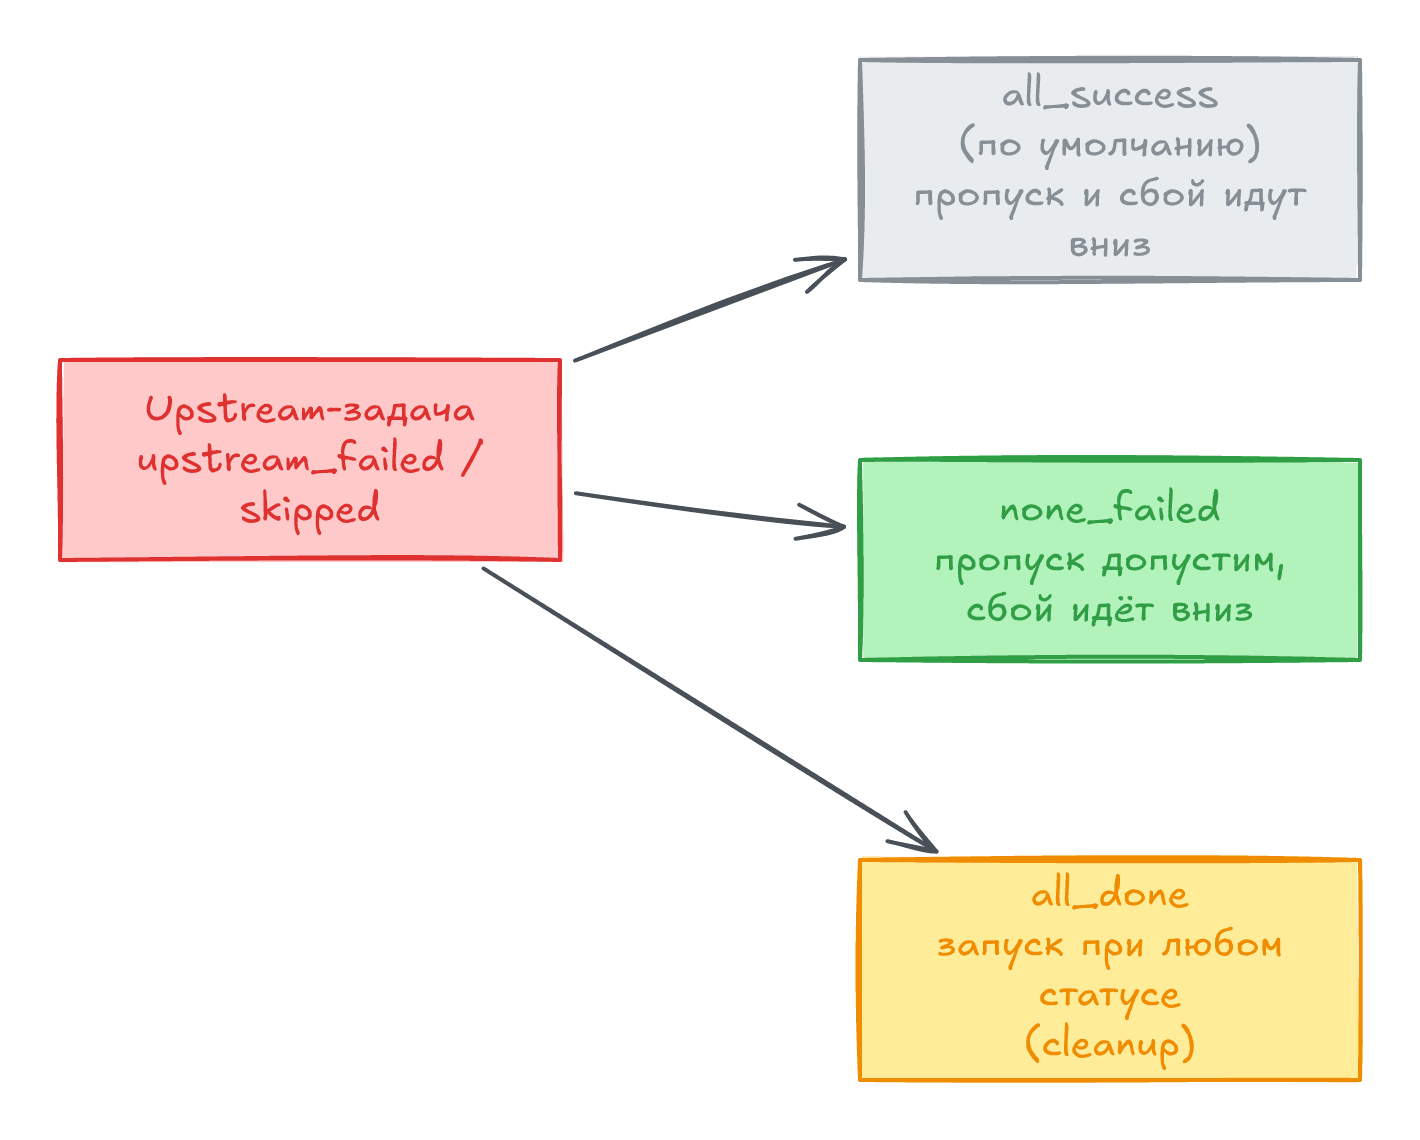
Заголовок раздела «Trigger rules»Scheduler постоянно проверяет задачи. Задача готова, когда выполнено её правило по статусам upstream.
| Правило | Когда запускается |
|---|---|
all_success (по умолчанию) | Все upstream успешны |
all_failed | Все upstream упали. Обработка ошибок |
all_done | Все upstream закончились с любым статусом. Cleanup |
one_failed | Упал хотя бы один. Быстрый алерт, не ждёт остальных |
one_success | Успешен хотя бы один. Не ждёт остальных |
none_failed | Нет упавших. Skipped допустим. Join веток |
none_failed_min_one_success | Нет упавших и хотя бы один успешен |
none_skipped | Нет пропущенных |
always | Всегда. Для тестов |
Как работает propagation:
- Упала
fetch_sales. Её downstream получаетupstream_failed. - Задачи без связи с упавшей продолжают работу.
all_successпередаёт вниз и сбой, и пропуск.none_failedпропуск не передаёт, но сбой передаёт.
XCom: данные между задачами
Заголовок раздела «XCom: данные между задачами»XCom(cross-communication) это маленькое сообщение, которое одна задача кладёт в metastore, а другая читает.xcom_push(key, value)кладёт значение.xcom_pull(task_ids, key)читает его.PythonOperatorсам кладёт возвращённое значение под ключомreturn_value.BashOperatorкладёт последнюю строку stdout.- Значения можно читать в шаблонах:
task_instance.xcom_pull(...). - Список всех значений: Browse, XComs в UI.
Минусы:
- Скрытая зависимость. В графе её не видно. Порядок должны обеспечить вы.
- Нарушает атомарность. Пример: токен API в XCom истёк, перезапуск второй задачи падает. Лучше получить токен и использовать его в одной задаче.
- Значение должно сериализоваться (lambda не подойдёт).
- Лимит размера зависит от БД metastore: MySQL 64 KB, PostgreSQL 1 GB, SQLite 2 GB. Это не значит, что надо хранить большое.
Что делать:
- Передавайте имена файлов, пути, идентификаторы. Большие данные кладите во внешнее хранилище.
- Для масштаба есть custom XCom backend (класс от
BaseXComсserialize_valueиdeserialize_value) и backend на object storage. - Старые значения чистит
airflow db clean. Для custom backend чистку делаете сами.
Taskflow API
Заголовок раздела «Taskflow API»Декораторы делают задачи из функций и скрывают XCom.
| Декоратор | Что создаёт |
|---|---|
@dag | DAG |
@task | PythonOperator |
@task.branch | BranchPythonOperator |
@task.short_circuit | ShortCircuitOperator |
@task.bash | BashOperator |
@task_group | TaskGroup |
@task.docker, @task.kubernetes, @task.virtualenv | Запуск в контейнере или окружении |
- Функция возвращает значение. Другая функция принимает его как аргумент. Airflow сам строит зависимость и XCom.
- Функцию с
@dagнужно вызвать в конце файла. Еслиdag_idне задан, им станет имя функции. - Минус: покрыта только часть операторов. Для остальных нужен обычный API.
- Смешивать стили можно, но будьте внимательны:
join_datasets >> model_id. - Значения между задачами всё равно идут через XCom, и лимиты те же.
Пример кода
Заголовок раздела «Пример кода»Проверено на Airflow 3.4: DAG проходит airflow dags test.
Ветка, join и Taskflow в одном DAG. Имена придуманы для примера.
import pendulumfrom airflow.sdk import dag, taskfrom airflow.providers.standard.operators.empty import EmptyOperator

@dag(schedule="@daily", start_date=pendulum.datetime(2025, 1, 1, tz="UTC"))def sales_branching():    @task.branch    def pick_source(data_interval_start=None):        switch_date = pendulum.datetime(2025, 6, 1, tz="UTC")        if data_interval_start < switch_date:            return "load_old"        return "load_new"
    @task    def load_old():        return "/data/old/part.csv"
    @task    def load_new():        return "/data/new/part.csv"
    join = EmptyOperator(task_id="join", trigger_rule="none_failed")
    @task    def publish(path: str = ""):        print("publish", path)
    pick = pick_source()    old, new = load_old(), load_new()    pick >> [old, new] >> join >> publish()

sales_branching()
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Fan-out / fan-in | Одна задача ведёт к нескольким / несколько к одной |
trigger_rule | Условие запуска задачи по статусам upstream |
skipped | Задача пропущена |
upstream_failed | Задача не запущена, потому что upstream упал |
| Propagation | Передача сбоя или пропуска вниз по графу |
BranchPythonOperator | Выбирает, какие задачи запускать |
LatestOnlyOperator | Пропускает всё, кроме последнего запуска |
XCom | Маленькое сообщение между задачами в metastore |
| Custom XCom backend | Свой класс хранения XCom, например в S3 |
| Taskflow API | Декораторы @dag, @task |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- После ветки ставьте отдельный join-task с
none_failed. Не меняйте правила у остальных задач. - Для cleanup и алертов используйте
all_doneиone_failed. - Деплой и дорогие шаги защитите
LatestOnlyOperator, если запускаете backfill. - Не гоняйте таблицы и DataFrame через XCom. Передавайте путь в хранилище.
- Следите за размером metastore. Запланируйте
airflow db clean. - Для простых Python-цепочек берите Taskflow. Меньше кода и явные зависимости.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему после
BranchPythonOperatorзадачаjoinсall_successпропускается? - Чем
none_failedотличается отall_done? - Какие минусы у XCom и что передавать вместо больших данных?
- Что делает Taskflow API с XCom и зависимостями?
Предыдущая: Templating и контекст. Следующая: Запуск по внешним событиям.