

Machines that Think, глава 4: Большие языковые модели
Главная мысль: LLM стали возможны благодаря трём вещам: архитектуре transformer, огромному числу параметров и огромным данным. Масштаб даёт силу, но делает модели дорогими. Поэтому их сжимают, дообучают по частям и делят на экспертов. А цена создания LLM решает, кто вообще может их строить.
Transformer: attention в центре
Заголовок раздела «Transformer: attention в центре»Transformer появился в 2017 году (статья «Attention Is All You Need»). Attention был и раньше, но как помощник для RNN. Transformer сделал его главным механизмом.
- Токены общаются напрямую, на любом расстоянии.
- Весь вход обрабатывается параллельно, а не по одному слову.
- Архитектура собрана из нескольких повторяющихся блоков.
Позиция токена
Заголовок раздела «Позиция токена»Attention сам по себе не видит порядок. Перемешайте слова — для него ничего не изменится. Поэтому к embedding каждого токена добавляют positional encoding.
- В оригинале использовали синусы и косинусы. Близкие позиции похожи, далёкие отличаются.
- Сейчас часто используют
RoPE: позиция встроена прямо в расчёт attention. - Пример: в «отчёт за май и отчёт за июнь» два слова «отчёт» начинают с одного embedding, но после позиции становятся разными.
Self-attention
Заголовок раздела «Self-attention»Каждый токен превращается в три вектора:
| Вектор | Роль |
|---|---|
query | Что токен ищет в контексте |
key | Что токен может предложить другим |
value | Какую информацию он передаст |
Шаги:
- Сравниваем
queryодного токена сkeyвсех токенов (dot product). Получаем оценки. softmaxпревращает оценки в веса. Сумма весов = 1.- Складываем
valueвсех токенов с этими весами. - Получаем новое представление токена —
hidden state. Оно уже учитывает контекст.
Мини-пример: веса внимания
Заголовок раздела «Мини-пример: веса внимания»Предложение «отчёт по продажам упал». Смотрим глазами слова «упал». Оценки придуманы.
import math
tokens = ["отчёт", "по", "продажам", "упал"]# Сырые оценки query("упал") · key(каждого токена). Числа придуманы.scores = [2.0, 0.1, 1.5, 1.0]
def softmax(xs):    exps = [math.exp(v) for v in xs]    total = sum(exps)    return [e / total for e in exps]
weights = softmax(scores)for t, w in zip(tokens, weights):    print(f"{t:10s} {w:.2f}")print("сумма:", round(sum(weights), 2))
# Causal mask: токен "по" (позиция 1) не видит будущие токеныmasked = [scores[0], scores[1], float("-inf"), float("-inf")]print("с маской:", [round(v, 2) for v in softmax(masked)])
Результат:
отчёт 0.47по 0.07продажам 0.29упал 0.17сумма: 1.0с маской: [0.87, 0.13, 0.0, 0.0]«Упал» берёт больше всего от «отчёт» (кто упал) и почти ничего от «по». С маской токен видит только себя и прошлые токены.
Multi-head attention
Заголовок раздела «Multi-head attention»Одна «голова» видит один тип связей. В языке их много: кто делает действие, где, к чему относится местоимение.
- Несколько голов работают параллельно, у каждой свои веса для
query,key,value. - Каждая голова сама учится смотреть на своё. Никто не задаёт это вручную.
- Выходы голов склеивают и смешивают одним линейным слоем.
Глубина без потерь
Заголовок раздела «Глубина без потерь»Attention работает в паре с feedforward слоем (обычный dense слой из главы 3). Чтобы глубокий стек учился стабильно, нужны две детали:
| Деталь | Что делает |
|---|---|
residual connection | Добавляет вход слоя к его выходу. Слой дополняет, а не заменяет. Ранние связи не теряются |
layer normalization | Возвращает значения в нормальный диапазон. Один сигнал не забивает остальные |
Без них большие модели просто не обучаются.
Encoder, decoder и маска
Заголовок раздела «Encoder, decoder и маска»- Encoder видит весь вход сразу. Каждый токен смотрит на все.
- Decoder генерирует по одному токену.
Causal maskзакрывает будущие токены. Иначе модель подсмотрит ответ, как на экзамене со шпаргалкой. - Cross-attention связывает их: query идёт от decoder, key и value от encoder.
- В конце линейный слой и
softmaxдают вероятность каждого токена из словаря.
| Семейство | Пример | Для чего |
|---|---|---|
| Encoder-only | BERT | Понимание: классификация, извлечение |
| Encoder–decoder | Оригинальный transformer | Перевод: вход в выход |
| Decoder-only | GPT | Генерация. Стал стандартом для LLM |
Сейчас почти все задачи сводят к предсказанию следующего токена. Одна модель делает и перевод, и суммаризацию. Связный текст рождается из выбора вероятного продолжения шаг за шагом. Для одних это значит «модель не думает». Для других — это путь к новому виду интеллекта.
Что делает модель «большой»
Заголовок раздела «Что делает модель «большой»»Три составляющие работают вместе:
| Составляющая | Что даёт |
|---|---|
| Parameters | Ёмкость. Ширина слоёв и глубина. Модель может различать больше тонких ситуаций |
| Training data | Какие структуры модель вообще увидит. Разнообразие важнее повторов |
| Обучаемость | Архитектура, которая не ломается при росте |
- Модели на RNN и LSTM имели миллионы или десятки миллионов параметров. BERT — сотни миллионов. GPT-3 — сотни миллиардов.
Scaling laws: ошибка падает плавно и предсказуемо, если вместе растут параметры, данные и вычисления. Но каждый следующий шаг даёт меньше.- Больше параметров — это потолок, а не гарантия качества.
- Transformer выиграл, потому что его вычисления — большие матричные операции. Это ровно то, что умеют GPU и TPU.
От большой модели к рабочей
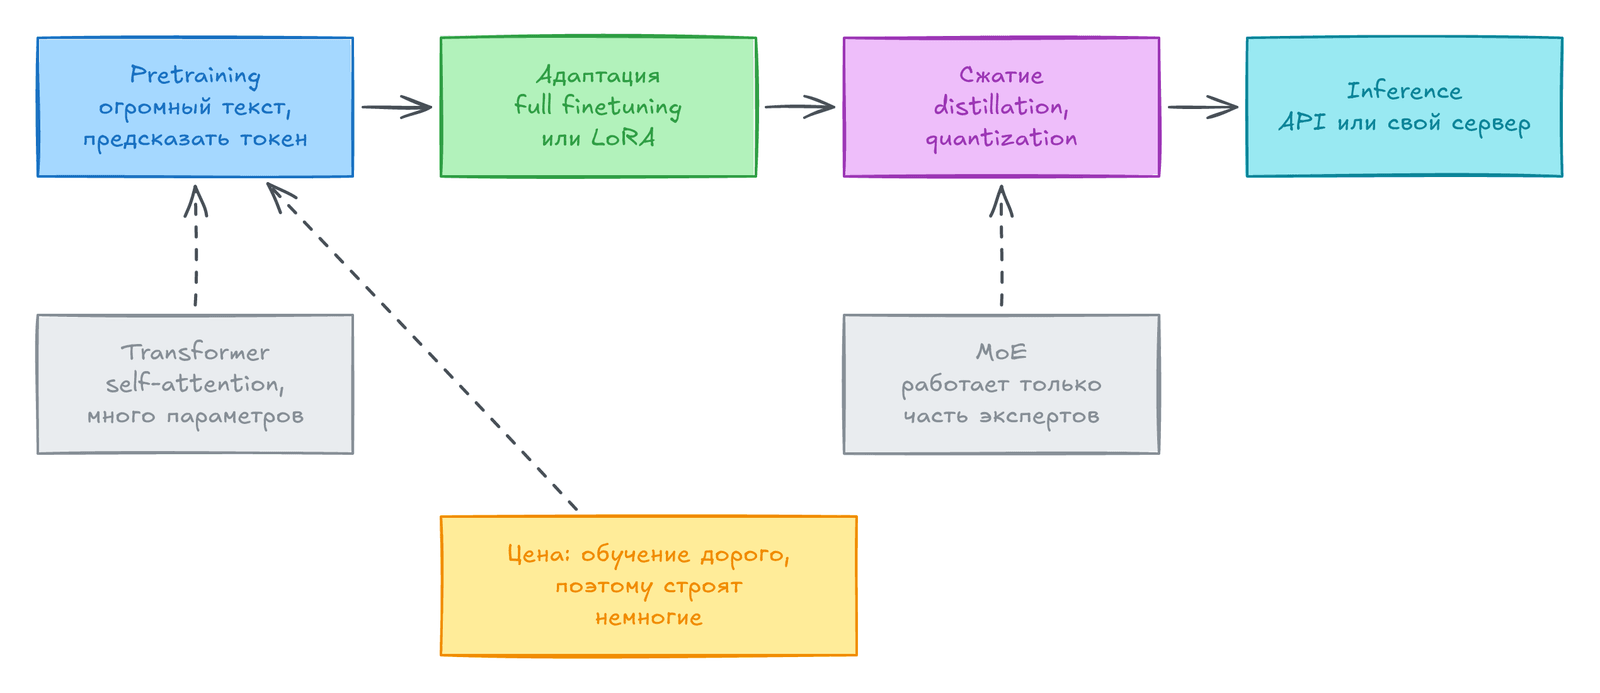
Заголовок раздела «От большой модели к рабочей»Учить модель нужно на большом масштабе. Использовать на таком масштабе часто невозможно. Поэтому модель адаптируют и сжимают.
| Метод | Что меняется | Идея |
|---|---|---|
| Pretraining | Все веса, с нуля | Предсказание следующего токена на огромном тексте |
| Full finetuning | Все веса | Дообучение под задачу или домен. Дорого |
LoRA | Небольшие добавки к замороженным весам | Маленькая поправка рядом с большими матрицами. Стандарт для open-source моделей |
| Distillation | Новая маленькая модель | Student учится повторять распределение вероятностей teacher, а не только правильный ответ |
| Quantization | Точность чисел | Веса хранятся в 8 или 4 битах вместо 16-32. Меньше памяти, быстрее |
- Pretraining похож на опыт в одном виде спорта с ракеткой: в другом такой человек учится быстрее новичка.
- В distillation teacher показывает не только ответ, но и как он взвешивает варианты. Поэтому student учится лучше, чем с нуля.
- Quantization не меняет структуру модели. Но грубая квантизация снижает точность. Помогает калибровка и выборочное применение.
- Главная мысль раздела: исполнять выученное можно с меньшей точностью, чем учиться.
Mixture of Experts
Заголовок раздела «Mixture of Experts»В обычной (dense) модели каждый параметр работает на каждом токене. С ростом модели это всё менее выгодно.
MoE меняет feedforward блок на набор независимых подсетей — экспертов:
- Маленькая
gating networkсмотрит на токен. - Выбирает несколько лучших экспертов (top-k) и даёт им веса.
- Выбранные эксперты считают параллельно, их выходы складываются.
- Остальные эксперты не работают и не учатся на этом токене.
Как семейный врач, который направляет пациента к нужному специалисту.
- Специализация не задаётся руками. Она появляется сама: эксперт чаще получает похожие токены и становится в них лучше.
- Нужен баланс. Если gate шлёт всё двум экспертам, остальные не учатся. Если поровну, специализации нет.
- Плюс: ёмкость растёт быстрее, чем цена одного токена. Примеры: Mixtral и, по слухам, GPT-4.
- Минус: токены идут разными путями. Batching хуже, нагрузка на железо неровная.
- MoE обычно ставят только вместо feedforward слоёв. Attention остаётся общим.
Мультимодальность
Заголовок раздела «Мультимодальность»Текст — это пересказ мира, а не сам мир. Модель может объяснить, как поменять колесо, ни разу его не видев. Но задачи с картинками, схемами, видео упираются в grounding: связь слов с реальными сигналами.
- У каждой модальности свой encoder: текст, картинка, звук.
- Все представления переводят в общее пространство.
- Обучение
contrastive: подпись и её картинку сближают, чужие пары разводят. - Потом текст может найти картинку, а картинка — повлиять на ответ.
| Стратегия | Как | Плюс | Минус |
|---|---|---|---|
| Late fusion | Модальности объединяют у выхода | Просто, стабильно | Мало взаимного влияния |
| Early fusion | Объединяют сразу после encoder | Богатое взаимодействие | Сложно, капризно в обучении |
| Transformer с cross-attention | Одна модальность делает запрос к другой | Гибко, связи учатся сами | Нужно много парных данных |
Ограничение: модель учит, что встречается вместе, а не почему. Она связывает дым с огнём, но не знает, что огонь вызывает дым. Мультимодальность сближает язык и восприятие. Но не сближает восприятие и понимание.
Цена интеллекта
Заголовок раздела «Цена интеллекта»| Фаза | Что происходит | Цена |
|---|---|---|
| Training | Forward и backward проходы, обновление весов на тысячах ускорителей | Десятки и сотни миллионов долларов. Энергия как у небольшого города за год |
| Inference | Только forward pass, веса заморожены | Дешевле за запрос, но платится каждый день и растёт с числом пользователей |
- Обучение — это одна большая ставка. Прервать дорого, повернуть назад почти нельзя.
- Инференс чувствителен к задержке. Железа нужно на пик, а не на среднюю нагрузку.
- Поэтому большинство компаний не держит frontier-модели у себя. Они используют API или небольшие open-source модели в облаке.
- Много инноваций сейчас про то, как сделать модели дешевле, а не больше.
- Энергия на одну операцию падает. Но общее потребление растёт, потому что растут модели и спрос.
- Цена влияет на науку: меньше экспериментов, больше осторожных улучшений, меньше смелых идей.
Масштаб как привратник
Заголовок раздела «Масштаб как привратник»- Знания открыты: архитектуры и методы опубликованы. Барьер не в секретах, а в исполнении.
- Полный цикл обучения frontier-модели доступен немногим компаниям. Остальные работают «ниже по течению»: адаптируют и встраивают.
- Зависимость. Если ваш продукт стоит на чужом API, то поведение модели, цена и правила меняются без вас.
- Неравенство знаний. Владельцы моделей видят внутренности и могут экспериментировать. Остальные судят только по выходам. Многие заявления о моделях нельзя проверить независимо.
- Пользоваться LLM могут все. Определять, какими они будут, — единицы.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
transformer | Архитектура, где attention — главный механизм |
positional encoding | Добавка к embedding, которая сообщает позицию токена |
self-attention | Каждый токен собирает информацию от других по весам |
query, key, value | Что ищу, что предлагаю, что передаю |
multi-head attention | Несколько голов внимания параллельно, каждая видит свои связи |
residual connection | Вход слоя добавляется к выходу |
causal mask | Запрет смотреть на будущие токены |
decoder-only | Семейство моделей, как GPT. Основа современных LLM |
scaling laws | Плавный рост качества при росте параметров, данных и вычислений |
LoRA | Дешёвое дообучение через маленькие добавки к замороженным весам |
distillation | Маленькая модель учится у большой |
quantization | Хранение весов с меньшей точностью |
MoE | Набор экспертов, на каждом токене работают лишь некоторые |
multimodality | Работа с текстом, картинками, звуком в одном пространстве |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Выбор модели. Число параметров не равно качеству. Сравнивайте модели на своих задачах, а не по размеру.
- MoE и цена. У MoE-модели «полный» размер большой, а активных параметров мало. Цена и скорость ближе к активным. Но память GPU нужна под все веса, если хостите сами.
- Промпт, LoRA или full finetuning. Начинайте с промпта и примеров. LoRA — когда нужен стабильный стиль или формат на своих данных. Full finetuning редко оправдан.
- Quantization для своего сервера. 4-битная версия open-source модели часто помещается на одну GPU. Проверьте качество на своих примерах: точность может упасть на SQL и числах.
- Маленькая distilled модель часто хватает для классификации тикетов, извлечения полей, разметки. Она дешевле и быстрее большой.
- Контекст стоит денег. Attention сравнивает каждый токен с каждым. Длинный промпт — это больше вычислений, задержки и счёта. Не кладите в контекст всю схему DWH, если нужна одна таблица.
- Зависимость от API. Модель за API может поменяться без предупреждения. Фиксируйте версию модели, храните набор тестовых промптов и прогоняйте их после обновлений.
- Корреляция, а не причина. LLM хорошо находит, что встречается вместе. Объяснение «почему упала метрика» от модели — это гипотеза, а не вывод. Проверяйте на данных.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Зачем transformer нужен positional encoding, если у RNN его не было?
- Что делают query, key и value? Что меняет causal mask?
- Чем LoRA отличается от distillation и quantization? Когда выбрать каждый метод?
- Почему MoE-модель дешевле в инференсе, чем dense-модель того же полного размера, и в чём её минусы?
Предыдущая: Как устроены нейросети. Следующая: Снова о человеке.