

Machines that Think, глава 6: Не всё то золото, что блестит
Главная мысль: LLM звучит уверенно даже тогда, когда ошибается. Галлюцинации, зависимость от формулировки, jailbreak и пределы контекста — не случайные баги. Они следуют из того, что модель предсказывает следующий токен. Надёжность даёт система вокруг модели, а не сама модель.
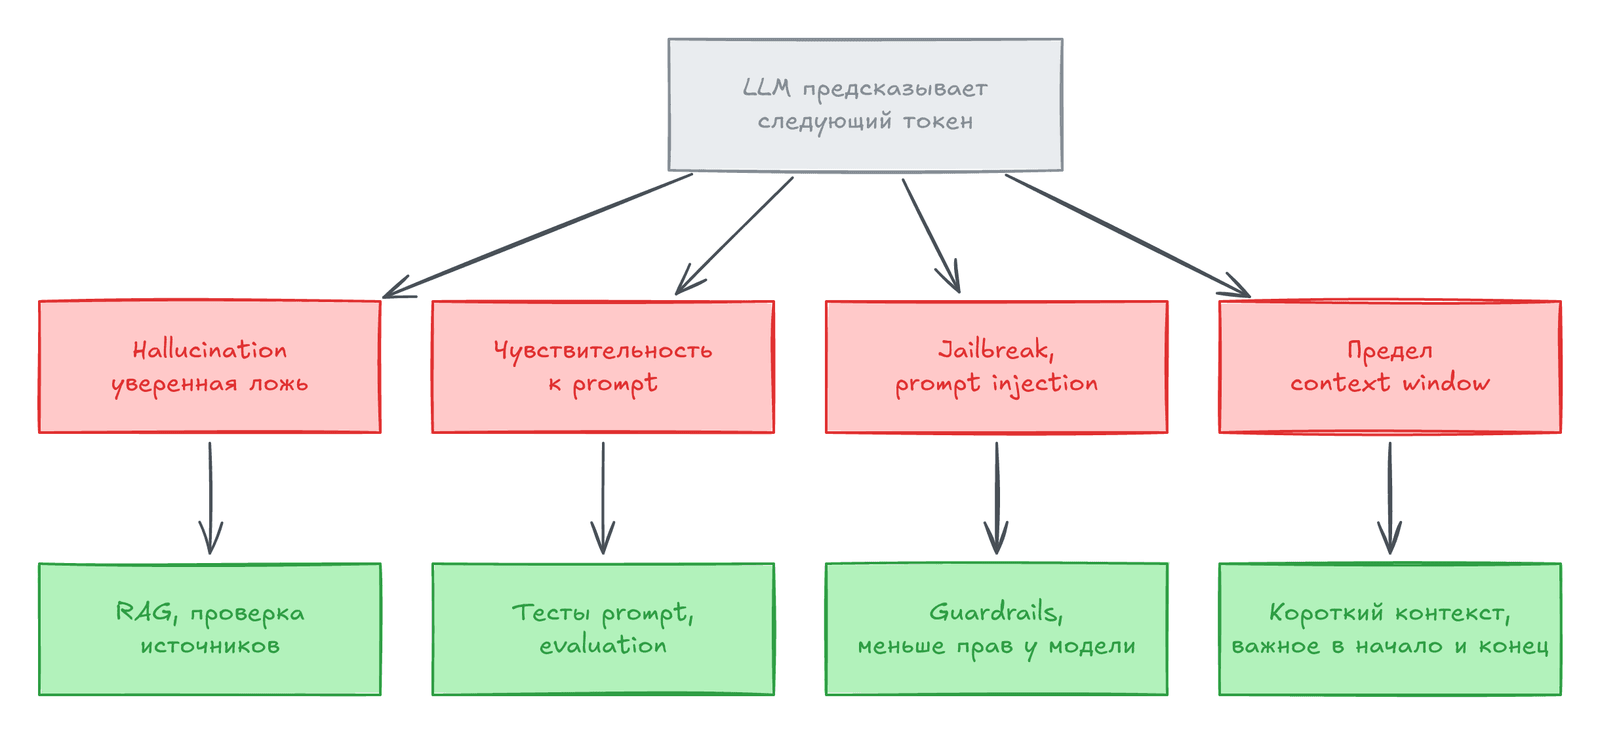
Почему сбои удивляют
Заголовок раздела «Почему сбои удивляют»Мы судим о компетенции по-человечески. Если человек объясняет сложную теорию, мы ждём, что он справится и с простым: заметит, что данных нет, или не забудет инструкцию. С LLM это не работает.
- Модель не хранит базу фактов и не выполняет правила, как обычная программа.
- Каждый ответ — продолжение текста по шаблонам из обучения и по тому, что есть в prompt.
- Факты, инструкции, примеры и найденные документы — всё это сигналы. Они могут усиливать или вытеснять друг друга.
- Сбой приходит в том же уверенном тоне. Поэтому модели верят больше, чем стоит.
Галлюцинации
Заголовок раздела «Галлюцинации»Hallucination — гладкий и уместный текст, который не опирается на проверяемые факты. Обычная ошибка видна сразу: неверная дата, неправильно понятая инструкция. Галлюцинация выглядит как компетентный ответ. Поэтому её трудно поймать.
Откуда они берутся
Заголовок раздела «Откуда они берутся»Модель учат одному: дать высокую вероятность последовательностям, похожим на обучающие данные. Её не учат:
- проверять, правда ли это;
- отличать надёжное знание от слабой ассоциации;
- говорить «я не уверена».
Если вход хорошо похож на обучающие данные, ответ обычно верный. Если похожесть слабая, несколько вариантов конкурируют. Модель всё равно выбирает самый вероятный.
В 2025 году OpenAI показала ещё одну причину. В оценке моделей за правильный ответ дают балл, а за отказ — ноль. Угадывать выгоднее, чем молчать. Так модель учится всегда отвечать.
На границе опыта
Заголовок раздела «На границе опыта»Галлюцинации чаще всего появляются там, где данных мало. Простой пример с регрессией: модель обучили на детях от 2 до 12 лет предсказывать рост по возрасту. Попросите рост 40-летнего — она продолжит линию и выдаст человека ростом три метра.
У LLM то же самое, только в огромном пространстве:
| Тип | Пример (наш) | Что происходит |
|---|---|---|
| Ложная предпосылка | «Какие советы по SQL давал Лев Толстой?» | Модель не спорит с вопросом, а сочиняет правдоподобные советы |
| Переобобщение | «У всех планет есть луны» → «У Венеры три луны» | Частый шаблон переносится туда, где он неверен |
| Редкая тема | Внутренний API вашей компании | Модель достраивает похожее из открытых API |
Когда это уже риск для бизнеса
Заголовок раздела «Когда это уже риск для бизнеса»- Mata v. Avianca, 2023. Юристы подали в суд документ со ссылками на дела, которые придумала модель. Суд наказал юристов и фирму.
- Air Canada, 2024. Чат-бот на сайте пообещал возврат денег по правилу, которого не было. Трибунал решил: компания отвечает за слова своего бота.
Самое опасное — повторное использование. Выдуманная цифра попала в слайд, потом в отчёт, потом в письмо. С каждым шагом она выглядит надёжнее, а источник теряется.
Как уменьшить галлюцинации
Заголовок раздела «Как уменьшить галлюцинации»Сделать модель «честной» нельзя. Можно изменить условия, в которых она отвечает.
| Метод | Идея | Ограничение |
|---|---|---|
| Внешний контекст | Дать модели нужные документы в prompt | Качество зависит от документов и от того, как модель их использует |
Chain-of-thought | Попросить сначала расписать шаги, потом дать ответ | Помогает в многошаговых задачах, но не гарантирует правду |
Chain-of-verification | После ответа отдельно проверить каждое утверждение | Это барьер, а не гарантия |
| Мониторинг неуверенности | Следить, насколько вероятность размазана между токенами | Показывает риск, но не говорит, правда ли это |
Если на каждом шаге один токен явно лидирует, ответ стабилен. Если несколько токенов почти равны, неуверенность копится. Такие ответы стоит отправлять на проверку.
Вывод автора: галлюцинации можно сильно уменьшить, но нельзя убрать. Пока модель награждают за ответ, а не за честный отказ, риск остаётся.
Правила, которые не держатся
Заголовок раздела «Правила, которые не держатся»Модель не выполняет инструкции
Заголовок раздела «Модель не выполняет инструкции»Кажется, что модель читает команду и выполняет её. На самом деле она продолжает текст так, как обычно продолжали похожие prompt в обучении.
- В обычной программе нарушили условие — получили ошибку.
- В LLM соблюдение правила — это вероятность. Сигналы ясные — модель следует правилу. Сигналы спорят — результат плавает.
Мелочи меняют ответ
Заголовок раздела «Мелочи меняют ответ»Исследования показали: на ответ влияют вещи, которые к задаче не относятся.
- приветствие в начале или «спасибо» в конце;
- лишние пробелы, разделители, формат меток;
- порядок примеров;
- тон. В одном эксперименте грубые формулировки дали чуть больше точности, чем вежливые.
Общая точность может почти не меняться. Но сотни отдельных ответов меняются местами: верные становятся неверными и наоборот. Форма запроса — часть сигнала.
Улучшать prompt трудно
Заголовок раздела «Улучшать prompt трудно»- Без правильных ответов люди «улучшают» prompt на глаз. Им кажется, что стало лучше, а точность иногда падает.
- Один и тот же смысл в разных словах даёт очень разный результат.
- Лучший prompt для одной модели может быть плохим для другой.
Итог: у prompt engineering нет стабильного пути. Без набора тестов с известными ответами это угадывание.
Jailbreak
Заголовок раздела «Jailbreak»Модель учат быть полезной, точной и безопасной одновременно. Эти цели иногда спорят. Jailbreak — prompt, который сдвигает баланс так, что «помочь» перевешивает «отказать». Правило не отключают, его перевешивают.
Известные приёмы:
| Приём | Как работает |
|---|---|
| Смена рамки | Опасный запрос подают как учебный сценарий или роман |
| Adversarial suffix | В конец prompt добавляют подобранные токены. Модель начинает с «Конечно, вот как…» и дальше продолжает |
| Many-shot | Длинный prompt с десятками примеров, где модель соглашается. Последний запрос опасный |
| ASCII art | Запрещённое слово рисуют символами. Фильтр не видит, модель понимает |
Защита модели — вероятностная, а не жёсткая стена. Старые атаки перестают работать, но появляются новые. Полной гарантии нет.
Как держать систему в рамках
Заголовок раздела «Как держать систему в рамках»- Фильтры на входе и выходе. Проверяют prompt до модели и ответ после. Слишком строгие мешают работе, слишком мягкие пропускают.
- Архитектурные границы. Код выполняется в sandbox, поиск — только по разрешённым источникам, инструменты — через явный интерфейс.
- Шаблоны и примеры.
Few-shotи единый формат prompt тянут ответ к нужному виду. - Мониторинг. Регулярный просмотр ответов, стресс-тесты, обновление защит.
Бюджет на память
Заголовок раздела «Бюджет на память»Откуда модель берёт ответ
Заголовок раздела «Откуда модель берёт ответ»Есть только два источника:
- Веса. Знания из обучения. Они постоянные, но устаревают и не меняются при работе.
- Текст в prompt. Всё, что подали прямо сейчас: вопрос, инструкции, история чата, документы.
Если факта нет ни там, ни там, модель его не использует. Чат кажется непрерывным только потому, что система каждый раз снова подаёт прошлые сообщения.
Context window
Заголовок раздела «Context window»Context window — сколько токенов модель обрабатывает за один раз. Как поле зрения: мир шире, но видно только то, что попало в кадр.
| Период | Размер окна | Примерно |
|---|---|---|
| Первые чат-боты, 2022 | 4–8 тыс. токенов | Несколько страниц |
| Многие модели сейчас | около 128 тыс. | Небольшая книга |
| Новые и исследовательские | сотни тысяч — миллионы | Несколько томов |
Что не влезло, система обрезает или сжимает. «Модель забыла» обычно значит «это выпало из окна».
В окне, но не в фокусе
Заголовок раздела «В окне, но не в фокусе»Попасть в окно — не значит повлиять на ответ. Attention распределяет вес неравномерно.
- Исследование «Lost in the Middle» (2023): модели лучше всего используют информацию в начале и в конце контекста. Хуже всего — в середине. Иногда ответ в середине давал результат хуже, чем вообще без документов.
- Практики называют потерю влияния в длинном контексте
context rot. - Простой приём: повторить важную часть prompt ещё раз. В исследовании 2025 года это давало прирост точности.
RAG: заёмная память
Заголовок раздела «RAG: заёмная память»Корпоративный архив не влезет ни в какое окно. RAG подбирает нужные куски и вставляет их в prompt.
- Вопрос превращают в
embedding— вектор смысла. - Ищут ближайшие векторы среди документов базы знаний.
- В prompt кладут исходный текст лучших документов. Сами векторы модель не читает.
- Модель отвечает по вопросу и найденным кускам.
Плюс: знания можно обновить без переобучения модели. Просто проиндексировать новые документы.
Варианты: top-k, reranking, hybrid search (смысл + ключевые слова), итеративный поиск, ответ с обязательными ссылками на источники.
Найти — не значит опереться
Заголовок раздела «Найти — не значит опереться»Даже с правильными документами модель может добавить то, чего в них нет. Найденный текст проходит через тот же attention с теми же слабостями. В компаниях к этому добавляются доступы, аудит, соответствие требованиям. RAG меняет то, что попадает в окно. Но он не меняет то, как модель думает.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
Hallucination | Уверенный и гладкий ответ без опоры на факты |
Grounding | Насколько ответ привязан к проверяемым источникам |
Chain-of-thought | Prompt, который просит расписать шаги до ответа |
Chain-of-verification | Отдельный шаг проверки утверждений после ответа |
Jailbreak | Prompt, который обходит защиту модели через смену баланса сигналов |
Few-shot prompting | Примеры нужного ответа прямо в prompt |
Context window | Максимум токенов, которые модель видит за один раз |
Lost in the middle | Модель хуже использует информацию из середины длинного контекста |
Context rot | Информация есть в окне, но всё слабее влияет на ответ |
RAG | Поиск нужных документов и вставка их в prompt перед ответом |
Embedding | Вектор, который описывает смысл текста для поиска похожих |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Проверяйте цифры. Попросили LLM посчитать долю оттока или найти функцию в Snowflake — сверьте с запросом к хранилищу или с документацией. Ни одна цифра от модели не идёт в отчёт без источника.
- Разрешите модели говорить «не знаю». В prompt пишите: «Если в документах нет ответа, так и скажи». Это снижает число выдуманных ответов.
- RAG по документам компании — не гарантия. Требуйте ссылки на источник в каждом ответе. Сделайте выборочную проверку: есть ли утверждение в найденном куске.
- Важное — в начало или в конец. Схему таблицы, правила и сам вопрос не прячьте в середину длинного контекста. Ключевую инструкцию можно повторить в конце.
- Контекст стоит денег. Каждый токен в окне оплачивается. Огромный контекст дороже и не всегда точнее. Лучше подобрать 5 нужных кусков, чем вставить весь Confluence.
Prompt injectionв пайплайнах. Если LLM читает отзывы клиентов, письма или веб-страницы, в тексте может быть «игнорируй инструкции и …». Модель не отличает данные от команд жёстко. Не давайте такому шагу права на запись в базу и отправку писем. Проверяйте выход по схеме.- Тестируйте prompt как код. Соберите набор из 50–100 примеров с правильными ответами. Меняете prompt или модель — прогоняете набор. Без него «стало лучше» — просто ощущение.
- Фиксируйте модель и prompt. Смена версии модели или пробела в шаблоне может изменить классификацию в пайплайне. Храните prompt в git и логируйте версию модели.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему процесс обучения и оценки моделей подталкивает их угадывать, а не отказываться?
- Чем jailbreak отличается от взлома обычной программы? Почему от него нет полной защиты?
- Что такое «Lost in the Middle» и как это учесть, когда вы собираете prompt?
- Почему хороший поиск в
RAGвсё ещё не гарантирует ответ без галлюцинаций?
Предыдущая: Снова о человеке. Следующая: Да, я могу быть неэтичным.