

Data Pipelines with Apache Airflow, глава 15: Airflow в production
Главная мысль: в production важно выбрать executor под нагрузку, настроить параллелизм и логи, следить за метриками и получать алерты о сбоях. Для разных команд решают отдельно: один общий Airflow или свой у каждой.
Компоненты Airflow
Заголовок раздела «Компоненты Airflow»| Компонент | Роль |
|---|---|
| API server | Показывает UI. Это единственный шлюз для других компонентов к metastore (Airflow 3) |
| DAG processor | Разбирает файлы DAG и кладёт их сериализованную версию в metastore. В Airflow 3 это отдельный обязательный процесс |
| Scheduler | Решает, какие tasks запускать, и ставит их в очередь |
| Workers | Выполняют tasks. Их тип задаёт executor |
| Triggerer | Нужен только для deferrable operators |
| Metastore | База с метаданными: DAG runs, состояния, сериализованные DAG |
Книга отмечает: путь “всё через API server” в Airflow 3 пока реализован не везде. Поведение может отличаться.
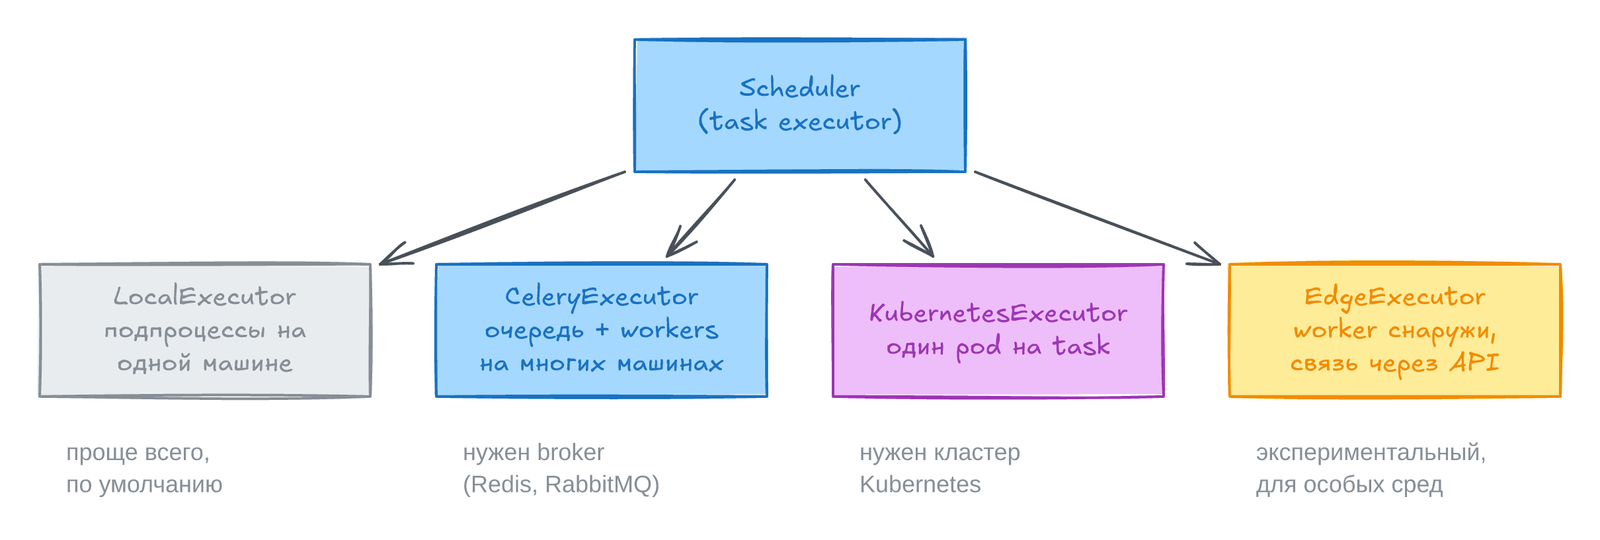
Выбор executor
Заголовок раздела «Выбор executor»Executor настраивают переменной AIRFLOW__CORE__EXECUTOR. Порядок приоритета настроек: переменная окружения, _CMD-вариант, airflow.cfg, команда в cfg, значение по умолчанию.
| Executor | Распределённый | Установка | Когда подходит |
|---|---|---|---|
LocalExecutor | Нет | Простая | Хватает одной машины. Это default в Airflow 3 |
CeleryExecutor | Да | Средняя | Нужно масштабироваться на несколько машин |
KubernetesExecutor | Да | Сложная | Есть Kubernetes, нужна изоляция |
EdgeExecutor | Да | Средняя | Tasks должны идти вне среды Airflow, например on-premise |
Есть ещё BatchExecutor и EcsExecutor для AWS. Книга их не разбирает.
LocalExecutor
Заголовок раздела «LocalExecutor»- Tasks идут в подпроцессах scheduler на одной машине.
- Лимит параллелизма:
AIRFLOW__CORE__PARALLELISM, по умолчанию 32. - Нужна база PostgreSQL или MySQL.
CeleryExecutor
Заголовок раздела «CeleryExecutor»- Scheduler кладёт tasks в очередь (broker: Redis, RabbitMQ, AWS SQS). Workers забирают их.
- Нужны
AIRFLOW__CELERY__BROKER_URLиAIRFLOW__CELERY__RESULT_BACKEND. - Файлы DAG должны быть доступны на всех workers по одному пути. Способы: общая файловая система или образ с DAG внутри.
- Мониторинг: Flower (
airflow celery flower, порт 5555). - Это самый простой способ масштабироваться: Kubernetes не нужен.
KubernetesExecutor
Заголовок раздела «KubernetesExecutor»- Каждый task идёт в своём pod. Scheduler просит Kubernetes API создать pod.
- Есть три способа доставить DAG: общий PersistentVolume, git-sync init container или DAG внутри образа.
- Даёт хорошую изоляцию, но больше накладных расходов. Иногда и на Kubernetes выбирают Celery.
- Обычно ставят через Helm (глава 17).
EdgeExecutor
Заголовок раздела «EdgeExecutor»- Worker работает вне среды Airflow и общается с API server. Нужен провайдер
edge3. - Подходит, если часть tasks должна идти в особой среде.
- Статус: экспериментальный.
Несколько executors сразу
Заголовок раздела «Несколько executors сразу»- В конфиге можно указать список, например
LocalExecutor,CeleryExecutor. - Для отдельного task executor задают аргументом
executor=. Если не указан, берётся первый в списке. - Старые “гибридные” executors (
CeleryKubernetesExecutor) книга не советует. Они держатся на хитрости сqueue.
Metastore
Заголовок раздела «Metastore»- Airflow работает с базой через SQLAlchemy. Для production рекомендуют PostgreSQL. SQLite годится только для тестов.
- Строку подключения задают в
AIRFLOW__CORE__SQL_ALCHEMY_CONN.
Полезные команды CLI:
| Команда | Что делает |
|---|---|
airflow db migrate | Создаёт схему или обновляет до последней версии |
airflow db check | Проверяет доступность базы |
airflow db clean | Удаляет старые записи до заданной даты |
airflow db shell | Открывает консоль базы. Не правьте данные руками |
airflow db reset | Стирает базу и создаёт пустую |
Чтобы убрать примеры, поставьте LOAD_EXAMPLES=False и LOAD_DEFAULT_CONNECTIONS=False. Делайте это до первой инициализации. Если примеры уже в базе, флаг их не удалит.
Scheduler и параллелизм
Заголовок раздела «Scheduler и параллелизм»Scheduler делает две вещи: решает, какие tasks готовы (task scheduler), и запускает их через executor (task executor).
Путь task: scheduled, queued, running, success. Executor запускает airflow tasks run в отдельном процессе. Пока task идёт, он шлёт heartbeat в metastore.
Можно запустить несколько scheduler. Лидера не выбирают. Они координируются блокировками строк в базе (row-level locking), поэтому база должна это поддерживать. Если один scheduler упал, остальные работают.
Настройки, которые ограничивают число параллельных tasks:
| Настройка | По умолчанию | Что ограничивает |
|---|---|---|
MAX_ACTIVE_TASKS_PER_DAG | 16 | Tasks в queued или running на один DAG |
MAX_ACTIVE_RUNS_PER_DAG | 16 | Параллельные DAG runs одного DAG |
PARALLELISM | 32 | Все tasks во всей системе |
WORKER_CONCURRENCY (Celery) | 16 | Tasks на один worker |
- Есть ещё лимит
default_pool: 128 слотов. Для тяжёлых tasks заводят отдельный pool с малым числом слотов. - На один процесс worker закладывайте не меньше 200 МБ RAM.
DAG processor
Заголовок раздела «DAG processor»- Он регулярно перечитывает файлы в папке DAG. Это нужно для динамических DAG, у которых код тот же, а структура меняется.
REFRESH_INTERVAL(по умолчанию 300 с) задаёт, как часто искать новые файлы. Если новые DAG появляются слишком долго, уменьшите его.PARSING_PROCESSES(по умолчанию 2) задаёт число процессов разбора.- Чем чаще разбор, тем быстрее видны изменения. Но растёт нагрузка на CPU.
Три вида логов:
- API server logs. Access и error логи. По умолчанию идут в stdout.
- Scheduler logs. Пишутся в файлы. Показывают, как scheduler разбирает DAG и создаёт runs.
- Task logs. Один файл на одну попытку task. Путь:
dag_id=.../task_id=.../<run>/attempt=N.log.
Если контейнеры эфемерные, логи пропадут вместе с ними. Включите remote logging: LOGGING__REMOTE_LOGGING=True и REMOTE_LOG_CONN_ID. Поддерживаются S3, GCS, Azure Blob, Elasticsearch, OpenSearch и другие.
Метрики
Заголовок раздела «Метрики»Наблюдаемость строится из трёх вещей: логи, метрики, traces. Книга разбирает метрики.
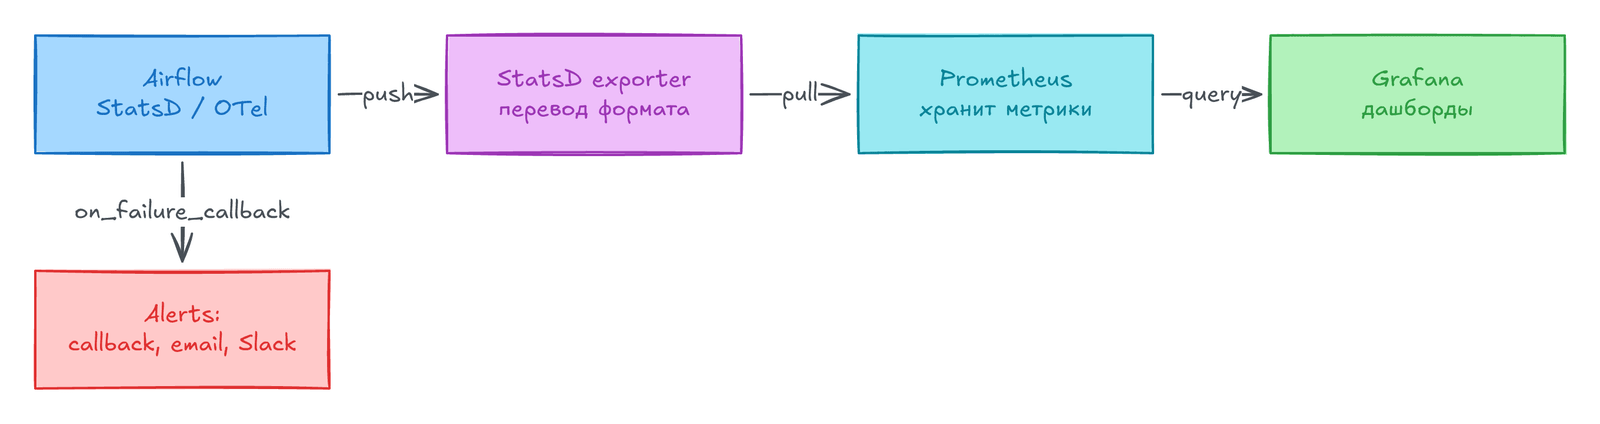
- Airflow умеет отправлять метрики через StatsD или OpenTelemetry.
- StatsD работает по модели push. Prometheus работает по модели pull. Поэтому между ними ставят
statsd-exporter. Он переводит формат. - Prometheus хранит метрики как time series. Выбирать их можно по именам и labels (
dag_id,task_id). - Grafana строит дашборды поверх Prometheus.
- Задержка от события до графика обычно в пределах минуты.
Четыре сигнала для наблюдения: latency, load, errors, saturation. Примеры метрик:
| Метрика | Что показывает |
|---|---|
dag_processing.import_errors | Ошибки разбора DAG. Должно быть 0 |
dag_processing.total_parse_time | Время разбора всех DAG. Резкий рост плохо |
ti_failures | Число упавших task instances |
executor.open_slots | Свободные слоты executor |
executor.queued_tasks | Tasks в состоянии queued |
dagrun.<dag_id>.first_task_scheduling_delay | Задержка начала DAG run |
Для остальных систем ставят exporters: node exporter для машин, exporter для PostgreSQL, Celery, Redis, Kubernetes.
on_failure_callbackна DAG срабатывает при падении всего DAG run.on_failure_callbackна task (обычно черезdefault_args) срабатывает при падении task. Есть ещёon_success_callbackиon_retry_callback.- Функцию callback пишете вы: Slack, PagerDuty, email.
- Для email есть
email_on_failureиemail. Нужна настройка SMTP. Логин и пароль берут из connection. - Не делайте слишком много алертов. Люди перестают их читать (alert fatigue).
Один Airflow или несколько
Заголовок раздела «Один Airflow или несколько»| Один на всех | Свой на команду | |
|---|---|---|
| Стоимость | Ниже, ресурсы общие | Выше, компоненты дублируются |
| Изоляция | Слабая. Один сбой касается всех | Полная. Свои настройки и апгрейды |
| Права и владение DAG | Сложнее | Проще |
| Связь между командами | Assets работают | Assets не видны между instances. Нужны обходные решения |
Пример кода
Заголовок раздела «Пример кода»Проверено на Airflow 3.4: DAG проходит airflow dags test.
Callback при падении и общий default_args (функция и имена придуманы для примера):
import pendulumfrom airflow.providers.standard.operators.bash import BashOperatorfrom airflow.sdk import DAG

def notify_failure(context):    ti = context["ti"]    print(f"Task {ti.task_id} failed in DAG {ti.dag_id}")

with DAG(    dag_id="nightly_export",    schedule="@daily",    start_date=pendulum.datetime(2026, 1, 1, tz="UTC"),    default_args={"on_failure_callback": notify_failure, "retries": 1},) as dag:    export = BashOperator(        task_id="export",        bash_command="echo export",        executor="LocalExecutor",    )
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Executor | Часть scheduler. Задаёт, как и где запускаются tasks |
| Broker | Очередь для Celery (Redis, RabbitMQ, SQS) |
| Pod | Минимальная единица запуска в Kubernetes |
| Metastore | База с метаданными Airflow |
parallelism | Глобальный лимит параллельных task instances |
| Pool | Ограничение числа слотов для группы tasks |
| Heartbeat | Периодический сигнал, что task ещё идёт |
| StatsD | Протокол отправки метрик (push) |
| Prometheus | Система сбора метрик (pull) с базой time series |
| Grafana | Инструмент дашбордов |
| Callback | Функция, которая вызывается при событии (сбой, успех, retry) |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Начните с
LocalExecutor. Переходите на Celery или Kubernetes, когда не хватает ресурсов одной машины или нужна отказоустойчивость. - Для production берите PostgreSQL. Регулярно запускайте
airflow db clean, чтобы metastore не рос бесконечно. - Подбирайте лимиты вместе:
parallelism,max_active_tasks_per_dag, pools и память workers. - Включите remote logging до первого сбоя. Потом старые логи уже не вернуть.
- Следите минимум за
import_errors,ti_failures, очередью и задержкой планирования. - Добавьте
on_failure_callbackвdefault_args. Алерты выбирайте внимательно, иначе их перестанут читать. - Если у вас несколько команд, решите заранее, как делить Airflow. Это влияет на стоимость, права и связи через assets.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Какую роль в Airflow 3 играет API server? Чем отличается DAG processor от scheduler?
- Когда выбрать
CeleryExecutor, а когдаKubernetesExecutor? - Почему DAG может выполнять только 16 tasks параллельно, хотя
parallelismравен 32? - Зачем между Airflow и Prometheus ставят
statsd-exporter?
Предыдущая: Проект: GenAI и семейные традиции. Следующая: Защита Airflow.