

Data Pipelines with Apache Airflow, глава 12: Best practices
Главная мысль: хороший pipeline Airflow это чистый код DAG, задачи, которые можно безопасно повторить, и экономная работа с данными. Airflow лучше всего оркестрирует. Тяжёлую работу отдавайте внешним системам.
Чистые DAG
Заголовок раздела «Чистые DAG»Стиль кода
Заголовок раздела «Стиль кода»- Выберите общий стиль: PEP 8 или Google Python Style Guide.
- Static checkers (
Pylint,Flake8) ищут ошибки и нарушения стиля. - Formatters (
Black,YAPF) приводят код к одному виду. Ruffобъединяет linter и formatter. Он написан на Rust и быстрый.- У
Ruffесть правила для Airflow: имя переменной задачи должно совпадать сtask_id. ПравилаAIR3помогают мигрировать с Airflow 2 на 3.
Единый стиль Airflow
Заголовок раздела «Единый стиль Airflow»Один результат в Airflow можно получить разными способами. Выберите один и держитесь его.
| Что | Варианты |
|---|---|
| Определение DAG | with DAG(...), DAG(...) с dag=, декоратор @dag (Taskflow) |
| Зависимости | >>, <<, [a] >> b, set_upstream, set_downstream |
Не смешивайте записи зависимостей в одном DAG. Читать такой код тяжело.
Секреты в одном месте
Заголовок раздела «Секреты в одном месте»- Храните credentials в Airflow connections, а не в коде или в файлах рядом.
- В своём коде берите их через
BaseHook.get_connection(conn_id). - Если секреты в Kubernetes secrets или в облачном vault, подключайте их через secrets backend.
- В конфигурационных файлах секреты не держите. Они лежат в открытом виде.
Конфигурация
Заголовок раздела «Конфигурация»Для конфига есть много мест: YAML, переменные окружения, Python-модуль, Airflow Variables. Главное, чтобы подход был одинаковый во всех DAG.
- Общие параметры держите в одном файле (принцип DRY).
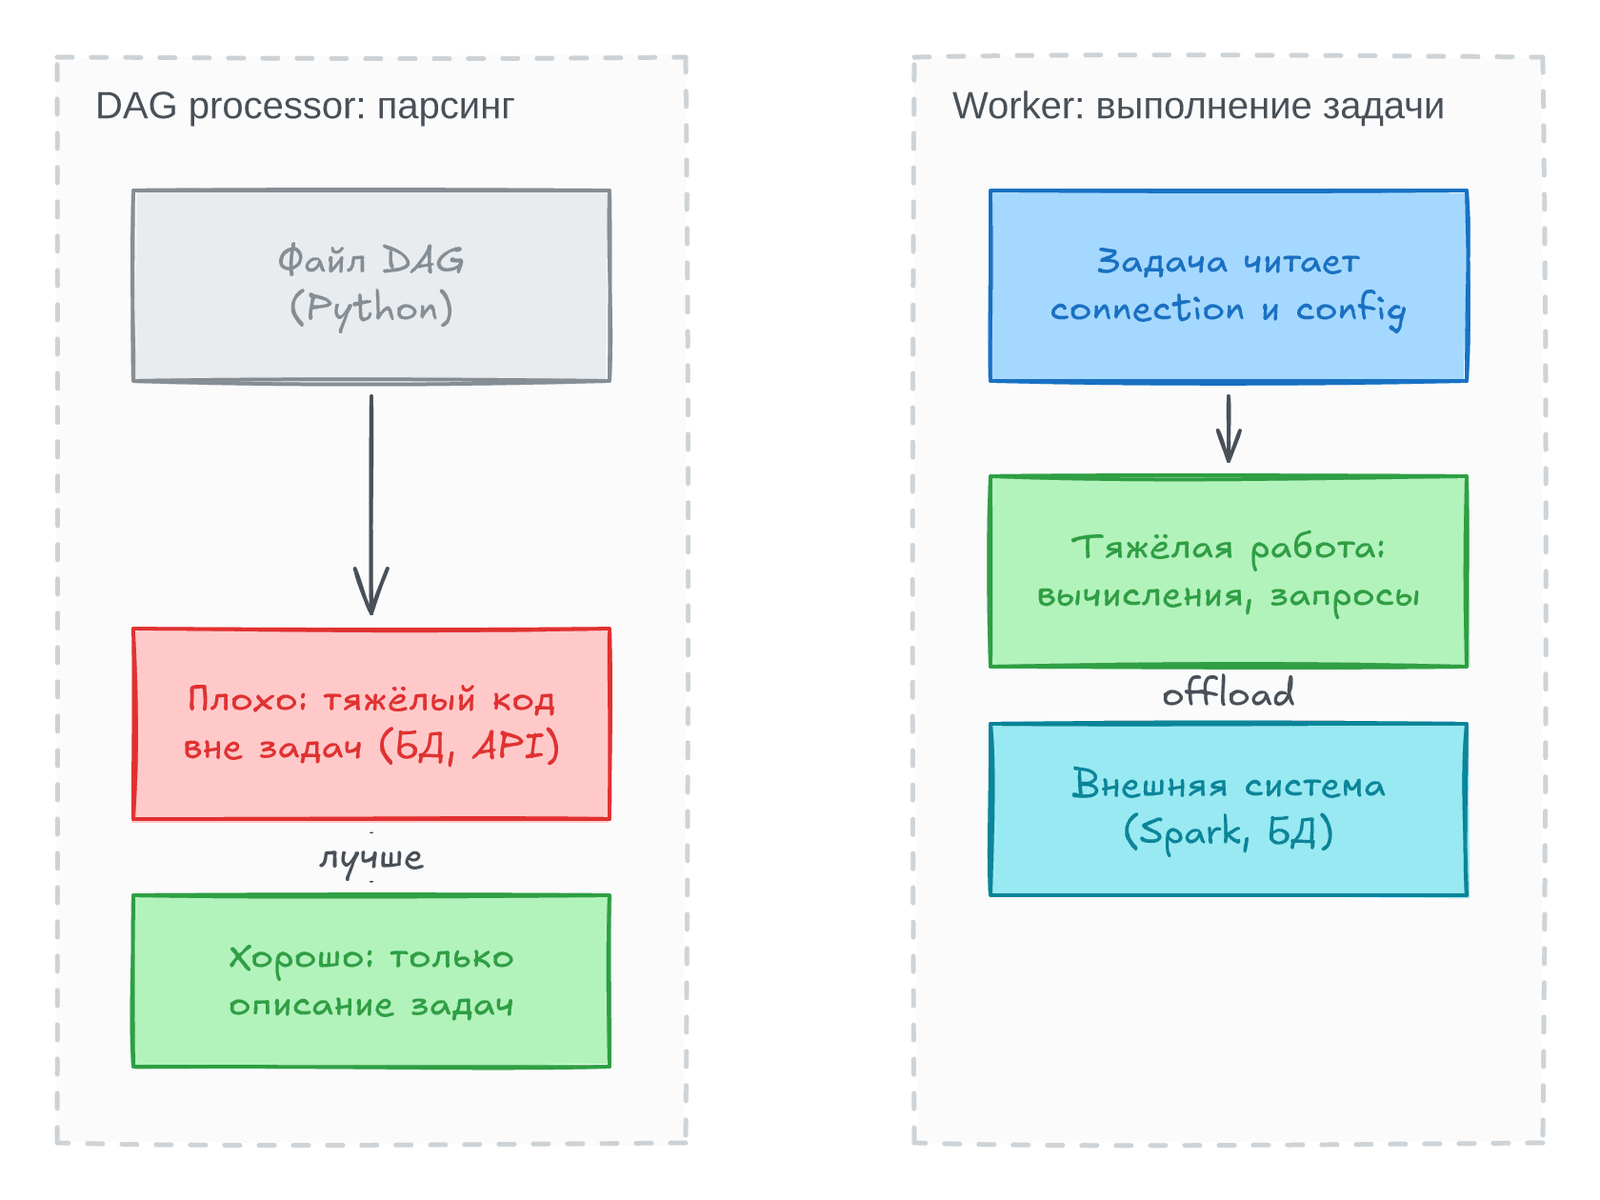
- Помните, где выполняется код. Файл, прочитанный на уровне DAG, читает scheduler или DAG processor. Файл, прочитанный внутри задачи, читает worker. У них могут быть разные файловые системы.
- Лучше общее хранилище, доступное всем компонентам.
Не считайте в определении DAG
Заголовок раздела «Не считайте в определении DAG»Airflow заново выполняет файл DAG каждые ~30 секунд (зависит от настроек). Всё, что лежит вне задач, выполняется при каждом парсинге.
- Тяжёлое вычисление в теле файла тормозит весь парсинг.
Variable.get()илиget_connection()вне задачи бьёт по БД каждый раз.- Решение: перенесите вызов внутрь функции задачи. Тогда он идёт один раз, при запуске.
Фабрики
Заголовок раздела «Фабрики»Если вы пишете много похожих DAG, напишите factory function. Она принимает конфиг и возвращает задачи или DAG.
- Для нескольких DAG из одного файла нужны разные имена в
globals(). Иначе Airflow увидит только последний DAG. - Книга советует осторожность: обычно один файл на один DAG.
- Фабрика плюс YAML позволяет не-программистам настраивать ETL.
Task groups
Заголовок раздела «Task groups»TaskGroup складывает связанные задачи в один узел в UI. Его можно раскрыть. Группы можно вкладывать друг в друга. Они сильно уменьшают шум в больших DAG.
Явное расписание
Заголовок раздела «Явное расписание»Строка вроде @daily может вести себя по-разному.
- Настройки
create_cron_data_intervalsиcreate_delta_data_intervalsменяют её смысл на уровне экземпляра. - В Airflow 2 по умолчанию работали intervals, в Airflow 3 по умолчанию работают точки во времени.
- Совет: всегда задавайте класс timetable явно (
CronTriggerTimetable,CronDataIntervalTimetable).
Dynamic Task Mapping
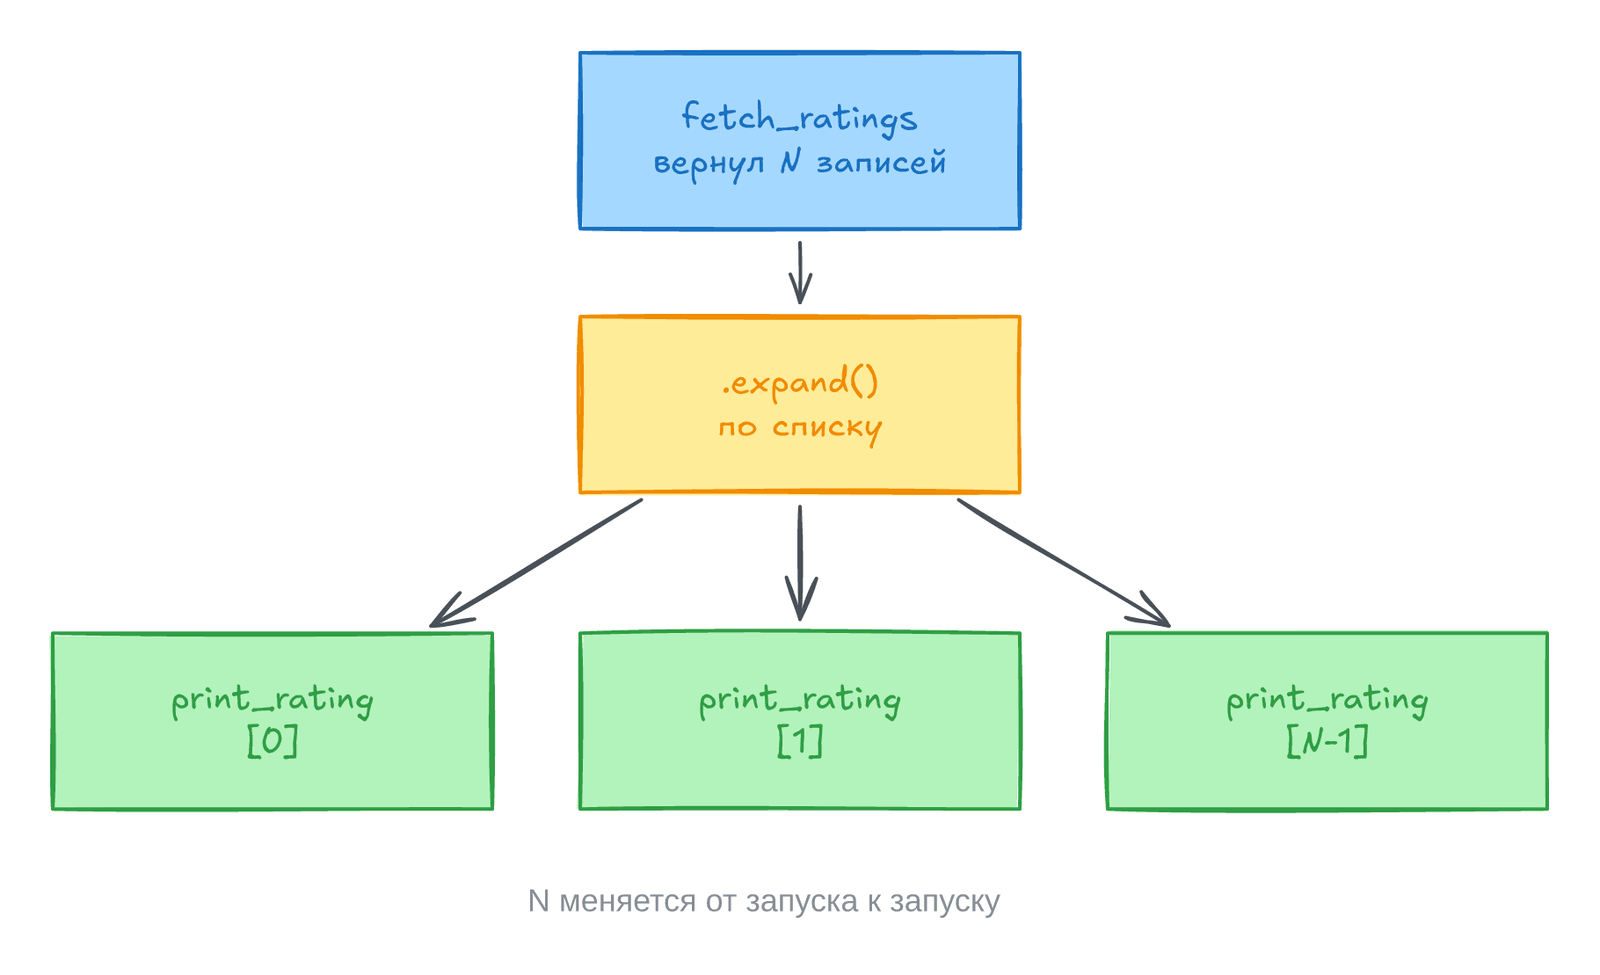
Заголовок раздела «Dynamic Task Mapping»Иногда число задач заранее неизвестно. Например, каждый день приходит разное число файлов. Одна задача на все файлы не атомарна и не параллельна. Её нельзя повторить для одного файла.
expand()создаёт по одной задаче на элемент входа.partial()задаёт параметры, одинаковые для всех.- В Taskflow запись чище:
print_rating.expand(rating=fetch_ratings()). - Можно размножать и
task_group. - В UI такая задача помечена
[], а экземпляры видны поmap index. - Структура DAG может отличаться от запуска к запуску.
Воспроизводимые задачи
Заголовок раздела «Воспроизводимые задачи»- Идемпотентность. Повтор задачи даёт тот же итог. Повторы бывают при retry и при перезапуске. Обычно для этого результат перезаписывают. Побочные эффекты (уведомления) тоже учитывайте.
- Детерминизм. Те же входные данные дают тот же выход. Источники недетерминизма:
- неявный порядок в dict или в строках из БД без
ORDER BY; - внешнее состояние: random, глобальные переменные, файлы;
- параллельная обработка без сортировки результата;
- race conditions и неверная обработка исключений.
- Лекарство: явная сортировка, фиксированный seed.
- неявный порядок в dict или в строках из БД без
- Функциональный подход. Чистые функции без побочных эффектов обычно идемпотентны и детерминированы. Эту идею называют functional data engineering.
Эффективная работа с данными
Заголовок раздела «Эффективная работа с данными»| Совет | Идея |
|---|---|
| Меньше данных | Отбросьте лишние строки и колонки. Агрегируйте и фильтруйте до join |
| Инкрементально | Обрабатывайте партицию по времени в каждом запуске. Ошибка не требует пересчёта всего |
| Кэш промежуточных данных | Сохраняйте результат каждого шага. Тогда можно перезапустить один шаг |
| Не на локальном диске | Задачи идут на разных worker. Нужно общее хранилище: bucket, БД |
| Offload | Фильтры и агрегации делайте в БД. Тяжёлые вычисления отдавайте Spark |
Дополнительно:
- Всегда храните самую сырую версию данных. Источники часто не хранят историю.
- Промежуточные данные может быть слишком много. Храните их ограниченное время и чистите.
- Airflow задуман как оркестратор. Не делайте из workers вычислительный кластер.
Много параллельных задач могут перегрузить общий ресурс: БД, GPU, кластер Spark.
- Pool это набор слотов. Слот даёт доступ к ресурсу.
- Создать pool можно в UI: Admin, Pools. Укажите имя, описание и число слотов.
- Задача указывает
pool="имя". Scheduler берёт слот перед запуском задачи. - Если слотов нет, задача ждёт.
- Pool на 10 слотов значит не более 10 одновременных задач.
- Есть флажок: считать ли deferrable-задачи в слотах.
Пример кода
Заголовок раздела «Пример кода»Проверено на Airflow 3.4: DAG проходит airflow dags test.
Dynamic Task Mapping в Taskflow и задача в pool. Имена придуманы для примера.
from datetime import datetime
from airflow.sdk import dag, task

@dag(start_date=datetime(2025, 1, 1), schedule=None)def mapping_demo():    @task    def list_files():        return ["a.csv", "b.csv", "c.csv"]
    @task(pool="db_pool")    def load_file(name: str):        print(f"Loading {name}")
    load_file.expand(name=list_files())

mapping_demo()
Тяжёлый вызов внутри задачи, а не в теле файла:
from airflow.sdk import BaseHook, task

@taskdef call_api():    conn = BaseHook.get_connection("my_api")    return conn.host
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Idempotent | Повтор даёт тот же итог |
| Deterministic | Тот же вход даёт тот же выход |
| Factory function | Функция, которая создаёт задачи или DAG по конфигу |
TaskGroup | Группа задач в одном узле UI |
| Dynamic Task Mapping | Создание задач по данным во время запуска |
expand() / partial() | Что размножить / что оставить постоянным |
| Secrets backend | Подключение внешнего хранилища секретов |
| Pool | Набор слотов, ограничивающий параллелизм |
| Offloading | Перенос тяжёлой работы во внешнюю систему |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Подключите
ruffиblackв CI. Договоритесь о стиле DAG и зависимостей. - Проверьте DAG на тяжёлый код вне задач. Особенно на запросы к БД и API.
- Секреты только в connections или secrets backend.
- Пишите задачи так, чтобы запись была
overwriteпо партиции. Тогда retry и backfill безопасны. - Не пишите промежуточные файлы на диск worker. Берите общее хранилище.
- Ограничивайте нагрузку на хрупкие системы через pools.
- Задавайте timetable явно. Не полагайтесь на строку
@daily.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему вычисления в теле файла DAG вредны? Куда их переносить?
- Когда фабрика не подходит и нужен Dynamic Task Mapping?
- Что значит идемпотентная и детерминированная задача? Приведите по одному примеру нарушения.
- Почему не стоит хранить промежуточные данные на локальном диске worker?
Предыдущая: Запуск задач в контейнерах. Следующая: Проект: самый быстрый путь по Нью-Йорку.