

Data Pipelines with Apache Airflow, глава 14: Проект с GenAI и семейными рецептами
Главная мысль: чтобы LLM отвечала по вашим данным, не нужно её переобучать. Достаточно RAG: найти нужные куски текста в векторной базе и подать их модели. Airflow готовит и обновляет эти данные.
Задача проекта
Заголовок раздела «Задача проекта»Есть семейные рецепты. Хочется положить их в систему, где можно спросить: “Есть ли в рецепте дрожжи?”, “Переведи на другой язык”, “Чем заменить ингредиент?”. Проект называется Recipe Vault.
Почему не fine-tuning
Заголовок раздела «Почему не fine-tuning»Fine-tuning значит дообучить LLM на своих данных. У этого пути четыре проблемы:
| Проблема | Суть |
|---|---|
| Цена | Нужно менять миллиарды параметров. Нужны мощные машины |
| Повторное обучение | Каждая новая порция рецептов требует нового обучения |
| Хостинг | Свою модель надо где-то держать |
| Источник неясен | Знания модели смешиваются. Не видно, что из ваших рецептов, а что из общих данных |
Как работает RAG
Заголовок раздела «Как работает RAG»RAG (retrieval-augmented generation) даёт LLM доступ к внешней “библиотеке”. Модель не обучается заново.
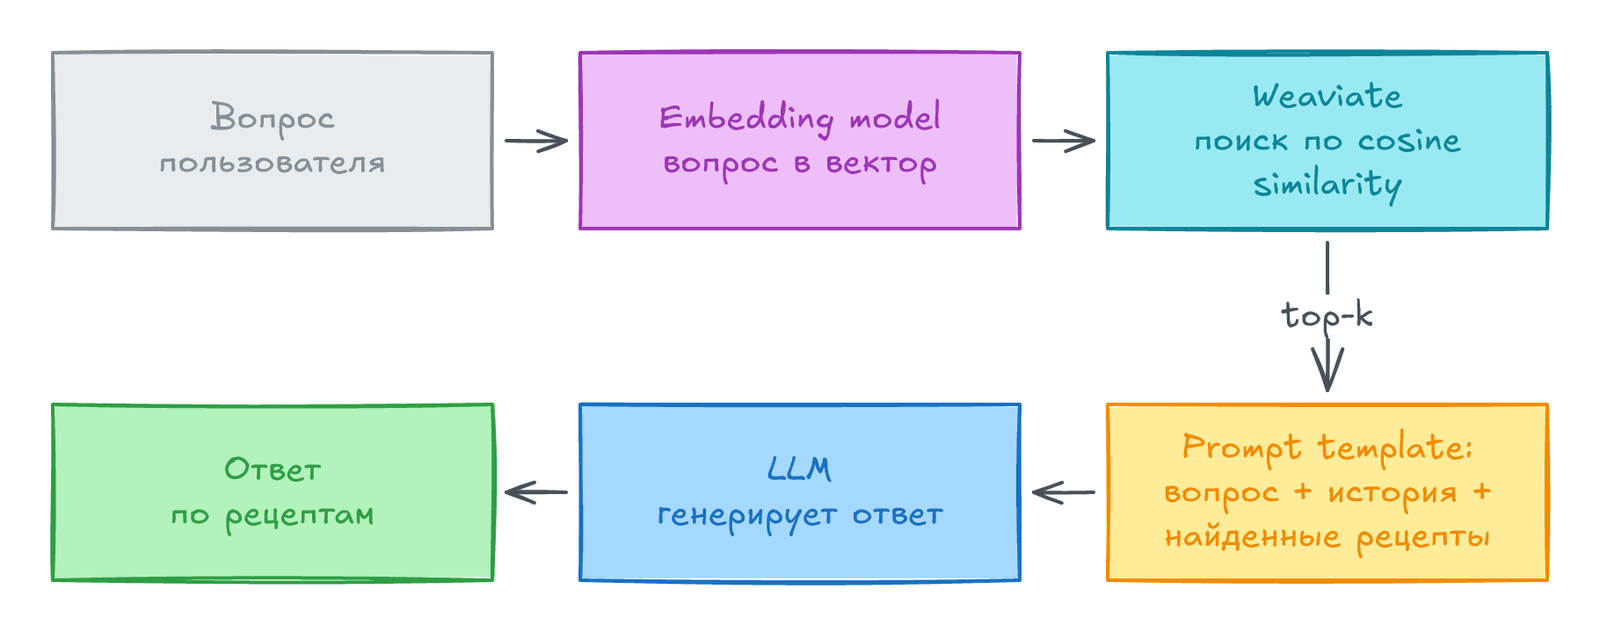
- Пользователь задаёт вопрос.
- Embedding model превращает вопрос в вектор (набор чисел).
- Векторная база ищет самые близкие по смыслу куски.
- Вопрос и найденные куски собирают в prompt.
- LLM отвечает на основе этого контекста.
Идея vector space простая. Каждому тексту соответствует точка. Похожие по смыслу тексты лежат рядом. Книга показывает это на примере с двумя осями: острое или мягкое, сладкое или солёное. В реальности у text-embedding-3-large около 3 тысяч измерений. Они не про вкус, а про смысл.
Близость считают как cosine similarity. Важно направление вектора, а не точные значения. Одинаковое направление даёт 1.
Сервисы проекта
Заголовок раздела «Сервисы проекта»| Сервис | Роль |
|---|---|
| MinIO | Хранилище файлов. Сюда попадают рецепты в JSON |
| Weaviate | Открытая векторная база |
vectorflow | Свой Python-пакет с CLI для шагов обработки |
recipe_vault | Приложение на Streamlit: загрузка рецептов и чат |
| Airflow | Оркестрация загрузки данных |
Всё поднимается через Docker Compose, как и в главе 13.
DAG загрузки данных
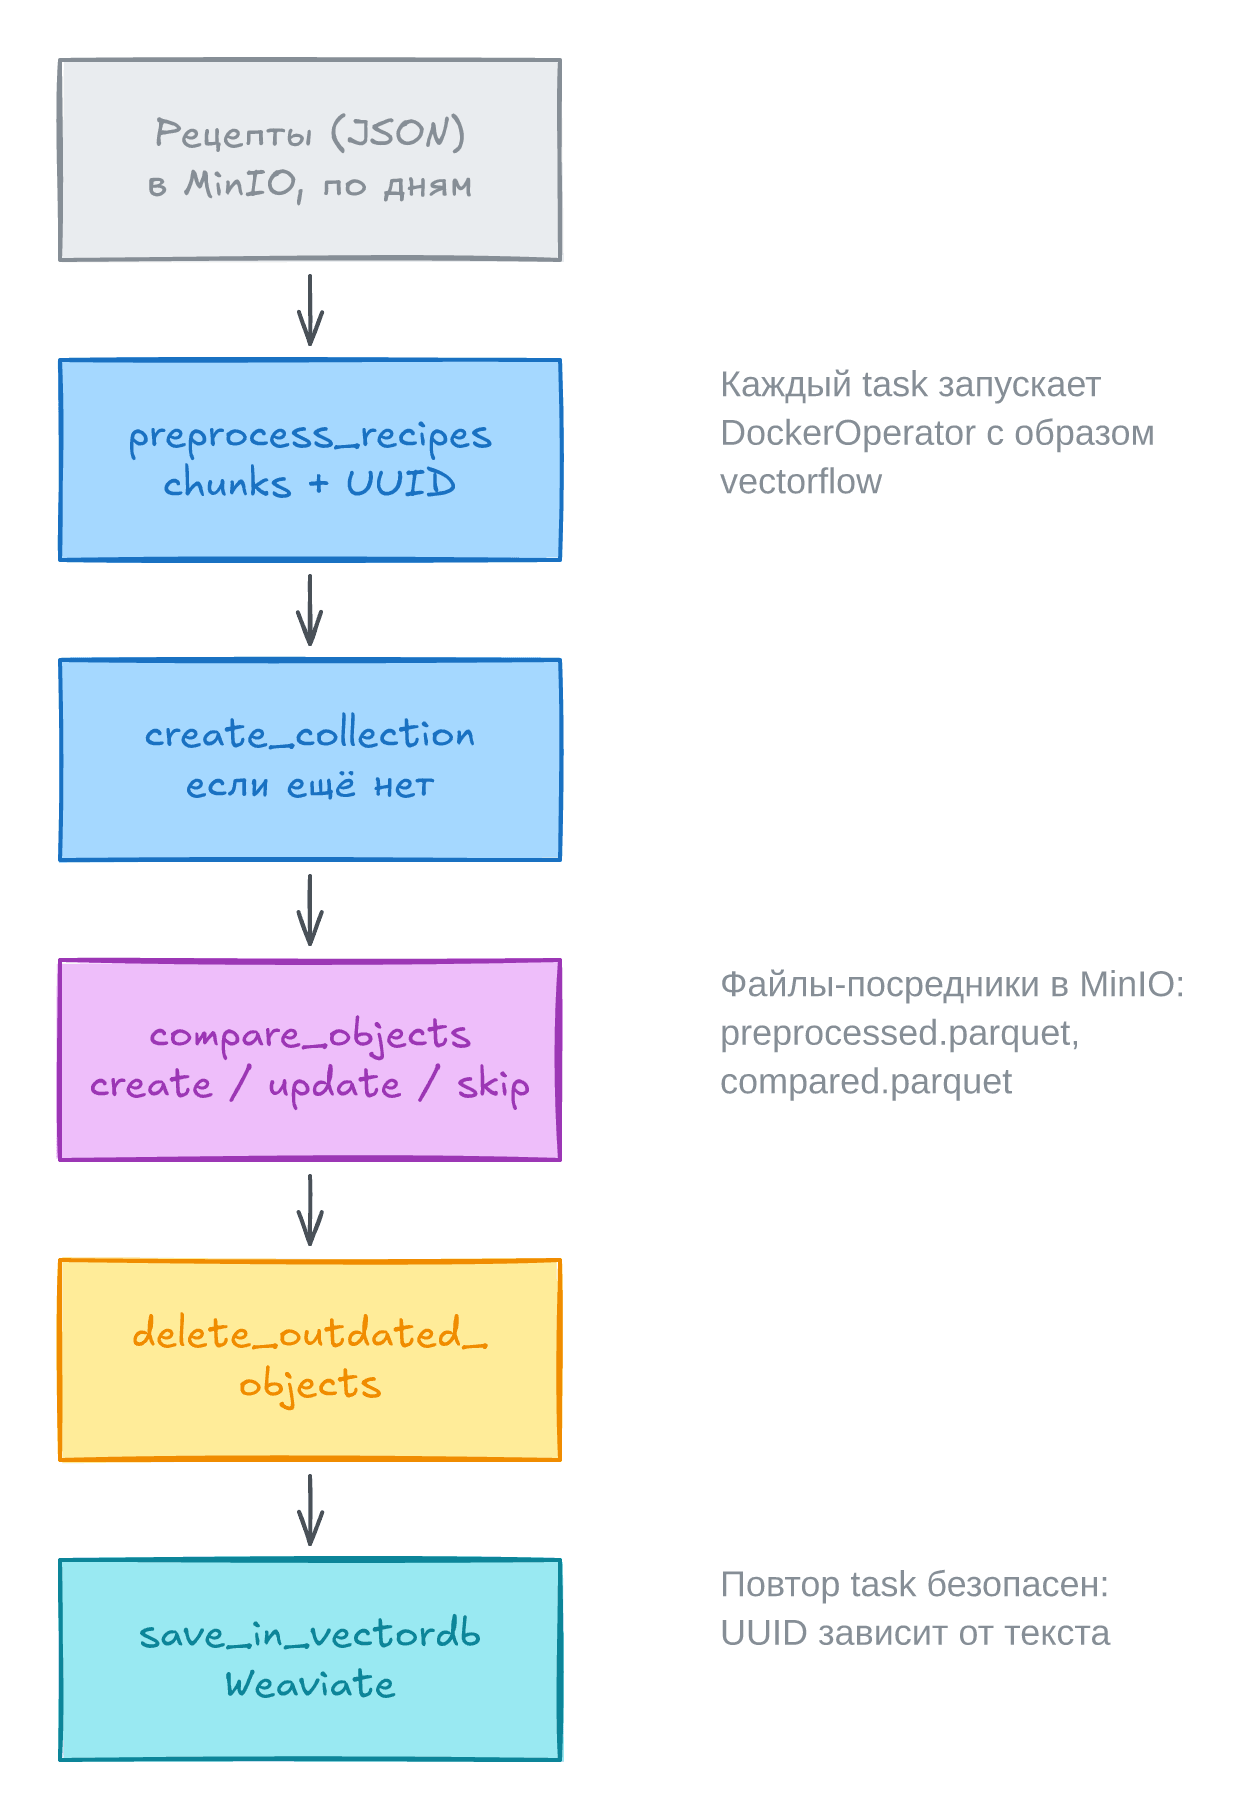
Заголовок раздела «DAG загрузки данных»Все tasks запускают один образ через DockerOperator. Внутри образа CLI с командами preprocess, create, compare, save. Airflow только оркеструет, тяжёлая работа идёт в контейнере.
Общие параметры оператора собраны в словарь и передаются как **docker_kwargs. Так код не дублируется. Основные параметры:
image: образ контейнера.environment: переменные окружения (доступ к MinIO, Weaviate, OpenAI).docker_url: адрес Docker daemon. В проекте это socket proxy, так безопаснее.network_mode: сеть, где видны все сервисы.auto_remove: удалять контейнер после успеха.
Расписание: ежедневно. Дата в пути MinIO задаётся шаблоном data_interval_start. Для старых дат запускают backfill.
Шаг 1. preprocess_recipes
Заголовок раздела «Шаг 1. preprocess_recipes»- Читает JSON за день из MinIO.
- Делит каждый рецепт на два chunk: ингредиенты и инструкции. В каждый кладёт название рецепта.
- Для каждого
recipe_nameиchunkсчитает UUID функциейgenerate_uuid5. - Сохраняет один
DataFrameвpreprocessed.parquet.
Про размер chunk. Если взять весь рецепт целиком или целую книгу, трудно понять источник. Если резать на предложения, на один вопрос вернётся много кусков одного рецепта. Книга выбирает середину: два chunk на рецепт.
UUID строится из текста. Тот же текст даёт тот же UUID. Любая правка, даже в одной цифре, даёт новый UUID. Это нужно для проверки на дубли.
Шаг 2. create_collection
Заголовок раздела «Шаг 2. create_collection»Collection в Weaviate похожа на таблицу. Для неё задают:
- имя (
recipes); vectorizer_config: какая embedding model и как подключиться (OpenAI API или Azure OpenAI);properties: поляrecipe_uuid,recipe_name,chunk_uuid,chunk. UUID-поля не векторизуются.
Task сначала проверяет, есть ли коллекция. Если есть, он ничего не делает. Поэтому его безопасно запускать каждый день.
Шаг 3. compare_objects
Заголовок раздела «Шаг 3. compare_objects»Task сравнивает UUID из файла с UUID в базе. Для каждой записи три случая:
| Случай | Действие |
|---|---|
| Рецепта нет в базе | Пометка create |
| Рецепт есть, но chunk UUID другие | Пометка update |
| Всё совпало | Запись удаляется из DataFrame |
Результат лежит в compared.parquet. Стратегия подходит для этого проекта. В других проектах (например, с несколькими пользователями) правила обновления будут другими.
Шаги 4 и 5. delete и save
Заголовок раздела «Шаги 4 и 5. delete и save»delete_outdated_objectsудаляет из базы chunk с пометкойupdate(методdelete_many).save_in_vectordbпишет новые и обновлённые записи пакетами. Векторы считаются автоматически по настройкам коллекции.- При ошибке записи поднимается
ValueError, task падает. Исправьте причину и перезапустите task.
Запрос: retrieval и prompt
Заголовок раздела «Запрос: retrieval и prompt»- Weaviate сам векторизует вопрос тем же embedding model и ищет близкие chunks.
- Prompt template (в книге на LangChain) задаёт правила. Отвечать только по найденному контексту. Если ответа нет, сказать об этом. Формат ответа единый.
- В prompt три параметра: вопрос, история чата, контекст.
- Если нужного рецепта нет, ассистент так и говорит. Он может предложить похожие из базы.
Пример кода
Заголовок раздела «Пример кода»Проверено на Airflow 3.4: DAG загружается, функция chunk_id проверена в pytest. Для запуска DAG нужен Docker.
Как задают общие параметры для нескольких DockerOperator (имена и образ придуманы для примера):
import pendulumfrom airflow.providers.docker.operators.docker import DockerOperatorfrom airflow.sdk import DAG
COMMON = {    "image": "my_pipeline_cli:latest",    "docker_url": "tcp://docker-socket-proxy:2375",    "auto_remove": "success",}
with DAG(    dag_id="notes_ingestion",    schedule="@daily",    start_date=pendulum.datetime(2026, 1, 1, tz="UTC"),) as dag:    split = DockerOperator(        task_id="split_notes",        command=["split", "s3://data/{{ data_interval_start | ds }}"],        **COMMON,    )    load = DockerOperator(        task_id="load_to_vector_db",        command=["load", "notes"],        **COMMON,    )    split >> load
Идея UUID по содержимому в виде функции. Здесь uuid5 из стандартной библиотеки:
import uuid

def chunk_id(text: str) -> str:    """Same text gives the same id; any edit gives a new id."""    return str(uuid.uuid5(uuid.NAMESPACE_URL, text.strip()))
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| GenAI / LLM | Генеративный ИИ. Большая языковая модель |
| Fine-tuning | Дообучение модели на своих данных |
| RAG | Поиск нужных документов и передача их LLM как контекста |
| Embedding model | Модель, которая превращает текст в вектор |
| Vector database | База, которая хранит векторы и ищет по близости |
| Cosine similarity | Мера близости по направлению векторов |
| Chunk | Небольшой кусок текста для векторизации |
| Collection | Аналог таблицы в Weaviate |
| UUID по содержимому | Ключ, который зависит от текста. Нужен для проверки на дубли |
| Prompt template | Шаблон инструкций для LLM |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Airflow в GenAI-проектах отвечает за данные: сбор, очистку, chunking, embeddings, обновление базы. Качество ответов зависит от качества этих данных.
- Делайте обновление идемпотентным. UUID по содержимому и шаг compare не дают плодить дубли.
- Храните промежуточные результаты (
preprocessed,compared) в Parquet. Падение одного task не ломает остальные, и его можно повторить. - Тяжёлый код запускайте в контейнерах через
DockerOperator. Общие параметры собирайте в один словарь. - Размер chunk влияет на точность поиска. Выбирайте его под данные и проверяйте на вопросах.
- Секреты (ключи OpenAI) передавайте через переменные окружения или connections. Не пишите их в код DAG.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Назовите проблемы fine-tuning. Как RAG решает их?
- Чем плохи слишком большие и слишком маленькие chunks?
- Как UUID по содержимому помогает отличить новый рецепт от изменённого?
- Почему task
create_collectionможно запускать каждый день?
Предыдущая: Проект: транспорт NYC. Следующая: Airflow в production.