

Data Pipelines with Apache Airflow, глава 3: Расписания по времени
Главная мысль: расписание Airflow задают через start_date, schedule, end_date и catchup. Для инкрементальной загрузки нужны data interval. А чтобы повторные запуски были безопасны, task должна быть атомарной и идемпотентной.
Пример: события пользователей
Заголовок раздела «Пример: события пользователей»На сайте есть сервис, который пишет, какие страницы открывали пользователи. API отдаёт события только за последние 7 дней (в примере внешний сервис хранит 30 дней). Нужна история дольше, поэтому мы сами сохраняем данные.
DAG из двух tasks:
fetch_eventsскачивает JSON черезcurl(BashOperator).calculate_statsсчитает статистику через pandasgroupby(PythonOperator).
Первая версия не имеет расписания (schedule=None). Дальше мы делаем её регулярной и инкрементальной.
Четыре параметра расписания
Заголовок раздела «Четыре параметра расписания»| Параметр | Что значит |
|---|---|
start_date | Начало окна, в котором DAG может запускаться. Обязателен |
end_date | Конец окна. Не обязателен. Без него DAG работает бесконечно |
schedule | Как часто запускать. Обязателен. None значит только ручной запуск |
catchup | Запускать ли пропущенные интервалы из прошлого |
catchup=False значит, что Airflow смотрит только вперёд, с момента включения DAG. catchup=True значит, что он создаст runs и за прошлое, начиная со start_date.
Что изменилось в Airflow 3
Заголовок раздела «Что изменилось в Airflow 3»Это самое важное предупреждение главы.
| Airflow 2 | Airflow 3 | |
|---|---|---|
Строка "@daily" или cron в schedule | Interval-based (data interval) | Trigger-based |
catchup по умолчанию | True | False |
- Чтобы не путаться, указывайте timetable класс явно:
CronTriggerTimetableилиCronDataIntervalTimetable. - Всегда задавайте
catchupявно. - Дефолт можно сменить настройкой
scheduler.catchup_by_default.
Trigger-based расписания
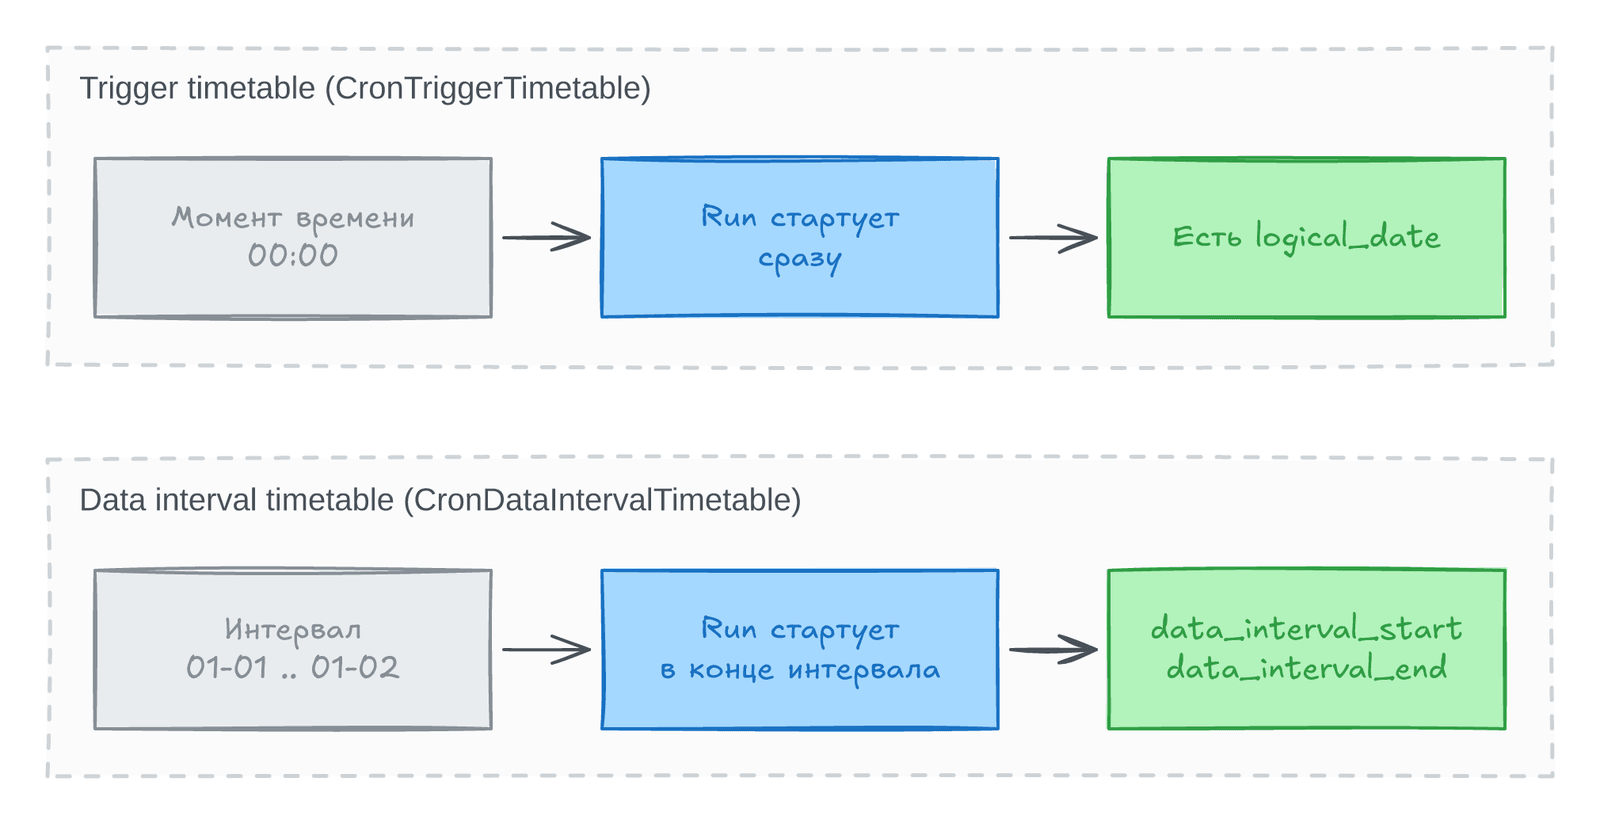
Заголовок раздела «Trigger-based расписания»Trigger timetable определяет точки во времени. Когда точка прошла, Airflow сразу создаёт run. Это работает как cron.
- Run получает
logical_date: время, за которое он запущен. - Интервала данных нет. Task сама решает, какие данные брать.
Способы описать расписание
Заголовок раздела «Способы описать расписание»| Способ | Пример | Комментарий |
|---|---|---|
| Cron | CronTriggerTimetable("0 0 * * *", timezone="UTC") | Пять полей: минута, час, день месяца, месяц, день недели |
| Preset | @hourly, @daily, @weekly, @monthly, @quarterly, @yearly | Короткие имена для частых cron |
| Frequency | DeltaTriggerTimetable(pendulum.duration(days=2)) | Для «раз в два дня», что cron не умеет |
Cron stateless: он сверяет шаблон с текущим временем. Поэтому «каждые 2 дня» через cron ломается на границе месяца. Frequency помнит прошлый запуск.
Примеры: 0 * * * * это каждый час. 0 0 * * MON-FRI это по будням в полночь.
Совет: проверяйте cron на crontab.guru и пишите комментарий к сложным выражениям.
Шаблоны в командах
Заголовок раздела «Шаблоны в командах»Чтобы не перезаписывать один файл, имя файла строят из даты: {{ logical_date | ds }}. Это Jinja-шаблон. Подробнее в главе 5.
Но у trigger-подхода остаются минусы. Мы не контролируем диапазон событий, и статистика получается не строго дневной.
Data interval: инкрементальная обработка
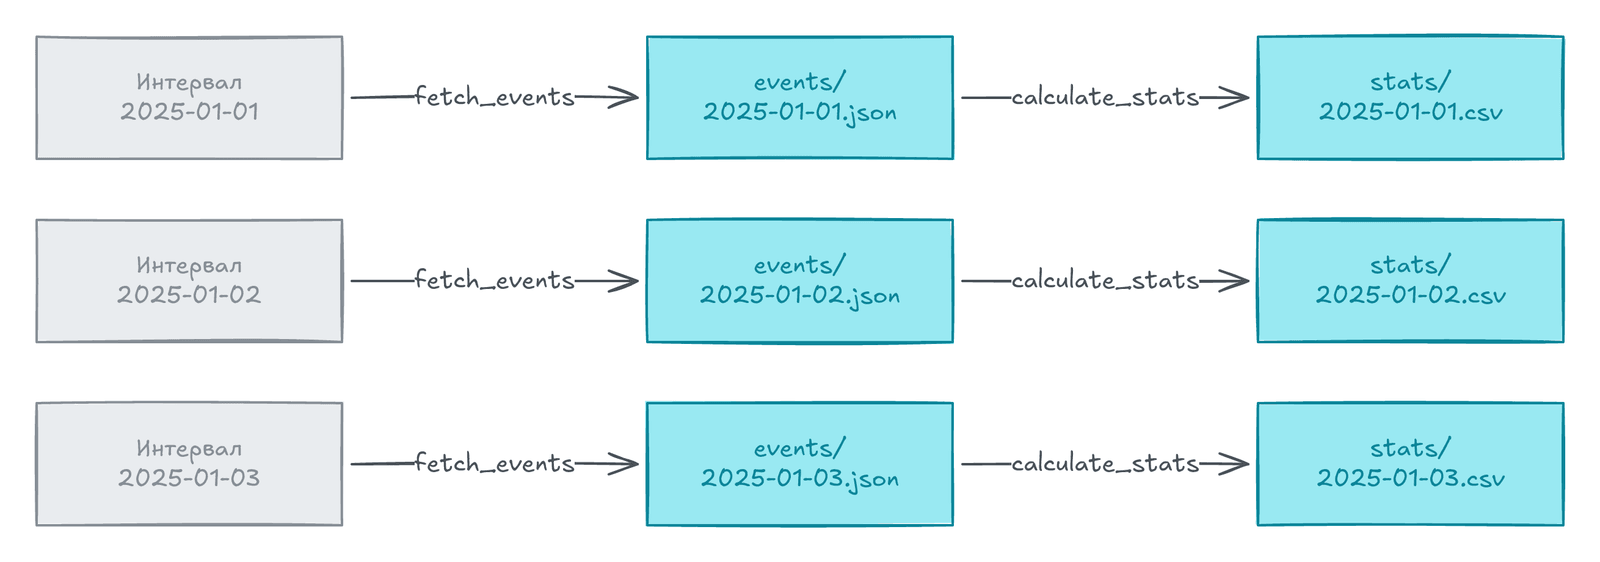
Заголовок раздела «Data interval: инкрементальная обработка»Идея: делить время на интервалы и обрабатывать данные только за свой интервал.
Плюсы:
- Каждый run обрабатывает малую часть данных.
- Нет дубликатов между файлами.
- Файлы по дням (partitions) копятся дольше лимита API.
Data interval timetable задаёт отрезок времени, а не точку:
CronDataIntervalTimetableдля cron и preset.DeltaIntervalTimetableдля frequency.
Что меняется:
- Run стартует в конце интервала. Данные за него уже есть.
- В контексте появляются
data_interval_startиdata_interval_end. logical_dateобычно указывает на начало интервала.
Пример: дневной интервал 2024-01-01. Run запустится сразу после его конца, около 2024-01-02 00:00. Начало интервала 2024-01-01, конец 2024-01-02. Начало включено, конец нет.
| Trigger | Data interval | |
|---|---|---|
| Когда стартует run | В момент точки | В конце интервала |
Есть data_interval_start/end | Нет | Да |
| Для чего | Действие по времени | Инкрементальная загрузка |
Нерегулярные события
Заголовок раздела «Нерегулярные события»Если события идут не по ритму (праздники, матчи, выборы), используйте EventsTimetable со списком дат.
- Список должен быть конечным и небольшим. Длинный список замедляет загрузку DAG.
- Ведёт себя как trigger: есть
logical_date, но нет data interval. - Для инкремента придётся считать смещения самим.
- Флаг
restrict_to_events=Trueограничивает ручные запуски. Они берут ближайшую подходящую дату из списка.
Backfilling
Заголовок раздела «Backfilling»Backfilling это запуск DAG за прошлые интервалы. Лучше всего он работает с data interval.
Для чего нужен:
- Загрузить историю, когда создаёте новый dataset.
- Пересчитать данные, когда изменили код или нашли ошибки. Сделайте
clearстарых runs.
Ограничения:
- Источник должен хранить данные. API с окном 7 дней не даст загрузить старше.
- Старые партиции в вашем хранилище при этом уже есть. Их можно пересчитать без API.
- Backfill может создать сотни параллельных runs. Это нагрузит Airflow и внешние системы.
Как ограничить нагрузку:
| Параметр | Что делает |
|---|---|
max_active_runs | Максимум одновременных runs одного DAG (по умолчанию 16) |
max_active_tasks | Максимум одновременных tasks одного DAG (по умолчанию 16) |
pools | Лимит по ресурсу, глава 12 |
В Airflow 2 max_active_tasks назывался concurrency.
Атомарность
Заголовок раздела «Атомарность»Task должна либо успешно дать результат, либо упасть, не меняя состояние системы.
- Плохо: одна функция пишет CSV, а потом шлёт письмо. Письмо не ушло, task failed, но CSV уже записан.
- Хорошо: разделить на
calculate_statsиsend_stats. Каждая либо делает всё, либо ничего. - Но не дробите всё подряд. Если для запроса нужен токен, получение токена и запрос лучше оставить в одной task. Они тесно связаны.
- Готовые operators обычно атомарны. С
PythonOperatorиBashOperatorоб этом думаете вы.
Идемпотентность
Заголовок раздела «Идемпотентность»Task идемпотентна, если повторный запуск с теми же входами не меняет результат.
- Хорошо: файл
events/{{ logical_date | ds }}.jsonперезаписывается. Повтор даёт тот же файл. - Плохо: дописывать события в один общий
events.json. Каждый повтор создаёт дубли. - Для файлов по партициям: перезаписывайте свою партицию.
- Для баз: используйте upsert.
Именно идемпотентность делает безопасным clear и backfilling.
Пример кода
Заголовок раздела «Пример кода»Проверено на Airflow 3.4: DAG проходит airflow dags test.
Имена придуманы для примера.
import pendulumfrom airflow.providers.standard.operators.bash import BashOperatorfrom airflow.sdk import DAGfrom airflow.timetables.interval import CronDataIntervalTimetable
with DAG(    dag_id="demo_daily_clicks",    start_date=pendulum.datetime(2025, 1, 1, tz="UTC"),    schedule=CronDataIntervalTimetable("0 0 * * *", timezone="UTC"),    catchup=True,    max_active_runs=2,):    BashOperator(        task_id="load_day",        bash_command=(            "echo {{ data_interval_start | ds }} {{ data_interval_end | ds }}"        ),    )
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
start_date / end_date | Границы окна, где DAG может запускаться |
schedule | Правило запуска: timetable, cron, preset или None |
catchup | Запускать ли пропущенные интервалы из прошлого |
CronTriggerTimetable | Trigger-расписание по cron |
DeltaTriggerTimetable | Trigger-расписание по частоте |
CronDataIntervalTimetable | Data interval по cron |
DeltaIntervalTimetable | Data interval по частоте |
EventsTimetable | Запуск по списку дат |
logical_date | Время, за которое запущен run |
data_interval_start/end | Границы интервала данных run |
Partition | Кусок набора данных, обычно по дате |
Atomicity | Всё или ничего |
Idempotency | Повтор с теми же входами не меняет результат |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Задавайте
catchupявно в каждом DAG. Не полагайтесь на дефолт Airflow 2 или 3. - Для загрузки в
warehouseпо дням берите data interval и пишите в партицию своего интервала. - Делайте
INSERTчерез перезапись партиции илиMERGE. Тогдаclearи backfill не создают дубли. - Перед backfill на большой период проверьте
max_active_runsи pools. Иначе вы перегрузите источник. - Для миграции с Airflow 2 на 3 проверьте все строки
scheduleи значениеcatchup.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем trigger timetable отличается от data interval timetable? Когда стартует run в каждом случае?
- Что изменилось в Airflow 3 для
schedule="@daily"и дляcatchup? - Почему cron не умеет «каждые два дня» и что использовать вместо него?
- Приведите пример неатомарной и неидемпотентной task. Как исправить обе?
Предыдущая: Анатомия DAG. Следующая: Asset-aware scheduling.