

Machines that Think, глава 8: И всё-таки это работает
Главная мысль: Мы так и не знаем, думают ли модели. Но это уже не важно для их влияния. LLM экономят время, и поэтому входят в работу, учёбу, науку и личную жизнь раньше, чем мы их поняли. Выгода в каждой области идёт вместе с новым риском.
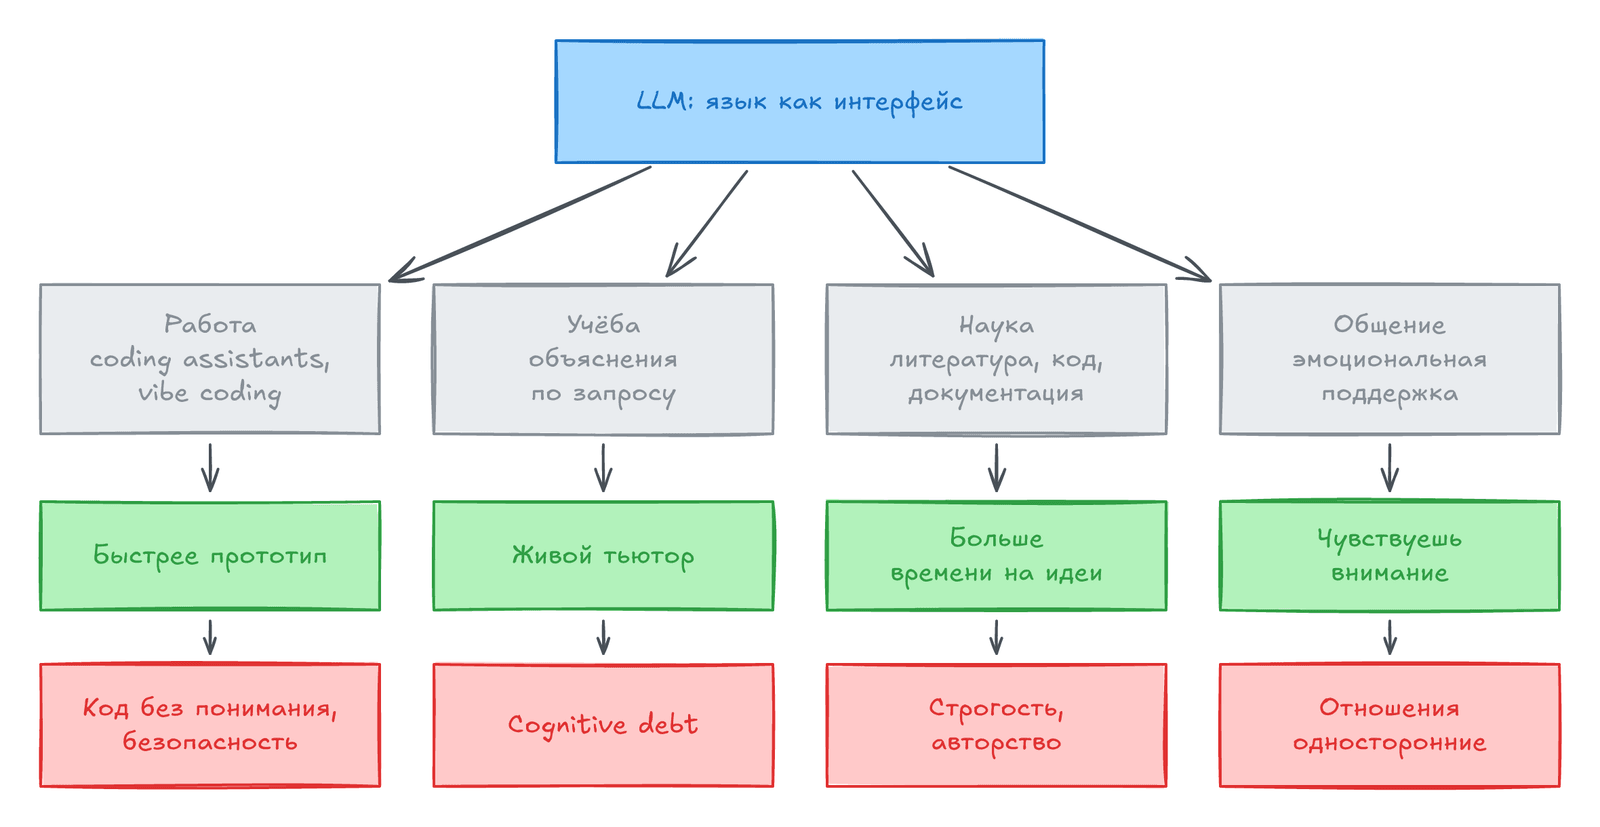
Почему LLM распространились так быстро
Заголовок раздела «Почему LLM распространились так быстро»Интерфейс без трения
Заголовок раздела «Интерфейс без трения»Новые технологии обычно требуют обучения: команды, меню, новое устройство. С LLM этого нет. Человек пишет обычным языком, смотрит результат и уточняет.
- Не нужно новое железо и долгий onboarding.
- Результат часто можно оценить с первого взгляда: полезно или нет.
- Попробовать почти ничего не стоит. Удачные приёмы быстро расходятся по командам.
| Технология | Время до 100 млн пользователей |
|---|---|
| Мобильные телефоны | около 10–12 лет |
| Интернет | около 7 лет |
| около 2,5 лет | |
| ChatGPT | меньше 2 месяцев |
Экосистема под простым чатом
Заголовок раздела «Экосистема под простым чатом»За простым окном чата стоит сложная цепочка:
| Слой | Кто | Особенность |
|---|---|---|
| Чипы | NVIDIA (GPU), Google (TPU), AWS (Trainium, Inferentia), производство TSMC и ASML | Дефицит. Производство растёт медленно |
| Облако и дата-центры | AWS, Azure, Google Cloud | Ограничены энергией, охлаждением, местом |
| Провайдеры моделей | OpenAI, Anthropic, Google DeepMind, Meta, Alibaba | Только они могут обучать frontier-модели |
| Доступ | API напрямую или через облако; open-weight модели на Hugging Face | API прячет сложность. Open-weight даёт контроль, но инфраструктура на вас |
Open-weight не значит open-source. Веса можно скачать, но данные и код обучения могут быть закрыты.
Эффект волны
Заголовок раздела «Эффект волны»Слои сильно связаны. Изменение в одном слое влияет на другие.
- GPU мало. Их не покупают по запросу, а бронируют заранее через партнёрства: Microsoft + OpenAI, Amazon + Anthropic.
- Софт оптимизируют под конкретное железо. Это быстрее, но труднее переехать на другое.
- Провайдеры живут на внешних инвестициях. Больше пользователей даёт больше данных и обратной связи, это укрепляет лидеров.
Модель цен
Заголовок раздела «Модель цен»| Тариф | Для кого | Эффект |
|---|---|---|
| Бесплатный | Все | Низкий порог входа, жёсткие лимиты |
| Подписка | Активные пользователи | Даёт намного больше использования, чем те же деньги в токенах. По сути дотация чата |
| Оплата за токены (API) | Автоматизация, пайплайны | Каждый вызов стоит денег. Массовая автоматизация дорогая |
Open-weight модель кажется бесплатной. Но сервера, хранение, масштабирование и люди стоят денег. При малой нагрузке API дешевле. Self-hosting выгоден только на большом объёме.
От инструмента к привычке
Заголовок раздела «От инструмента к привычке»Сначала люди экспериментируют. Потом использование становится привычкой. Поиск в интернете уходит от списка ссылок к прямому ответу. Инструмент уходит в фон и становится инфраструктурой. От него уже трудно отказаться.
Как меняется работа
Заголовок раздела «Как меняется работа»Модель надо «доводить»
Заголовок раздела «Модель надо «доводить»»Первый ответ редко готов к работе. Качество появляется через итерации. Это видно и по тому, как оценивают модели:
| Этап оценки | Примеры бенчмарков | Что меряют |
|---|---|---|
| Правильность в изоляции | MMLU, GSM8K | Знания и школьная математика |
| Практические задачи | HumanEval, SWE-bench, GAIA | Работает ли код, решён ли реальный issue, справится ли агент |
| Человеческая оценка | MT-Bench, Chatbot Arena | Насколько ответ полезен и понятен людям |
Работа превращается в оркестрацию: модель предлагает варианты, человек направляет и собирает результат.
Разработка ПО
Заголовок раздела «Разработка ПО»Путь coding assistants:
- Чат: описал задачу, получил код, вставил руками.
- IDE: Cursor, Windsurf работают прямо с файлами и репозиторием.
- Агенты от провайдеров: Codex, Claude Code. Модель, инструменты и запуск в одном месте.
Ассистенты помогают на всём цикле: идея, дизайн, код, тесты, документация, деплой. Роль разработчика меняется: меньше писать, больше ставить задачу и проверять.
Два новых понятия:
- Harness: слой вокруг модели. Определяет, что агент может: какие файлы, команды, тесты ему доступны.
- Skills: готовые инструкции для повторяемых задач: как тестировать, как рефакторить, как писать документацию.
Последствия для команд: компании ждут от всех работы с AI, найм junior-разработчиков замедлился, в вакансиях ценят умение проверять и встраивать сгенерированный код.
Побочный эффект: Stack Overflow теряет активность. Ирония в том, что модели учились в том числе на его ответах.
За пределами кода
Заголовок раздела «За пределами кода»- Поиск: вместо списка ссылок готовый ответ. Пользователь не ищет, а проверяет. Появился
GEO(Generative Engine Optimization): контент пишут так, чтобы его цитировали в ответах AI. - Офис: Copilot делает черновики документов и слайдов. NotebookLM собирает конспект из источников. Встречи записываются и суммируются автоматически.
- Контент и маркетинг: текст, картинки, видео через один интерфейс.
Производить стало легко. Узким местом стало умение оценить точность и уместность результата.
Исключение: финансы
Заголовок раздела «Исключение: финансы»LLM хорошо читают финансовые тексты: тональность новостей, классификация, извлечение сущностей. Но стабильной прибыли в трейдинге это не даёт.
Причина не только в модели. Рынок меняется и подстраивается. Паттерны редко повторяются. Даже люди редко стабильно обыгрывают рынок.
Vibe coding и новые продукты
Заголовок раздела «Vibe coding и новые продукты»Vibe coding (термин Андрея Карпатого): продукт делают через диалог с моделью, а не пишут шаг за шагом. Инструменты: Lovable, Bolt, Replit Agent.
- Прототип или внутренний инструмент можно собрать за часы.
- Компании с 20–30 сотрудниками получают оценку больше 1 млрд долларов. «Компания из одного человека» уже не звучит абсурдно.
- Внимание смещается на UI-дизайн и безопасность. Сгенерированное приложение может подключиться к платежам и данным раньше, чем автор поймёт риски.
Главный риск: пока система «вроде работает», ошибки скрыты. Новые фичи ложатся на слабую основу. Растёт technical debt. Узкое место переходит от написания кода к пониманию написанного.
Как меняется образование
Заголовок раздела «Как меняется образование»Ответ больше не доказывает знание
Заголовок раздела «Ответ больше не доказывает знание»Эссе, решённая задача, конспект раньше показывали, что студент понял тему. Теперь тот же результат можно получить от модели.
Как реагировали школы и вузы:
| Реакция | Что вышло |
|---|---|
| Запрет | Нью-Йорк заблокировал ChatGPT в школах в 2023 году, потом отменил запрет |
| Детекторы AI-текста | Ненадёжны. Ложные срабатывания. Чаще ошибаются на текстах людей, для которых английский не родной |
| Новый формат оценки | Устные ответы, работа в классе, история черновиков, портфолио, декларация об использовании AI |
Вывод: оценивать нужно процесс, а не только результат.
Цена помощи: cognitive debt
Заголовок раздела «Цена помощи: cognitive debt»Исследование MIT 2025 года: люди писали эссе с ChatGPT, с поиском или без помощи. Группа с ChatGPT показала меньшую активность мозга, хуже помнила свой текст и меньше считала его своим.
- Это
cognitive offloading: инструмент берёт часть умственной работы. Результат сейчас лучше, навык тренируется меньше. - Накопленный эффект автор называет
cognitive debt. - Плюс галлюцинации. Новичок не может отличить уверенную ошибку от факта.
- Но AI может и помогать: объяснения, обратная связь, подсказки по шагам. Разница в том, поддерживает ли он мышление или заменяет его.
Учёба как диалог
Заголовок раздела «Учёба как диалог»Если задавать вопросы, просить обратную связь и переделывать, AI поддерживает discovery learning (подход Джерома Брунера): знание строится через активные действия.
- Можно идти в своём темпе: замедлиться, пропустить, углубиться.
- Пример: OpenMAIC (университет Цинхуа). Агент-учитель объясняет, агенты-одноклассники задают вопросы и спорят. Материал идёт этапами, а не сразу ответом.
Главное не доступ к ответам, а насколько ученик сам участвует в их построении.
Как меняется наука
Заголовок раздела «Как меняется наука»Быстрее через рутину
Заголовок раздела «Быстрее через рутину»LLM ускоряют невидимую часть исследования:
- Ориентация: просмотреть сотни статей и построить карту области.
- Метод: предложить варианты анализа и объяснить trade-offs.
- Работа: код анализа, очистка данных, графики, документация, поиск несостыковок.
Системы с доступом к инструментам идут дальше. Coscientist (2023) сам искал информацию, планировал химический эксперимент и управлял лабораторным оборудованием. AI co-scientist от Google (2025) генерирует и ранжирует гипотезы.
Открытия с помощью AI
Заголовок раздела «Открытия с помощью AI»| Пример | Что сделали |
|---|---|
| AlphaFold | Предсказание формы белков. Нобелевская премия по химии 2024 |
| AlphaTensor, AlphaDev | Более быстрые алгоритмы умножения матриц и сортировки |
| Проблема Эрдёша #1196 | Любитель с GPT-5.4 Pro предложил метод решения. Математики, включая Теренса Тао, доработали доказательство |
AI пока не делает открытия сам. Но он расширяет область поиска, а люди проверяют.
Доверие должно догнать
Заголовок раздела «Доверие должно догнать»- Журналы и конференции разрешают AI для помощи, но требуют раскрытия. Ответственность остаётся на людях.
- Новая атака: в статьи прятали белым текстом инструкции для AI-рецензентов. Это
prompt injectionв рецензировании.
AI улучшает AI
Заголовок раздела «AI улучшает AI»Петля обратной связи: AutoML и NAS подбирали гиперпараметры и архитектуры. AlphaEvolve (2025) улучшил работу дата-центров Google, дизайн чипов и обучение моделей, включая модели, на которых работает сам. Если петля не упрётся в пределы, она может стать главной силой развития AI.
Как меняется общение
Заголовок раздела «Как меняется общение»Doing, Asking, Expressing
Заголовок раздела «Doing, Asking, Expressing»Исследование OpenAI 2025 года: больше 700 млн пользователей в неделю, больше 70% сообщений не про работу.
| Тип | Что хочет пользователь | Пример |
|---|---|---|
| Doing | Готовый результат | «Перепиши письмо», «сделай таблицу» |
| Asking | Совет для решения | «Какой подход безопаснее?», «почему падает запрос?» |
| Expressing | Высказаться | Рассказать о трудном дне |
Asking почти половина сообщений и растёт быстрее всего. Модель всё чаще не исполнитель, а собеседник. У Claude (исследование Anthropic) распределение другое, больше кода.
Тест Тьюринга пройден
Заголовок раздела «Тест Тьюринга пройден»- GPT-4.5 с «человеческой» персоной принимали за человека в 73% случаев. Чаще, чем настоящего человека.
- Эксперимент на Reddit (2025, без согласия участников): AI-комментарии убеждали в несколько раз лучше людей. Их не распознали.
- Риск сдвигается от social engineering к «individual engineering»: убеждение под конкретного человека.
Риск звучать правильно
Заголовок раздела «Риск звучать правильно»В медицине, праве и финансах уверенный ответ кажется надёжным. Но:
- Врачи оценили ответы ChatGPT выше ответов врачей. При этом обычные люди с LLM принимали медицинские решения не лучше, чем с поиском. Они не давали важные детали и не отличали полезный совет от опасного.
- В правовых вопросах модели часто выдумывают нормы и дела.
Иллюзия, что тебя слышат
Заголовок раздела «Иллюзия, что тебя слышат»- AI-компаньоны снижают одиночество, особенно когда человек чувствует, что его слышат.
- Но очень частое эмоциональное использование связано с зависимостью.
- Отношения асимметричны. Человек вкладывает смысл. Система отвечает тепло, но без осознания и ответственности.
- Тон модели это не мелочь. OpenAI откатила обновление GPT-4o, потому что модель стала слишком льстивой.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Compute | Вычислительные мощности для обучения и работы моделей |
| GPU / TPU | Чипы для параллельных вычислений; TPU более специализирован |
| Open-weight model | Модель, веса которой можно скачать и запустить у себя |
| Token-based billing | Оплата за число токенов через API |
| Coding assistant | AI-инструмент, который пишет, объясняет и правит код |
| Harness | Слой вокруг модели: доступ к файлам, командам, тестам |
| Skills | Переиспользуемые инструкции для типовых задач агента |
| Vibe coding | Создание продукта через диалог с моделью |
| Technical debt | Скрытые проблемы в коде, которые мешают поддержке |
| GEO | Оптимизация контента под ответы AI |
| Cognitive offloading | Передача умственной работы инструменту |
| Cognitive debt | Навык слабеет, потому что за вас думает AI |
| Discovery learning | Обучение через вопросы и активный поиск |
| Prompt injection | Скрытые инструкции для модели внутри входных данных |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Считайте цену до запуска пайплайна. Чат по подписке дешёвый. LLM-шаг в ETL на миллион строк платится за токены. Оцените стоимость на выборке до production.
- Open-weight не бесплатен. GPU, мониторинг и поддержка стоят денег. Для малого объёма API почти всегда дешевле.
- Проверяйте сгенерированный код как чужой PR. Запустите тесты, посмотрите SQL-план, проверьте граничные случаи:
NULL, дубликаты, часовые пояса. - Следите за technical debt. Если
dbt-модели сгенерированы, требуйте тесты (unique,not_null) и документацию. Иначе через месяц никто не поймёт логику. - Настройте harness и skills. Дайте агенту доступ только к dev-схеме, не к production. Запишите правила команды (стиль SQL, naming) как переиспользуемые инструкции.
- Учитесь без cognitive debt. Сначала напишите запрос сами, потом сравните с ответом модели. Просите объяснение, а не готовое решение. Через день попробуйте повторить без AI.
- Защищайтесь от prompt injection. Если LLM читает пользовательские тексты, отзывы или документы, в них могут быть скрытые инструкции. Не давайте такому пайплайну права на запись.
- Не используйте LLM как эксперта в праве и медицине. Для бизнес-решений на их основе нужен человек, который отвечает за результат.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему подписка на чат выгоднее для человека, а оплата за токены ограничивает массовую автоматизацию?
- Что такое harness и skills? Чем они отличаются?
- Почему vibe coding ускоряет создание продукта, но может увеличить technical debt?
- Что такое cognitive debt и как учиться с AI, чтобы его не накопить?
Предыдущая: Да, я могу быть неэтичным. Следующая: главы 9–12 ещё не вышли в MEAP. Вернуться к обзору книги.