

Machines that Think, глава 3: Как устроены нейросети
Главная мысль: Нейросеть строится из простых частей: нейронов, весов и функций активации. Она учится на ошибках: считает loss, находит виноватые веса и чуть-чуть их правит. Архитектура задаёт, какие закономерности сеть может найти. Язык оказался самой трудной задачей. Решение пришло через attention.
Что такое нейрон
Заголовок раздела «Что такое нейрон»Искусственный нейрон: это не клетка мозга, а маленькая формула. Числа на входе, одно число на выходе.
| Часть | Что делает |
|---|---|
| Inputs | Вектор чисел. Каждое число описывает одну черту объекта |
| Weights | Сила каждого входа. Вход умножается на вес, всё складывается |
| Bias | Константа. Сдвигает результат вверх или вниз |
| Activation function | Нелинейная функция. Решает, пропустить сигнал, ослабить или погасить |
| Output | Одно число. Оно идёт на вход следующим нейронам |
Один нейрон умеет мало. Сила появляется, когда нейронов много и они работают вместе.
Слои и глубина
Заголовок раздела «Слои и глубина»- Input layer принимает данные. Output layer выдаёт ответ.
- Hidden layers лежат между ними. «Скрытые» значит только одно: они не общаются с внешним миром.
- Сеть с 1-2 скрытыми слоями называют shallow. Она различает простые случаи.
- Много слоёв дают deep network. Отсюда термин
deep learning. - Ранние слои ловят простые признаки (края на картинке). Поздние слои собирают из них сложные (форма, объект).
Пример: классификатор тикетов поддержки. На входе частота слов, длина текста, тип клиента. На выходе три класса: «баг», «вопрос по оплате», «другое».
Веса: где хранится знание
Заголовок раздела «Веса: где хранится знание»- Знание сети распределено по весам. Ни один вес не хранит понятие «кошка» или «сарказм».
- Понятия появляются из совместной работы миллионов (и миллиардов) весов.
- Это и сила, и проблема. Сеть ловит то, что человек не опишет руками. Но объяснить её решение трудно.
- Этим занимаются
explainable AIиmechanistic interpretability.
Зачем нужна нелинейность
Заголовок раздела «Зачем нужна нелинейность»Без функций активации сеть рисует только прямую границу между классами. Хуже того: десять линейных слоёв сводятся к одному. Умножить на 4, потом разделить на 2 — то же самое, что умножить на 2.
| Функция | Как ведёт себя | Где встречается |
|---|---|---|
sigmoid | Плавно от 0 до 1, похоже на вероятность | Старые классификаторы |
tanh | Как sigmoid, но вокруг нуля (от -1 до 1) | Ранние RNN |
ReLU | Отрицательное в 0, положительное как есть | Сделала deep learning практичным |
Swish | Как ReLU, но пропускает немного отрицательных | Популярна с 2019 |
softmax | Превращает список оценок в вероятности, сумма 1 | Последний слой при выборе класса |
С нелинейностью сеть может приблизить почти любую зависимость. Это доказано в теории. Но «может» не значит «обязательно выучит».
Путь данных от входа к выходу через все слои называют forward pass.
Как сеть учится
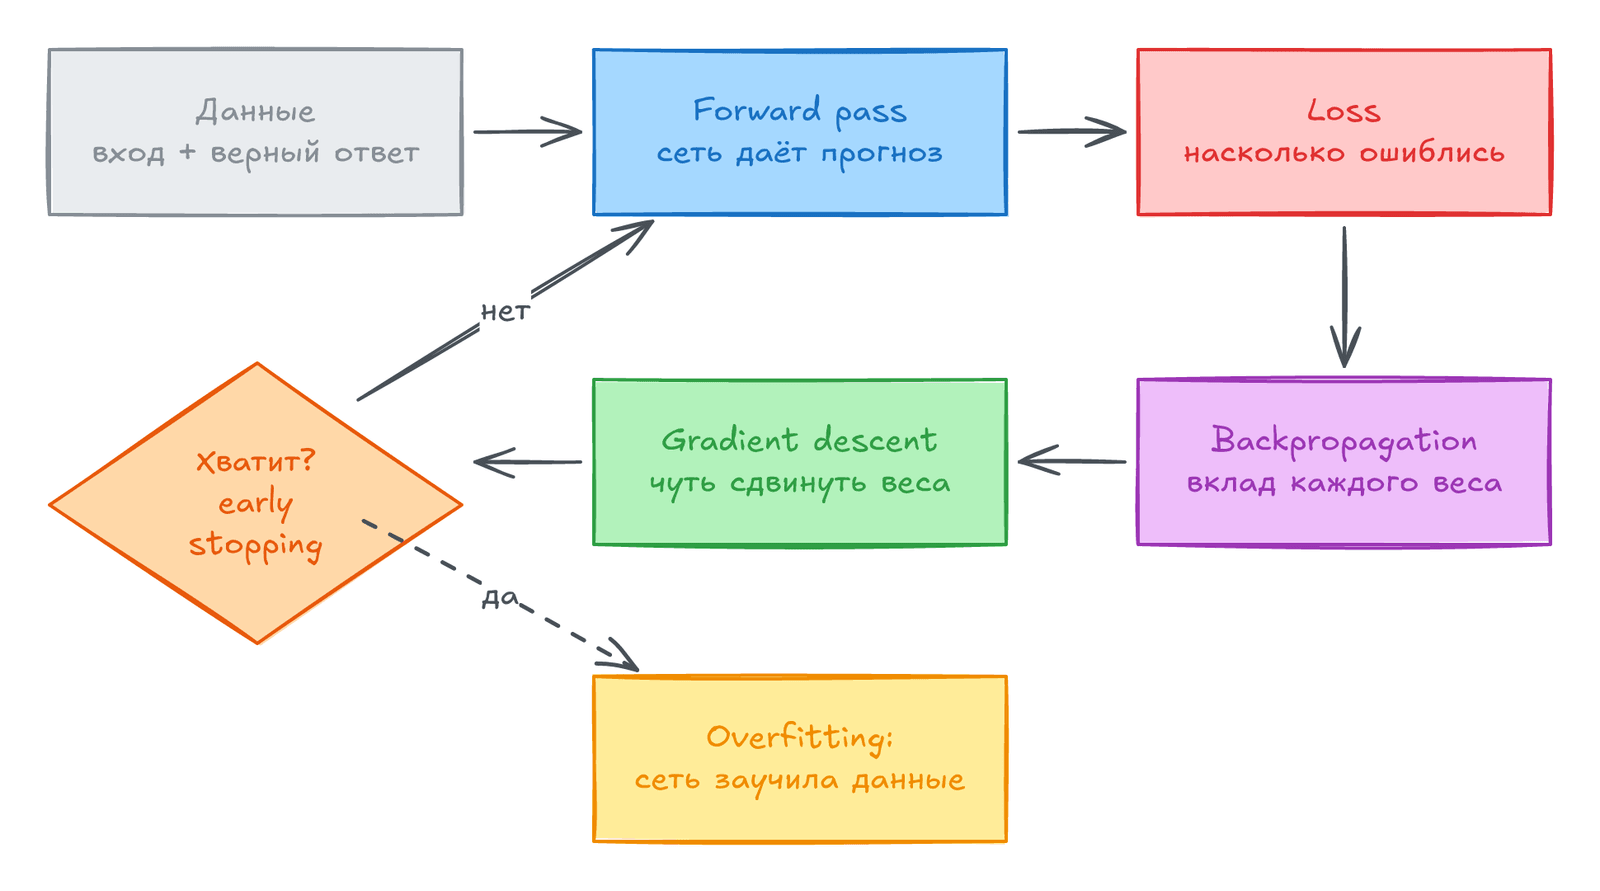
Заголовок раздела «Как сеть учится»Веса сначала случайные (initialization). Первые ответы — почти угадывание. Дальше цикл:
- Forward pass: сеть даёт прогноз.
- Loss: одно число, насколько прогноз далёк от правильного ответа.
- Backpropagation: идём назад по сети и для каждого веса считаем, как он повлиял на ошибку. Получаем
gradient. - Gradient descent: сдвигаем веса против градиента. Размер шага задаёт
learning rate.
Backpropagation сам веса не меняет. Он только показывает, кто виноват. Меняет оптимизатор. Производные считаются автоматически (autodiff).
Loss functions
Заголовок раздела «Loss functions»| Loss | Задача | Особенность |
|---|---|---|
| MSE | Регрессия (число) | Сильно наказывает большие ошибки |
| MAE | Регрессия | Спокойнее к выбросам |
| Cross-entropy | Классификация | Больно бьёт за уверенный неправильный ответ |
| Binary cross-entropy | Да/нет | Выход ведёт себя как вероятность |
| Hinge | Классификация | Требует запас между классами |
Learning rate и оптимизаторы
Заголовок раздела «Learning rate и оптимизаторы»- Шаг слишком маленький: обучение идёт очень долго или застревает в мелкой ямке.
- Шаг слишком большой: модель перескакивает хорошее решение и прыгает туда-сюда.
learning rate— этоhyperparameter. Его выбирает человек, а не данные.Momentumпомнит прошлое направление и сглаживает шум.Adamдобавляет к momentum адаптивный шаг: смело там, где сигнал ясный, осторожно там, где нет.
Batches и epochs
Заголовок раздела «Batches и epochs»- Сеть учится не на всём датасете сразу, а на маленьких группах —
batch. - Маленький batch: больше шума, больше исследования. Большой batch: стабильнее, но менее гибко.
- Один полный проход по данным —
epoch. Первые эпохи дают быстрый рост, поздние шлифуют.
Мини-пример: один нейрон, три шага
Заголовок раздела «Мини-пример: один нейрон, три шага»Нейрон оценивает, спам ли письмо. Запускается в python3 без библиотек.
import math
# Признаки письма: число ссылок, слово "скидка" (0/1), отправитель знаком (0/1)x = [3.0, 1.0, 0.0]y_true = 1.0          # это спам
w = [0.1, 0.2, -0.3]  # начальные весаb = 0.0lr = 0.5              # learning rate
def sigmoid(z):    return 1 / (1 + math.exp(-z))
for step in range(3):    # forward pass    z = sum(wi * xi for wi, xi in zip(w, x)) + b    y_pred = sigmoid(z)    loss = (y_pred - y_true) ** 2          # MSE для одного примера    # градиент (chain rule): dloss/dz    dz = 2 * (y_pred - y_true) * y_pred * (1 - y_pred)    # gradient descent: шаг против градиента    w = [wi - lr * dz * xi for wi, xi in zip(w, x)]    b = b - lr * dz    print(f"шаг {step}: y_pred={y_pred:.3f}, loss={loss:.4f}")
Результат:
шаг 0: y_pred=0.622, loss=0.1425шаг 1: y_pred=0.814, loss=0.0346шаг 2: y_pred=0.856, loss=0.0206С каждым шагом прогноз ближе к 1, loss меньше. Большая сеть делает то же самое, только с миллиардами весов.
Что на самом деле выучила сеть
Заголовок раздела «Что на самом деле выучила сеть»- Сеть знает только то, что уменьшает loss. Это не понимание задачи.
- Ей всё равно, правдивы ли данные. Ложные, но последовательные данные она выучит так же хорошо.
- Знание привязано к условиям обучения. Модель распознаёт лицо при одном свете и теряет его при другом.
Учиться не значит запоминать
Заголовок раздела «Учиться не значит запоминать»Цель обучения — generalization: правильно отвечать на новых данных. Если модель запомнила примеры, она хрупкая.
- Underfitting: модель слишком простая, не видит закономерность.
- Overfitting: модель запомнила шум. Пример: сеть решила, что корова — это зелёная трава на фоне.
Как бороться:
| Метод | Идея |
|---|---|
| Weight regularization | Штраф за большие веса. Модель становится проще и спокойнее |
| Dropout | На каждом шаге случайно выключаем часть нейронов. Сеть не может полагаться на один путь |
| Gradient clipping | Ограничиваем слишком большие шаги от странных примеров |
| Шум в обучении | Небольшие искажения входов или весов делают модель устойчивее |
| Validation set + early stopping | Держим часть данных отдельно. Останавливаемся, когда validation loss начинает расти |
| Data augmentation | Делаем варианты примеров: повернуть картинку, перефразировать текст |
Автор связывает переобучение с будущими галлюцинациями. Модель уверенно отвечает там, где у неё нет основы.
Абстракция как сжатие
Заголовок раздела «Абстракция как сжатие»- Модель сжимает много примеров в шаблоны «что обычно встречается вместе».
- Человек тоже ищет шаблоны, но опирается на знание о мире. Это помогает отсеять случайные связи.
- Поведение модели на новых данных — это продление шаблонов, а не понимание понятий.
- Часто этого хватает для работы. Но думает ли такая система, зависит от того, что мы называем интеллектом.
Одна идея, много архитектур
Заголовок раздела «Одна идея, много архитектур»Dense (fully connected) сеть соединяет каждый нейрон со всеми нейронами следующего слоя. Она гибкая, но не знает ничего о структуре данных. Картинка для неё — просто список чисел. Поэтому придумали архитектуры со встроенными допущениями.
| Архитектура | Для каких данных | Главная идея |
|---|---|---|
| Dense | Таблицы, общие задачи | Все связаны со всеми |
| CNN | Картинки (пространство) | Маленький фильтр скользит по картинке. Одни веса для всех мест. Pooling сжимает карту признаков |
| RNN | Последовательности (время) | Читает по шагу. Хранит hidden state как память |
| LSTM / GRU | Длинные последовательности | Gates решают, что помнить, что обновить, что забыть |
| Autoencoder | Поиск структуры | Encoder сжимает в latent space, decoder восстанавливает |
| VAE, GAN, diffusion | Генерация новых данных | GAN: генератор подделывает, дискриминатор ловит подделки |
Проблема простой RNN: сигнал при передаче шаг за шагом либо затухает, либо взрывается. Поэтому она плохо помнит далёкое.
Autoencoder полезен для поиска аномалий: что плохо восстанавливается, то необычно. Но если сеть слишком мощная, она просто копирует вход и ничего не учит.
Автор говорит: архитектура — это гипотеза о том, как должна течь информация.
Почему язык так труден
Заголовок раздела «Почему язык так труден»Смысл слова зависит от слов, которые могут стоять далеко. И смысл меняется, когда приходят новые слова.
| Подход | Сильная сторона | Слабость |
|---|---|---|
| RNN (с конца 1980-х) | Лучше n-грамм, видит контекст | Всё смешивается в одно состояние. Трудно вернуть старое |
| LSTM / GRU | Помнят дольше. Дали первый нейронный перевод (seq2seq) | Всё ещё по одному токену. Нет параллелизма |
| CNN для текста (Kim, 2014) | Быстро ловит локальные признаки: тональность, тему | Видит только маленькое окно |
| Attention (Bahdanau и др., 2014) | Модель сама смотрит назад на нужные слова | Стала основой transformer |
Идея attention: не тащить весь контекст в одном векторе, а обращаться к нему по запросу. Для каждого слова модель даёт веса всем другим словам и берёт больше от важных.
Вторая революция — pretraining и transfer learning. Сначала модель учится на огромном объёме сырого текста. Потом её дообучают под задачу на малом объёме размеченных данных. Одна модель вместо отдельной модели на каждую задачу.
Итог главы: transformer не улучшил RNN, а отказался от неё. Последовательную память заменил прямой доступ ко всему контексту. Об этом следующая глава.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
neuron | Формула: взвешенная сумма входов + bias + активация |
weights | Обучаемые числа. В них хранится знание сети |
activation function | Нелинейная функция. Без неё слои схлопываются в один |
forward pass | Проход данных от входа к выходу |
loss | Одно число: насколько ответ далёк от правильного |
backpropagation | Обратный проход: вклад каждого веса в ошибку |
gradient descent | Сдвиг весов против градиента |
learning rate | Размер шага. Hyperparameter |
batch, epoch | Группа примеров на один шаг; полный проход по данным |
overfitting | Модель запомнила шум и плохо работает на новых данных |
dropout | Случайное отключение нейронов при обучении |
early stopping | Остановка, когда validation loss начинает расти |
CNN, RNN, LSTM | Архитектуры для картинок, последовательностей, длинных последовательностей |
attention | Механизм выбора важных частей входа для текущего шага |
transfer learning | Общее обучение сначала, специализация потом |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Train / validation / test — это не формальность. Тот же принцип работает, когда вы оцениваете LLM на своих данных. Держите отдельный набор примеров, которые не попадали в промпты и примеры для few-shot.
- Модель выучит ваши ошибки. Если в данных для finetuning дубли, кривые метки или старые правила, модель воспроизведёт их уверенно. Чистка данных важнее числа эпох.
- Overfitting при finetuning реален. Маленький датасет + много эпох = модель повторяет ответы из обучения и ломается на новых. Следите за validation loss.
- Модель не знает, где кончаются её знания. На входе, которого не было в обучении (новая схема таблиц, внутренний жаргон), она всё равно ответит уверенно. Проверяйте ответы на краевых случаях.
- Autoencoder и простые сети всё ещё полезны: поиск аномалий в метриках пайплайна, сжатие признаков. Не каждая задача требует LLM.
- Веса не объяснить построчно. Если нужна объяснимость для аудита (кредит, медицина), простая модель иногда лучше.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему сеть из десяти слоёв без функций активации не сильнее одного слоя?
- Что делает backpropagation и чем он отличается от gradient descent?
- Модель отлично работает на training set и плохо на validation. Что случилось и какие три метода помогут?
- Почему RNN и CNN плохо справлялись с языком и что изменил attention?
Предыдущая: Теперь мы говорим. Следующая: Большие языковые модели.