

Data Pipelines with Apache Airflow, глава 8: Связь с внешними системами
Главная мысль: сила Airflow в том, что он соединяет другие системы. Operator - это тонкий слой над клиентом сервиса. Сложность обычно не в Airflow, а в настройке самой внешней системы. Тяжёлую работу выносите из Airflow.
Provider packages
Заголовок раздела «Provider packages»До этой главы книга использовала BashOperator и PythonOperator. Это базовые операторы. Для внешних систем нужны отдельные пакеты.
- Core-пакет
apache-airflowне содержит облачных операторов. - Каждая система имеет свой provider package. Он ставится через
pip. - Оператор принимает аргументы и внутри вызывает клиент:
boto3для AWS, Cloud SDK для GCP.
| Система | Пакет |
|---|---|
| AWS | apache-airflow-providers-amazon |
| GCP | apache-airflow-providers-google |
| Azure | apache-airflow-providers-microsoft-azure |
| PostgreSQL | apache-airflow-providers-postgres |
Пример: S3CopyObjectOperator копирует объект между bucket. Вы заполняете имена bucket и ключи. Внутри он вызывает copy_object() из boto3.
Use case 1: обучение ML-модели
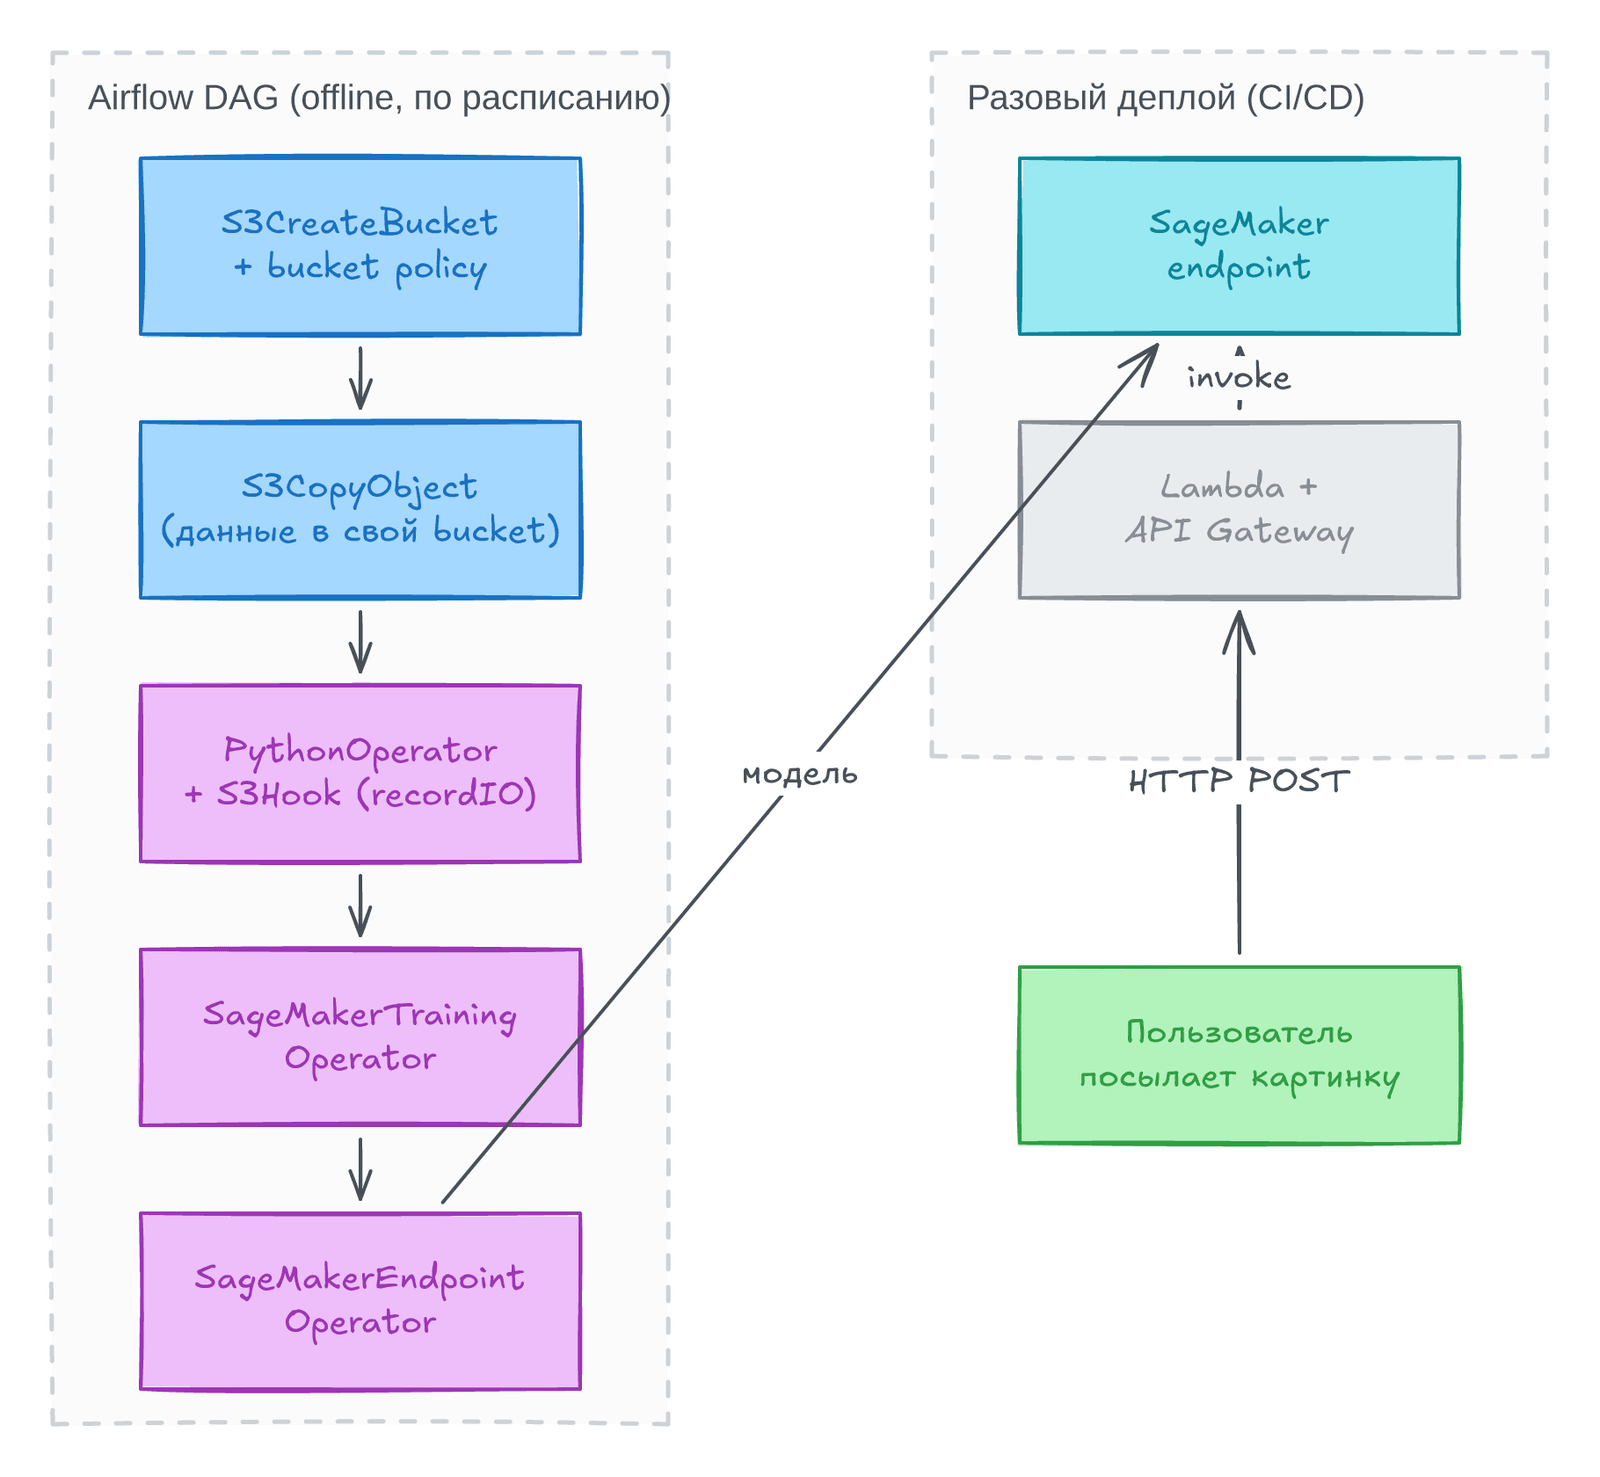
Заголовок раздела «Use case 1: обучение ML-модели»Книга строит pipeline для классификатора рукописных цифр (датасет MNIST) на AWS S3 и SageMaker.
Что делает Airflow, а что нет:
| Часть | Где живёт |
|---|---|
| Offline: загрузка данных, подготовка, обучение, деплой модели | Airflow, периодически |
| Online: API, который отвечает пользователю мгновенно | Отдельный деплой, обычно CI/CD |
API не нужно выкатывать каждую неделю. Поэтому Lambda и API Gateway в DAG не включают. Разовую инфраструктуру лучше деплоить через CI/CD.
Шаги DAG:
S3CreateBucketOperatorсоздаёт bucket.PythonOperatorставит bucket policy, чтобы SageMaker мог читать данные.S3CopyObjectOperatorкопирует публичный датасет в свой bucket.PythonOperatorсS3Hookпреобразует данные в формат recordIO.SageMakerTrainingOperatorобучает модель.SageMakerEndpointOperatorвыкладывает модель за HTTP endpoint.
Когда готового оператора нет, пишете функцию сами и вызываете через PythonOperator. Для S3 в ней используют S3Hook.
Два урока для любой внешней системы
Заголовок раздела «Два урока для любой внешней системы»- Уникальные имена. SageMaker требует уникальное имя training job. Фиксированное имя сломает второй запуск. Добавьте в имя
logical_dateчерез template. Тогда task идемпотентна. - Ждите завершения. С
wait_for_completion=Trueоператор опрашивает AWS черезcheck_interval. Task завершается, только когда завершилась работа в облаке. Без этого получится fire and forget: вы не узнаете, что job упала.
Данные в памяти
Заголовок раздела «Данные в памяти»Функция преобразования читает файл в io.BytesIO. После task на диске ничего не остаётся. Датасет маленький (15 МБ). Для больших данных используйте диск и читайте частями.
Локальная разработка: airflow tasks test
Заголовок раздела «Локальная разработка: airflow tasks test»Если с вашей машины есть доступ к облаку, можно запускать одну task из командной строки.
- Положите ключи в
~/.aws/credentialsи задайтеAWS_PROFILE. - Задайте
AIRFLOW_HOME. Папкаdagsищется внутри. Другой путь задают черезAIRFLOW__CORE__DAGS_FOLDER. - Выполните
airflow db init. Нужна база для логов. БезAIRFLOW__CORE__SQL_ALCHEMY_CONNсоздаётся локальный SQLite. - Запустите
airflow tasks test <dag_id> <task_id> <date>.
Что важно:
- Команда не пишет состояние в базу. Она только запускает task и показывает лог.
- Если task использует
{{ ds }}, подумайте, какую дату передать. - В production храните секреты в secret manager (Vault, Key Vault, AWS SSM, Google Secret Manager). Подробнее в главе 16.
Кроме того, книга упоминает экспериментальную функцию Object Storage (с Airflow 2.8). Она даёт единый код для S3, GCS и Azure Blob.
Use case 2: перенос данных из A в B
Заголовок раздела «Use case 2: перенос данных из A в B»Классическая задача ETL: выгрузить данные из системы A, при необходимости преобразовать и положить в систему B. Для таких задач в экосистеме есть A-to-B operators: MySqlToGoogleCloudStorageOperator, SFTPToS3Operator, HttpOperator и другие.
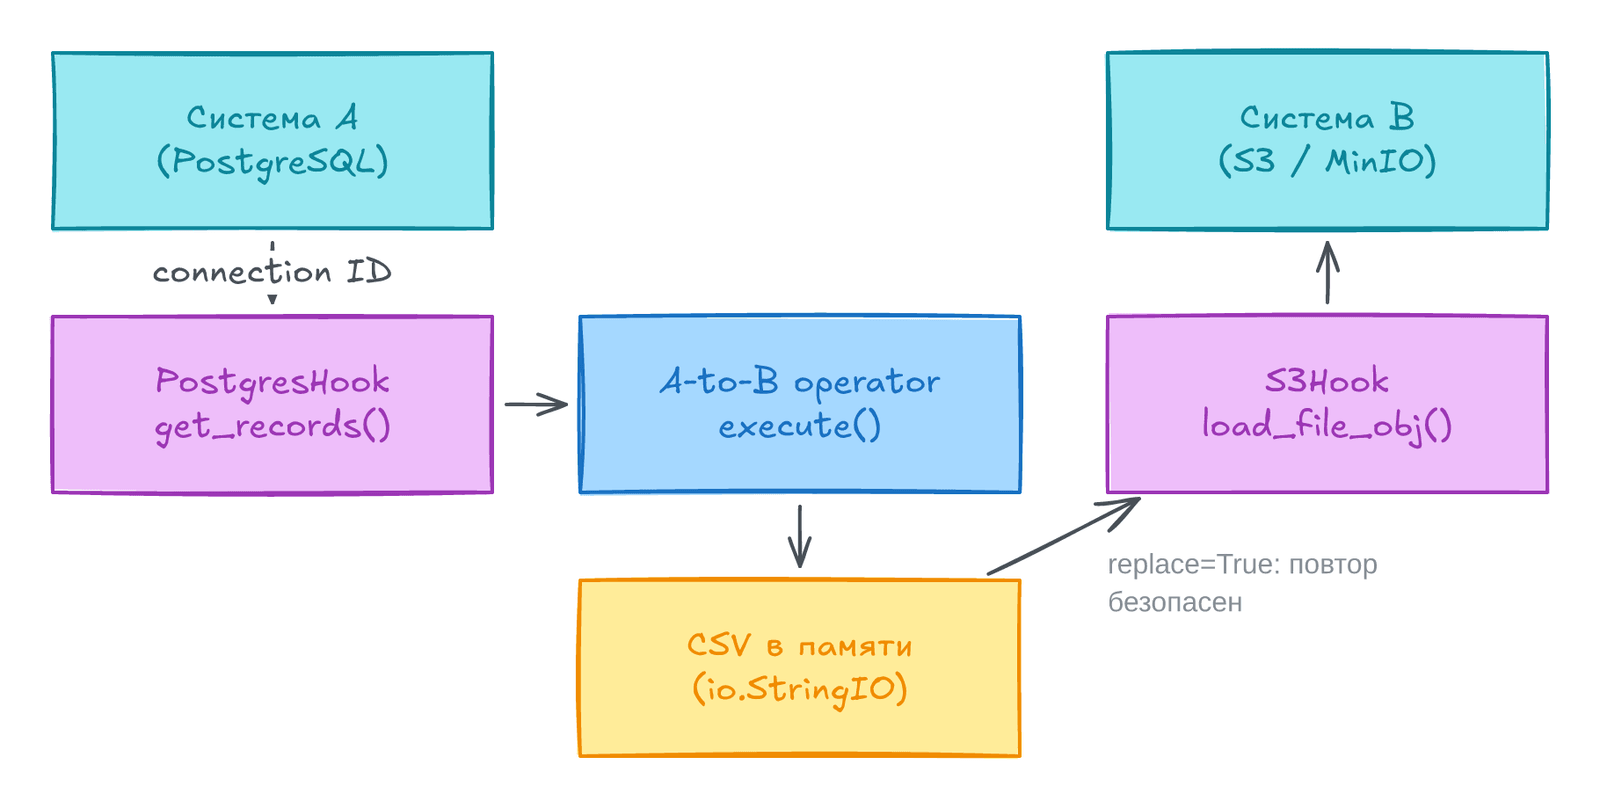
Пример книги: листинги Airbnb в Амстердаме. Раз в день из PostgreSQL выгружаем данные в S3 (MinIO, S3-совместимое хранилище). Потом контейнер с pandas считает изменение цен и пишет результат обратно в S3.
Готового оператора PostgresToS3Operator нет. Книга предлагает посмотреть, как устроены похожие операторы, и написать свой.
Как устроен A-to-B operator
Заголовок раздела «Как устроен A-to-B operator»- В
execute()создаются дваhook: один для системы A, другой для B. - Hook знает, как подключиться по
connection ID. - Промежуточный результат хранится где-то между ними.
| Оператор | Где лежит промежуточный результат | На что смотреть |
|---|---|---|
MongoToS3Operator | В памяти | Хватит ли RAM |
S3ToSFTPOperator | Во временном файле на диске | Хватит ли места на диске |
Что не так с первой версией
Заголовок раздела «Что не так с первой версией»PostgresHook.get_records()возвращает список кортежей.- Если превратить его в строку через
str(), получится текст, который не понимает ниpandas, ни Spark. - Решение: записать результат в CSV через
csv.writerв буфер и загрузить черезS3Hook.load_file_obj(). replace=Trueделает загрузку идемпотентной. Без него повторный запуск упадёт на уже существующем файле.
Заметка про имена: S3Hook принимает aws_conn_id, а не s3_conn_id. Причина: он наследуется от AwsBaseHook. Чтобы это понять, читайте исходный код и документацию.
В запросе используют templates, например data_interval_start и {{ ds }} для имени файла.
Orchestration и execution
Заголовок раздела «Orchestration и execution»В сообществе спорят: Airflow только запускает работу или выполняет её сам?
BashOperatorиPythonOperatorработают в том же окружении, что и Airflow.- Тяжёлая задача может занять все ресурсы машины.
- Лучше разделять: Airflow запускает job и ждёт. Работу делает Spark или другой движок.
Способы запустить Spark job:
| Способ | Что нужно |
|---|---|
SparkSubmitOperator | spark-submit и конфиг YARN на машине Airflow |
SSHOperator | SSH-доступ к Spark. Конфиг Spark не нужен |
HttpOperator с Livy | Запущенный Livy (REST API для Spark) |
В примере книги работу делает контейнер через DockerOperator. Airflow запускает контейнер, забирает логи и удаляет его. Главное: не оставлять состояние после запуска. Тогда task идемпотентна (подробнее в главе 11).
Пример кода
Заголовок раздела «Пример кода»Проверено на Airflow 3.4: operator проверен в pytest, Postgres и S3 заменены mock.
Мини-версия A-to-B operator. Имена выдуманы.
import csvimport io
from airflow.providers.amazon.aws.hooks.s3 import S3Hookfrom airflow.providers.postgres.hooks.postgres import PostgresHookfrom airflow.sdk import BaseOperator

class OrdersToS3Operator(BaseOperator):    template_fields = ("query", "s3_key")
    def __init__(self, query, s3_bucket, s3_key, **kwargs):        super().__init__(**kwargs)        self.query = query        self.s3_bucket = s3_bucket        self.s3_key = s3_key
    def execute(self, context):        rows = PostgresHook(postgres_conn_id="shop_db").get_records(self.query)        text = io.StringIO()        csv.writer(text).writerows(rows)        S3Hook(aws_conn_id="lake").load_file_obj(            io.BytesIO(text.getvalue().encode()),            bucket_name=self.s3_bucket,            key=self.s3_key,            replace=True,        )
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Provider package | Пакет с операторами и hooks для одной системы |
Hook | Класс для подключения к системе по connection ID |
| A-to-B operator | Operator, который переносит данные из одной системы в другую |
airflow tasks test | Команда, которая запускает одну task без записи состояния |
wait_for_completion | Оператор ждёт конца внешней работы |
| Fire and forget | Запустить работу и не проверять результат |
DockerOperator | Запускает контейнер как task |
| Orchestration vs execution | Airflow управляет, другая система считает |
replace=True | Перезапись объекта в S3. Нужна для идемпотентности |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Сначала ищите готовый operator в provider package. Свой пишите, только если его нет.
- Читайте документацию внешней системы. Большая часть проблем будет там, а не в Airflow.
- Давайте внешним ресурсам уникальные имена с
logical_date. Так перезапуск и backfill безопасны. - Всегда ждите завершения внешней работы или используйте deferrable-версию (глава 7).
- Не загружайте большие данные в память worker. Читайте частями или передавайте через диск и хранилище.
- Тяжёлые трансформации отдавайте в Spark, dbt, warehouse или контейнер. Airflow только запускает их.
- Разовую инфраструктуру (API, Lambda) выкатывайте через CI/CD, а не через DAG.
- Проверяйте одну task локально через
airflow tasks test. Не ждите полного запуска.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Зачем нужны provider packages? Что делает operator внутри?
- Почему в имя training job добавляют
logical_date? - Чем
MongoToS3Operatorотличается отS3ToSFTPOperatorпо хранению промежуточных данных? - Почему лучше не выполнять тяжёлую обработку внутри Airflow?
Предыдущая: Запуск workflow внешними событиями. Следующая: Свои operators и sensors.