

Data Pipelines with Apache Airflow, глава 1: Знакомство с Apache Airflow
Главная мысль: pipeline лучше описывать как граф из небольших задач. Airflow запускает этот граф по расписанию, следит за порядком задач и помогает чинить сбои. Он создан для batch-pipelines, а не для потоков.
Pipeline как граф задач
Заголовок раздела «Pipeline как граф задач»Пример из книги: дашборд погоды. У него три шага: взять прогноз из API, очистить данные, отправить их в дашборд.
- Каждый шаг это
task. На графе он выглядит как узел. - Порядок шагов это зависимость. На графе это стрелка от одной task к другой.
- Такой граф называют
DAG: directed acyclic graph. Directedзначит, что у стрелки есть направление.Acyclicзначит, что циклов нет. Иначе task A ждёт B, а B ждёт A, и обе стоят.
Как выполнить такой граф, понятно из простого алгоритма:
- Найди незавершённые tasks, у которых все upstream-задачи готовы.
- Поставь их в очередь и выполни.
- Повтори, пока не закончатся все tasks.
Airflow делает то же самое. Сверху он добавляет логику расписания.
Граф или один скрипт
Заголовок раздела «Граф или один скрипт»Второй пример: компания продаёт зонты. Нужно обучить модель, которая связывает продажи с погодой.
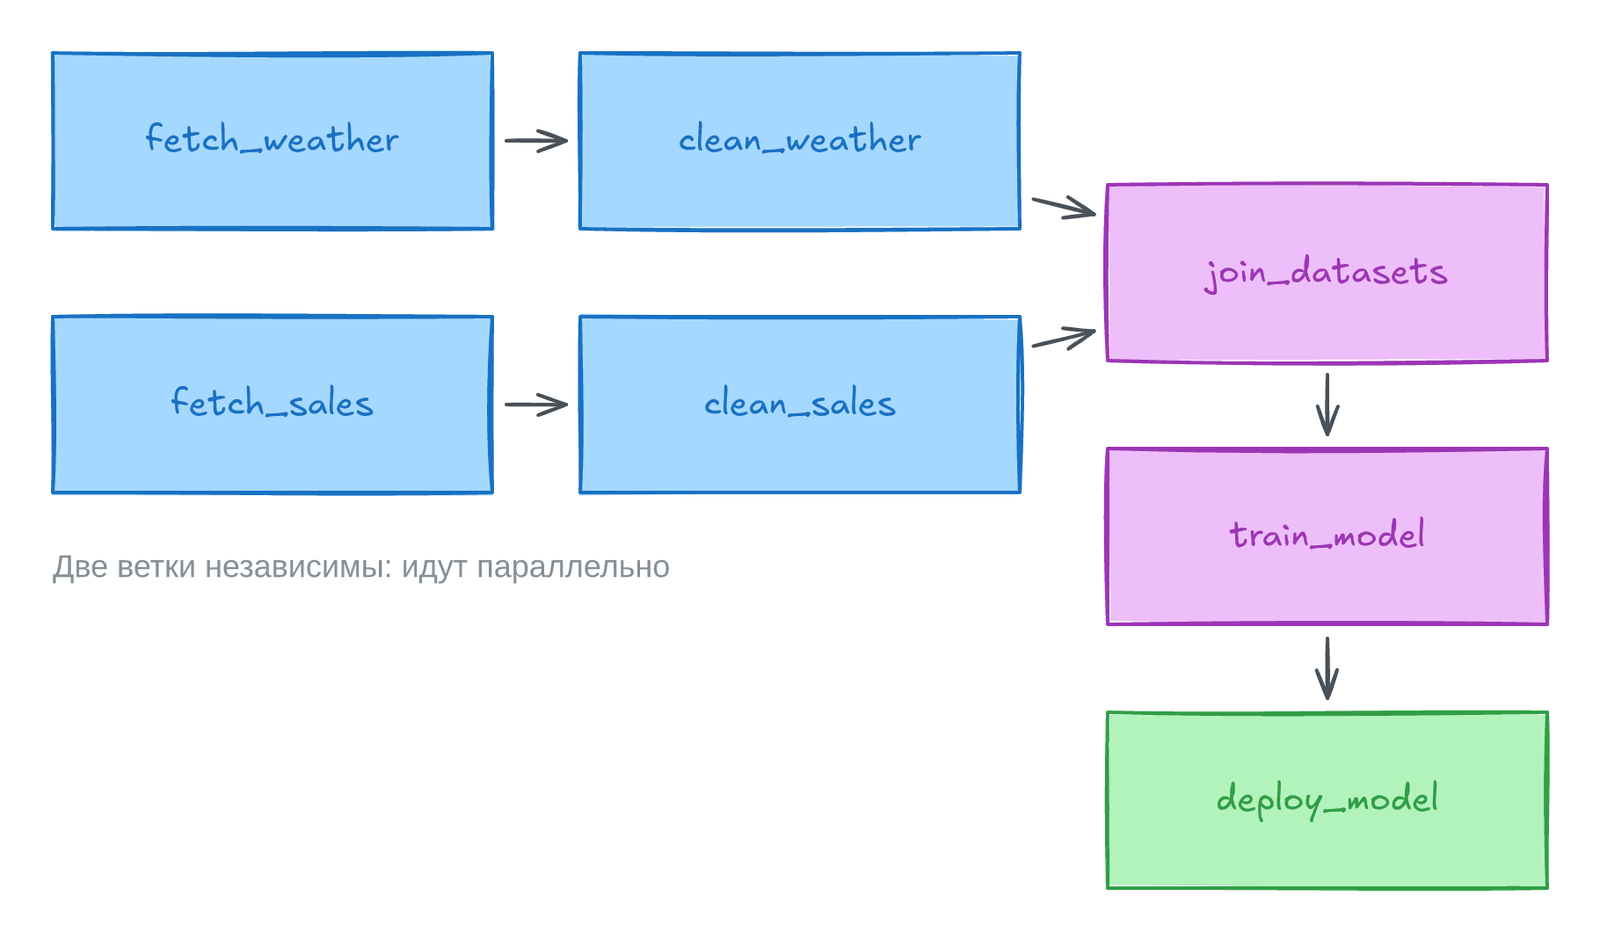
Что даёт граф вместо одного большого скрипта:
| Плюс | Пример |
|---|---|
| Параллельность | Ветки погоды и продаж не связаны, их можно считать одновременно |
| Частичный перезапуск | Упала clean_sales. Перезапускаем её и tasks после неё, а не весь скрипт |
| Читаемость | По графу видно структуру pipeline |
| Мелкие шаги | Каждый шаг можно менять и проверять отдельно |
Airflow среди workflow managers
Заголовок раздела «Airflow среди workflow managers»Задача запускать граф зависимых задач старая. Книга сравнивает много инструментов: Airflow, Luigi, Dagster, Prefect, Argo, Oozie, Azkaban и другие.
Главные различия:
- Как описан workflow. Oozie использует XML. Это читаемо, но негибко. Airflow и Luigi используют код. Это гибко, но код надо тестировать.
- Что встроено. В Make и самописных скриптах нет расписания. Нужен
cron. Airflow даёт расписание, UI и мониторинг в одной платформе.
Как устроен Airflow
Заголовок раздела «Как устроен Airflow»Airflow написан на Python. DAG описывается в Python-файле (DAG file). В Airflow 3 появилась возможность писать на других языках, но основной остаётся Python.
Плюсы кода:
- DAG можно генерировать динамически, например из конфигов.
- Task может сделать всё, что умеет Python.
- Много
providersдля баз, облаков и больших данных.
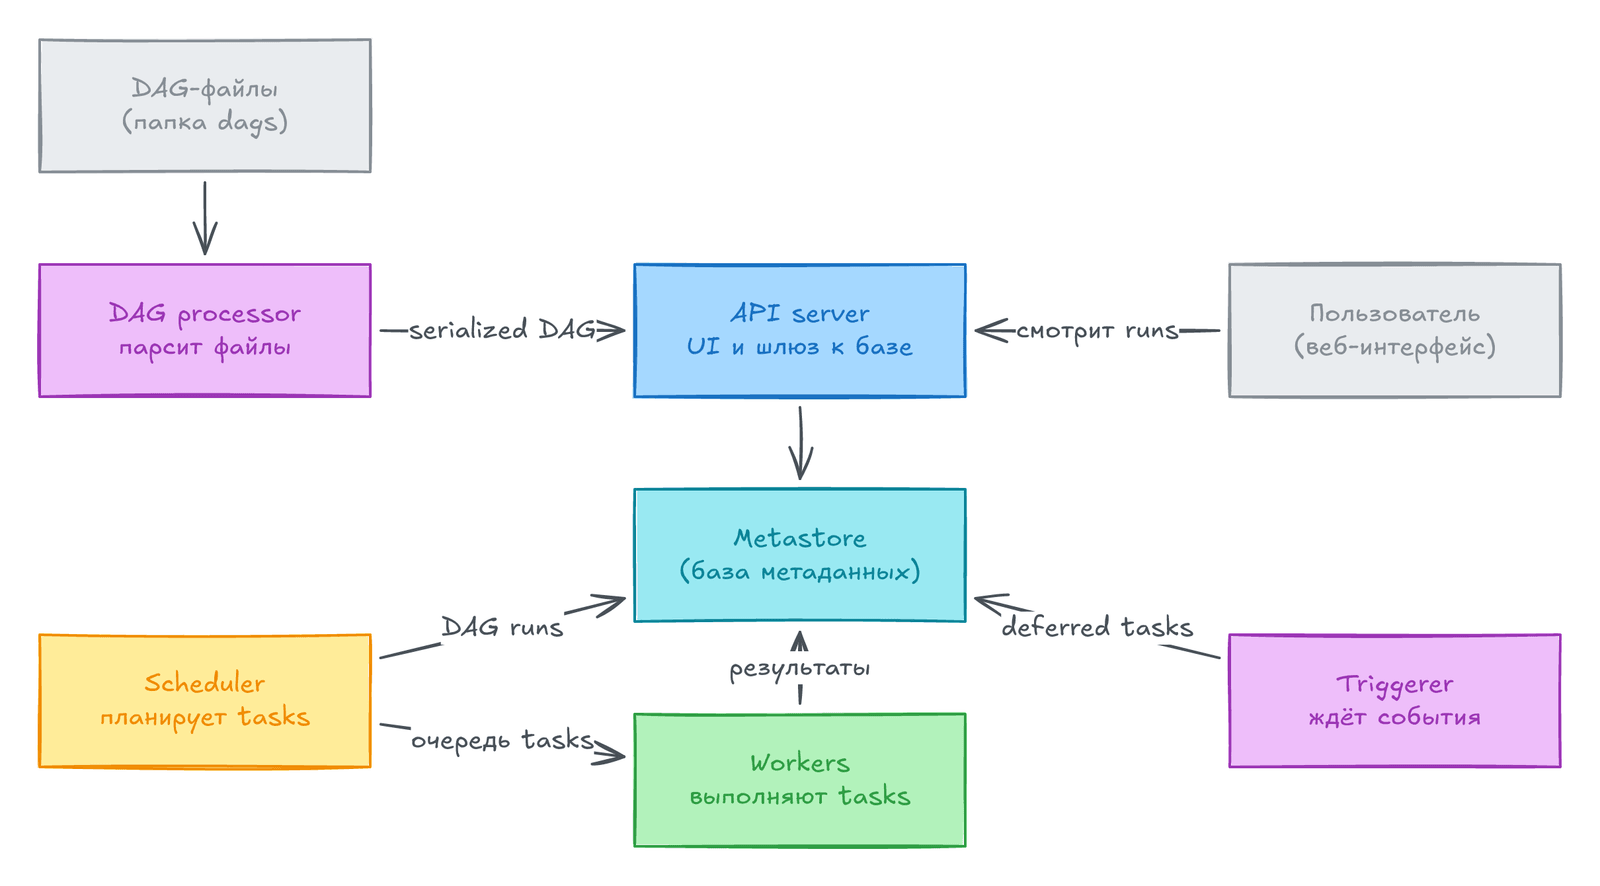
Пять компонентов
Заголовок раздела «Пять компонентов»| Компонент | Что делает |
|---|---|
| DAG processor | Читает DAG-файлы, парсит их и кладёт результат в metastore |
| Scheduler | Проверяет расписание, создаёт DAG runs, ставит tasks в очередь |
| Workers | Берут tasks из очереди и выполняют их |
| Triggerer | Ждёт внешние события для deferred tasks, чтобы worker не простаивал |
| API server | Даёт веб-интерфейс и служит шлюзом между компонентами и базой |
Ещё есть metastore: база, где хранятся DAG, runs и состояния tasks. По книге, все обращения к базе идут через API server.
Цикл scheduler
Заголовок раздела «Цикл scheduler»- DAG processor разбирает файлы и сохраняет DAG.
- Scheduler смотрит, прошёл ли
schedule interval. - Для каждого запущенного DAG он проверяет зависимости tasks.
- Готовые tasks уходят в очередь на workers.
- Tasks, которые ждут внешний ресурс, уходят в triggerer.
- Цикл повторяется.
Мониторинг и сбои
Заголовок раздела «Мониторинг и сбои»- В UI есть обзор всех DAG,
graph viewиgrid view. Grid viewсамый полезный. Он показывает историю runs, статусы tasks и логи.- Упавшую task Airflow может повторить (
retries), с паузой между попытками. - Если retries не помогли, task получает статус failed. Можно настроить уведомления.
- В UI можно сделать
clearдля task. Тогда она и её downstream tasks запустятся заново.
Инкрементальная загрузка и backfilling
Заголовок раздела «Инкрементальная загрузка и backfilling»Расписание Airflow делит время на интервалы: день, неделя и так далее. Каждый run знает свой интервал.
- Incremental pipeline. Каждый run обрабатывает только данные своего интервала (delta), а не всю таблицу.
- Backfilling. Можно запустить DAG за прошлые интервалы и заполнить историю.
- Reprocessing. Изменили код? Сделайте clear старых runs, и данные пересчитаются.
Подробности в главе 3.
Когда брать Airflow
Заголовок раздела «Когда брать Airflow»Подходит, если нужно:
- запускать сложные workflow по расписанию или по событию;
- работать с данными по интервалам времени;
- подключаться ко многим системам (PostgreSQL, BigQuery и другие);
- применять практики разработки: код, git, review;
- делать backfilling.
Плюсы платформы: open source, нет vendor lock-in, давно в production, есть managed-версии.
Не подходит, если:
- нужен streaming, то есть обработка отдельных событий в реальном времени;
- команда не пишет код. Лучше инструмент с GUI, например Azure Data Factory;
- нужны data lineage и data versioning из коробки. Airflow поддерживает OpenLineage, но этого мало;
- структура DAG меняется каждый день.
Большие DAG требуют инженерной дисциплины: переиспользуемые DAG, модульные tasks, принципы DRY и SRP.
Пример кода
Заголовок раздела «Пример кода»Проверено на Airflow 3.4: DAG проходит airflow dags test.
Так выглядит минимальный DAG из двух tasks. Имена придуманы для примера.
import pendulumfrom airflow.providers.standard.operators.bash import BashOperatorfrom airflow.sdk import DAG
with DAG(    dag_id="demo_weather_board",    start_date=pendulum.datetime(2025, 1, 1, tz="UTC"),    schedule=None,):    fetch = BashOperator(task_id="fetch", bash_command="echo fetch")    publish = BashOperator(task_id="publish", bash_command="echo publish")
    fetch >> publish
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
DAG | Directed acyclic graph: граф tasks без циклов |
Task | Один шаг pipeline, узел графа |
DAG file | Python-файл, который описывает DAG |
DAG processor | Компонент, который парсит DAG-файлы |
Scheduler | Компонент, который решает, когда и что запускать |
Worker | Процесс, который выполняет task |
Triggerer | Компонент для deferred tasks, ждущих события |
Metastore | База метаданных Airflow |
Provider | Пакет интеграции с внешней системой |
Backfilling | Запуск DAG за прошлые интервалы |
Incremental load | Обработка только новых данных за интервал |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Режьте pipeline на небольшие tasks. Тогда сбой стоит дешёвого перезапуска, а не полной перегрузки.
- Принимайте Airflow как orchestrator. Он запускает работу в warehouse,
dbt, Spark. Тяжёлую обработку данных не делайте внутри worker. - Для потоковых данных (Kafka и подобные) берите другие инструменты. Airflow можно использовать для batch-слоя вокруг них.
- Опишите DAG так, чтобы каждый run брал данные своего интервала. Тогда backfilling работает сам.
- Помните: DAG это код. Храните его в git и проверяйте через review.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему граф должен быть acyclic? Что случится при цикле?
- Что выигрывает pipeline в виде графа по сравнению с одним скриптом?
- Какую роль играют scheduler, DAG processor, workers и triggerer?
- В каких случаях Airflow не стоит брать?
Предыдущая: Обзор книги. Следующая: Анатомия DAG.