

Data Quality Fundamentals, глава 1: Почему качество данных важно именно сейчас
Главная мысль: Плохие данные бывают в каждой компании. Авторы называют это data downtime: время, когда данные пропали, неточны или ошибочны. Проблема растёт, потому что растут данные, источники, команды и шаги пайплайна. Именно в 2020-х качество данных стало приоритетом бизнеса.
О чём глава
Заголовок раздела «О чём глава»Первая глава отвечает на вопрос: почему качество данных вдруг стало важным и что авторы называют качеством. Глава 2 покажет, из каких частей строить надёжную систему.
data downtimeи его цена.- Определение качества данных.
- Идеи DevOps в мире данных (
DataOps). - Пять причин роста
data downtime. - Тренды:
data mesh, streaming,lakehouse.
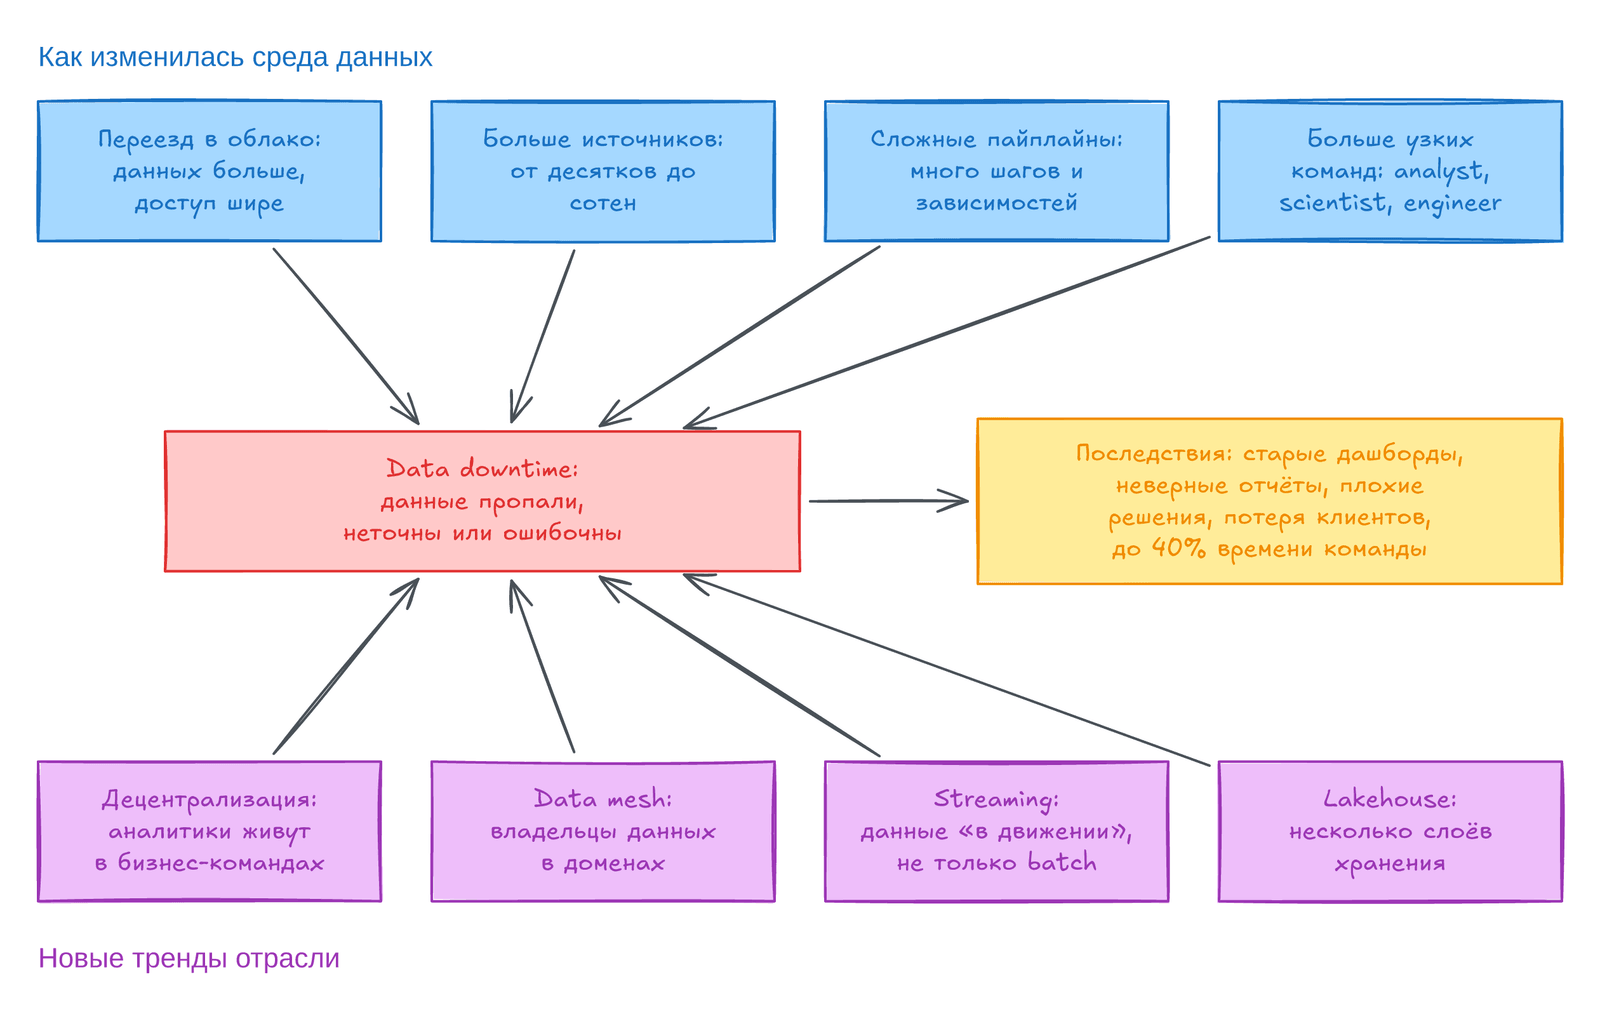
Каждая причина добавляет места, где данные могут сломаться. Справа стоят последствия.
Проблема: «данные неверны»
Заголовок раздела «Проблема: «данные неверны»»Вы закрываете ноутбук, и вам пишут. В отчёте маркетинга нет данных. В дашборде CTO есть дубли. CEO не понимает число в слайде для совета директоров. Это data downtime: периоды, когда данные пропали, неточны или ошибочны. Он виден в устаревших дашбордах, неверных отчётах и плохих решениях.
Цена высокая. Компании теряют миллионы долларов в год, не считая доверия клиентов. По данным ZoomInfo (2019), каждая пятая компания потеряла клиента из-за качества данных. Более 40% времени дата-команды уходит на такие проблемы.
Барр Мозес однажды вернулась после долгой сессии планирования и нашла на мониторе стикер «Данные неверны». Такие тихие сбои повторялись. Вместе с Лиором Гавишем она опросила сотни дата-команд. Везде одно и то же: схема меняется и ломает пайплайн, в отчётах дубли, данные пропадают из дашбордов.
Плохие данные старше компаний. Полярник Скотт ошибся в оценке маршрута к Южному полюсу. Зонд Mars Climate Orbiter в 1999 году разбился из-за ошибки при вводе данных: результат оказался не в единицах SI. Авария обошлась NASA в 125 миллионов долларов.
«Данные в production» здесь значат данные из источников (CRM, CMS, базы), которые загрузили в хранилище или озеро и которые идут по пайплайну к аналитике. Пайплайн может быть пакетным (batch) или потоковым (stream): измерять качество в обоих случаях примерно одинаково.
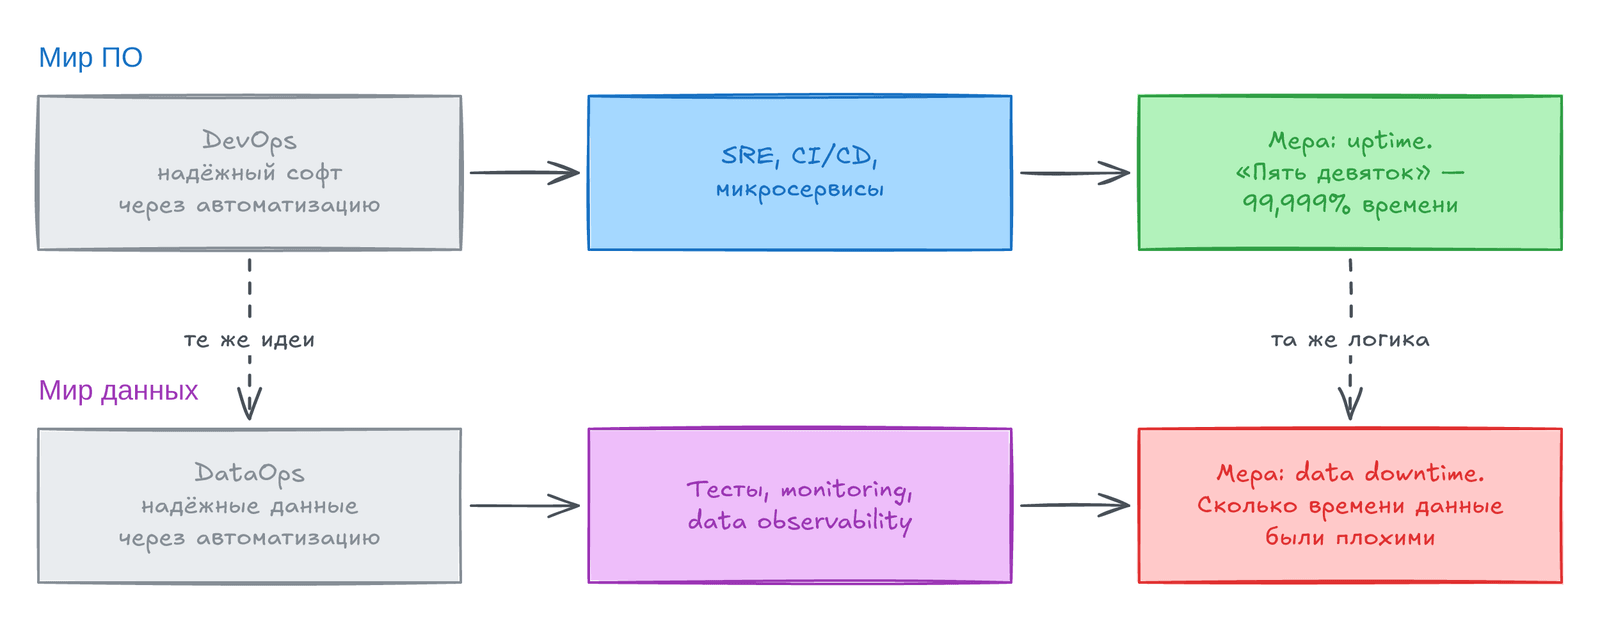
В софте доступность измеряют через uptime, и «пять девяток» (99,999%) становятся стандартом. Авторы спрашивают: как применить это к данным? В книге речь об аналитических пайплайнах: дашборды, продукты данных, ML.
Пояснение: 99,999% значит примерно пять минут простоя в год. Расчёт есть в практике ниже.
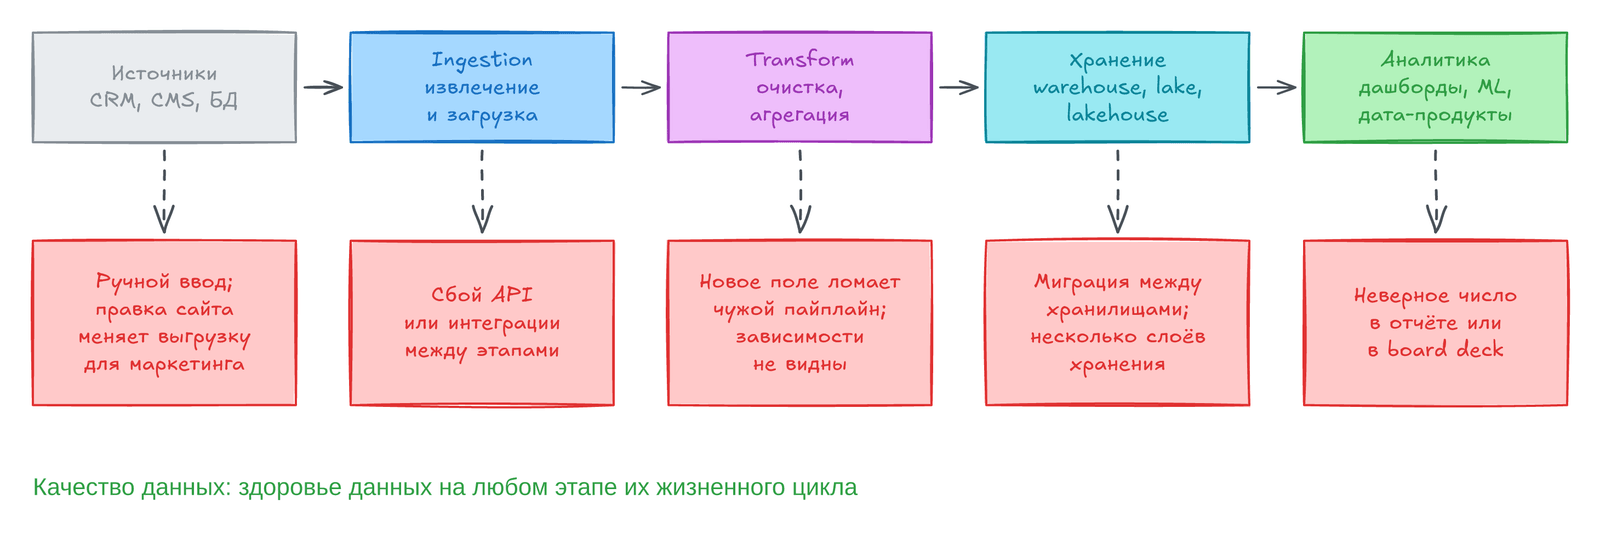
Что такое качество данных
Заголовок раздела «Что такое качество данных»Идея не нова. Определение сложилось как мера надёжности, полноты и точности данных. «Нельзя управлять тем, что не измеряешь», а высокое качество данных — первый шаг любой аналитики.
Авторы определяют так: качество данных — это здоровье данных на любом этапе жизненного цикла. Оно портится до загрузки, в production и даже при анализе.
У темы плохая репутация: она скучнее, чем «machine learning». Отдельного человека на неё обычно нет, и ею занимаются те же аналитики и инженеры. Но если данным не доверяют, не доверяют и команде. Фраза «лучше никаких данных, чем плохие» верна, но такого выбора обычно нет. Проблемы почти неизбежны при том, как быстро растёт потребление данных.
Текущий момент
Заголовок раздела «Текущий момент»Только в 2020-х качество стало приоритетом бизнеса: данные стали почти товаром. Компании начали обращаться с данными как с кодом. Идеи взяли из DevOps, области, цель которой — выпускать надёжный софт через автоматизацию. Оттуда пришли SRE (инженерия надёжности), CI/CD и микросервисы.
Применение этих идей к данным называют DataOps: это повышение надёжности и скорости данных через автоматизацию. С 2019 года Intuit, Airbnb, Uber и Netflix много пишут о надёжных данных. Их данные питают не только аналитику, но и сами сервисы. Остальные компании повторяют их практики: усиливают тесты, вводят monitoring и data observability.
Почему растёт data downtime
Заголовок раздела «Почему растёт data downtime»Переезд в облако
Заголовок раздела «Переезд в облако»Раньше хранилище данных (data warehouse) стояло в подвале офиса. Теперь это облачные Redshift, Snowflake и BigQuery. Облако упростило управление и ускорило обработку. Следом в облако ушли и озёра (data lake). Когда компании и их данные ушли в облако, аналитика для решений и качество данных стали важнее.
Больше источников данных
Заголовок раздела «Больше источников данных»Компании используют от десятков до сотен источников. Любой может измениться без предупреждения. Например, инженеры правят сайт, и ломается набор данных для маркетинга. Метрики оказываются неверными, и решения по рекламе тоже.
Сложные пайплайны
Заголовок раздела «Сложные пайплайны»Этапов много, а зависимости между ними непрозрачны. Изменение в одном наборе может неожиданно сломать зависимые наборы. Данные извлекают, загружают, преобразуют, хранят, отдают, и на каждом стыке есть риск. Сбои возможны и вне стыков: при миграции между хранилищами и ручном вводе.
Больше специализированных команд
Заголовок раздела «Больше специализированных команд»Растёт число аналитиков, дата-сайентистов и инженеров. Аналитики чистят данные и пишут запросы, а инженеры отвечают за быстрые и надёжные системы. Граница размыта: Uber в конце 2010-х переименовал всех аналитиков в дата-сайентистов. Появляются также роли data steward, analytics engineer и лидеры data governance.
Чем больше людей, тем неизбежнее недопонимание. Например, одна команда добавила поле, у другой упал пайплайн, и данных нет. Следствие: потеря выручки и доверия клиентов, риски соответствия требованиям.
Децентрализованные команды
Заголовок раздела «Децентрализованные команды»Бизнес-команды сами работают с данными. Это похоже на переход от монолитов к микросервисам. Это не data mesh: здесь центральная команда платформы обслуживает аналитиков, распределённых по бизнесу. Например, в компании на 200 человек 3 инженера и 10 встроенных аналитиков. Несколько доменов создают данные, поэтому наборы дублируются, пропадают или устаревают.
Другие тренды отрасли
Заголовок раздела «Другие тренды отрасли»Data mesh
Заголовок раздела «Data mesh»Data mesh — это версия микросервисов для платформы данных. Авторы предупреждают: идея молодая, и о ней спорят.
Автор идеи — Жамак Дехгани из Thoughtworks. Это социотехническая парадигма. Каждый домен владеет своими пайплайнами и отдаёт данные как продукт (data-as-a-product), а связывает домены универсальный уровень совместимости с общими стандартами. Центральная инфраструктура при этом даёт доменам средства обработки.
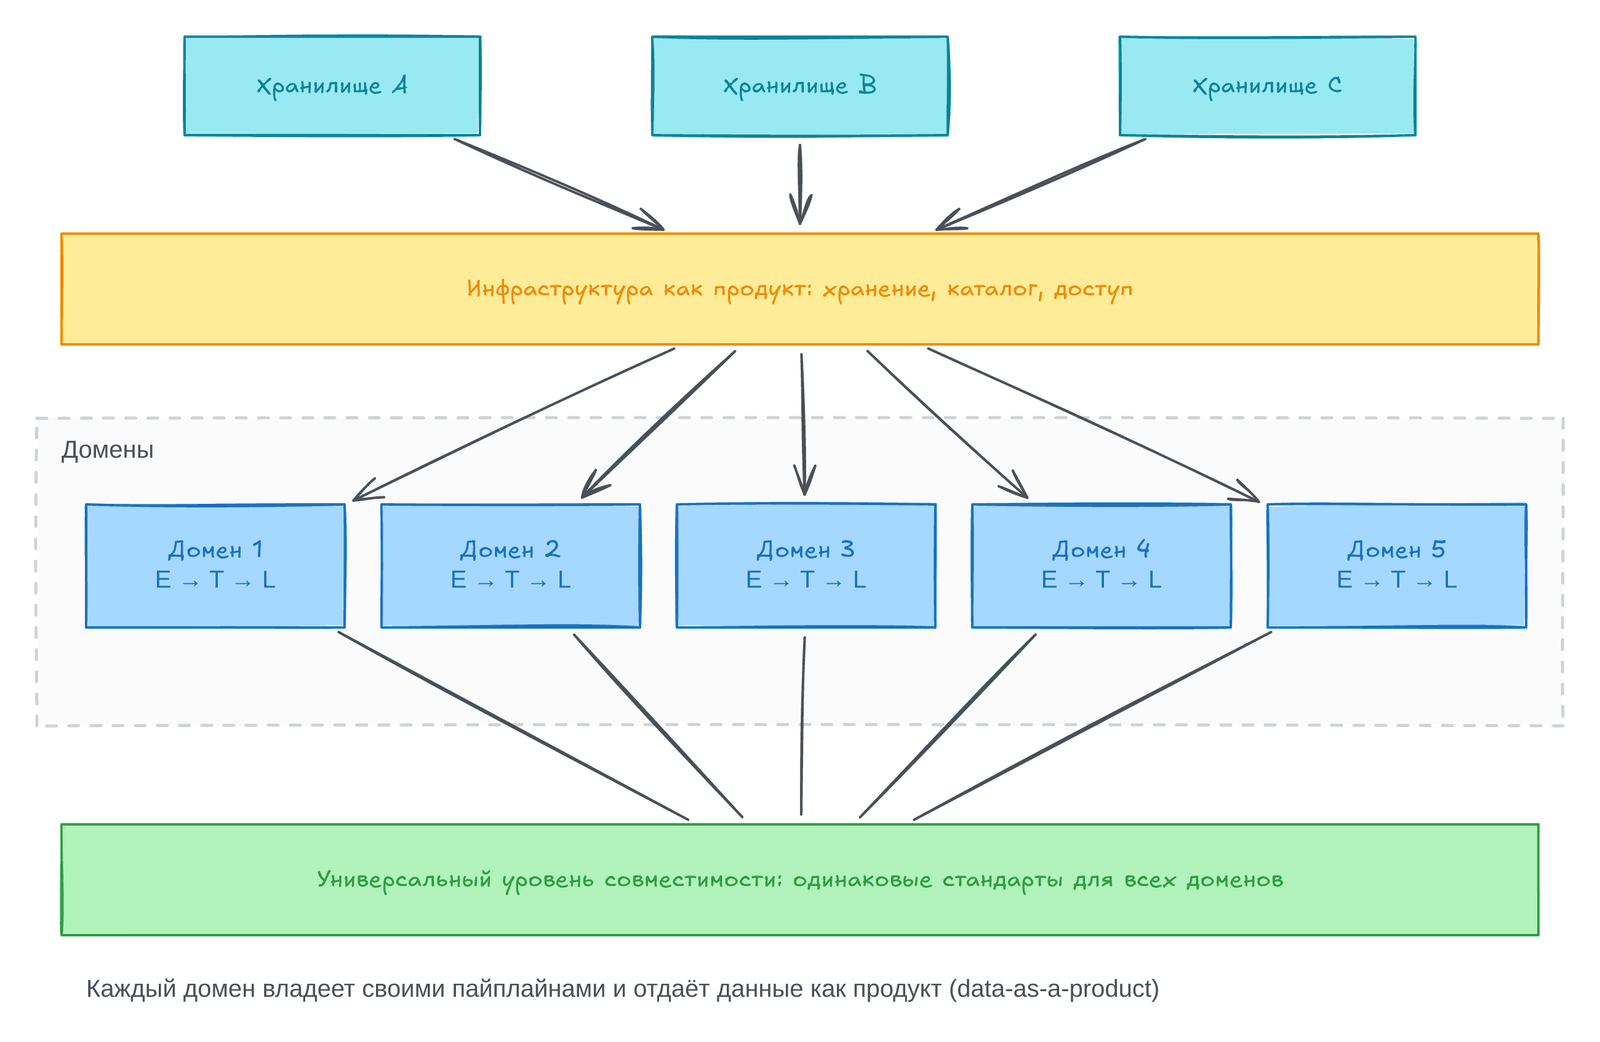
Это наша версия рисунка 1-1: сверху инфраструктура, посередине домены, снизу стандарты.
По мнению авторов, data mesh работает, только если данные надёжны. А надёжность даёт внимание к качеству: тесты, monitoring, data observability. Intuit описал платформу как «связанную сеть данных высокого качества». JPMorgan Chase построил mesh, чтобы разграничить владение данными.
Streaming data
Заголовок раздела «Streaming data»Раньше качество проверяли тестами пакетных данных до production. Теперь бизнесу нужна аналитика в реальном времени. Выводы получаются быстрее, но вопросов к качеству больше: streaming-данные «в движении». Компании используют и batch, и stream, и командам приходится пересматривать тесты.
Рост data lakehouse
Заголовок раздела «Рост data lakehouse»Хранилище (структурированные данные) или озеро (сырые)? Всё чаще оба: появился lakehouse. Хранилища получили возможности озёр, озёра получили SQL и схему. Но пайплайны усложняются: данные идут в несколько слоёв хранения, и ломаться есть чему даже при хороших тестах.
Итоги главы
Заголовок раздела «Итоги главы»Data downtimeстоит миллионы и доверие клиентов, а более 40% времени команды уходит на такие проблемы.- Качество данных — здоровье данных на любом этапе жизненного цикла.
DataOpsпереносит идеи DevOps в данные, аuptimeслужит образцом для измерения.- Рост
data downtimeобъясняют облако, источники, сложные пайплайны и команды. Data meshтребует надёжных данных и общих стандартов.- Streaming и
lakehouseдобавляют новые места для сбоев. - Качество данных — это не только техника, но и культура. Это марафон, а не спринт.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
data downtime | Время, когда данные пропали, неточны или ошибочны |
DataOps | Надёжность данных через автоматизацию, как в DevOps |
uptime | Доля времени, когда сервис доступен |
data mesh | Доменные команды владеют данными как продуктами |
data-as-a-product | Набор данных с владельцем, как продукт |
lakehouse | Гибрид озера и хранилища |
streaming | Непрерывный поток данных в пайплайн |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Записывайте каждый инцидент: когда данные стали плохими и когда это исправили. Без записей нет прогресса.
- Проверяйте три типичных признака: данные не пришли, пришли дубли, данные устарели.
- Договоритесь с командами-источниками об уведомлениях об изменениях.
- Назначьте владельца каждому набору данных.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»В главе нет кода, поэтому практика только одна. Она показывает главную идею: data downtime проверяют запросом и измеряют как простой сервиса. Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку.
Шаг 1. Создаём данные с проблемами
Заголовок раздела «Шаг 1. Создаём данные с проблемами»В таблице orders есть дубль, пропавший день и пустая сумма. Таблица downtime хранит инциденты за май 2024.
CREATE TABLE orders ASSELECT * FROM (VALUES    (1, 'C1', 120.0, DATE '2024-05-01', TIMESTAMP '2024-05-02 06:00:00'),    (2, 'C2',  80.0, DATE '2024-05-01', TIMESTAMP '2024-05-02 06:00:00'),    (3, 'C1',  45.0, DATE '2024-05-02', TIMESTAMP '2024-05-03 06:00:00'),    (3, 'C1',  45.0, DATE '2024-05-02', TIMESTAMP '2024-05-03 06:00:00'),    (4, 'C3',  NULL, DATE '2024-05-02', TIMESTAMP '2024-05-03 06:00:00'),    (5, 'C2',  60.0, DATE '2024-05-04', TIMESTAMP '2024-05-05 06:00:00'),    (6, 'C4',  95.0, DATE '2024-05-04', TIMESTAMP '2024-05-05 06:00:00')) t(order_id, customer_id, amount, order_date, loaded_at);
CREATE TABLE downtime ASSELECT * FROM (VALUES    (TIMESTAMP '2024-05-02 06:00:00', TIMESTAMP '2024-05-02 18:00:00'),    (TIMESTAMP '2024-05-10 08:00:00', TIMESTAMP '2024-05-11 08:00:00')) t(started_at, resolved_at);
Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»«Сейчас» для примера равно 2024-05-07 09:00.
-- свежесть: сколько часов прошло с последней загрузкиSELECT date_diff('hour', max(loaded_at), TIMESTAMP '2024-05-07 09:00:00') AS hours_since_loadFROM orders;
-- дублиSELECT order_id, count(*) AS n FROM orders GROUP BY order_id HAVING count(*) > 1;
-- пропавшие дниSELECT d::DATE AS missing_dayFROM generate_series(DATE '2024-05-01', DATE '2024-05-04', INTERVAL 1 DAY) t(d)WHERE d::DATE NOT IN (SELECT order_date FROM orders);
-- пустые суммыSELECT count(*) AS null_amount FROM orders WHERE amount IS NULL;
Последняя загрузка была 51 час назад. Дубль у order_id = 3, пропал день 2024-05-03, одна сумма пустая.
Задания
Заголовок раздела «Задания»1. Сделайте представление orders_clean без дублей и пустых сумм. Сколько строк было и стало?
Решение
CREATE VIEW orders_clean ASSELECT DISTINCT * FROM orders WHERE amount IS NOT NULL;
SELECT count(*) AS rows_raw, (SELECT count(*) FROM orders_clean) AS rows_clean FROM orders;
Было 7 строк, стало 5. Пропавший день представление не вернёт: данных там нет.
2. Посчитайте uptime данных за май 2024 (31 день) по таблице downtime.
Решение
SELECT sum(date_diff('minute', started_at, resolved_at)) / 60.0 AS downtime_hours, round(100 * (1 - sum(date_diff('minute', started_at, resolved_at)) / (31 * 24 * 60.0)), 2) AS uptime_pctFROM downtime;Два инцидента дали 36 часов data downtime. Это 95,16% времени.
3. Сколько минут простоя в год допускают цели 99,9%, 99,99% и 99,999%?
Решение
SELECT target, round(365 * 24 * 60 * (1 - target / 100), 2) AS minutes_per_yearFROM (VALUES (99.9), (99.99), (99.999)) t(target);Получается 525,6, 52,56 и 5,26 минуты. «Пять девяток» оставляют на простой около пяти минут в год.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Что такое
data downtimeи как он выглядит у потребителей данных? - Чем определение качества как «здоровья на любом этапе» шире проверки готовых таблиц?
- Почему мера
uptimeподходит для данных? - Как рост числа источников, команд и шагов пайплайна приводит к
data downtime? - Почему
data meshработает только при высоком качестве данных?
Предыдущая: Обзор книги. Следующая: Глава 2. Из чего собрать надёжную систему данных.