

Data Quality Fundamentals, глава 5: Архитектура для надёжности данных
Главная мысль: Надёжные данные не появляются сами. Их встраивают в каждый этап: проверяют при загрузке, наблюдают внутри пайплайна, измеряют на выходе. Нужны три вещи: процессы из DevOps (тесты и observability), устойчивая платформа данных и общие для всех SLA, SLI и SLO.
О чём глава
Заголовок раздела «О чём глава»В главе 4 мы разобрали поиск аномалий. Теперь вопрос шире: как построить систему, где данные надёжны на каждом этапе? Надёжность данных (data reliability) — это способность организации давать доступные и «здоровые» данные на всём жизненном пути. Это результат высокого качества. Airbnb и Uber пишут, что качество у них в центре платформы. Но писать проще, чем делать. Темы главы:
- что делать при загрузке, внутри пайплайна и на выходе;
- шесть слоёв платформы данных;
- цена плохих данных и SLA, SLO, SLI;
- кейс Blinkist.
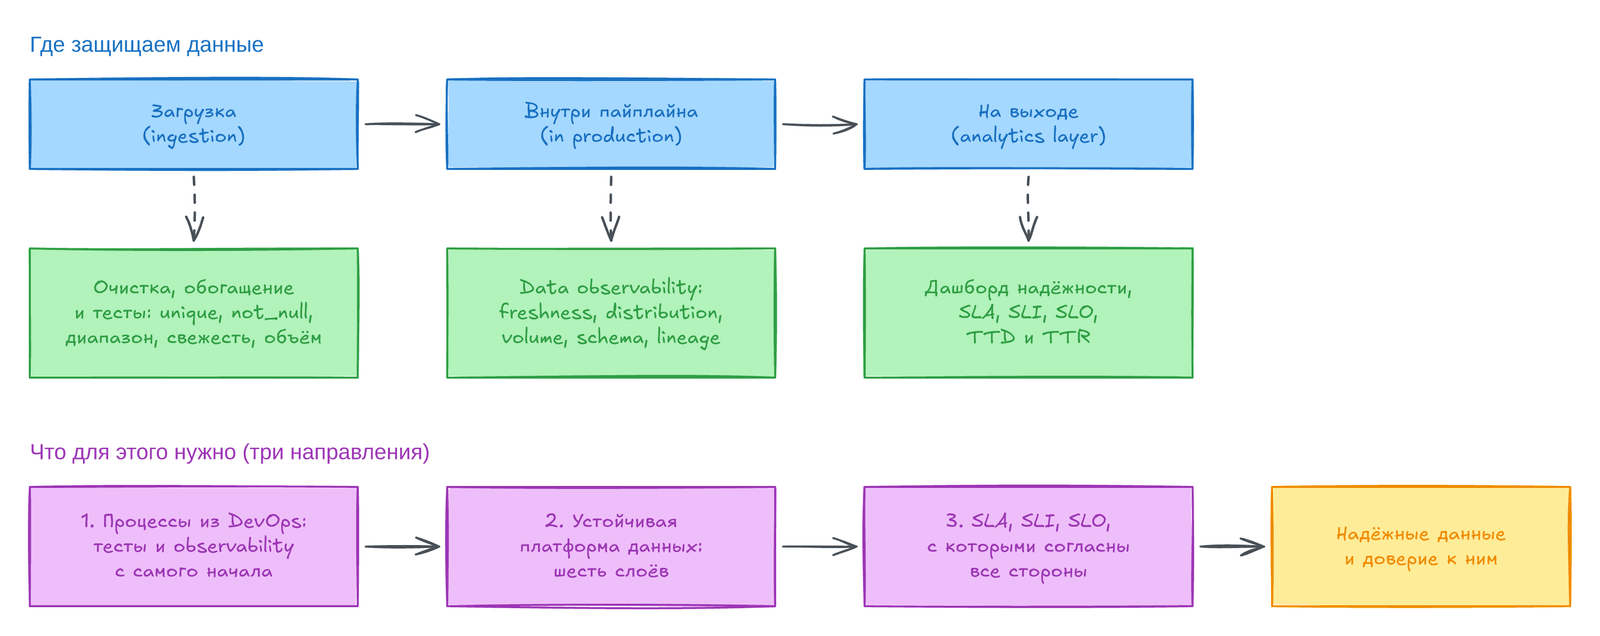
Сверху три этапа жизни данных, снизу — то, что нужно построить в организации. Глава 6 продолжит: как чинить инциденты.
Надёжность данных при загрузке
Заголовок раздела «Надёжность данных при загрузке»Решения хороши настолько, насколько хороши данные: «garbage in, garbage out». Ошибки бывают на любом шаге, но проще всего поймать их при загрузке (ingestion), пока они не пошли дальше. Поэтому компании вводят строгие стандарты для входящих данных. Практики:
- Очистка (
data cleaning): убрать неполные, лишние, неверные и повторяющиеся данные. Её часто делают дата-инженеры, но всё чаще за неё отвечают те, кто производит данные. Авторы просят объяснять всей компании, зачем это нужно. - Структурирование (
data wrangling): привести данные к нужному виду. - Обогащение (
data enrichment): добавить свои или чужие данные там, где их не хватает или они неточны. - Тесты (
data testing): после очистки это главная линия защиты.
Формат, согласованность, полноту, свежесть и уникальность проверяют инструменты.
Тесты данных
Заголовок раздела «Тесты данных»Data testing проверяет наши предположения о данных до production или во время неё. Простейшие тесты: значения уникальны (unique) и не пустые (not_null). Три типа тестов авторы описали в главе 3:
| Тип | Что проверяет |
|---|---|
| Unit | Что строка SQL делает своё дело, на очень малых данных |
| Functional | Большие наборы: валидацию, загрузку, ETL, внутри пайплайна |
| Integration | Что пайплайн выдаёт допустимые значения. Сначала на фейковых данных |
Типичные проверки: NULL, свежесть, объём (не стали ли 200 строк двумя тысячами), распределение, пропуски.
Пример авторов: вы — медиа-дистрибьютор, в наборе 500 строк (City, County, Price, Customers, Product). Три запроса проверяют, что в пайплайн идут только клиенты Берлина, что в City нет NULL и что цена между 4,50 и 8,50 $. Мы повторим это в практике ниже.
Тестировать утомительно: нужно знать, чего ждать от данных и как выглядят «плохие» данные. Эти ожидания называют утверждениями (assertions). Тесты обычно пишут сами аналитики и инженеры, а в некоторых компаниях есть команды Data Quality Assurance. Инструменты: Apache Griffin и Great Expectations; возможности тестов у dbt ограничены.
Как программист не выкладывает код без тестов, так дата-инженер не должен запускать пайплайн на непроверенных данных. Но тесты ловят только ожидаемое, а данные меняются и в production. Поэтому добавляют мониторинг и поиск аномалий из главы 4.
Качество данных внутри пайплайна
Заголовок раздела «Качество данных внутри пайплайна»В 1990-е упавший сайт почти не замечали. Сегодня замечают все: в январе 2021 года упал Slack, и многие компании остались без главного чата. Теперь почти каждая компания держит команду SRE (site reliability engineering): она следит, чтобы приложения работали всегда. С ростом систем (например, при переходе к микросервисам) нужна наблюдаемость (observability): мониторинг, отслеживание и обнаружение инцидентов. У неё три столпа:
- метрики: числа во времени;
- логи: текстовая запись о событии с временем;
- трейсы: причинно связанные события в распределённой системе.
Команды данных берут те же принципы. Данные «в production» — это хранилище или озеро, ETL и аналитический слой (на схеме платформы ниже это поток слева направо). У наблюдаемости данных (data observability) пять столпов:
| Столп | Вопрос |
|---|---|
| Freshness | Данные свежие? Когда их генерировали? Какие upstream-данные вошли? |
| Distribution | Значения в допустимых границах? Формат верный? Данные полные? |
| Volume | Всё ли пришло? |
| Schema | Как менялась схема? Кто менял и зачем? |
| Lineage | Какие источники и потребители у набора? Кто на него опирается? |
Простой данных (data downtime) — это период, когда данные пропали, неверны или неточны. Обычно это значит, что пайплайн сломан. Как SRE измеряют простой приложения во времени, так можно измерять и простой данных. Бизнес всё теснее связан с данными, и растёт спрос на объективные цифры: для многих команд хорошая отправная точка — измерять uptime и простой данных.
Качество данных на выходе
Заголовок раздела «Качество данных на выходе»Часто вы узнаёте о плохих данных только на аналитическом слое или даже позже, когда данные вернулись в приложения. Здесь качество можно отслеживать так:
- Дашборд надёжности:
TTD(time to detection, время до обнаружения),TTR(time to resolution, время до решения) и другие метрики. - SLA (service-level agreement): обещания клиентам и «наказание» за невыполненную цель, например, скидка 10% в следующем месяце.
- SLI (service-level indicator): конкретное число. В Slack SRE считают число ответов с кодом 200.
- SLO (service-level objective): целевое значение для SLI, например, успех 99% запросов, и так в 95% случаев.
- Net promoter score: довольны ли потребители данными (вовремя ли пришли, можно ли им верить).
Главное: договориться с потребителями, как они используют данные и что для них «надёжно». SLI должен быть очень конкретным: если эта оценка «слегка неверна», вся стратегия uptime может быть ошибочной. Покрыть тестами все наборы нельзя, но если согласовать, какие данные важны и для кого, вы закроете большую часть рисков.
Шесть измерений качества
Заголовок раздела «Шесть измерений качества»Традиционно качество измеряют ответственные за данные (data stewards) и руководители governance. По Data Management Association UK, у качества шесть измерений:
| Измерение | Вопрос |
|---|---|
Полнота (completeness) | Насколько данные полны? |
Своевременность (timeliness) | Данные пришли вовремя? |
Валидность (validity) | Формат, тип и диапазон в порядке? |
Точность (accuracy) | Данные соответствуют реальному миру? |
Согласованность (consistency) | Они совпадают с принятыми определениями? |
Уникальность (uniqueness) | Одна и та же точка не записана дважды? |
Инженеру они применимы не всегда. Например, точность: инженер обычно не видит конечный результат в бизнес-контексте, его зовут, когда что-то сломалось. На дашборде он чаще смотрит на:
- долю лишних или ошибочных данных (сколько из 1 ТБ данных пропущено, неточно или устарело);
- число
NULL(полноту) и процент дубликатов (уникальность): каждое показывает только одну сторону; - своевременность и согласованность формата значений;
- число команд, которые регулярно используют данные: важно для
data mesh.
Платформа данных
Заголовок раздела «Платформа данных»Надёжным данным нужна продуманная платформа: технологии, которые ведут данные от загрузки до аналитики. Она зависит от бизнеса: для e-commerce на 2000 человек она другая, чем для финтеха на 20. Но слои есть везде. Авторы выделяют шесть: ingestion, storage и processing, transformation и modeling, BI и analytics, discovery и governance, quality и observability.
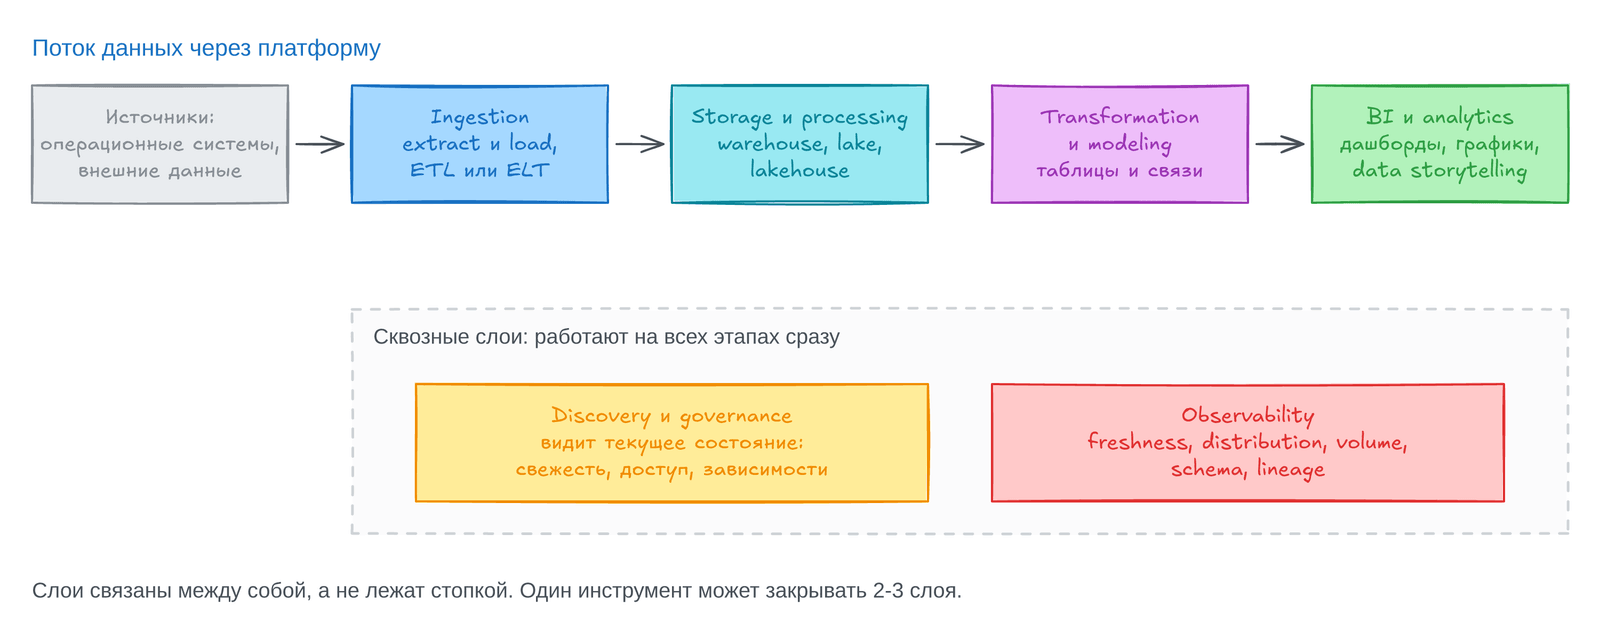
Слои связаны между собой, а не лежат стопкой, и приоритета между ними нет. Лучшие команды вкладываются в каждый, и один инструмент часто закрывает два-три слоя.
Загрузка данных
Заголовок раздела «Загрузка данных»Загрузка собирает структурированные и неструктурированные данные из многих источников. Это шаги extract и load в ETL и ELT. В ETL данные преобразуют до загрузки. Облачные хранилища умеют хранить «сырые» данные, поэтому появился ELT: загрузить сырое и преобразовать в конце. Инструменты бывают готовые, open source и самописные. Orchestration часто относят к загрузке, но авторы советуют добавлять её после хранения, обработки и BI: ей нужны уже работающие данные. Тестируйте на каждом шаге: проверенные при загрузке данные дальше могут испортиться.
Хранение и обработка
Заголовок раздела «Хранение и обработка»Здесь данные лежат и обрабатываются. Облако сделало это доступным и недорогим. Три типа:
- Хранилище (
data warehouse): полностью управляемое, требует схемы, поэтому гигиена данных строже с первой минуты. - Озеро (
data lake): обычно собрано командой из open source и готовых продуктов, поддерживает сырые данные и распределённые вычисления. - Lakehouse: гибрид, добавляет озеру SQL и схему или даёт хранилищу гибкость.
Выбор разный для каждой компании и меняется со временем.
Трансформация и моделирование
Заголовок раздела «Трансформация и моделирование»Это два разных процесса. Трансформация — подготовка сырых данных для анализа: профилирование, маппинг полей, генерация кода, его выполнение и проверка результата. Моделирование — поиск ключевых понятий и связей, в которых живёт бизнес-логика, и описание их таблицами. Раньше трансформацию делали инженеры на Python, R и SQL, теперь часть делают аналитики в no-code и low-code инструментах. Но основная работа у дата-инженеров, и там нужен не только SQL. Трансформация идёт пакетами (batch) или потоком (stream). Поток нужен, когда свежесть важнее точности (глава 3).
BI и аналитика
Заголовок раздела «BI и аналитика»Лучшие данные бесполезны, если бизнес не может ими пользоваться. Инструменты аналитики показывают данные в дашбордах, графиках и на картах: без них остаются миллионы строк в таблице. Следующий шаг: data storytelling, то есть рассказ о данных с контекстом и причинами трендов. Он развивается только при доступном self-serve BI.
Поиск и управление данными
Заголовок раздела «Поиск и управление данными»Раньше данные описывали каталоги (data catalog) — инвентарь метаданных. Они показывают, где лежат персональные данные и кто имеет доступ, поэтому нужны для governance и соблюдения законов. Но каталоги ручные, плохо масштабируются и плохо поддерживают неструктурированные данные.
Новый подход — это data discovery: динамичное понимание данных по тому, как их загружают, хранят, агрегируют и используют потребители домена. Governance остаётся общим для доменов, но discovery показывает текущее состояние, а не «каталожное». Discovery отвечает на вопросы: какой набор свежее и какие можно списать, когда таблицу обновляли и что значит поле. Он показывает, кто использует данные, какие у них зависимости, это production-данные или нет и выполняются ли мои предположения.
Доверие к данным: data observability
Заголовок раздела «Доверие к данным: data observability»Шестой слой авторы пропустили намеренно. Самый современный стек бесполезен, если данным нельзя верить. Первый шаг к доверию: понять текущее состояние данных, как это делают разработчики с помощью DevOps. Observability — это не последний шаг, а подход, охватывающий весь жизненный цикл: автоматический мониторинг, алерты и разбор инцидентов по пяти столпам. Хороший инструмент подключается к стеку, даёт сквозной lineage и следит за данными «на месте», не вынимая их из хранилища: так не страдают безопасность и соответствие требованиям. Аудиты и расследования утечек становятся проще.
ROI качества данных
Заголовок раздела «ROI качества данных»Плохие данные приводят к потере времени и выручки, создают риски и подрывают доверие. По опросу клиентов Monte Carlo, дата-сайентисты и инженеры тратят на «тушение пожаров» 40% времени и больше. Gartner оценивает потери от простоя данных больше чем в 15 млн $ в год. Свыше 88% американских компаний теряли деньги из-за качества данных, а каждая пятая потеряла клиента. Поэтому сначала измерьте ущерб и поймите, какие наборы важнее.
Цена простоя данных
Заголовок раздела «Цена простоя данных»Авторы берут из DevOps две метрики. TTD — это время, за которое команда замечает проблему. Часто это дни и даже месяцы: первыми простой замечают потребители, когда дашборд «выглядит странно». Долгое обнаружение стоит дорого: чем дольше, тем труднее восстановить данные перезапуском или backfill, и все решения на неверных данных нужно проверять заново. TTR — это время от алерта до решения. Оно зависит от сложности, наличия lineage, качества discovery и ресурсов. В деньгах разговор с руководством проще:
(TTD, часы + TTR, часы) × цена часа простоя = цена простоя данных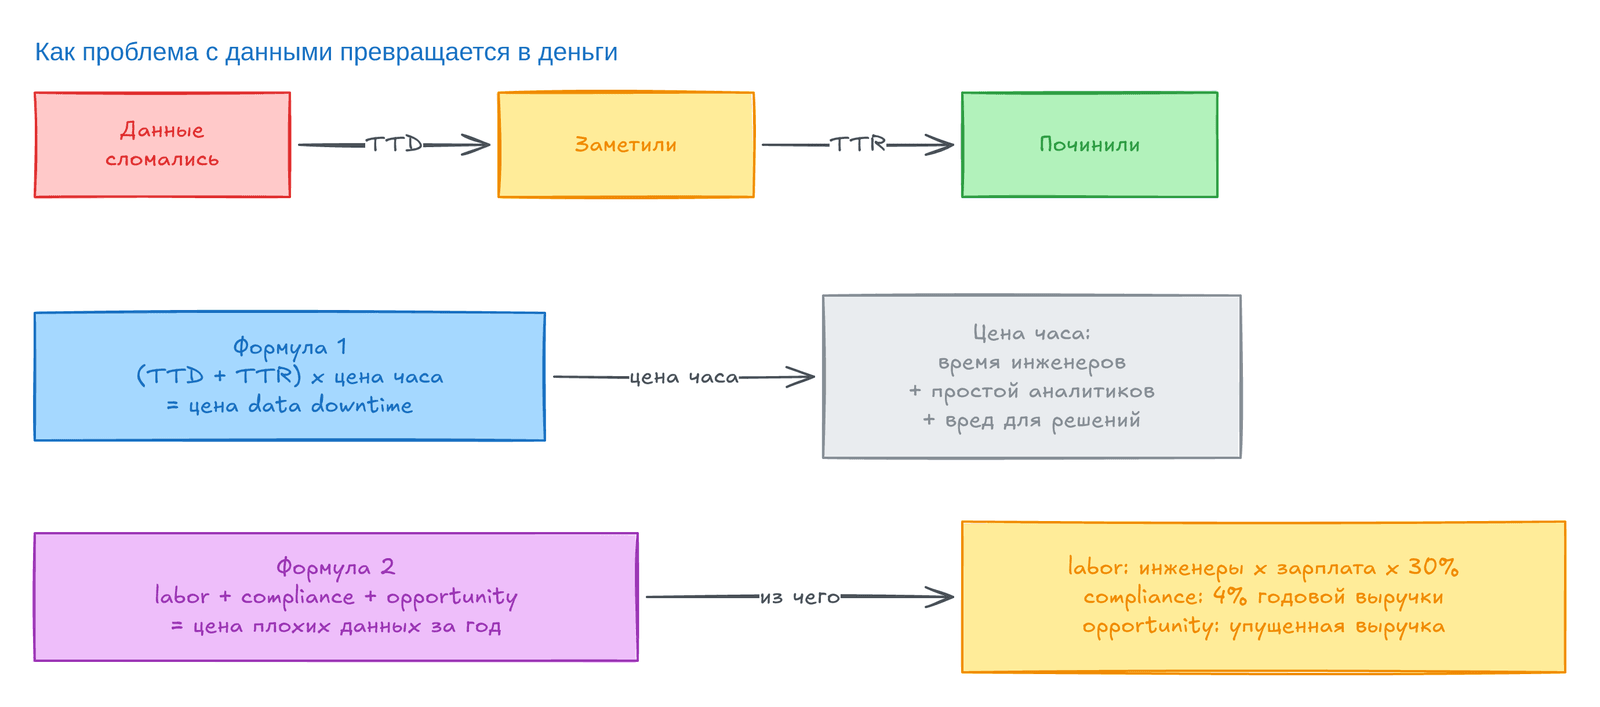
Цена часа включает время инженеров и влияние на потребителей. Инженер тратит четверть каждого часа простоя на разбор: при 59 $ в час это 14,75 $. Если вы отчитываетесь перед биржей, час неверной отчётности стоит тысячи долларов. Аналитики: 10 человек по 75 $ дают 750 $ в час. Допустим, пострадают четверо, поэтому цену снижают на 60%, до 300 $. При 100 часах простоя в месяц выходит 100 × 300 × 12 = 360 000 $ в год.
Пояснение: В книге написано «больше 420 000 $», но по этим числам выходит 360 000 $ (377 700 $ вместе со временем инженера). Мы считаем по формуле.
В эту сумму не входят упущенные возможности. Плохие данные часто не видны, пока не станет поздно, и бюджет заранее просить трудно. Но базовые TTD и TTR позволяют назвать ожидаемый эффект улучшений. Посчитаем в Python:
hourly = 59.0 * 0.25 + 75.0 * 10 * (1 - 0.60) # инженер + аналитикиone_incident = (36 + 6) * hourly # TTD = 36 ч, TTR = 6 чyear = 100 * 300 * 12 # 100 часов простоя в месяцСкрипт ch05_downtime_cost.py считает это и ещё несколько вещей. Запуск: python3 scripts/data-quality-fundamentals-code/ch05_downtime_cost.py. Вывод:
инженер: 14.75 $/час; аналитики: 750 -> 300 $/часодин инцидент: (36 + 6) x 314.75 = 13,219.50 $год, только аналитики: 100 x 300 x 12 = 360,000 $год, аналитики и инженер: 377,700 $labor 216,000 + compliance 2,000,000 + opportunity 500,000 = 2,716,000 $ в годSLO 99.00%: можно 1,296.0 минут простоя за кварталSLO 99.90%: можно 129.6 минут простоя за кварталSLO 99.99%: можно 13.0 минут простоя за кварталBlinkist: 50% от 240 часов = 120 часов в неделюПоправка на внешние факторы
Заголовок раздела «Поправка на внешние факторы»Годовую цену сломанных данных авторы считают так: труд, риск несоответствия законам (его оценивают средними штрафами GDPR) и упущенные возможности из-за потери доверия. По опросам более 150 команд, на проблемы качества уходит 30–40% времени.
labor + compliance risk + opportunity cost = годовая цена сломанных данныхLabor равен числу дата-инженеров, умноженному на зарплату и на 30%, а Compliance risk оценивается в 4% годовой выручки. Opportunity cost — это выручка, которую можно было получить, если бы команда работала быстрее. Это отправная точка: измерить цену — значит сделать первый шаг к пониманию последствий и их предотвращению.
SLA, SLO и SLI для данных
Заголовок раздела «SLA, SLO и SLI для данных»За образцом авторы снова идут к SRE. Несколько команд данных из интервью уже внедрили эти рамки, чтобы расставлять приоритеты и измерять надёжность. SLO определяют и измеряют SLA продукта, команды или поставщика, а также последствия его нарушения. Например, Slack обещает клиентам тарифа Plus и выше 99,99% uptime за квартал, иначе даёт кредиты на будущее.
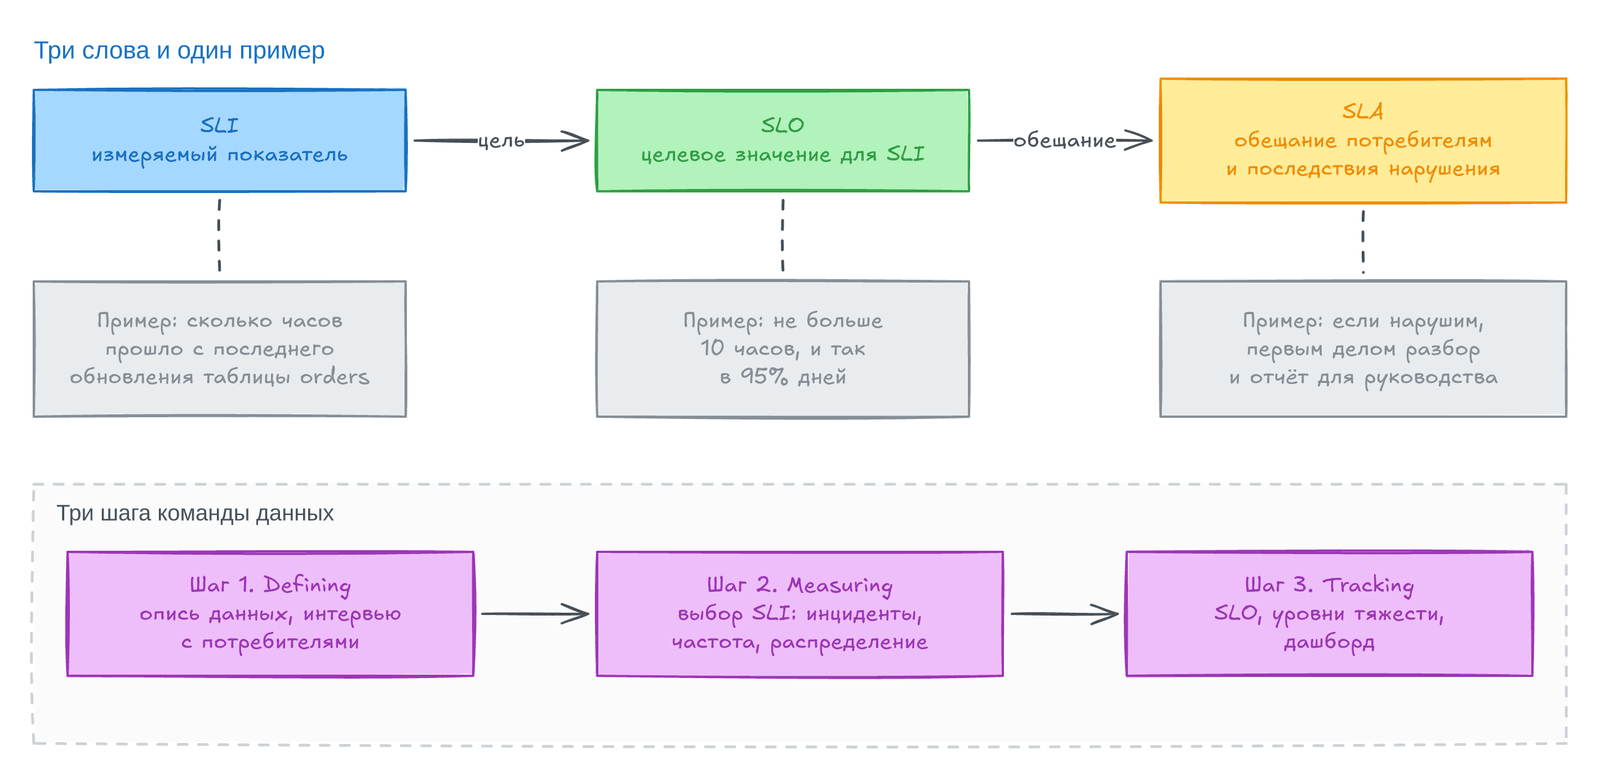
Внутренние SLO помогают разработке, продукту и бизнесу договориться, что важно. Запись SLO заменяет «все стараются держать uptime около 100%» ясными ожиданиями. Цель меньше 100% оставляет место для развития: без допуска на простой нет места для инноваций, а системы всё равно иногда ломаются. А с SLA инженеры знают, как и когда вмешаться. Цифры показывают цену цели: SLO 99,99% за квартал разрешает около 13 минут простоя, а SLO 99% — около 1296 минут (скрипт из предыдущего раздела это считает).
Для данных работает то же. SLA помогают выстроить доверие между данными, командой и потребителями. Без согласованных SLI потребители опираются на слухи. С SLO организация становится «data-driven» в отношении самих данных. Но SLA сам по себе ничего не стоит: нужно согласие производителей, инженеров, аналитиков и потребителей о том, сколько ресурсов уйдёт на соблюдение. SLA «ради SLA» без вложений ставят команду в плохую позицию. Вводите их так же, как KPI:
- Оцените бизнес-приоритеты.
- Поймите, как они связаны с данными и аналитикой.
- Выясните, насколько потребителю нужно высокое качество и насколько он терпит плохое.
- Задайте SLO и получите согласие заинтересованных сторон.
- Измеряйте SLO.
Для команд данных это три шага: определить, измерить, отслеживать.
Шаг 1. Определяем надёжность через SLA
Заголовок раздела «Шаг 1. Определяем надёжность через SLA»Сначала договоритесь, что значит «надёжные данные» для бизнеса. Начните с инвентаризации: какие данные, как и кем используются; прошлые показатели дадут базовую оценку. Затем соберите отзывы потребителей: инженеры далеки от их повседневной работы. Все стороны должны согласиться с определениями: например, 99% пользователей таблица X безразлична, а для 1% она — основа бизнеса. Технологии не заменят плохую культуру: SLA станут полезны, только когда их согласуют.
Шаг 2. Измеряем через SLI
Заголовок раздела «Шаг 2. Измеряем через SLI»SLI отражают согласованное состояние данных и то, как выглядит простой: пропущенные, дублированные или устаревшие данные. Примеры:
- число инцидентов с набором (для внешних источников оно вам неподконтрольно, но остаётся ключевым фактором простоя);
- частота обновления критичной таблицы (если таблица должна обновляться раз в 10 часов или чаще, знать это нужно и вам, и потребителям);
- ожидаемое распределение набора (выход за норму может иметь внешнюю причину, но разобраться стоит).
Шаг 3. Отслеживаем через SLO
Заголовок раздела «Шаг 3. Отслеживаем через SLO»SLO — это допустимые диапазоны простоя, и они должны опираться на реальность. Если вы отслеживаете TTD без автоматического мониторинга, SLO должен быть мягче, чем у зрелой команды с observability. Диапазоны дают единую шкалу тяжести инцидентов и быструю реакцию. Затем строят дашборды: свои или в специальных инструментах. Влияние на бизнес авторы советуют оценивать через простой данных.
Связь с инцидентами
Заголовок раздела «Связь с инцидентами»Когда случится инцидент, нужен способ сортировать и вести его, и тут снова помогает SRE. Пример: отчёт руководителя показывает устаревшие данные. Причина неизвестна, но нужно сообщить, что пайплайн сломан и команда занимается проблемой, и регулярно рассказывать о ходе работ коллегам и заинтересованным сторонам. Хорошая коммуникация сильно облегчает выполнение SLA.
Кейс Blinkist
Заголовок раздела «Кейс Blinkist»У Blinkist, сервиса подписки на электронные книги, больше 16 млн пользователей. Gopi Krishnamurthy, директор по инженерии, отвечал за дата-инженерию, инфраструктуру, рост и монетизацию.
Проблема началась с нехватки данных в реальном времени. Blinkist вкладывал в платный маркетинг (Facebook, Google), а те оптимизировали кампании по поведенческим данным из приложения. План на 2020 год: рост 40%. Но пандемия изменила жизнь аудитории, и старые данные перестали отражать реальность. Данные в реальном времени стали критичными и для рекламных бюджетов, и для понимания поведения в приложении (кампания про «поездки на работу» устарела). Руководство зависело от данных всё сильнее, а команда Gopi боролась с простоем: плохое качество, задержки дашбордов, сломанные пайплайны. «Каждый понедельник у нас был созвон с руководством, и почти каждый раз я объяснял, почему мы не растём», — вспоминает он. Команда тратила около 50% времени на «тушение пожаров». Так дальше было нельзя.
Основой перемен стали governance, качество данных и рефакторинг. Команда ввела строгие тесты и observability и начала отслеживать SLA и SLI. Gopi называет центром подхода data reliability engineering: надёжность данных — объект первого класса, как DevOps и SRE для разработки. Это позволило чинить простой раньше, чем он касался потребителей. Вместе с руководителями команда согласовала конкретные SLA.
Результат: экономия 120 часов в неделю для шести дата-инженеров. Заслугу за рост компании команда данных целиком не берёт, но прозрачность и observability улучшили выбор аудитории и каналов.
Пояснение: 120 часов равны 50% рабочего времени шести инженеров при 40-часовой неделе. Это почти всё время, которое команда тратила на «пожары».
Авторы напоминают: SLO и SLI сами ничего не улучшают. Команда Gopi выяснила, что важнее всего, задала SLI и SLO и приоритизировала проекты под них. Часто команды увлекаются метриками, но не выясняют, что мешает попасть в цели.
Итоги главы
Заголовок раздела «Итоги главы»- Проще всего ловить проблемы при загрузке: очистка, обогащение и тесты (
unique,not_null, диапазон, свежесть, объём). - Тесты ловят только ожидаемое. Для неизвестного нужны мониторинг и поиск аномалий.
- Внутри пайплайна работает observability с пятью столпами. Простой данных измеряют, как SRE измеряют простой приложений.
- Платформа состоит из шести связанных слоёв. Шестой, observability, проходит через все остальные.
- Цену плохих данных можно посчитать:
(TTD + TTR) × цена часаиlabor + compliance + opportunity. - SLI — показатель, SLO — цель для него, SLA — обещание потребителям. Цель не равна 100%.
- SLA вводят тремя шагами (определить, измерить, отслеживать) и только с согласия всех сторон.
- Blinkist сэкономил 120 часов в неделю, но важнее самих метрик работа с ними. Стратегия качества растёт постепенно.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
Data downtime | Периоды, когда данные пропали, неточны или ошибочны |
Assertions | Записанные ожидания: как должны выглядеть данные |
| Пять столпов | Freshness, distribution, volume, schema, lineage |
Data discovery | Понимание текущего состояния данных в домене |
TTD | Время от поломки до обнаружения |
TTR | Время от алерта до решения |
SLI, SLO, SLA | Показатель, цель для него, обещание потребителям |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Поставьте
unique,not_null, проверки диапазона, свежести и объёма на каждый критичный источник. Добавьте утверждения на каждом шаге пайплайна, не только на входе. - Добавьте к тестам мониторинг свежести, объёма, схемы и распределения.
- Не покрывайте все таблицы. Спросите потребителей, какие данные важны, и начните с них.
- Записывайте TTD и TTR каждого инцидента. Без базовых цифр бюджет не обосновать.
- Выбирайте SLI вместе с потребителями. SLO ставьте по текущему уровню, а не 100%.
- Решите, кто и как часто сообщает потребителям об инциденте.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. Повторим тесты при загрузке, посчитаем цену простоя, SLI и SLO.
Шаг 1. Создаём данные
Заголовок раздела «Шаг 1. Создаём данные»subscriptions — это наша версия набора из книги, с испорченными данными: пустые города, цены вне диапазона, три дубля. В incidents лежат три инцидента, а loads показывает возраст таблицы orders в 09:00 в течение 30 дней.
CREATE TABLE subscriptions ASSELECT i AS id,       CASE WHEN i % 50 = 0 THEN NULL            ELSE ['Berlin', 'Paris', 'Madrid', 'Rome'][1 + i % 4] END AS city,       CASE WHEN i % 100 = 7 THEN 12.00            WHEN i % 100 = 8 THEN 1.00            ELSE 4.99 + i % 4 END AS priceFROM generate_series(1, 500) t(i);
-- три дубля: строки с id 10, 20, 30 загрузились дваждыINSERT INTO subscriptions SELECT * FROM subscriptions WHERE id IN (10, 20, 30);
CREATE TABLE incidents ASSELECT * FROM (VALUES  (1, 'orders',    TIMESTAMP '2026-03-02 02:00', TIMESTAMP '2026-03-03 14:00', TIMESTAMP '2026-03-03 20:00'),  (2, 'payments',  TIMESTAMP '2026-03-10 01:00', TIMESTAMP '2026-03-10 09:00', TIMESTAMP '2026-03-10 11:00'),  (3, 'customers', TIMESTAMP '2026-03-18 03:00', TIMESTAMP '2026-03-21 03:00', TIMESTAMP '2026-03-21 09:00')) t(incident_id, table_name, started_at, detected_at, resolved_at);
-- возраст таблицы orders в 09:00 каждого дня (часов с последнего обновления)CREATE TABLE loads ASSELECT DATE '2026-03-01' + i::INTEGER AS load_date, 2 + (i * 7) % 11 AS age_hoursFROM range(30) t(i);
Шаг 2. Проверяем данные при загрузке
Заголовок раздела «Шаг 2. Проверяем данные при загрузке»Каждая строка — это один тест. В колонке failed должны быть нули.
SELECT 'not_null: city' AS test, count(*) AS failed FROM subscriptions WHERE city IS NULLUNION ALL SELECT 'unique: id', count(*) - count(DISTINCT id) FROM subscriptionsUNION ALL SELECT 'range: price 4.50..8.50', count(*) FROM subscriptions WHERE price <= 4.50 OR price >= 8.50UNION ALL SELECT 'volume: ждём 500 строк', abs(count(*) - 500) FROM subscriptions;┌─────────────────────────┬────────┐│ test │ failed ││ varchar │ int64 │├─────────────────────────┼────────┤│ not_null: city │ 10 ││ unique: id │ 3 ││ range: price 4.50..8.50 │ 10 ││ volume: ждём 500 строк │ 3 │└─────────────────────────┴────────┘Все тесты красные: данные испорчены специально.
Задания
Заголовок раздела «Задания»Задание 1. Найдите id дублей и число копий.
Решение
SELECT id, count(*) AS copies FROM subscriptions GROUP BY id HAVING count(*) > 1 ORDER BY id;┌───────┬────────┐│ id │ copies ││ int64 │ int64 │├───────┼────────┤│ 10 │ 2 ││ 20 │ 2 ││ 30 │ 2 │└───────┴────────┘Тест unique показал только число лишних строк (3), а здесь видно, какие именно.
Задание 2. Для каждого инцидента посчитайте TTD, TTR в часах и цену простоя при цене часа 314,75 $ (14,75 $ — инженер и 300 $ — аналитики).
Решение
SELECT incident_id, table_name, date_diff('minute', started_at, detected_at) / 60.0 AS ttd_hours, date_diff('minute', detected_at, resolved_at) / 60.0 AS ttr_hours, round((date_diff('minute', started_at, resolved_at) / 60.0) * 314.75, 2) AS downtime_costFROM incidents ORDER BY incident_id;┌─────────────┬────────────┬───────────┬───────────┬───────────────┐│ incident_id │ table_name │ ttd_hours │ ttr_hours │ downtime_cost ││ int32 │ varchar │ double │ double │ double │├─────────────┼────────────┼───────────┼───────────┼───────────────┤│ 1 │ orders │ 36.0 │ 6.0 │ 13219.5 ││ 2 │ payments │ 8.0 │ 2.0 │ 3147.5 ││ 3 │ customers │ 72.0 │ 6.0 │ 24550.5 │└─────────────┴────────────┴───────────┴───────────┴───────────────┘Самый дорогой — инцидент 3: его заметили через 72 часа. Здесь TTD влияет на цену сильнее, чем TTR.
Задание 3. SLI — это доля дней, когда таблица была не старше 10 часов. SLO равен 95%. Выполнен ли он?
Решение
SELECT count(*) AS days, count(*) FILTER (WHERE age_hours <= 10) AS fresh_days, round(100.0 * count(*) FILTER (WHERE age_hours <= 10) / count(*), 1) AS sli_pct, CASE WHEN 100.0 * count(*) FILTER (WHERE age_hours <= 10) / count(*) >= 95 THEN 'SLO выполнен' ELSE 'SLO нарушен' END AS verdictFROM loads;┌───────┬────────────┬─────────┬─────────────┐│ days │ fresh_days │ sli_pct │ verdict ││ int64 │ int64 │ double │ varchar │├───────┼────────────┼─────────┼─────────────┤│ 30 │ 24 │ 80.0 │ SLO нарушен │└───────┴────────────┴─────────┴─────────────┘SLI равен 80%, цель — 95%: SLO нарушен. Теперь с потребителями можно говорить цифрами.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему проблемы лучше ловить при загрузке и почему этого мало?
- Чем data testing отличается от data observability?
- Зачем ставить SLO меньше 100%?
- Как посчитать цену простоя данных и почему TTD часто важнее TTR?
- Почему SLA нельзя «назначить» без потребителей?
- Чем data discovery отличается от каталога данных?
Предыдущая: Глава 4. Мониторинг и поиск аномалий в пайплайнах. Следующая: Глава 6. Как чинить проблемы с качеством данных в масштабе.