

Data Quality Fundamentals, глава 6: Как чинить проблемы с качеством данных в масштабе
Главная мысль: Найти проблему в данных мало. Нужен повторяемый процесс: обнаружить инцидент, разобраться, исправить, провести разбор без поиска виноватых и не дать инциденту повториться. Авторы берут этот процесс из DevOps и SRE. Они добавляют роль incident commander и пять шагов поиска первопричины.
О чём глава
Заголовок раздела «О чём глава»Что делать, когда алерт уже сработал? В главе 5 мы строили надёжные пайплайны. Эта глава о том, как справляться с поломками, которые всё равно случаются. Темы главы:
- чему учит DevOps и что такое жизненный цикл надёжности данных;
- пять этапов работы с инцидентом: обнаружение, реакция,
root cause analysis, исправление, разбор; - профилактика: тесты, CI/CD,
discovery,observability; - роль
incident commander, оценка серьёзности,SLOиSLI; - кейс PagerDuty.
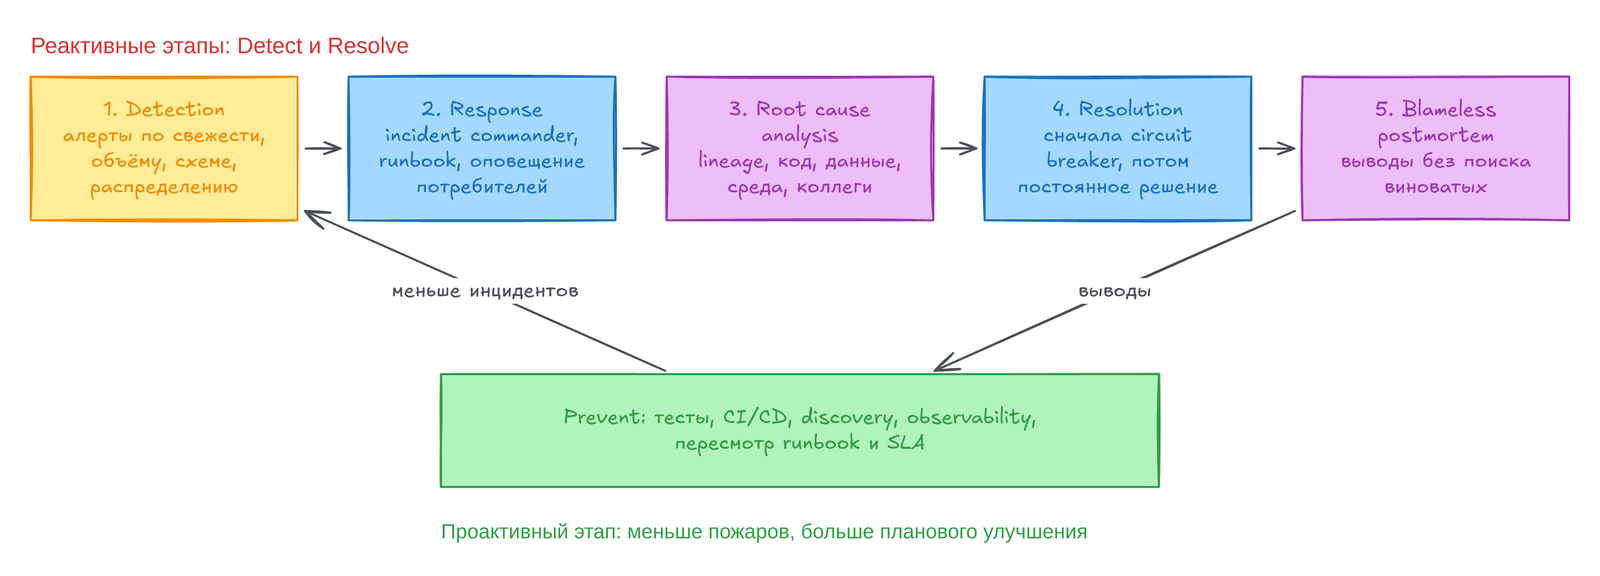
Схема показывает путь одного инцидента: пять первых этапов реактивные, а этап Prevent проактивный и замыкает цикл.
Как чинят проблемы в разработке ПО
Заголовок раздела «Как чинят проблемы в разработке ПО»Пятница, 17:00. Финансовый директор пишет, что в квартальном отчёте неверные числа. Семь часов уходит на поиск причины: в исходной таблице изменилась схема. Что дальше? Для большинства команд найденная причина — только начало пути к доверию.
Авторы предлагают не изобретать процесс заново. В DevOps есть непрерывный цикл из восьми этапов: Plan, Code, Build, Test, Release, Deploy, Operate, Monitor. Многие приёмы из разработки ПО уже прижились в данных: тесты, SLA, распределённые архитектуры. Но качество данных мы всё ещё чаще чиним реактивно, и это мешает масштабировать аналитику.
Google SRE Handbook напоминает: если реакцию на инцидент не продумать заранее, в реальной аварии принципы быстро забываются. Incident management — это процесс, в котором вы находите проблему, ищете первопричину, исправляете, анализируете и предотвращаете повторение.
Управление инцидентами с данными
Заголовок раздела «Управление инцидентами с данными»Франсиско Альберини, бывший product manager в Segment, вспоминает: когда данные ломались, он писал одному инженеру, который помнил всё. Если инженер был занят, сам он часами вручную проверял тысячи таблиц. Это не масштабируется.
Авторы предлагают data reliability life cycle, вариант цикла DevOps для данных. В нём три группы действий:
- Detect: собирать данные, мониторить, поднимать алерты.
- Resolve: оценить ущерб, сообщить о нём, восстановить данные.
- Prevent: подправить процессы, оценить результат, пересмотреть подход.
В рабочем виде это пять шагов: обнаружение, реакция, root cause analysis (RCA), исправление и blameless postmortem.
Обнаружение инцидента
Заголовок раздела «Обнаружение инцидента»Данные нужно тестировать до production. Но плохие данные всё равно просочатся, и тогда нужны мониторинг и алерты. Их задают вручную порогами или получают из решения для поиска аномалий (anomaly detection) либо для data observability: оно сравнивает данные с историей и вашими правилами.
Ключевая часть обнаружения — поиск отклонений в «столпах здоровья» (объём, свежесть, схема и распределение). Он ценнее, когда охватывает всю платформу: хранилище, озеро, ETL, BI. Хороший детектор настраивают так, чтобы было меньше шума и ложных срабатываний (баланс precision и recall). Как строить детекторы, мы разбирали в главе 4.
Авторы предупреждают: команды надеются, что поиск аномалий решит всё. Это не так. Во-первых, инциденты нельзя «решить» навсегда: пайплайны будут ломаться, а null появляться в неудобный момент. Во-вторых, если полагаться только на обнаружение, оно становится единственной точкой отказа. Нужны ещё реакция, исправление и профилактика. Anomaly detection — инструмент, а не серебряная пуля.
Авторы поясняют это сравнением. Водитель говорит механику: «С машиной что-то не так». Механик часами ищет разболтанную свечу. Алерт «что-то сломалось» похож на эту фразу. Руководитель аналитики из крупной компании сказал Барр Мозес: алерт нужен как начало, но важнее знать, что сломалось, кого это задело, почему и где.
Реакция
Заголовок раздела «Реакция»Хорошая реакция начинается и заканчивается коммуникацией. Большую часть коммуникации можно подготовить заранее и автоматизировать через PagerDuty и Slack. Команда пишет два вида документов:
runbook: инструкции по сервисам и частым проблемам;playbook: пошаговый процесс действий при инциденте.
В них есть ссылки на код и документацию, а главное — распределение ролей при аварии. В SRE для этого есть дежурство (on-call): роли закрепляют по сервисам, обычно на час, день или неделю. Кроме исполнителя (incident responder) есть incident commander. Он раздаёт задачи, собирает информацию и сообщает о проблеме потребителям выше и ниже по потоку.
Метаданные с бизнес-контекстом показывают, какие команды затронуты. Вместе со сквозным lineage (см. главу 7) это даёт карту связей за минуты, а не за часы ручной рисовки.
Root cause analysis
Заголовок раздела «Root cause analysis»В теории RCA проста: несколько SQL-запросов по сегментам. На практике инцидент затрагивает много таблиц, иногда сотни. Например, данные устарели: причиной может быть задача в очереди, тайм-аут, партнёр, не доставивший файл, или смена расписания, из-за которой задача пропала из DAG.
По опыту авторов, почти всё сводится к трём источникам:
- неожиданное изменение во входных данных;
- изменение логики трансформации (ETL, SQL, Spark);
- проблема среды: ошибка запуска, права, сбой инфраструктуры, смена расписания.
Причина редко одна. Чаще это сочетание причин, и из него можно извлечь уроки для процессов. Помогает метод «пять почему» (five whys) из Amazon: назовите проблему, спросите, почему она случилась, и запишите ответ. Решите, корень ли это: можно ли было предотвратить или заранее обнаружить причину? Если причина в ошибке человека, почему она была возможна? Повторяйте, считая причину новой проблемой, пока не найдёте корни. Если проверки не поймали проблему заранее, это признак того, что они недостаточны.
Дальше авторы дают пять шагов RCA на примере сломанного дашборда клиентов.
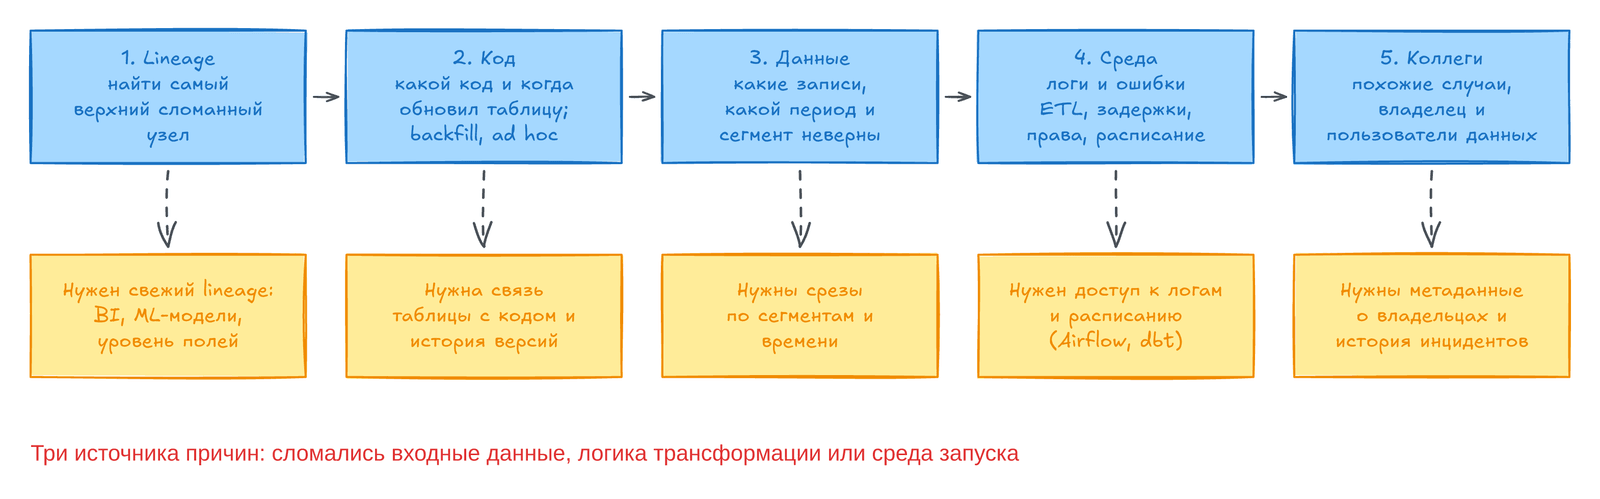
Под каждым шагом показано, что нужно команде.
Шаг 1. Посмотрите на lineage
Заголовок раздела «Шаг 1. Посмотрите на lineage»Найдите самый верхний по потоку узел, где проблема уже видна: там она и началась. В плохой день это источник за много шагов от дашборда. Тогда придётся идти вверх по DAG, а потом делать backfill. У всех, кто разбирает проблему, должен быть доступ к свежему lineage с BI-отчётами, ML-моделями и reverse ETL. Хорошо, если есть lineage на уровне полей.
Шаг 2. Посмотрите на код
Заголовок раздела «Шаг 2. Посмотрите на код»Найдите, как эту таблицу создаёт ETL или ELT. Какой код обновлял её последним и когда? Менялась ли логика? Были ли ручные записи (ad hoc writes) или backfill? Нужно знать код таким, каким он был при последнем обновлении.
Шаг 3. Посмотрите на данные
Заголовок раздела «Шаг 3. Посмотрите на данные»Неверны все записи или часть? Какой период? Какой сегмент, например только Android или заказы из Франции? Есть ли новые или пропавшие сегменты? Менялась ли схема? Не стали ли доллары центами, а время PST временем EST?
Полезный приём: смотреть, как другие поля связаны с аномалией. Команда Лиора увидела, что в важной таблице users вырос процент null в user_interests. Этот процент разложили по полю source (Twitter, Facebook, Google). Возможны два вывода:
- выросла доля записей из Twitter, а у него null и так больше. Тогда это сезонность или удачная кампания;
- доля Twitter прежняя, но null внутри Twitter вырос. Тогда это ошибка обработки данных Twitter, и искать нужно там.
Оба варианта объясняют рост null, но ведут к разным действиям. Статистика помогает, но это лишь часть RCA. Этот пример мы воспроизведём в практике ниже.
Шаг 4. Посмотрите на среду запуска
Заголовок раздела «Шаг 4. Посмотрите на среду запуска»Если данные в порядке, посмотрите на среду, где работают ETL/ELT-задачи (например, dbt). Были ли ошибки, задержки старта или долгие запросы? Менялись ли права, сеть, инфраструктура? Не убрали ли задачу из расписания? Для этого нужен доступ к логам и расписанию, например в Airflow.
Шаг 5. Подключите коллег
Заголовок раздела «Шаг 5. Подключите коллег»Прежде чем писать в Slack, спросите себя: были ли похожие случаи и как их решали? Кто владеет набором данных? Кто его использует? Ответы дают метаданные о владельцах и использовании, а также история прошлых инцидентов.
Авторы подводят итог: поломку редко можно свести к одной причине. Пять шагов делают RCA устойчивой практикой, а инженер, который «знает всё», получает передышку.
Исправление
Заголовок раздела «Исправление»Когда проблема найдена и ущерб понятен, её исправляют и сообщают участникам следующие шаги. Иногда это происходит ещё до RCA. Простейший вариант: остановить пайплайн или модель и перезапустить. Но данные ломаются по миллиону причин, поэтому часто нужна диагностика.
Часто решений два. «Начальное» — остановить пайплайн через circuit breaker (см. главу 3). «Финальное» — постоянное исправление причины. Статус инцидента публикуйте в выделенном канале Slack, wiki, документе или задаче JIRA. После исправления сообщите пострадавшим о дальнейших шагах и назначьте postmortem через несколько дней.
Blameless postmortem
Заголовок раздела «Blameless postmortem»Бывший SRE из Box и Slack сказал авторам: при любом инциденте виновата система, а не человек, написавший код. Хорошая система устойчива к ошибкам людей. То же верно для данных: пайплайны должны быть отказоустойчивыми и учитывать как known unknowns, так и unknown unknowns.
После исправления и RCA команда проводит кросс-функциональный postmortem: встречу и документ с хронологией, участниками, технологиями и последствиями. Он нужен, чтобы рассказать о результатах и чтобы действовать упреждающе. Рекомендации авторов:
- Говорите об обучении, а не о вине. Разбор должен быть
blameless. Поиск виноватых не укрепляет доверие. Когда цель — обучение и улучшение, проще заранее принять организационные и технические меры. - Оцените готовность к следующим инцидентам. Обновите runbook, мониторинг, алерты. В runbook запишите, кто чем владеет и когда запускаются задачи.
- Документируйте разбор и делитесь им. Без записи знания уходят вместе с инженером.
- Пересмотрите SLA.
SLA,SLIиSLO, разумные полгода назад, сегодня могут не подходить. Команда должна первой это заметить и сообщить потребителям.
Без понимания, как и почему возникает data downtime, устойчивость не улучшить.
Реакция на инциденты и их предотвращение
Заголовок раздела «Реакция на инциденты и их предотвращение»Процесс управления инцидентами — только первый шаг. Тесты закрывают known unknowns. А unknown unknowns? По оценке авторов, тесты ловят около 20% таких проблем. Остальные 80% находят недовольные коллеги, которые пишут про «сломанный отчёт».
Detect и Resolve — реактивные этапы цикла. Prevent — проактивный, он сокращает время на «тушение пожаров». Для него авторы советуют data reliability stack: слои тестов, CI/CD, discovery и observability.
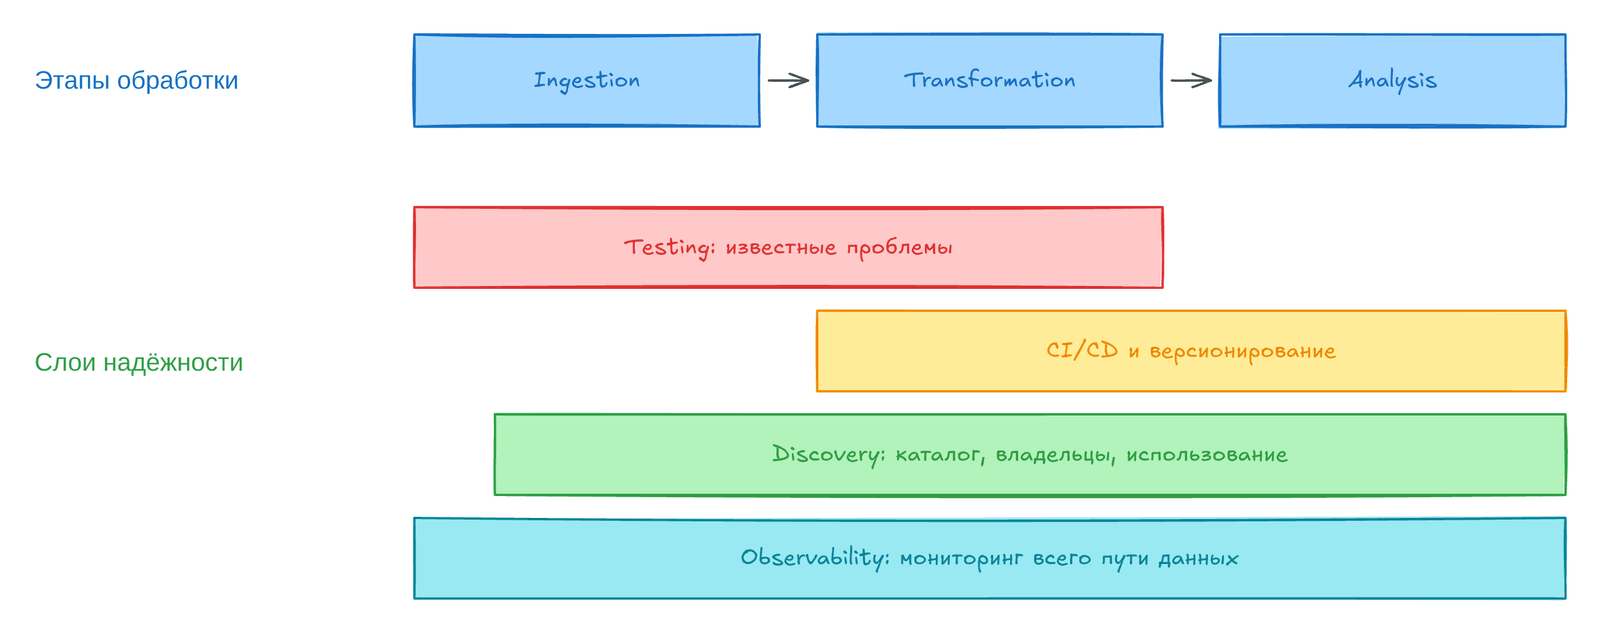
Testing стоит ближе к входу и трансформации, а CI/CD и версионирование защищают изменения кода. Discovery показывает владельцев и использование, а observability следит за всем путём. Слои подходят любой архитектуре: централизованной, распределённой или гибридной.
Рутина управления инцидентами
Заголовок раздела «Рутина управления инцидентами»Часто на дата-инженера ложится не только исправление, но и приоритизация, и коммуникация, а на вопрос «кто ведёт этот инцидент?» нет ответа. За SLA отвечает вся команда, но решения должен принимать конкретный человек. Это incident commander. Его задачи:
- рано и часто сообщать об инциденте команде и заинтересованным лицам;
- вести список затронутых объектов и аномалий;
- координировать работу и раздавать задачи;
- распространять runbook и playbook;
- оценивать серьёзность и влияние.
Командиров назначают по очереди на неделю или день либо закрепляют за наборами данных. Это в основном вопрос культуры: автоматизация и контроль состояния данных дают многое, а остальное — обучение. Каждый командир делает четыре шага.
Шаг 1. Направьте уведомления нужным людям
Заголовок раздела «Шаг 1. Направьте уведомления нужным людям»Всё зависит от устройства команды данных.
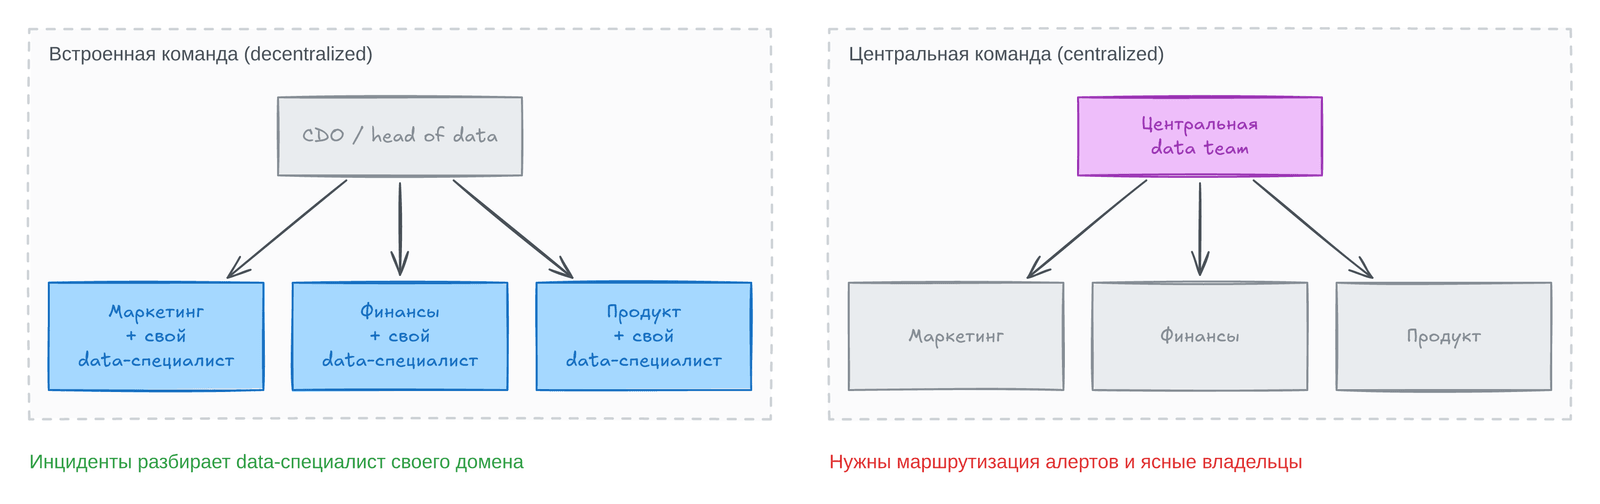
- Встроенная (decentralized) команда. Специалисты работают в бизнес-юнитах: например, маркетинговая команда владеет всеми маркетинговыми пайплайнами. Здесь реакцию делегировать проще, а такие люди подчиняются руководителю юнита или
CDO(chief data officer). - Центральная (centralized) команда. Она подчиняется CDO и принимает инциденты от многих юнитов. Маршрутизацию алертов надо продумать заранее. Плюсы и минусы обоих вариантов мы увидим в главе 8.
В любом случае заведите отдельные каналы Slack для пайплайнов и пригласите туда заинтересованных людей. Многие команды настраивают также PagerDuty или Opsgenie.
Шаг 2. Оцените серьёзность
Заголовок раздела «Шаг 2. Оцените серьёзность»Часть изменений безвредна, например ожидаемая смена схемы. Другие опасны: в важной таблице было 10 000 строк, стало 1 000. Помечайте статус инцидента: fixed, expected, investigating, no action needed, false positive. Метки помогают оценить серьёзность и сообщать обновления в нужные каналы.
А если сломался ненужный или устаревший набор? Авторы называют это phantom data: после разбора выясняется, что данные месяцами никто не использовал, а команда потратила часы. Чтобы понять, что важно, команды смотрят lineage и аналитику использования (operational analytics): какие пайплайны ломаются чаще, сколько стоит хранение. Это дают решения data observability. Если сломались данные для финансовой отчётности, приоритет очень высокий. Если нет, переходите к другим задачам.
Шаг 3. Сообщайте о статусе как можно чаще
Заголовок раздела «Шаг 3. Сообщайте о статусе как можно чаще»Здесь помогает runbook: он закрепляет зоны ответственности и сокращает дублирование работы. Когда «кто что делает» ясно, заведите страницу статуса, чтобы заинтересованные видели обновления в реальном времени. Авторы видели два способа делегирования:
- Дежурный. Один человек отвечает за все инциденты в период. Иногда это постоянная работа, иногда ротация раз в неделю.
- Закреплённые таблицы. Самый частый вариант. Каждый отвечает за инциденты по своим таблицам или отчётам наряду с обычной работой.
Подойдёт любой вариант: выбирайте по структуре команды, ресурсам и приоритетам.
Шаг 4. Согласуйте SLO и SLI
Заголовок раздела «Шаг 4. Согласуйте SLO и SLI»Commander не устанавливает SLO, но отвечает за их выполнение. Пример Slack: клиентам тарифа Plus и выше обещают 99,99% доступности за квартал и не больше 10 часов плановой недоступности. Если обещание нарушено, клиенты получают кредиты.
Пояснение:
SLA— внешнее обещание клиенту.SLO— внутренняя цель команды.SLI— метрика, по которой это измеряют. В тексте главы эти слова местами смешаны, мы держим такое разделение.
Какие SLI брать, зависит от задачи. Авторы напоминают три метрики из главы 5:
- N: число инцидентов с конкретным объектом. Вы часто не влияете на него из-за внешних источников, но измерять стоит.
- Time to detection (
TTD): сколько проходит от проблемы до алерта. Без хорошего обнаружения это недели или месяцы, а «тихие ошибки» ведут к дорогим решениям. - Time to resolution (
TTR): сколько проходит от алерта до исправления.
Снижая TTD и TTR, команда делает системы надёжнее.
Почему нужны data incident commanders
Заголовок раздела «Почему нужны data incident commanders»В инцидентах время и враг, и союзник. Команды пишут много тестов, а пайплайны всё равно ломаются. Командир с понятными процессами, небольшой автоматизацией и поддержкой организации заметно повышает надёжность.
Кейс: управление инцидентами в PagerDuty
Заголовок раздела «Кейс: управление инцидентами в PagerDuty»PagerDuty помогает более чем 16 800 компаниям в 90 странах выполнять SLA по доступности. Авторы поговорили с Ману Раджем, старшим директором по платформе данных и аналитике. Его команда называется DataDuty.
Ландшафт DataOps в PagerDuty
Заголовок раздела «Ландшафт DataOps в PagerDuty»Задача платформы — давать клиентам доверенные данные в любое время. Клиентами команды служат почти все отделы компании. В стеке есть PagerDuty (команда «ест свой собственный корм»), Snowflake, Fivetran, Segment, Mulesoft, AWS, Monte Carlo, Databricks. Недавно добавили data observability на основе ML.
Проблемы с данными в PagerDuty
Заголовок раздела «Проблемы с данными в PagerDuty»Как у многих SaaS-компаний, данные приходят из облачных приложений (Salesforce, Marketo, Netsuite) и внешних источников, в разных форматах и с разной частотой. Главная проблема: качество должно отвечать ожиданиям пользователей, а потребности бизнеса меняются каждый квартал.
Практики DevOps для масштабирования
Заголовок раздела «Практики DevOps для масштабирования»Команда внедрила три практики DevOps.
- Охватывайте весь жизненный цикл данных. Управление инцидентами дата-инженеров входит в
data operations, расширение DevOps. Оно покрывает проблемы и данных, и пайплайнов: аномалии, свежесть, схему, тренды метрик. Проверки в ETL со временем трудно поддерживать, и они не видят проблем в трендах данных. Поэтому для хранилища нужна observability. - Подавляйте шум. Среди алертов много сигналов об изменении данных, которые не означают новой проблемы. Качество системы алертов оценивают отношением шума к сигналу: чем оно ниже, тем лучше. DataDuty использует PagerDuty, чтобы находить похожие алерты и объединять несколько алертов одного инцидента в один.
- Группируйте объекты и инциденты для умной маршрутизации.
Data observability, по словам Ману, — первый шаг перед любым управлением инцидентами: «данные не обновились» и «странный тренд» — разные проблемы. Команда сгруппировала проблемы пайплайнов и настроила сортировку и алерты поверх этого. Алерты Airflow тоже идут через PagerDuty. Критичные объекты (отчётность для руководства и финансовая) идут с политикой эскалации и в BI-команду. Метрики BI (число клиентов, отток, число инцидентов с данными) тоже под алертами.
Итоги главы
Заголовок раздела «Итоги главы»- Инцидент с данными нужно вести как инцидент в ПО: обнаружить, отреагировать, найти причину, исправить и провести разбор.
- Цикл надёжности состоит из Detect, Resolve и Prevent. Первые два реактивные, третий проактивный.
- Поиск аномалий нужен, но один он даёт единственную точку отказа. Нужны ещё реакция, RCA и профилактика.
- Причины почти всегда в трёх местах: входные данные, логика трансформации, среда запуска. Причин часто несколько.
- RCA идёт в пять шагов: lineage, код, данные, среда, коллеги. Метод
five whysпомогает дойти до корня. - Разбор должен быть
blameless: виновата система, а не человек. Результат записывают и делят с командой. - Тесты ловят около 20% unknown unknowns. Остальное нужно ловить через CI/CD,
discoveryиobservability. Incident commanderведёт инцидент и оценивает серьёзность. Прогресс видно поN,TTDиTTR.- PagerDuty показывает три практики: охватывать весь жизненный цикл, подавлять шум и группировать алерты для маршрутизации.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
data reliability life cycle | Цикл Detect, Resolve, Prevent для надёжности данных |
incident commander | Человек, который ведёт инцидент от начала до конца |
runbook, playbook | Инструкция по сервисам и пошаговый процесс реакции |
поиск первопричины (root cause analysis) | Разбор: почему на самом деле сломались данные |
five whys | Метод: повторять «почему?», пока не найден корень |
blameless postmortem | Разбор инцидента без поиска виноватых |
circuit breaker | Останавливает пайплайн, чтобы плохие данные не пошли дальше |
SLA, SLO, SLI | Обещание клиентам, внутренняя цель и метрика |
TTD, TTR | Время до обнаружения и время до исправления |
phantom data | Данные, которые сломались, но бизнесу не нужны |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Заведите
runbookдля важных пайплайнов: владелец, расписание, где логи, кого оповестить. - Назначьте дежурного по данным на неделю. Пусть его имя будет в канале алертов.
- Ведите журнал инцидентов с метками: началось, обнаружили, исправили. Считайте
TTDиTTR. - При разборе аномалии сначала режьте данные по сегментам и периодам.
- Пишите разбор после серьёзного инцидента: хронология, причина, действия, без имён виноватых.
- Группируйте алерты одного пайплайна в один инцидент.
Практика на Python
Заголовок раздела «Практика на Python»Три маленьких примера на цифрах. Данные заданы в коде, сторонние библиотеки не нужны. Запуск: python3 scripts/data-quality-fundamentals-code/<файл>.
Шаг 3 RCA: смотрим на данные по сегментам
Заголовок раздела «Шаг 3 RCA: смотрим на данные по сегментам»Доля null в user_interests выросла с 16,7% до 23–24%. Скрипт ch06_rca_segments.py считает долю каждого источника и долю null внутри него в двух сценариях.
Прошлая неделя : null всего = 16.7%  twitter   доля записей 19.9%   null внутри 41.0%  facebook  доля записей 40.2%   null внутри 10.5%  google    доля записей 39.9%   null внутри 10.8%
Сценарий 1     : null всего = 23.4%  twitter   доля записей 45.1%   null внутри 39.9%  facebook  доля записей 27.1%   null внутри  9.9%  google    доля записей 27.8%   null внутри  9.6%  -> изменилась доля twitter, null внутри источников прежний: сезон или кампания
Сценарий 2     : null всего = 23.9%  twitter   доля записей 19.7%   null внутри 80.4%  facebook  доля записей 40.2%   null внутри 10.2%  google    доля записей 40.1%   null внутри  9.9%  -> доли те же, но null внутри twitter вырос: ошибка в обработке twitter
В сценарии 1 вырос вес Twitter, а null внутри источников прежний: кампания или сезон. В сценарии 2 доли прежние, но null внутри Twitter удвоился: искать нужно в обработке Twitter.
SLI для инцидентов: N, TTD и TTR
Заголовок раздела «SLI для инцидентов: N, TTD и TTR»Скрипт ch06_incident_metrics.py берёт журнал инцидентов и считает N, медиану TTD и медиану TTR.
таблица     N   TTD, ч   TTR, чorders      2      0.2      2.0customers   1     47.0      6.0payments    2      4.0      2.5
всего инцидентов N = 5медиана TTD = 0.3 ч, медиана TTR = 2.7 чхудший TTD = 47.0 ч (таблица customers: тихая ошибка жила почти два дня)
Таблицу customers исправили за 6 часов, но нашли только через 47. Улучшать нужно обнаружение, а не скорость исправления.
Подавление шума: группируем алерты
Заголовок раздела «Подавление шума: группируем алерты»Скрипт ch06_alert_grouping.py показывает идею из кейса PagerDuty: алерты одного пайплайна в окне 30 минут считаются одним инцидентом, а критичные данные идут с эскалацией.
алертов: 7, инцидентов после группировки: 4#1 orders_dag с минуты 5, алертов 4 (freshness, volume, schema, volume) -> on-call владельца пайплайна#2 finance_dag с минуты 40, алертов 1 (freshness) -> эскалация: on-call + BI-команда#3 orders_dag с минуты 55, алертов 1 (freshness) -> on-call владельца пайплайна#4 orders_dag с минуты 300, алертов 1 (volume) -> on-call владельца пайплайнаСемь алертов превратились в четыре инцидента. Финансовый пайплайн сразу попал и к дежурному, и в BI-команду.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему поиск аномалий нельзя считать полным решением проблемы инцидентов? Какие этапы нужны ещё?
- В каком порядке идут шаги RCA и зачем начинать с
lineage? - Доля null в поле выросла. Как по сегментам отличить удачную кампанию от ошибки обработки?
- Почему разбор инцидента должен быть
blameless? Что вы запишете вpostmortem, чтобы инцидент не повторился? - Как
incident commanderоценивает серьёзность инцидента и чем здесь помогаетlineage? - Что показывают
TTDиTTR? Какую из них улучшать, если ошибки долго остаются незамеченными?
Предыдущая: Глава 5. Архитектура для надёжности данных. Следующая: Глава 7. Сквозной lineage: от источника до дашборда.