

Data Quality Fundamentals, глава 10: Будущее надёжных систем данных
Главная мысль: Доверие к данным не купить одним инструментом. Оно держится на культуре, процессах и поддержке бизнеса, а бизнес поддерживает то, что можно посчитать в деньгах. Авторы дают формулу цены простоя и четыре прогноза: качество данных станет и проще, и сложнее.
О чём глава
Заголовок раздела «О чём глава»Как убедить компанию вкладываться в качество заранее и что ждёт эту область дальше? В главе 9 были живые истории команд. Здесь авторы берут формулу data downtime из главы 5 и превращают её в доллары. Потом идут четыре прогноза: слияние warehouse и lake, новые роли, автоматизация, data domains.
Вступление: данные и доверие
Заголовок раздела «Вступление: данные и доверие»Раньше данные жили изолированно: ими пользовались отдельные команды для разовых задач. Теперь аналитические данные стали главной «валютой» бизнеса. Мало собрать данные: им нужно доверять. Warehouses, dbt и каталоги уже добавляют проверки качества. Но авторы уверены: качество данных начинается и заканчивается культурой, процессом и поддержкой стейкхолдеров.
Shane Murray, бывший SVP по данным в New York Times, считает, что качество часто важнее каталогов и data discovery. Если не знаешь, свежи и точны ли данные, трудно получить пользу от стека. Доверие трудно заработать и легко потерять. Обычно о качестве вспоминают после ущерба: схема изменилась, и отчёт сломался, или упала модель dbt, и гендиректор усомнился в аналитике. Формула из главы 5 показывает цену простоя:
DDT = N × (TTD + TTR)DDT — это data downtime, N — число инцидентов, TTD — время до обнаружения, TTR — время до решения. Но как показать ценность качества, если аварии ещё не было?
Лучше предупредить, чем чинить
Заголовок раздела «Лучше предупредить, чем чинить»11 мая 2022 года акции Unity Technologies упали на 36%: выяснилось, что устаревшие данные больше квартала питали инструмент монетизации рекламы. Ошибка копилась и стоила $110 млн выручки. Если такое случается даже у технологичных компаний, остальным пора действовать заранее.
Первый шаг, по мнению авторов, — измерить финансовый эффект. Для этого есть калькулятор из двух частей. Константы в нём средние, свои числа лучше взять из журнала инцидентов.
Часы простоя в год
Заголовок раздела «Часы простоя в год»Авторы опираются на данные: по Monte Carlo (около 150 компаний) инцидент затрагивает 1 таблицу из 15 в год. По опросу Wakefield Research 2022 года (300+ дата-инженеров) обнаружение занимает 4 часа и больше, решение — в среднем 9. Для расчёта авторы берут TTD + TTR вместе: 8 часов при низкой зрелости качества данных, 6 при средней, 4 при высокой.
часы простоя = (таблицы / 15) × (TTD + TTR), не больше 8 7608 760 — это часы в году. Если зрелость низкая, а важных таблиц больше 16 425, данные в простое круглый год.
Цена работы инженеров
Заголовок раздела «Цена работы инженеров»На качество уходит 50% времени инженера при низкой зрелости, 35% при средней и 20% при высокой. Доли основаны на 150+ беседах с лидерами данных, кейсах и опросе Wakefield.
цена = число инженеров × 1 804 × $62 × доля времени1 804 — это рабочие часы в году (данные Минтруда США, 2022). $62 — это часовая ставка по Glassdoor.
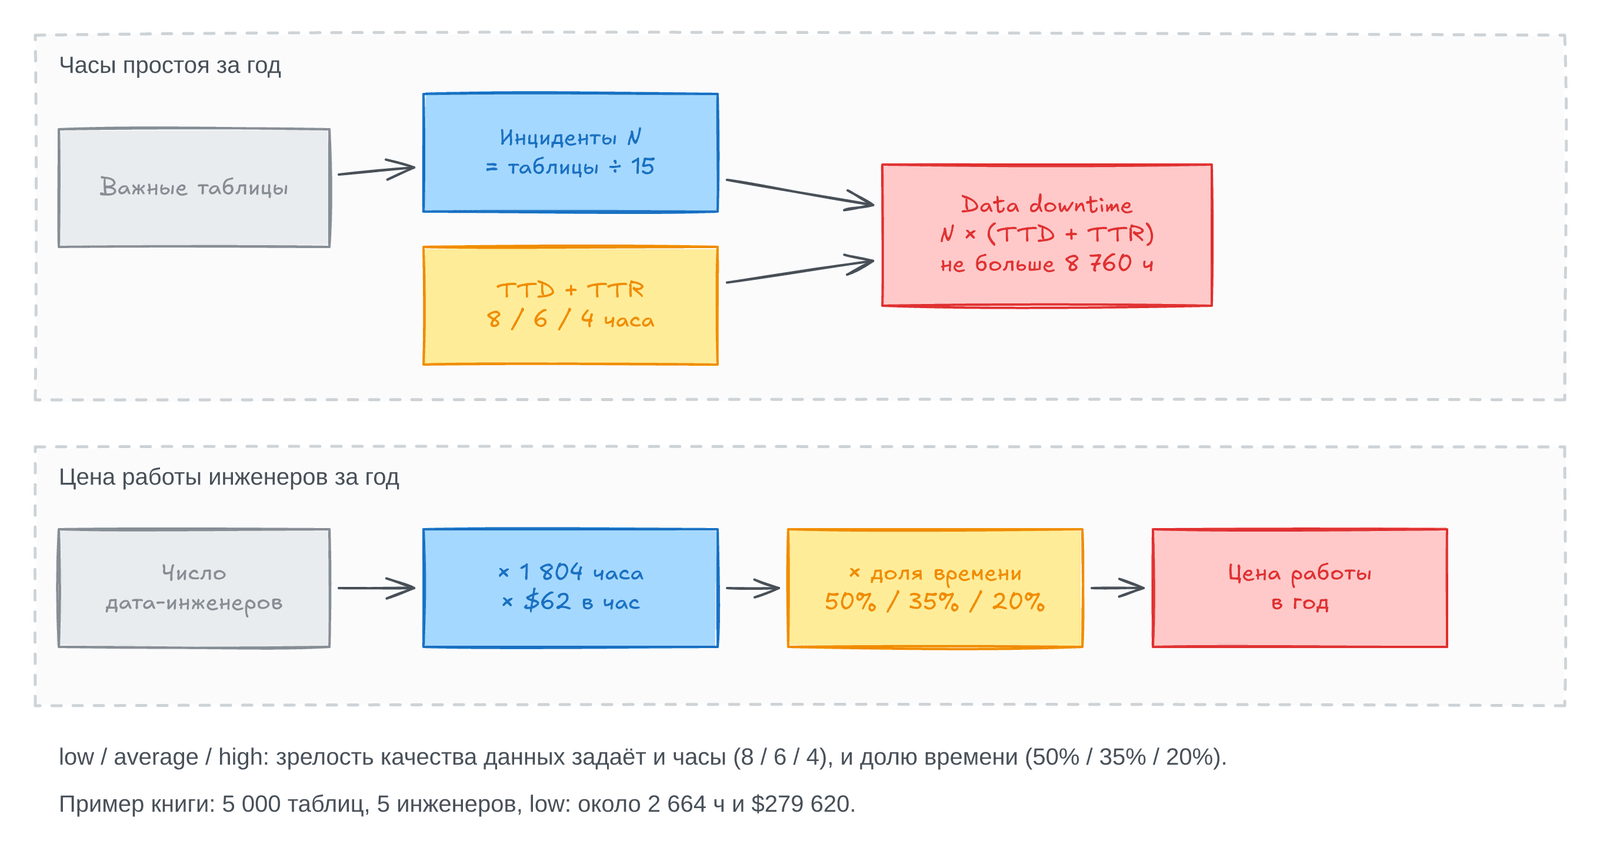
Пример книги: 5 000 таблиц, 5 инженеров, TTD + TTR — 8 часов. Выходит 2 664 часа простоя и работа на $279 620. В расчёт не входит opportunity cost: цена плохих решений на неверных данных. Авторы ждут, что алгоритмы научатся предсказывать и её.
Пояснение: В примере написано «средняя зрелость», но числа взяты для низкой (8 часов и 50%). Часы получились 2 664, потому что 5 000 / 15 округлили до 333.
Прогнозы на будущее качества и надёжности данных
Заголовок раздела «Прогнозы на будущее качества и надёжности данных»Быть проактивным мало: нужно знать, куда идёт область. Авторы выделяют четыре тренда.
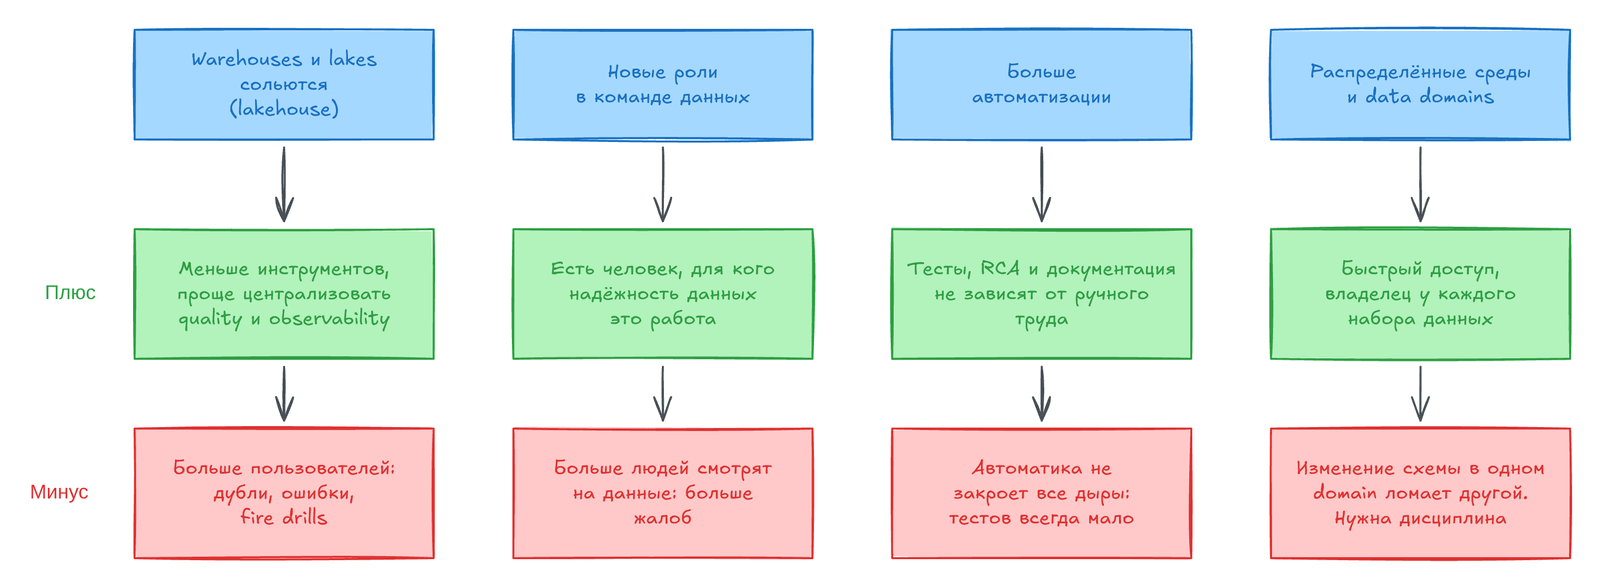
Warehouses и lakes сольются
Заголовок раздела «Warehouses и lakes сольются»Warehouse хранит структурированные данные в таблицах, lake — в основном неструктурированные. Но AWS, Snowflake, Google и Databricks делают решения, которые сливают оба мира. В warehouse проще следить за схемой, объёмом и freshness. Lake гибче, но у него много точек входа, и данные ломаются чаще.
Для качества это скорее хорошая новость, хотя и с оговорками. Меньше инструментов, значит, меньше мест для поломки. Lakehouse требует больше стандартизации, и это открывает путь к централизованному подходу к качеству и data observability. ACID и Delta Lake упрощают data contracts и управление изменениями. Минус: больше пользователей, а с ними больше дублей, ошибок и авралов.
Новые роли в команде данных
Заголовок раздела «Новые роли в команде данных»Данные стали отдельной организацией внутри компании со своими ролями: data scientist, аналитик, инженер. Авторы ждут ещё больше специализаций: это признак зрелости рынка. Четыре роли, которые станут важны:
- Data product manager ведёт жизненный цикл
data productи работу со стейкхолдерами. - Analytics engineer стоит между дата-инженером и аналитиками и моделирует данные так, чтобы данным верили.
- Data reliability engineer строит устойчивый стек: observability, тесты. Часто у него есть DevOps-опыт.
- Data designer помогает аналитикам рассказывать истории через визуализации. Это не database designer.
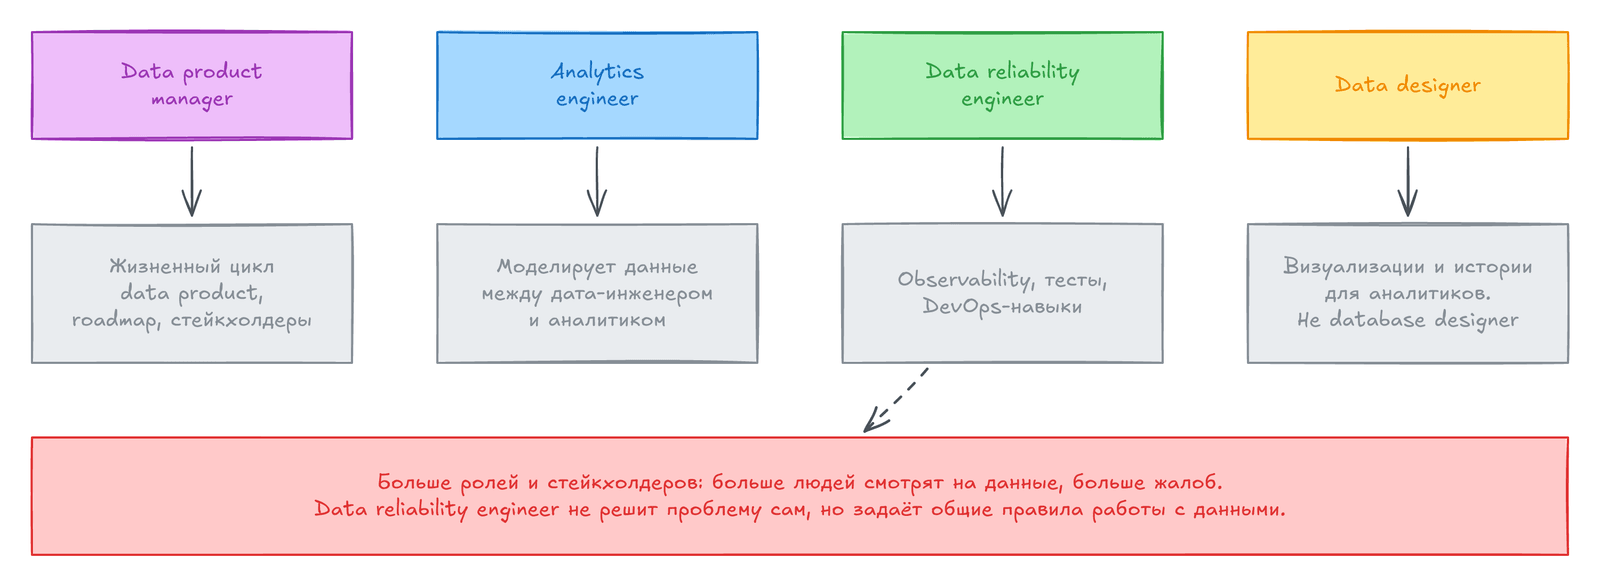
Больше ролей — больше стейкхолдеров, и больше людей смотрит на данные. Prateek Chawla из Monte Carlo говорит: чем больше людей смотрит, тем больше жалоб. Даже data reliability engineer не «решит» проблему качества. Но помогает, когда все знают, как работать с данными, чтобы ничего не ломалось.
Рост автоматизации
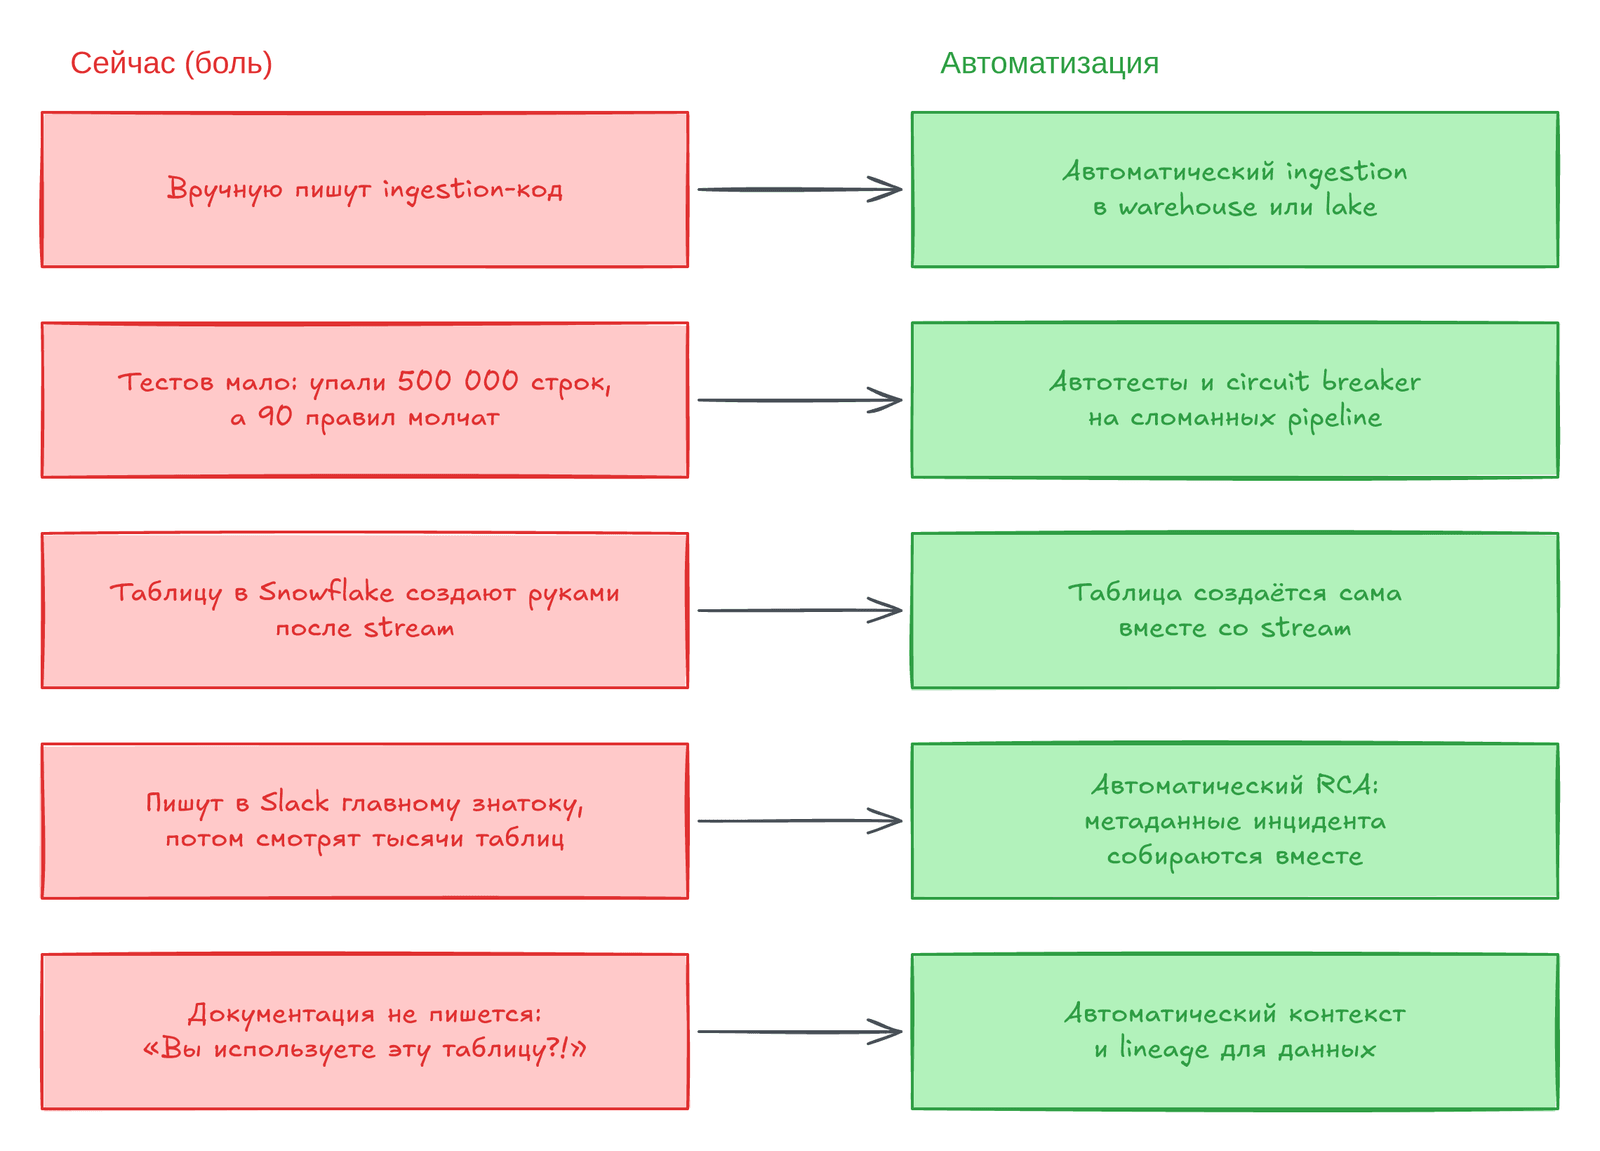
Заголовок раздела «Рост автоматизации»Автоматизация снимает ручной труд и закрывает дыры там, где не справляются тесты и каталоги. Авторы видят пять областей:
- Ручной код pipeline. Инженеру не нужно тратить время на перенос SQL из CSV в хранилище: для этого есть автоматический ingestion.
- Тесты и проверки оркестрации. Покрыть всё тестами нельзя. У одной компании было больше 90 правил на ключевом pipeline, но пропало 500 000 строк, и алерт не сработал. Нужны автотесты и
circuit breaker. - Из staging в production. Таблицу в Snowflake для данных из stream в S3 создают руками, и иногда о ней забывают. Лучше создавать её автоматически вместе со stream.
- Поиск первопричины. Сейчас в чат пишут тому, кто знает систему лучше всех, а потом вручную проверяют тысячи таблиц. Авторы хотят автоматический
root cause analysis(RCA), который собирает метаданные инцидента. - Документация и discovery. Если документация не автоматическая, её нет. Отсюда вопрос «Вы используете эту таблицу?!» и инженеры в роли каталога. Контекст и
lineageнужно создавать автоматически.
Распределённые среды и data domains
Заголовок раздела «Распределённые среды и data domains»В главе 1 речь шла о data mesh: функциональные команды сами используют данные. Потенциал большой: быстрый доступ, демократизация, информированные стейкхолдеры. Но есть и сложности. Авторы советуют посмотреть на микросервисы: там видно, что будет, когда мода на mesh пройдёт.
Такой подход требует дисциплины, чтобы соблюдать data governance. Изменение схемы в одном домене вызывает аврал в другом. Таблицу копируют для одной части бизнеса, а потом ею пользуется другая, и начинается путаница. Единый слой федерации обещает общие правила, но команды должны соблюдать контракты и использовать выделенные API, и это путает. Перед переходом на mesh стоит подумать: примет ли его вся организация.
Куда двигаться дальше
Заголовок раздела «Куда двигаться дальше»Качество данных станет и проще, и сложнее. Системы и объёмы растут, и это усложняет задачу. Зато автоматизации становится больше, и data downtime предотвращать легче. Надёжность станет базовым требованием даже для новых команд. Авторы ждут, что лидеры начнут мерить качество как показатель зрелости. Они заканчивают пожеланием: «чтобы у вас не было data downtime».
Итоги главы
Заголовок раздела «Итоги главы»- Инструменты не заменяют культуру: доверие держится на процессах и стейкхолдерах.
- Бюджет проще получить, если измерить цену простоя в часах и долларах.
- Часы простоя: (таблицы / 15) × (TTD + TTR), не больше 8 760 в год.
- Цена работы: инженеры × 1 804 × $62 × доля времени (50%, 35% или 20%).
- Unity потеряла $110 млн из-за устаревших данных, поэтому лучше действовать заранее.
- Warehouse и lake сольются: инструментов меньше, но pipeline сложнее.
- Появятся новые роли, но больше людей — больше жалоб на данные.
- Автоматизация охватит ingestion, тесты, перенос в production, RCA и документацию.
- Data domains дают скорость, но без дисциплины один домен ломает другой.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
TTD / TTR | Время до обнаружения инцидента и время до его решения |
зрелость качества данных (data quality maturity) | Уровень практик: low, average, high. Задаёт часы и долю времени |
lakehouse | Гибрид файлов lake и таблиц с транзакциями warehouse |
data reliability engineer | Инженер надёжности стека данных: observability, тесты |
data domains | Наборы данных, которыми владеет команда своей области |
opportunity cost | Цена упущенного и неверных решений на плохих данных |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Считайте цену простоя до аварии. Возьмите свои таблицы,
TTD,TTR, число инженеров и покажите результат руководству. - Не ждите полного покрытия тестами. Добавьте мониторинг объёма и freshness и
circuit breakerна ключевых pipeline. - Для mesh заранее решите, кто отвечает за схему. Контракты между доменами дешевле авралов.
Практика: считаем цену простоя
Заголовок раздела «Практика: считаем цену простоя»Скрипт считает часы и цену для трёх уровней зрелости. Полный код: ch10_labor_cost.py. Запуск: python3 scripts/data-quality-fundamentals-code/ch10_labor_cost.py. Вся логика уместилась в двух функциях:
def downtime_hours(tables, ttd_plus_ttr):    incidents = tables / TABLES_PER_INCIDENT           # N    return min(incidents * ttd_plus_ttr, HOURS_IN_YEAR)  # DDT = N * (TTD + TTR)

def labor_cost(engineers, share):    return engineers * WORK_HOURS * RATE * share
Результат для 5 000 таблиц и 5 инженеров:
5000 таблиц, 5 инженеровlow TTD+TTR=8 ч, доля 50%: простой 2,667 ч, работа 279,620 $average TTD+TTR=6 ч, доля 35%: простой 2,000 ч, работа 195,734 $high TTD+TTR=4 ч, доля 20%: простой 1,333 ч, работа 111,848 $потолок 8 760 ч при low: 16,425 таблиц20 000 таблиц, low: 8,760 ч (обрезано до потолка)Для low получается $279 620, как в книге. На уровне high работа стоит $111 848 — в 2,5 раза меньше.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему авторы считают, что одних инструментов мало?
- Что показывает формула
DDT = N × (TTD + TTR)и чего она не показывает? - У вас 3 000 важных таблиц и средняя зрелость. Сколько часов простоя в год даёт формула книги?
- Слияние warehouse и lake: какой плюс и какой минус для качества?
- Почему больше специализированных ролей может означать больше жалоб на данные?
- Какие риски у
data meshдля качества и что решить заранее?
Предыдущая: Глава 9. Качество данных на практике: беседы и кейсы. Следующая: Обзор книги.