

Data Quality Fundamentals, глава 3: Сбор, очистка, преобразование и тесты данных
Главная мысль: Качество данных нужно строить на каждом шаге пути данных: при сборе, очистке, преобразовании и тестировании. Чем ближе к источнику, тем данные грязнее. Тесты ловят только известные проблемы, а в orchestration добавляют circuit breaker: он не пускает плохие данные дальше.
О чём глава
Заголовок раздела «О чём глава»В главе 2 мы разобрали термины и места, где живут метаданные о качестве. Теперь авторы смотрят на весь жизненный цикл данных. Сбор и очистка относятся к началу пайплайна. Преобразование и тесты работают с данными на полпути к аналитике. В конце глава показывает, как держать качество на уровне orchestration с помощью Apache Airflow. Мониторинг и поиск аномалий будут в главе 4.
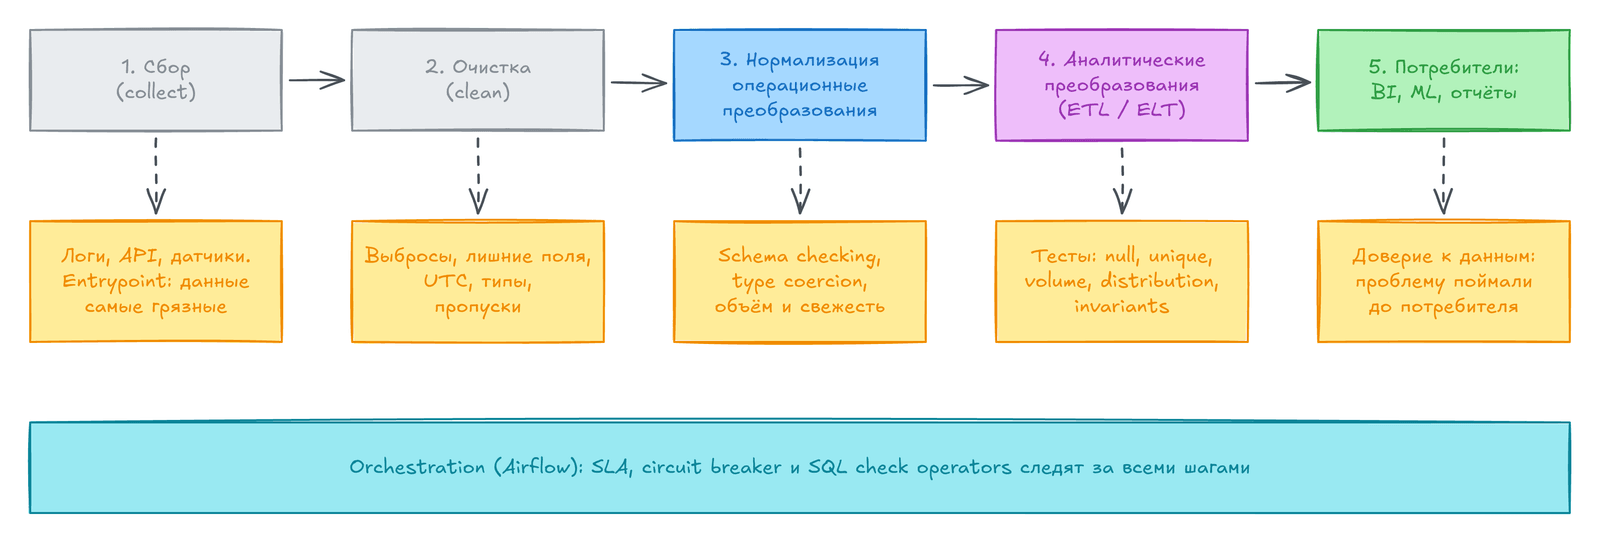
Сбор данных
Заголовок раздела «Сбор данных»Самая важная точка пайплайна стоит в самом начале. Авторы называют её entrypoint: это место, где данные из внешнего мира впервые попадают в пайплайн. Слово пришло из программирования: ENTRYPOINT в Docker запускается первым.
Здесь данные самые сырые: в них весь шум реального мира. Они приходят из логов, clickstream (потока кликов) и датчиков, часть структурирована, часть нет. Источник редко выбирает дата-инженер: его задают бизнес-цель или внешний сервис. Источники делятся на три группы.
Логи приложений
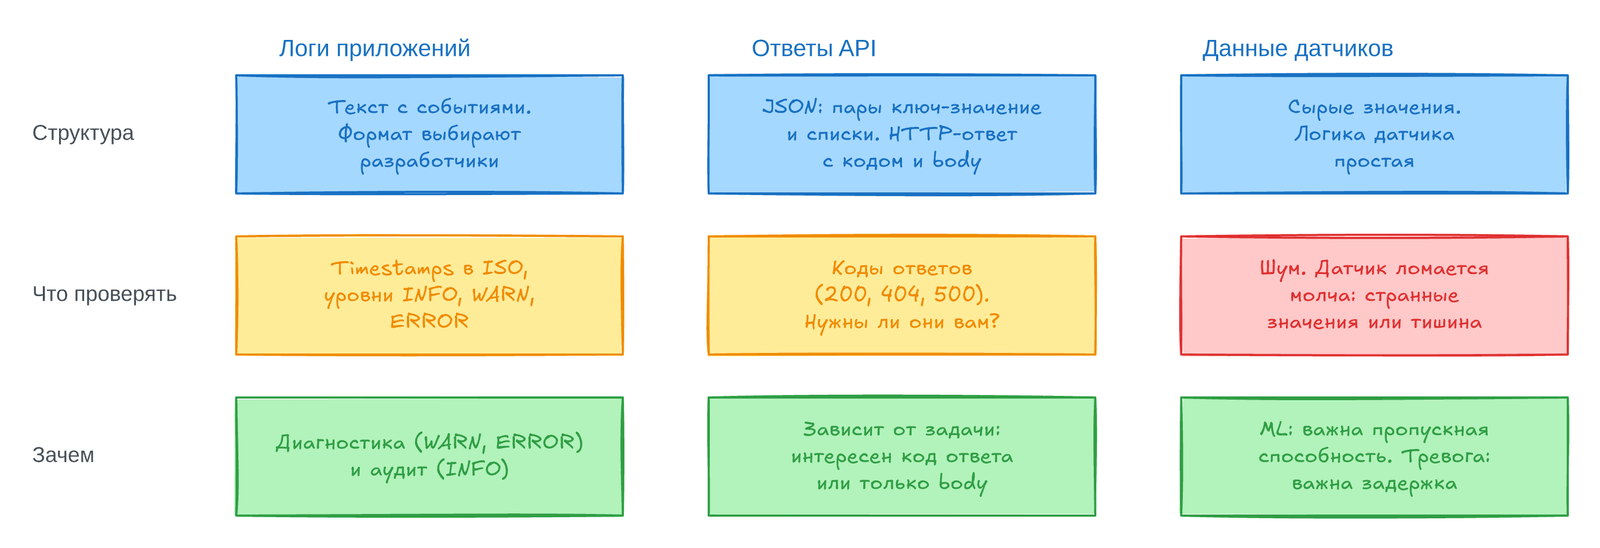
Заголовок раздела «Логи приложений»Application logs записывают действия внутри программы: пользователь читает блог и кликает по ссылкам, инженер создаёт виртуальную машину, ML-модель пишет эпохи обучения. В отличие от системных логов, здесь разработчики сами решают, что писать. Поэтому лог может не показывать всю историю. Авторы выделяют четыре свойства:
- Структура. Это просто сериализуемый текст. Ограничений на формат и длину почти нет, поэтому структура сильно меняется.
- Timestamps. Метка времени должна быть стандартной, чаще всего ISO:
yyyy-mm-ddThh:mm:ss[.mmm]. - Log levels.
INFOописывает событие,WARNпредупреждает,ERRORозначает сбой программы. - Цель. Хранить логи стоит денег, поэтому их собирают ради конкретной цели. Для диагностики («как часто запрос падает по тайм-ауту») нужны отдельные записи
WARNиERROR. Для аудита («кто послал запрос и сколько раз») нужны записиINFO, а сила аудита в больших агрегациях.
Ответы API
Заголовок раздела «Ответы API»API (интерфейс между двумя программами) отдаёт полуструктурированные данные. Что важно:
- Структура. Ответ распаковывается в объект, часто в
JSON: пары «ключ-значение» и списки. Это не поток текста, как лог. - Коды ответов. Запрос может упасть. Самые известные коды HTTP: 200, 404, 500. Доля ответов 500 прямо показывает, что сервер лежит.
- Цель. Смысл данных зависит от задачи. Для частоты ошибок главное код ответа. Если вы забираете данные с чужого сервера, код не важен, нужно только тело (
body).
Данные датчиков
Заголовок раздела «Данные датчиков»Логика датчика простая: он измеряет и отправляет значение, без записей INFO. Три особенности:
- Шум. Небольшая порция данных датчика, скорее всего, мусор. Выбросы уберёт дальнейшая обработка, поэтому ей нужен ровный и постоянный поток. Важна пропускная способность (
throughput). - Молчаливые поломки. Сломанный датчик не пришлёт
ERROR: Device offline. Он начнёт слать странные значения или замолчит. Проверяйте объём данных и время между batch. - Цель. Для ML важен большой объём, то есть throughput. Для inference в реальном времени (сигнал, что кто-то подошёл к двери) важна задержка (
latency).
Очистка данных
Заголовок раздела «Очистка данных»Многие считают очистку главным препятствием на пути к качеству. Data cleaning убирает неточные и нетипичные данные из набора, который в остальном годится. Данные в entrypoint только что пришли из хаоса: в них пропуски, ошибки, экстремальные значения и несовместимые форматы. Основные приёмы:
- Удаление выбросов. Шум ломает ML-пайплайны и портит дашборды: например, температура 99999° не должна идти дальше. Подойдут
z-scoreилиisolation forest. На больших наборах следите за скоростью метода. Но если следующая задача — это поиск выбросов, их удалять нельзя. - Оценка полей. Нужно ли поле вообще? Бесполезное поле стоит места и запутывает коллег. Больше полей — больше документации, а это вредит качеству.
- Нормализация. Некоторые значения важны только в сравнении с другими. Тогда используют нормы
L1иL2, вычитание среднего, единичную дисперсию. - Восстановление данных. Поля пропадают из-за ненадёжных API и отключённых датчиков. Если значение нужно, его можно восстановить интерполяцией, экстраполяцией или по похожим записям.
- Часовые пояса. Метки времени из разных мест сравнимы только при общем стандарте, обычно
UTC. Если отрезать пояс при сборе, вы никогда не узнаете, какое из двух событий было раньше. Многие баги вызваны путаницей с поясами, самый известный пример — Y2K. - Приведение типов. Если следующему шагу нужен определённый тип, приведите значения к нему при очистке. Это важно при объединении данных из разных форматов.
Batch и stream
Заголовок раздела «Batch и stream»Batch (пакетная обработка) собирает данные за период и отдаёт большими порциями. Stream (потоковая) обрабатывает их почти сразу. До середины 2010-х основным был batch: он дешевле, и его хватало даже для срочных задач. Потом Apache Kafka и Amazon Kinesis сделали stream доступным. Но чтобы делать выводы в реальном времени, batch слишком медленный.
Пример с банковской картой. Продавец обрабатывает платежи пакетом: шарф куплен в понедельник, а списание пройдёт в среду. Банк же сразу после авторизации может заметить подозрительную операцию. Если данные о транзакциях старые, антифрод опоздает. Пример stream — это заказ такси: сервис в реальном времени собирает локацию, цену и водителей.
Для batch авторы называют Apache Hadoop (он режет файлы и раздаёт куски узлам кластера) и управляемые аналоги: BigQuery, Snowflake, Redshift. Для stream это Spark, Kafka, Flink. Spark режет поток на небольшие пакеты (micro-batch), а Kafka разбирает события по мере появления.
Качество данных при потоковой обработке
Заголовок раздела «Качество данных при потоковой обработке»Batch старается собрать как можно больше, даже с задержкой. Stream старается собрать как можно быстрее и поэтому что-то теряет. Из-за этого качество в batch обычно выше, а в stream запас прочности меньше. Пример: одно изменение схемы API в рекламной системе даёт неверные данные, и компания переплачивает за рекламу или теряет выручку.
Раньше качество держали тестами. Команда писала их по своим допущениям, но предусмотреть всё нельзя. Появлялась новая ошибка, инженеры спешно искали первопричину, потом чинили и писали тест против повтора. По разговорам с сотнями команд авторы утверждают, что тесты покрывали около 20% возможных проблем, то есть «известные неизвестные». А источников теперь десятки и сотни. В stream всё ещё сложнее: данные меняются каждую секунду. Unit-, функциональные и интеграционные тесты закрывают основы, но не масштабируются на непредсказуемые данные. Подход к качеству придётся пересмотреть.
AWS Kinesis
Заголовок раздела «AWS Kinesis»Amazon Kinesis — это serverless-сервис потоков. Мощность растёт on-demand, то есть вместе с объёмом, а заранее выделять ресурсы не надо. Он собирает данные из сервисов AWS, логов, мобильных приложений и датчиков. Плюсы: доступность по требованию, оплата по использованию, богатый SDK и простая интеграция с S3 и Redshift, если вы уже в AWS.
Apache Kafka
Заголовок раздела «Apache Kafka»Apache Kafka — это открытая платформа потоков событий. Она оптимизирована для малой задержки: заявлена задержка от 2 мс. Плюсы: бесплатный код и сообщество, больше настроек (например, срок хранения данных; в Kinesis он, по книге, фиксирован: 7 дней) и высокая пропускная способность. В тестах Kafka держала до 30 000 записей в секунду, а Kinesis только единицы тысяч.
Пояснение: Это цифры 2022 года. Срок хранения в Kinesis теперь можно увеличить до 365 дней. Читайте цифры как иллюстрацию, а не как сравнение.
Из-за высокой задержки в потоке больше ошибок, и «стримить» вход прямо в аналитику рискованно. Поэтому для аналитики часто выбирают batch. Между Kinesis и Kafka выбирайте по задачам команды. Небольшой команде нужен быстрый результат, и ей подойдёт управляемый Kinesis. Большой команде с особыми требованиями подойдёт Kafka.
Нормализация данных
Заголовок раздела «Нормализация данных»Data transformation — это программа, которая переносит данные из исходных форматов в целевой. Первый слой операционных преобразований авторы называют нормализацией. Она работает на данных entrypoint, где шум, неоднозначность и разнородность максимальны.
Работа с разнородными источниками
Заголовок раздела «Работа с разнородными источниками»На входе в нормализацию у данных обычно такие свойства:
- Оптимизированы под задержку. Они доступны сразу, но платой становится полнота. Ждите неполные batch.
- Плоский формат. Данные «свалены» в центральное место, например в бакет
S3, без схемы и таблиц. - Сырой формат файлов. Логи и датчики не переводят в таблицы: это дорого и обычно не нужно.
- Необязательные поля. В сыром
JSONполя могут отсутствовать. Что значит отсутствие:NULL, 0 или текущее время? Это нужно решить для каждого поля. - Разнородность. Разные источники, форматы и полнота.
Эти свойства описывают данные в формате data lake. Для entrypoint чаще выбирают data lake: у него меньше ограничений. Стриминговые сервисы сбрасывают данные в data lake, а первый слой операционных преобразований переводит часть данных в структурированный вид в хранилище. Для этого служат функции AWS Lambda (для Kinesis) или потребители Kafka. Для регулярного переноса данных в хранилище подойдёт AWS Glue.
Schema checking и type coercion
Заголовок раздела «Schema checking и type coercion»Schema checking проверяет, что структура данных такая, как мы ждём: нужные поля на месте, формат верный. Type coercion (приведение типов) нужно, когда формат не подходит и данные приходится «привести» к другому. Изменение схемы — одна из главных причин поломок. Например, поле исчезло из ответа API после обновления версии. Или команда переименовала поле, а ваши скрипты сломались. Проверять нужно заранее: храните записи об ожидаемых схемах и показывайте, когда они меняются.
Приведение типов опаснее, чем кажется. Строку «4» в число 4 привести просто. А 4,00 в целое 4 уже теряет значимые цифры. Хуже всего 4,99 в 4: это не школьное округление, а отсечение всего после точки.
Синтаксическая и семантическая неоднозначность
Заголовок раздела «Синтаксическая и семантическая неоднозначность»Syntactic ambiguity — это путаница в подаче данных. Одна метрика лежит под разными именами (clickthrough_annual и clickthrough_rate_yr) или в data lake хранится целым числом, а в хранилище — с .00. Значение то же, но команде работать сложнее.
Semantic ambiguity хуже: путаница в назначении. Дата-инженер считает, что поле X хранит метрику пайплайна. Аналитик по имени решает, что оно показывает бизнес-цель, и ставит его на дашборд. Метрики компании могут исказиться. От этого защищает документация, причём заранее: неоднозначность быстро растёт вместе с командой.
Операционные преобразования в Kinesis и Kafka
Заголовок раздела «Операционные преобразования в Kinesis и Kafka»Сырые данные не означают работу «вслепую»: потоковые системы дают встроенные оповещения. В Kinesis потоки управляются функциями AWS Lambda: они запускаются до любого SQL-кода и в них можно встроить проверки. У Kafka много настроек и высокий порог входа. Управляемые версии (Confluent, AWS) часто сами защищают от части data downtime. У Confluent есть schema registry: он проверяет схемы и управляет их эволюцией. Метрики Kafka уходят через JMX.
Проверки здесь должны быть лёгкими: задержка важнее пропускной способности. Тяжёлые агрегации, такие как data drift, лучше отложить. Настройте сравнение исторической схемы с пришедшей и контроль объёма. Многое из «мониторинга» здесь вообще не про качество, а про то, чтобы данные не перегрузили мощность и память.
Аналитические преобразования
Заголовок раздела «Аналитические преобразования»Это преобразования аналитических данных, включая слой между операционными и аналитическими источниками (например, AWS Glue между S3 и Redshift).
Качество при ETL
Заголовок раздела «Качество при ETL»ETL — это три шага. Extract: сырые данные выгружают из источников в промежуточную область (staging area). Transform: данные в staging объединяют и обрабатывают по спецификации, иногда это просто копирование. Load: результат переносят в целевую таблицу.
Качество при transformation
Заголовок раздела «Качество при transformation»В ETL данные идут в staging, потом в цель. В ELT они сразу грузятся в цель и преобразуются там. ETL позволяет проверить данные до production. ELT быстрее, но без тестов и мониторинга качество ниже. Данные преобразуют, чтобы переименовать поля, убрать дубли, привести типы и единицы (например, все валюты к долларам), зашифровать чувствительные поля и провести проверки качества. Для темы книги важнее всего последнее.
Алерты и тесты
Заголовок раздела «Алерты и тесты»Системы dbt, WhereScape и Informatica тоже ломаются, поэтому нужны тесты и оповещения. Data testing проверяет допущения о данных до production или во время него. Самые частые тесты:
| Тест | Вопрос |
|---|---|
| Null values | Есть ли неизвестные значения (NULL)? |
| Volume | Данные пришли? Не слишком много или мало? |
| Distribution | Значения в допустимом диапазоне? |
| Uniqueness | Есть ли дубли? |
| Known invariants | Выполняется ли очевидное правило, например «прибыль = выручка минус затраты»? |
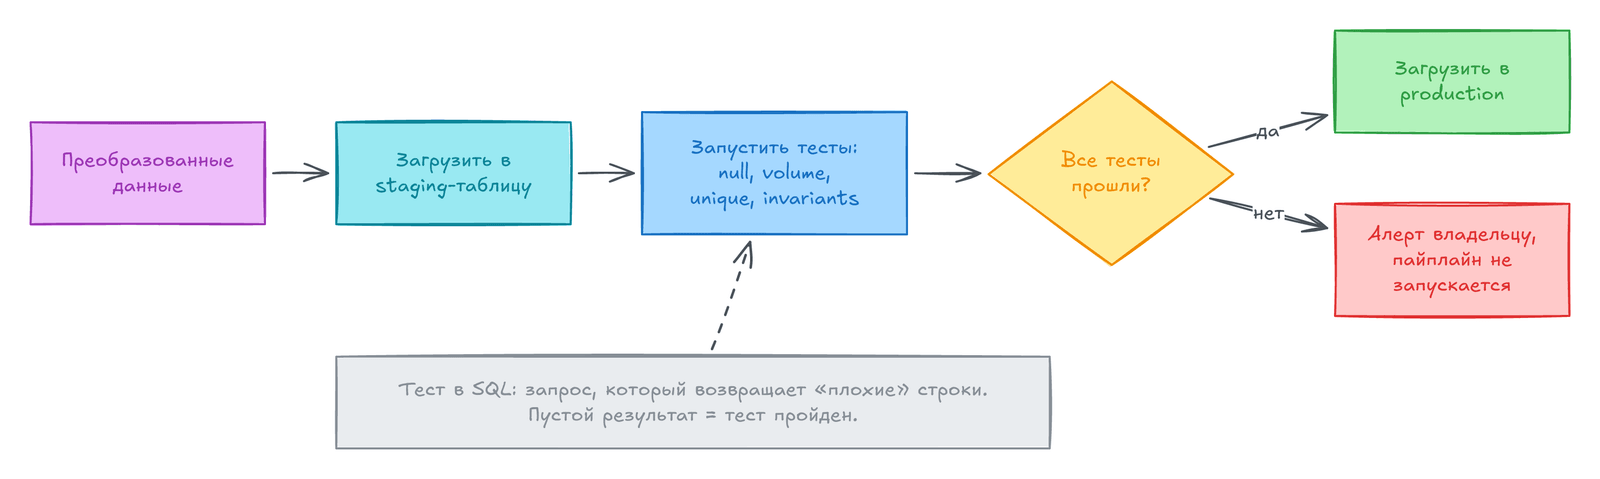
По опыту авторов, лучшие инструменты — dbt tests и Great Expectations. Процесс простой: загрузить преобразованные данные во временную staging-таблицу и запустить тесты. Они проверяют, что данные укладываются в пороги production. Если тест упал, владельцу уходит алерт, а пайплайн не запускается. Тесты можно запускать до преобразования и после каждого его шага.
Тесты в dbt
Заголовок раздела «Тесты в dbt»dbt run запускает SQL-модели, dbt test проверяет их. Тест в SQL возвращает «плохие» строки, и мы «утверждаем», что результат пуст. Авторы считают границу между unit- и integration-тестом в dbt размытой: модель можно проверять отдельно, но она стоит в длинной цепочке. Поэтому пишут оба вида, главное — документировать.
Пояснение: В книге «unit tests» в dbt это тесты данных на настоящих данных. С версии 1.8 в dbt «unit tests» означают другое: проверку логики модели на заданных строках. Тесты этой главы теперь называют data tests.
Тесты бывают двух видов:
- Singular tests. Отдельные SQL-тесты для конкретной модели. Пример из документации: у модели
fct_paymentsсумма платежей заказа не может быть отрицательной. Запрос возвращает заказы, где это не так. Мы повторим его в практике. - Generic tests. Шаблоны с параметрами (колонка, порог) для разных моделей. Четыре готовых:
unique,not_null,accepted_values,relationships(ссылочная целостность).
Ограничения:
- Технический долг. Тесты ведут вручную. Модель меняется, и тесты надо менять тоже. Сложные тесты отнимают почти столько же времени, сколько сами модели.
- Усталость от тестов. Один разработчик добавляет необоснованный тест. Другой спустя месяцы ломает его и, не понимая, зачем он был, удаляет ради зелёного CI. Авторы предупреждают: лучше вообще без тестов, чем с тестами, которые никто не воспринимает всерьёз.
- Ограниченная видимость. Тест может упасть из-за проблемы выше по цепочке (например, неверно настроенной Lambda в
AWS Glue). Он покажет, что проблема есть, но не покажет причину.
Great Expectations
Заголовок раздела «Great Expectations»Great Expectations — это открытый инструмент, где тесты («expectations») пишут на Python. Он гибче dbt и работает с разными ETL и ELT. Есть библиотека готовых проверок, например expect_column_values_to_be_between для zip_code. После запуска он строит страницу Data Doc: доли падений и выборку упавших строк. Плюсы: простота (пакет Python с командной строкой и Jupyter) и гибкие оповещения в Slack. Минусы: только Python, и он отделён от трансформации и orchestration. Если Data Docs вам не нужны, проще взять интегрированные тесты dbt.
Deequ — это открытая библиотека AWS на Apache Spark. Она проверяет всё, что помещается в Spark DataFrame: CSV, JSON, таблицы, логи. Для Python есть PyDeequ. Она тоже возвращает упавшие строки и умеет quarantine: изолировать плохие данные, пока они не ушли дальше. Проверки задают через VerificationSuite: размер набора, уникальность и непустота колонок, квантили. Плюсы: интеграция с AWS, масштабируемость, stateful calculation (метрики сохраняются и пересчитываются при новых данных, поэтому не нужно пересчитывать весь набор) и поиск аномалий по бегущим средним и отклонениям. Минусы: Scala сложна для людей вне дата-инжиниринга, интеграционные тесты потребуют много работы, интерфейса почти нет.
Качество данных в Apache Airflow
Заголовок раздела «Качество данных в Apache Airflow»Apache Airflow, Luigi, Matillion и Stitch управляют качеством на уровне orchestration: создают, расписывают и мониторят процессы. У процесса (DAG, directed acyclic graph) много контрольных точек, и поэтому сбоев хватает. Самые частые причины data downtime в Airflow: деградирующие запросы и ошибочный Python-код. Деградирующий запрос отрабатывает, но дольше ожидаемого: чаще всего это значит, что пайплайн не масштабируется.
SLA планировщика
Заголовок раздела «SLA планировщика»В Airflow можно задать SLA: максимальное время выполнения задачи. Для этого в параметр sla передают datetime.timedelta. Если задача идёт дольше, в интерфейсе виден «SLA missed». Свою логику можно задать через sla_miss_callback, например оповещение в Slack, Teams или почту. Он принимает пять параметров: dag, task_list (нарушившие SLA задачи), blocking_task_list (задачи не в состоянии SUCCESS), slas и blocking_tis.
Пояснение: Это описание Airflow 2. В Airflow 3 функцию SLA убрали. На новой версии ищите замену в документации.
Circuit breakers в Airflow
Заголовок раздела «Circuit breakers в Airflow»Circuit breaker (автоматический выключатель) останавливает пайплайн, если данные не проходят пороги качества. Идея пришла из CI/CD, где так не дают новым релизам ломать системы. Пример: после обновления метрик запустить проверки целостности до запуска задач ниже. Так аналитики не получат ложных алертов. Другой случай: остановить поток в середине пайплайна, если входные данные неточные.
Circuit breaker не даёт смешивать данные высокого и низкого качества. У него два состояния: circuit closed (данные текут) и circuit open (данные не текут). По словам Сандипа Уттамчанди, бывшего Chief Data Architect в Intuit, для него нужны три вещи: lineage, profiling по всему пайплайну и автоматический запуск выключателя по найденным проблемам. Авторы видели, как он ловит проблемы свежести, объёма и распределения.
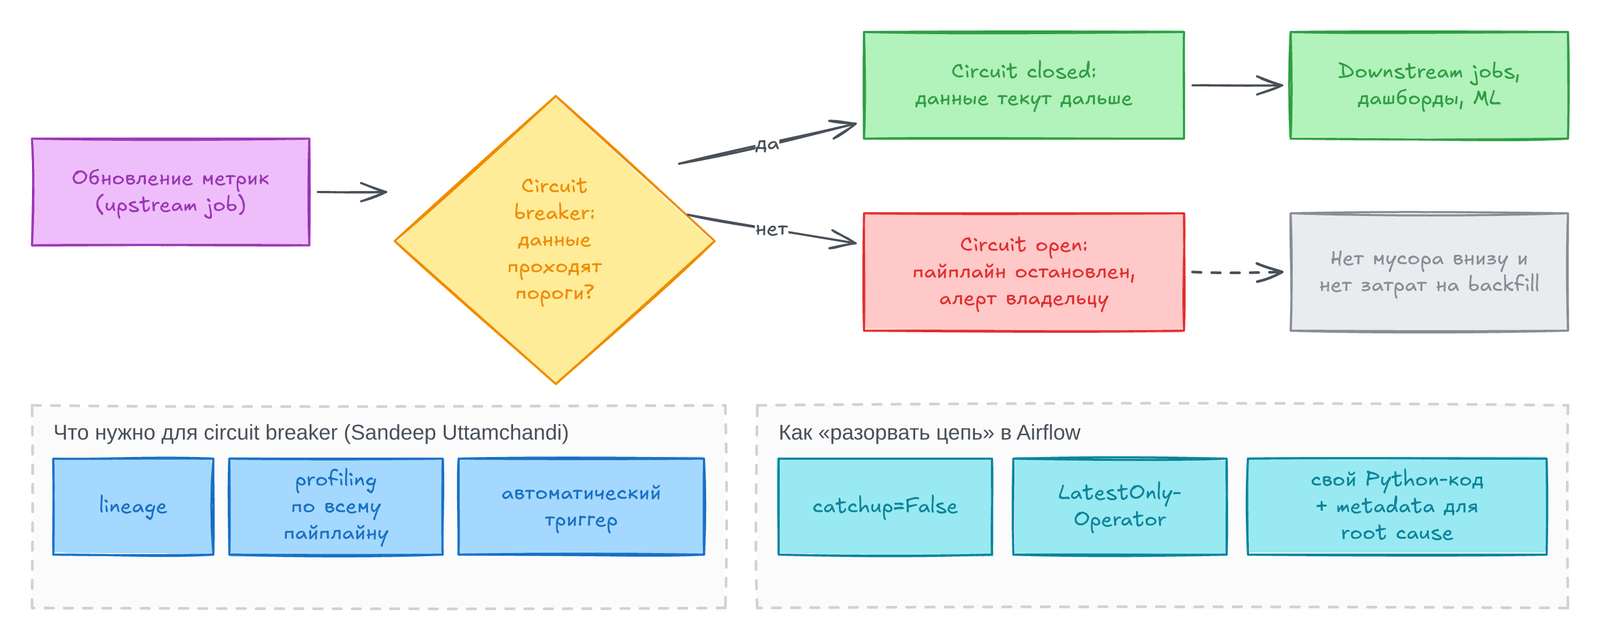
В Airflow выключатель останавливает пайплайн, если данные не отвечают порогам свежести, объёма и схемы. Он защищает хорошие пайплайны и экономит на backfill: не нужно перезапускать DAG, который «тихо» отработал на плохих данных. Три способа:
- задать
catchup=Falseу DAG; - добавить
LatestOnlyOperator; - вставить свой Python-код, который останавливает DAG и выводит метаданные для
root cause analysisв платформуdata observabilityили каталог.
SQL check operators
Заголовок раздела «SQL check operators»SQL check operators проверяют значения, интервалы и пороги, как тесты dbt или Great Expectations. Можно написать свой SQL-запрос, который возвращает одну строку, и оператор смотрит, нет ли в ней значения False. В книге это SQLCheckOperator. Как и в circuit breaker, можно добавить Python-код, который остановит пайплайн.
Останавливать пайплайн стоит только при серьёзных инцидентах. Иначе circuit breaker и SQL check operators заблокируют несвязанные и вполне качественные задачи, и данные перестанут доходить до потребителей.
Итоги главы
Заголовок раздела «Итоги главы»- Качество данных строят проактивно на каждом шаге: сбор, очистка, преобразование, тесты и orchestration.
- Entrypoint получает самые грязные данные. Датчики ломаются молча, поэтому за ними следят по объёму и паузам.
- Очистка: выбросы, лишние поля, нормализация, пропуски, UTC, типы.
- Batch дешевле и качественнее, stream быстрее, но теряет данные. На stream тесты плохо масштабируются.
- При нормализации проверяйте схему и типы, а смысл полей документируйте заранее.
- Тест — это запрос, который возвращает плохие строки. Частые тесты: null, volume, distribution, uniqueness, known invariants.
dbt tests,Great ExpectationsиDeequрешают одну задачу. Выбор зависит от стека: SQL, Python или Spark и AWS.- Тесты ловят около 20% проблем (оценка авторов). Остальное требует мониторинга.
- Circuit breaker и SQL check operators в Airflow останавливают плохие данные. Используйте их только для серьёзных инцидентов.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
entrypoint | Место, где внешние данные впервые попадают в пайплайн |
Application logs | Логи приложений, состав которых выбирают разработчики |
Type coercion | Приведение значения к другому типу, явное или неявное |
Schema checking | Проверка, что структура данных совпадает с ожидаемой схемой |
Syntactic ambiguity | Путаница в подаче данных: разные имена и типы для одного смысла |
Semantic ambiguity | Путаница в назначении данных: люди по-разному понимают смысл поля |
Data testing | Проверка допущений о данных до production и во время него |
Singular test / generic test | Разовый SQL-тест одной модели и шаблонный тест с параметрами в dbt |
Circuit breaker | Останавливает пайплайн, если данные не проходят пороги |
SQL check operators | Операторы Airflow, которые проверяют данные SQL-запросом |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Опишите, что значит «нет поля» в каждом сыром источнике:
NULL, 0 или ошибка. - Храните время в UTC и не режьте информацию о часовом поясе при сборе.
- Для датчиков и внешних API мониторьте объём и паузы между batch.
- Храните ожидаемую схему и сравнивайте её с пришедшей. Любое изменение должно быть заметно.
- Приводите типы явно и проверяйте, что знаки после запятой не теряются.
- Комментируйте, зачем нужен каждый тест, чтобы его не удалили ради зелёного CI.
- Ставьте circuit breaker только на критичные данные. Для мелких проблем хватит алерта.
Практика: Python
Заголовок раздела «Практика: Python»Два примера лежат в ch03_coercion.py и ch03_circuit_breaker.py. Запуск: python3 scripts/data-quality-fundamentals-code/ch03_coercion.py.
Первый пример показывает ловушки приведения типов. int() отсекает дробную часть, а round() округляет. Дальше в выводе идут деньги в float и Decimal и перевод локального времени в UTC.
for x in (4.00, 4.49, 4.99, -4.99): print(f"int({x}) = {int(x)} round({x}) = {round(x)}")== 1. Type coercion: float -> intint(4.0) = 4 round(4.0) = 4int(4.49) = 4 round(4.49) = 4int(4.99) = 4 round(4.99) = 5int(-4.99) = -4 round(-4.99) = -5int('4') = 4 но int('4.99') даёт ошибку: ValueError
== 2. Деньги: float и Decimal0.1 + 0.2 = 0.30000000000000004Decimal('0.1') + Decimal('0.2') = 0.3
== 3. Локальное время в UTC2024-03-10 09:30:00 (UTC+3) -> 2024-03-10T06:30:00+00:002024-03-10 08:15:00 (UTC-5) -> 2024-03-10T13:15:00+00:002024-03-10 14:00:00 (UTC+9) -> 2024-03-10T05:00:00+00:00Второй пример — это circuit breaker в миниатюре. Если критичная проверка падает, цепь открывается и следующие шаги не запускаются. Мелкая проблема даёт только предупреждение.
# (название, функция, критичная ли проверка)CHECKS = [("freshness", check_freshness, True), ("volume", check_volume, True), ("schema", check_schema, True), ("nulls", check_nulls, False)]Хороший батч [OK ] freshness: возраст данных 3:00:00, максимум 6:00:00 [OK ] volume: строк 1000, ожидаем от 800 до 1200 [OK ] schema: все колонки на месте [OK ] nulls: доля пустых customer_id 0.2%, максимум 1.0% цепь ЗАКРЫТА: transform и load запущеныПлохой батч [STOP] freshness: возраст данных 16:00:00, максимум 6:00:00 [STOP] volume: строк 120, ожидаем от 800 до 1200 [STOP] schema: нет колонок: ['customer_id'] [OK ] nulls: доля пустых customer_id 0.0%, максимум 1.0% цепь ОТКРЫТА: transform и load не запущены, алерт отправлен владельцуБатч с мелкой проблемой [OK ] freshness: возраст данных 3:00:00, максимум 6:00:00 [OK ] volume: строк 1000, ожидаем от 800 до 1200 [OK ] schema: все колонки на месте [WARN] nulls: доля пустых customer_id 4.0%, максимум 1.0% цепь ЗАКРЫТА: transform и load запущеныПрактика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку.
Шаг 1. Создаём данные с дефектами
Заголовок раздела «Шаг 1. Создаём данные с дефектами»В данных пять ошибок: дубль order_id, пустой клиент, опечатка в статусе, несуществующий клиент и возврат больше платежа.
CREATE TABLE customers ASSELECT * FROM (VALUES (1, 'Анна'), (2, 'Борис'), (3, 'Вера')) t(customer_id, name);
CREATE TABLE orders ASSELECT * FROM (VALUES    (101, 1,    'paid',    120.00),    (102, 2,    'paid',     80.50),    (103, 3,    'shipped', 200.00),    (104, 1,    'paid',     15.00),    (104, 2,    'paid',     15.00),  -- дубль order_id    (105, NULL, 'paid',     60.00),  -- нет клиента    (106, 3,    'payd',     30.00),  -- опечатка в статусе    (107, 9,    'new',      45.00)   -- клиента 9 нет в customers) t(order_id, customer_id, status, amount);
CREATE TABLE payments ASSELECT * FROM (VALUES    (1, 101,  120.00), (2, 102, 80.50), (3, 103, 200.00),    (4, 106,   50.00), (5, 106, -70.00)  -- возврат больше оплаты) t(payment_id, order_id, amount);
Шаг 2. Запускаем тесты
Заголовок раздела «Шаг 2. Запускаем тесты»Каждый тест ищет «плохие» строки, а мы считаем их. На здоровых данных везде будет 0. Это проверки dbt: not_null, unique, accepted_values, relationships и singular-тест про сумму платежей.
SELECT test, failed_rows FROM ( SELECT 'not_null: orders.customer_id' AS test, count(*) AS failed_rows FROM orders WHERE customer_id IS NULL UNION ALL SELECT 'unique: orders.order_id', count(*) FROM ( SELECT order_id FROM orders GROUP BY order_id HAVING count(*) > 1) UNION ALL SELECT 'accepted_values: orders.status', count(*) FROM orders WHERE status NOT IN ('new', 'paid', 'shipped', 'cancelled') UNION ALL SELECT 'relationships: orders -> customers', count(*) FROM orders o LEFT JOIN customers c USING (customer_id) WHERE o.customer_id IS NOT NULL AND c.customer_id IS NULL UNION ALL SELECT 'singular: сумма платежей заказа >= 0', count(*) FROM ( SELECT order_id, sum(amount) AS total_amount FROM payments GROUP BY order_id HAVING NOT (sum(amount) >= 0))) ORDER BY test;┌──────────────────────────────────────┬─────────────┐│ test │ failed_rows ││ varchar │ int64 │├──────────────────────────────────────┼─────────────┤│ accepted_values: orders.status │ 1 ││ not_null: orders.customer_id │ 1 ││ relationships: orders -> customers │ 1 ││ singular: сумма платежей заказа >= 0 │ 1 ││ unique: orders.order_id │ 1 │└──────────────────────────────────────┴─────────────┘Каждый из пяти тестов нашёл свою ошибку. Пустой клиент не попал в relationships: тест not_null ловит его отдельно.
Задания
Заголовок раздела «Задания»Задание 1. Volume. За десять дней загрузили таблицу daily_loads. Найдите день, когда строк меньше половины среднего за предыдущие дни (до 7 дней).
CREATE TABLE daily_loads ASSELECT d::DATE AS load_date, CASE WHEN d::DATE = DATE '2024-03-10' THEN 180 ELSE 1000 + (extract(day FROM d)::INT * 37) % 90 END AS rows_loadedFROM generate_series(DATE '2024-03-01', DATE '2024-03-10', INTERVAL 1 DAY) t(d);Решение
SELECT load_date, rows_loaded, round(avg_prev) AS avg_prevFROM (SELECT *, avg(rows_loaded) OVER ( ORDER BY load_date ROWS BETWEEN 7 PRECEDING AND 1 PRECEDING) AS avg_prev FROM daily_loads)WHERE rows_loaded < 0.5 * avg_prev;┌────────────┬─────────────┬──────────┐│ load_date │ rows_loaded │ avg_prev ││ date │ int32 │ double │├────────────┼─────────────┼──────────┤│ 2024-03-10 │ 180 │ 1042.0 │└────────────┴─────────────┴──────────┘Оконная функция считает среднее по предыдущим дням. Загрузка 10 марта намного меньше нормы.
Задание 2. Known invariants. В таблице finance прибыль должна равняться выручке минус затраты. Найдите строки, где это не так.
CREATE TABLE finance ASSELECT * FROM (VALUES (1, 500, 300, 200), (2, 400, 250, 150), (3, 450, 300, 170)) t(month_no, revenue, cost, profit);Решение
SELECT * FROM finance WHERE profit <> revenue - cost;┌──────────┬─────────┬───────┬────────┐│ month_no │ revenue │ cost │ profit ││ int32 │ int32 │ int32 │ int32 │├──────────┼─────────┼───────┼────────┤│ 3 │ 450 │ 300 │ 170 │└──────────┴─────────┴───────┴────────┘В третьем месяце прибыль должна быть 150, а записано 170.
Задание 3. Type coercion. Найдите строки, которые нельзя привести к числу. Потом посмотрите, как DuckDB приводит дробные числа к целым.
CREATE TABLE raw_amounts ASSELECT * FROM (VALUES (1, '120.50'), (2, '80'), (3, 'n/a'), (4, '4,99')) t(id, amount_text);Решение
SELECT id, amount_text FROM raw_amountsWHERE TRY_CAST(amount_text AS DECIMAL(10, 2)) IS NULL;
SELECT 4.99::DOUBLE::INTEGER AS cast_4_99, 4.5::DOUBLE::INTEGER AS cast_4_5, 5.5::DOUBLE::INTEGER AS cast_5_5;┌───────┬─────────────┐│ id │ amount_text ││ int32 │ varchar │├───────┼─────────────┤│ 3 │ n/a ││ 4 │ 4,99 │└───────┴─────────────┘┌───────────┬──────────┬──────────┐│ cast_4_99 │ cast_4_5 │ cast_5_5 ││ int32 │ int32 │ int32 │├───────────┼──────────┼──────────┤│ 5 │ 4 │ 6 │└───────────┴──────────┴──────────┘TRY_CAST возвращает NULL вместо ошибки, поэтому плохие строки легко найти. Запятая в '4,99' тоже не прошла. DuckDB округляет 4,99 до 5, а int() в Python отсекает до 4. Правило зависит от системы, поэтому проверяйте его в своей.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему entrypoint самое «грязное» место пайплайна и какие три источника там встречаются?
- Чем поломка датчика отличается от поломки приложения и как её заметить?
- Почему в stream качество данных обычно ниже, чем в batch, и почему обычные тесты там плохо работают?
- Чем синтаксическая неоднозначность отличается от семантической и какая опаснее?
- Когда стоит выбрать dbt tests, когда Great Expectations, а когда Deequ?
- Когда нужен circuit breaker и чем рискует команда, которая ставит его везде?
Предыдущая: Глава 2. Из чего собрать надёжную систему данных. Следующая: Глава 4. Мониторинг и поиск аномалий в пайплайнах.