

Data Quality Fundamentals, глава 9: Качество данных на практике: беседы и кейсы
Главная мысль: Надёжные данные зависят не только от тестов и мониторинга. Им нужны правильная организация (владение данными в доменах, как в data mesh), метаданные с понятным применением и вовремя начатая работа над качеством. Авторы показывают это на беседе с Zhamak Dehghani, на истории Kolibri Games и на семи сигналах, что пора заниматься data quality.
О чём глава
Заголовок раздела «О чём глава»Как выглядит надёжность данных в живой компании, а не в учебнике? В главе 8 речь шла о том, как сделать качество делом всей компании. Теперь авторы смотрят на соседние практики, от которых зависит надёжность. Они обещают пять тем: data mesh, качество в переходе на облачный стек, графы знаний, data discovery и момент старта. Отдельного раздела про графы знаний в главе нет: вместо него идёт раздел о метаданных. Облачный стек показан через историю Kolibri Games. В главе 10 авторы подведут итоги.
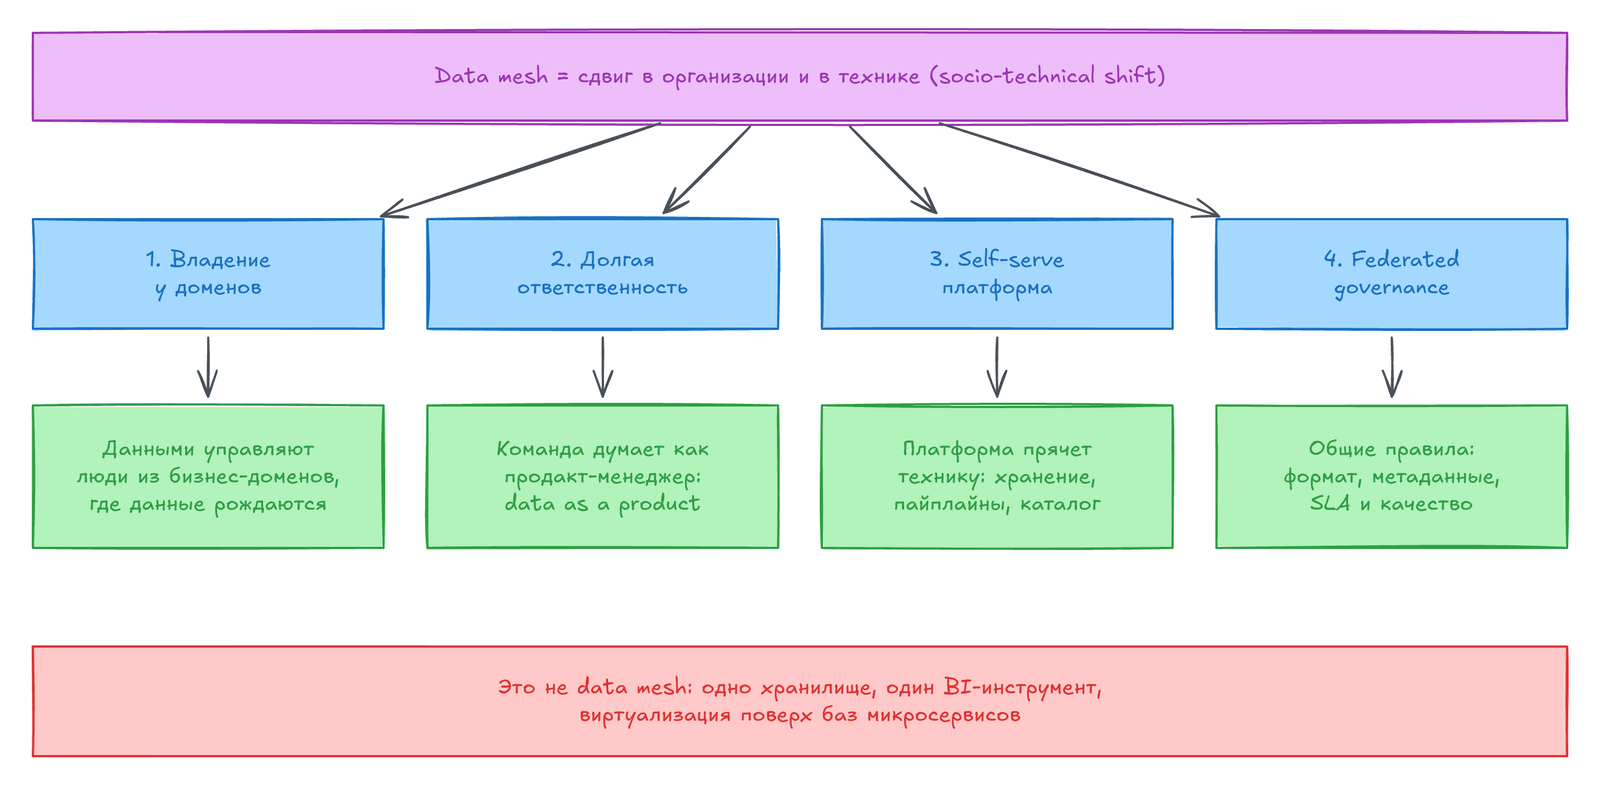
На схеме показаны четыре элемента data mesh из беседы с Zhamak Dehghani и то, что к нему не относится.
Data mesh и качество данных
Заголовок раздела «Data mesh и качество данных»Многие компании называют себя «data-first», но их архитектура не масштабируется. Команда данных тонет в ad hoc запросах и в центральном ETL-пайплайне, а хранилище или озеро в одних руках перестаёт справляться. Тогда команды переходят к распределённой модели с «федеративным управлением» (federated governance). Это data mesh. Авторы сравнивают его с переходом от монолита к микросервисам. Термин ввела Zhamak Dehghani, консультант Thoughtworks. Её определение: архитектура платформы данных, которая учитывает, что данные есть везде в компании, и строится вокруг доменов и самообслуживания.
Основа mesh — это domain-driven design Эрика Эванса: структура и язык кода совпадают с бизнес-доменом. Вместо одного озера у каждого домена свои пайплайны, а данные считаются продуктом (data as a product). Домены связывает слой совместимости с едиными стандартами. Авторы советуют прочитать статью Zhamak «How to Move Beyond a Monolithic Data Lake to a Distributed Data Mesh», её книгу и доклад Max Schulte о переходе Zalando на mesh.
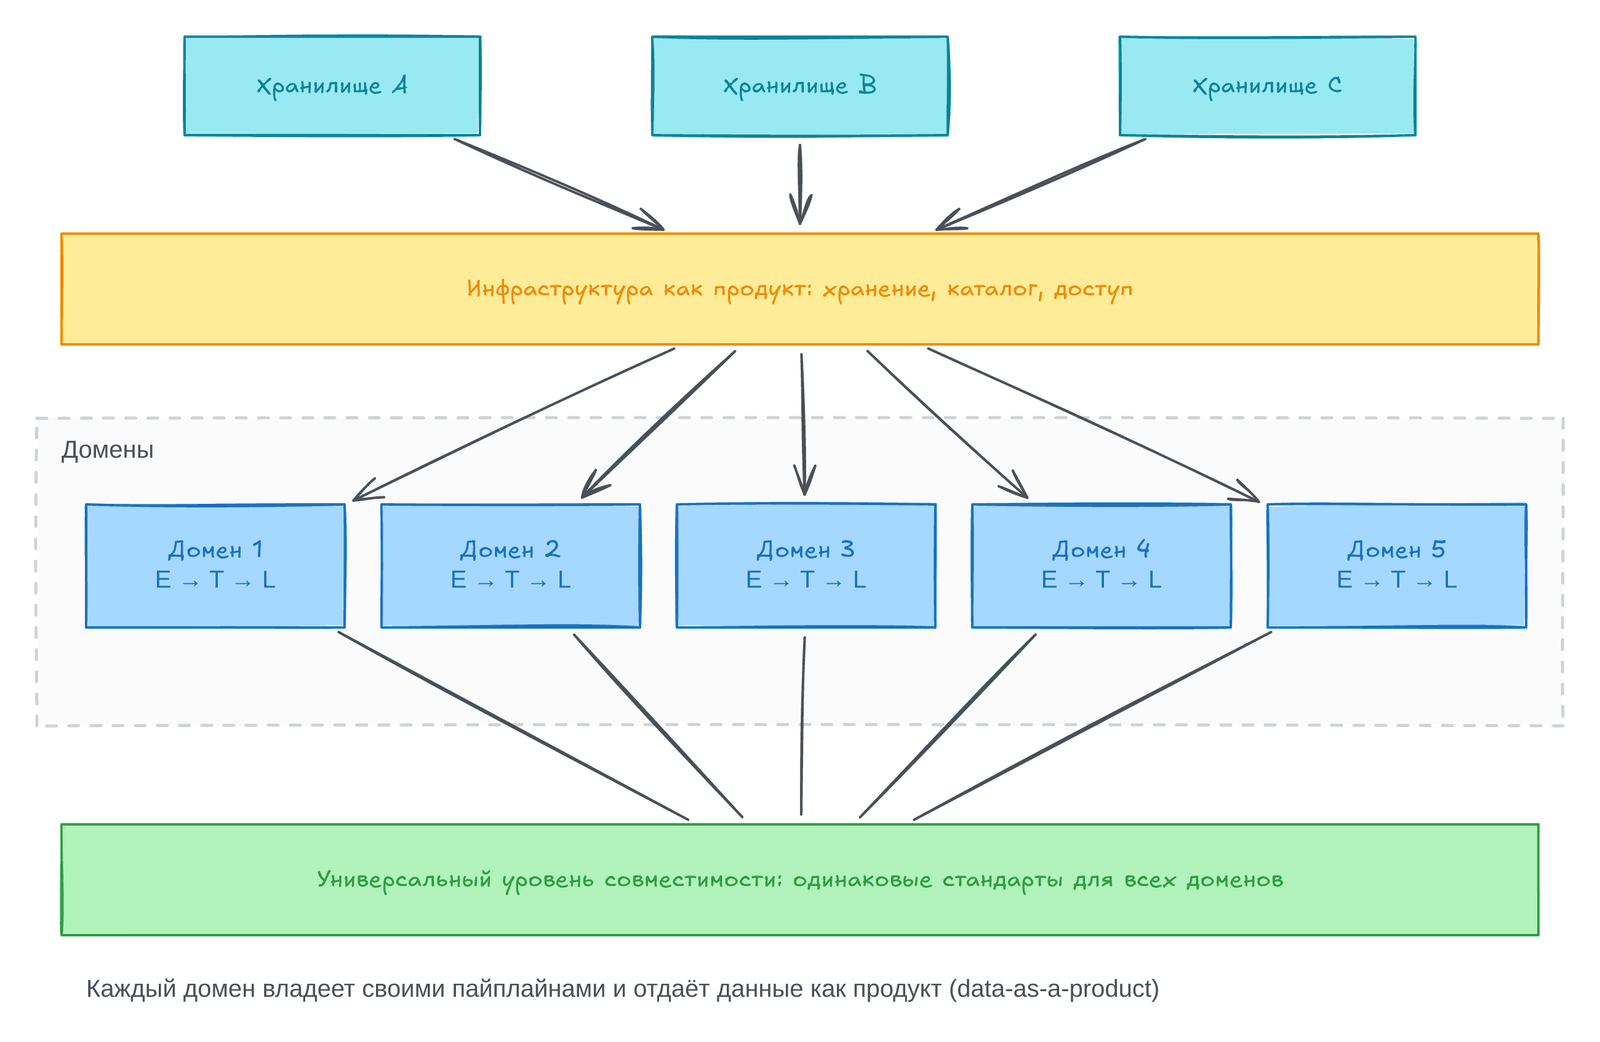
Здесь три части: источники данных, инфраструктура и доменные пайплайны под управлением функциональных владельцев. Внизу лежит слой совместимости со стандартами, наблюдаемостью и governance. Он позволяет задать единый уровень качества во всех доменах. Та же схема была в главе 1.
Домены владеют данными и pipeline
Заголовок раздела «Домены владеют данными и pipeline»Домены получают владение данными и отвечают за то, чтобы отдавать их как продукт. Сам домен занимается приёмом, очисткой и агрегацией данных для BI и владеет своими ETL-пайплайнами. А общие для всех доменов возможности позволяют хранить сырые данные, вести каталог и управлять доступом.
Self-serve платформа
Заголовок раздела «Self-serve платформа»Если у каждого домена свои люди и свои движки, труд дублируется. Поэтому общие возможности (движки пайплайнов, хранилище, стриминг) выносят в центральную платформу. Домены пользуются ими для своих ETL и сохраняют автономию.
Совместимость и общие стандарты
Заголовок раздела «Совместимость и общие стандарты»Часть данных нужна нескольким доменам. Поэтому mesh стандартизирует формат, governance, поиск и поля метаданных. Как и микросервис, домен заранее согласует SLA и меры качества, которые «гарантирует» потребителям.
Зачем нужен data mesh
Заголовок раздела «Зачем нужен data mesh»Раньше компании держали одно хранилище, которое вела небольшая группа и на котором копился технический долг. К 2020 году в моде было озеро данных с потоковой обработкой. У такой схемы два недостатка: центральный ETL даёт командам мало контроля над растущими объёмами, а разным задачам нужны разные преобразования, и платформа перегружена. Итог: производители данных отключены от процесса, потребители теряют терпение, команда данных тонет в бэклоге. Mesh даёт лучшее из двух миров: общую базу и домены, которые сами отвечают за пайплайны. Zhamak считает, что архитектуру проще всего масштабировать, разбив её на домены. Self-serve платформа заодно автоматизирует стандарты, lineage, мониторинг, алерты, логи и метрики качества продуктов данных.
Нужен ли mesh вам
Заголовок раздела «Нужен ли mesh вам»Вокруг темы выросло сообщество, появились сотни статей и немало недопонимания. Авторы советуют задуматься о mesh командам с большим числом источников и потребностью быстро менять данные.
Считаем data mesh score
Заголовок раздела «Считаем data mesh score»Авторы дают простой расчёт: вы отвечаете на пять вопросов числами и складываете их. Сумма и есть data mesh score.
| Вопрос | Что считаем |
|---|---|
| Источники | Сколько у компании источников данных |
| Команда данных | Сколько аналитиков, инженеров и продактов |
| Домены | Функциональные команды, использующие данные, плюс продукты, плюс data-фичи |
| Узкое место | Как часто data engineering тормозит новые продукты данных (1 «никогда», 10 «всегда») |
| Governance | Насколько он важен (1 «мне всё равно», 10 «не даёт спать») |
Чем выше сумма, тем сложнее инфраструктура и тем вероятнее польза от mesh. Если сумма выше 10, уже стоит взять часть практик. Если выше 30, вы в «сладкой зоне». Расшифровка такая:
- 1–15. Экосистема мала и однородна, mesh, скорее всего, не нужен.
- 15–30. Компания быстро растёт. Стоит взять часть практик mesh, чтобы позже мигрировать проще.
- 30 и выше. Команда данных двигает компанию, и mesh поддержит демократизацию данных.
Авторы ждут, что mesh станет обычным для облачных компаний больше чем на 300 человек. Расчёт запустим в практике ниже.
Беседа с Zhamak Dehghani
Заголовок раздела «Беседа с Zhamak Dehghani»Авторы поговорили с Zhamak Dehghani, пока писали книгу. Она развеяла частые мифы о data mesh.
Можно ли собрать data mesh из одного продукта?
Заголовок раздела «Можно ли собрать data mesh из одного продукта?»Нет. Zhamak называет mesh «социо-техническим сдвигом» (socio-technical shift) в том, как мы собираем, ведём и делим аналитические данные. Это организационная парадигма, а не набор технологий. Микросервисную архитектуру нельзя построить на одной базе данных, и mesh нельзя построить только на хранилище или BI-инструменте. Архитектуру можно считать data mesh, если в ней есть четыре элемента:
- владение данными перешло от центральной команды к тем, кто подходит лучше всего, часто к доменам-источникам;
- у команд есть долгая ответственность и продуктовое мышление: данные — это продукт;
- команды получили self-serve инфраструктуру данных;
- новые проблемы решает новая модель federated governance.
Data mesh и data virtualization
Заголовок раздела «Data mesh и data virtualization»Data virtualization значит, что приложение читает данные из многих разрозненных систем. Раньше виртуализация лежала поверх OLTP-баз и микросервисов и отдавала данные как есть. Для mesh, по словам Zhamak, это плохая идея. База, оптимизированная под транзакции, открывается для аналитики. А прогнозная аналитика и исторические тренды требуют совсем другого вида данных.
У каждой команды своё хранилище?
Заголовок раздела «У каждой команды своё хранилище?»Тоже нет. Если у каждой команды своё хранилище, дублирование и плохое качество растут, как и стоимость. Продукту данных нужна автономия, но не отдельный физический слой. Если mesh живёт в одном облаке, слой хранения может быть общим. Схемы, права доступа и модель аренды (tenancy) при этом независимы. Хранилище обычно ведёт центральная инженерная команда, а аналитики и data scientist в доменах строят дашборды и модели поверх него.
Self-serve платформа и data mesh: одно и то же?
Заголовок раздела «Self-serve платформа и data mesh: одно и то же?»Нет. Большинство платформ построено для центральных команд, чтобы они быстрее разбирали бэклог. Платформа для mesh должна дать доменам автономию, а generalist-технологам — возможность создавать продукты данных. Команда ведёт данные от начала до конца и сама отдаёт их потребителям.
Подходит ли data mesh всем командам?
Заголовок раздела «Подходит ли data mesh всем командам?»Нет: модель ещё «довольно молодая». Больше всего смысла в ней там, где надо масштабировать надёжность данных. Первыми приходят компании, ориентированные на инженерию, готовые и строить, и покупать. Если заинтересованные стороны страдают от поиска данных, а цикл инноваций замедлился, вы, возможно, подходите.
Кто «владеет» data mesh?
Заголовок раздела «Кто «владеет» data mesh?»Одного владельца нет. Нужна поддержка сверху: данные и платформы слишком заметны и политизированы. Chief data officer, подчинённый CEO, обычно ускоряет внедрение. Но владеть данными будут домены. Zhamak говорит: «если домены не на борту, мы лишь переусложняем распределение данных внутри центральной команды». Для старта нужны один-три домена-союзника. Инфраструктурных инженеров убеждать обычно не нужно: они сами чувствуют боль.
Мешает ли data mesh инженерам и аналитикам?
Заголовок раздела «Мешает ли data mesh инженерам и аналитикам?»Наоборот, чаще он их мирит. Во время инцидентов инженеры, моделисты и аналитики обычно показывают пальцем друг на друга. Единые стандарты mesh фиксируют договорённость о качестве, поиске и схеме продукта. В хороший mesh входят шифрование, версионирование и схема продукта данных, каталог, governance, lineage, мониторинг с алертами и логами, метрики качества. Вместе они дают слой наблюдаемости и доверия. Zhamak надеется, что для lineage, метрик и SLO вырастут открытые стандарты, как это было с логами. Авторы добавляют: такая структура заставляет отвечать на вопросы governance. Когда использовать данные? Какие стандарты нужны всем? За что отвечает каждый домен? Многие компании применяют идеи mesh давно, просто не знали названия.
Кейс: путь Kolibri Games по стеку данных
Заголовок раздела «Кейс: путь Kolibri Games по стеку данных»António Fitas, бывший head of Data Engineering в берлинской Kolibri Games, собирал стек данных с первой версии. Студия выросла из стартапа в студенческой квартире в 2016 году до сделки с Ubisoft в 2020. Релиз выходит почти каждую неделю, поток данных огромен: 100 миллионов событий в день, 40 типов событий. Команда данных выросла с одного маркетинг-аналитика до 10+ человек, и теперь строит mesh.
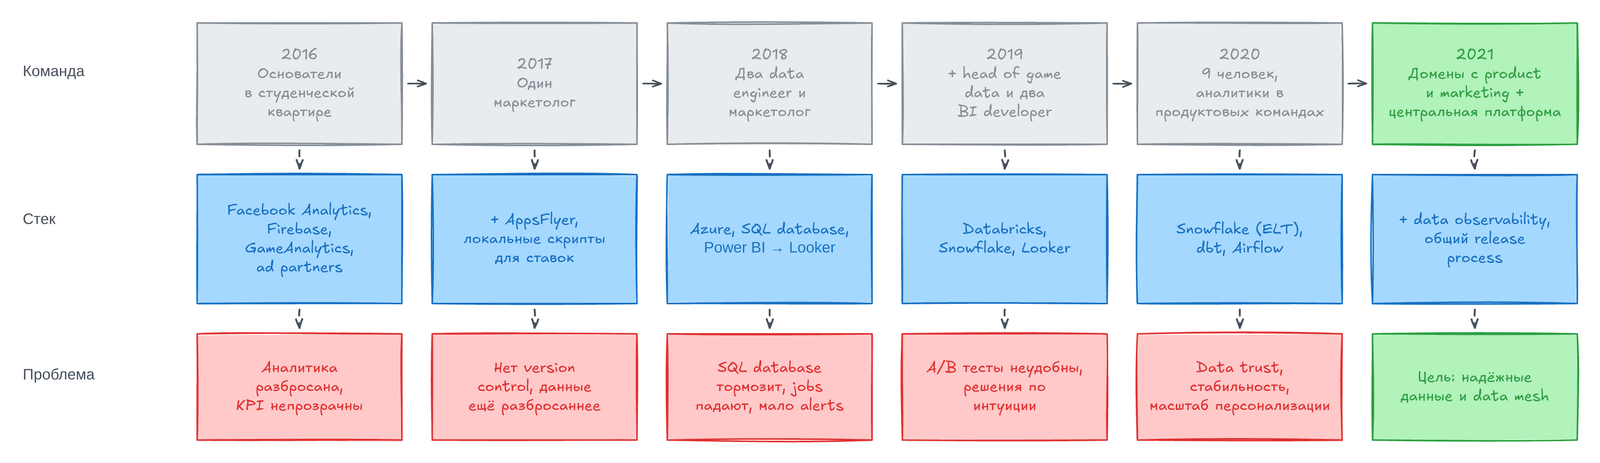
Схема показывает по годам команду, стек и главную проблему.
Первые потребности
Заголовок раздела «Первые потребности»В 2016 основатели делали игру в студенческой квартире при Karlsruhe Institute of Technology. Первая игра, Idle Miner Tycoon, быстро добилась успеха. Данные нужны были, чтобы понять, работает ли игра и зарабатывает ли компания: выручка от покупок и рекламы, игровые KPI, сбои. Стартап взял только сторонние инструменты: Facebook Analytics, данные рекламных партнёров, Firebase и GameAnalytics. Качество не было приоритетом, и позже это вышло боком: аналитика была разбросана, было неясно, как считают KPI, отчёты расходились, интеграции SDK ломались. Игроки приходили органически, но хотелось больше, поэтому взялись за маркетинг на данных.
Performance marketing
Заголовок раздела «Performance marketing»Компания переехала в офис в Карлсруэ. «Командой данных» был один маркетинг-менеджер. Он считал return on ad spend, прогнозировал lifetime value и писал скрипт для ставок. Добавили AppsFlyer, SaaS для атрибуции кампаний. Но не было прозрачности и version control. «Мы были как будто с завязанными глазами», — вспоминает António. При этом второй год закончился с выручкой выше €10 млн.
2018: профессионализация и централизация
Заголовок раздела «2018: профессионализация и централизация»Компания переехала в Берлин. Пришёл António, как раз к 50 миллионам скачиваний, и с ещё одним дата-инженером начал строить настоящую организацию данных. Цель: собрать данные в одном месте, построить центральное хранилище и дашборды. Почти всё взяли в Azure, построили телеметрию событий и пакетную загрузку из API в озеро. Power BI сменили на Looker из-за version control. Узким местом стала SQL database: загрузка, дашборды и ad hoc запросы мешали друг другу, jobs падали, алертов почти не было.
2019: ориентация на данные
Заголовок раздела «2019: ориентация на данные»Компания достигла 100 миллионов скачиваний и 100 сотрудников. Цели: понять поведение игроков, ставить A/B тесты и ускорить хранилище. Добавили head of game data и двух BI developer. Часть Azure заменили на Databricks. Но озеро как хранилище на Spark не прижилось: команда предпочитала Python и SQL, а Looker на Spark был медленным. Поэтому SQL database сменил Snowflake, главный движок аналитики. Но A/B тесты были неудобны, а решения в играх принимали «по интуиции и отзывам сообщества».
2020: данные ведут решения
Заголовок раздела «2020: данные ведут решения»Ubisoft купил Kolibri Games, а команду вдохновили data mesh и доменное владение. Ввели SLA по данным и расширили self-serve. Цели, которые отслеживали с продуктовыми менеджерами: 90% решений по Idle Miner Tycoon подкреплены данными, time-to-insight меньше часа на 90% вопросов, 90% изменений проверено аналитикой. Новые аналитики шли прямо в продуктовые команды, пришли третий дата-инженер и два data scientist. Команда перешла с ETL на ELT в Snowflake, добавила dbt и Airflow. Продуктовые аналитики вместе с разработчиками игры сами определяли новые события, без дата-инженера. Но остались проблемы: data trust, стабильность софта и масштаб персонализации. По словам António, данных и моделей стало слишком много, чтобы следить за тем, всё ли верно.
2021: строим data mesh
Заголовок раздела «2021: строим data mesh»Фокус сместился на доверие и надёжность как основу для mesh: больше тестов, общий процесс релиза, больше мониторинга и алертов, доменные кросс-функциональные команды. В домены продукта и маркетинга добавили проджект-менеджеров и BI developer. Центральная платформа строит фреймворки и инфраструктуру. Для качества выбрали мониторинг всех активов хранилища с end-to-end lineage: так быстрее находить причину инцидентов. Вложились в dbt и data observability.
Пять выводов из пяти лет
Заголовок раздела «Пять выводов из пяти лет»Быть data-driven — это марафон. Вот выводы António, которые подойдут команде любого размера:
- Свой стек данных окупается.
- Платформу придётся менять, поэтому важно понимать, когда и для какого объёма данных.
- Для доверия нужна высокая
data observability: видеть проблему и легко о ней сообщать. - Сначала база, потом сложное. Аналитиков надо было нанять раньше.
- Культура данных порой важнее правильного стека.
Авторы добавляют: технологии и процессы дают лишь часть результата. Всё начинается и заканчивается культурой.
Метаданные на службе бизнеса
Заголовок раздела «Метаданные на службе бизнеса»Команды научились собирать много данных, а теперь собирают метаданные (metadata): данные о данных. Это хорошо: dbt упрощает их отслеживание, облака облегчают обмен. Но ошибка прошлого повторяется: метаданные без применения бесполезны. Даже lineage без контекста — это «просто красивая картинка» для демо руководству. Авторы называют три применения:
- Оценить влияние изменения. Без lineage вы меняете поле вслепую. С lineage на уровне таблиц и полей видно, каких потребителей это заденет.
- Найти первопричину. Ночью сломался дашборд для руководства, а в хранилище 100 000 таблиц. Lineage сразу показывает активы выше по потоку, ведущие к
data downtime. - Объяснить потребителям, что сломалось. Допустим, ETL прошёл, но в колонке 80% null: тихий сбой. Lineage подскажет, кого предупредить.
Метаданные должны отвечать не только на «кто, что, где, когда, почему». Потребителям нужны ответы и на другие вопросы. Важны ли эти данные и что они значат? Можно ли использовать их безопасно? Откуда они? Кто полагается на актив, когда я его меняю? Можно ли им доверять? Для ответов команды берут API к инструментам, каталоги, документацию и lineage, но им не хватает применения к боли бизнеса. Авторы шутят: метаданные без применения — как слон на велосипеде: впечатляет, но бесполезно. Нужно спрашивать себя: какой цели служат эти метаданные и какую реальную боль потребителей они решают?
Data discovery: ценность метаданных
Заголовок раздела «Data discovery: ценность метаданных»Технологии доступа к данным в облаке повзрослели, а способы их понимать в распределённой среде отстают. Авторы показывают, где проваливаются каталоги и как им помогает data discovery (федеративный каталог), чтобы озеро не стало болотом (data swamp). О технике каталогов смотрите главу 2.
Хранилище или озеро
Заголовок раздела «Хранилище или озеро»Хранилище даёт структуру, но оно негибкое и местами дорогое. Озеро гибко, но приносит проблемы с организацией и governance. Команды с озером или lakehouse часто не могут ответить: где лежат данные, кто имеет доступ, как их использовать, свежие ли они, как ими пользуется бизнес.
Каталоги тонут в озере и в mesh
Заголовок раздела «Каталоги тонут в озере и в mesh»Каталог (data catalog) — это инвентаризация метаданных. Хранилище заставляет структурировать данные, поэтому их легко каталогизировать. В озере данные распределены и меняются, а каталог обычно ведут вручную. Без автоматизации такое управление не масштабируется. То же в mesh: каталоги плохо адаптируются к новому, и состояние данных «сейчас» неясно.
От каталога к data discovery
Заголовок раздела «От каталога к data discovery»Каталог редко распределён и видит данные одномерными. К тому же у неструктурированных данных нет модели, на которую он опирается. Без lineage команды тратят время на тушение проблем. Инженерам нужен API, а не только UI, и учёт разных точек входа в озеро. Данные в озеро приходят сырыми, лежат в JSON или Parquet, их читают Spark и Presto, и поломок много. Data discovery вырос из доменной архитектуры mesh.
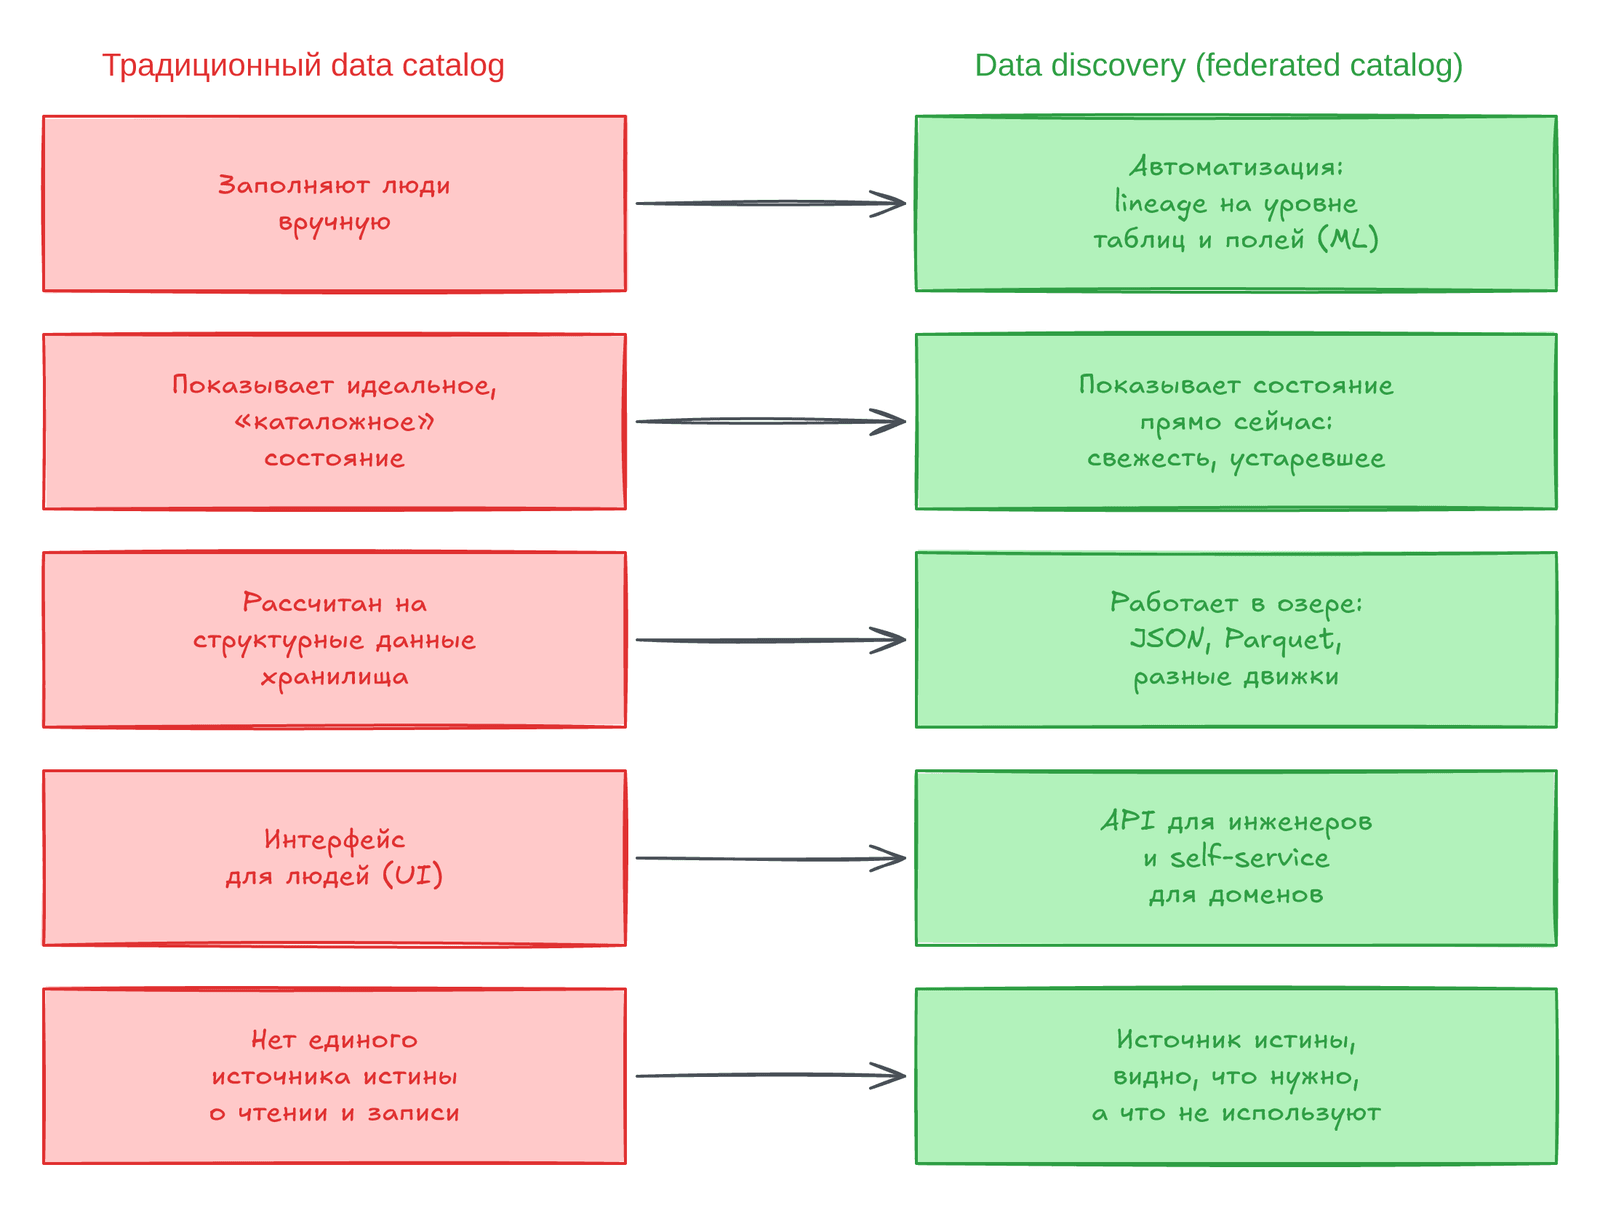
Слева слабые места каталога, справа — ответ discovery. Он закрывает пробелы пятью способами:
- Автоматизация. С помощью ML инструмент сам строит lineage на уровне таблиц и полей.
- Состояние сейчас. Видно, какие наборы устарели и когда обновлялась таблица.
- Влияние на бизнес. Lineage ловит незаметные изменения схемы и показывает зависимости.
Self-serveв доменах. Команды понимают данные без службы поддержки. Для доверия добавьтеdata observability.- Governance и оптимизация. В озере данные читают разными инструментами, и единого источника истины нет. Discovery может стать таким источником. Он же показывает самые востребованные и ненужные активы.
Авторы надеются наконец отказаться от шуток про «data swamp». Но неважно, насколько данные находимы, если им не доверяют. Качество редко идёт первым, но заняться им стоит рано, чтобы избежать лишнего data downtime.
Когда начинать заниматься data quality
Заголовок раздела «Когда начинать заниматься data quality»Частый вопрос лидеров данных: «Когда стоит вкладываться в data quality?» Ответ: «Это зависит». Строя платформу, люди думают о запуске, а не о доверии. Data observability бывает лишней там, где пара дашбордов подключена к локальной базе. Но многие компании вкладываются в платформу, а использование и доверие не растут. Авторы называют семь опережающих признаков.
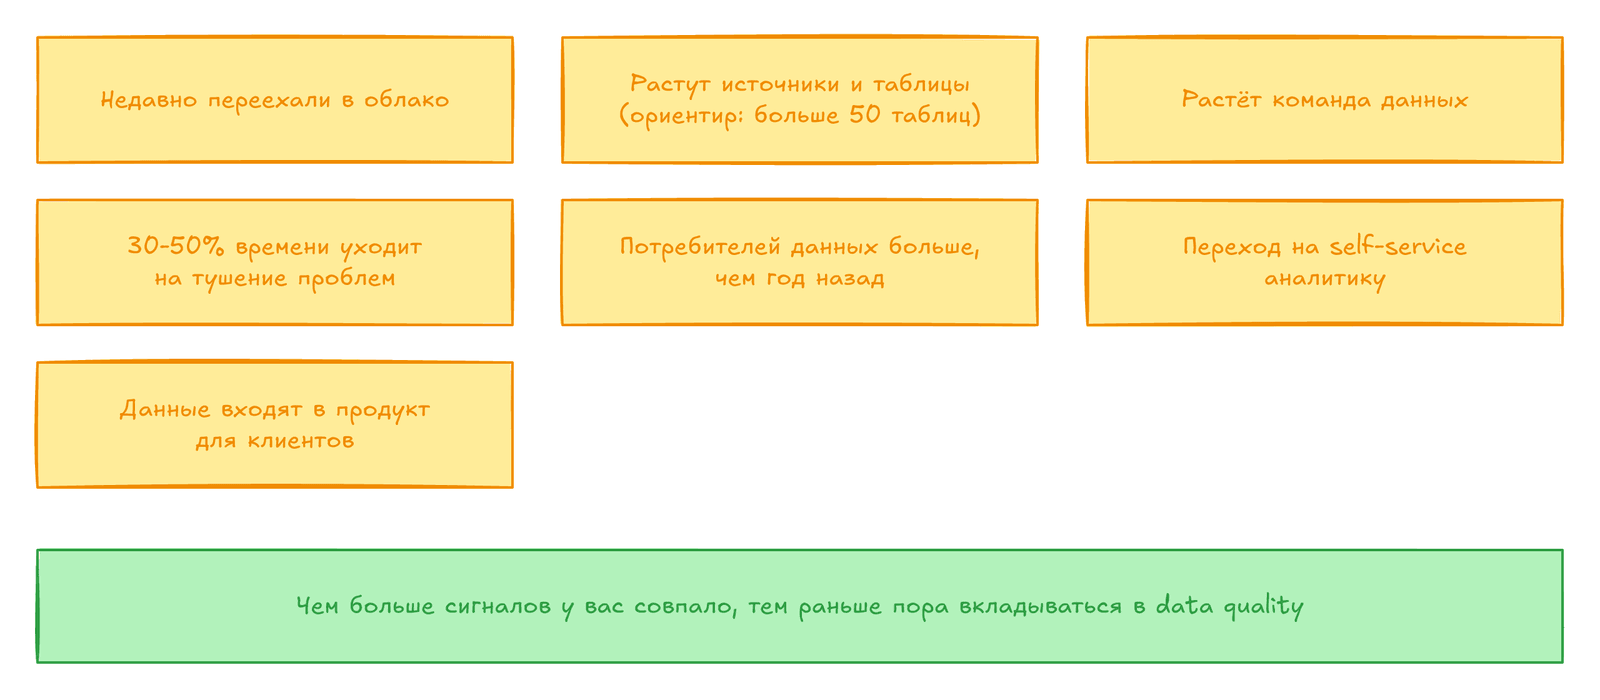
Чем больше сигналов совпадает с вашей ситуацией, тем раньше пора начинать.
Вы недавно переехали в облако
Заголовок раздела «Вы недавно переехали в облако»При переезде в озеро или между облаками (скажем, с Amazon Redshift на Snowflake) причины обычно такие: платформа устарела, не масштабируется без ручного труда или дорога. Какой бы ни была причина, нужно укрепить доверие к платформе и сохранить скорость. Для AutoTrader UK data observability была частью первого переезда в облако. Edward Kent, Principal Developer, объясняет: пользователи старых систем должны верить, что новые так же надёжны.
Стек растёт: больше источников, таблиц и сложности
Заголовок раздела «Стек растёт: больше источников, таблиц и сложности»Жёсткого правила нет, но ориентир авторов: больше 50 таблиц. Если таблиц меньше, а цена простоя высока, observability всё равно разумна. Важна и скорость роста. Рекламная платформа Choozle ждала «разрастания таблиц» (table sprawl). По словам CTO Adam Woods, когда рекламодатель подключает Google, Bing или Facebook, Fivetran сам кладёт данные в хранилище, а CTO не знает, когда создан коннектор. Нужен мониторинг, иначе первыми узнают клиенты.
Команда данных растёт
Заголовок раздела «Команда данных растёт»Команда меняется (от централизованной к децентрализованной), знания остаются у первых сотрудников. Без проактивного подхода технический долг копится. Один клиент авторов столкнулся с проблемой «You’re Using That Table?!»: аналитики не понимают, какие таблицы живые, а какие устарели. Помогают сертификация данных (data certification) и сквозной lineage. Даже команде из одного человека полезна автоматизация.
Команда тратит на тушение проблем не меньше 30% времени
Заголовок раздела «Команда тратит на тушение проблем не меньше 30% времени»Когда авторы основали Monte Carlo, они опросили больше 100 лидеров данных. Больше 60% опрошенных были на ранней стадии пути к надёжности и тратили первую половину дня на тушение проблем. Отраслевые исследования показывают, что дата-инженеры тратят 30–50% времени на сломанные пайплайны, ошибки в моделях и устаревшие дашборды.
Потребителей данных больше, чем год назад
Заголовок раздела «Потребителей данных больше, чем год назад»Растёт компания, растёт число потребителей, а с ними вероятность плохих данных. Ирония: у самых data-driven компаний больше потребителей, которые заметят ошибку. В AutoTrader UK больше 50% сотрудников ежемесячно работают в Looker, в том числе с финансовой отчётностью.
Компания переходит на self-serve аналитику
Заголовок раздела «Компания переходит на self-serve аналитику»Команда рада, что нет потока ad hoc запросов. Но потребителям нужно доверять данным, иначе смысл self-serve теряется. Проблемы бывают двух видов: предсказуемые (known unknowns) и непредсказуемые (unknown unknowns).
Данные входят в ценность продукта для клиентов
Заголовок раздела «Данные входят в ценность продукта для клиентов»«Скоро каждое приложение станет приложением данных». Toast, поставщик кассовых систем для ресторанов, отличается от конкурентов бизнес-аналитикой для клиентов. Noah Abramson, data engineering manager в Toast, говорит: «наши клиенты — это все сотрудники Toast». Стек данных становится клиентским, поэтому нужны надёжность и аптайм как у основного продукта.
Data quality начинается с доверия
Заголовок раздела «Data quality начинается с доверия»Как газовые компании доверяют своим скважинам, так организации должны доверять данным. При проактивном подходе команда первой узнаёт о проблеме, до тревожных сообщений в Slack. Иначе время уходит на тушение, а доверие падает. Лучше встроить качество в платформу как можно раньше.
Итоги главы
Заголовок раздела «Итоги главы»- Data mesh — это социо-технический сдвиг: владение у доменов, долгая ответственность, self-serve платформа и federated governance.
- Mesh не равен виртуализации данных и не значит «у каждой команды своё хранилище»: слой хранения может быть общим.
Data mesh scoreскладывает пять чисел. Ниже 15 mesh, скорее всего, не нужен, от 30 он приносит пользу.- Mesh нужна поддержка сверху и один-три домена-союзника. Без домена на борту это лишь переусложнение.
- Kolibri Games за пять лет прошла путь от сторонних инструментов до Snowflake, dbt, Airflow и observability. Проблемы с доверием выросли вместе с числом моделей.
- Вывод António Fitas: сначала база, потом сложное, а культура данных важнее стека.
- Метаданные и lineage ценны только при применении: оценка влияния, поиск первопричины, оповещение потребителей.
- Каталоги с ручным вводом не справляются с озёрами.
Data discoveryавтоматизирует lineage и показывает состояние сейчас. - Начинать заниматься качеством стоит рано: 50+ таблиц, 30% времени на тушение проблем и рост числа потребителей говорят, что время пришло.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
data mesh | Данными владеют доменные команды, платформа общая, стандарты едины |
domain-driven design | Идея Эрика Эванса: структура кода совпадает с бизнес-доменом |
data as a product | Данные отдают как продукт: с владельцем, SLA и качеством |
federated governance | Общие правила для доменов при их независимости |
data virtualization | Приложение читает данные из многих систем, не копируя их. Это не mesh |
data mesh score | Сумма пяти чисел, оценка пользы от mesh |
data discovery | Автоматическое понимание данных, федеративный каталог |
data swamp | Озеро, где ничего не найти и нельзя доверять |
known unknowns / unknown unknowns | Проблемы, которые можно предсказать, и которые нельзя |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Прежде чем внедрять mesh, посчитайте score и поговорите с доменами. Без их согласия это не mesh.
- Даже без mesh возьмите его практики: владельцев данных,
SLAи общие стандарты метаданных. - Используйте lineage в разборах инцидентов и при изменении схемы, а не только в демо.
- Если каталог заполняют вручную и он отстаёт от реальности, добавьте автоматический discovery и мониторинг свежести.
- Меряйте, сколько времени команда тратит на тушение проблем. Если на тушение уходит от 30% времени, это сигнал начинать.
- Перед открытием self-serve доступа включите мониторинг и
SLA.
Практика: data mesh score на Python
Заголовок раздела «Практика: data mesh score на Python»Вот расчёт из книги в виде функции. Границы 15 и 30 в книге попадают сразу в два диапазона, поэтому в коде мы выбрали: до 15 включительно, от 30 включительно. Компании выдуманы нами.
def mesh_score(sources, team, domains, bottleneck, governance):    assert 1 <= bottleneck <= 10 and 1 <= governance <= 10    return sources + team + domains + bottleneck + governance

def verdict(score):    if score <= 15:        return "data mesh, скорее всего, не нужен"    if score < 30:        return "взять практики data mesh, чтобы потом проще мигрировать"    return "data mesh в зоне пользы (sweet spot)"
небольшой стартап score = 13 -> data mesh, скорее всего, не нуженрастущий продукт score = 28 -> взять практики data mesh, чтобы потом проще мигрироватькрупная компания score = 112 -> data mesh в зоне пользы (sweet spot)Пояснение: сумма почти целиком зависит от трёх счётчиков (источники, люди, домены), а две оценки 1–10 добавляют немного. Считайте score грубым ориентиром. Полный скрипт: ch09_mesh_score.py.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»В книге нет кода, но есть признаки, которые можно посчитать: больше 50 таблиц, тушение от 30% времени, больше потребителей, чем год назад. Проверим их на квартальных срезах. Данные выдуманы нами. Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку.
Шаг 1. Создаём данные
Заголовок раздела «Шаг 1. Создаём данные»CREATE TABLE snapshot ASSELECT * FROM (VALUES (DATE '2024-03-31', 18, 12, 2, 60, 960), (DATE '2024-06-30', 27, 15, 2, 90, 960), (DATE '2024-09-30', 41, 24, 3, 190, 1440), (DATE '2024-12-31', 58, 31, 3, 330, 1440), (DATE '2025-03-31', 73, 40, 4, 520, 1920), (DATE '2025-06-30', 96, 52, 5, 760, 2400)) t(quarter_end, tables_cnt, consumers, engineers, firefight_hours, total_hours);Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»-- должно быть 6 кварталов и false: тушение не может занимать больше часов, чем естьSELECT count(*) AS quarters, max(firefight_hours > total_hours) AS bad_rows FROM snapshot;Задания
Заголовок раздела «Задания»1. Для каждого квартала покажите три сигнала: больше 50 таблиц, тушение от 30% времени, потребителей больше, чем год назад (четыре квартала назад).
Решение
SELECT quarter_end, tables_cnt > 50 AS many_tables, round(100.0 * firefight_hours / total_hours, 1) AS firefight_pct, firefight_hours * 1.0 / total_hours >= 0.30 AS much_firefighting, consumers > lag(consumers, 4) OVER (ORDER BY quarter_end) AS more_consumersFROM snapshotORDER BY quarter_end;Таблиц больше 50 с декабря 2024. Тушение достигло 30% только в июне 2025 (31,7%). Для первых четырёх кварталов more_consumers равен NULL: год назад данных нет.
2. Посчитайте, сколько сигналов горит в каждом квартале. Когда впервые горят два и больше?
Решение
WITH signals AS ( SELECT quarter_end, tables_cnt > 50 AS many_tables, firefight_hours * 1.0 / total_hours >= 0.30 AS much_firefighting, coalesce(consumers > lag(consumers, 4) OVER (ORDER BY quarter_end), false) AS more_consumers FROM snapshot)SELECT quarter_end, many_tables::INT + much_firefighting::INT + more_consumers::INT AS signalsFROM signalsORDER BY quarter_end;В марте 2025 горят два сигнала (таблицы и потребители), в июне 2025 все три. Первый сигнал был уже в декабре 2024: начать можно было на полгода раньше, чем тушение выросло до 30%.
3. Команда выросла с 2 до 5 инженеров. Стало ли тушения меньше на одного человека?
Решение
SELECT quarter_end, engineers, firefight_hours, round(firefight_hours * 1.0 / engineers, 1) AS firefight_per_engineerFROM snapshotORDER BY quarter_end;Нет. Команда выросла в 2,5 раза, а тушения на одного инженера стало больше в пять раз: со 30 до 152 часов за квартал. Новые люди проблему не решают: нужны проактивные проверки.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему Zhamak Dehghani называет data mesh «социо-техническим сдвигом», а не технологией? Почему нельзя построить mesh только на хранилище?
- Чем data mesh отличается от data virtualization? Почему виртуализация поверх баз микросервисов плохо подходит для аналитики?
- Чем self-serve платформа для mesh отличается от обычной платформы данных?
- Какую ошибку Kolibri Games сделала с качеством данных в 2016–2017 и что António Fitas советует делать иначе?
- Почему lineage без контекста это «просто красивая картинка»? Назовите три применения, при которых он полезен.
- Компания только что переехала в облако, а команда тратит 40% времени на тушение проблем. Какие сигналы из семи уже есть и с чего начать?
Предыдущая: Глава 8. Качество данных для всей компании. Следующая: Глава 10. Будущее надёжных систем данных.