

Data Quality Fundamentals, глава 2: Из чего собрать надёжную систему данных
Главная мысль: Данные могут сломаться на любом шаге пайплайна. Поэтому надо знать, из каких частей он состоит, и снимать метрики с каждой. Почти все метрики можно получить из метаданных: системных таблиц, журналов запросов и каталога данных.
О чём глава
Заголовок раздела «О чём глава»Из чего состоит платформа данных и где в ней мерить качество? В главе 1 авторы показали цену плохих данных и ввели понятие data downtime. Надёжность держится на трёх опорах: процессы, технологии, люди. Здесь разобраны технологии. Процессы и людей авторы оставили для главы 8.
Темы главы: операционные и аналитические данные, data warehouse, data lake и lakehouse, метрики качества на примере Snowflake, журналы запросов и каталог данных.
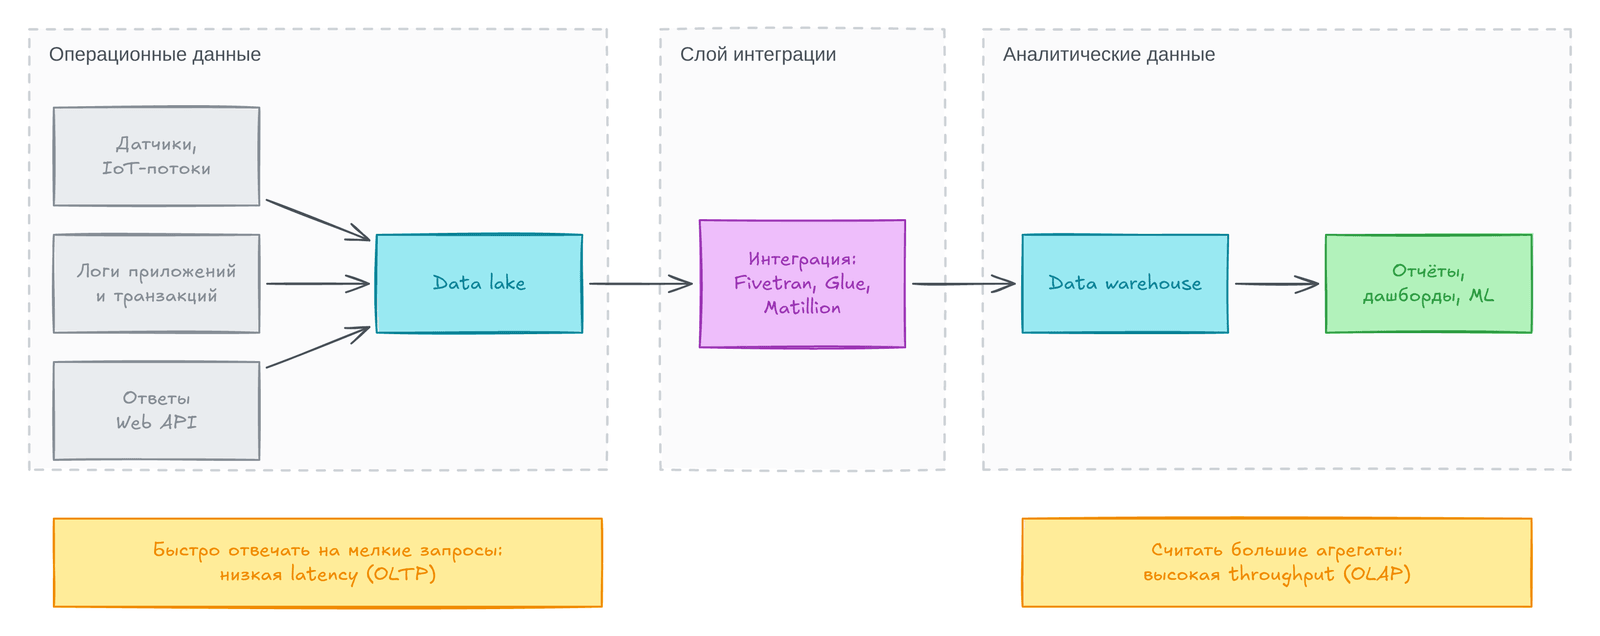
Схема показывает один из вариантов платформы. Данные идут слева направо: от операционных источников через слой интеграции к аналитическим данным.
Операционные и аналитические данные
Заголовок раздела «Операционные и аналитические данные»Операционные данные рождаются в повседневной работе компании: снимки склада, показы рекламы, записи о транзакциях. Аналитические данные стоят за бизнес-решениями: отток клиентов, кликабельность, показы по регионам. Авторы говорят так: операционные данные ведут бизнес, а аналитические помогают управлять бизнесом.
Аналитические данные кажутся важнее, но обычно строятся из агрегатов операционных. Это то же деление, что OLTP (системы для транзакций) и OLAP (системы для аналитики). Книга посвящена качеству аналитических данных, а операционными занимаются DevOps, SRE и разработчики.
Чем они отличаются
Заголовок раздела «Чем они отличаются»Операционные данные почти всегда стоят выше по потоку (upstream). Например, клик пользователя в 5 утра — это операционная запись, а кликабельность декабрьской кампании — аналитическая запись, посчитанная из таких кликов.
Главное различие — в компромиссе между throughput и latency. Throughput — сколько данных система обработает за время. Latency — задержка до обработки одного запроса. При фиксированных ресурсах нельзя улучшить оба показателя сразу. Авторы объясняют это на кофейне. Поставьте всех на кассу и кофемашину: кофе выдают быстро, но столики не убирают, и гости не помещаются. Отправьте всех в зал: столики чистые, но очередь растёт.
Поэтому транзакционную базу настраивают на низкую latency: детали заказа нужны при загрузке страницы. Аналитическую базу настраивают на высокую throughput: она считает большие агрегаты. Именно поэтому из интерфейса клиента обычно не обращаются к Snowflake или Redshift, а агрегаты на триллион строк не считают в MySQL или Postgres.
Data warehouse и data lake
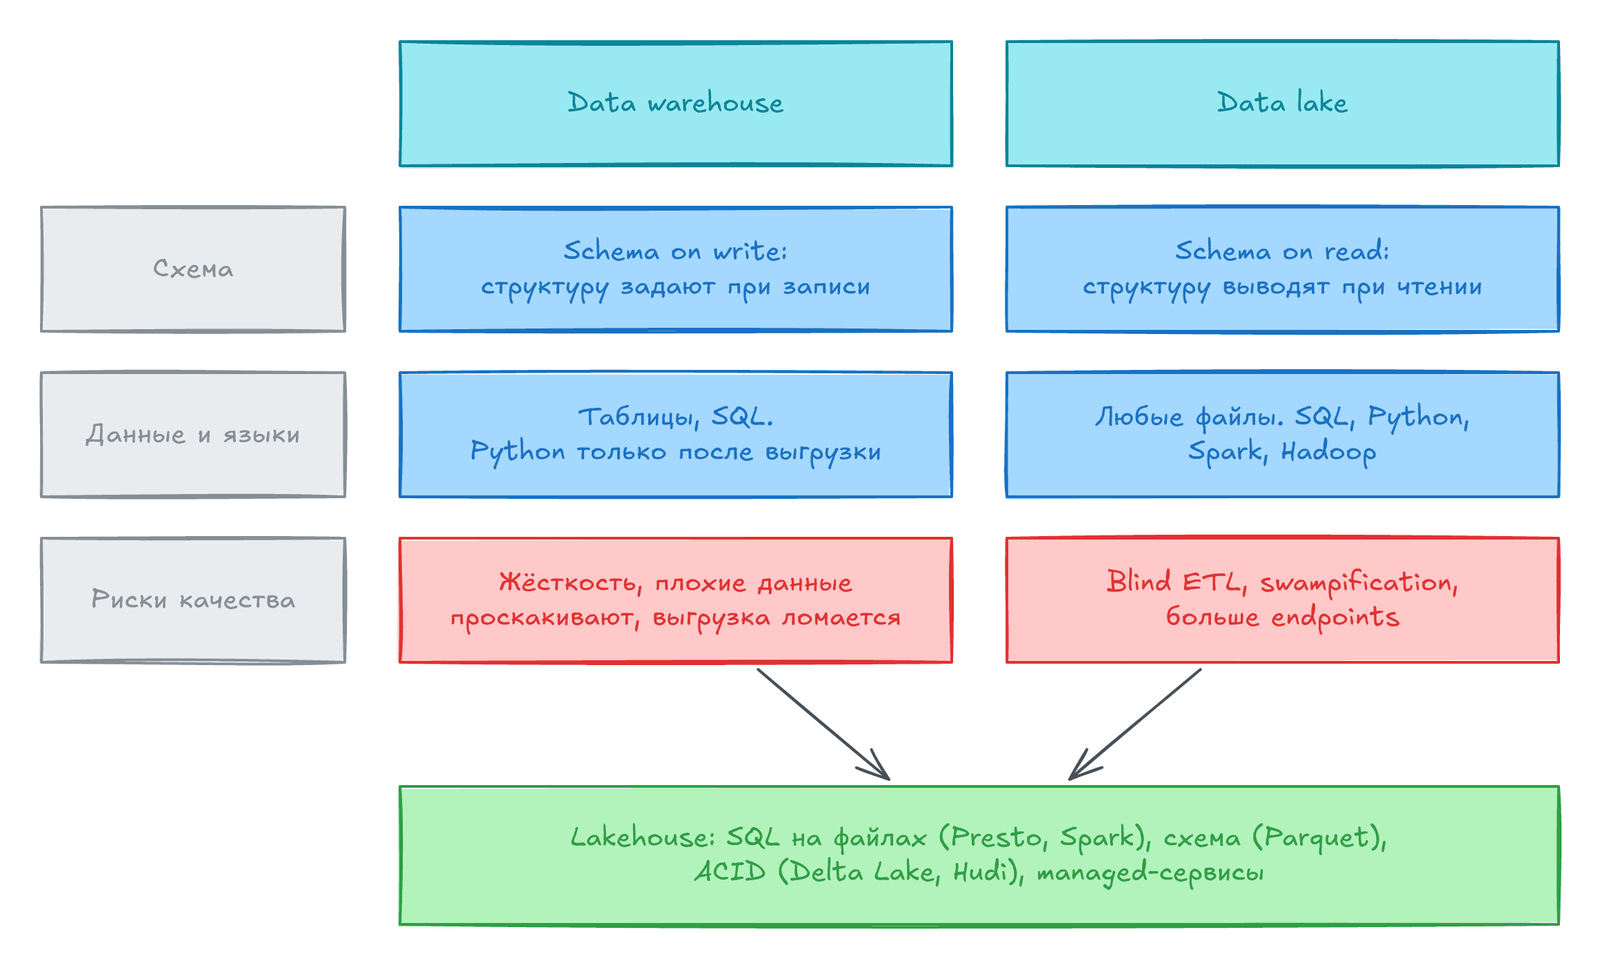
Заголовок раздела «Data warehouse и data lake»Эти системы не взаимозаменяемы, но сближаются. Многим компаниям нужны обе. Data warehouse хранит структурированные данные в строках и столбцах. Данные уже преобразованы, и у каждой таблицы есть причина существовать. Data lake хранит что угодно: структурированные, полуструктурированные и неструктурированные данные. Строгих правил загрузки нет. Поэтому озеро обычно больше по объёму и сложнее в управлении.
Data warehouse: схема на уровне таблиц
Заголовок раздела «Data warehouse: схема на уровне таблиц»Хранилище работает по принципу schema on write: структуру задают в момент записи, и каждое следующее преобразование явно описывает новую структуру. Это готовое управляемое решение, его просто запустить. Строгая схема держит данные в порядке и упрощает чтение.
Современное хранилище отчасти обязано Kimball Group. В 1980-х она предложила методологию жизненного цикла DW/BI: способы хранения данных — бизнес-активы, а не просто технологические предпочтения. Подробнее в конспекте Data Warehouse Toolkit. Популярные решения: Amazon Redshift (первое массовое облачное хранилище, колоночное), Google BigQuery (serverless, масштабируется по нагрузке) и Snowflake (работает поверх AWS, Google и Azure, вычисления и хранение оплачиваются отдельно).
У хранилища три недостатка, важных для качества:
- Мало гибкости. Данные нужно привести к табличному виду с определённой схемой. JSON поддерживается плохо, и плохие данные проскакивают незамеченными.
- Только SQL. Для ML нужен Python, поэтому данные выгружают из хранилища. При выгрузке часто возникают аномалии объёма, свежести и схемы.
- Неудобная работа. Команде data scientists, которая быстро итерирует, строгая схема мешает: структура у них меняется постоянно.
Data lake: работа на уровне файлов
Заголовок раздела «Data lake: работа на уровне файлов»Озеро работает по принципу schema on read: структуру выводят в момент чтения. Это вариант хранилища «сделай сам»: команда сама выбирает компоненты для метаданных, хранения и вычислений. Зато data scientists и ML-инженеры получают гораздо больше данных, в том числе неструктурированных.
Пояснение:
schema on readлегко увидеть в DuckDB. Запрос к CSV-файлу сам выводит типы колонок. Если формат файла изменится, запрос сломается при чтении, а не при записи.
Термин придумал James Dixon из Pentaho. Он описал озеро как «большой водоём в более естественном состоянии». Первые озёра строили на Hadoop MapReduce и HDFS, запросы выполняли через Hive. В начале 2010-х озёра стали практичнее благодаря Apache Spark. Типичные черты озера: хранение отделено от вычислений, вычисления распределены, основа — открытый код, работа идёт с сырыми данными, поддерживаются не только SQL-запросы, но и другие модели программирования (Spark, PySpark).
У гибкости есть цена. Авторы называют три проблемы надёжности:
- Data integrity. У файлов нет гарантий насчёт схемы. Если вы преобразуете данные, исходя из предположения о схеме, это
blind ETL: преобразование вслепую. Любое неожиданное изменение выше по потоку может его сломать. - Swampification. Озеро накапливает технический долг и знания «в головах»: где лежат данные, кто владелец, как они изменятся, знает один опытный инженер. Если слишком сильно на это полагаться, озеро превращается в болото данных (
data swamp): работать невозможно, потому что войти в данные слишком трудно. - Больше endpoints. Данные собирают и меняют большим числом способов. Больше шагов — больше шансов на ошибку.
Данные лежат в озере как есть или питают хранилище и BI через слой интеграции вроде AWS Glue. Маленькие команды иногда делают озеро единственным хранилищем данных. Авторы предупреждают: помните про болото.
А что насчёт lakehouse
Заголовок раздела «А что насчёт lakehouse»Lakehouse появился, когда облачные хранилища получили черты озера (Redshift Spectrum, Delta Lake), а озёра — черты хранилища (SQL, схема). Сближению озёр и хранилищ помогают четыре вещи:
- Быстрый SQL. Presto и Spark дают SQL почти с интерактивной скоростью поверх озера, без выгрузки в хранилище.
- Схема. Parquet добавил строгую схему и колоночное хранение.
- ACID. Delta Lake и Apache Hudi сделали запись и чтение транзакционными: атомарность, согласованность, изоляция, долговечность.
- Управляемые сервисы. Databricks, Amazon Athena и Amazon Glue снимают с команды часть работы.
Авторы ждут роста популярности lakehouse, особенно для потоковой аналитики вроде той, что у Uber и Airbnb.
Синхронизация хранилищ и озёр
Заголовок раздела «Синхронизация хранилищ и озёр»Хранилища и озёра соединяет слой интеграции данных (data integration layer). Инструменты вроде AWS Glue, Fivetran и Matillion собирают данные из разных источников, объединяют и преобразуют их. Классический случай: взять данные из озера и загрузить в хранилище в структурированном виде. Известный процесс интеграции — ETL: данные извлекают, преобразуют в новую структуру и загружают в целевое хранилище.
Сбор метрик качества данных
Заголовок раздела «Сбор метрик качества данных»Теперь вопрос: какие именно метрики качества брать?
Что такое метрики качества данных
Заголовок раздела «Что такое метрики качества данных»«Нельзя исправить то, чего не измеряешь», — пишут авторы. Метрики качества — это KPI, которые показывают, что данные достаточно здоровы для потребителей. Авторы предлагают мерить качество через data downtime: время, когда данные неполные, неверные или пропали.
Слово взято из ранней эпохи интернета. Тогда простой приложения не пугал, а сейчас приложения критичны, и простой тщательно считают. Но к простою данных пока относятся несерьёзно: SLA для команд, работающих с данными, вводит лишь горстка компаний. Авторы ждут, что внимание к data downtime вырастет.
Вопрос «данные сломаны?» слишком широк. Его заменяют конкретными вопросами:
- Данные свежие?
- Данные полные?
- Поля в ожидаемых пределах?
- Доля null выше или ниже нормы?
- Схема изменилась?
Ответы нужны в числах: так вопросы становятся метриками.
Как получить метрики
Заголовок раздела «Как получить метрики»Ответы берут из анализа хранилищ, озёр и слоёв преобразования между ними. Есть две сложности.
- Масштаб. Таблиц и данных много, поэтому нужно группировать запросы, оптимизировать их, убирать дубликаты, приводить схемы к одному виду и хранить всё в масштабируемом хранилище. Это отдельный пайплайн, который надо сопровождать. К тому же следите за расходом кредитов Snowflake.
- Мониторинг всего стека. Данные могут сломаться где угодно: в потоках, озёрах, дашбордах, ML-моделях. Поэтому метрики нужно собирать со всех этих мест. Настоящая
data observabilityвыходит за пределы хранилища.
Пример: метрики из Snowflake
Заголовок раздела «Пример: метрики из Snowflake»Snowflake даёт метрики качества прямо из хранилища. Авторы описывают четыре шага, и с поправками их можно повторить в Redshift, BigQuery и других OLAP-хранилищах.
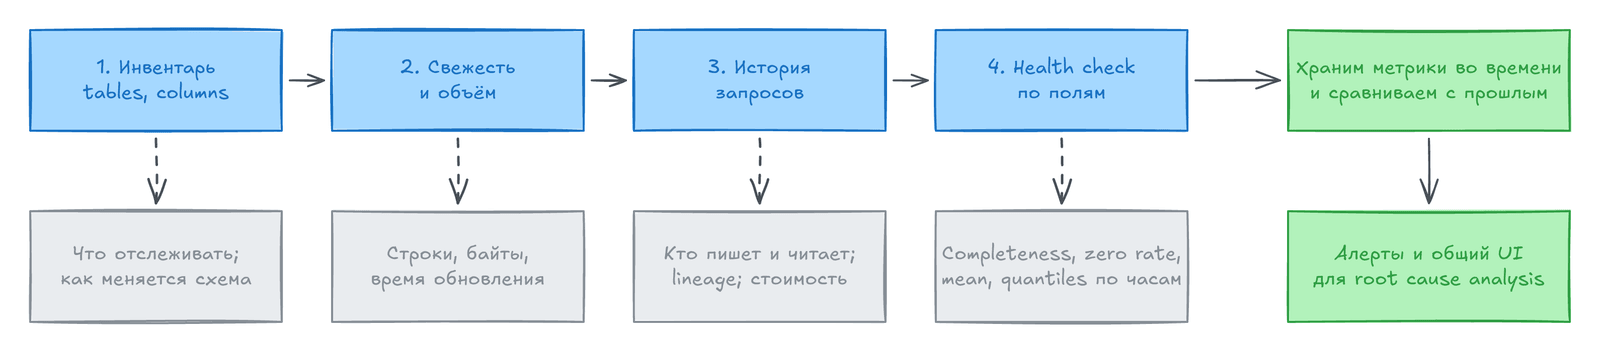
Шаг 1. Инвентарь. Нужен список таблиц, иначе непонятно, что отслеживать. information_schema.tables отдаёт владельца, тип, время хранения и комментарий. information_schema.columns отдаёт схему: если видно, как она меняется, поломки проще предотвратить и разобрать. Представления и внешние таблицы запрос не включает: для них есть SHOW VIEWS и SHOW EXTERNAL TABLES.
Шаг 2. Свежесть и объём. Snowflake сам считает байты, строки и время последнего изменения (ROW_COUNT, BYTES, LAST_ALTERED). Если хранить эти значения и следить, как они меняются, видно, как часто обновляется таблица и сколько данных приходит. Главное — так находят пропущенные и аномальные обновления. Для представлений свежесть зависит от их таблиц.
Шаг 3. История запросов. Журнал нужен для разбора поломок: видно, как и когда в таблицу писали. Он помогает построить lineage, понять, кто что использует, и сократить расходы. Авторы берут query_history, отсеивая системные и неудачные запросы. Ещё полезен copy_history: файлы загрузок, число строк, ошибки.
Шаг 4. Health check. Для критичных таблиц считают метрики по часовым интервалам и сравнивают их с прошлыми значениями. У строкового поля account_id это completeness (доля не пустых значений), distinctness (доля уникальных), доля значений в формате UUID и длины значений. У числового поля num_of_users это доля нулей и отрицательных значений, среднее, минимум, максимум и квантили. Так находят аккаунты без ID, дубликаты, неверный формат и нули из-за пропавших данных. Чтобы это работало на больших объёмах, берут только последние сутки и, если нужно, выборку (sampling).
Метрики должны быть доступны всей команде. Автоматические уведомления и общий интерфейс отличают быстрое решение от многодневной катастрофы.
Query logs в хранилище
Заголовок раздела «Query logs в хранилище»Query logs — записи обо всех операциях в хранилище. Из них видно, кто обращается к данным, откуда они пришли и куда ушли, как часто выполняется преобразование и сколько строк затронуто. У вендоров это системные таблицы: QUERY_HISTORY в Snowflake, AuditLogs в BigQuery, STL_QUERY в Redshift.
У журналов два свойства: они хранят историю лишь за несколько дней, и в них намного больше информации, чем нужно. Поэтому нужные метрики и агрегаты надо сразу копировать в постоянное место. Готовые поля такие: пользователь, SQL и его хэш, общее время, код ошибки, размер входа и выхода. Этого хватает, чтобы ответить на такие вопросы:
- Когда таблицу читали в последний раз?
- Обновление пришло по расписанию или нарушило его?
- Как нагружено хранилище по времени суток?
- Запрос стал дольше, чем два месяца назад?
- У кого или у какого бота есть доступ, которого быть не должно?
Query logs и метаданные в озере
Заголовок раздела «Query logs и метаданные в озере»В озере схема не принудительная, поэтому многие метрики хранилища там недоступны. Но часть метаданных вы получаете бесплатно. Например, Amazon S3 для своих нужд хранит время вставки и размер объекта. Из них видно, когда объект обновили и растёт ли средний размер файлов.
Кроме системных метаданных, при создании объекта можно записать свои заголовки (object headers). Подумайте, чего не хватает для оценки data downtime: какой пайплайн создал объект и какая у него схема. Хэш схемы подскажет, что одна сторона преобразования устарела. Проще ответить на вопрос «кто создал объект», если писать в озеро может только один пайплайн. Это амбициозный, но проактивный подход.
Проектирование каталога данных
Заголовок раздела «Проектирование каталога данных»Каталог данных — как библиотечный каталог: опись метаданных, которая показывает доступность, здоровье и расположение данных. Каталог — единый источник правды (Alation, Collibra и Informatica добавляют ML и автоматизацию). Через него видно lineage, и это повышает доверие к данным. Он показывает и где лежат персональные данные (PII), куда они расползаются и у кого есть к ним доступ. Каталог отвечает: где искать данные, важны ли они, что значат, как их использовать.
Самый простой каталог — огромная таблица в Excel. У ручного подхода есть очевидные проблемы:
- В крупных хранилищах десятки тысяч таблиц. Без автоматизации не обойтись.
- Большая часть данных неструктурирована и быстро меняется. Вручную их не описать.
- Производитель данных описывает таблицу иначе, чем потребитель, и потребители понимают её по-разному.
Вывод авторов: ручные каталоги больше не подходят, метаданные нужно находить автоматически.
Как построить каталог
Заголовок раздела «Как построить каталог»- Согласовать. Договоритесь с командами операций и аналитики, какие данные важны. Многие начинают с таблицы: источник, связи, время обновления.
- Назначить владельцев. Они отвечают за актуальность своих данных. Владельцев назначают по источнику, схеме или домену.
- Заполнить. Вручную или SQL-парсерами: sqlparse, ANTLR, Apache Calcite, парсер MySQL. Парсер разбирает SQL на части (ключевые слова, идентификаторы, условия) и складывает их в структуру, которую могут обработать другие программы.
- Хранить. Подходят PostgreSQL, MySQL, MariaDB или стек ELK.
В примере из книги ANTLR разбирает запрос SELECT CUST_NAME FROM CUSTOMERS WHERE ... в дерево. Из дерева видны колонка, таблица и условие, и эти метаданные идут в MySQL. Каталог можно показывать в Amundsen, Apache Atlas, DataHub или CKAN. В практической части ниже мы делаем то же проще.
Data discovery: каталог нового поколения
Заголовок раздела «Data discovery: каталог нового поколения»Каталоги хорошо работают на жёстких моделях. Но пайплайны усложняются, неструктурированные данные становятся нормой, и каталог перестаёт отражать реальность. Каталоги следующего поколения будут учиться, сами выводить смысл данных и поддерживать data discovery и active metadata. Авторы предлагают представить, что вы спрашиваете хранилище прямо в Slack. По их словам, это уже недалеко.
Data discovery — понимать здоровье распределённых данных в реальном времени. Идея взята из data mesh Zhamak Dehghani (Thoughtworks): владельцы доменов отвечают за свои данные как за продукты. Discovery заменяет каталог динамичной картиной домена: как данные принимают, хранят, агрегируют и используют. Важное отличие: discovery показывает текущее состояние данных, а не идеальное, «каталожное».
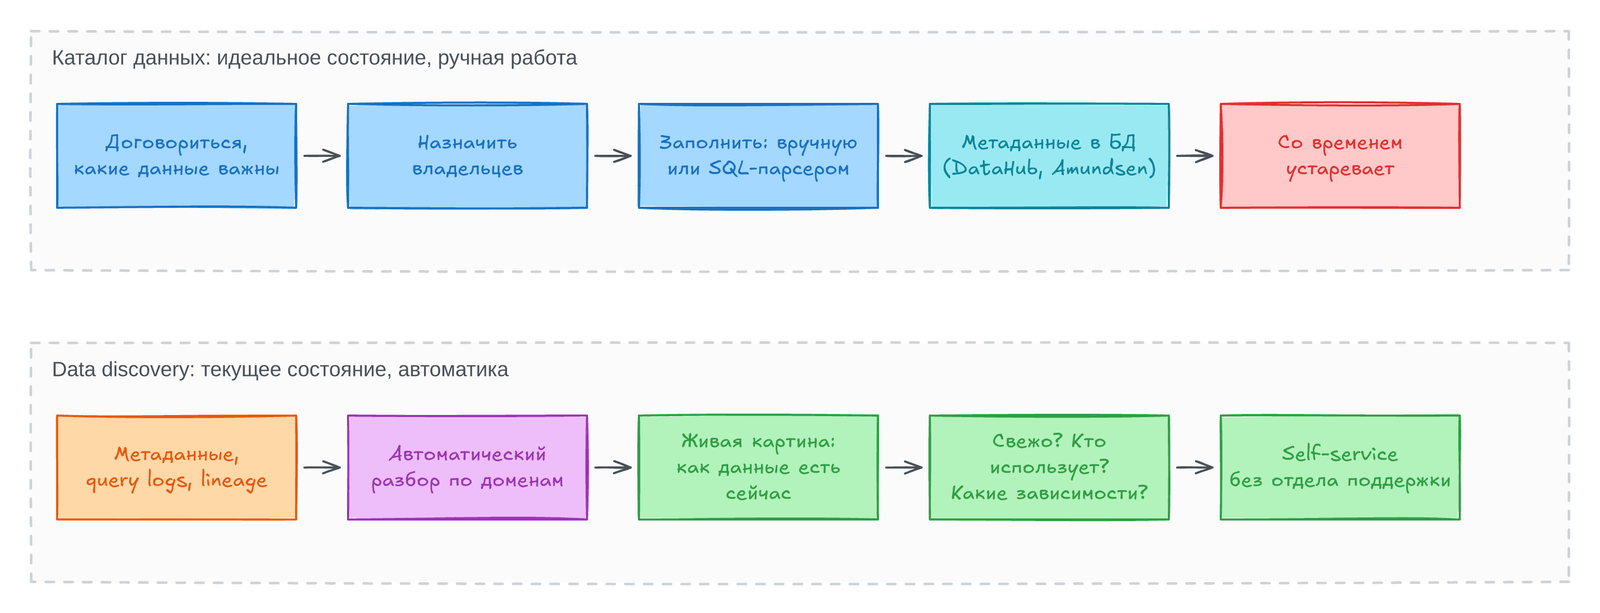
Верхний ряд — путь каталога от договорённости до устаревания. Нижний — как discovery собирает живую картину из метаданных, журналов и lineage.
Discovery отвечает на вопросы: какой набор данных самый свежий, когда обновлялась таблица, кто использует данные, какие у них зависимости и выполняются ли мои допущения.
У каталога, ориентированного на качество, три свойства:
Self-serveи автоматизация. Команда может пользоваться каталогом без отдельной службы поддержки. Данные используют чаще.- Масштаб. Discovery использует ML, чтобы видеть картину при росте данных. Решения принимают на живых данных, а не на устаревшей документации.
- Lineage. Автоматический
lineageтаблиц и полей показывает зависимости и помогает найти причину поломки. Подробнее в главе 7.
Авторы считают, что команда, скорее всего, уже платит за discovery: ручными проверками, самописными правилами или ценой решений на сломанных данных. Современные команды переходят на автоматику и платформы data observability.
Итоги главы
Заголовок раздела «Итоги главы»- Операционные данные обслуживают приложения и стоят выше по потоку. Аналитические строятся из них.
- Throughput и latency конкурируют, поэтому нужны разные системы для транзакций и аналитики.
- Хранилище (
schema on write) строгое, но негибкое. Озеро (schema on read) гибкое, но несёт риски:blind ETL, болото, больше endpoints. Lakehouseсоединяет SQL, схему и ACID с файлами озера. Слой интеграции иETLсвязывают системы.- Качество удобно мерить через
data downtime. Вопрос «данные сломаны?» превращают в пять измеримых: свежесть, полнота, диапазоны, доля null, схема. - Метрики из хранилища берут за четыре шага: инвентарь, свежесть и объём, история запросов, health check. Историю метрик надо хранить.
- Журналы запросов хранят данные недолго, поэтому нужные метрики копируют в постоянное место. В озере помогают метаданные объектов и свои заголовки.
- Ручные каталоги не справляются с масштабом.
Data discoveryсобирает метаданные автоматически и показывает реальное состояние данных.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
throughput / latency | Объём обработки за время и задержка одного запроса |
schema on write / schema on read | Структуру задают при записи (хранилище) или выводят при чтении (озеро) |
blind ETL | Преобразование в озере без гарантий схемы |
data swamp | Озеро, в котором без знаний «в головах» не разобраться |
lakehouse | Файлы озера плюс SQL, схема и ACID |
data downtime | Время, когда данные неполные, неверные или пропали |
query logs | Журнал запросов к хранилищу |
data discovery | Живая картина текущего состояния данных по доменам |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Начните с инвентаря. Раз в сутки сохраняйте
information_schema.tablesиcolumnsв свою таблицу. Так вы поймаете новые, пропавшие и изменённые таблицы. - Храните историю метрик. Одно значение ничего не говорит. Нужны ряды по часам и дням: строки, доля null, время обновления.
- Копируйте query logs. Журнал хранит дни. Сохраняйте пользователя, время, таблицы, длительность и ошибки.
- Не пишите в озеро вслепую. Проверяйте схему файла перед преобразованием. Дайте права записи одному пайплайну на путь.
- Назначьте владельца каждой важной таблице. Без владельца каталог устареет через месяц.
Практика в Python: журнал запросов
Заголовок раздела «Практика в Python: журнал запросов»Из журнала запросов можно получить lineage, список читателей и последнее чтение. Скрипт ch02_query_log.py разбирает выдуманный журнал. Вместо SQL-парсера из книги он использует регулярные выражения: для учебного примера хватает, для production нужен настоящий парсер. Запуск: python3 scripts/data-quality-fundamentals-code/ch02_query_log.py.
WRITE = re.compile(r"INSERT\s+INTO\s+([\w.]+)", re.I)READ = re.compile(r"(?:FROM|JOIN)\s+([\w.]+)", re.I)
edges, readers, last_read = set(), {}, {}for ts, user, sql in LOG:    m = WRITE.search(sql)    target = m.group(1) if m else None    for src in READ.findall(sql):        if target:            edges.add((src, target))        else:  # запрос ничего не пишет: это чтение            readers.setdefault(src, set()).add(user)            last_read[src] = max(last_read.get(src, ts), ts)
== lineage: из чего построена таблицаdim.dates -> mart.revenuemart.orders_daily -> mart.revenueraw.orders -> mart.orders_daily
== кто читает таблицы и когда читали в последний разmart.orders_daily последнее чтение 2026-03-02 11:30 читают: lookermart.revenue последнее чтение 2026-03-01 09:40 читают: anna, lookerraw.customers_pii последнее чтение 2026-03-02 15:20 читают: tmp_botraw.orders последнее чтение 2026-03-03 10:00 читают: boris
== доступ, которого быть не должноtmp_bot читает raw.customers_piiЗапросы с INSERT дают рёбра lineage, остальные дают читателей. Последняя строка показывает бота с доступом к персональным данным.
Практика в DuckDB: метрики и data downtime
Заголовок раздела «Практика в DuckDB: метрики и data downtime»Мы повторим шаги 1, 2 и 4 из примера со Snowflake. Колонки LAST_ALTERED в DuckDB нет, поэтому свежесть берём из самих данных. Запустите duckdb в терминале или откройте shell.duckdb.org. Выполняйте блоки по порядку.
Пояснение: в книге запросы написаны для Snowflake. Здесь они переписаны для DuckDB, а метрики те же:
completeness,distinctness,zero rate, среднее.
Шаг 1. Создаём таблицу с тремя поломками
Заголовок раздела «Шаг 1. Создаём таблицу с тремя поломками»В client_hub лежат данные за двое суток: по 50 строк в час. В час 20 пришло 5 строк. В часы 30–35 у 40% строк пустой account_id. С часа 40 в num_of_users одни нули.
CREATE TABLE client_hub ASWITH raw AS ( SELECT h, n, hash(h * 100 + n) AS k FROM generate_series(0, 47) AS a(h), generate_series(0, 49) AS b(n) WHERE NOT (h = 20 AND n >= 5))SELECT TIMESTAMP '2026-01-01 00:00:00' + to_hours(h) + to_minutes(n) AS created_on, CASE WHEN h BETWEEN 30 AND 35 AND k % 100 < 40 THEN NULL ELSE 'ACC-' || lpad((k % 400)::VARCHAR, 4, '0') END AS account_id, CASE WHEN h >= 40 THEN 0 ELSE 1 + (k // 7) % 20 END AS num_of_usersFROM raw;Шаг 2. Инвентарь, свежесть и объём
Заголовок раздела «Шаг 2. Инвентарь, свежесть и объём»SELECT table_name, column_name, data_type, is_nullableFROM information_schema.columnsWHERE table_schema = 'main'ORDER BY ordinal_position;┌────────────┬──────────────┬───────────┬─────────────┐│ table_name │ column_name │ data_type │ is_nullable ││ varchar │ varchar │ varchar │ varchar │├────────────┼──────────────┼───────────┼─────────────┤│ client_hub │ created_on │ TIMESTAMP │ YES ││ client_hub │ account_id │ VARCHAR │ YES ││ client_hub │ num_of_users │ UBIGINT │ YES │└────────────┴──────────────┴───────────┴─────────────┘SELECT count(*) AS row_count, min(created_on) AS first_row, max(created_on) AS last_rowFROM client_hub;┌───────────┬─────────────────────┬─────────────────────┐│ row_count │ first_row │ last_row ││ int64 │ timestamp │ timestamp │├───────────┼─────────────────────┼─────────────────────┤│ 2355 │ 2026-01-01 00:00:00 │ 2026-01-02 23:49:00 │└───────────┴─────────────────────┴─────────────────────┘Шаг 3. Health check по часам
Заголовок раздела «Шаг 3. Health check по часам»Считаем метрики по часам и сохраняем их в таблицу: так строится история метрик.
CREATE TABLE health_hourly ASSELECT date_trunc('hour', created_on) AS bucket_start, count(*) AS row_count, round(count(account_id) / count(*), 2) AS account_completeness, round(count(DISTINCT account_id) / count(*), 2) AS account_distinctness, round(avg(CAST(num_of_users = 0 AS INT)), 2) AS users_zero_rate, round(avg(num_of_users), 1) AS users_meanFROM client_hubGROUP BY ALL;Проверим четыре часа: нормальный, с малым объёмом, с пустыми ID и с нулями.
SELECT *FROM health_hourlyWHERE bucket_start IN ('2026-01-01 05:00', '2026-01-01 20:00', '2026-01-02 07:00', '2026-01-02 17:00')ORDER BY bucket_start;┌─────────────────────┬───────────┬──────────────────────┬──────────────────────┬─────────────────┬────────────┐│ bucket_start │ row_count │ account_completeness │ account_distinctness │ users_zero_rate │ users_mean ││ timestamp │ int64 │ double │ double │ double │ double │├─────────────────────┼───────────┼──────────────────────┼──────────────────────┼─────────────────┼────────────┤│ 2026-01-01 05:00:00 │ 50 │ 1.0 │ 0.96 │ 0.0 │ 10.5 ││ 2026-01-01 20:00:00 │ 5 │ 1.0 │ 1.0 │ 0.0 │ 8.4 ││ 2026-01-02 07:00:00 │ 50 │ 0.56 │ 0.54 │ 0.0 │ 10.3 ││ 2026-01-02 17:00:00 │ 50 │ 1.0 │ 0.94 │ 1.0 │ 0.0 │└─────────────────────┴───────────┴──────────────────────┴──────────────────────┴─────────────────┴────────────┘Задания
Заголовок раздела «Задания»Задание 1. Найдите часы с проблемой и сгруппируйте их по типу. Правила: меньше 25 строк, completeness ниже 0,9, zero rate выше 0,5.
Решение
SELECT CASE WHEN row_count < 25 THEN 'мало строк' WHEN account_completeness < 0.9 THEN 'пустые account_id' WHEN users_zero_rate > 0.5 THEN 'нули в num_of_users' END AS problem, count(*) AS hours, min(bucket_start) AS from_hour, max(bucket_start) AS to_hourFROM health_hourlyWHERE row_count < 25 OR account_completeness < 0.9 OR users_zero_rate > 0.5GROUP BY problemORDER BY from_hour;┌─────────────────────┬───────┬─────────────────────┬─────────────────────┐│ problem │ hours │ from_hour │ to_hour ││ varchar │ int64 │ timestamp │ timestamp │├─────────────────────┼───────┼─────────────────────┼─────────────────────┤│ мало строк │ 1 │ 2026-01-01 20:00:00 │ 2026-01-01 20:00:00 ││ пустые account_id │ 6 │ 2026-01-02 06:00:00 │ 2026-01-02 11:00:00 ││ нули в num_of_users │ 8 │ 2026-01-02 16:00:00 │ 2026-01-02 23:00:00 │└─────────────────────┴───────┴─────────────────────┴─────────────────────┘Найдены все три поломки: 1, 6 и 8 часов.
Задание 2. Какую долю времени данные были в data downtime за двое суток?
Решение
WITH flags AS ( SELECT row_count < 25 OR account_completeness < 0.9 OR users_zero_rate > 0.5 AS is_bad FROM health_hourly)SELECT sum(is_bad::INT) AS bad_hours, count(*) AS all_hours, round(100.0 * sum(is_bad::INT) / count(*), 1) AS downtime_pctFROM flags;┌───────────┬───────────┬──────────────┐│ bad_hours │ all_hours │ downtime_pct ││ int128 │ int64 │ double │├───────────┼───────────┼──────────────┤│ 15 │ 48 │ 31.3 │└───────────┴───────────┴──────────────┘Почти треть времени данные были непригодны. Если у таблицы обещан SLA, это нарушение.
Задание 3. Порог «меньше 25 строк» записан вручную. Замените его правилом без числа: час плох, если строк меньше половины медианы.
Решение
SELECT bucket_start, row_count, (SELECT median(row_count) FROM health_hourly) AS typical_rowsFROM health_hourlyWHERE row_count < 0.5 * (SELECT median(row_count) FROM health_hourly);┌─────────────────────┬───────────┬──────────────┐│ bucket_start │ row_count │ typical_rows ││ timestamp │ int64 │ double │├─────────────────────┼───────────┼──────────────┤│ 2026-01-01 20:00:00 │ 5 │ 50.0 │└─────────────────────┴───────────┴──────────────┘Правило нашло тот же час 20 и подстроится под любую таблицу. К поиску аномалий мы вернёмся в главе 4.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему нельзя настроить систему и под низкую latency, и под высокую throughput? Как это связано с выбором между OLTP и OLAP?
- Что такое
blind ETLи почему он опаснее в озере, чем в хранилище? - Какие четыре возможности сближают озёра и хранилища в
lakehouse? - Какие пять вопросов превращают «данные сломаны?» в метрики?
- Почему метрики из журнала запросов нужно копировать в свою таблицу?
- Чем
data discoveryотличается от каталога данных и почему ручной каталог устаревает?
Предыдущая: Глава 1. Почему качество данных важно сейчас. Следующая: Глава 3. Сбор, очистка, преобразование и тесты данных.