

Data Quality Fundamentals, глава 8: Качество данных для всей компании
Главная мысль: Доверие к данным нельзя построить одними тестами. Качество данных — это не только техника, но и культура: общие цели, понятные владельцы, обучение и простые правила. Дата-команда не должна тащить это одна. Нужно относиться к данным как к продукту и договориться, кто за что отвечает.
О чём глава
Заголовок раздела «О чём глава»Как сделать так, чтобы за качество данных отвечала вся компания, а не только дата-инженеры? В главе 7 мы разобрали lineage: он показывает, откуда данные и кто от них зависит. Теперь авторы переходят от инструментов к людям и процессам. Это самая длинная глава книги. Темы:
- данные как продукт и пять способов применить этот подход;
- как заработать доверие к платформе данных;
- роли,
blast radiusи матрица ответственностиRACI; data certification: семь шагов;- кейс Toast: как менялась структура дата-команды;
- грамотность в работе с данными,
data governanceи стратегия качества.
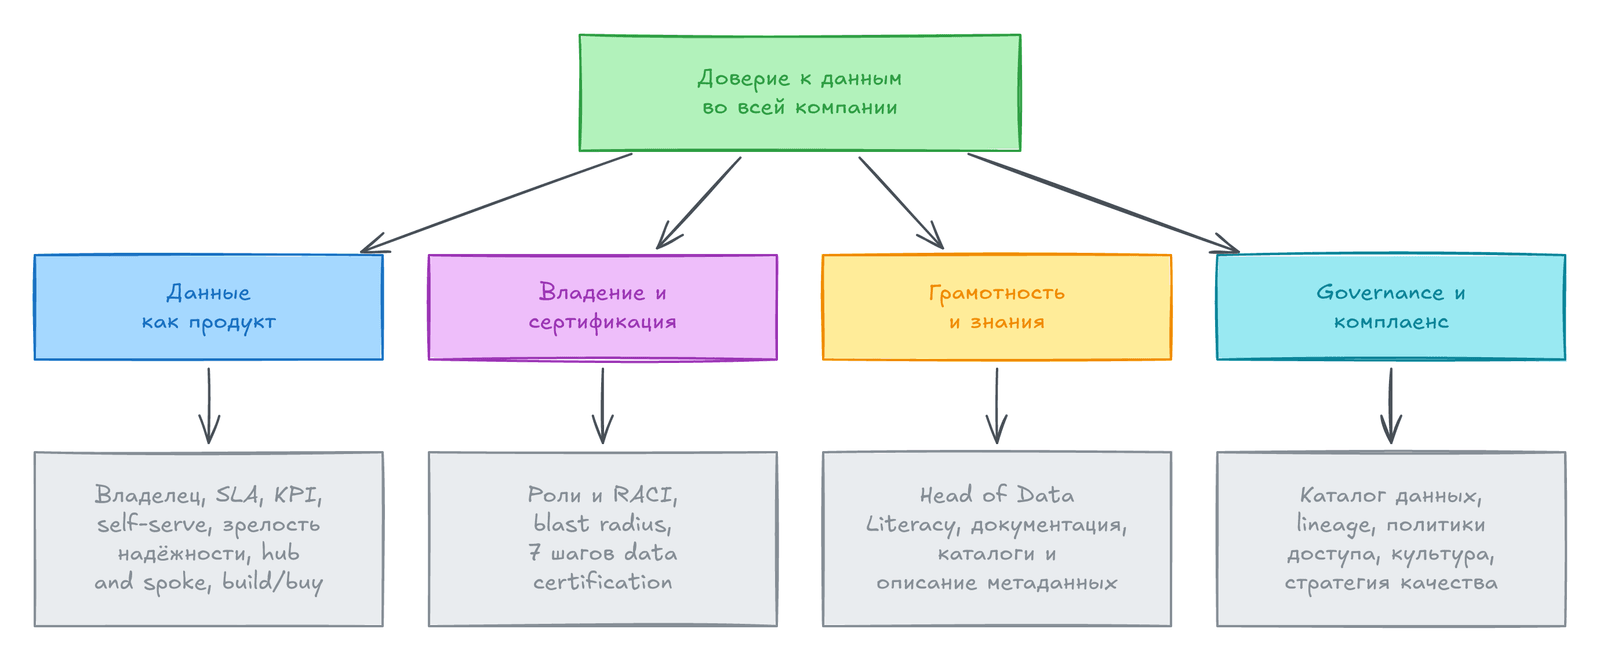
Доверие нельзя купить тестами
Заголовок раздела «Доверие нельзя купить тестами»Авторы начинают с вопросов, которые дата-команда слышит каждый день: «Этим данным можно верить?», «Чья это таблица?». Ответ обычно ложится на дата-инженеров, analytics engineers и аналитиков. Но сколько тестов ни запускай, доверие появляется только тогда, когда его принимает вся компания.
Идеально точных данных почти не бывает. Чаще важно понять, насколько им можно верить. Синди Хаусон (Cindi Howson, ThoughtSpot) приводит такой пример: группа крови должна быть точной, а рекламную кампанию можно оценивать по данным, которые «направленно верны», то есть достаточно точны для решения. Чтобы работа с данными была простой и итеративной, авторы советуют взять урок у программной инженерии. Первый шаг: относиться к данным так же серьёзно, как к боевому ПО.
Данные как продукт
Заголовок раздела «Данные как продукт»Что считать продуктом данных
Заголовок раздела «Что считать продуктом данных»Десятилетиями данные жили в изолированных silo. Команды пайплайнов были скорее «сантехниками», чем партнёрами. Теперь лучшие команды относятся к данным как к data product: набору данных или инструменту, которым управляют как продуктом.
Точное определение найти трудно. Продуктом может быть дашборд в Looker, платформа A/B-тестов или целая многослойная платформа. Поэтому авторы описывают не форму, а результат. Хороший продукт данных даёт доступ к данным там и тогда, когда они нужны. Он помогает людям самим работать с данными, ускоряет инсайты, экономит время команды и потребителей и даёт более точные выводы.
У продукта данных те же качества, что у хорошего SaaS:
| Качество | Что значит для данных |
|---|---|
| Надёжность и observability | Допустимый простой считают «девятками» (99,9% или 99,999%). Как инженеры следят за SaaS через Datadog, так менеджеры данных должны видеть проблемы почти в реальном времени |
| Масштабируемость | Продукт растёт вместе с компанией и спросом |
| Расширяемость | Он собран из разных решений, легко подключается через API и отдаёт данные так, как удобно потребителям |
| Удобство | Его легко освоить, и с ним быстро делают работу |
| Безопасность и compliance | Утечки и штрафы регуляторов дорого стоят |
| Дисциплина релизов | Есть roadmap и контроль качества обновлений |
Как о продуктах данных думают практики
Заголовок раздела «Как о продуктах данных думают практики»В начале 2000-х LinkedIn, Netflix и Uber работали с огромными объёмами данных, но никто не отвечал за то, чтобы аналитика была операционной и доступной. Новое поколение инженеров, архитекторов и руководителей стало применять к данным практики программной инженерии и SRE. Авторы поговорили с лидерами нескольких компаний, включая Convoy и Uber. Общий вывод: качество в приоритете, а начинается оно с отношения к данным как к продукту.
Convoy: данные как сервис или как результат
Заголовок раздела «Convoy: данные как сервис или как результат»Convoy — это маркетплейс грузоперевозок из Сиэтла. Чад Сандерсон (Chad Sanderson), Head of Product в Data Platform, описывает две школы мысли:
- Данные как часть сервиса. Продукт порождает данные, и весь пайплайн входит в продукт. К таким данным нужна та же строгость, что и к коду приложения.
- Данные как результат кода. Продуктом считают вывод любого кода, который служит клиенту: отчёт, дашборд, платформу. Чад сравнивает warehouse с кодовой базой на SQL, которую используют аналитики и продакт-менеджеры. Всё, что вышло в «продакшен-среду данных», доступную компании, — это продукт. Опубликованный дашборд в Mode или Metabase тоже.
В обоих случаях данные похожи на микросервис: их используют разные функции и потребители вне дата-команды. Чад считает, что обе школы требуют тестов, SLA, SLI и SLO, документации и мониторинга. Данные должны быть надёжными, а если нет, люди должны знать об этом и иметь возможность это исправить.
Uber: появление data product manager
Заголовок раздела «Uber: появление data product manager»Uber с самого начала (2009) считал данные конкурентным преимуществом. Чтобы сделать их операционными, компания стала относиться к ним как к боевому ПО, которым пользуются многие команды. В обычном софте продуктом управляет product manager. Значит, и данным нужен свой. По словам Атула Гупты (Atul Gupte), бывшего data product manager в Uber, такой менеджер отвечает за демократизацию данных и за то, чтобы они быстрее приносили пользу. Он проектирует и ведёт платформу данных для многих клиентов. Его вопросы: какие данные есть, кому они нужны, откуда и куда идут. А ещё: можно ли упростить работу с ними, соответствуют ли они требованиям и как сделать их полезнее для большего числа людей. Он отвечает на эти вопросы, создавая внутренние инструменты. Роль новая: люди приходят в неё из B2B product management, внутренних инструментов, аналитики или backend-разработки.
Как применять подход: пять шагов
Заголовок раздела «Как применять подход: пять шагов»1. Согласуйте ожидания со stakeholders рано и часто
Заголовок раздела «1. Согласуйте ожидания со stakeholders рано и часто»Когда данные — это продукт, внутренние клиенты становятся stakeholders. Привлекайте ключевых потребителей, когда строите roadmap и пишете SLA. Для этого нужно понимать, кто использует данные, как и зачем. Помогает data storytelling: рассказать, чем работа ценна именно для этого слушателя. Так убеждают вложиться в инфраструктуру данных, а не в блестящие ML-модели. История «надёжные данные дают точнее прогноз выручки» убеждает лучше, чем «качество данных полезно бизнесу».
2. Примените мышление продакт-менеджера
Заголовок раздела «2. Примените мышление продакт-менеджера»Стройте и измеряйте продукты данных так же, как боевое ПО: пишите scoping-документы и делите проект на спринты. В Ironclad, как рассказывает Джессика Черни (Jessica Cherny), для больших проектов вместе со stakeholders пишут «scoping-документ» по данным, как продакт-менеджер пишет спецификацию, и итерируют его вместе с инженерами. Результат получается согласованным между функциями.
Учитывайте масштаб. По словам Чада, в базу часто попадают события сервисов, которые инженеры «бросили не думая»: сначала строят сервисы, потом думают о данных. Кайл Шэннон (Kyle Shannon, SeatGeek) добавляет: когда за год нанимаешь 20–30 человек, совет «спроси в Slack» не работает. Нужно документировать всё и убирать дубли.
Задайте KPI до начала работы. От зрелых команд ждут оценки финансового эффекта. Многие считают стоимость data downtime (периодов, когда данные неполные, неверные или пропали) и время, которое команда тратит на разбор проблем вместо новых продуктов. Применяйте базовые метрики одинаково во всех сценариях.
3. Вкладывайтесь в self-serve
Заголовок раздела «3. Вкладывайтесь в self-serve»Self-serve (самообслуживание) — это инструменты, с которыми бизнес берёт данные сам. Тогда дата-команда не работает как сервис разовых запросов. Self-serve — это и принцип data mesh (подхода, где данными владеют доменные команды). Маммад Задех (Mammad Zadeh), бывший VP Engineering по платформе данных в Intuit, ввёл метрику: сократил ли инструмент время, нужное на задачу, например на поиск данных или доступ к ним. Его совет: центральные команды дают инструменты производителям и потребителям данных и не мешают им.
4. Приоритет качеству и надёжности
Заголовок раздела «4. Приоритет качеству и надёжности»Строгость нужна на всём пути, от ingestion до данных для потребителей. Свой уровень можно сверить с моделью зрелости надёжности данных (data reliability maturity curve). В ней четыре стадии.
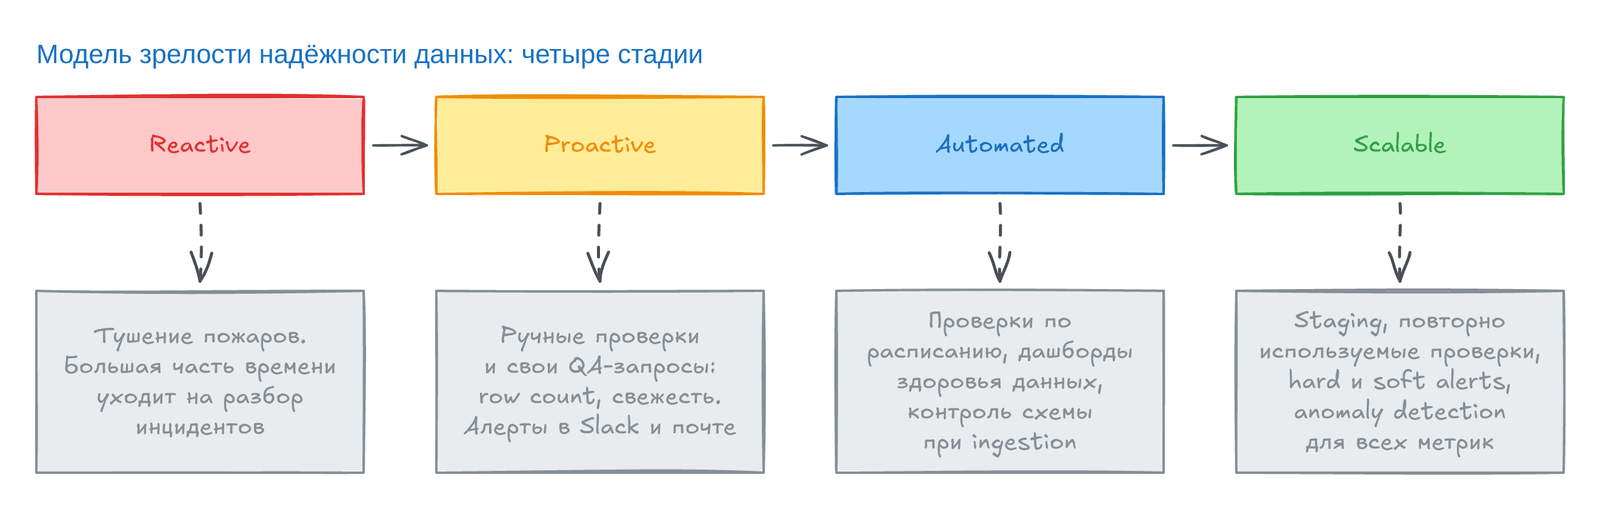
Диаграмма читается слева направо: чем правее, тем меньше пожаров и шире охват.
- Reactive. Команда в основном разбирает инциденты, поэтому на важные проекты времени нет.
- Proactive. Инженеры и аналитики вместе пишут ручные проверки и QA-запросы, например сверяют row count на ключевых этапах или следят за временем обновления. Алерты ещё приходят в Slack или почту, но многое ловится заранее.
- Automated. Проверки идут по расписанию, охват шире. Есть дашборды здоровья данных, хранятся метрики для трендов, схема проверяется при ingestion.
- Scalable. Команда использует DevOps: staging-среду, повторно используемые проверки, hard и soft alerts. Критичные данные покрыты почти целиком, и большинство проблем решается до влияния на потребителей. Например, anomaly detection по всем ключевым метрикам.
5. Найдите правильную структуру команды
Заголовок раздела «5. Найдите правильную структуру команды»Есть центральная команда, которая делает всё. Есть аналитики внутри бизнес-подразделений: они знают домен, но рискуют получить silo и разные правила. Многие лидеры нашли, что лучше всего работает вариант hub and spoke («ступица и спицы»). Центральная platform-команда («ступица») отвечает за инфраструктуру и качество данных. Встроенные аналитики и инженеры («спицы») отвечают за семантический слой и применение данных в бизнесе. Минус: без согласования со ступицей спицы дублируют работу.
Грег Уолдман (Greg Waldman, Toast) прошёл за пять лет путь от центральной модели к децентрализованной и к hub and spoke. Его совет: оставаться гибким. То, что работает при 200 людях, не работает при 500 или 1000. Джессика Черни ценит встроенных аналитиков за понимание настоящей потребности. Ей однажды заказали сложную кластеризацию. Она спросила, зачем это нужно, и задача оказалась проще.
Вывод: «данные как продукт» — это не мода, а осознанный сдвиг мышления. Он даёт больше самообслуживания, более точные решения и больший эффект от данных.
Как заработать доверие к платформе данных
Заголовок раздела «Как заработать доверие к платформе данных»В главе 2 мы разбирали, как построить платформу. Теперь вопрос: как сделать, чтобы ей пользовались и верили её результатам? Авторы дают пять практик.
Свяжите цели продукта с целями бизнеса
Заголовок раздела «Свяжите цели продукта с целями бизнеса»Долгое время платформы считали средством, а не продуктом. Сначала спросите: как данные связаны с целями компании? Менеджер платформы видит общую картину, а не одну функцию. Например, цель — рост выручки. Тогда нужно ответить: какие продукты её дают и какие данные они собирают, что делать с данными до использования, каким командам они нужны. А ещё: кто получит доступ, как быстро и какие проверки compliance нужны. Ответы покажут приоритеты roadmap, а также то, для кого вы строите (чаще это инженеры) и для кого проектируете (повседневные пользователи, например аналитики).
Получите поддержку нужных людей
Заголовок раздела «Получите поддержку нужных людей»Нужно одобрение CTO или VP of Data, но на их решения влияют доверенные советники: staff-инженеры, технические программные менеджеры, практики. Один продакт-менеджер три месяца убеждал VP Engineering в идее каталога данных, а начальник штаба закрыл вопрос одним письмом.
Авторы советуют три параллельных шага: продать руководству видение, продать реальным пользователям ежедневную пользу и с любым собеседником держаться клиентского подхода. Платформа расширяет возможности и дата-команды, и потребителей. На рисунке в книге четыре типичных пользователя: от человека с базовым SQL и таблицами до менеджера, которому нужны готовые дашборды. Посередине — аналитик и инженер.
Выбирайте долгий рост, а не быстрые победы
Заголовок раздела «Выбирайте долгий рост, а не быстрые победы»Платформам данных не нужно «быть первыми на рынке»: это внутренние инструменты, и клиент у вас сама компания. Roadmap будет не раз меняться, но менять его нужно с мыслью о росте. Платформа Uber строилась пять лет, Pinterest прошёл несколько версий, а LinkedIn развивает платформу с 2008 года. Решения «на короткий срок» проще запустить, но со временем они дороже. График авторов показывает это: у решения с низким внутренним качеством функциональность сначала растёт быстрее, потом отстаёт от решения с высоким качеством. Быстрые победы помогают получить согласие внутри компании, если они вписаны в общий план и не близоруки.
Согласуйте базовые метрики
Заголовок раздела «Согласуйте базовые метрики»«Качество» значит разное для разных людей, поэтому нужно договориться о базовых ожиданиях к надёжности данных. Для ПО SLO и SLI ставят без раздумий, и дата-команды должны делать то же. Stakeholders не будут одинаково представлять «хорошие данные», и это нормально. Выберите базовую метрику и получите подпись под «наименьшим общим знаменателем». Авторы советуют SLA на часы data downtime (из главы 6) или число проблем качества в неделю.
Решите, строить или покупать
Заголовок раздела «Решите, строить или покупать»Uber, LinkedIn и Facebook строят платформы сами, часто на open source. Вам это может не подойти. Авторы советуют покупать, пока вы не убедитесь в одном из трёх:
- продукт работает с чувствительными данными (финансы, здоровье), которые по закону нельзя отдавать вендору;
- нужны настройки под ваши системы, настолько узкие, что вендор их не сделает;
- у «строить» есть стратегическая ценность: конкурентное преимущество или привлечение людей.
Для больших универсальных задач (warehouse, lake, BI) чаще проще купить. Для узких, но критичных (например, агрегация GPS-данных по шоссе) придётся строить. Хорошая новость: data engineering сейчас переживает ренессанс, как software engineering в начале 2010-х. Появляются инструменты для узких задач: reverse ETL, поведенческая аналитика, ML feature stores.
Платформа как продукт даёт согласие по приоритетам, единые стандарты качества и лучшую совместную работу. Она двигает roadmap приложений, улучшает опыт клиентов и стандартизирует governance и compliance (GDPR, CCPA).
Кто отвечает за качество данных
Заголовок раздела «Кто отвечает за качество данных»Ответов на этот вопрос много. Многие быстро ищут виноватого при простое, но мало кто готов решить проблему и объяснить её последствия. Растущую сферу влияния простоя называют blast radius (радиус поражения): это то, насколько простой данных затронет тех, кто ниже по потоку.
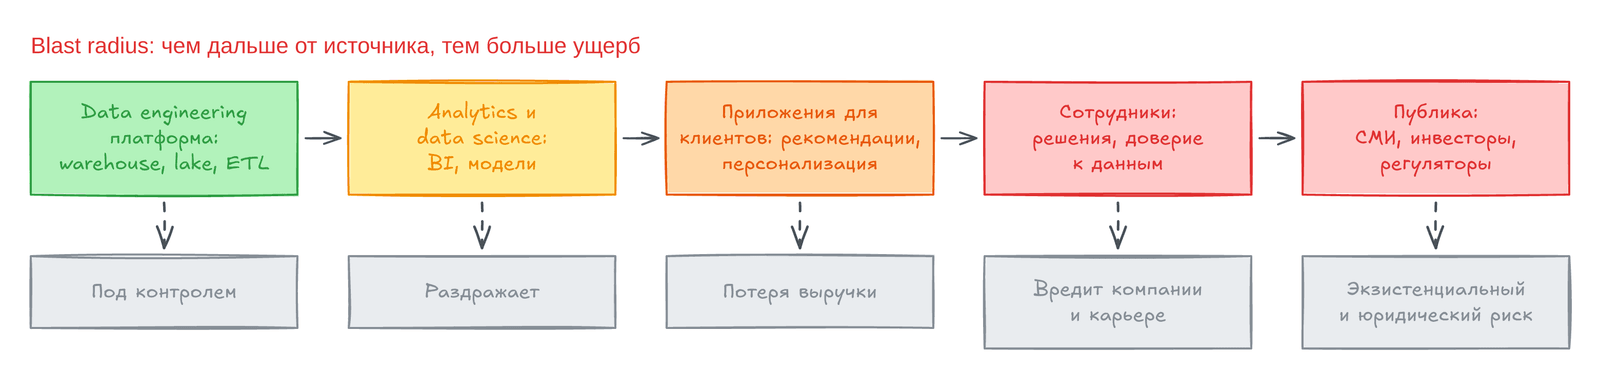
Диаграмма идёт слева направо. Внутри data engineering проблема остаётся под контролем. Для аналитиков это раздражение, для клиентских приложений (рекомендации, персонализация) — потеря выручки. Для сотрудников это подрыв доверия и вред карьере, для публики (СМИ, инвесторов) — экзистенциальный и юридический риск.
Роли и их боли
Заголовок раздела «Роли и их боли»Авторы описывают семь типичных ролей в вымышленной компании.
| Роль | Чего хочет | Что болит |
|---|---|---|
| Chief data officer (CDO) | Чтобы отделы получали нужные данные и риски были под контролем | Отвечает, если плохие данные дошли до CEO или публики. Хочет видеть всю экосистему сверху |
| BI-аналитик | Дашборд для маркетинга, продаж и операций | Первым получает звонок. Null и дубли — его враги. Устал проверять «странное значение» в отчёте |
| Analytics engineer | Чтобы все получали нужные данные; модели в dbt работали | Ломающее изменение схемы рушит его трансформации. Главный друг: data observability |
| Data scientist | Знать, откуда данные и что им можно верить, иначе A/B-тесты не работают | Команда тратит примерно 80% времени на чистку и понимание данных |
| Data governance lead | Единые определения данных и метрик; контроль доступа | Плохие данные — это штрафы, иски и потеря доверия. «Как бухгалтерия: о тебе вспоминают, когда всё сломалось» |
| Дата-инженер | Масштабируемая платформа, надёжный ingestion, быстрый ремонт | Соединяет всю экосистему. Её будят ночью. |
| Data product manager | Платформа, которая объединяет данные многих источников, с автоматизацией и self-serve | Нужно соблюдать GDPR и CCPA. Платформа всегда «в одной трансформации от того, что хотел BI» |
Кто отвечает за надёжность
Заголовок раздела «Кто отвечает за надёжность»Простого ответа нет: в конечном счёте это дело каждого, от CDO до дата-инженера. Чтобы разложить обязанности, авторы предлагают матрицу RACI.
Пояснение: R (Responsible) делает работу. A (Accountable) отвечает за результат. C (Consulted) участвует советом. I (Informed) только получает информацию.
Ниже наш вариант таблицы авторов: для каждой задачи видно, кто делает работу и кто отвечает за неё.
| Задача | Accountable | Responsible |
|---|---|---|
| Доступность данных | CDO, analytics engineer | BI, data engineering, product manager |
| Понятность данных | CDO | BI, data science |
| Инсайты и рекомендации | CDO | BI, analytics engineer, data science |
| Compliance | CDO | Data governance |
| Высокое качество данных | CDO, analytics engineer | Data science, data engineering, product manager |
| Надёжность данных | CDO | Analytics engineer, data engineering, product manager |
В компаниях с терабайтами данных (Netflix, Uber) мониторинг и алерты по надёжности обычно ведут дата-инженеры и data product managers. В остальных компаниях это чаще тоже делают они. Им приходится балансировать спрос на данные и то, что можно дать надёжно. Последствия плохих решений чаще несут BI-аналитики: их дашборды показывают плохие данные или ломаются из-за изменений, о которых никто не сказал.
Как создать ответственность за качество
Заголовок раздела «Как создать ответственность за качество»«Дата-инженеры — не каталоги данных». В их обязанностях нет «отвечать в Slack, какие таблицы годятся для отчёта», но это происходит. Аналитики не телепаты, но им приходится угадывать, можно ли верить данным. Причина в скорости: команды торопятся, строят data mesh и self-serve платформы.
Авторы сравнивают это с версиями презентаций: появляются копии вроде V6_Final_RealFinal. В данных так же: шесть моделей с мелкими отличиями делают одно и то же, и никто не знает, какая свежая. Из этого вырастают проблемы: лишние вопросы «какую таблицу брать», ниже качество и доверие, больше data downtime. Когда данным не доверяют, в прогнозы закладывают запас на ошибку. Авторы вспоминают остановку производства Peloton: плохой прогноз опасен, когда неопределённость спроса и поставок высока.
Баланс между доступностью и доверием
Заголовок раздела «Баланс между доступностью и доверием»В главе 2 мы говорили про data discovery: это способ понимать здоровье распределённых данных в реальном времени, по доменам. Он может заменить классический каталог. Как и каталог, он федеративный: единые стандарты governance, а инструменты у доменов свои. Но он показывает текущее состояние данных, а не «идеальное», описанное в каталоге. Он особенно полезен, если владельцы отвечают за данные как за продукты, и опытные пользователи берут их сами.
Но как потребитель узнает, какие наборы домен подготовил, преобразовал и одобрил? И как убедиться, что везде выполняются общие стандарты качества, владения и коммуникации? Для многих команд ответ — это data certification.
Сертификация данных
Заголовок раздела «Сертификация данных»Data certification — это процесс, в котором данные одобряют для использования в компании после того, как они выполнили согласованные SLA по качеству, observability, владению, решению проблем и коммуникации. По смыслу она близка к проверке качества, валидации и верификации, но добавляет слой процессов: связывает людей, фреймворки и технологии с корпоративными правилами. Обычно в требования входят автоматические проверки свежести, объёма, схемы и распределения; SLA на поставку; владельцы, которые отвечают за разбор алертов; алерты в Slack или почту; порядок коммуникации при сбоях.
Семь шагов программы сертификации
Заголовок раздела «Семь шагов программы сертификации»Программа даёт масштаб (единый подход во многих доменах) и эффективность (обмен данными между доменами становится надёжнее).
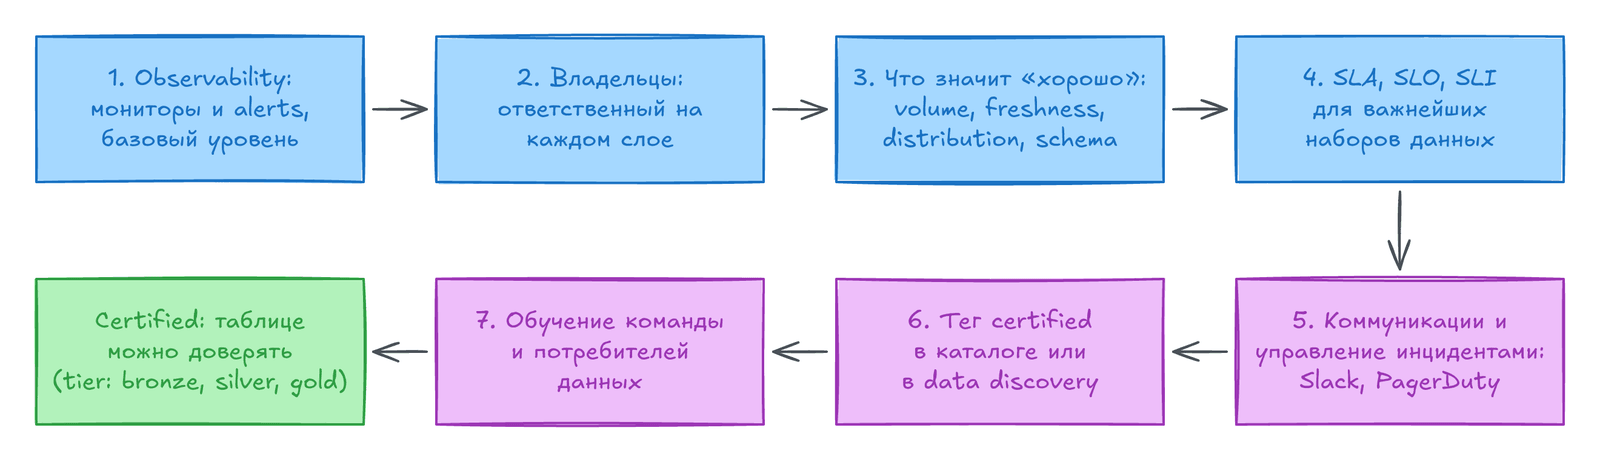
Схема идёт змейкой: первый ряд слева направо, второй справа налево. В конце таблица получает статус certified.
Шаг 1. Постройте observability. Чтобы задать базовый уровень, нужно видеть, как система работает сейчас, и иметь сквозной подход к поиску инцидентов, алертам и triage. Дашборд инцидентов сам показывает аномалии, изменения схемы, удалённые таблицы и нарушения правил. Если что-то сломается (а оно сломается), вы узнаете первыми. Заодно видно, какие системы чаще дают проблемы: это нужно для SLA. Таблицу считают сертифицированной, только если она под мониторингом аномалий.
Шаг 2. Определите владельцев. У каждого сертифицированного набора есть ответственный на всём пути, от ingestion до слоя аналитики. Инструменты метаданных позволяют назначить владельца таблице и добавить теги. Одни команды внедряют RACI, другие вписывают владельцев в SLA.
Шаг 3. Поймите, что такое «хорошие» данные. Задайте stakeholders вопросы «кто, что, когда, где и зачем». Так вы узнаете, что для них значит качество и какие данные важнее всего. Из ответов получаются KPI:
| Область | Пример правила |
|---|---|
| Freshness | Данные обновляются к 8:00 каждый день (директор смотрит дашборд в 8:30). Или: данные не старше X часов |
| Distribution | Колонка X никогда не null. Колонка Y всегда уникальна. Поле X не меньше поля Y |
| Volume | Таблица X никогда не уменьшается |
| Schema | В таблице нельзя удалять поля |
| Lineage | У 100% данных таблицы X есть источники и потребители с метаданными |
| Data downtime | Число инцидентов × (время до обнаружения + время до решения). Например: у таблицы X менее Y часов простоя в год |
| Query speed | Среднее время запроса. Или тоньше: X% запросов завершаются быстрее Y секунд |
| Ingestion | Данные от партнёра Y приходят к 5 утра |
Полезнее ставить SLA на каждую часть downtime: «снизим число инцидентов на X%, время до обнаружения на X%, время до решения на X%». Кроме того, так можно настроить точечные алерты под то, что важно бизнесу.
Шаг 4. Задайте SLA, SLO и SLI для важнейших наборов. SLA на пайплайн (глава 6) повышает надёжность и необходим для сертификации. Он должен быть конкретным, измеримым через SLO и SLI и достижимым. Он описывает отношения сторон: кто за что отвечает в штатной ситуации и при проблеме. Брэндон Байдел (Brandon Beidel, Red Ventures) считает, что хороший SLA реалистичен. «Надёжные данные всегда» слишком размыто. Хороший SLA объясняет, почему это важно, чего ждут, когда, как это будет достигнуто, где лежат данные и кого это затрагивает. Байдел вписывает в SLA и реакцию на нарушение: «Команда Z гарантирует обновление таблицы X к 8:00. В течение двух часов после алерта команда проверит, сообщит затронутым и начнёт root cause analysis. В течение рабочего дня заведёт тикет и расскажет о прогрессе».
Пояснение: по Байделю, SLA — это обещание («таблица X обновится к 8:00»), а SLO — это цель его выполнения («мы выполним его в 99% случаев»). SLI — это измерение: в какой доле дней таблица реально успела. Его мы считаем в практике ниже.
Байдел советует не пытаться охватить всё сразу. Большинство клиентов сначала сертифицируют новые данные («go forward»), а старые чистят второй волной. Многие лучшие команды начинают с самых важных таблиц: с большим числом запросов, пользователей и зависимостей. Некоторые вводят уровни сертификации (bronze, silver, gold) с разным уровнем сервиса.
Шаг 5. Опишите коммуникацию и управление инцидентами. Куда придут алерты? Как команда сообщает о прогрессе внутри и снаружи? Ясное и прозрачное общение создаёт культуру ответственности. Многие ведут алерты и разбор в Slack, PagerDuty или Microsoft Teams: так быстро координируются и видно всей команде (подробнее в главе 6). Нужно продумать и сообщение о крупном сбое остальной компании: где объявить и как часто обновлять.
Шаг 6. Выберите способ пометить данные как certified. Теперь есть SLA, понятное владение, коммуникация и ожидания по решению проблем. Остаётся сертифицировать и показать одобренные наборы. Авторы советуют децентрализовать сертификацию: единые правила, применяемые на уровне доменов, дают скорость без лишней бюрократии. Теги ставят в data discovery, самодельном инструменте или каталоге.
Шаг 7. Обучите команду и потребителей. Тег certified не гарантирует, что аналитики будут соблюдать правила. Команду надо учить процедурам и при необходимости добиваться исполнения. Полезно иногда получать алерты, не требующие действий: например, таблица выросла из-за нового источника. Ничего не сломано, но команде полезно знать. Однако усталость от алертов (alert fatigue) реальна. Если алерты игнорируют, меняйте мониторы или разделите каналы связи. С потребителями не стесняйтесь: помогите им перейти от субъективных ощущений к объективной картине и дайте им словарь, чтобы они участвовали в решении.
Итог: инженер ставит таблице тег certified вместе с владельцем, она появляется в warehouse, аналитик берёт её в дашборд. Простоев становится заметно меньше. Без процессов и культуры сертифицировать надёжность очень трудно. Технология не заменит хорошую гигиену данных, но помогает.
Кейс Toast: как искали структуру дата-команды
Заголовок раздела «Кейс Toast: как искали структуру дата-команды»Вопрос «централизовать или децентрализовать?» стоит перед каждым лидером растущей компании. Центральные команды становятся узким местом, а децентрализованные дают дублирование. Грег Уолдман, Senior Director of BI в Toast (ПО для точек продаж в ресторанах), за пять лет вырастил команду с одного аналитика (себя) до 20+ человек. Она прошла путь от центральной модели к гибридно-децентрализованной и обратно.
Начало: маленькая команда не справляется со спросом
Заголовок раздела «Начало: маленькая команда не справляется со спросом»Грег пришёл в 2016 году, когда в Toast было 200 человек, но не было аналитиков: компания жила на Excel. Задача была такой: на встречах один думает, что число пять, а другой — что четыре, и они спорят. За первый год команда выросла до трёх человек. Но компания выросла вдвое (400 человек к 2018 году), и центральная команда не успевала. «У нас были очереди за дверью», — говорит Грег. Если не удовлетворить спрос, бизнес начнёт работать менее data-driven.
Гиперрост с децентрализованной командой
Заголовок раздела «Гиперрост с децентрализованной командой»Децентрализация началась сама: в продажах и customer success появились свои «карманы» аналитики. В 2018 году десять специалистов работали внутри бизнес-единиц, а компания выросла до 850 человек. Тогда же стек перестроили в современный распределённый (S3, Airflow, Snowflake, Looker). Аналитики сохраняли связь с центральной командой, и в итоге получился гибрид. К 2019 году в компании было 1250 человек, а в данных работали 15 аналитиков, дата-сайентистов и инженеров. Тогда проявились проблемы. Первая: разная строгость правил. Пока команда маленькая, любые данные лучше, чем никаких, а на масштабе неточные данные вредят.
Возврат к центру и фокус на доверии
Заголовок раздела «Возврат к центру и фокус на доверии»Toast вернул аналитиков из customer success и go-to-market в единую команду. Выбирая структуру, Грег всегда сравнивает три варианта.
| Модель | Плюсы | Минусы |
|---|---|---|
| Централизованная | Единые стандарты, обмен знаниями, видно весь бизнес, меньше дублирования | Ниже скорость, теряется контекст «на земле», борьба за ресурсы |
| Гибридная | Сложное делает центр, базовое делают спицы | Путаница в ответственности, разный governance |
| Децентрализованная | Скорость, знание бизнеса, прямая связь с целями отдела | Разные стандарты, дублирование, анализ под ожидания руководителя |
Скрытое преимущество центральной модели Грег видит в обмене знаниями: люди учатся друг у друга. Принцип Грега: техлиды должны помогать аналитикам, а не быть узким местом.
Советы по масштабированию дата-команды
Заголовок раздела «Советы по масштабированию дата-команды»Команда осела на центральной структуре с несколькими распределёнными элементами. Грег даёт четыре совета.
- Нанимайте универсалов, но первым специалистом возьмите дата-инженера. Сначала команда нанимала «data athletes», которые умеют понемногу всё. Когда Грег искал senior manager, откликнулась дата-инженер, и стало ясно, насколько нужна такая роль. Её нужно было искать на год раньше. Без инженера команда тонет в ETL и масштабировании инфраструктуры.
- Стройте разнообразную команду с первого дня. Однородная команда плохо понимает потребителей данных. Позже собрать разных людей труднее: они идут туда, где уже разнообразно. Авторы советуют писать инклюзивные описания вакансий вместе с HR, собирать разнообразные панели собеседований, искать кандидатов без «классических» названий ролей и использовать слепой отбор по квалификации.
- Общайтесь больше, чем кажется нужным. При изменении структуры надо говорить об этом и повторять: качество и сроки анализа не изменятся. Аналитикам, подчинённым бизнес-руководителям, нужно право возражать по данным. Иначе их толкают показывать цифры, подтверждающие чужие гипотезы.
- Не переоценивайте «single source of truth». Идея единого источника правды сильная. Но пока есть «направленная» observability (таблица свежая? известен ли владелец? почему 50 строк стали 500?), единый источник не так срочен. Часто хватает направленной точности, а погоня за идеалом тратит ресурсы. Правило 80/20 важно: лучше иметь сквозной взгляд на здоровье данных, чем тонкий контроль.
Последний совет Грега: нанимайте людей с сильной коммуникацией. Аналитик бесполезен, если не может объяснить выводы нетехническим коллегам.
Грамотность в работе с данными
Заголовок раздела «Грамотность в работе с данными»Как построить культуру качества? Для многих всё начинается с data literacy: умения читать данные, писать с ними и общаться о данных так, чтобы это приносило ценность. Как понять ценность качества, если не понимаешь ценность самих данных? Хорошая стратегия даёт поддержку сверху и принятие снизу: self-serve и обучение для нетехнических коллег.
Один CDO рассказал Барр Мозес (Barr Moses) на симпозиуме MIT, что создал роль «Head of Data Literacy» на всю компанию (около 10 000 человек). Для каждого подразделения делают scorecard навыков (Excel, SQL, R, Python), ставят цели (какие навыки и на каком уровне нужны) и обучают людей. Один человек отвечает за грамотность компании конкретно и измеримо. Учить нужно и ценности качества данных: зачем уметь читать данные, если им нельзя верить? Венди Тёрнер-Уильямс (Wendy Turner-Williams, CDO Tableau) отмечает: данные нужно давать тем, кому они нужны, и обучать людей, как их использовать.
Многие лидеры называют главным препятствием нехватку документации. Команды держатся на неявных знаниях и устаревших wiki. Эми Смит (Amy Smith, Intuit) говорит: успех нового дата-сайентиста часто зависит от команды, которая готова записывать знания. Что поможет:
- Каталоги данных. Команде из 2–5 человек хватит таблицы в Excel. По мере зрелости стоит рассмотреть собственное, стороннее или open source решение.
- СУБД (DBMS). Она держит в порядке формат данных, поля и структуру записей, но контекст каталога не заменит.
- Инструменты моделирования данных. Они помогают находить и визуализировать данные и связи в стеке.
- Операционные дашборды платформы данных. Они показывают, как данные используют и какие важнее всего: по потреблению и числу правил качества.
Авторы советуют аналитикам дописывать недостающие измерения, когда они их замечают, а не только когда они нужны. Если сейчас не нужно, это не значит, что не понадобится коллеге.
Governance и compliance
Заголовок раздела «Governance и compliance»Ни одна тема не вызывает столько путаницы и раздражения, как data governance: управление данными внутри и за пределами организации. Тема важна из-за GDPR и CCPA. Классически это поддержание доступности, удобства, происхождения (provenance) и безопасности данных. Один лидер назвал её «картой, которая не даёт финансовому директору сесть в тюрьму». Но Gartner прогнозировал, что более 80% инициатив governance в 2022 году провалятся. Авторы считают, что репутация плохая, потому что классические подходы не масштабируются на облачные стеки. Сильным инструментом governance стали каталоги данных.
Каталог данных в первую очередь
Заголовок раздела «Каталог данных в первую очередь»Каталог данных похож на библиотечный каталог: это инвентарь метаданных. Он показывает lineage источника и так повышает доверие, а ещё помогает следить, где хранятся персональные данные (PII), куда они «расползаются» дальше и у кого есть к ним доступ. Ручные каталоги не успевают за ростом данных и их распределением по доменам. Вендоры начинают использовать ML. Автоматические каталоги бывают трёх типов.
- Собственная разработка. Airbnb, Netflix и Uber строят свои каталоги (например, Databook в Uber), чтобы соответствовать нормам стран и союзов (GDPR). Плюс: можно быстро собрать дашборды с нужными полями. Минус: со временем падают видимость и взаимодействие, особенно в lineage. Для большинства компаний тратить силы на многомиллионный каталог нет смысла.
- Сторонние инструменты. Теперь есть каталоги на ML для распределённого governance. Главная жалоба на старые решения: неудобство. Если инструментом неудобно пользоваться, люди не будут следить за compliance.
- Open source. В 2018 году Lyft открыл Amundsen (движок data discovery и метаданных). Похожие проекты: Apache Atlas, Magda, CKAN. Но теги метаданных для контроля доступа ставят вручную, а на это не хватает времени. Один продакт-менеджер отказался от open source каталога: в нём не было готовой поддержки всех источников его стека.
Не только каталоги
Заголовок раздела «Не только каталоги»По мере роста каталогов недостаточно. Чтобы закрывать пробелы, нужно понимать, к каким данным реально обращаются. С этим помогают lineage и observability (см. главу 7). Для распределённых команд и чувствительных данных третьих сторон нужны автоматические политики: поиск PII и контроль доступа, собственной разработки или вендорские.
Без культуры не получить поддержку ни для governance, ни для качества. Зосия Коссовски (Zosia Kossowski, HubSpot) говорит: когда компания растёт, людям трудно потерять автономию, и приходится вводить больше процессов. Если чистота данных входит в критерии приёмки релиза, это проще, чем когда данные считают побочным продуктом. Её совет: привлекайте инженерных руководителей и всех, кто производит данные, в разговор о governance рано, чтобы они понимали, какую боль это причиняет.
Стратегия качества данных
Заголовок раздела «Стратегия качества данных»Теперь соберём всё вместе. Авторы называют шаги для тех, кто запускает инициативу качества с нуля.
- Сделайте руководство ответственным. Сначала честно оцените текущее состояние: как вы измеряете качество, какие KPI, кто за них отвечает и участвует ли руководство.
- Задайте KPI качества. Поймите каждый этап жизненного цикла и ценность данных: требования к сырым данным отличаются от требований к преобразованным. Не придумывайте «странные» оценки точности. Измеряйте простое: полноту, свежесть, точность, согласованность и валидность.
- Запустите программу governance. Если о программе качества никто не слышит, влияния не будет. Создайте программу «чемпионов качества данных»: они несут идею и проводят людей по правилам доступа, использования и хранения. Объясняйте, как качество влияет на каждую функцию, и ищите быстрые победы.
- Автоматизируйте lineage и инструменты governance. Ручной мониторинг утомителен и не поспевает за ML-моделированием, быстрыми дашбордами и data mesh. Вкладывайтесь в инструменты, которые проверяют и сигналят автоматически. С пользовательскими правилами они раскрывают потенциал данных.
- Составьте план коммуникации. Он держит руководство в курсе, stakeholders — согласными с ходом проекта, а владельцев данных — в курсе их задач. Хороший план двусторонний. Отличный убеждает скептиков, что команда управляет ситуацией.
Цель стратегии: чтобы все в компании чувствовали, что могут использовать данные, которым можно доверять. В итоге авторы отмечают, что компании всё чаще нанимают data reliability engineers, экспертов по observability и руководителей по data literacy.
Итоги главы
Заголовок раздела «Итоги главы»- Качество данных — это техника и культура. Тесты не создают доверия, пока его не принимает вся компания.
- Продуктом данных можно считать и сервис, который порождает данные, и результат кода (отчёт, дашборд, платформу). Нужны надёжность, владелец, SLA и документация.
- Пять шагов подхода: согласовать ожидания, мыслить как продакт-менеджер, вложиться в self-serve, добиваться надёжности по модели зрелости, подобрать структуру команды (часто hub and spoke).
- Платформу данных строят как продукт: связывают с целями бизнеса, выбирают долгий рост, согласуют базовые метрики и взвешивают build и buy.
- Проблема данных растёт вниз по пайплайну (blast radius), поэтому нужны ясные роли. По матрице RACI итоговая ответственность лежит на CDO.
Data certification— это семь шагов: observability, владельцы, критерии «хорошо», SLA, коммуникация, тег certified и обучение. Начинать лучше с важнейших таблиц и новых данных.- Структуру команды нужно менять вместе с ростом компании. Toast прошёл через все три модели.
- Без
data literacyи документации качество не живёт. Помогают отдельная ответственность за грамотность и каталоги метаданных. Data governanceдержится на каталоге, lineage, автоматических политиках и культуре. Стратегия качества: ответственность руководства, простые KPI, чемпионы, автоматизация, коммуникация.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
data product | Набор данных или инструмент, которым управляют как продуктом: владелец, SLA, пользователи |
data product manager | Менеджер, который отвечает за платформу данных и её пользу для потребителей |
self-serve | Инструменты, с которыми бизнес берёт данные сам, без запросов к дата-команде |
data reliability maturity curve | Модель зрелости: reactive, proactive, automated, scalable |
hub and spoke | Центральная platform-команда плюс встроенные аналитики в подразделениях |
blast radius | Размах последствий простоя данных ниже по потоку |
RACI | Матрица ролей: Responsible, Accountable, Consulted, Informed |
data certification | Одобрение набора данных после выполнения согласованных SLA |
data discovery | Понимание текущего состояния данных по доменам в реальном времени |
data literacy | Умение читать данные и общаться о них так, чтобы это давало ценность |
data governance | Управление доступностью, удобством, происхождением и безопасностью данных |
single source of truth | Единый «золотой» источник данных. Авторы советуют не переоценивать его |
PII | Персональные данные, по которым можно опознать человека |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Назначьте владельца каждой важной таблице. Запишите его в каталоге или теге. Без владельца таблицу нельзя сертифицировать.
- Пишите SLA как обещание с действиями. «К 8:00» мало. Добавьте, кто реагирует, за сколько часов и куда пишет.
- Считайте SLI и часы downtime. Их можно получить запросом по логам загрузок и инцидентов. Пример в практике ниже.
- Сертифицируйте по приоритету. Начните с таблиц, которые больше всего читают и от которых многое зависит. Старое оставьте на вторую волну.
- Не будьте каталогом в Slack. Если вас спрашивают, «какая таблица годится», нужны каталог и теги certified.
- Следите за alert fatigue. Если алерты игнорируют, меняйте мониторы.
- Не гонитесь за идеалом. Для маркетинговой аналитики хватает направленной точности. Строгость нужна там, где ошибка дорога.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Книга не даёт кода, но идею легко проверить на данных. Мы сделаем маленькую проверку «можно ли сертифицировать таблицу»: считаем SLI (долю дней, когда данные пришли к сроку), часы data downtime по формуле из шага 3 и применяем правило сертификации. Данные выдуманы, лимит простоя 8 часов за период. Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку.
Шаг 1. Создаём данные
Заголовок раздела «Шаг 1. Создаём данные»Три таблицы: обещания (срок, цель SLO и владелец), 20 дней загрузок и инциденты. У partner_feed нет владельца.
CREATE TABLE datasets ASSELECT * FROM (VALUES  ('orders',       'anna',  TIME '08:00', 0.95),  ('payments',     'boris', TIME '08:00', 0.95),  ('partner_feed', NULL,    TIME '05:00', 0.90)) t(table_name, owner, deadline, slo);
CREATE TABLE loads ASWITH days AS (  SELECT d.table_name, d.deadline, n::INT AS n,         CASE d.table_name           WHEN 'orders'   THEN CASE WHEN n = 5 THEN 45 ELSE -30 END           WHEN 'payments' THEN CASE WHEN n IN (2, 6, 9, 12) THEN 70 ELSE -20 END           ELSE                 CASE WHEN n IN (3, 4) THEN 120 ELSE -10 END         END AS delay_min,         CASE d.table_name           WHEN 'orders'   THEN 1000 + n * 10           WHEN 'payments' THEN CASE WHEN n = 8 THEN 300 ELSE 500 + n * 5 END           ELSE                 200 + n * 2         END AS row_count  FROM datasets d, generate_series(0, 19) AS g(n))SELECT table_name, DATE '2026-03-01' + n AS load_date,       ((DATE '2026-03-01' + n) + deadline) + to_minutes(delay_min) AS loaded_at,       row_countFROM days;
CREATE TABLE incidents ASSELECT * FROM (VALUES  ('orders',       1.0, 2.0),  ('payments',     2.0, 6.0),  ('payments',     1.0, 3.0),  ('payments',     4.0, 10.0),  ('partner_feed', 0.5, 1.5)) t(table_name, hours_to_detect, hours_to_resolve);
Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»В loads должно быть по 20 дней на таблицу.
SELECT table_name, count(*) AS load_days, min(load_date) AS first_day, max(load_date) AS last_dayFROM loads GROUP BY table_name ORDER BY table_name;┌──────────────┬───────────┬────────────┬────────────┐│ table_name │ load_days │ first_day │ last_day ││ varchar │ int64 │ date │ date │├──────────────┼───────────┼────────────┼────────────┤│ orders │ 20 │ 2026-03-01 │ 2026-03-20 ││ partner_feed │ 20 │ 2026-03-01 │ 2026-03-20 ││ payments │ 20 │ 2026-03-01 │ 2026-03-20 │└──────────────┴───────────┴────────────┴────────────┘Шаг 3. SLI: доля дней, когда данные пришли к сроку
Заголовок раздела «Шаг 3. SLI: доля дней, когда данные пришли к сроку»CREATE VIEW sli ASSELECT d.table_name, d.slo, count(*) FILTER (WHERE l.loaded_at::TIME <= d.deadline) AS on_time_days, count(*) AS days, round(on_time_days / days, 2) AS sliFROM loads l JOIN datasets d USING (table_name)GROUP BY ALL;SELECT * FROM sli ORDER BY table_name;┌──────────────┬──────────────┬──────────────┬───────┬────────┐│ table_name │ slo │ on_time_days │ days │ sli ││ varchar │ decimal(3,2) │ int64 │ int64 │ double │├──────────────┼──────────────┼──────────────┼───────┼────────┤│ orders │ 0.95 │ 19 │ 20 │ 0.95 ││ partner_feed │ 0.90 │ 18 │ 20 │ 0.9 ││ payments │ 0.95 │ 16 │ 20 │ 0.8 │└──────────────┴──────────────┴──────────────┴───────┴────────┘orders и partner_feed держат свои цели, payments нет: 0,8 вместо 0,95.
Шаг 4. Data downtime: число инцидентов × (время до обнаружения + время до решения)
Заголовок раздела «Шаг 4. Data downtime: число инцидентов × (время до обнаружения + время до решения)»CREATE VIEW downtime ASSELECT table_name, count(*) AS incidents, sum(hours_to_detect + hours_to_resolve) AS downtime_hFROM incidents GROUP BY table_name;SELECT * FROM downtime ORDER BY table_name;┌──────────────┬───────────┬───────────────┐│ table_name │ incidents │ downtime_h ││ varchar │ int64 │ decimal(38,1) │├──────────────┼───────────┼───────────────┤│ orders │ 1 │ 3.0 ││ partner_feed │ 1 │ 2.0 ││ payments │ 3 │ 26.0 │└──────────────┴───────────┴───────────────┘Шаг 5. Правило сертификации
Заголовок раздела «Шаг 5. Правило сертификации»Таблица certified, если у неё есть владелец, SLI не ниже SLO и простой не больше 8 часов.
SELECT d.table_name, d.owner IS NOT NULL AS has_owner, s.sli >= d.slo AS slo_met, coalesce(w.downtime_h, 0) <= 8 AS downtime_ok, CASE WHEN d.owner IS NOT NULL AND s.sli >= d.slo AND coalesce(w.downtime_h, 0) <= 8 THEN 'certified' ELSE 'not certified' END AS statusFROM datasets dJOIN sli s USING (table_name)LEFT JOIN downtime w USING (table_name)ORDER BY d.table_name;┌──────────────┬───────────┬─────────┬─────────────┬───────────────┐│ table_name │ has_owner │ slo_met │ downtime_ok │ status ││ varchar │ boolean │ boolean │ boolean │ varchar │├──────────────┼───────────┼─────────┼─────────────┼───────────────┤│ orders │ true │ true │ true │ certified ││ partner_feed │ false │ true │ true │ not certified ││ payments │ true │ false │ false │ not certified │└──────────────┴───────────┴─────────┴─────────────┴───────────────┘Сертифицирована только orders. У partner_feed нет владельца, у payments не выполнены SLO и лимит простоя.
Задания
Заголовок раздела «Задания»Задание 1. Правило volume из шага 3: «таблица никогда не уменьшается». Найдите дни, когда row_count стал меньше, чем вчера.
Решение
SELECT table_name, load_date, row_count, lag(row_count) OVER (PARTITION BY table_name ORDER BY load_date) AS prev_rowsFROM loadsQUALIFY row_count < prev_rowsORDER BY table_name, load_date;┌────────────┬────────────┬───────────┬───────────┐│ table_name │ load_date │ row_count │ prev_rows ││ varchar │ date │ int64 │ int64 │├────────────┼────────────┼───────────┼───────────┤│ payments │ 2026-03-09 │ 300 │ 535 │└────────────┴────────────┴───────────┴───────────┘Таблица payments потеряла строки 9 марта. Это не отменяет сертификацию, но алерт нужен.
Задание 2. Для канала инцидентов нужен список опозданий: таблица, день, во сколько пришла и на сколько минут позже срока.
Решение
SELECT l.table_name, l.load_date, strftime(l.loaded_at, '%H:%M') AS loaded_at, date_diff('minute', l.load_date + d.deadline, l.loaded_at) AS minutes_lateFROM loads l JOIN datasets d USING (table_name)WHERE l.loaded_at::TIME > d.deadlineORDER BY table_name, load_date;┌──────────────┬────────────┬───────────┬──────────────┐│ table_name │ load_date │ loaded_at │ minutes_late ││ varchar │ date │ varchar │ int64 │├──────────────┼────────────┼───────────┼──────────────┤│ orders │ 2026-03-06 │ 08:45 │ 45 ││ partner_feed │ 2026-03-04 │ 07:00 │ 120 ││ partner_feed │ 2026-03-05 │ 07:00 │ 120 ││ payments │ 2026-03-03 │ 09:10 │ 70 ││ payments │ 2026-03-07 │ 09:10 │ 70 ││ payments │ 2026-03-10 │ 09:10 │ 70 ││ payments │ 2026-03-13 │ 09:10 │ 70 │└──────────────┴────────────┴───────────┴──────────────┘Семь опозданий: одно у orders, два у partner_feed, четыре у payments.
Задание 3. Что у payments занимает больше времени: обнаружение или решение? Посчитайте сумму каждой части по таблицам.
Решение
SELECT table_name, sum(hours_to_detect) AS detect_h, sum(hours_to_resolve) AS resolve_hFROM incidents GROUP BY table_name ORDER BY table_name;┌──────────────┬───────────────┬───────────────┐│ table_name │ detect_h │ resolve_h ││ varchar │ decimal(38,1) │ decimal(38,1) │├──────────────┼───────────────┼───────────────┤│ orders │ 1.0 │ 2.0 ││ partner_feed │ 0.5 │ 1.5 ││ payments │ 7.0 │ 19.0 │└──────────────┴───────────────┴───────────────┘У payments и обнаружение (7 часов), и решение (19 часов) велики. Решение больше, поэтому SLA стоит писать отдельно для каждой части downtime.
Скрипты, которые запускают блоки и печатают этот вывод, лежат в scripts/data-quality-fundamentals-code/ (ch08_sqlrun.py и ch08_out_*.py).
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему авторы говорят, что доверие к данным нельзя построить одними тестами? Чем качество данных похоже на культуру?
- Какие две школы «данных как продукта» описал Чад Сандерсон и что общего в требованиях к обеим?
- Команда держит ручные проверки row count и получает алерты в Slack. На какой стадии модели зрелости она находится и что нужно для следующей?
- Что такое blast radius? Кто в цепочке страдает сильнее всего и почему?
- Вы вводите data certification. С каких таблиц начнёте и какие семь шагов пройдёте? Что должно быть в хорошем SLA, кроме срока?
- Почему Toast вернулся от децентрализованной модели к центральной? Как понять, что пора менять структуру команды?
Предыдущая: Глава 7. Сквозной lineage: от источника до дашборда. Следующая: Глава 9. Качество данных на практике: беседы и кейсы.