

Data Quality Fundamentals, глава 7: Сквозной lineage: от источника до дашборда
Главная мысль: Lineage — это карта пути данных от источника до дашборда. Без неё первопричину сбоя ищут вручную и долго. Авторы советуют строить lineage автоматически и до уровня отдельных полей.
О чём глава
Заголовок раздела «О чём глава»Как быстро понять, где сломались данные и кого это задело? В главе 6 мы разбирали, как чинить проблемы в масштабе. Там lineage был главным помощником. Здесь авторы показывают, как его построить: требования, данные, разбор SQL, интерфейс. В конце идёт кейс компании Fox.
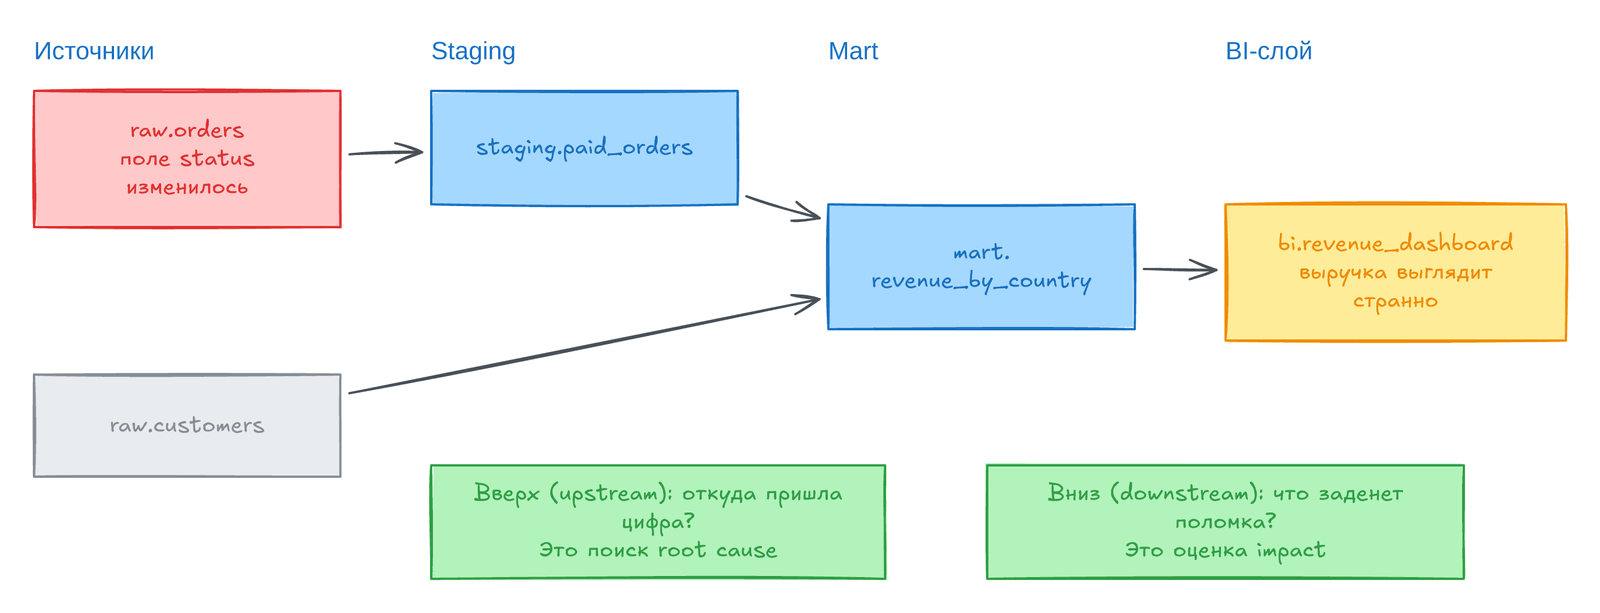
На схеме в источнике изменилось поле status. Оно прошло через staging и mart и дошло до дашборда. Вверх по карте ищем причину цифры, вниз оцениваем, кого заденет поломка.
Зачем data-командам такая карта
Заголовок раздела «Зачем data-командам такая карта»В 2004 году Google лежал несколько часов из-за вируса MyDoom. Инженеры искали причину вручную и в панике. Менеджер Бенджамин Трейнор Слосс решил, что так нельзя, и описал дисциплину site reliability engineering (SRE) о надёжности систем: в ней рутину автоматизируют, а сбои предвидят.
Data-команды сейчас в похожем положении. Системы данных сложны, зависимостей много, а данными пользуется вся компания. Команды переняли практики разработки и стали использовать dbt, Airflow, Snowflake, Databricks. Чтобы данным доверяли как продукту, нужна карта, которая связывает разрозненные системы. Это lineage.
Сквозной lineage на уровне полей
Заголовок раздела «Сквозной lineage на уровне полей»Тесты данных нужны, но для поиска первопричины и оценки влияния нужен lineage. Авторы сравнивают его с git blame: он показывает, где что сломалось в большой системе.
Что такое lineage
Заголовок раздела «Что такое lineage»Data lineage — запись о том, как данные дошли из точки A в точку B: от загрузки в хранилище до визуализации в BI. Он связывает источники (upstream) и зависимости ниже по потоку (downstream): отчёты и дашборды. К тому же современные инструменты показывают влияние изменений вплоть до колонки.
Строить lineage с нуля трудно, ведь даже простые SQL-запросы сложны. Раньше его разбирали вручную, зная среду компании почти наизусть. Такая карта быстро устаревает: данных больше, инструментов больше, а no-code BI открывает анализ новым пользователям.
Базовые требования к lineage
Заголовок раздела «Базовые требования к lineage»Много лет команды пользовались table-level lineage: картой зависимостей между таблицами. Эта карта полезна в целом, но не объясняет, как именно ломается pipeline. Авторы выделяют пять требований:
- Быстрый результат. Нужно быстро увидеть влияние изменения на поля и отчёты. Для этого уровень таблицы слишком крупный.
- Безопасность. Lineage не должен напрямую читать данные и PII. Он работает с метаданными, логами и запросами, а данные остаются у клиента.
- Автоматизация. Ручной lineage перекладывает работу на клиента. Лучше обновлять его автоматически.
- Интеграции. Нужен
knowledge graph, который сам создаёт узлы от хранилища (Snowflake, Databricks) и трансформаций (dbt, Airflow) до BI (Looker, Tableau). - Уровень колонок. Логи запросов дают только таблицы. Колонки надо разбирать отдельно: это трудно.
По базовому lineage можно считать агрегаты, например, сколько таблиц ниже по потоку использует каждое поле. Цель простая: сократить время обнаружения и исправления проблем.
Для чего нужен lineage на уровне полей
Заголовок раздела «Для чего нужен lineage на уровне полей»- Подозрительные цифры. Команда финтех-компании на 400 человек увидела странное значение в отчёте Looker. По lineage поля она нашла виновника: модель dbt, которая не запустилась.
- Снижение data debt.
Data debt— накопленные устаревшие колонки и таблицы. Lineage показывает, нужна ли колонка отчётам. - Управление PII. Видно, какие колонки с PII доходят до дашбордов. Данные можно убрать, а дашборд скрыть.
Дизайн lineage
Заголовок раздела «Дизайн lineage»Сначала нужно понять, из каких таблиц берётся каждая колонка. Это трудно: преобразования используют много источников. К тому же надо рекурсивно дойти до настоящих таблиц, если источник — псевдоним подзапроса, построенного на других подзапросах.
Комбинаций SQL-конструкций очень много, и первый прототип Monte Carlo покрыл только около 70% из них. Чтобы закрыть всё для всех хранилищ, ETL и BI, надо проверять каждый clause вместе с каждым другим.
В основе lineage три элемента: таблица-приёмник в отчёте, её поля и таблицы-источники в хранилище. Модель должна хранить сразу много запросов, ведь одну таблицу могут обновлять разные запросы. Авторы советуют собрать ID документа из логической модели, ID таблицы (table_mcon) и хэша объекта lineage поля. Тогда сохранятся все комбинации. Запись включает ID, версию, время, таблицы-источники, поле-приёмник и разобранный запрос.
Для каждого поля-приёмника хранится список колонок, которые его определяют: selected fields. Второй список — nonselected fields. Это колонки из WHERE и других частей запроса. Они влияют на то, какие строки берутся из источников, но не на значения. Их отделяют, чтобы интерфейс не показывал лишнего.
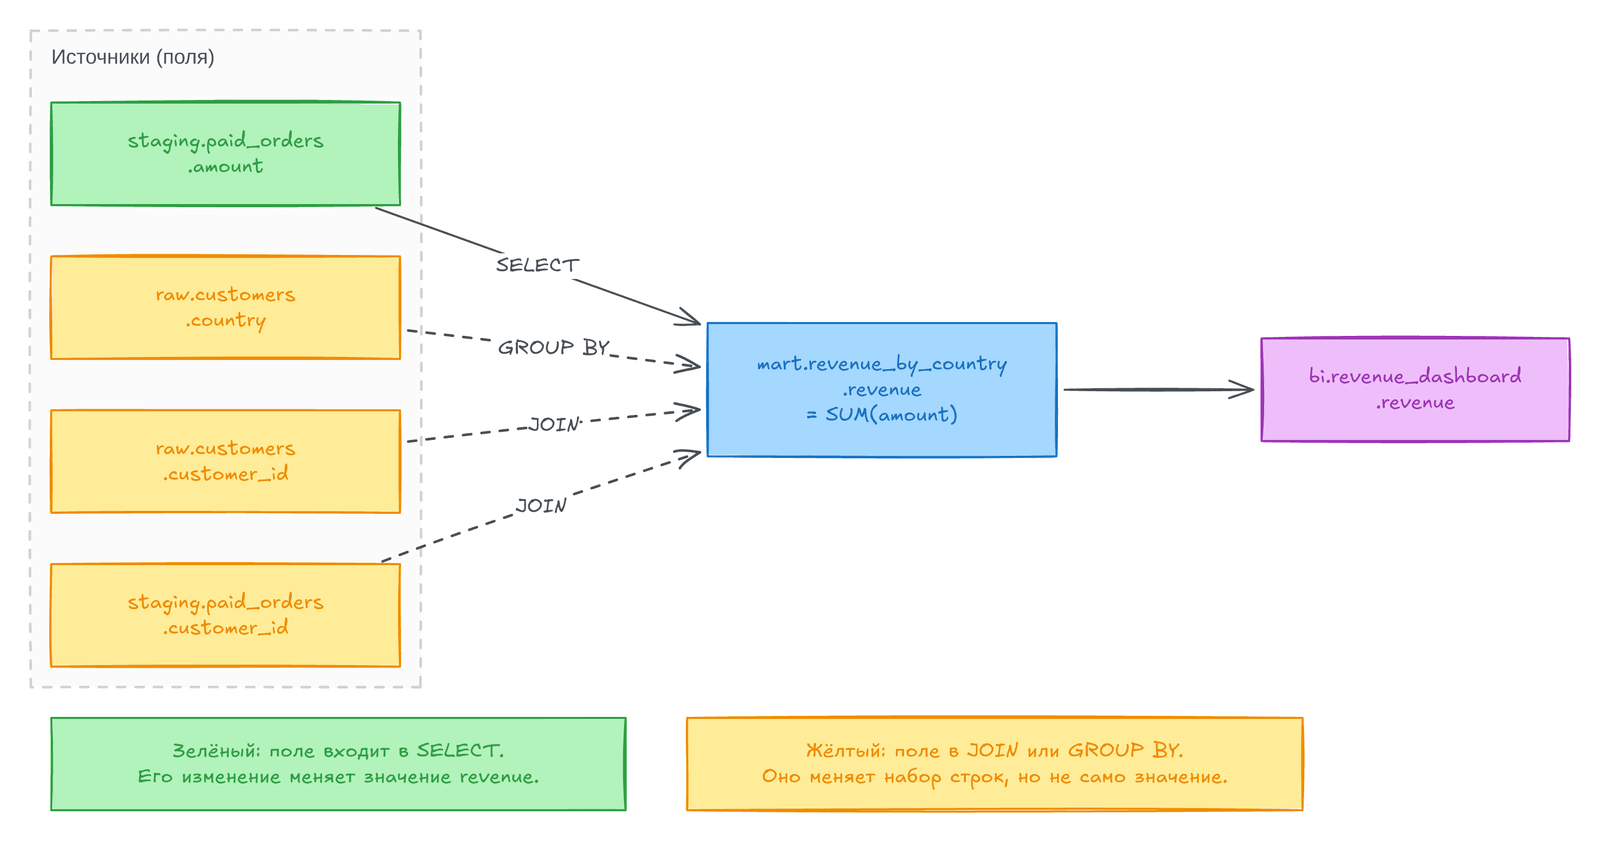
Поле revenue берёт значение из amount (зелёный). Остальные поля стоят в JOIN и GROUP BY (жёлтые): они решают, какие строки попадут в сумму.
В книге есть реальный запрос: девять временных таблиц в WITH, часть из них использует предыдущие, а в основном запросе есть соединения таблиц и подзапросов. Lineage по полям сводит его к понятным связям.
Разбор запросов
Заголовок раздела «Разбор запросов»SQL разбирают парсером. Авторы взяли ANTLR: open source генератор парсеров, который по грамматике достаёт колонки и связи полей. Для простых SELECT это сработало, и авторы поверили, что смогут построить рабочий бэкенд.
Но есть проблемы. Парсер медленно разбирает длинные запросы, где WITH определяет подзапросы, а основной запрос на них ссылается. Есть и нюансы диалекта: имя без кавычек разбирается как колонка, в кавычках — как строка. Выход: подправить грамматику под своё хранилище.
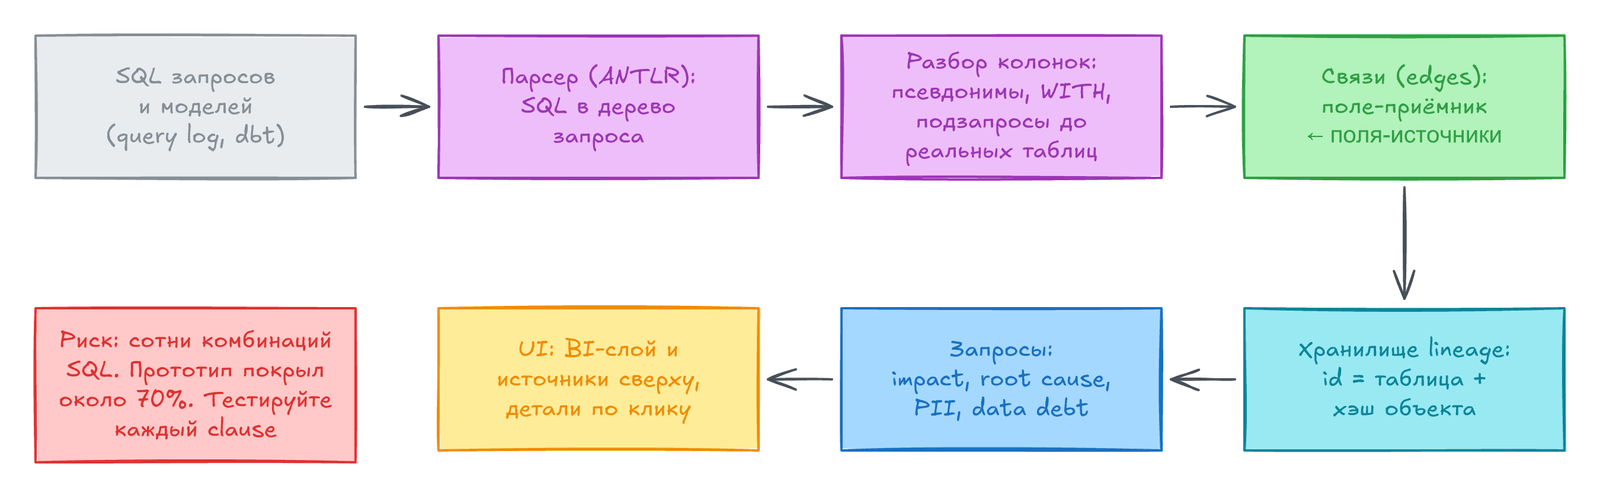
Сложный SQL создаёт и задачу для интерфейса. Нужно спрятать паутину связей и оставить дерево только с важными ветками.
Интерфейс lineage
Заголовок раздела «Интерфейс lineage»Lineage мало автоматизировать, его надо дополнять: подсвечивать связи, важные для конкретной проблемы. По словам авторов, лучший lineage показывает нужную информацию в нужный момент.
Чаще всего команды смотрят на два крайних слоя. Нижний — BI-объекты (Looker, Tableau). Команде важно знать влияние на них, чтобы сказать: «Аналитик, не используй это число, оно устарело». Верхний — таблица или поле в хранилище. К нему приходят, идя по lineage слой за слоем: там обычно причина, и её чинят.
Авторы советуют делать UI как переиспользуемый компонент на open source JavaScript или TypeScript. У поля могут быть десятки таблиц выше или ниже по потоку, а у них тысячи полей. Поэтому отрисовка не должна тормозить: для больших наборов подойдут лёгкие библиотеки вроде React Virtuoso.
Lineage должен показывать как минимум два вида связей:
- SELECT lineage: связь «поле к полю». Изменение верхнего поля прямо меняет нижнее.
- Non-SELECT lineage: связь «поле к таблице», например из
WHERE. Нижние поля часто формируются фильтрацией или сортировкой по верхним.
Советы по разработке
Заголовок раздела «Советы по разработке»- Слушайте коллег. Парсер оказался сложнее, чем думали: коллега предупреждал о его причудах, но к нему не сразу прислушались. Это стоило много времени.
- Делайте прототип. Через несколько недель авторы отдали неидеальный прототип самым заинтересованным клиентам и получили первые подсказки.
- Выпускайте и улучшайте (
ship and iterate). Не ждите идеала: покажите, соберите отзывы, поправьте.
Авторы ждут, что по мере взросления рынка автоматический lineage станет нормой.
Кейс: надёжность данных в Fox
Заголовок раздела «Кейс: надёжность данных в Fox»Данные часто застревают в силосах, а запросы копятся в очередях к перегруженным инженерам. Алекс Твердохлеб, VP of Data Services в Fox Networks, выстроил команды, технологии и доверие, чтобы бизнес сам делал ad hoc аналитику без очередей, насколько это возможно.
«Controlled freedom»
Заголовок раздела ««Controlled freedom»»Подход Алекса — «контролируемая свобода» (controlled freedom). Он считает, что команда данных как единственный источник правды создаёт самый большой силос. Поэтому она не становится стражем, а задаёт рамки. Центральная команда держит три области: как данные приходят, как они защищены и как оптимизированы для стандартных executive-отчётов. Когда источники надёжны, а метрики едины, потребители свободно пользуются данными. Всё остальное, включая поиск данных и ad hoc аналитику, остаётся свободным.
Децентрализованная команда
Заголовок раздела «Децентрализованная команда»В Fox digital работают пять команд: сбор данных, engineering, аналитика, data science, архитектура. Единого лидера по архитектуре нет, решают вместе. Аналитики сидят рядом с бизнесом и ищут новые источники. Их работа превращается в STM (Source to Target Mapping): спецификацию, по которой инженеры строят pipeline. Так инженеры получают задачу для решения, а не стратегию аналитики, которую ещё надо собрать. Авторы оговариваются: подход зависит от структуры команды и SLA и подойдёт не всем.
Технологии для задач, а не ради новинок
Заголовок раздела «Технологии для задач, а не ради новинок»Алекс против погони за новинками: сначала надо понять бизнес, а иногда текущий стек достаточно оптимизировать. Fox выбрал lakehouse ради self-serve аналитики. Данные идут через «трёхслойный пирог»:
- Raw: данные как пришли.
- Optimized: отсортированы и нарезаны, в форматах для скорости. Это пул для self-serve.
- Published: оформлены как модели для широкого использования.
Алекс предупреждает: данные, которые трудно найти и наблюдать, превращаются в болото. Нужны единые форматы и строгие правила хранения.
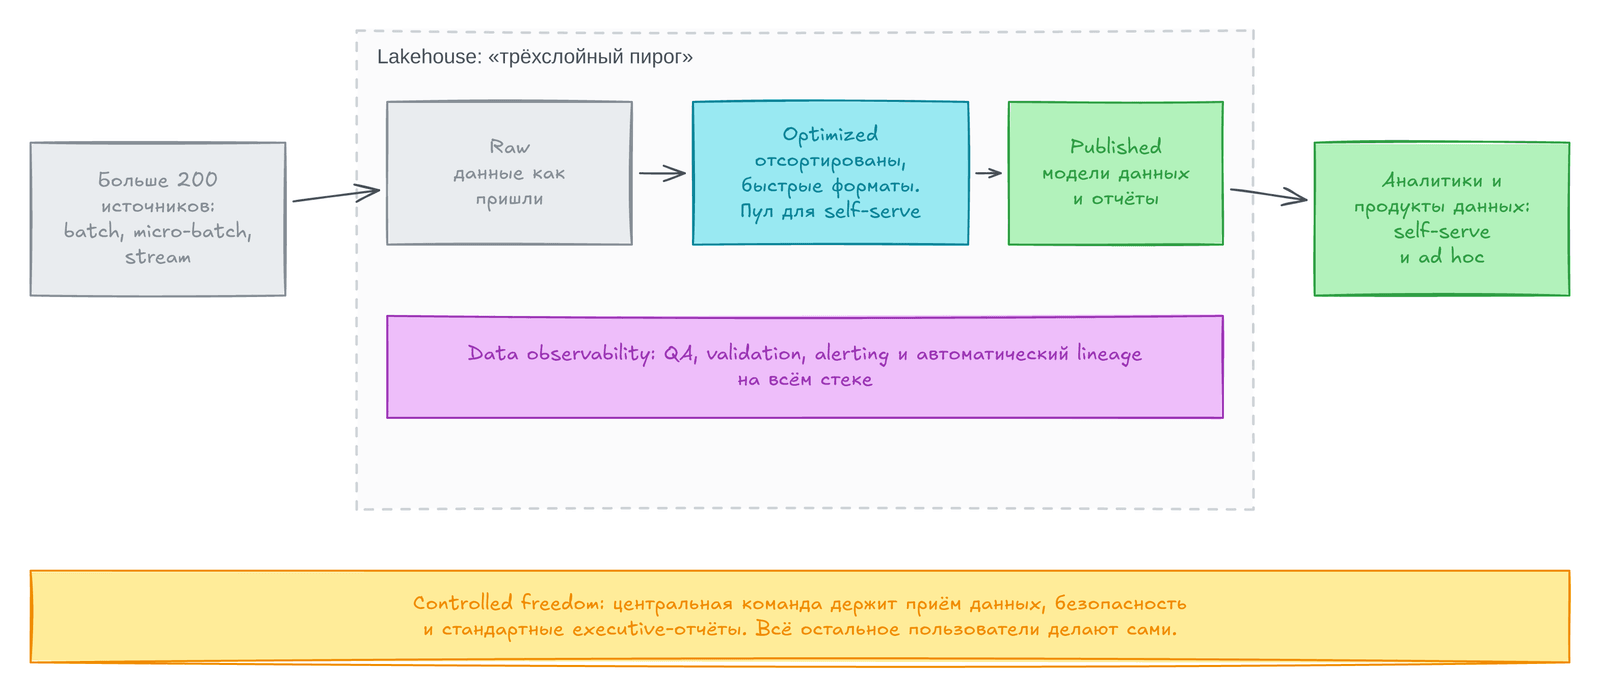
Доверие к данным делает аналитику self-serve
Заголовок раздела «Доверие к данным делает аналитику self-serve»Self-serve работает, если данным доверяют, поэтому весь стек обёрнут в QA, validation и alerting. Это observability. Fox получает данные из более чем 200 источников и обрабатывает почти 10 000 схем и десятки миллиардов записей в неделю. Команду под такой объём не масштабировать, поэтому нужны инструменты, в том числе Monte Carlo (продукт компании авторов). Мониторинг и автоматический lineage делают команду проактивной: проблему ловят до production, а если она дошла, по lineage видно масштаб. Всё держится на прозрачности: если скрывать проблемы, доверие теряется. А честность и ответственность дают ещё один шанс.
Итоги главы
Заголовок раздела «Итоги главы»- Lineage — карта пути данных от источника до BI. С ней ищут первопричину и оценивают влияние.
- Table-level lineage слишком грубый. Для быстрого исправления нужен lineage на уровне полей.
- Хорошему lineage нужны быстрый результат, безопасность, автоматизация, интеграции и уровень колонок.
- Главные сценарии: проверка подозрительных цифр, снижение data debt и контроль PII.
- Модель хранит связи «поле-приёмник — поля-источники». Одни связи задают значение (
select), другие — набор строк (non-select). - Разбор SQL — самая трудная часть. Первый прототип покрыл около 70% конструкций.
- Интерфейс прячет паутину связей. Чаще всего важны BI-слой и источники.
- Fox строит self-serve на «контролируемой свободе» и на observability с автоматическим lineage.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
lineage | Карта пути данных от источника до дашборда |
lineage на уровне полей | Связи между отдельными колонками |
table-level lineage | Lineage на уровне таблиц, без колонок |
upstream / downstream | Выше по потоку (источники) и ниже (отчёты) |
SELECT lineage | Поле задаёт значение нижнего поля |
non-SELECT lineage | Поле из WHERE, JOIN меняет набор строк |
knowledge graph | Граф объектов данных и связей |
data debt | Накопленные устаревшие объекты данных |
SRE | Дисциплина надёжности систем |
STM | Source to Target Mapping: спецификация для инженеров |
controlled freedom | Центр держит рамки, пользователи свободны внутри |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Стройте lineage автоматически из логов запросов и кода моделей. Ручная карта устареет.
- Начинайте с поля, а не с таблицы.
- Помечайте колонки с PII и проверяйте их путь до дашбордов.
- Перед удалением колонки смотрите на её потребителей в lineage.
- При инциденте идите вверх за причиной, потом вниз за влиянием и предупредите владельцев дашбордов.
- Парсер SQL должен падать на непонятном запросе, а не молча его пропускать.
Практика: lineage из SQL на Python
Заголовок раздела «Практика: lineage из SQL на Python»Lineage строится из самих SQL-запросов. Мы собрали маленькую версию. Парсер берём готовый: функция DuckDB json_serialize_sql возвращает дерево запроса. Наш код обходит дерево и ищет связи select и non-select. Он понимает WITH, подзапросы, JOIN, UNION, агрегаты и оконные функции. Полный код: ch07_lineage.py. Запуск: python3 scripts/data-quality-fundamentals-code/ch07_lineage.py.
Пять моделей лежат в списке MODELS. Вот одна из них:
"mart.revenue_by_country": """ WITH enriched AS ( SELECT c.country, p.amount FROM staging.paid_orders p JOIN raw.customers c ON c.customer_id = p.customer_id ) SELECT country, SUM(amount) AS revenue FROM enriched GROUP BY country""",Скрипт печатает запись для одного поля. ID состоит из таблицы и хэша объекта, как советует книга. В конце видно, что парсер не молчит, если не умеет разобрать запрос:
== 1. Связи, найденные в 5 моделяхвсего связей: 24из них select: 11 | non-select: 13
== 2. Запись lineage для поля mart.revenue_by_country.revenueedge_id: mart.revenue_by_country:95f902c3faполе: mart.revenue_by_country.revenuesources (select): staging.paid_orders.amountnon_select_sources: raw.customers.country, raw.customers.customer_id, staging.paid_orders.customer_id
== 3. Парсер не молчит, если не умеет разобрать запросне поддерживается: подзапрос внутри выражения
Теперь используем связи. Скрипт ch07_impact.py отвечает на вопросы из книги: что заденет сбой, откуда цифра, куда доходит PII, какие колонки не нужны.
== 1. Impact: поле источника сломалосьraw.orders.amount  меняет значения в: bi.revenue_dashboard.revenue, bi.top_customers_dashboard.total  меняет набор строк в: -raw.orders.status  меняет значения в: -  меняет набор строк в: bi.revenue_dashboard.country, bi.revenue_dashboard.revenue, bi.top_customers_dashboard.email, bi.top_customers_dashboard.total
== 2. Root cause: откуда берётся bi.revenue_dashboard.revenueзначение приходит из: raw.orders.amountнабор строк задают: raw.customers.country, raw.customers.customer_id, raw.orders.customer_id, raw.orders.status
== 3. PII: колонки с персональными данными доходят до дашбордовraw.customers.email -> bi.top_customers_dashboard.email, bi.top_customers_dashboard.total
== 4. Data debt: колонки источников без потребителейraw.orders.created_at
Пояснение:
raw.orders.statusне меняет значения в дашбордах, но меняет набор строк. Если формат статуса сменится, фильтрstatus = 'paid'пропустит другие заказы, и выручка изменится.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Связи удобно хранить в таблице. Тогда анализ влияния — это рекурсивный запрос. Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку.
Шаг 1. Создаём таблицу связей
Заголовок раздела «Шаг 1. Создаём таблицу связей»Таблица lineage_edges содержит те же 24 связи. Таблица raw_columns — колонки источников.
CREATE TABLE lineage_edges ASSELECT * FROM (VALUES  ('staging.paid_orders', 'order_id', 'raw.orders', 'order_id', 'select'),  ('staging.paid_orders', 'order_id', 'raw.orders', 'status', 'non-select'),  ('staging.paid_orders', 'customer_id', 'raw.orders', 'customer_id', 'select'),  ('staging.paid_orders', 'customer_id', 'raw.orders', 'status', 'non-select'),  ('staging.paid_orders', 'amount', 'raw.orders', 'amount', 'select'),  ('staging.paid_orders', 'amount', 'raw.orders', 'status', 'non-select'),  ('mart.revenue_by_country', 'country', 'raw.customers', 'country', 'select'),  ('mart.revenue_by_country', 'country', 'raw.customers', 'customer_id', 'non-select'),  ('mart.revenue_by_country', 'country', 'staging.paid_orders', 'customer_id', 'non-select'),  ('mart.revenue_by_country', 'revenue', 'staging.paid_orders', 'amount', 'select'),  ('mart.revenue_by_country', 'revenue', 'raw.customers', 'country', 'non-select'),  ('mart.revenue_by_country', 'revenue', 'raw.customers', 'customer_id', 'non-select'),  ('mart.revenue_by_country', 'revenue', 'staging.paid_orders', 'customer_id', 'non-select'),  ('mart.top_customers', 'email', 'raw.customers', 'email', 'select'),  ('mart.top_customers', 'email', 'raw.customers', 'customer_id', 'non-select'),  ('mart.top_customers', 'email', 'staging.paid_orders', 'customer_id', 'non-select'),  ('mart.top_customers', 'total', 'staging.paid_orders', 'amount', 'select'),  ('mart.top_customers', 'total', 'raw.customers', 'customer_id', 'non-select'),  ('mart.top_customers', 'total', 'raw.customers', 'email', 'non-select'),  ('mart.top_customers', 'total', 'staging.paid_orders', 'customer_id', 'non-select'),  ('bi.revenue_dashboard', 'country', 'mart.revenue_by_country', 'country', 'select'),  ('bi.revenue_dashboard', 'revenue', 'mart.revenue_by_country', 'revenue', 'select'),  ('bi.top_customers_dashboard', 'email', 'mart.top_customers', 'email', 'select'),  ('bi.top_customers_dashboard', 'total', 'mart.top_customers', 'total', 'select')) t(dst_table, dst_col, src_table, src_col, kind);
CREATE TABLE raw_columns ASSELECT * FROM (VALUES  ('raw.orders', 'order_id'), ('raw.orders', 'customer_id'), ('raw.orders', 'amount'),  ('raw.orders', 'status'), ('raw.orders', 'created_at'),  ('raw.customers', 'customer_id'), ('raw.customers', 'email'), ('raw.customers', 'country')) t(tbl, col);
Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»Должно быть 11 связей select и 13 non-select.
SELECT kind, count(*) AS edges FROM lineage_edges GROUP BY kind ORDER BY kind;Задания
Заголовок раздела «Задания»Задание 1. Найдите все поля ниже по потоку от raw.orders.amount. Идите только по связям select и покажите глубину.
Решение
WITH RECURSIVE down(tbl, col, depth) AS ( SELECT dst_table, dst_col, 1 FROM lineage_edges WHERE src_table = 'raw.orders' AND src_col = 'amount' AND kind = 'select' UNION SELECT e.dst_table, e.dst_col, d.depth + 1 FROM down d JOIN lineage_edges e ON e.src_table = d.tbl AND e.src_col = d.col AND e.kind = 'select')SELECT depth, tbl || '.' || col AS field FROM down ORDER BY depth, field;Результат: 5 полей на глубинах 1–3. Последние два лежат в bi.*.
Задание 2. Для каждой колонки источника посчитайте, сколько полей bi.* она задевает (по всем связям). Какие колонки не задевают ничего?
Решение
WITH RECURSIVE reach(root_tbl, root_col, tbl, col) AS ( SELECT src_table, src_col, dst_table, dst_col FROM lineage_edges WHERE src_table LIKE 'raw.%' UNION SELECT r.root_tbl, r.root_col, e.dst_table, e.dst_col FROM reach r JOIN lineage_edges e ON e.src_table = r.tbl AND e.src_col = r.col)SELECT c.tbl AS raw_table, c.col AS raw_column, count(DISTINCT r.tbl || '.' || r.col) FILTER (WHERE r.tbl LIKE 'bi.%') AS bi_fieldsFROM raw_columns cLEFT JOIN reach r ON r.root_tbl = c.tbl AND r.root_col = c.colGROUP BY c.tbl, c.colORDER BY bi_fields DESC, raw_table, raw_column;Результат: status и оба customer_id задевают по 4 поля. Колонки order_id и created_at не задевают ничего: это data debt. LEFT JOIN нужен, чтобы они не пропали из результата.
Задание 3. raw.customers.email — это PII. До каких полей дашбордов она доходит?
Решение
WITH RECURSIVE reach(tbl, col) AS ( SELECT dst_table, dst_col FROM lineage_edges WHERE src_table = 'raw.customers' AND src_col = 'email' UNION SELECT e.dst_table, e.dst_col FROM reach r JOIN lineage_edges e ON e.src_table = r.tbl AND e.src_col = r.col)SELECT tbl || '.' || col AS bi_field FROM reach WHERE tbl LIKE 'bi.%' ORDER BY 1;Результат: оба поля bi.top_customers_dashboard. email дошёл как значение, а total — как группировка.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем lineage на уровне полей лучше lineage на уровне таблиц? Когда таблицы мало?
- Почему lineage не должен читать сами данные? Что он использует вместо них?
- Чем
SELECT lineageотличается отnon-SELECT lineage? Как поле изWHEREможет испортить цифру? - Почему разбор SQL — самая трудная часть lineage? Как не пропустить редкие конструкции?
- Какие два слоя lineage важны чаще всего и почему?
- Что такое «controlled freedom» в Fox? Что остаётся у центральной команды?
Предыдущая: Глава 6. Как чинить проблемы с качеством данных в масштабе. Следующая: Глава 8. Качество данных для всей компании.