

Data Quality Fundamentals, глава 4: Мониторинг и поиск аномалий в пайплайнах
Главная мысль: Тесты ловят только проблемы, которые вы предвидели. Остальное ловит мониторинг: он учится по истории, как выглядят «нормальные» данные, и тревожит при отклонении. Идеального детектора нет: меньше ложных тревог значит больше пропусков, и наоборот. Поэтому порог нужно подбирать и измерять через precision, recall и F-score.
О чём глава
Заголовок раздела «О чём глава»Как узнать о поломке, которую никто не ждал? В главе 3 были тесты и очистка. Тесты не покрывают всё. Здесь авторы (с участием Райана Кирнса) на учебном примере строят мониторы для пяти столпов data observability: свежесть, объём, распределение, схема и lineage. Потом они объясняют, как оценивать детектор. В главе 5 эти идеи войдут в архитектуру вместе с SLA, SLI и SLO.
Темы главы:
- известные и неизвестные «неизвестные» проблемы;
- мониторы свежести и распределения на SQL;
- мониторы схемы и
lineage, расследование аномалии; - ложные срабатывания,
precision,recall,F-score; - другие методы, хранилища и озёра.
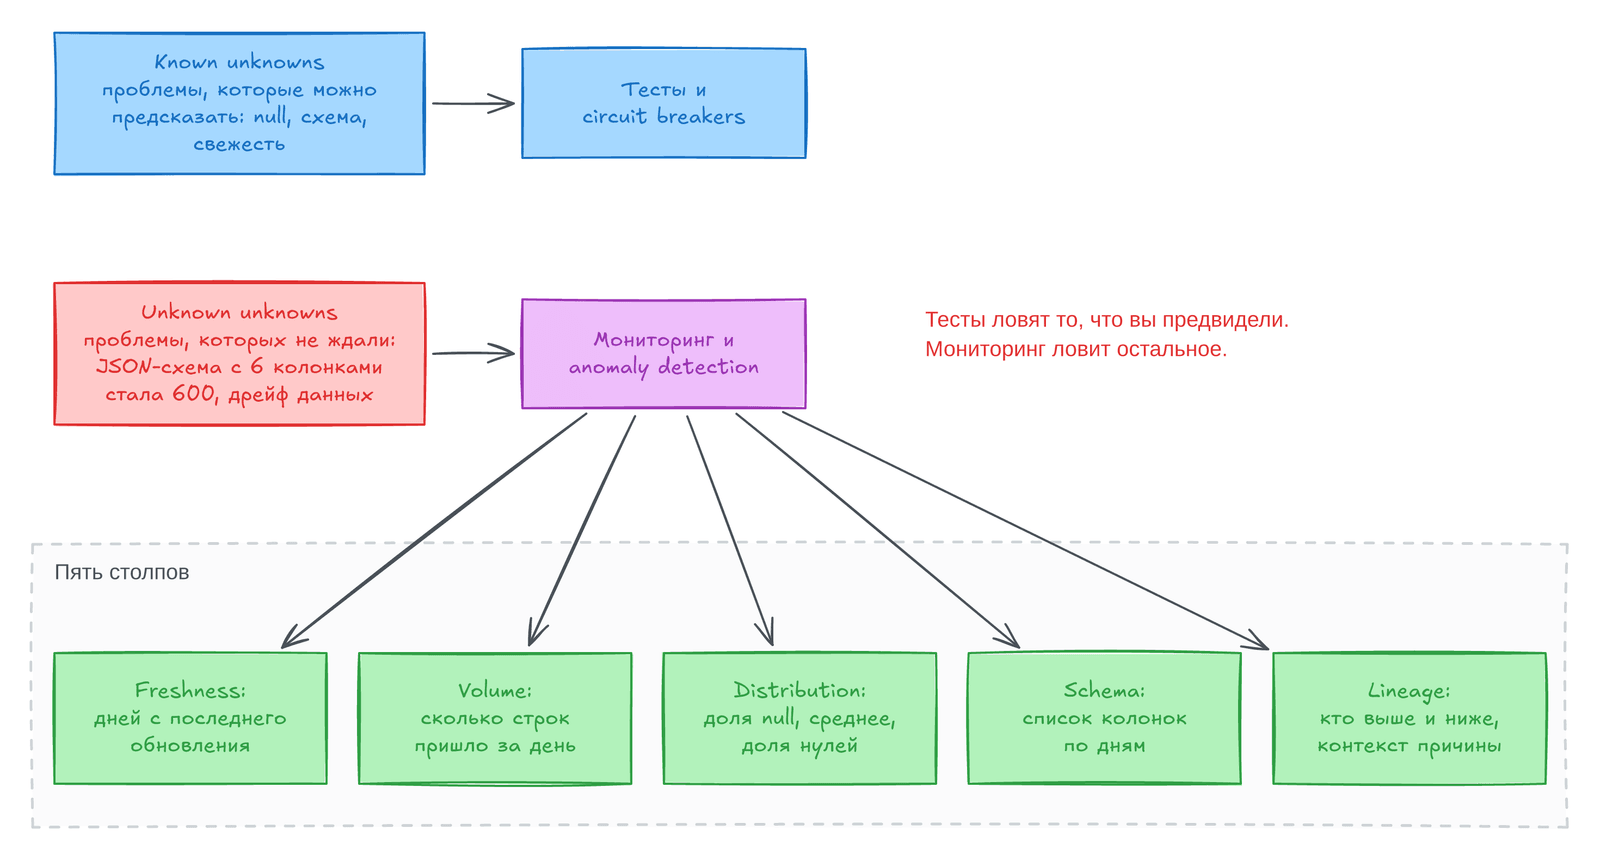
Слева показаны два вида проблем и то, чем их закрывают. Внизу — столпы, метрики которых считает монитор.
Known unknowns и unknown unknowns
Заголовок раздела «Known unknowns и unknown unknowns»Авторы начинают с машины. Вы купили новую машину, все системы в порядке. На трассе хлопок: проколото колесо. Гвоздь на дороге нельзя было проверить заранее. С данными так же: никакие тесты не защитят от data downtime полностью. Он возникает на любом шаге пайплайна, часто по причинам, не связанным с самими данными. Поэтому нужен мониторинг, а в нём anomaly detection: поиск событий, сильно отличающихся от нормы (например, мошенничество с картой или падение сайта). Такие методы развивают Meta, Google и Uber. Для глубокого погружения авторы советуют отчёт Anomaly Detection for Monitoring (Jinka, Schwartz).
Раньше это считали «приятным дополнением». Теперь системы сложнее, а данными пользуются все функции, поэтому команды должны действовать и заранее, и после факта. Машина сама сообщает, что мало масла или давления в шинах. Мониторинг данных работает так же.
Проблемы бывают двух видов:
- Known unknowns можно предсказать:
null, конкретные задержки, смена схемы из-за регулярно обновляемой системы. Их закрывают тесты иcircuit breaker. - Unknown unknowns не покроет даже полный набор тестов. Они возникают по всему пайплайну, а не только там, где стоят проверки.
Примеры unknown unknowns:
- другая команда меняет JSON-схему, и из 6 колонок получается 600;
- случайное изменение в ETL отключает тесты, и плохие данные проходят;
- устаревшие данные неделями никто не замечает, и страдают метрики маркетинга;
data drift: данные медленно меняются. Его трудно поймать, если тесты смотрят только на новую порцию, а не на то, что уже лежит в таблице.
Мониторинг сравнивает поведение с тем, что обычно было у пайплайна. Если знаешь, как выглядят «хорошие» данные, проще заметить «плохие».
Как построить детектор аномалий
Заголовок раздела «Как построить детектор аномалий»Авторы разбирают пошаговый пример. Технологии могут быть любыми. В книге это SQLite, Jupyter и Python. Данные придуманы: таблица EXOPLANETS про пригодные для жизни экзопланеты, с аномалиями, смоделированными по реальным инцидентам. В ней есть расстояние, гравитация, период обращения, температура (любое поле может быть NULL) и date_added: когда система добавила планету.
Пояснение: в книге пример на SQLite, у нас те же идеи на DuckDB и на других сгенерированных данных. Код в практике.
Пример «ретроспективный»: мы смотрим на историю. В продакшене anomaly detection работает в реальном времени на каждом этапе жизненного цикла данных. Здесь строят детекторы свежести и распределения.
Мониторинг свежести
Заголовок раздела «Мониторинг свежести»Freshness отвечает на вопрос «данные актуальны?». Если отчёт обновляется каждый час и вдруг выглядит старым, что-то сломалось.
SQL не хранит, когда добавлена каждая запись. Поэтому дату добавления нужно писать самим (date_added). Группировка по ней показывает ритм таблицы: около 100 строк в день, с пробелами в несколько дней. Пробел измеряет метрика days_since_last_update: на дату X самые новые данные были Y дней назад. Её считают оконной функцией LAG:
days_since_last_update = date_added - LAG(date_added) OVER (ORDER BY date_added)В таблице этого значения нет, его даёт data observability. Теперь нужен порог: сколько дней уже много? Параметр превращает запрос в детектор: он решает, что считать аномалией, то есть поводом для алерта. При пороге 1 день находятся шесть пропусков: 8, 4, 8, 3, 5 и 3 дня. Восемь дней без данных могут означать поломку пайплайна.
Число 1 — это параметр модели. «Правильного» значения нет, но от него зависит результат:
- Меньше порог: ловим больше настоящих аномалий (высокий
recall), но часть «аномалий» не будет авариями. - Больше порог: алерты почти всегда настоящие (высокий
precision), но часть проблем пропускаем.
При пороге 3 два малых пропуска не видны. При пороге 7 остаются два самых больших. Лучший параметр лежит в «зоне Златовласки»: между слишком низким и слишком высоким. Этот баланс авторы называют постоянной темой в продакшене.
Распределение (distribution)
Заголовок раздела «Распределение (distribution)»Теперь смотрим на здоровье отдельных полей. Distribution показывает ожидаемые значения и как часто они встречаются. Простейший вопрос: как часто поле NULL? Какая-то доля пустых значений допустима, но если 10% стали 90%, надо знать.
Центральная предельная теорема говорит: средние независимых случайных выборок приближаются к нормальному распределению (колоколу Гаусса). Его задают среднее μ и разброс σ. Отсюда наивная идея: считать z-score значения, то есть (значение − μ) / σ: как далеко оно от центра колокола. Проведите линию (например, три σ) и назовите аномалией всё за ней. Статистически это верно, но для качества данных такой подход не годится по двум причинам.
- Теорема требует независимых случайных наблюдений. Для скорости ветра это разумно. Бизнес-данные другие: наблюдения связаны с другими переменными. У сети, закрытой по воскресеньям, число клиентов в день не подчиняется нормальному распределению: одна седьмая значений равна нулю. Эти нули задаёт день недели, а не случай.
- «Аномальное» не значит «интересное». Правило «три
σ» всегда формально верно. Но у временного ряда есть контекст (день недели, повторяющийся шаблон). И не каждая аномалия помогает найтиdata downtime.
Покажем это на коротком Python-примере. Восемь недель: по воскресеньям 0 строк (это норма), в одну среду загрузка не пришла (это поломка).
mu, sigma = statistics.mean(rows), statistics.pstdev(rows)z = [(n - mu) / sigma for n in rows]# ... verdict() считает тревоги и ложные воскресеньяprint("z-score, порог 3: ", verdict([i for i, v in enumerate(z) if abs(v) > 3]))print("z-score, порог 2: ", verdict([i for i, v in enumerate(z) if abs(v) > 2]))среднее = 83.6, sigma = 36.7, z у нуля = -2.28z-score, порог 3: тревог: 0, из них ложных (воскресенья): 0, поломка поймана: нетz-score, порог 2: тревог: 9, из них ложных (воскресенья): 8, поломка поймана: дас учётом дня недели: тревог: 1, из них ложных (воскресенья): 0, поломка поймана: даПри пороге 3 поломка не поймана. При пороге 2 поймана, но восемь воскресений тоже дали тревогу. Последняя строка — это детектор, который сравнивает день с тем же днём недели в прошлые недели: он нашёл только поломку. Код: ch04_zscore_seasonality.py.
Теперь пример книги: доля NULL в каждом поле по дням (строки с NULL делим на все строки, группируем по date_added). На графике видны всплески. Возьмём avg_temp: простейший детектор срабатывает, когда доля NULL больше 0,9. Он находит шесть дней в двух сериях подряд. Это «тупой инструмент»: иногда шаблон прост и порога хватает, но данные бывают шумными или с seasonality.
Seasonality(сезонность) — это предсказуемые колебания ряда с периодом. У посещаемости церкви недельная сезонность с пиком в воскресенье. У продаж курток в универмаге годовая: максимум осенью, минимум весной.
Алерты подряд избыточны. Их фильтруют: оставляют дату, только если предыдущий алерт был больше чем за день до неё. Остаётся три алерта. Ключевой параметр снова — порог 0,9: «доля NULL выше 90% — это проблема».
Умнее использовать rolling average, скользящее среднее за две недели. Алерт ставим, когда доля NULL минус скользящее среднее больше 0,3: так учитывается недавняя норма. Разность берут без модуля: рост доли NULL тревожит, а резкое снижение обычно не стоит алерта.
Мониторы для schema и lineage
Заголовок раздела «Мониторы для schema и lineage»Свежесть и распределение — это «классические» задачи: перед нами поток данных, и надо понять, выглядит ли он странно. Но нужен ещё контекст. Где случилась аномалия? Какие пайплайны выше по потоку могли стать причиной? Какие дашборды ниже по потоку пострадают? Изменилась ли структура данных? Ответы дают метаданные, а за них отвечают столпы schema и lineage.
Аномалии схемы
Заголовок раздела «Аномалии схемы»Добавим таблицу EXOPLANETS_EXTENDED: это та же таблица позже во времени. В ней есть новые данные и две новые колонки, eccentricity и atmosphere. Старые строки задним числом не заполнили, поэтому там пусто.
Появление колонок — это schema change: формальный чертёж данных изменился. Такое неприятно искать вручную. Оно может означать новые API-эндпоинты, «устаревшие» поля, которые ещё не устарели, или добавление и удаление колонок, строк и таблиц. База не хранит историю схемы, поэтому изменение легко пропустить.
Выход тот же, что с date_added: вести историю самим. Таблица EXOPLANETS_COLUMNS хранит список колонок на каждую дату. Сравнивая список со вчерашним (LAG), находим дату изменения: в книге это 19 июля. Общая схема для любого столпа: найти метаданные, которые показывают здоровье пайплайна, сохранять их и построить детектор.
Визуализация lineage
Заголовок раздела «Визуализация lineage»Lineage — самый целостный из пяти столпов. Он даёт контекст инциденту: (1) какие источники ниже по потоку пострадают, (2) какие источники выше по потоку могут быть первопричиной. Через SQL его трудно «нарисовать», но простой пример показывает пользу. Полностью тема раскрыта в главе 7.
Добавим таблицу HABITABLES, построенную из EXOPLANETS. В ней есть habitability: число от 0 до 1, насколько вероятна жизнь. Ещё есть perihelion и aphelion (ближняя и дальняя точки орбиты), atmosphere, min_temp и max_temp. Орбитальные точки считают из eccentricity, поэтому у старых строк они пустые. Получается граф: HABITABLES и EXOPLANETS_COLUMNS зависят от EXOPLANETS. Это очень простой lineage, но он уже полезен.
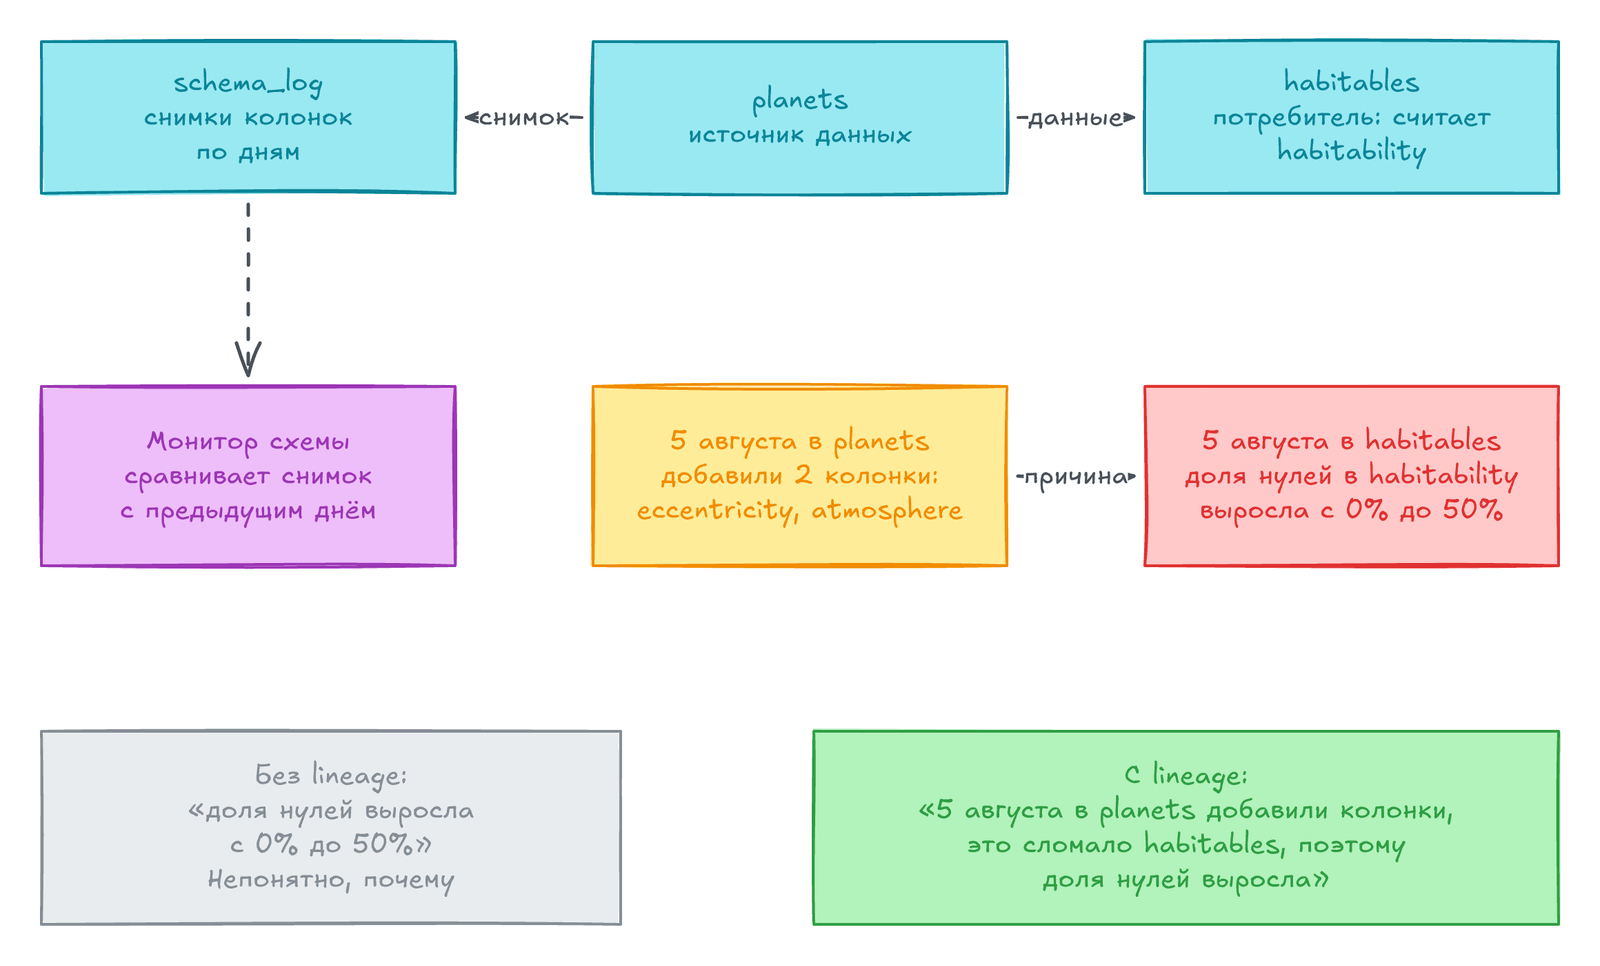
На схеме таблицы названы как в нашей практике (planets, habitables, schema_log). Жёлтый блок — это причина, красный — симптом. Зелёный блок внизу показывает, чем помогает lineage.
Расследование аномалии
Заголовок раздела «Расследование аномалии»Возьмём ключевую метрику habitability. Среднее по дням обычно около 0,5, но позже падает вдвое, до 0,25. Это аномалия распределения. В чём причина?
Авторы проверяют две гипотезы:
- Доля
NULLвhabitability. Везде 0, это не причина. - Доля нулей. До какого-то дня она равна 0, потом около 44%.
Берём детектор распределения и ищем первый день, когда доля нулей стала больше нуля. Это 19 июля: доля прыгнула с 0% до 37%. В этот же день изменилась схема EXOPLANETS_EXTENDED. Она выше по потоку от HABITABLES, значит, инциденты, скорее всего, связаны.
Сравните два объяснения:
- 19 июля доля нулей в
habitabilityвыросла с 0% до 37%. - 19 июля в
EXOPLANETSначали писать два новых поля. Это повлияло наHABITABLES: когдаeccentricityнеNULL, поляmin_tempиmax_tempчасто получали экстремальные значения. Поэтому выросла доля нулей вhabitability, а мы увидели падение среднего.
Первое объяснение называет только факт. Второе через зависимости таблиц и полей называет причину. Инженер со вторым объяснением решит проблему быстрее. Авторы считают schema и lineage двумя главными столпами для понимания последствий data downtime ниже по потоку, а часто и в реальном мире.
Масштабирование: Python и machine learning
Заголовок раздела «Масштабирование: Python и machine learning»Машинное обучение нужно, чтобы мониторинг работал в масштабе. ML-детекторы гибче применяются к множеству таблиц, и не нужно вручную писать правила по мере роста хранилища. Они подстраиваются под данные в реальном времени и видят сложные сезонные шаблоны, которые человек не заметит.
Вернёмся к свежести. Таблица получает около 100 строк в день, но иногда «уходит в офлайн». Некоторые пробелы нормальны: телескоп был на обслуживании. Другие — это поломка: например, сменили формат дат на ISO, и задача загрузки теперь падает. Правило «чем длиннее пробел, тем хуже» полезно, но как ловить только настоящие проблемы? Коротко: никак, идеальный предсказатель невозможен. Но понятия ML помогают поставить задачу структурно.
Ложные срабатывания и пропуски проблем
Заголовок раздела «Ложные срабатывания и пропуски проблем»Каждый алерт надо проверять вопросом: он точный? Есть два плохих сценария:
- алерт пришёл, проблемы нет: мы потратили время человека;
- проблема была, алерта нет: сбой остался незамеченным.
Это false positive (предсказали аномалию, а всё в порядке) и false negative (предсказали «ок», а была проблема). Первое похоже на крик «волк!» впустую, второе — на сторожа, спящего на посту. Нужно больше true positive (алерт при проблеме) и true negative (тишина, когда всё хорошо).
Anomaly detection — это задача без учителя (unsupervised): у данных нет меток, оптимальный ответ при обучении не известен. Без эталона нет сигнала ошибки (разницы между прогнозом и правильным ответом). Но словарь «с учителем» всё равно нужен: иначе нельзя сравнить два алгоритма или измерить улучшение.
На каждую точку детектор отвечает «аномалия» или «нет». При этом на самом деле проблема либо есть, либо нет. Так получаются четыре исхода: TP, TN, FP, FN.
Избежать обеих ошибок нельзя из-за простой статистики: меньше FP значит больше FN, и наоборот. Детектор «мальчик, кричавший волк» считает аномалией всё: он чувствителен (пропусков нет), но неспецифичен (много ложных тревог). Ему никто не верит. Детектор «спящая собака» не считает аномалией ничего: он специфичен (ложных тревог нет), но нечувствителен (много пропусков). На него нельзя положиться. Нужна середина.
Precision и recall
Заголовок раздела «Precision и recall»После запуска детектора у нас есть TP, TN, FP, FN. Из них считают метрики. Авторы выбирают две.
Precision = TP / (TP + FP). Из всех алертов: сколько верных. Высокийprecisionзначит: алерту можно верить.Recall = TP / (TP + FN). Из всех настоящих аномалий: сколько поймали. Высокийrecallзначит: детектор редко спит на посту.
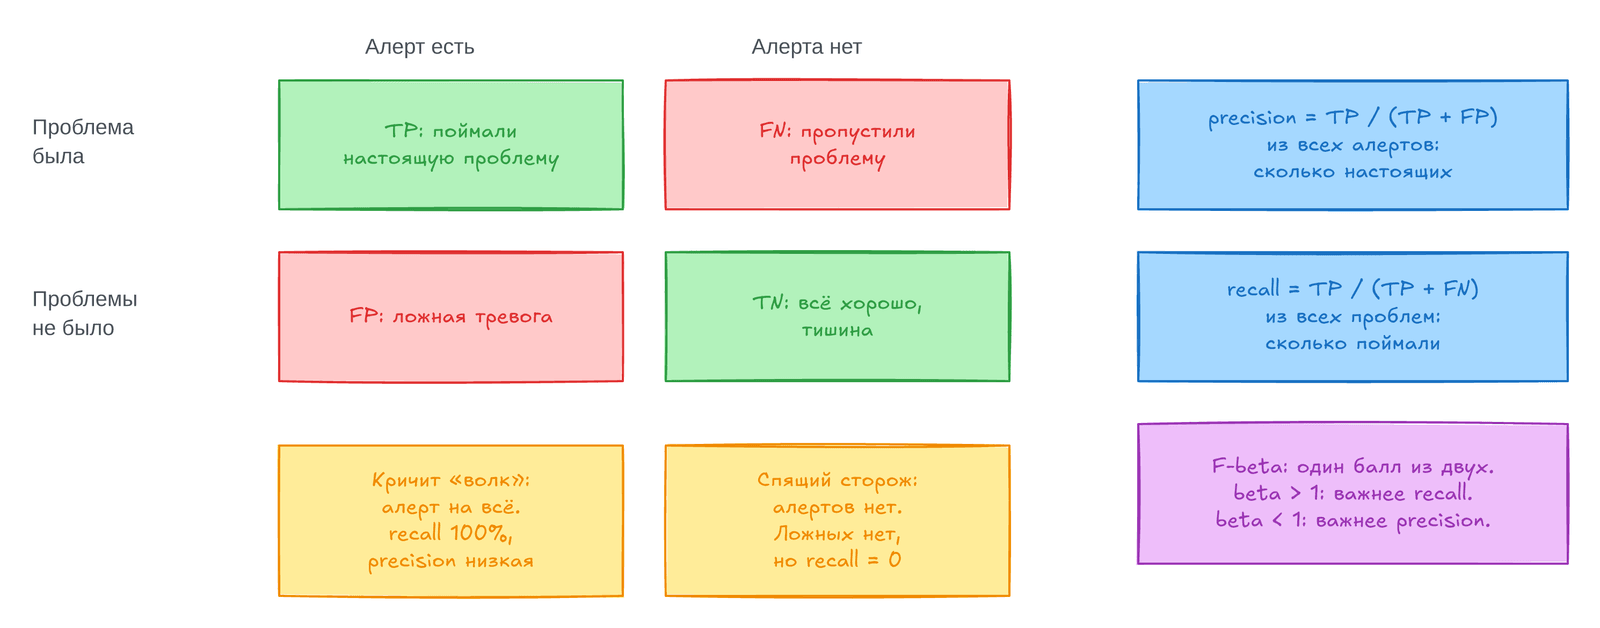
Строки — как было на самом деле, столбцы — ответ детектора.
Метрики тянут в разные стороны. Идеальный precision: ничего не алертить, ложных тревог нет, но recall ужасен. Идеальный recall: алертить на всё, пропусков нет, но precision падает.
Пояснение: при «ничего не алертим» формально
TP + FP = 0, иprecisionне определена. Авторы имеют в виду, что ложных тревог нет. Суть та же.
В бизнесе нужна одна цель, а не две. Метрики объединяет F-score. Общая формула для β ≥ 0:
F_β = (1 + β²) · Precision · Recall / (β² · Precision + Recall)Это взвешенная оценка: β задаёт вес. Смысл: «recall в β раз важнее precision». При β = 1 они равны. Если β > 1, важнее recall: «лучше поймать всё, даже с редкой ложной тревогой». Если β < 1, важнее precision: «лучше, чтобы тревоги были настоящими, даже если часть проблем пропущена».
Фреймворки для детекторов
Заголовок раздела «Фреймворки для детекторов»Алгоритмы не обязательно писать руками. Любимые инструменты авторов:
- Facebook Prophet: прогноз рядов с дневной, недельной, месячной и годовой сезонностью. Python и R.
- TensorFlow: библиотека ML. В
Kerasесть автоэнкодер: нейросетевая авторегрессия, мощнееARIMA. - PyTorch: похожая библиотека. В науке популярнее, а TensorFlow чаще в индустрии.
- scikit-learn:
ARIMA,k-nearest neighborsиisolation forest(последние два — методы кластеризации). - MLflow:
experiment tracking, то есть управление моделями в разработке и продакшене. Общий реестр и «проекты» (упакованное окружение) гарантируют, что код работает одинаково на разных машинах. - TensorBoard: визуализации TensorFlow: потери по эпохам, матрицы ошибок, разбор отдельных ошибок.
С ними детекторы лучше: меньше ложных срабатываний и пропусков, меньше ручной настройки.
Детектор свежести: precision и recall на деле
Заголовок раздела «Детектор свежести: precision и recall на деле»Вернёмся к свежести. Алгоритм простой: «любой пропуск длиннее X дней — аномалия». Даже для него precision, recall и F-score полезны. Нужны метки (ground truth): настоящий ли это инцидент. Без них метрики не посчитать, поэтому всегда думайте, как получить метки.
Авторы задали метки произвольно. Инцидентами они назвали два восьмидневных пропуска, пятидневный и один из двух трёхдневных. Четырёхдневный и второй трёхдневный инцидентами не считали. Длинные пропуски чаще настоящие, но гарантии нет, поэтому модель эффективна, но неидеальна, как в жизни.
При пороге 3 дня три алерта настоящие и один ложный, один инцидент пропущен. Precision = 3/4 = 0,75, recall = 0,75, F1 = 0,75. При пороге 5 алертов два, оба настоящие, precision = 1. Но два инцидента пропущены, recall = 0,5, F1 = 0,667. На графике по порогу видны закономерности: агрессивные детекторы с низким порогом дают лучший recall, пассивные — лучший precision, а F1 достигает максимума между ними. В книге это порог 4.
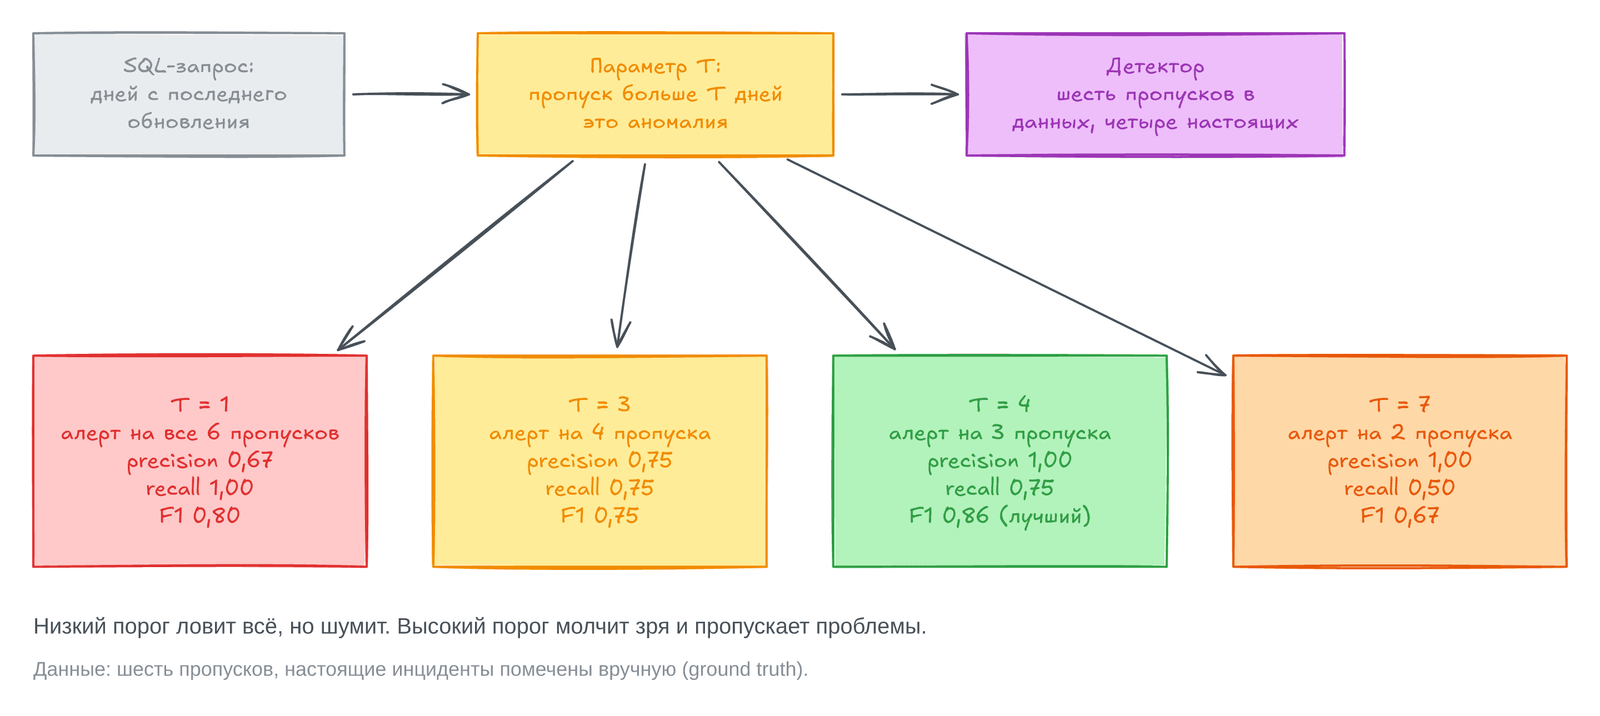
Читайте сверху вниз: запрос и параметр T дают детектор, ниже результат при разных T.
Те же расчёты в нашем коде. Функция считает F_β, скрипт перебирает пороги от 1 до 7:
def f_beta(p, r, beta): """F-beta = (1 + b^2) * P * R / (b^2 * P + R). beta > 1: важнее recall.""" if p + r == 0: return 0.0 return (1 + beta**2) * p * r / (beta**2 * p + r)порог T | TP FP FN | precision recall | F1 F2 F0.5 1 | 4 2 0 | 0.67 1.00 | 0.800 0.909 0.714 2 | 4 2 0 | 0.67 1.00 | 0.800 0.909 0.714 3 | 3 1 1 | 0.75 0.75 | 0.750 0.750 0.750 4 | 3 0 1 | 1.00 0.75 | 0.857 0.789 0.938 5 | 2 0 2 | 1.00 0.50 | 0.667 0.556 0.833 6 | 2 0 2 | 1.00 0.50 | 0.667 0.556 0.833 7 | 2 0 2 | 1.00 0.50 | 0.667 0.556 0.833лучший порог по F1: 4
детектор «всегда ОК»: accuracy = 99.6%, recall = 0.0, precision не определенаКод: ch04_fscore.py. Метки повторяют форму книги (длины 8, 4, 8, 3, 5, 3), даты наши. F2 (важнее recall) выше при низком пороге, F0,5 (важнее precision) выше при пороге 4 и больше. Так же ведут себя кривые в книге.
F-score: гармоническое среднее
Заголовок раздела «F-score: гармоническое среднее»F1 — это гармоническое среднее precision и recall: F1 = 2 / (1/Precision + 1/Recall). Оно ценит обе метрики одинаково. Но часто одна важнее.
Пример: 13 января 2018 года жителям Гавайев пришло сообщение, что на острова летит баллистическая ракета, и нужно искать укрытие. Алерт ушёл в 8:07 и кончался словами «Это не учения». Через 38 минут, когда сеть и линия 911 легли от перегрузки, власти признали ошибку. Это был тест, но система отправила настоящий алерт: ложное срабатывание. Обратный случай, пропуск реальной угрозы, был бы тяжелее. Значит, для такой системы FP лучше FN: recall важнее precision. F1 не подходит, нужна F_β с β > 1, например F2 или F3.
Почему accuracy не подходит
Заголовок раздела «Почему accuracy не подходит»Авторы почти не говорят «точность» (accuracy). Причина (пример профессора Стэнфорда Мехрана Саями): система диагностики редкой болезни всегда отвечает «нет». Если болезнь у 1,2 млн из 330 млн человек, accuracy = 1 − 1,2/330 ≈ 99,6%. Цифра отличная, но система бесполезна: она не нашла ни одного больного. Поэтому в ML смотрят на precision и recall. В конце нашего скрипта тот же эффект: детектор «всегда ОК» на 1000 проверках с 4 инцидентами показывает accuracy 99,6% и recall 0.
С F-score и настроенным алгоритмом можно ловить проблемы по всем пяти столпам.
Другие подходы к anomaly detection
Заголовок раздела «Другие подходы к anomaly detection»Лучшие алгоритмы делают три вещи: находят проблему почти в реальном времени, оповещают тех, кому нужно знать, и помогают предотвращать простои. Пример главы — лишь верхушка. Вот другие подходы:
- Правила и жёсткие пороги. Явные границы метрик. Называть это поиском аномалий можно, только если большинство точек лежит внутри порога. Правила отлично масштабируются и подходят для чётких
SLA. - Авторегрессия. Для временных рядов: данные прошлых шагов подают в линейную регрессию и предсказывают следующую точку. Точки, далеко ушедшие от прогноза, считаются аномальными. Со скользящим средним получаются
ARMAиARIMA. На примере с экзопланетами это сработало бы хорошо. - Экспоненциальное сглаживание. Убирает тренд и сезонность, чтобы простые методы (например,
ARIMA) могли работать. Известная модель: Holt-Winters. - Кластеризация.
k-nearest neighborsиisolation forestраскладывают похожие точки по группам и находят «белых ворон»: точки в маленьких группах. - Гиперпараметры. Часть параметров модель выучивает сама (в
z-scoreэтоμиσ). Другие,hyperparameters, задаёт человек: размер нейросети, скорость обучения, число эпох. - Ансамбль. Берёт лучшее из методов (кластеризация, сглаживание, авторегрессия) и объединяет прогнозы голосованием.
Эти темы выходят за рамки книги. Авторы отсылают к Hands-On Machine Learning Орельена Жерона.
Мониторы для хранилищ и для озёр
Заголовок раздела «Мониторы для хранилищ и для озёр»Важно понять, с чем вы работаете: со структурированным хранилищем или с «диким западом» data lake. Отличия в трёх пунктах: сколько точек входа учитывать, как собираются и хранятся метаданные, как вы к ним обращаетесь.
Точки входа. В озере их много, а данные из разных источников очень разные. Например, доля NULL в таблицах из Postgres, логах приложений и веб-API ведёт себя по-разному. Подход «один размер для всех» опасен: разным форматам подходят разные архитектуры и гиперпараметры. Решения: добавить источник как признак модели, взять ансамбль или завести отдельную модель на каждый случай.
Метаданные. Метаданные, собранные прямо в озеро, часто нужно подготовить: привести типы, выровнять схемы, вывести новые признаки. Это нормально делать перед обучением, если не создавать узкое место на больших пакетах. Иногда выгоднее поставить между озером и ML-алгоритмом шаги ELT. Зачем, показывает раздел «Cleaning Data» из главы 3.
Итоги главы
Заголовок раздела «Итоги главы»- Тесты закрывают known unknowns. Мониторинг и
anomaly detectionзакрывают unknown unknowns. - Запрос становится детектором, когда у него есть метрика и параметр: порог, окно, доля.
Freshness— это «дней с последнего обновления» черезLAG.Distribution— это долиNULLи нулей, среднее.- Простой
z-scoreплохо работает на бизнес-данных: наблюдения связаны, естьseasonality, и не каждая аномалия интересна. Schemaловят снимками списка колонок по дням.Lineageпоказывает, что выше и ниже, и сокращает путь к первопричине.False positiveиfalse negativeнельзя убрать вместе. Меньше одних значит больше других.Precisionотвечает «сколько алертов настоящие»,recall— «сколько проблем поймали».F_βобъединяет их, аβзадаёт, что важнее.- Без меток (
ground truth) нельзя измерить детектор.Accuracyдля редких событий обманывает. - В озере много точек входа: детекторы лучше делать по источникам.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
known unknowns / unknown unknowns | Проблемы, которые можно предсказать, и те, которых не ждали |
anomaly detection | Поиск значений, сильно отличающихся от нормы |
| детектор | Метрика плюс параметр. Решает, что считать аномалией |
z-score | (значение − μ) / σ: отклонение от среднего в стандартных отклонениях |
seasonality | Предсказуемые колебания ряда с периодом |
rolling average | Среднее за последние N точек: недавняя норма |
precision | TP / (TP + FP): доля настоящих алертов |
recall | TP / (TP + FN): доля пойманных проблем |
F-score | Один балл из precision и recall, β задаёт вес recall |
ground truth | Правильные метки: что было настоящей проблемой |
hyperparameters | Параметры, которые задаёт человек, а не выучивает модель |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Начните с двух метрик на важную таблицу.
days_since_last_updateи число строк в день: это один SQL-запрос. - Храните метаданные сами: снимки схемы и историю метрик.
- Порог — это решение, а не константа. Записывайте, почему порог такой, и пересматривайте его после ложных тревог.
- Размечайте инциденты. Таблица
incidents(day, table, is_real)позволяет считатьprecisionиrecallи сравнивать пороги по цифрам. - Выберите
βпо цене ошибки. Для витрины, от которой зависят деньги, важнееrecall. Если тревоги будят людей ночью, важнееprecision. - Читайте
lineageвместе с аномалией. Если выше по потоку в тот же день изменилась схема, начинайте оттуда.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. Данные генерирует SQL: хэш от id даёт одинаковый результат при каждом запуске.
Шаг 1. Создаём данные
Заголовок раздела «Шаг 1. Создаём данные»Таблица planets (как EXOPLANETS в книге) получает около 100 строк в день. Периоды из gaps дают пропуски свежести. В дни из spikes почти вся avg_temp равна NULL. С 5 августа в planets «появились новые колонки» (это записано в schema_log), и половина значений habitability в habitables становится нулём. Таблица incidents — это метки ground truth.
-- Периоды без загрузки (в эти дни данных нет) и дни, когда avg_temp почти вся NULLCREATE TABLE gaps(first_missing DATE, last_missing DATE);INSERT INTO gaps VALUES  ('2024-02-03','2024-02-09'), ('2024-03-20','2024-03-22'), ('2024-05-11','2024-05-17'),  ('2024-06-04','2024-06-05'), ('2024-06-18','2024-06-21'), ('2024-07-08','2024-07-09');CREATE TABLE spikes(day DATE);INSERT INTO spikes VALUES ('2024-04-09'), ('2024-07-23'), ('2024-07-24'), ('2024-07-25');
-- Основная таблица: 85-114 строк в день, доля NULL в avg_temp около 30%CREATE TABLE planets ASSELECT d.day || '-' || n AS id, d.day AS date_added,       CASE WHEN (hash(d.day || '-' || n || 't') % 1000) / 1000.0                 < CASE WHEN d.day IN (SELECT day FROM spikes) THEN 0.95 ELSE 0.3 END            THEN NULL            ELSE 200 + (hash(d.day || '-' || n || 'v') % 400) END AS avg_tempFROM (SELECT CAST(range AS DATE) AS day FROM range(DATE '2024-01-01', DATE '2024-09-07', INTERVAL 1 DAY)) dCROSS JOIN LATERAL (SELECT unnest(range(1, 86 + (hash(d.day::VARCHAR) % 30)::INT)) AS n)WHERE NOT EXISTS (SELECT 1 FROM gaps g WHERE d.day BETWEEN g.first_missing AND g.last_missing);
-- Потребитель: с 5 августа половина значений habitability ломается и становится 0CREATE TABLE habitables ASSELECT id, date_added,       CASE WHEN date_added >= DATE '2024-08-05' AND hash(id || 'z') % 100 < 50 THEN 0.0            ELSE (hash(id || 'h') % 999 + 1) / 1000.0 END AS habitabilityFROM planets;
-- Снимок списка колонок planets по дням и метки настоящих инцидентов свежестиCREATE TABLE schema_log ASSELECT day, CASE WHEN day < DATE '2024-08-05' THEN 'id,avg_temp,date_added'                 ELSE 'id,avg_temp,date_added,eccentricity,atmosphere' END AS colsFROM (SELECT CAST(range AS DATE) AS day FROM range(DATE '2024-01-01', DATE '2024-09-07', INTERVAL 1 DAY));CREATE TABLE incidents(day DATE);INSERT INTO incidents VALUES ('2024-02-10'), ('2024-05-18'), ('2024-06-22'), ('2024-07-10');
Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»Первый запрос должен вернуть 0 строк: id не повторяются.
SELECT id FROM planets GROUP BY id HAVING count(*) > 1;SELECT count(*) AS rows_total, count(DISTINCT date_added) AS load_days FROM planets;┌─────────┐│ id ││ varchar │├─────────┤│ 0 rows │└─────────┘┌────────────┬───────────┐│ rows_total │ load_days ││ int64 │ int64 │├────────────┼───────────┤│ 22307 │ 225 │└────────────┴───────────┘Шаг 3. Монитор свежести
Заголовок раздела «Шаг 3. Монитор свежести»Метрика days_since_last_update через LAG. Порог 1 день: каждое значение выше единицы — это пробел.
CREATE VIEW freshness ASSELECT date_added,       date_diff('day', lag(date_added) OVER (ORDER BY date_added), date_added) AS days_since_last_updateFROM (SELECT DISTINCT date_added FROM planets);
SELECT * FROM freshness WHERE days_since_last_update > 1 ORDER BY date_added;┌────────────┬────────────────────────┐│ date_added │ days_since_last_update ││ date │ int64 │├────────────┼────────────────────────┤│ 2024-02-10 │ 8 ││ 2024-03-23 │ 4 ││ 2024-05-18 │ 8 ││ 2024-06-06 │ 3 ││ 2024-06-22 │ 5 ││ 2024-07-10 │ 3 │└────────────┴────────────────────────┘Шесть пропусков длиной 8, 4, 8, 3, 5 и 3 дня. Как в книге, чем выше порог, тем меньше алертов.
Шаг 4. Среднее потребителя
Заголовок раздела «Шаг 4. Среднее потребителя»Среднее habitability по месяцам падает в августе почти вдвое. Причину ищем в задании 3.
SELECT date_trunc('month', date_added)::DATE AS month, round(avg(habitability), 3) AS avg_habitabilityFROM habitables GROUP BY month ORDER BY month;┌────────────┬──────────────────┐│ month │ avg_habitability ││ date │ double │├────────────┼──────────────────┤│ 2024-01-01 │ 0.503 ││ 2024-02-01 │ 0.503 ││ 2024-03-01 │ 0.504 ││ 2024-04-01 │ 0.499 ││ 2024-05-01 │ 0.499 ││ 2024-06-01 │ 0.498 ││ 2024-07-01 │ 0.495 ││ 2024-08-01 │ 0.272 ││ 2024-09-01 │ 0.248 │└────────────┴──────────────────┘Задания
Заголовок раздела «Задания»Задание 1. Для порогов T от 1 до 7 посчитайте TP, FP, FN, precision, recall и F1. Алерт: days_since_last_update > T. Настоящие инциденты лежат в incidents. Какой порог лучший?
Решение
WITH t AS (SELECT range AS threshold FROM range(1, 8)),scored AS ( SELECT t.threshold, count(*) FILTER (WHERE f.days_since_last_update > t.threshold AND i.day IS NOT NULL) AS tp, count(*) FILTER (WHERE f.days_since_last_update > t.threshold AND i.day IS NULL) AS fp, count(*) FILTER (WHERE f.days_since_last_update <= t.threshold AND i.day IS NOT NULL) AS fn FROM t CROSS JOIN freshness f LEFT JOIN incidents i ON i.day = f.date_added WHERE f.days_since_last_update > 1 GROUP BY t.threshold)SELECT threshold, tp, fp, fn, round(tp / (tp + fp), 2) AS precision, round(tp / (tp + fn), 2) AS recall, round(2 * tp / (2 * tp + fp + fn), 3) AS f1FROM scored ORDER BY threshold;┌───────────┬───────┬───────┬───────┬───────────┬────────┬────────┐│ threshold │ tp │ fp │ fn │ precision │ recall │ f1 ││ int64 │ int64 │ int64 │ int64 │ double │ double │ double │├───────────┼───────┼───────┼───────┼───────────┼────────┼────────┤│ 1 │ 4 │ 2 │ 0 │ 0.67 │ 1.0 │ 0.8 ││ 2 │ 4 │ 2 │ 0 │ 0.67 │ 1.0 │ 0.8 ││ 3 │ 3 │ 1 │ 1 │ 0.75 │ 0.75 │ 0.75 ││ 4 │ 3 │ 0 │ 1 │ 1.0 │ 0.75 │ 0.857 ││ 5 │ 2 │ 0 │ 2 │ 1.0 │ 0.5 │ 0.667 ││ 6 │ 2 │ 0 │ 2 │ 1.0 │ 0.5 │ 0.667 ││ 7 │ 2 │ 0 │ 2 │ 1.0 │ 0.5 │ 0.667 │└───────────┴───────┴───────┴───────┴───────────┴────────┴────────┘Лучший порог по F1 равен 4: ни одной ложной тревоги и три из четырёх инцидентов. Порог 1 ловит все четыре, но с двумя ложными тревогами. Тот же расчёт на Python: ch04_fscore.py.
Задание 2. Найдите дни, когда доля NULL в avg_temp выше скользящего среднего за 14 прошлых дней больше чем на 0,3. Оставьте один алерт на серию подряд идущих дней.
Решение
WITH rates AS ( SELECT date_added, avg((avg_temp IS NULL)::INT) AS null_rate FROM planets GROUP BY date_added),w AS ( SELECT *, avg(null_rate) OVER (ORDER BY date_added ROWS BETWEEN 14 PRECEDING AND 1 PRECEDING) AS rolling FROM rates),alerts AS ( SELECT date_added, null_rate, rolling, date_diff('day', lag(date_added) OVER (ORDER BY date_added), date_added) AS days_since_prev_alert FROM w WHERE null_rate - rolling > 0.3)SELECT date_added, round(null_rate, 3) AS null_rate, round(rolling, 3) AS rollingFROM alerts WHERE days_since_prev_alert IS NULL OR days_since_prev_alert > 1 ORDER BY date_added;┌────────────┬───────────┬─────────┐│ date_added │ null_rate │ rolling ││ date │ double │ double │├────────────┼───────────┼─────────┤│ 2024-04-09 │ 0.981 │ 0.315 ││ 2024-07-23 │ 0.949 │ 0.273 │└────────────┴───────────┴─────────┘Остались два алерта: 9 апреля и первый день серии 23 июля. Окно не включает текущий день (1 PRECEDING), поэтому текущий всплеск не поднимает свою же «норму». Разность без модуля: нас интересует только рост доли NULL.
Задание 3. Найдите дату изменения схемы в schema_log и первую дату, когда в habitables появилась ненулевая доля нулей в habitability. Что это говорит о причине?
Решение
WITH changes AS ( SELECT day, cols, lag(cols) OVER (ORDER BY day) AS past_cols FROM schema_log),zero_rate AS ( SELECT date_added, avg((habitability = 0)::INT) AS zr FROM habitables GROUP BY date_added)SELECT (SELECT min(day) FROM changes WHERE cols <> past_cols) AS schema_changed_on, (SELECT min(date_added) FROM zero_rate WHERE zr > 0) AS zero_rate_started_on;┌───────────────────┬──────────────────────┐│ schema_changed_on │ zero_rate_started_on ││ date │ date │├───────────────────┼──────────────────────┤│ 2024-08-05 │ 2024-08-05 │└───────────────────┴──────────────────────┘Обе даты совпадают: 5 августа. planets выше по потоку от habitables, поэтому изменение схемы там с большой вероятностью и есть причина. Это то же рассуждение, что «Объяснение 2» в книге.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем known unknowns отличаются от unknown unknowns и чем закрывают каждый вид?
- Почему простой
z-scoreс порогом триσплохо работает на данных вроде числа клиентов в день? - Детектор алертит на всё. Что будет с
precisionиrecall? А если он никогда не алертит? - Когда выбрать
F2, а когдаF0,5? Приведите пример для данных. - Почему
accuracy99,6% у детектора «всегда ОК» ничего не значит? - Как совпадение даты изменения схемы и даты роста доли нулей помогает найти причину инцидента?
Предыдущая: Глава 3. Сбор, очистка, преобразование и тесты данных. Следующая: Глава 5. Архитектура для надёжности данных.