

Data Quality Fundamentals — конспект книги
Data Quality Fundamentals: A Practitioner’s Guide to Building Trustworthy Data Pipelines — книга Barr Moses, Lior Gavish и Molly Vorwerck (O’Reilly, сентябрь 2022). Авторы работают в Monte Carlo, компании, которая создала категорию data observability. Книга учит, как сделать данные надёжными: как замечать проблемы раньше пользователей, как их чинить и как построить доверие к данным в компании. В книге 10 глав.
Это подробный пересказ на русском, а не перевод. За полным текстом идите в оригинал.
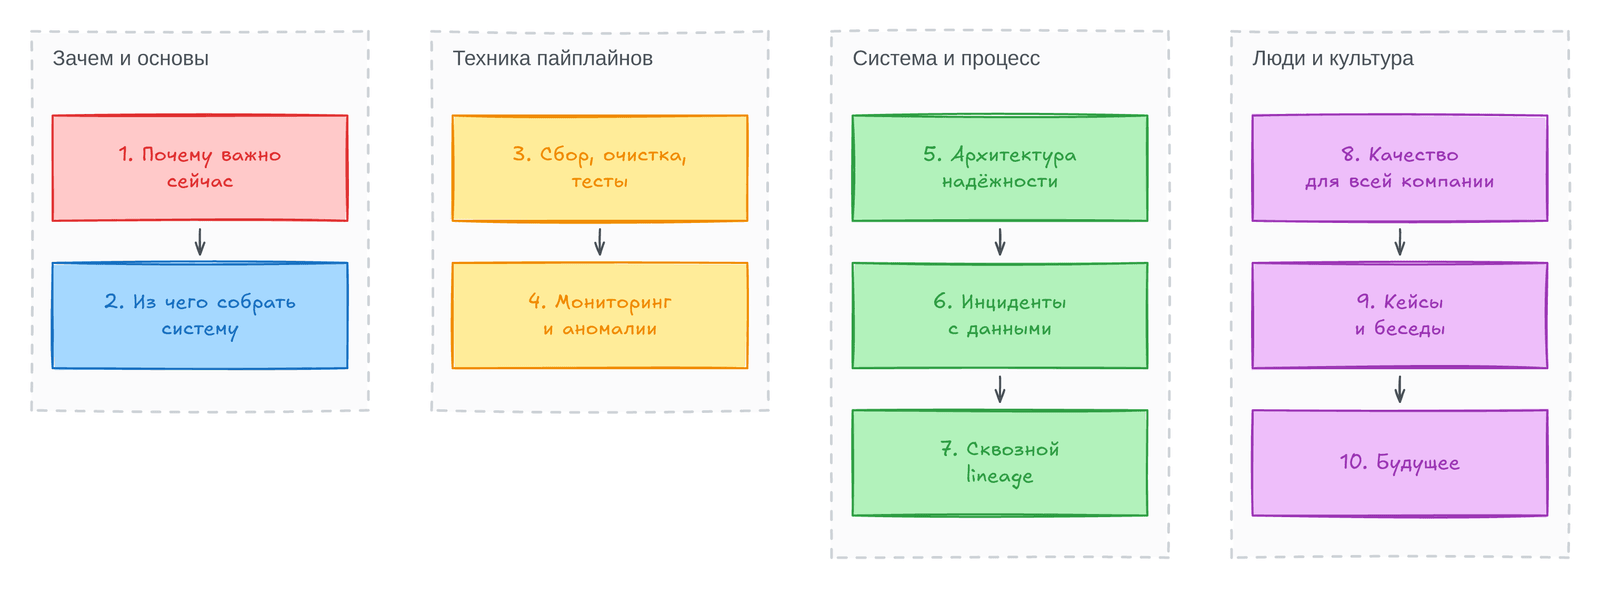
Читайте карту так: книга идёт от проблемы к людям. Сначала она объясняет, почему данные ломаются (блок 1). Потом показывает техники: тесты и мониторинг (блок 2). Дальше собирает их в систему и процесс: архитектуру, инциденты, lineage (блок 3). В конце говорит о людях, кейсах и будущем (блок 4).
О чём книга простыми словами
Заголовок раздела «О чём книга простыми словами»У многих команд хорошие пайплайны, но плохие данные. Например, инфраструктура современная, а в дашборде вдруг пустые значения. Таблица на 5 000 строк стала таблицей на 500 строк. Скрытое изменение схемы сломало отчёт директору. Авторы называют такие периоды data downtime: время, когда данные пропали, неточны или ошибочны.
Главная идея книги: к данным нужно относиться так же строго, как к продакшен-софту. Инженеры ПО давно используют DevOps и SRE: мониторинг, алерты, SLA, разбор инцидентов. Авторы переносят эти практики на данные и называют подход DataOps. Тесты ловят проблемы, которые мы ожидали, а мониторинг и data observability — неожиданные. Lineage помогает найти причину, а процесс работы с инцидентами не даёт одной и той же ошибке повториться.
Книга не только про технику. Авторы повторяют: доверие к данным строят люди и процессы. Нужны владельцы, договорённости с потребителями и поддержка руководства. Поэтому в книге много места отведено командам, ролям и кейсам компаний.
Что нужно знать заранее
Заголовок раздела «Что нужно знать заранее»- SQL. В главе 4 мониторы свежести и распределения показаны на SQL (в книге — SQLite). Начните с практики по SQL.
- Пайплайны и хранилища:
ETL,data warehouse,data lake. Если нужна основа, прочитайте конспект Fundamentals of Data Engineering. - Python. Нужен на уровне чтения кода: короткие примеры есть в нескольких главах, в том числе детектор аномалий в главе 4.
- Статистика. Нужны среднее, стандартное отклонение,
precisionиrecall. Всё нужное объясняем по ходу. - Тему качества данных кратко разбирает наша страница о Data Quality и главы 9–10 конспекта Data Engineering Design Patterns.
Зачем читать
Заголовок раздела «Зачем читать»- Одна тема, вся картина. Книга идёт от сбора данных и тестов до культуры и ролей, а другие книги разбирают качество одной главой.
- Язык для разговора с бизнесом.
SLA,SLO,SLI, цена простоя, ROI качества данных: с этим можно прийти к руководителю. - Практичные приёмы. Мониторы свежести и объёма на SQL, цепочка поиска первопричины,
circuit breakerв Airflow, метрики инцидентов. - Реальные истории. Blinkist, PagerDuty, Fox, Toast, Kolibri Games, разговор с Zhamak Dehghani о data mesh.
- Взгляд на роли. Кто отвечает за качество: дата-инженер, analytics engineer, владелец продукта данных,
incident commander.
Как устроена книга
Заголовок раздела «Как устроена книга»| Блок | Главы | О чём |
|---|---|---|
| Зачем и основы | 1–2 | Что такое data downtime, почему проблема растёт, из чего состоит платформа данных и как с неё снимать метрики качества |
| Техника пайплайнов | 3–4 | Сбор, очистка, тесты (dbt, Great Expectations, Deequ, Airflow). Мониторинг и поиск аномалий |
| Система и процесс | 5–7 | Архитектура надёжности, SLA и ROI, управление инцидентами, сквозной lineage |
| Люди и культура | 8–10 | Данные как продукт, роли и ответственность, сертификация, кейсы, data mesh, будущее |
Блоки повторяют путь команды. Сначала нужно понять, что ломается и где (главы 1–2). Потом поставить проверки на каждом шаге (глава 3) и мониторинг на случай неожиданного (глава 4). Дальше собрать это в архитектуру с обещаниями потребителям (глава 5), научиться чинить (глава 6) и видеть зависимости (глава 7). В конце нужно сделать так, чтобы качество стало делом всей компании (главы 8–10).
Главные идеи
Заголовок раздела «Главные идеи»| Идея | Где разбирается |
|---|---|
data downtime стоит денег, доверия и более 40% времени команды | Глава 1 |
| Метрики качества можно получать из метаданных и журнала запросов | Глава 2 |
| Тесты закрывают известное, но ловят лишь около 20% проблем | Глава 3 |
Мониторинг ловит unknown unknowns: свежесть, объём, распределение, схема | Глава 4 |
SLI — метрика, SLO — цель, SLA — обещание | Глава 5 |
| Цена простоя = (TTD + TTR) × цена часа простоя | Глава 5, глава 10 |
| Инцидент: обнаружить, отреагировать, найти первопричину, исправить, разобрать без поиска виноватых | Глава 6 |
| Первопричину ищут в пяти местах: lineage, код, данные, окружение, коллеги | Глава 6 |
| Lineage на уровне полей нужен автоматический и строится из разбора SQL | Глава 7 |
| Данные — это продукт: у него есть владелец, SLA и сертификация | Глава 8 |
| Data mesh — не инструмент, а организационный сдвиг | Глава 9 |
| Надёжность данных станет базовым требованием и мерой зрелости | Глава 10 |
Для кого
Заголовок раздела «Для кого»Авторы пишут для тех, кто строит и поддерживает пайплайны: дата-инженеров, аналитиков и data scientists. Предварительных требований книга не называет, но примеры предполагают базовый SQL и Python.
| Роль | Что получит |
|---|---|
| Data engineer | Мониторы, тесты, circuit breaker, процесс инцидентов, lineage |
| Analytics engineer | Тесты в dbt, SLA для моделей, сертификация данных |
| Аналитик | Понимание, откуда берутся ошибки в отчётах и как о них говорить |
| Руководитель | Цена простоя, роли, структура команды, стратегия качества |
Как читать
Заголовок раздела «Как читать»- Новичок. Читайте по порядку: главы 1, 2 и 3 дают основу, а главу 7 оставьте на второй проход.
- Analytics engineer. Читайте главы 3, 4, 5 и 8: тесты, мониторинг, SLA, сертификация.
- Data engineer. Читайте главы 3, 4, 6 и 7: проверки в пайплайне, детекторы, инциденты, lineage.
- Руководитель. Читайте главы 1, 5, 8, 9 и 10: там о стоимости проблемы, SLA, ролях и о том, когда начинать.
Книга идёт от технических глав к организационным, и главы 8–10 можно читать отдельно от остальных.
Как работать с практикой
Заголовок раздела «Как работать с практикой»Во многих главах есть практика: SQL в DuckDB и короткие примеры на Python. Они повторяют идеи главы на маленьких данных, которые мы создаём сами. Примеры книги на Snowflake, Airflow или Java мы заменили версиями, которые запускаются бесплатно и локально.
- Нужны Python 3.10+ и DuckDB CLI. Запустите
duckdbв терминале или откройте shell.duckdb.org. - На страницах стоят короткие примеры, а полные скрипты лежат в репозитории: scripts/data-quality-fundamentals-code. Запускайте так:
python3 -I scripts/data-quality-fundamentals-code/<файл>.py. - Вывод под кодом настоящий: мы запускали каждый пример. Данные создаются с фиксированным seed, поэтому результат у вас будет тем же.
Связь с другими конспектами
Заголовок раздела «Связь с другими конспектами»| Книга | Как связана |
|---|---|
| Fundamentals of Data Engineering | Даёт общий жизненный цикл данных. Эта книга углубляет одну его сторону: качество |
| Data Engineering Design Patterns | Паттерны качества и observability в коде. Эта книга даёт процесс и организацию |
| Data Pipelines with Apache Airflow | Airflow как место для circuit breaker и проверок |
Разбор по главам
Заголовок раздела «Разбор по главам»| Глава | Какой вопрос решает | Практика |
|---|---|---|
| 1. Почему качество данных важно сейчас | Что такое качество данных и data downtime, почему проблема растёт | Проверки свежести, дублей и пропусков, uptime и «пять девяток» в DuckDB |
| 2. Из чего собрать надёжную систему данных | Как устроена платформа данных и откуда брать метрики качества | Журнал запросов, метрики по часам и data downtime в DuckDB |
| 3. Сбор, очистка, преобразование и тесты данных | Как сохранить качество на каждом шаге пайплайна: batch и stream, тесты, Airflow | Type coercion, UTC, circuit breaker, тест в DuckDB |
| 4. Мониторинг и поиск аномалий | Как ловить неожиданные проблемы и мерить качество детектора | Свежесть и распределение на SQL, z-score и сезонность, precision, recall, F-score |
| 5. Архитектура для надёжности данных | Где и как строить надёжность: ingestion, пайплайн, платформа, SLA, ROI | Цена простоя, SLI и SLO в DuckDB |
| 6. Как чинить проблемы в масштабе | Как вести инцидент и находить первопричину | Сегменты для RCA, метрики инцидентов, группировка алертов |
| 7. Сквозной lineage | Как построить lineage на уровне полей | Lineage из SQL, анализ влияния, рекурсивные запросы в DuckDB |
| 8. Качество данных для всей компании | Как сделать качество делом всей компании: продукт, роли, сертификация | SLI, downtime и правило сертификации в DuckDB |
| 9. Кейсы и беседы | Как качество связано с data mesh, метаданными и когда начинать | Data mesh score, три задачи в DuckDB |
| 10. Будущее надёжных систем данных | Как обосновать вложения в качество и куда всё идёт | Расчёт стоимости труда на проблемы с данными |
Каждая страница содержит главную мысль, схемы, подробный разбор, ключевые термины, выводы для практики и вопросы для самопроверки.