

Claude AI Bible, глава 1: Машина с совестью
Главная мысль: Claude — это не кнопка, которая делает ровно то, что велели. Он ближе к начитанному коллеге со своим мнением, который иногда скажет, что идея плохая. Почти все его особенности идут от одного решения Anthropic о том, какой AI она хочет построить.
О чём глава
Заголовок раздела «О чём глава»Глава объясняет, почему Claude ведёт себя именно так, и даёт словарь для всей книги. Автор обещает не научные статьи, а знания практика, который строил на Claude реальные системы. Темы: компания Anthropic и её юридическая форма, Constitutional AI, устройство LLM, характер Claude и девять базовых терминов. Карта книги — в обзоре.
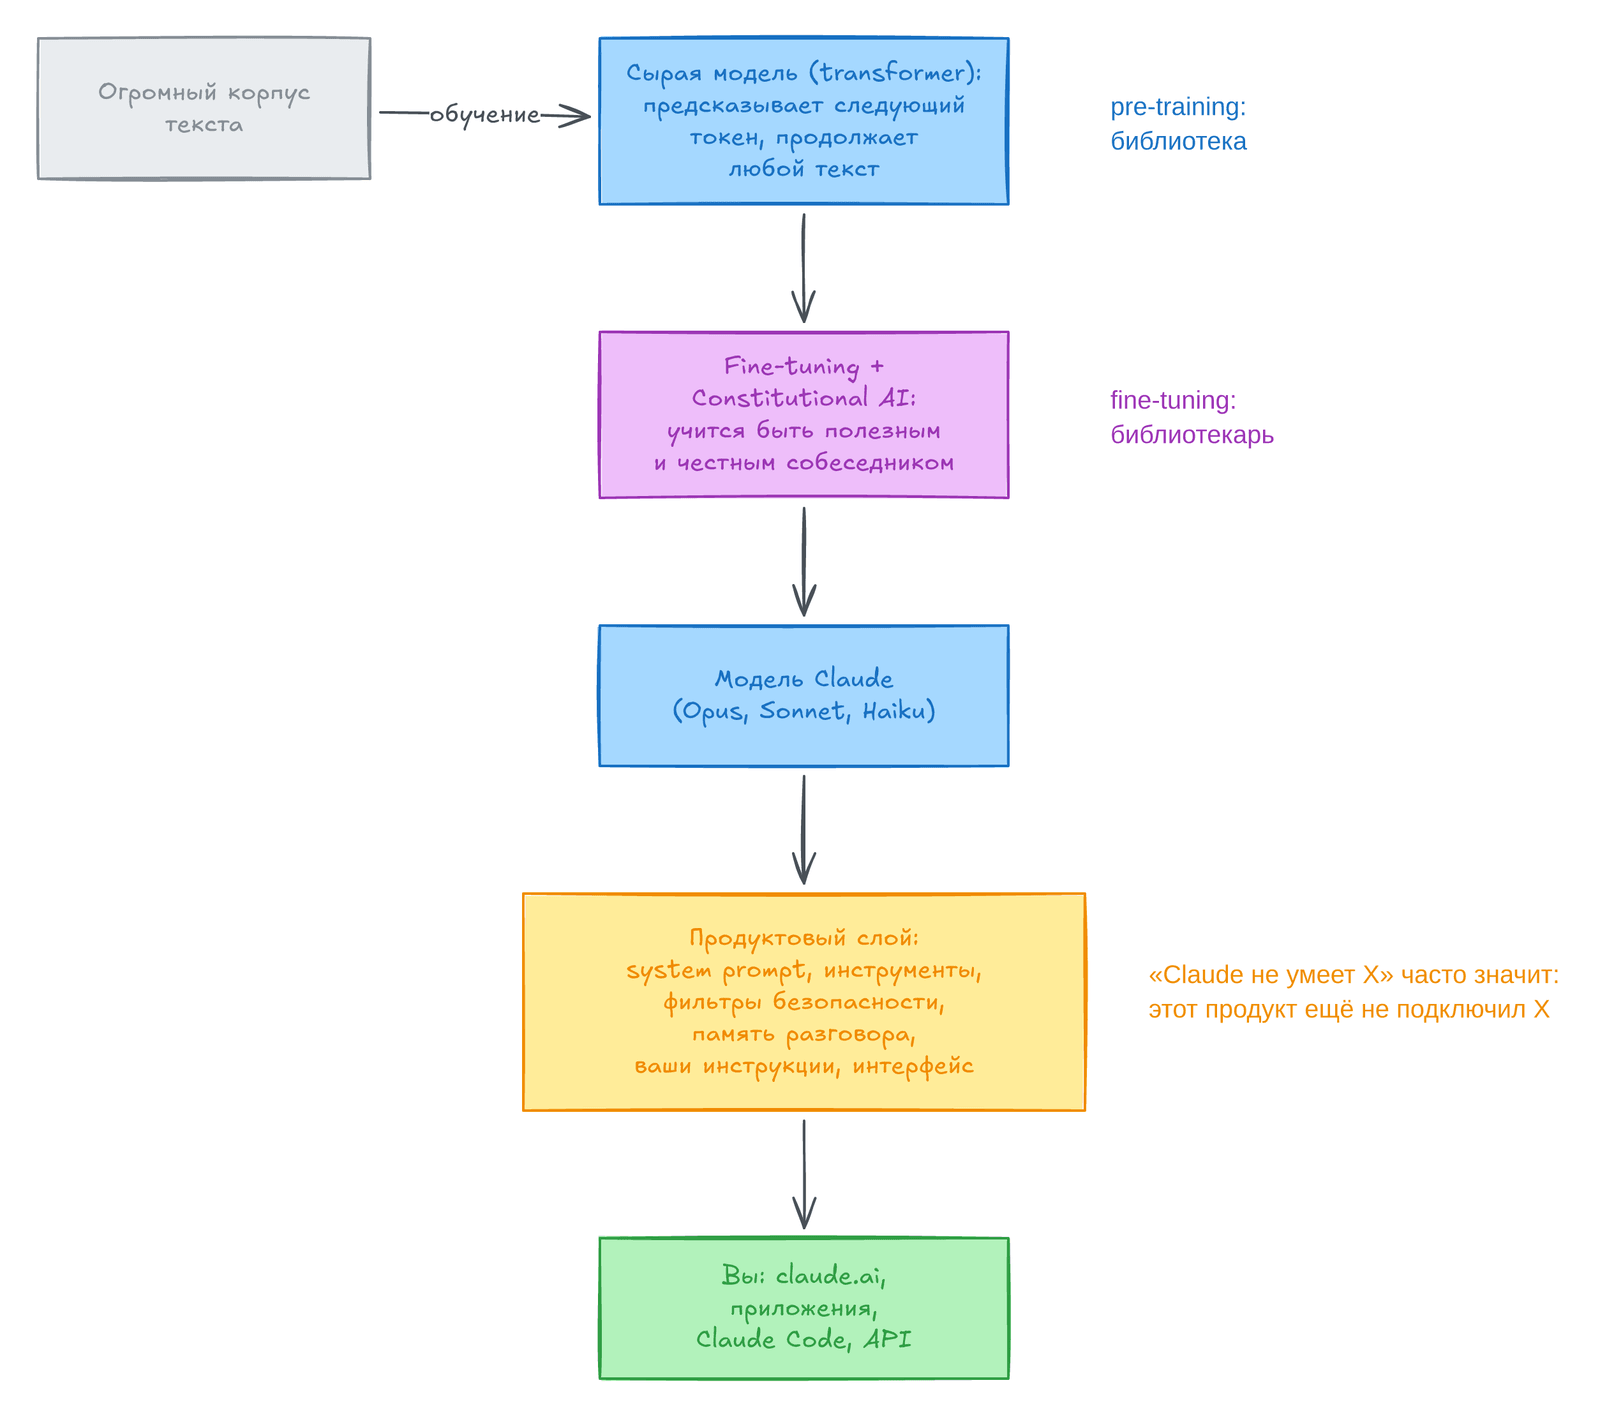
Схема читается сверху вниз: модель учится на текстах, потом её учат быть собеседником, и только поверх неё строят продукт.
Кто построил Claude и почему это важно
Заголовок раздела «Кто построил Claude и почему это важно»Anthropic основали в 2021 году исследователи из другой крупной AI-лаборатории. Компанией руководят брат и сестра: Дарио Амодеи (CEO, исследования) и Даниэла Амодеи (президент, операционная работа). По мнению автора, такое руководство делает компанию цельной, и у неё ясный тезис: мощный AI появится в любом случае, риски реальны, и безопаснее строить его самим, задавая планку ответственности.
Главное здесь — юридическая форма. Anthropic — это корпорация общественной пользы (Public Benefit Corporation). Обычная корпорация обязана максимизировать прибыль, и если совет директоров жертвует прибылью ради другой цели, акционер может подать в суд. Директора PBC обязаны учитывать заявленную миссию наравне с прибылью. Миссия Anthropic — помочь человечеству безопасно пройти переход к трансформирующему AI.
Эта структура видна в продукте. Claude отказывается помогать во вредных делах, компания публикует политики безопасности и оценивает модели по уровню риска до выпуска. И Claude скорее скажет «я не уверен», чем выдумает ответ: компания решила, что блефующий AI опаснее сомневающегося.
Совет автора: выбирая AI-поставщика, сначала прочитайте его структуру и политики безопасности, а уже потом результаты
benchmark. Структура показывает, как компания поведёт себя под давлением.Benchmarkпоказывает результат на тесте, под который модель могли подогнать.
Constitutional AI простыми словами
Заголовок раздела «Constitutional AI простыми словами»После основного обучения поведение модели настраивают люди. Раньше оценщики сравнивали тысячи пар ответов, а модель училась давать «понравившиеся» ответы. Изъян метода в том, что модель учится нравиться, а это не то же, что быть честной: льстец тоже нравится людям.
Ответ Anthropic называется Constitutional AI. Модель получает письменный свод принципов — конституцию — и частично учится сама: критикует свои ответы по этим принципам и исправляет их. Источники принципов — например, декларации о правах человека и простые формулировки ценностей: будь полезен, не вреди, будь честен, уважай собеседника, не читай мораль, не обманывай.
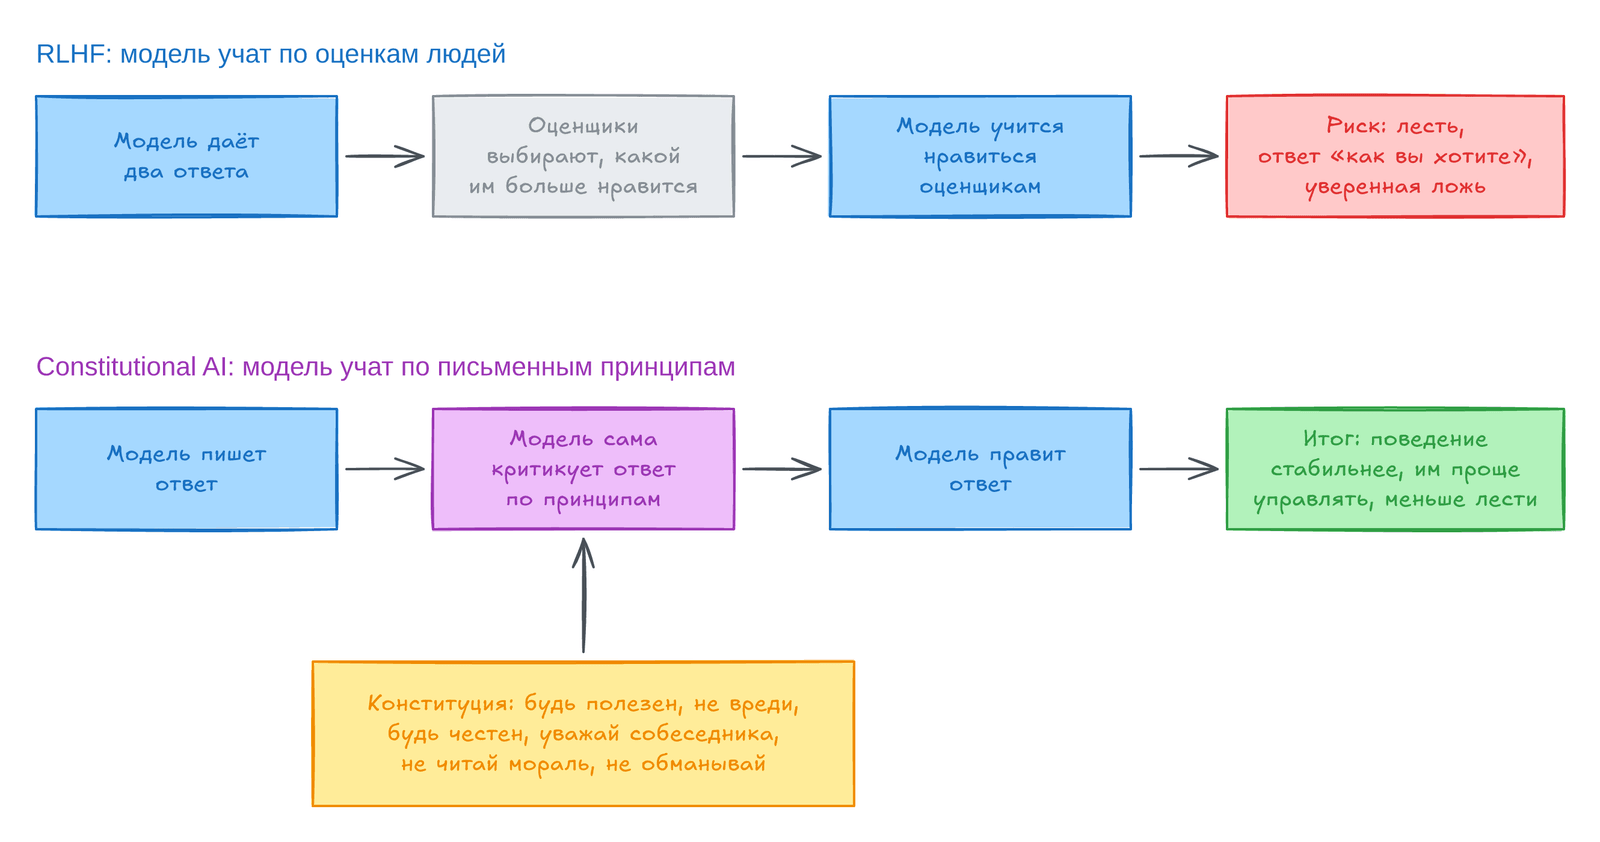
Разница между строками схемы — в источнике оценки: вкус оценщика или записанный принцип.
Автор сравнивает это с воспитанием. Можно после каждого поступка ребёнка говорить «хорошо» или «плохо» и ждать, что он угадает ваши ценности. А можно дать короткий список правил, по которому он проверяет себя заранее. Ошибки останутся, но ребёнок объяснит свой выбор, а чтобы изменить его поведение, достаточно поправить список.
Ценности Claude опираются на записанные принципы, а не на средний вкус оценщиков. Поэтому его поведение стабильнее, им проще управлять, и он реже говорит то, что вы хотите услышать. Одобрение пользователя для него — побочный эффект, а не цель. При этом конституция не делает модель безошибочной: Claude ошибается, иногда с невозмутимым видом. Но характер ошибок другой, чем у модели, обученной собирать клики.
Ловушка: отказ не значит, что Claude вас осуждает, а помощь с острой темой не значит, что границ нет. Если отказ кажется ошибкой, прямо назовите законную цель. Запрос «я медсестра и пишу памятку о симптомах передозировки» получит куда более полезный ответ, чем тот же вопрос без контекста.
Что такое AI-ассистент и LLM в 2026 году
Заголовок раздела «Что такое AI-ассистент и LLM в 2026 году»Claude — это LLM (большая языковая модель), обёрнутая в продукт. Модель — нейросеть архитектуры transformer, которую обучили на огромном объёме текста предсказывать следующий кусок текста. Она предсказывает продолжение, добавляет его к тексту и повторяет, пока не решит остановиться. Эссе, код и вежливый отказ собраны из повторения этого одного шага.
На таком масштабе сеть вынуждена усвоить, как описан мир: грамматику, факты, ход рассуждений. Она ведёт себя так, будто понимает, но не настолько надёжно, чтобы перестать проверять её ответы.
Сырая модель ещё не Claude: она похожа на очень начитанного человека, который не знает, что участвует в разговоре, и продолжит текст в любую сторону. Ассистентом её делает fine-tuning на примерах полезного диалога, и здесь же работает Constitutional AI. По словам автора, это дообучение — разница между библиотекой и библиотекарем.
Поверх модели лежит продуктовый слой. В claude.ai вы говорите не с голой моделью, а с системой. В неё входят system prompt с правилами, инструменты вроде веб-поиска и запуска кода, фильтры безопасности, память разговора, ваши инструкции и интерфейс. Поэтому жалоба «Claude не умеет X» часто значит «этот продукт ещё не подключил X».
Почему Claude ощущается иначе
Заголовок раздела «Почему Claude ощущается иначе»Тексты Claude постоянные пользователи часто узнают сразу. Автор выделяет три черты, и все они вытекают из решений выше.
| Черта | Как проявляется |
|---|---|
| Ценности без проповедей | Обсуждает сложные темы и высказывает мнение, но не читает лекций. Моралист и модель без стержня — оба провала |
| Отказ льстить | О бизнес-плане скажет и сильные стороны, и допущение, которое его потопит. Это хороший редактор, а не поддакивающий собеседник |
| Честность о неуверенности | Говорит «не уверен» или «проверьте по первоисточнику». Такому инструменту можно доверять соразмерно его уверенности |
Автор сравнивает другие чат-боты с приливом, который поднимается туда, куда укажут. Claude похож на реку: она движется в нужную сторону, но у неё своё течение, и с ним лучше работать, чем бороться.
Случай из практики: логистическая компания в Роттердаме месяц мучилась с AI-инструментом, который уверенно строил графики с нарушением обязательного отдыха водителей. Claude на той же задаче спрашивал, не выйдет ли водитель за лимит часов, и честно говорил, что не гарантирует соответствие закону. «Он признаёт, чего не знает, — сказала диспетчер. — Поэтому я ему и доверяю».
Гонка к вершине и что она даёт вам
Заголовок раздела «Гонка к вершине и что она даёт вам»Anthropic говорит о «гонке к вершине» (race to the top): если лаборатория с упором на безопасность делает отличные модели, конкуренты вынуждены догонять её и по качеству, и по ответственности. Обратный путь — гонка ко дну, где ради скорости экономят на безопасности.
Для пользователя польза конкретная. Модель реже уверенно галлюцинирует там, где ошибка дорога. Политики о данных и вреде опубликованы и стабильны, а это важно, когда compliance просит обосновать выбор. В продукте нет рекламы, и он не продаёт ваши данные. Но это преимущество, а не гарантия: важные результаты всё равно проверяют, в серьёзных решениях сохраняют участие человека (human-in-the-loop).
Задание: возьмите реальное решение с заметным риском. Попросите Claude не советовать, а спорить с вашим выбором и оценить свою уверенность в контраргументе. Смотрите, спорит ли он честно и говорит ли, где кончается его уверенность.
Продукт — не модель, и версии меняются
Заголовок раздела «Продукт — не модель, и версии меняются»Anthropic выпускает семейство продуктов на одних и тех же моделях. Поэтому «Claude не может этого» обычно значит «этот продукт не может, а другой может».
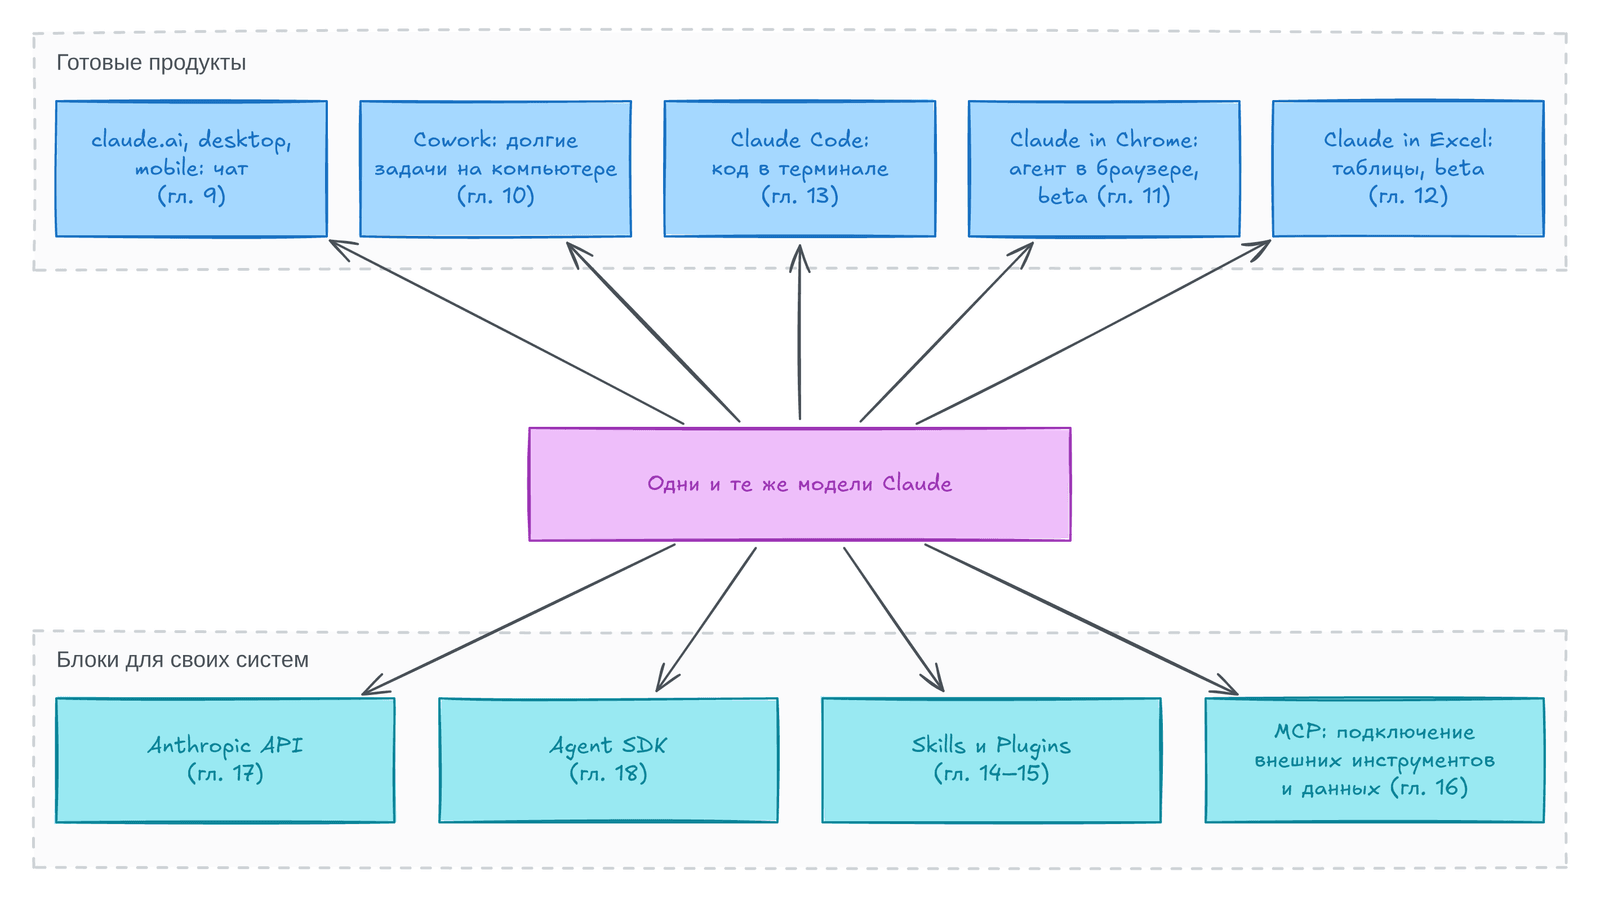
Сверху на схеме готовые продукты. Cowork пока в статусе research preview, Claude in Chrome и Claude in Excel — в beta, а Claude Code ведёт agentic разработку в терминале. Снизу блоки для своих систем, и среди них MCP — стандарт подключения внешних инструментов и данных.
Всё это быстро меняется. Книга 2026 года — снимок, верный в общей форме и ненадёжный в мелочах. Поэтому автор советует брать из книги концепции, а цены, лимиты и функции сверять с официальной документацией.
Словарь
Заголовок раздела «Словарь»Автор выделяет девять терминов, без которых не понять остальную книгу.
| Термин | Что значит |
|---|---|
| токен | Единица текста для модели: короткое слово или часть слова, примерно ¾ английского слова. По токенам считают цену API и лимиты |
context window | Сколько токенов модель держит за раз, вместе с её ответом. У Claude порядка 200 000. При переполнении старое забывается |
| параметр | Число внутри модели, его подбирают при обучении. Их миллиарды, но их число — грубый показатель возможностей, как лошадиные силы в рекламе машины |
| галлюцинация | Уверенный, но ложный ответ: выдуманная ссылка или цифра. Умысла нет, так ошибаются все модели |
fine-tuning | Дообучение на небольшом целевом наборе: так из предсказателя текста делают ассистента |
RLHF | Обучение на оценках людей. Работает, но рискует научить лести |
inference | Работа обученной модели при ответе. Обучение строит двигатель, inference — езда |
| мультимодальный | Понимает не только текст, но и картинки: скриншоты, графики |
| агент | Получает цель, планирует шаги, вызывает инструменты, смотрит на результат и повторяет. Чат-бот объясняет дорогу, агенту отдают ключи |
От галлюцинаций автор советует защищаться устройством процесса: ошибка не должна дойти до места, где навредит. А «совесть» модели, по его словам, и делает разумным отдать агенту ключи.
Итоги главы
Заголовок раздела «Итоги главы»- Anthropic — корпорация общественной пользы, и эта форма объясняет почти все особенности Claude.
Constitutional AIучит модель по письменным принципам, поэтому Claude стабилен, управляем и не льстит.- Claude — это
LLMнаtransformer, которая предсказывает текст по одному токену. - Модель и продукт — разные вещи: продуктовый слой добавляет инструменты, фильтры и память.
- Claude отличают ценности без проповедей, отказ льстить и честность о неуверенности.
- Гонка к вершине не заменяет проверку результатов и участие человека.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Public Benefit Corporation | Директора обязаны учитывать миссию наравне с прибылью |
Constitutional AI | Модель критикует и правит свои ответы по письменной конституции |
| продуктовый слой | Всё вокруг модели: system prompt, инструменты, фильтры, память, интерфейс |
| гонка к вершине | Качество вместе с безопасностью тянет вверх всю отрасль |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Выбирая LLM для
pipeline, читайте политики поставщика о данных, а не толькоbenchmark. - Если Claude отказал в законной задаче, например в разборе логов с персональными данными, назовите цель прямо.
- Если чат не видит вашу базу, возможно, нужен Claude Code, API или
MCP server. - Ответ модели перед загрузкой в хранилище должен проходить те же проверки, что и любые входные данные.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему форма Public Benefit Corporation влияет на поведение Claude?
- Чем
Constitutional AIотличается отRLHF? - Почему сырая модель после
pre-trainingещё не ассистент? - Когда жалоба «Claude не умеет X» говорит о продукте, а не о модели?
- Почему готовность сказать «не уверен» повышает доверие к модели?
Предыдущая: Обзор книги. Следующая: Семейство моделей Opus, Sonnet и Haiku.