

Redefining Data Engineering with AI, глава 1: Инжиниринг данных в компании в эпоху AI
Главная мысль: инжиниринг данных — это не служба поддержки для аналитиков, а основа, без которой AI в компании так и остаётся экспериментом. AI уже берёт на себя рутину: шаблонный SQL, заготовки тестов, документацию. Но он же порождает AI slop — правдоподобный, но неверный по смыслу код. Поэтому главной работой дата-инженера становится проверка, data governance и знание бизнеса.
О чём глава
Заголовок раздела «О чём глава»Это первая глава книги. Она отвечает на вопрос: зачем компании инжиниринг данных и data governance и что меняется, когда в работу приходит AI. Общий план книги — на странице конспекта.
- Цифровые компании и почему код и данные одинаково важны.
- Что делает инжиниринг данных и почему данные — это продукт.
Data governance: что это, зачем и сколько приносит.- Как инжиниринг данных влияет на data science и AI.
- Что AI упрощает и что остаётся сложным: проблема
AI slop. - Контроль со стороны человека и шаги внедрения AI.
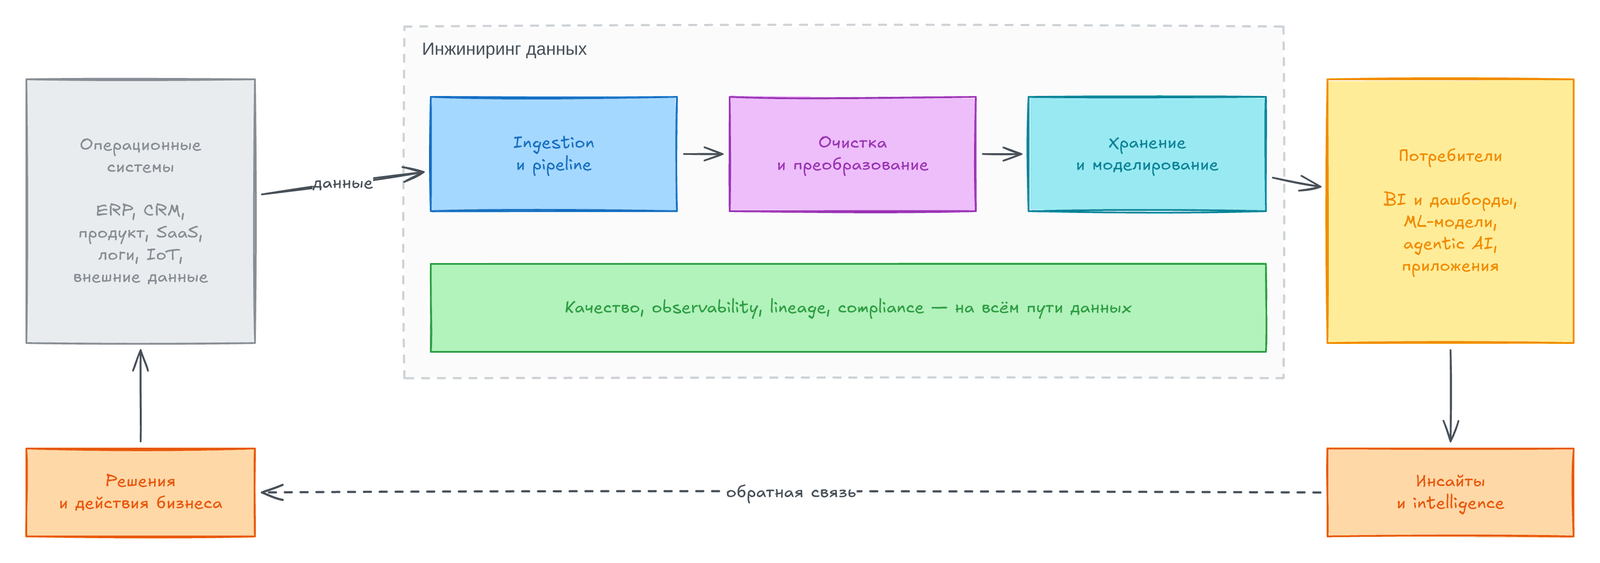
Схему читают слева направо: данные идут из рабочих систем к потребителям. Нижняя стрелка — обратный путь: выводы меняют решения бизнеса, а значит, и сами системы.
Цифровые компании и смена лидеров
Заголовок раздела «Цифровые компании и смена лидеров»Авторы начинают с того, как быстро меняются лидеры рынка. По данным Harvard Business Review, с 1955 года до начала 1990-х из Fortune 500 за каждое десятилетие выпадало больше половины компаний, а к 2000-м — почти 80%. Только 49 компаний были в каждом списке больше 70 лет. Из состава 1955 года к 2019 году осталось 10%, и среди них IBM.
Одну из причин авторы видят в подъёме «цифровых» компаний после 1995 года. Их три вида:
| Вид | Кто это | Примеры |
|---|---|---|
digital disruptors | Вынесли компьютеры и интернет из лабораторий в обычную жизнь | Apple, Microsoft, HP, Xerox, IBM |
digital natives | Родились в цифровую эпоху, и технология с первого дня определяла их бизнес | Yahoo, Amazon, Google |
digital evolutionaries | Начинали без компьютеров, но шаг за шагом перестроились вокруг технологий | Walmart, Disney, Nike |
Под компанией (enterprise) в книге понимают любую крупную организацию, где много команд зависят друг от друга ради общей цели.
Код — это «как», данные — это «что»
Заголовок раздела «Код — это «как», данные — это «что»»Почти любой код делает одно из трёх: создаёт данные, читает их или преобразует. Поэтому польза программы зависит и от логики, и от устройства данных. Авторы поясняют это через объектно-ориентированное программирование. Данные — это состояние объекта, например balance у класса BankAccount. Код — это допустимые операции над ним: deposit() и withdraw(). Иначе говоря, данные отвечают на вопрос «что», а код — на вопрос «как».
Писать код и не думать, как данные будут двигаться между системами, — всё равно что строить болид «Формулы-1» без топливной системы и выхлопа, предупреждают авторы.
Что такое инжиниринг данных
Заголовок раздела «Что такое инжиниринг данных»По определению авторов, инжиниринг данных (data engineering) — это функция компании, которая строит, эксплуатирует и контролирует инфраструктуру и процессы. Вместе эти части превращают сырые побочные данные рабочих систем в надёжные data product. Авторы спорят с мифом, что всё это нужно только для аналитики и ML. Для них инжиниринг данных — часть разработки ПО: систему проектируют сразу как код и данные вместе, и ни одна часть не может быть «на потом».
Место в архитектуре компании
Заголовок раздела «Место в архитектуре компании»Инжиниринг данных стоит между рабочими системами (ERP, CRM, SaaS, логи, датчики IoT) и потребителями: BI, прогнозными моделями, agentic AI, персонализацией. По этому мосту в одну сторону идут данные, а в обратную — выводы и прогнозы. Так возникает обратная связь (feedback loop) между системами и ценностью, которую они создают.
Основные функции
Заголовок раздела «Основные функции»У дата-инженеров четыре основные функции.
Ingestion и pipeline. Автоматические pipeline забирают данные из приложений, SaaS, журналов событий, датчиков и внешних источников. Затем они кладут их в data lake, хранилище данных (data warehouse) или lakehouse. Pipeline должен выдерживать изменения схемы, скачки задержки, сбои и непредсказуемый объём, поэтому это не разовая постройка, а постоянная работа.
Очистка и преобразование. В сырых данных есть дубли, пропуски и противоречия. Дата-инженеры убирают их, приводят типы, применяют бизнес-логику и обогащают данные, чтобы потребители могли на них опереться.
Архитектура хранения и моделирование данных. Решения принимают на трёх уровнях:
| Уровень | Примеры решений |
|---|---|
| Физическое хранение | Parquet и ORC против Avro и CSV; Snappy или ZSTD; Delta Lake или Iceberg; S3 или MinIO |
| Логическая модель | «Звезда», «снежинка», semantic layer, ER-модели |
| Организация данных | Партиции, бакеты, индексы |
Ошибки здесь накапливаются: неудачное сжатие ведёт к медленным запросам, дорогим вычислениям и задержке бизнес-результата.
Качество и observability. Сюда входят проверки качества данных, observability с SLA на время прихода данных, lineage с каталогом данных, а также compliance и аудит. Эта функция превращает данные из обузы, которую нельзя использовать без долгой проверки, в актив с проверяемым качеством.
Почему это важно
Заголовок раздела «Почему это важно»Без такой дисциплины копятся пять рисков. Качество падает: данные идут без проверок. Доверие пропадает: команды перепроверяют всё вручную или не опираются на данные вовсе. Рост ломает процессы: процессы без документации не выдерживают роста объёма. Растут риски compliance: неотслеженные потоки не проходят аудит. Появляются silo: без общих data product команды держат свои копии данных и свою инфраструктуру.
Продуктовый подход
Заголовок раздела «Продуктовый подход»Ключевая идея — вести данные как продукт. У таблиц, data lake и semantic layer есть пользователи, обязательства по сервису, документация, версии и обратная связь. Цель меняется с «перенести данные из A в B» на «дать надёжные data product для решений». Поэтому команде важны не только uptime и скорость, но и data contract, которые не ломаются, и аккуратные изменения схемы. Авторы настаивают: это не вспомогательная служба, а стратегическая способность компании.
Таблица 1-1 книги показывает, что инжиниринг данных добавляет к соседним практикам. Вот наша версия:
| Практика | Что добавляет инжиниринг данных |
|---|---|
DevOps (разработка ПО) | Моделирование транзакций, observability рабочих систем, обмен сообщениями |
DataOps (аналитика) | Аналитические модели, потоковые и пакетные pipeline, преобразования, data governance |
MLOps (модели) | Feature engineering, данные для pre-training и ML |
Данные, которые никто не использует, вредят бизнесу, предупреждают авторы: за хранение и обработку компания платит, а решений на их основе не принимает.
Что такое data governance
Заголовок раздела «Что такое data governance»Здесь авторы снова идут от основ. Самая старая форма управления — государство, и у него три ветви власти. Законодательная принимает правила, исполнительная следит за их выполнением, а судебная решает, было ли нарушение и что за ним следует. Те же три функции работают в любой области: в технологиях, финансах, AI и данных. Data governance — это способы выполнять их для данных компании.
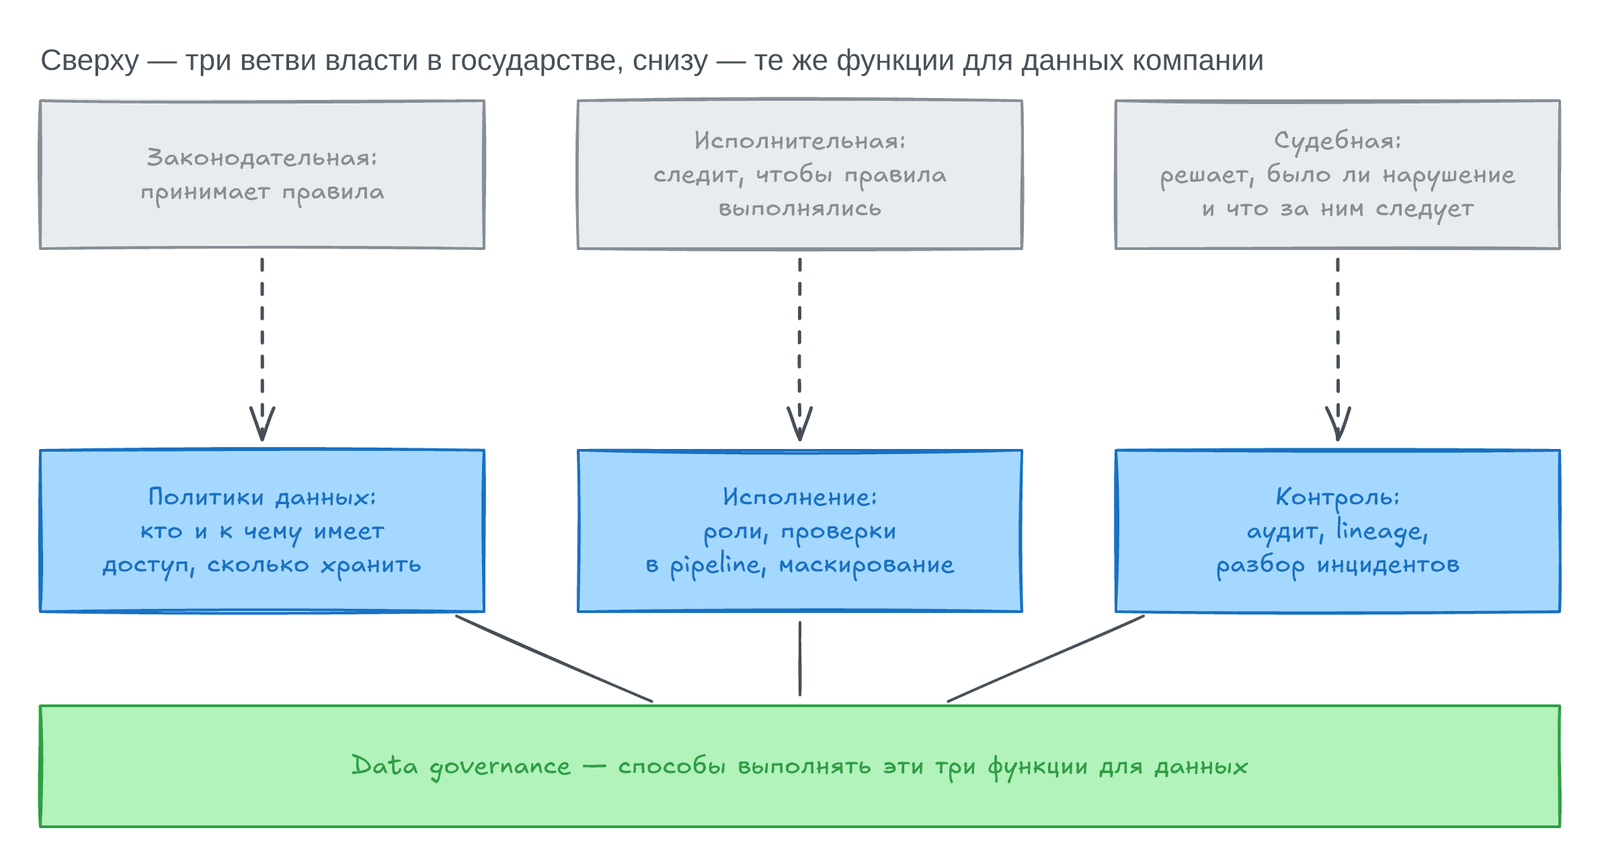
Каждая ветвь власти сверху соответствует функции data governance снизу. Авторы признают, что модель упрощённая: реальные системы правил сложнее и зависят от среды. Но как отправная точка она полезна.
Шахматы compliance: зачем governance компании
Заголовок раздела «Шахматы compliance: зачем governance компании»Международная компания выполняет разные и порой противоречивые законы. Это GDPR (штраф до €20 млн или 4% годовой выручки), китайский PIPL с жёстким контролем данных внутри страны и калифорнийский CCPA. По словам авторов, data governance снижает затраты на compliance на 30–40%.
Пример — фармкомпания в ЕС, США и Китае. Ей одновременно нужны согласия по GDPR, журналы аудита по правилам FDA и хранение данных в Китае. Без общей инфраструктуры под каждый закон строят своё решение, и архитектура рассыпается. Зрелый data governance делает из требований шаблоны: согласие становится data contract, compliance — шагом pipeline, а хранение в стране — правилом маршрутизации. Так компания выходит на новые рынки без перестройки платформы.
Ценность: меньше затрат и быстрее рост
Заголовок раздела «Ценность: меньше затрат и быстрее рост»Без data governance сбои предсказуемы. Финансы и продажи считают выручку по-разному, и в отчёт для руководства попадает то число, которое выглядит лучше. Схема источника меняется, ETL работает дальше, а модели строят на тихо испорченных данных. Временные права забывают отозвать, и, по данным авторов, 65% утечек связаны со слабым data governance: защита периметра не мешает тем, у кого уже есть доступ.
Зрелый data governance ещё и ускоряет работу. Аналитики тратят 60–80% времени на поиск и проверку данных, а каталог с владельцами, метрики качества и lineage сокращают это с дней до часов. Авторы приводят оценку: аналитика работает на 33% быстрее. Для AI это вопрос доказательств. Когда регулятор спрашивает, на каких данных обучена модель, ответ дают lineage и записи о согласиях. Такие компании, пишут авторы, не обязательно соблюдают закон лучше, но могут это доказать. Польза есть и в отраслях: банку проще считать риски, больнице — доверять данным пациентов, фармацевтике — быстрее получать одобрение лекарств.
Сколько это приносит: ROI
Заголовок раздела «Сколько это приносит: ROI»Авторы называют три источника выгоды. Первый — предотвращённые затраты: плохие данные стоят компании в среднем $12,9 млн в год, а с учётом потерянного времени и неверных решений — до 30% выручки. Второй — дешёвый compliance: банки снизили ИТ-затраты на него на 30%, а штрафы велики (HIPAA — свыше $100 млн, CCPA — $2 500–7 500 за нарушение). При автоматизации правил ошибок в данных становится на 20–40% меньше. Третий — рост выручки за счёт новых продуктов и AI на надёжных данных.
ROI обычно меряют четырьмя метриками: качество данных, сэкономленное время, число замечаний аудита и широта использования данных в командах.
Как инжиниринг данных влияет на data science и AI
Заголовок раздела «Как инжиниринг данных влияет на data science и AI»По мнению авторов, именно инжиниринг данных решает, останется AI экспериментом или станет надёжной системой для всей компании.
От экспериментов к надёжной работе
Заголовок раздела «От экспериментов к надёжной работе»Путь от модели в Jupyter до прода обычно недооценивают. Без порядка в данных data scientists ищут данные, чинят pipeline и повторяют чужие преобразования, а на модели времени не остаётся. Продуманные pipeline дают стабильные data product и признаки. Поэтому модели строятся быстрее, результат легче повторить, а вывести в прод проще. Для AI и агентов дата-инженеры отвечают за feature store, потоки событий и хранилища истории.
Качество данных прямо влияет на точность и устойчивость модели, даже если алгоритм тот же. Валидация, lineage и observability защищают от drift данных — постепенного падения их качества, при котором модель ошибается всё чаще, но внешне работает нормально. Авторы подчёркивают, что такой тихий сбой опаснее явной ошибки.
Governance и безопасность на уровне AI
Заголовок раздела «Governance и безопасность на уровне AI»Агент, который сам выполняет действия, «видит» мир через данные, которые готовят дата-инженеры. Те же команды строят guardrails: права доступа, учёт согласий и журналы аудита. Без них agentic AI становится риском для compliance и безопасности, а не преимуществом.
Эффект платформы и масштаб
Заголовок раздела «Эффект платформы и масштаб»Хорошая платформа даёт сетевой эффект: новая AI-задача берёт готовые наборы данных и признаки вместе с документацией и проверками.
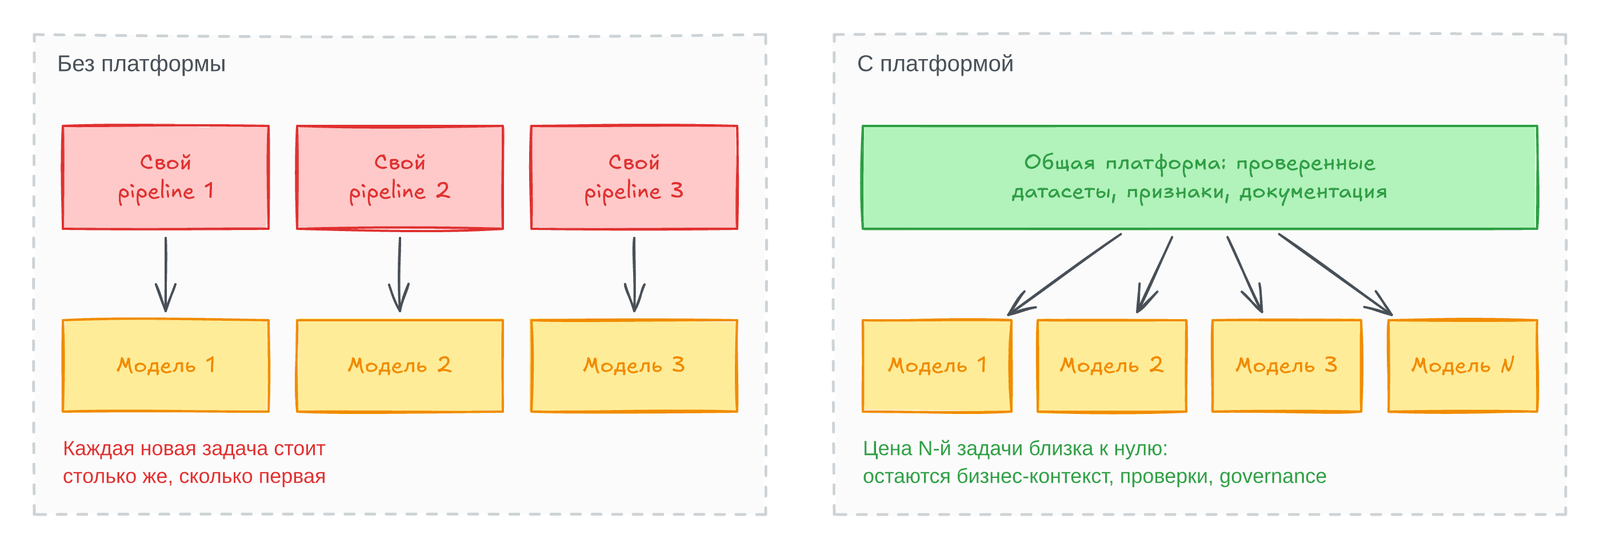
Слева вторая задача удваивает работу, а третья утраивает. Справа, по словам авторов, цена N-й задачи стремится к нулю: остаются бизнес-контекст, проверки и data governance. Так компания растёт от одной модели в проде до сотен без такого же роста штата.
Бизнес-логика внутри data products
Заголовок раздела «Бизнес-логика внутри data products»Дата-инженеры стоят между источниками и потребителями, поэтому могут записать смысл бизнеса прямо в слой данных. Речь об эталонных определениях («кто такой клиент?»), стандартных метриках и data contract. Если ими управляют как data product, а не как таблицами отделов, AI становится предсказуемее и лучше совпадает с тем, как компания мерит успех.
Авторы называют три стратегических вопроса. Первый — устройство команд: центральная платформа плюс дата-инженеры в доменах. Второй — границы роли (scope creep): остаться «сантехниками pipeline» или стать владельцами data product, метрик и SLA вместе с бизнесом. Третий — build vs buy: платформу собирают из облачных сервисов, а свои силы оставляют для доменной логики и data governance.
AI-перемены
Заголовок раздела «AI-перемены»Генеративный AI упрощает несложный SQL и шаблонный ETL. Зато растёт вес другой работы: понимать бизнес, задавать эталонные наборы данных, метрики и data contract, управлять доступом и приватностью, строить гибридную архитектуру из пакетной и потоковой обработки.
Что становится проще: автоматизация рутины
Заголовок раздела «Что становится проще: автоматизация рутины»Граница между разработкой ПО и инжинирингом данных размывается. Авторы перечисляют, что AI уже умеет:
| Область | Что делает AI |
|---|---|
| Код | Пишет SQL по описанию и шаблонный код dbt, Airflow и Spark за минуты; переводит между диалектами и языками; делает заготовки тестов и документацию |
| Качество | Ищет drift и выбросы, предлагает правила валидации, объясняет падения pipeline |
| Скорость | Помогает начинающим дата-инженерам, отвечает на вопросы о наборах данных, ищет ошибки в цепочке преобразований |
| Бизнес-пользователи | Self-service-аналитика, поиск по каталогу на обычном языке, статус задач в чате |
| Эксплуатация | Ускоряет SQL, предлагает партиции, советует размер ресурсов и архивацию |
Что остаётся сложным: проблема AI slop
Заголовок раздела «Что остаётся сложным: проблема AI slop»Авторы настаивают: human-in-the-loop остаётся обязательным. AI slop — это массовый результат AI, где скорость и объём важнее ясности и контекста. SQL выполняется, но считает не по той логике, а схема ломает data contract. Тесты проверяют только happy path, а документация уверенно описывает неверное поведение. По отдельности всё выглядит приемлемо, но вместе копится смысловой долг.
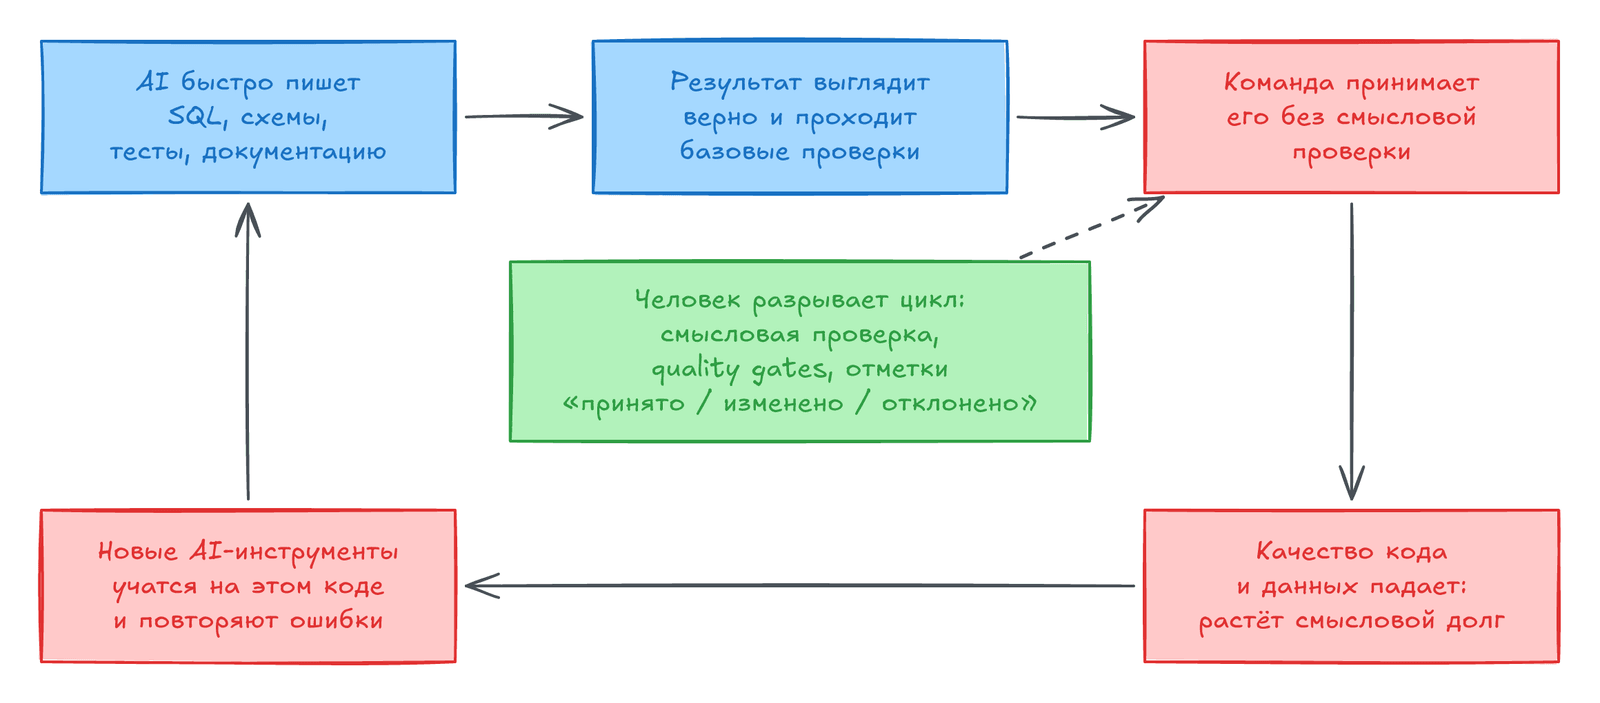
Цикл замыкается, когда команда раз за разом выбирает скорость: качество кода падает, а новые AI-инструменты учатся на нём. Зелёный блок показывает, где человек разрывает цикл.
Чистить AI slop трудно по четырём причинам. Ошибку трудно обнаружить: она проходит ревью и всплывает позже. Она распространяется из базового слоя в BI, признаки ML, reverse ETL и API. Приходится восстанавливать контекст, потому что AI не записывает, почему выбрал решение. Наконец, возникает drift качества: плохие подсказки снижают уровень всей кодовой базы.
Как выглядит контроль со стороны человека
Заголовок раздела «Как выглядит контроль со стороны человека»Авторы описывают три части контроля со стороны человека:
- Смысловая проверка. Человек знает предметную область. Он ловит SQL с неверным
grainсоединения, порядком фильтров или путаницей времени события и времени обработки. Он замечает схемы, которые нарушаютdata contract, тесты без отраслевых крайних случаев (часовые пояса, правила регуляторов) иdriftдокументации. Data governance. Человек переводит правила вguardrails.AI slopмешает этому: он прячет правила в сгенерированные конфиги, поощряет формальное соблюдение без понимания причин и размывает ответственность при инциденте.- Оценка и чистка. Человек строит систему, которая находит ошибки AI и ограничивает их распространение, но сама не отнимает выигрыш в скорости.
В итоге человек пишет меньше кода, но становится главным слоем проверки. Никакая модель не знает стратегию компании, её рынок и требования регуляторов, предупреждают авторы.
Как встроить AI в работу дата-инженеров
Заголовок раздела «Как встроить AI в работу дата-инженеров»Три трудности
Заголовок раздела «Три трудности»Авторы называют три трудности. Первая — сложность данных: работа с ними из побочной задачи превратилась в отдельные роли, например разметчиков данных и инженеров качества данных. Вторая — оценка: открытые ответы моделей трудно проверять. Третья — ресурсы: большие модели требуют больше вычислений и дают большую задержку.
Практические шаги: сначала культура
Заголовок раздела «Практические шаги: сначала культура»Сложнее технических задач — культура. Авторы вспоминают фразу, которую приписывают Питеру Друкеру: культура съедает стратегию на завтрак. Дата-инженер больше не пишет весь код сам: он проверяет, что код от AI верно передаёт бизнес-логику и правила. Для этого главной работой команды становится не написание кода, а его проверка. Команда явно помечает подсказки AI как «принято», «изменено» или «отклонено». Руководители, в свою очередь, поддерживают тех, кто отклоняет «достаточно хорошие» подсказки. Без такой культуры AI лишь быстрее копит смысловой долг.
Затем авторы предлагают четыре шага:
- Начать с малого. AI пишет код и документацию для некритичных
pipeline, а люди строго проверяют. Отметки о подсказках помогают настраиватьpromptи выбирать модели. До масштабирования сравните сроки и дефекты с ручной работой. - Автоматизировать рутину в границах. AI пишет скрипты и шаги выкладки, но проверка не даёт ему менять рабочие данные, повышать права и обходить согласование. Библиотека
promptхранит стандарты компании. - Добавить
observabilityс учётом AI. Мониторинг отличает сбой источника от ошибки AI и сбоя инфраструктуры. Он же замечает странности в подсказках, которые могут говорить оdriftмодели илиprompt injection.Lineageотмечает части, сделанные AI. - Строить итерациями с
quality gate. Тесты проверяют смысл, а не только типы. Новыйpipelineсначала работает вshadow modeрядом со старым. Если решение AI требует больше N раундов правок, его пишут вручную.
Итог авторов: AI — напарник, а не замена.
Итоги главы
Заголовок раздела «Итоги главы»- Код отвечает на вопрос «как», данные — на вопрос «что», и о форме данных нужно думать так же, как о логике.
- Инжиниринг данных — мост между рабочими системами и потребителями: туда идут данные, обратно — выводы.
- Данные ведут как продукт: с пользователями,
SLA, документацией иdata contract. Data governanceповторяет три ветви власти и, по данным авторов, экономит наcompliance30–40% и ускоряет аналитику на 33%.- На зрелой платформе цена каждой следующей AI-задачи стремится к нулю.
- AI берёт на себя рутину, но порождает
AI slop, который копится как смысловой долг. - Контроль со стороны человека — это смысловая проверка,
data governance, оценка и чистка. - Внедрение AI начинается с культуры, а затем идут четыре шага с
quality gateиshadow mode.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
Data product | Набор данных с владельцем, пользователями, SLA и документацией |
Data governance | Правила, их исполнение и контроль для данных компании |
Data contract | Договор о схеме и качестве между производителем и потребителем |
| Эффект платформы | Одна платформа ускоряет все следующие задачи |
AI slop | Правдоподобный, но неверный по смыслу результат AI |
| Смысловая проверка | Проверка по правилам бизнеса, а не только по синтаксису |
Quality gate | Проверка, без которой изменение не идёт дальше |
Shadow mode | Новый pipeline работает рядом со старым, результаты сравнивают |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Отмечайте в ревью, какой код написал AI: это поможет при разборе инцидентов.
- Проверяйте SQL от AI на
grainсоединений, порядок фильтров и тип времени, а не только на то, что запрос выполнился. - Держите эталонные определения метрик в
semantic layerилиdata contract, а не в конфигах. - Новый
pipelineот AI сначала запускайте вshadow mode. - Регулярно пересматривайте права доступа: забытые временные права — частый источник утечек.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему авторы считают, что инжиниринг данных — часть разработки ПО, а не только служба для аналитики?
- Как три ветви власти помогают понять
data governance? Приведите пример каждой функции для данных. - Почему цена N-й AI-задачи на зрелой платформе стремится к нулю и что в ней всё же остаётся?
- Почему
AI slopтрудно заметить и почему он может ухудшать сами AI-инструменты? - Когда стоит отказаться от решения AI и написать код вручную?
- Зачем отмечать подсказки AI как «принято», «изменено» или «отклонено»?
Предыдущая: обзор книги. Следующая: Эволюция AI и инструменты.