

Analytics Engineering with SQL and dbt, глава 3: SQL для аналитики
Главная мысль: SQL живёт десятки лет и остаётся главным языком аналитики. Движки под ним меняются, а сам язык остаётся тем же. Глава даёт основу, без которой не работает dbt: базы данных, DDL и DML, JOIN, view, CTE и оконные функции. В конце авторы показывают SQL поверх Python-инструментов: DuckDB, Polars, FugueSQL и dask-sql.
О чём глава
Заголовок раздела «О чём глава»В главе 2 авторы спроектировали модель данных для книжного издательства. Теперь они превращают её в настоящие таблицы и учат работать с ними на SQL. Глава отвечает на вопрос: какой SQL нужен analytics engineer, чтобы потом писать модели в dbt? Темы главы:
- почему SQL так долго остаётся востребованным;
- основы баз данных: пирамида DIKW, виды баз, СУБД, четыре языка SQL;
- создание таблиц (
DDL) и работа с данными (DML):SELECT,WHERE,GROUP BY,JOIN,UPDATE,DELETE; view,CTEи оконные функции;- SQL для распределённой обработки: DuckDB, Polars, FugueSQL;
- бонус: обучение ML-модели на SQL через dask-sql.
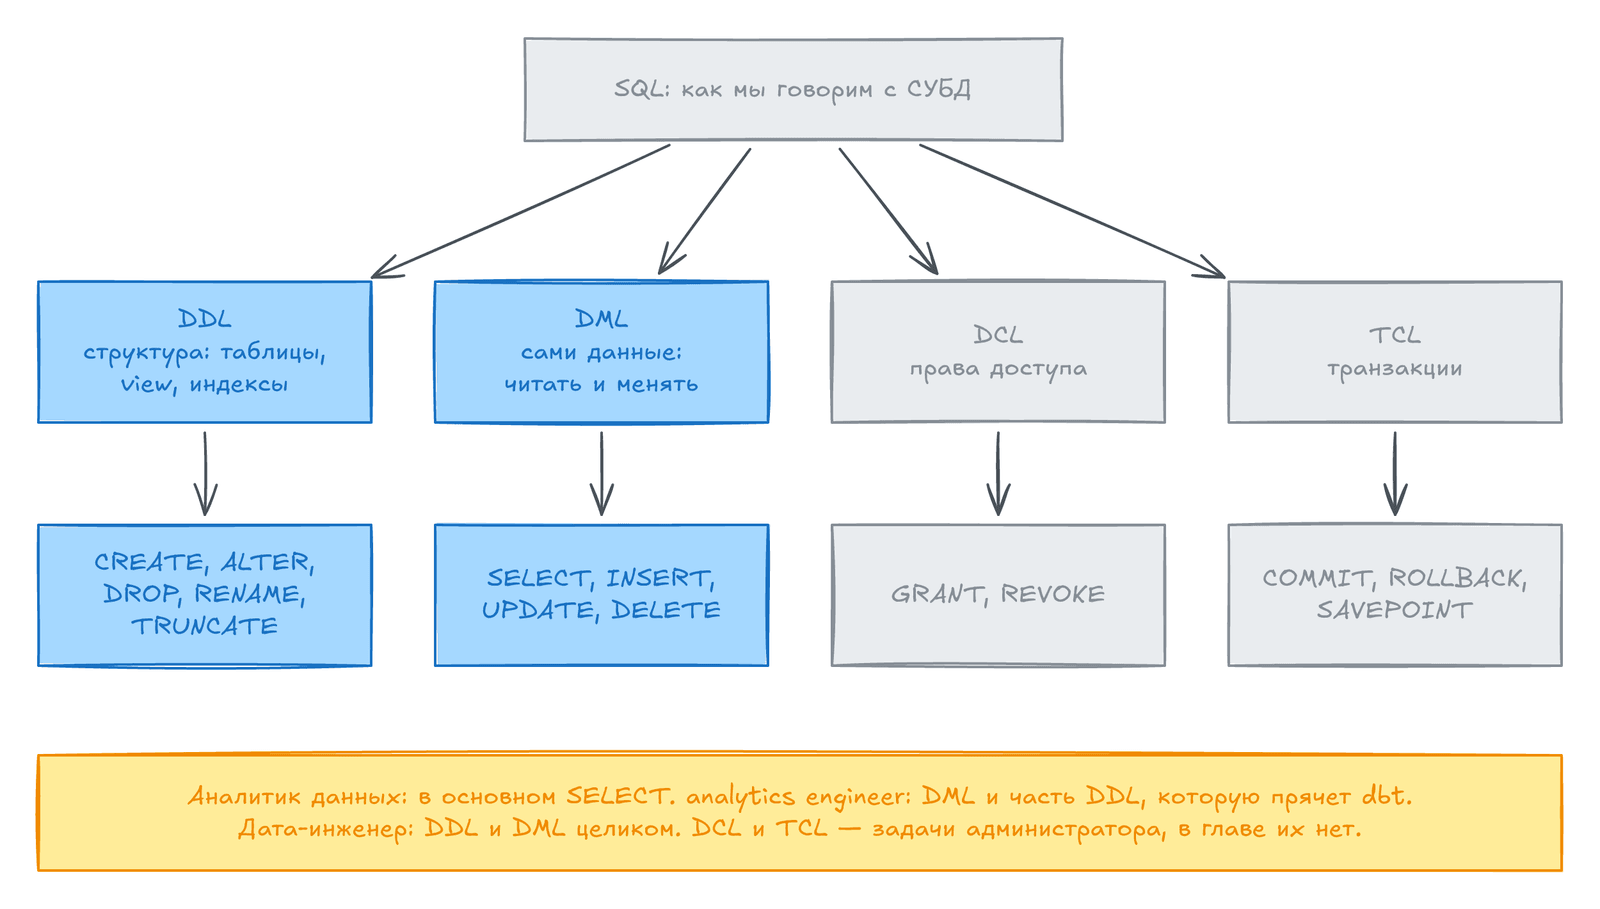
Схема показывает карту главы: синие языки разобраны подробно, а серые только названы.
Авторы начинают с того, зачем вообще нужен SQL. SQL (Structured Query Language) — это стандартный язык для работы с реляционными базами: он умеет читать, сохранять, менять и анализировать данные. Его синтаксис понятен, и сообщество приняло его как общий язык специалистов по данным. С его помощью аналитик выбирает нужную часть данных, считает сложные агрегаты и соединяет таблицы, чтобы найти скрытые закономерности.
У SQL есть ещё два преимущества. Во-первых, SQL быстро достаёт и меняет данные. Он берёт только нужные строки и столбцы, поэтому расходует меньше ресурсов. Он же умеет вставлять, менять и удалять записи, а значит, годится для очистки данных перед анализом. Во-вторых, SQL легко встраивается в Python и BI-платформы. Облачные хранилища данных (data warehouse) — Google BigQuery, Amazon Redshift, Snowflake — используют SQL как основной язык запросов.
Почему SQL держится так долго
Заголовок раздела «Почему SQL держится так долго»Авторы замечают: pipeline на SQL часто живут много лет. Запросы и хранимые процедуры до сих пор лежат в основе важных систем банков, ритейла и даже научных проектов. При этом язык всё время развивается, а новые инструменты — dbt, DuckDB и библиотека Polars — дают доступ к своим функциям именно через SQL. Авторы видят у этого несколько причин.
Читаемость. SQL позволяет писать и в императивном, и в декларативном стиле. Часть запросов похожа на команды: «достань данные пользователя», «посчитай за период». Но сильнее всего SQL в декларативном стиле: автор описывает, что он хочет получить, а не как это достать. Поэтому код понимают BI-разработчики, аналитики данных, дата-инженеры и data scientists. Код на SQL почти документирует сам себя, и это помогает работать в смешанных командах.
Новые движки под старым интерфейсом. Интерфейс SQL почти не изменился, а движки под ним сильно выросли. Классические СУБД стали быстрее. Spark и Presto научили SQL обрабатывать огромные объёмы. DuckDB выполняет быстрые параллельные аналитические запросы на одной машине.
При этом системы с SQL не одинаковы. SQL Server часто ставили под хранилище, хотя он создан для OLTP. OLTP — это транзакционная нагрузка: много мелких записей и чтений, как в интернет-магазине. Snowflake и Redshift, наоборот, — специализированные OLAP-хранилища для больших аналитических запросов и отчётов. SQL работает в системах обоих типов, поэтому один язык даёт доступ к данным и в транзакционных, и в аналитических базах.
Строгие типы данных. Опытный дата-инженер знает, как тяжело согласовать типы данных между языками и движками. SQL-движки строго следят за типами, поэтому тип столбца остаётся одним и тем же на всём пути данных. К тому же есть Apache Arrow — общий формат данных в памяти для R, Python и разных баз. Если выбрать движок с поддержкой Arrow, многие проблемы с типами исчезнут, а зависимостей станет меньше.
Совместимость с практиками разработки. Раньше большие SQL-скрипты было трудно поддерживать и менять. Новые инструменты это исправили. DuckDB не требует зависимостей и оптимизирован под аналитику, поэтому на нём удобно писать unit-тесты и быстро проверять SQL-код. CTE дробят большой запрос на небольшие части, и каждую часть можно проверить отдельно.
Новые возможности языка. Lambda-функции позволяют писать произвольные функции прямо внутри запроса. Оконные функции считают агрегаты, ранги и статистику по частям данных. Современные движки добавили полнотекстовый поиск, функции для геоданных и пользовательские функции (UDF). Всё это вместе объясняет, почему люди продолжают учить SQL и применять его каждый день.
Основы баз данных
Заголовок раздела «Основы баз данных»Базы данных хранят, упорядочивают и отдают огромные объёмы данных. Именно развитие баз данных сделало SQL главным языком для реляционных систем. Но сначала авторы предлагают понять, как связаны данные, информация и знания.
Для этого служит пирамида DIKW (Data, Information, Knowledge, Wisdom). Это концептуальная модель: она показывает, как сырые данные шаг за шагом превращаются в мудрость, на основе которой можно действовать.
| Уровень | Что это | Пример |
|---|---|---|
| Данные | Сырые факты без контекста и смысла. Кирпичики для информации | «1989», «учитель», «зелёный» |
| Информация | Данные с контекстом, которые отвечают на конкретный вопрос | «Мой учитель математики родился в 1989 году». «Светофор на перекрёстке горит зелёным» |
| Знание | Информация плюс опыт и понимание. На знании уже можно принимать решения | «Раз учитель родился в 1989 году, он взрослый». «Светофор, к которому я еду, переключается на зелёный» |
| Мудрость | Глубокое понимание: человек применяет знания и делает верные выводы | «Учителю пора думать о пенсионных накоплениях». «Свет зелёный, можно ехать» |
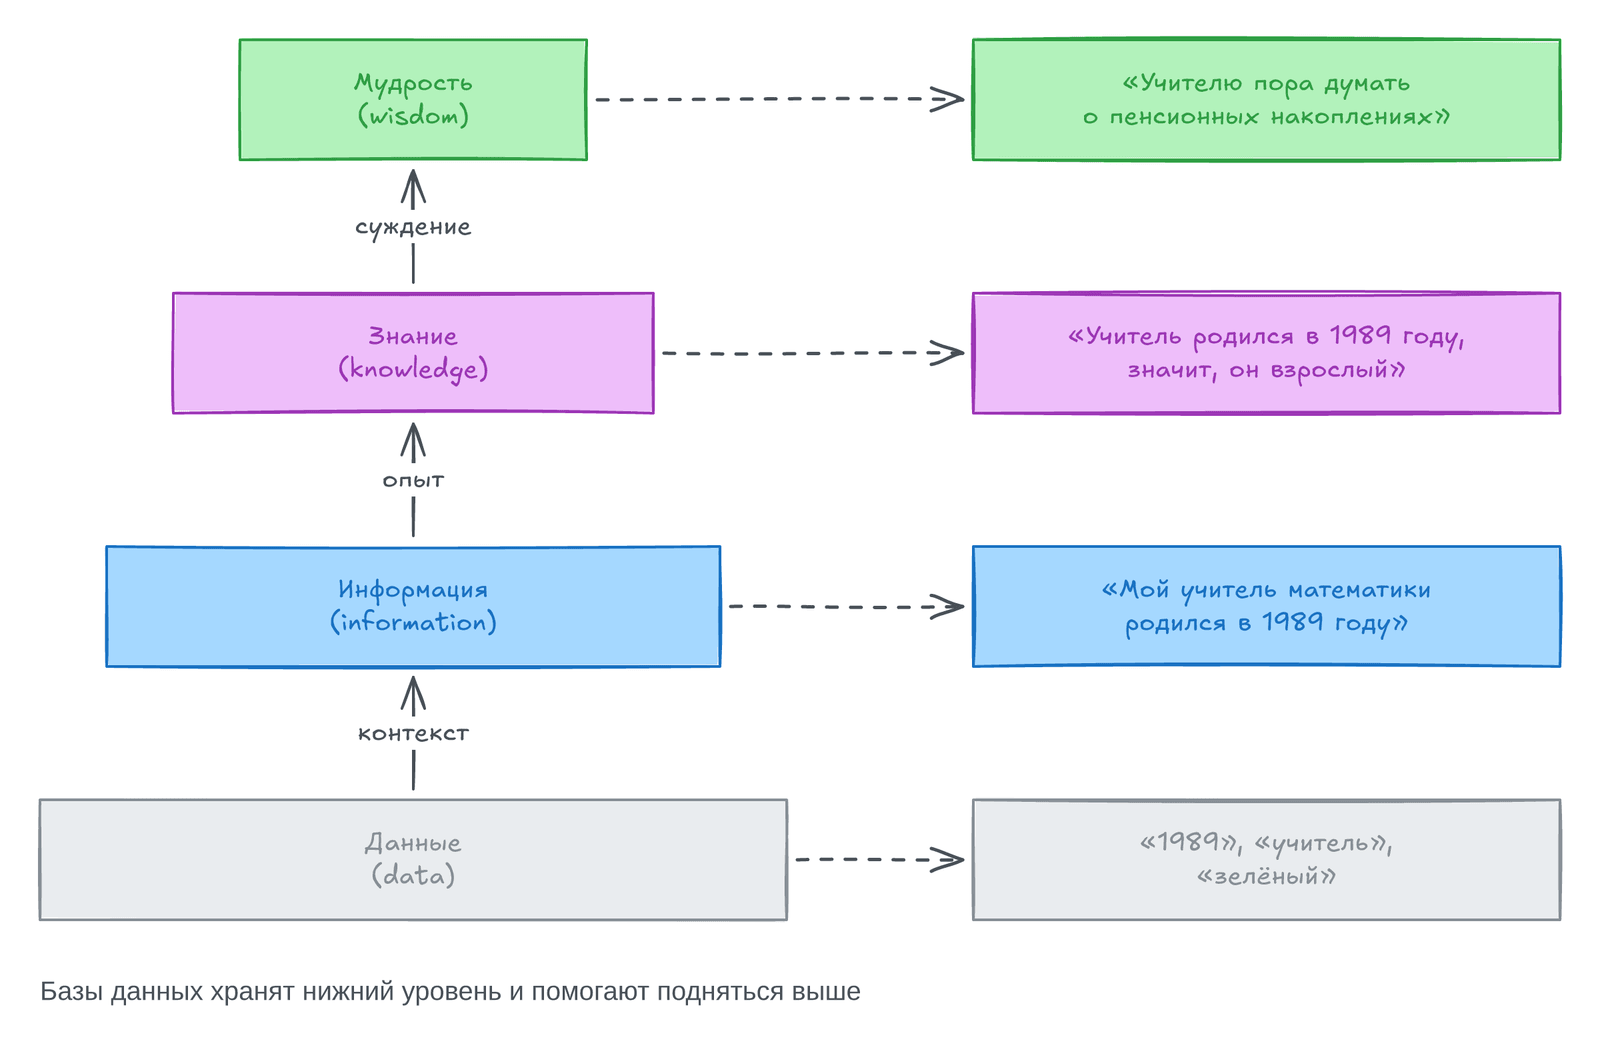
Читайте схему снизу вверх: каждый уровень добавляет к предыдущему что-то новое: контекст, опыт или суждение (это подписи на стрелках). База данных хранит нижний уровень пирамиды. Без неё бизнес не превратит данные в знания и не примет обоснованных решений.
Виды баз данных
Заголовок раздела «Виды баз данных»Авторы делят базы данных на две большие категории.
Реляционные базы. Это самая распространённая категория. Данные лежат в таблицах из строк и столбцов, связи между таблицами задают ключи, а запросы пишут на SQL. Реляционные базы гарантируют целостность данных и надёжность транзакций. Они поддерживают свойства ACID — атомарность, согласованность, изоляцию и долговечность. Проще говоря, транзакция либо проходит целиком, либо не проходит вовсе, и база восстанавливается после сбоя.
Нереляционные базы, или NoSQL (not only SQL). Они появились как ответ на большие объёмы неструктурированных и полуструктурированных данных. У них нет жёсткой схемы. Данные хранятся как пары ключ-значение, документы, широкие столбцы (wide-column) или графы. Такие базы ставят на первое место скорость, горизонтальное масштабирование и гибкость схемы. Они хорошо подходят для аналитики в реальном времени, неструктурированных данных и IoT. Дальше в главе речь идёт только о реляционных базах, потому что цель главы — основы SQL.
Базу данных можно представить как часть всех данных в мире: организация сама её строит и наполняет данными, которые нужны для её задач. Базы стоят в центре почти любого привычного дела: бронирования отеля или билета на самолёт, покупки телефона на маркетплейсе, входа в соцсеть, визита к врачу.
В реляционной базе таблица описывает сущность нашего мира: студента в университете или книгу в библиотеке. Столбец описывает атрибут сущности: у студента есть имя и адрес, у книги — название и ISBN. Строка — это сами данные: конкретный студент или конкретная книга.
Связи между таблицами база поддерживает с помощью ключей: первичных и внешних. Эти механизмы следят, чтобы связанные таблицы не противоречили друг другу. В книге пример — университет, где студент записывается на несколько курсов, а на курс записано много студентов. Такую связь «многие ко многим» мы построим ниже на книгах и категориях.
Система управления базами данных
Заголовок раздела «Система управления базами данных»СУБД (DBMS, Database Management System) — это программа, которая создаёт базу, управляет ею и даёт с ней работать. Она стоит посредником между пользователем или приложением и самими данными. СУБД скрывает сложность хранения и даёт единый способ работать с данными, а заодно следит за целостностью, безопасностью и одновременным доступом.
Главные функции СУБД:
| Функция | Что делает |
|---|---|
| Определение данных | Создаёт и меняет схемы: таблицы, столбцы, связи, ограничения |
| Работа с данными | Вставляет, читает, меняет и удаляет данные через язык запросов, обычно SQL |
| Безопасность и целостность | Задаёт роли и права доступа, проверяет ограничения, чтобы данные оставались точными |
| Параллельный доступ и транзакции | Не даёт одновременным пользователям испортить данные, выполняет группы операций по правилам ACID |
| Резервные копии и восстановление | Делает копии и поднимает данные после сбоя или аварии |
Примеры реляционных СУБД: Microsoft Access, Microsoft SQL Server, Postgres, MySQL, SQLite. Примеры нереляционных: MongoDB, Apache Cassandra, Apache CouchDB, Redis, Elasticsearch.
Как «разговаривать» с базой
Заголовок раздела «Как «разговаривать» с базой»Снаружи с базой через СУБД говорят на четырёх языках, и все они входят в SQL. Схема в начале страницы показывает их вместе с главными командами.
DDL(data definition language) работает со схемой: создаёт таблицы и другие объекты.DML(data manipulation language) работает с самими данными.DCL(data control language) управляет правами доступа.TCL(transaction control language) управляет транзакциями.
В книге разобраны только DDL и DML. DCL и TCL относятся к администрированию, и авторы их не касаются.
Создаём структуру данных с DDL
Заголовок раздела «Создаём структуру данных с DDL»DDL — часть SQL, которая создаёт и меняет структуру объектов базы: таблиц, индексов, последовательностей, псевдонимов. Главные команды:
| Команда | Что делает |
|---|---|
CREATE | Создаёт объект: таблицу, view, индекс, ограничение. Задаёт имя, столбцы, типы и свойства |
DROP | Удаляет объект навсегда вместе со всеми данными |
ALTER | Меняет структуру объекта: добавляет, меняет или удаляет столбцы и ограничения |
RENAME | Переименовывает таблицу или столбец, не трогая данные |
TRUNCATE | Быстро удаляет все строки, но оставляет таблицу. Быстрее DELETE, потому что освобождает страницы данных целиком и не пишет в журнал каждую строку |
CONSTRAINT | Задаёт ограничение: правило, которому должны отвечать данные столбца |
INDEX | Создаёт индекс по одному или нескольким столбцам. Индекс — отсортированная структура, которая ускоряет поиск и сортировку |
Большинство команд понятны из названия. Подробнее авторы разбирают только ограничения (constraints) — правила, которые защищают целостность данных. Обычно их задают для столбца или для всей таблицы.
- Первичный ключ (primary key) — столбец или набор столбцов, который однозначно определяет строку. Он не пускает дубликаты и NULL. На него обычно ссылаются внешние ключи других таблиц.
- Внешний ключ (foreign key) задаёт связь двух таблиц. Значения в столбце должны совпадать со значениями первичного ключа в другой таблице. Это и есть ссылочная целостность.
UNIQUEзапрещает повторы значений. В отличие от первичного ключа, допускает NULL.CHECKзадаёт условие на значения столбца. Так проверяют бизнес-правила, например «рейтинг от 0 до 5».NOT NULLтребует, чтобы у каждой строки было значение в столбце. Это защищает от неожиданных пропусков.
Последняя тема перед практикой — типы данных. Они различаются между движками, поэтому авторы берут за образец MySQL:
| Тип | Как объявляют | Пример значения |
|---|---|---|
| Целое число | INT, SMALLINT, BIGINT, TINYINT | 156, 2012412 |
| Дробное число | DECIMAL, NUMERIC, FLOAT, DOUBLE | 3.14, 94.5482 |
| Логический | BOOLEAN, BOOL, BIT, TINYINT | true/false или 0/1 |
| Дата | DATE | 2023-07-06 |
| Время | TIME | 18:34:59 |
| Дата и время | TIMESTAMP, DATETIME | 2017-12-31 18:34:59 |
| Текст | CHAR, VARCHAR, NVARCHAR, TEXT | «hello world», «porto1987» |
Текстовый тип выбирают внимательно: у каждого есть своя максимальная длина.
Авторы уточняют, кому какие команды нужны. Дата-инженер проектирует базу и работает с данными, поэтому ему нужны все команды. Аналитик данных в основном пишет DML, чаще всего SELECT. analytics engineer сочетает DML и часть DDL, но DDL за него обычно пишет dbt.
Теперь создадим базу для издательства O’Reilly из главы 2. На этот раз это уже физическая модель: четыре таблицы — авторы, книги, категории и связь книг с категориями.
Пояснение: в книге примеры написаны для MySQL (
CREATE DATABASE OReillyBooks; USE OReillyBooks;). Здесь все блоки SQL переписаны под DuckDB и идут по порядку: запуститеduckdbи выполняйте их один за другим. Данные — наши, а структура та же, что в книге.
-- В DuckDB база в памяти уже открыта, поэтому сразу создаём таблицыCREATE TABLE authors ( author_id INTEGER PRIMARY KEY, author_name VARCHAR(100) NOT NULL);CREATE TABLE books ( book_id INTEGER PRIMARY KEY, book_title VARCHAR(100) NOT NULL, author_id INTEGER REFERENCES authors (author_id), -- внешний ключ rating DECIMAL(10, 2) CHECK (rating BETWEEN 0 AND 5));CREATE TABLE category ( category_id INTEGER PRIMARY KEY, category_name VARCHAR(50) UNIQUE);-- Таблица-связка: книга может быть в нескольких категориях, категория содержит много книгCREATE TABLE book_category ( book_id INTEGER REFERENCES books (book_id), category_id INTEGER REFERENCES category (category_id));Таблица book_category хранит связь «многие ко многим» между книгами и категориями. Потом приходит новое требование: нужно хранить год издания книги. В книге приведён общий синтаксис ALTER TABLE: добавить столбец (ADD), изменить тип (ALTER COLUMN), переименовать (RENAME COLUMN), добавить или изменить ограничение (ADD CONSTRAINT), удалить столбец (DROP COLUMN). Нам подходит первый вариант:
ALTER TABLE books ADD COLUMN publication_year INTEGER;Работаем с данными через DML
Заголовок раздела «Работаем с данными через DML»DML выбирает, вставляет, меняет и удаляет данные в базе. Это главный язык для того, чтобы доставать и менять содержимое реляционной базы.
Вставляем данные: INSERT
Заголовок раздела «Вставляем данные: INSERT»INSERT добавляет в таблицу одну или несколько строк. Синтаксис: INSERT INTO table_name (column1, column2, ...) VALUES (value1, value2, ...). Список столбцов можно не писать, и тогда база ждёт значения для всех столбцов. Число значений должно совпадать с числом столбцов: только так значения попадут в нужные столбцы. Иначе большинство движков выдаст ошибку.
INSERT INTO authors (author_id, author_name) VALUES (1, 'Анна Смирнова'), (2, 'Павел Орлов'), (3, 'Юлия Мартынова'), (4, 'Игорь Белов'), (5, 'Олег Титов');INSERT INTO books (book_id, book_title, author_id, publication_year, rating) VALUES (1, 'Python с нуля', 1, 2012, 4.5), (2, 'Основы React', 2, 2014, 3.7), (3, 'Машинное обучение на практике', 3, 2017, 4.9), (4, 'JavaScript без боли', 4, 2014, 2.8), (5, 'Data Science для бизнеса', 5, 2019, 4.2);INSERT INTO category (category_id, category_name) VALUES (1, 'Программирование'), (2, 'Машинное обучение'), (3, 'Data Science'), (4, 'Software Engineering'), (5, 'Алгоритмы'), (6, 'Computer Science');INSERT INTO book_category (book_id, category_id) VALUES (1, 1), (2, 1), (3, 2), (4, 1), (5, 3);Столбец author_id в books ссылается на authors. Поэтому книгу с несуществующим автором вставить нельзя: это запрещает ссылочная целостность. Вот что ответит DuckDB на INSERT INTO books VALUES (9, 'Книга без автора', 42, 4.0, 2020);:
Constraint Error: Violates foreign key constraint because key "author_id: 42" does not exist in the referenced tableПроверить содержимое любой таблицы можно простым SELECT * FROM authors;.
Выбираем данные: SELECT
Заголовок раздела «Выбираем данные: SELECT»SELECT — одна из главных команд SQL. Она достаёт данные и складывает их в результирующую таблицу (result set). Простейший вид: SELECT column1, column2 FROM table_name. В SELECT перечисляют столбцы или выражения, а в FROM — таблицу. Дальше авторы по очереди добавляют фильтры, группировку, сортировку и соединения. Тем, кто уже уверенно пишет SELECT, авторы советуют сразу перейти к оконным функциям или к dbt в главе 4.
Фильтруем: WHERE
Заголовок раздела «Фильтруем: WHERE»WHERE задаёт условия, которым должны отвечать строки. Это необязательная, но самая частая часть запроса. Условия строят из операторов:
| Группа | Операторы | Что делают |
|---|---|---|
| Сравнение | =, <> или !=, <, >, <=, >= | Сравнивают значения |
| Сравнение | LIKE '%текст%' | Ищет подстроку |
| Сравнение | IN ('a', 'b') | Значение входит в список |
| Логика | BETWEEN | Значение лежит в диапазоне |
| Логика | AND, OR, NOT | Все условия верны / хотя бы одно верно / отрицание |
| Множества | UNION | Склеивает результаты двух SELECT и убирает дубликаты |
| Множества | UNION ALL | Склеивает результаты, дубликаты остаются |
Авторы показывают три запроса к таблице books: книги до 2015 года, книги 2017 года и книги со словом «Python» в названии. Вот первый из них:
SELECT book_title, publication_yearFROM booksWHERE publication_year < 2015;┌─────────────────────┬──────────────────┐│ book_title │ publication_year │├─────────────────────┼──────────────────┤│ Python с нуля │ 2012 ││ Основы React │ 2014 ││ JavaScript без боли │ 2014 │└─────────────────────┴──────────────────┘Логический оператор соединяет условия. Найдём книги 2012 года или вышедшие после 2015-го:
SELECT book_title, publication_yearFROM booksWHERE publication_year = 2012 OR publication_year > 2015;┌───────────────────────────────┬──────────────────┐│ book_title │ publication_year │├───────────────────────────────┼──────────────────┤│ Python с нуля │ 2012 ││ Машинное обучение на практике │ 2017 ││ Data Science для бизнеса │ 2019 │└───────────────────────────────┴──────────────────┘Те же операторы работают не только в WHERE, но и в HAVING.
Группируем: GROUP BY и HAVING
Заголовок раздела «Группируем: GROUP BY и HAVING»GROUP BY делит строки на группы по одному или нескольким столбцам: каждая группа — это одно уникальное сочетание значений. Обычно вместе с ним используют агрегатные функции:
| Функция | Что считает |
|---|---|
COUNT() | Число строк или непустых значений |
SUM() | Сумму |
AVG() | Среднее |
MAX(), MIN() | Максимум и минимум |
DISTINCT | Не функция, а ключевое слово. Внутри агрегата считает только разные значения: COUNT(DISTINCT x) |
Так строят отчёты по трендам и сводки: продажи за месяц, входы пользователей за квартал. Посчитаем, сколько книг в каждой категории:
SELECT category_id, COUNT(book_id) AS book_countFROM book_categoryGROUP BY category_idORDER BY category_id;┌─────────────┬────────────┐│ category_id │ book_count │├─────────────┼────────────┤│ 1 │ 3 ││ 2 │ 1 ││ 3 │ 1 │└─────────────┴────────────┘Здесь видно только category_id. Название категории лежит в другой таблице, и чтобы его показать, нужен JOIN.
HAVING фильтрует уже готовые группы. В этом его отличие от WHERE: WHERE отбирает строки до группировки, а HAVING — после. Операторы у них одни и те же. Оставим только категории, где не меньше двух книг:
SELECT category_id, COUNT(book_id) AS book_countFROM book_categoryGROUP BY category_idHAVING COUNT(book_id) >= 2;┌─────────────┬────────────┐│ category_id │ book_count │├─────────────┼────────────┤│ 1 │ 3 │└─────────────┴────────────┘Сортируем: ORDER BY
Заголовок раздела «Сортируем: ORDER BY»ORDER BY упорядочивает результат по одному или нескольким столбцам: по возрастанию (ASC, по умолчанию) или по убыванию (DESC). Без сортировки трудно сразу увидеть, какая книга самая новая. С ORDER BY publication_year DESC новые книги окажутся сверху:
SELECT book_title, publication_yearFROM booksORDER BY publication_year DESC, book_title;┌───────────────────────────────┬──────────────────┐│ book_title │ publication_year │├───────────────────────────────┼──────────────────┤│ Data Science для бизнеса │ 2019 ││ Машинное обучение на практике │ 2017 ││ JavaScript без боли │ 2014 ││ Основы React │ 2014 ││ Python с нуля │ 2012 │└───────────────────────────────┴──────────────────┘Соединяем таблицы: INNER, LEFT, RIGHT, FULL и CROSS JOIN
Заголовок раздела «Соединяем таблицы: INNER, LEFT, RIGHT, FULL и CROSS JOIN»JOIN соединяет данные нескольких таблиц по условию. Это один из главных навыков аналитика: без соединений сложные данные не дают ответов. Чтобы увидеть разницу между видами JOIN, авторы добавляют автора без книг:
INSERT INTO authors (author_id, author_name) VALUES (6, 'Иван Пустов');В книге каждый вид соединения показан диаграммой Венна: круг A — левая таблица, круг B — правая, пересечение — строки с парой. Мы свели эти диаграммы в одну схему.
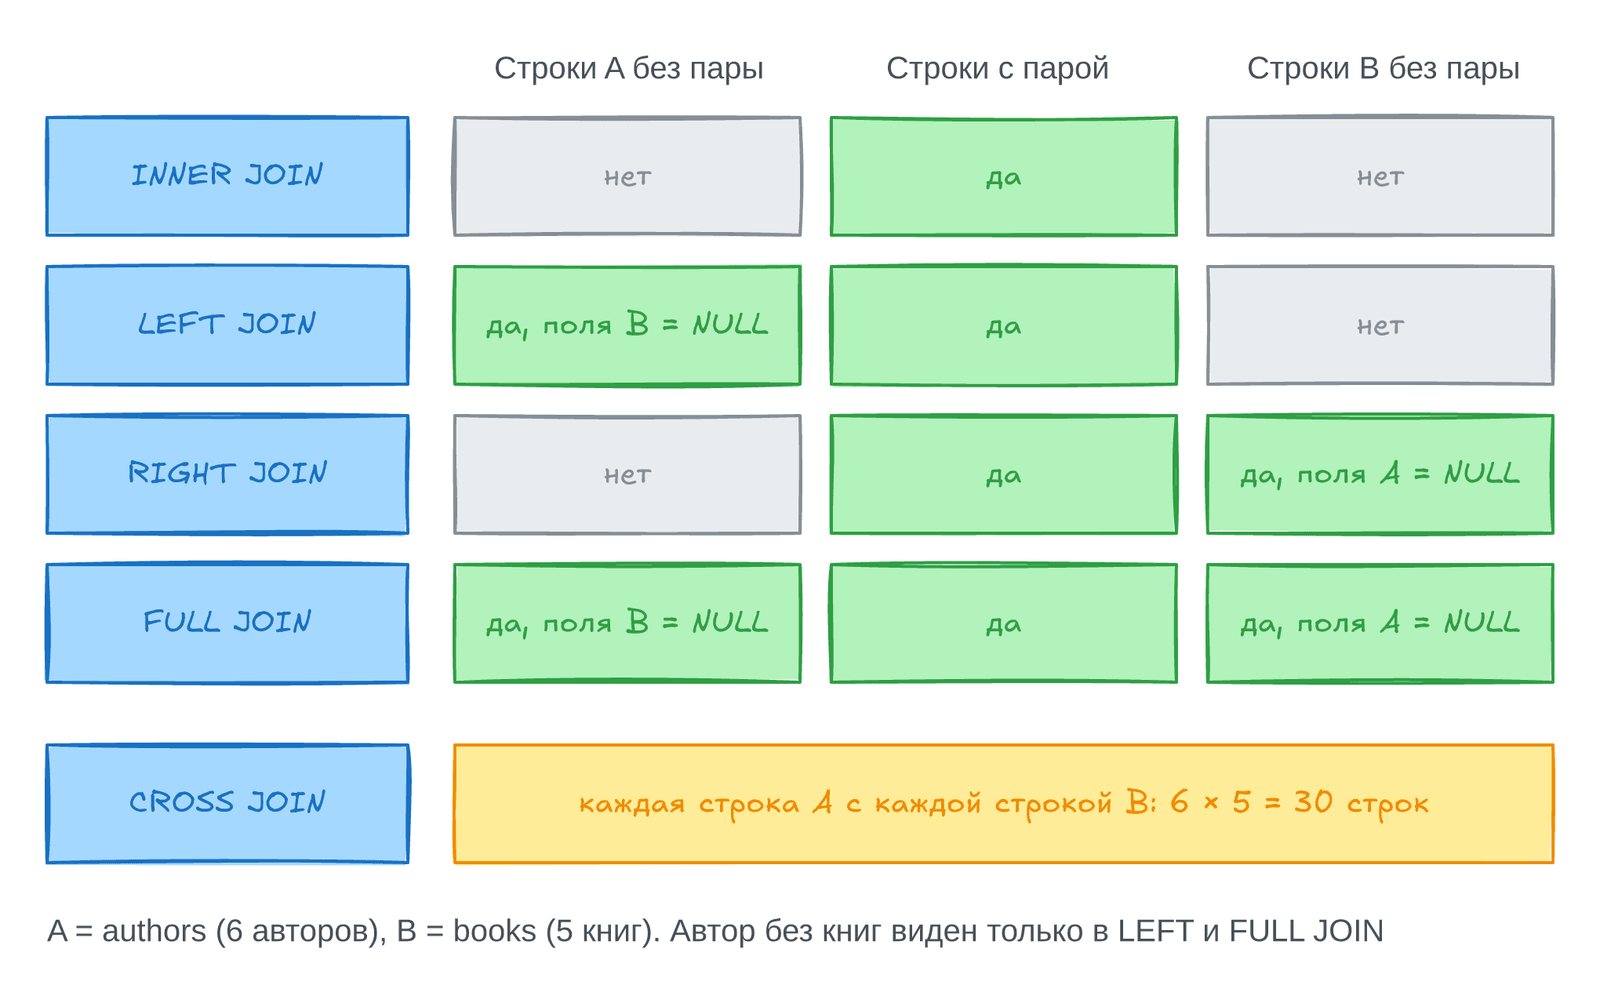
Каждая строка схемы — один вид соединения. Зелёная клетка значит, что такие строки попадут в результат.
INNER JOIN возвращает только строки, у которых нашлась пара в обеих таблицах. На диаграмме Венна это пересечение кругов. Синтаксис: FROM table_a INNER JOIN table_b ON условие. Запрос «авторы с книгами» не покажет Ивана Пустова, ведь книг у него нет.
LEFT JOIN (или LEFT OUTER JOIN) возвращает все строки левой таблицы и совпавшие строки правой. Если пары нет, столбцы правой таблицы заполняются NULL. Выведем всех авторов, включая тех, у кого нет книг:
SELECT a.author_id, a.author_name, b.book_titleFROM authors AS aLEFT JOIN books AS b ON a.author_id = b.author_idORDER BY a.author_id;┌───────────┬────────────────┬───────────────────────────────┐│ author_id │ author_name │ book_title │├───────────┼────────────────┼───────────────────────────────┤│ 1 │ Анна Смирнова │ Python с нуля ││ 2 │ Павел Орлов │ Основы React ││ 3 │ Юлия Мартынова │ Машинное обучение на практике ││ 4 │ Игорь Белов │ JavaScript без боли ││ 5 │ Олег Титов │ Data Science для бизнеса ││ 6 │ Иван Пустов │ NULL │└───────────┴────────────────┴───────────────────────────────┘Если заменить здесь LEFT JOIN на INNER JOIN, последняя строка пропадёт. Левая таблица authors в LEFT JOIN видна целиком, а из правой books берутся только совпадения.
RIGHT JOIN (или RIGHT OUTER JOIN) работает зеркально: все строки правой таблицы плюс совпавшие строки левой. Запрос «все книги и их авторы» вернёт пять книг. Книг без автора у нас нет, поэтому строк с NULL в результате не будет.
FULL JOIN (или FULL OUTER JOIN) возвращает все строки обеих таблиц, то есть объединяет LEFT и RIGHT JOIN. Где пары нет, стоят NULL. В нашем примере он вернёт шесть строк, как и LEFT JOIN. Авторы предупреждают, что MySQL не поддерживает FULL JOIN, поэтому там его собирают как UNION из LEFT JOIN и RIGHT JOIN. В DuckDB FULL JOIN есть.
CROSS JOIN (декартово соединение) соединяет каждую строку первой таблицы с каждой строкой второй. Условие соединения ему не нужно. На диаграмме Венна круги здесь не пересекаются, потому что результат — все возможные пары:
SELECT COUNT(*) AS pairsFROM authorsCROSS JOIN books;┌───────┐│ pairs │├───────┤│ 30 │└───────┘Шесть авторов на пять книг дают 30 строк. Диаграмма Венна, по мнению авторов, хорошо объясняет, какие строки совпали, а какие нет.
Меняем данные: UPDATE
Заголовок раздела «Меняем данные: UPDATE»UPDATE меняет существующие строки: UPDATE table_name SET column1 = value1, ... WHERE condition. В SET перечисляют столбцы и новые значения, а необязательный WHERE выбирает строки для изменения. Допустим, название книги с book_id = 2 нужно уточнить:
UPDATE booksSET book_title = 'Основы React для начинающих'WHERE book_id = 2;Удаляем данные: DELETE
Заголовок раздела «Удаляем данные: DELETE»DELETE удаляет строки по условию или все строки таблицы: DELETE FROM table_name WHERE condition. Так чистят таблицу от устаревших и ненужных записей. Главное здесь — WHERE: без него удалятся все строки. Допустим, издательство больше не выпускает книги категории Computer Science (category_id = 6):
DELETE FROM categoryWHERE category_id = 6;
SELECT (SELECT book_title FROM books WHERE book_id = 2) AS new_title, (SELECT COUNT(*) FROM category) AS categories_left;┌─────────────────────────────┬─────────────────┐│ new_title │ categories_left │├─────────────────────────────┼─────────────────┤│ Основы React для начинающих │ 5 │└─────────────────────────────┴─────────────────┘Есть и другой способ — soft delete (мягкое удаление). Строку не стирают, а ставят ей флаг «удалена». История сохраняется, запись легко вернуть, а журнал изменений помогает пройти аудит.
Храним запросы как view
Заголовок раздела «Храним запросы как view»View — это виртуальная таблица, которую задаёт запрос. У неё, как у таблицы, есть столбцы и строки. Но данные view не хранит: каждый раз при обращении она берёт их из исходных таблиц своим запросом. Синтаксис: CREATE VIEW view_name AS SELECT .... Создадим view, которая считает книги каждого автора:
CREATE VIEW author_book_count ASSELECT a.author_id, a.author_name, COUNT(b.book_id) AS book_countFROM authors AS aLEFT JOIN books AS b ON a.author_id = b.author_idGROUP BY a.author_id, a.author_name;
SELECT * FROM author_book_count ORDER BY author_id;┌───────────┬────────────────┬────────────┐│ author_id │ author_name │ book_count │├───────────┼────────────────┼────────────┤│ 1 │ Анна Смирнова │ 1 ││ 2 │ Павел Орлов │ 1 ││ 3 │ Юлия Мартынова │ 1 ││ 4 │ Игорь Белов │ 1 ││ 5 │ Олег Титов │ 1 ││ 6 │ Иван Пустов │ 0 │└───────────┴────────────────┴────────────┘Зачем нужны view, авторы объясняют так:
- Фильтр над таблицами. Запрос
viewможет брать данные из нескольких таблиц и другихview, даже из разных баз. Например, он может собрать вместе данные региональных серверов компании. - Удобный вид для каждого пользователя.
Viewскрывает лишние детали и показывает только то, что нужно конкретной аудитории. - Безопасность. Пользователь читает
viewи не получает прямого доступа к таблицам под ней. - Переименование. Псевдонимы в
SELECTдают столбцам привычные для аудитории имена, а структура таблицы не меняется. Над одними данными можно держать несколькоviewс разными соглашениями об именах. - Обратная совместимость. Если схема таблицы изменилась,
viewможет повторить старую структуру. Тогда старые запросы и приложения продолжат работать.
-- В книге здесь id и title, но таких столбцов в books нет: исправленоCREATE VIEW renamed_books ASSELECT book_id AS "BookID", book_title AS "BookTitle", rating AS "BookRating"FROM books;У view есть и опасности. Зависимость от структуры таблиц — это одновременно польза и проклятие: если таблица изменилась, view придётся переписывать. Сложная view со многими соединениями и расчётами может тормозить, поэтому её запрос нужно оптимизировать и читать план выполнения. Кроме того, view даёт лишь иллюзию защиты: тот, кто получил доступ к ней, может добраться и до данных под ней. Настоящую защиту дают права на уровне базы. Наконец, view не проверяет ограничения и ссылочную целостность, как физическая таблица.
В книге пример сложной view соединяет книги, авторов и категории тремя JOIN и выводит столбцы из всех таблиц. Такой запрос трудно прочитать с первого взгляда. Авторы предлагают распутывать его с помощью CTE.
Common Table Expressions
Заголовок раздела «Common Table Expressions»Многие аналитики сталкивались со сложными запросами, где непонятно, зачем нужна каждая часть и от чего она зависит. Хуже всего, когда результат неверный, а найти виновную часть запроса не получается. Здесь помогают CTE.
CTE (Common Table Expression) — это именованный временный результат, который объявляют через WITH перед основным запросом. CTE дробит сложный запрос на понятные блоки и делает код читаемым. Порядок работы такой:
- Объявить
CTEсловомWITHи дать ему имя. Столбцы можно перечислить явно. - После
ASв скобках написать запрос любой сложности: с фильтрами, соединениями, агрегатами. - В основном запросе обращаться к
CTEпо имени, как к обычной таблице. - По желанию добавить следующие
CTEцепочкой, каждое строит своё на предыдущих.
CTE похожи на подзапросы в FROM и на view, но читаются легче. Авторы сравнивают оба способа на задаче «самые продаваемые книги 2022 года среди книг с высоким рейтингом». Для неё нужна таблица продаж:
CREATE TABLE sales ASSELECT * FROM (VALUES (1, 1, 101, 2022, 30.00), (2, 3, 101, 2022, 55.00), (3, 3, 102, 2022, 55.00), (4, 5, 102, 2022, 40.00), (5, 1, 103, 2022, 30.00), (6, 3, 103, 2023, 55.00), (7, 2, 104, 2022, 25.00), (8, 5, 104, 2023, 40.00), (9, 1, 105, 2022, 30.00), (10, 4, 105, 2022, 20.00)) AS t(sale_id, book_id, customer_id, sale_year, amount);Сначала решение с подзапросом. Фильтр по рейтингу спрятан внутри FROM:
SELECT pb.book_title, SUM(s.amount) AS revenueFROM ( SELECT book_id, book_title FROM books WHERE rating >= 4.2) AS pbJOIN sales AS s ON pb.book_id = s.book_idWHERE s.sale_year = 2022GROUP BY pb.book_titleORDER BY revenue DESCLIMIT 2;Теперь то же самое на двух CTE:
WITH popular_books AS ( -- шаг 1: только книги с высоким рейтингом SELECT book_id, book_title FROM books WHERE rating >= 4.2),best_sellers AS ( -- шаг 2: их выручка за 2022 год SELECT pb.book_title, SUM(s.amount) AS revenue FROM popular_books AS pb JOIN sales AS s ON pb.book_id = s.book_id WHERE s.sale_year = 2022 GROUP BY pb.book_title)SELECT * -- итог: две лучшиеFROM best_sellersORDER BY revenue DESCLIMIT 2;┌───────────────────────────────┬─────────┐│ book_title │ revenue │├───────────────────────────────┼─────────┤│ Машинное обучение на практике │ 110.00 ││ Python с нуля │ 90.00 │└───────────────────────────────┴─────────┘Оба запроса дают одинаковый результат, но у каждого CTE одна понятная обязанность. popular_books только отбирает книги с высоким рейтингом. best_sellers только считает их продажи за 2022 год. Основной запрос, как советуют авторы, остаётся простым и лишь выбирает нужные для анализа столбцы.
Авторы называют ещё три случая, где CTE полезны:
- Повторное использование.
CTEобъявляют один раз, а обращаются к нему сколько угодно раз в основном запросе и в следующихCTE. Повторов кода становится меньше, а с ними и ошибок. - Замена постоянной
view. Иногда создаватьviewв базе не нужно или нельзя. ТогдаCTEдействует как временнаяview, которая живёт только внутри одного запроса. - Один расчёт для нескольких частей запроса. Расчёт делают в
CTEодин раз и дальше берут готовый результат.
Последний случай показан ниже: суммы покупок клиентов считаются в CTE, а затем по ним считается среднее.
-- В книге AVG стоит рядом с обычными столбцами без GROUP BY, такой запрос не выполнится.-- Среднее по всем строкам рядом с каждой строкой даёт оконная функция AVG(...) OVER ()WITH customer_totals AS ( SELECT customer_id, SUM(amount) AS total_amount FROM sales GROUP BY customer_id)SELECT customer_id, total_amount, ROUND(AVG(total_amount) OVER (), 2) AS avg_amountFROM customer_totalsORDER BY customer_id;┌─────────────┬──────────────┬────────────┐│ customer_id │ total_amount │ avg_amount │├─────────────┼──────────────┼────────────┤│ 101 │ 85.00 │ 76.0 ││ 102 │ 95.00 │ 76.0 ││ 103 │ 85.00 │ 76.0 ││ 104 │ 65.00 │ 76.0 ││ 105 │ 50.00 │ 76.0 │└─────────────┴──────────────┴────────────┘Итог авторов такой: CTE разбивают сложную задачу на небольшие части и задают промежуточные результаты, на которые можно ссылаться несколько раз. Код становится модульным, а поддерживать его легче. Модели dbt в следующих главах написаны именно в этом стиле.
Оконные функции
Заголовок раздела «Оконные функции»Оконная функция — это расчёт по набору строк, связанных с текущей строкой. Она похожа на агрегатную функцию, но не схлопывает строки в одну: каждая строка остаётся на месте и получает своё значение. Так оконные функции заменяют громоздкие подзапросы и процедурную логику.
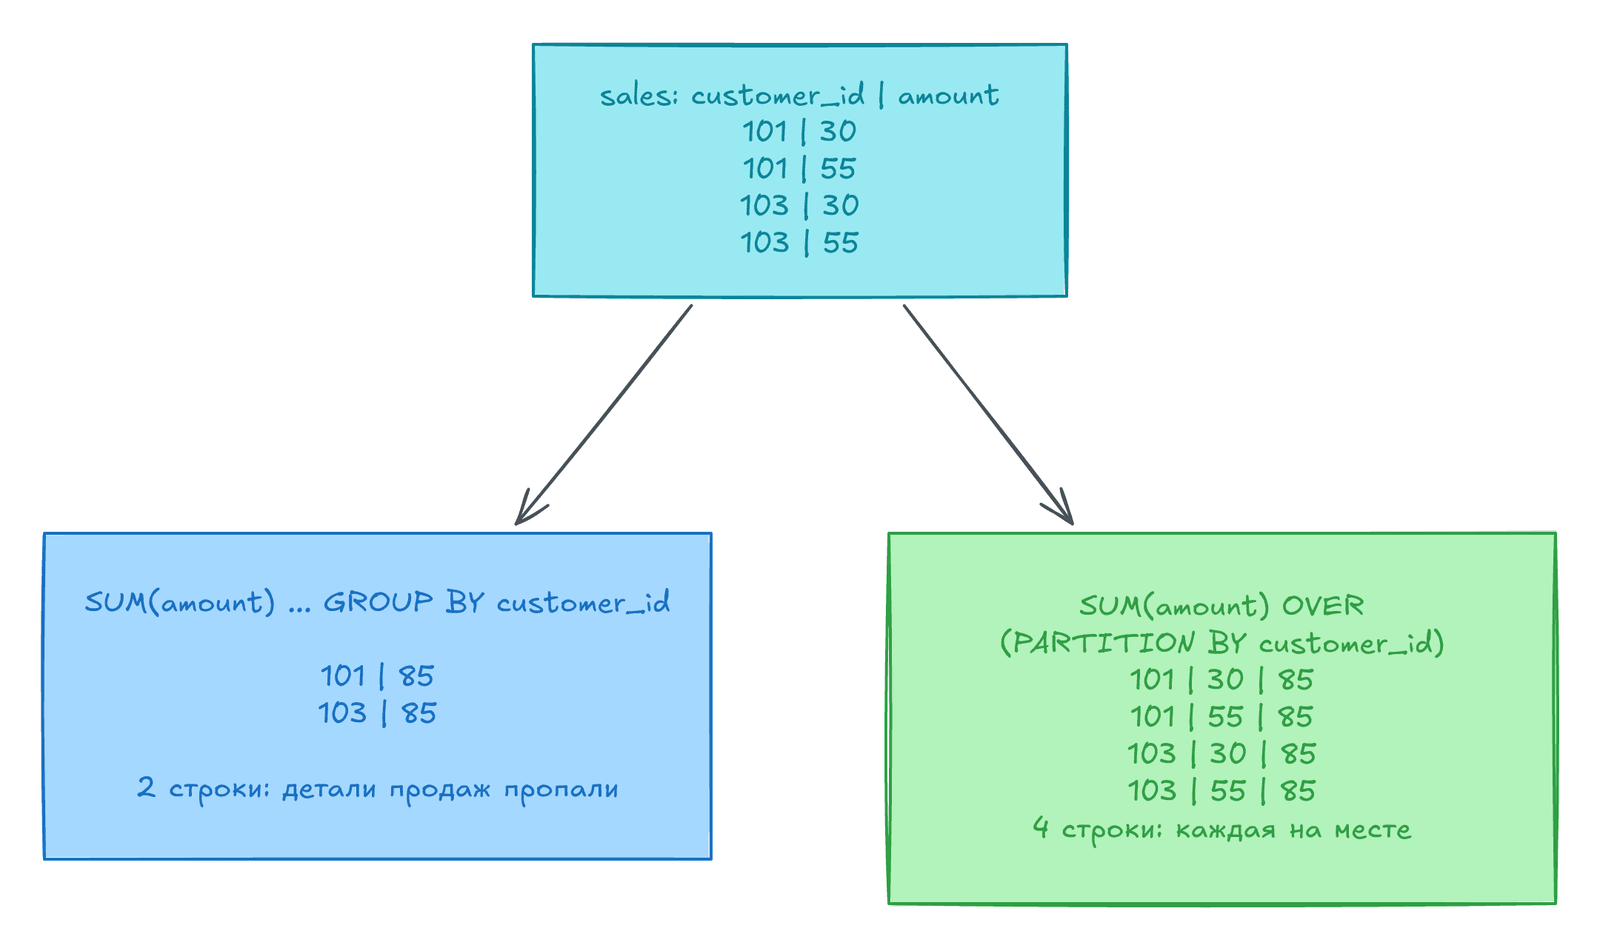
Схема показывает главное отличие: слева строки схлопнулись, справа каждая строка получила сумму своей группы.
Авторы называют три типичные задачи:
- ранжирование внутри группы или относительно всех строк;
- доступ к соседним строкам, чтобы сравнить период с прошлым;
- накопительные итоги и другие агрегаты по окну.
Синтаксис: функция() OVER (PARTITION BY ... ORDER BY ...). Здесь OVER задаёт окно, по которому считается функция. Внутри него PARTITION BY делит строки на группы по одному или нескольким столбцам, и функция считается в каждой группе отдельно. ORDER BY задаёт порядок строк внутри группы, и функция идёт по строкам в этом порядке. Вместе они точно определяют, на какие строки смотрит функция. Число строк в результате при этом не меняется.
| Тип | Что делает | Функции |
|---|---|---|
| Агрегатные | Считают агрегат по окну и возвращают значение для каждой строки | SUM(), COUNT(), AVG(), MAX(), MIN() |
| Ранжирующие | Присваивают строке номер или ранг внутри окна | ROW_NUMBER(), RANK(), DENSE_RANK(), NTILE(), PERCENT_RANK(), CUME_DIST() |
| Аналитические | Берут значения из других строк окна, не меняя число строк | LAG(), LEAD(), FIRST_VALUE(), LAST_VALUE() |
Авторы пробуют функции на столбце publication_year по одной. Мы собрали их в один запрос. В наших данных две книги вышли в 2014 году: так видна разница между ранжирующими функциями.
SELECT book_title, publication_year, ROW_NUMBER() OVER (ORDER BY publication_year, book_id) AS row_num, RANK() OVER (ORDER BY publication_year) AS rnk, DENSE_RANK() OVER (ORDER BY publication_year) AS dense_rnk, NTILE(3) OVER (ORDER BY publication_year, book_id) AS bucket, LAG(publication_year) OVER (ORDER BY publication_year, book_id) AS prev_yearFROM booksORDER BY row_num;┌───────────────────────────────┬──────────────────┬─────────┬─────┬───────────┬────────┬───────────┐│ book_title │ publication_year │ row_num │ rnk │ dense_rnk │ bucket │ prev_year │├───────────────────────────────┼──────────────────┼─────────┼─────┼───────────┼────────┼───────────┤│ Python с нуля │ 2012 │ 1 │ 1 │ 1 │ 1 │ NULL ││ Основы React для начинающих │ 2014 │ 2 │ 2 │ 2 │ 1 │ 2012 ││ JavaScript без боли │ 2014 │ 3 │ 2 │ 2 │ 2 │ 2014 ││ Машинное обучение на практике │ 2017 │ 4 │ 4 │ 3 │ 2 │ 2014 ││ Data Science для бизнеса │ 2019 │ 5 │ 5 │ 4 │ 3 │ 2017 │└───────────────────────────────┴──────────────────┴─────────┴─────┴───────────┴────────┴───────────┘Как читать результат:
ROW_NUMBER()нумерует строки подряд. В книге им считают «нарастающий счёт» книг по году издания.RANK()даёт одинаковым значениям одинаковый ранг, а следующий ранг пропускает: после двух вторых мест идёт четвёртое. Если повторы рангов не нужны, авторы советуютROW_NUMBER().DENSE_RANK()тоже даёт одинаковый ранг, но без пропусков.NTILE(3)раскладывает строки на три примерно равные корзины. Так делят данные на сегменты, считают перцентили и квартили, готовят равные выборки.LAG()берёт значение из предыдущей строки в порядкеOVER. Здесь это год предыдущей книги.LEAD()делает то же для следующей строки.
Агрегатные функции из раздела про GROUP BY тоже работают в окне. Добавим PARTITION BY, и сумма станет накопительной внутри каждого клиента:
SELECT customer_id, sale_id, amount, SUM(amount) OVER (PARTITION BY customer_id ORDER BY sale_id) AS running_total, COUNT(*) OVER (PARTITION BY customer_id) AS sales_in_groupFROM salesWHERE customer_id IN (101, 103)ORDER BY customer_id, sale_id;┌─────────────┬─────────┬────────┬───────────────┬────────────────┐│ customer_id │ sale_id │ amount │ running_total │ sales_in_group │├─────────────┼─────────┼────────┼───────────────┼────────────────┤│ 101 │ 1 │ 30.00 │ 30.00 │ 2 ││ 101 │ 2 │ 55.00 │ 85.00 │ 2 ││ 103 │ 5 │ 30.00 │ 30.00 │ 2 ││ 103 │ 6 │ 55.00 │ 85.00 │ 2 │└─────────────┴─────────┴────────┴───────────────┴────────────────┘SQL для распределённой обработки
Заголовок раздела «SQL для распределённой обработки»Компании переезжают в облако и упираются в одну и ту же проблему. Их реляционные базы держат критичные приложения, но плохо масштабируются и не раскрывают возможности облака. База становится узким местом переезда. Компаниям нужна надёжность проверенных Oracle, SQL Server, Postgres и MySQL вместе с масштабом и глобальным охватом облака.
Некоторые компании пробовали NoSQL. Такие базы масштабируются, но плохо подходят для транзакций: их изначально не проектировали под строгую согласованность. Некоторые NoSQL-решения со временем научились решать часть таких задач, но с оговорками. Уровней изоляции для критичной нагрузки, как в банках и больницах, они всё равно не дают.
Поэтому появился distributed SQL — распределённый SQL. Одна логическая база развёрнута на многих физических узлах: в одном дата-центре или в нескольких. Авторы видят у такого подхода три сильные стороны:
- Эластичное масштабирование. Данных и пользователей стало больше — добавляют узлы, и база растёт горизонтально. Скорость сохраняется даже под большой нагрузкой.
- Устойчивость. Данные лежат на многих узлах. Если один узел упал, запросы уходят на живые узлы, и простоя с потерей данных удаётся избежать.
- Глобальный охват. Узлы ставят в разных регионах ближе к пользователям. Задержка падает, и данные быстро доступны из любой точки мира.
Как устроены распределённые движки, авторы не разбирают: их интересуют только интерфейсы. Большинство движков дают API или SDK, но те, что ориентированы на аналитику, часто говорят на SQL. Spark, Hadoop и Dask распределяют работу по многим машинам и параллелят вычисления. SQL даёт декларативный и знакомый способ описать, что сделать с данными. Вместе это позволяет обрабатывать огромные объёмы привычным языком. Примерами такого SQL-слоя поверх распределённых движков авторы называют DuckDB, сам dbt и FugueSQL.
Пояснение: DuckDB — встраиваемая СУБД, она работает внутри одного процесса на одной машине. Авторы в начале главы сами так её описывают. На кластер запрос переносят другие движки: Spark, Dask, Ray. Fugue, о котором речь ниже, умеет переключать один и тот же код между ними.
Но даже с SQL-интерфейсом без Python обычно не обойтись. Даже в документации Spark Python нужен, чтобы загрузить DataFrame, преобразовать данные и обработать результат запроса. В стандартном SQL просто нет конструкций для многих операций распределённой обработки. Поэтому одним SQL весь процесс от начала до конца обычно не описать.
Пример авторов: топ-5 книг O’Reilly по числу проданных экземпляров. Это обычный запрос с WHERE, ORDER BY ... DESC и LIMIT 5. Но если результат нужно соединить с демографией клиентов из другого набора данных, нарисовать график или выгрузить в другой формат, приходится писать на Python. Частая задача — отдать данные через API, а этого SQL не умеет совсем.
Авторы показывают связку SQL и FastAPI. Приложение открывает один endpoint — адрес /top_books, по которому приложение отдаёт данные. При обращении к нему вызывается функция get_top_books. Она подключается к DuckDB, выполняет SQL-запрос, превращает строки в список словарей и возвращает JSON. Наша версия запускается без сервера, через тестовый клиент FastAPI (ch03_fastapi.py):
@app.get("/top_books")def get_top_books(): rows = con.execute(""" SELECT title, units_sold FROM sales WHERE publisher = 'Север' ORDER BY units_sold DESC LIMIT 2 """).fetchall() return {"top_books": [{"title": t, "units_sold": u} for t, u in rows]}200{'top_books': [{'title': 'dbt на практике', 'units_sold': 1200}, {'title': 'SQL для начинающих', 'units_sold': 1000}]}SQL готовит данные, а Python отдаёт их наружу. Дальше авторы разбирают три Python-инструмента с SQL-интерфейсом: DuckDB, Polars и FugueSQL.
Работа с данными в DuckDB
Заголовок раздела «Работа с данными в DuckDB»Большинство data scientists знают pandas — главную библиотеку для работы с данными в Python. Она простая, гибкая и понимает много форматов. Но иногда приходится выбирать между скоростью выполнения и удобством инструмента. Особенно тяжело, когда данные не влезают в память или нужны сложные преобразования.
В таких случаях SQL может оказаться лучше pandas, и тут появляется DuckDB. Он сочетает сильные стороны pandas и SQL: быстро выполняет сложные запросы на больших данных и работает прямо с DataFrame pandas, без лишних копирований. Авторы замечают и тренд: некоторые компании заменяют Spark связкой dbt и DuckDB. Решать это надо в каждом случае отдельно. Но такая связка позволяет аналитикам делать более сложные преобразования, разово или по расписанию в pipeline.
Установка DuckDB
Заголовок раздела «Установка DuckDB»DuckDB — очень лёгкий движок: он работает внутри процесса приложения и не требует внешних зависимостей. Для Python достаточно pip install duckdb. После этого через DuckDB можно сразу выполнять SQL над DataFrame pandas и получать результат снова в виде DataFrame.
SQL-запросы в DuckDB
Заголовок раздела «SQL-запросы в DuckDB»Авторы перечисляют главные свойства DuckDB:
- Работает внутри приложения. Как и у SQLite, у него нет отдельного сервера и клиент-серверной архитектуры.
- Создан для
OLAP. Векторное выполнение запросов и колоночное хранение ускоряют аналитику.OLAP— аналитическая нагрузка: большие запросы по многим строкам, при этом транзакционные системы не страдают. - Самодостаточен. Ничего не нужно ставить, обновлять и поддерживать отдельно. Данные быстро ходят между приложением и базой.
- Зрелый. Его проверяют миллионами запросов из ведущих систем. Он соблюдает
ACID, поддерживает вторичные индексы и богатый SQL. - Много языков. Есть интеграция с Python и R, а также API для C, C++ и Java.
Пошаговый пример авторов: импортировать pandas и DuckDB, открыть базу в памяти (duckdb.connect()), создать DataFrame с продажами книг и зарегистрировать его как таблицу sales (con.register). Затем посчитать выручку SQL-запросом и получить её числом через fetchall() или DataFrame через df(). В конце книга рисует столбчатую диаграмму через matplotlib. Наш вариант без графика (ch03_duckdb_pandas.py):
import duckdbimport pandas as pd
# Маленький DataFrame: SQL видит его по имени переменнойmydf = pd.DataFrame({"a": [1, 2, 3]})print(duckdb.query("SELECT SUM(a) AS total FROM mydf").to_df())
# Продажи книг (наши данные)sales_df = pd.DataFrame({    "title": ["SQL для начинающих", "Python для анализа", "dbt на практике", "Основы Spark"],    "publisher": ["Север", "Север", "Север", "Юг"],    "price": [30.0, 45.0, 50.0, 40.0],    "units_sold": [1000, 800, 1200, 600],})
con = duckdb.connect()            # база в памяти процессаcon.register("sales", sales_df)   # DataFrame становится таблицей sales
query = """SELECT SUM(price * units_sold) AS total_revenueFROM salesWHERE publisher = 'Север'          -- строки в SQL только в одинарных кавычках"""total = con.execute(query).fetchall()[0][0]   # одно числоprint("total_revenue:", total)
df_total = con.execute(query).df() # тот же результат как DataFrameprint(type(df_total).__name__, df_total.shape) total0 6.0total_revenue: 126000.0DataFrame (1, 1)Строки в SQL пишите в одинарных кавычках. В DuckDB двойные кавычки означают имя столбца, поэтому WHERE publisher = "O'Reilly" упадёт с ошибкой.
У pandas есть pandas.read_sql: он выполняет SQL через подключение к базе и загружает результат в DataFrame. Для лёгких задач этого хватает, но для тяжёлой обработки нет. Классические Postgres и MySQL обрабатывают данные строка за строкой, поэтому аналитические запросы идут долго и сильно грузят CPU. DuckDB создан для аналитики и хранит данные по колонкам и обрабатывает их векторами. Поэтому он параллелит и чтение с диска, и выполнение запроса. Внутри DuckDB использует парсер SQL от Postgres и совместим с его функциями.
Работа с данными в Polars
Заголовок раздела «Работа с данными в Polars»Polars, как и DuckDB, решает проблему медленного pandas на больших данных. Это быстрая библиотека DataFrame, целиком написанная на Rust. Авторы выделяют четыре её преимущества:
- Нет индекса. В pandas индекс у DataFrame часто лишний. Polars обходится без него, и операции становятся проще.
- Apache Arrow внутри. Pandas хранит данные в массивах NumPy (pandas 2.0 может это изменить), а Polars — в массивах Arrow. Это ускоряет загрузку, экономит память и ускоряет расчёты.
- Параллельность. Rust хорош для производительности и многопоточности, поэтому Polars выполняет операции параллельно.
- Ленивое выполнение (
lazy evaluation). Polars сначала изучает весь запрос, оптимизирует его и только потом выполняет. Pandas умеет только немедленное выполнение (eager): каждое выражение считается сразу.
Для analytics engineer Polars полезен экономией памяти и скоростью на больших данных. Кроме того, он легко встраивается в pipeline на Rust.
Установка Polars
Заголовок раздела «Установка Polars»Ставится одной командой pip install polars. В книге затем создают DataFrame из трёх столбцов: название книги, проданные экземпляры и издатель.
SQL-запросы в Polars
Заголовок раздела «SQL-запросы в Polars»Сначала авторы показывают родной API Polars: отсортировать по UnitsSold по убыванию, взять пять строк и превратить результат в DataFrame pandas для печати. Синтаксис похож на pandas. Затем идут два способа работать на SQL.
Первый способ — через DuckDB. DuckDB регистрирует DataFrame Polars как таблицу и выполняет над ней SQL, а результат снова превращается в DataFrame Polars. Второй способ — встроенный SQL самого Polars, без внешних библиотек. Порядок такой: создать контекст pl.SQLContext(), зарегистрировать в нём DataFrame под именем и выполнить запрос через execute(). Результат — снова DataFrame Polars. Фрагмент нашего скрипта ch03_polars_sql.py:
# 3. Встроенный SQL в Polars: контекст, регистрация, запросctx = pl.SQLContext()ctx.register("books", df)res = ctx.execute("SELECT author, price FROM books WHERE price >= 45 ORDER BY price").collect()print(res)shape: (2, 2)┌──────────┬───────┐│ author ┆ price ││ --- ┆ --- ││ str ┆ f64 │╞══════════╪═══════╡│ Петров ┆ 45.0 ││ Сидорова ┆ 50.0 │└──────────┴───────┘execute() по умолчанию возвращает ленивый LazyFrame, а collect() запускает расчёт. Так специалист с сильным SQL пользуется быстрым движком Polars и не учит новый API.
Работа с данными в FugueSQL
Заголовок раздела «Работа с данными в FugueSQL»Fugue — единый интерфейс для распределённых вычислений. Код на Python, pandas или SQL запускается на Spark, Dask или Ray почти без изменений. Главная задача Fugue — масштабировать существующий код pandas на распределённые движки, не переписывая его.
Для этой главы важен FugueSQL. Он позволяет описать весь процесс обработки на SQL поверх DataFrame pandas, Spark и Dask и при этом вызывать Python-код. FugueSQL полезен и для параллельной обработки, и для запросов на одной машине.
Установка Fugue и FugueSQL
Заголовок раздела «Установка Fugue и FugueSQL»Базовая установка — pip install fugue. Остальные возможности добавляют дополнения (extras):
| Дополнение | Что даёт |
|---|---|
sql | Поддержку FugueSQL. Без него работает только не-SQL часть Fugue |
spark, dask, ray | Движок выполнения (ExecutionEngine) Spark, Dask или Ray |
duckdb | DuckDB как движок выполнения, очень быстрый и в памяти |
polars | Поддержку DataFrame Polars |
ibis | Интеграцию с Ibis, интерфейсом для SQL-подобных запросов |
cpp_sql_parser | Парсер FugueSQL на C++: заметно быстрее парсера на чистом Python. На редких платформах может понадобиться компилятор C++ |
Несколько дополнений ставят одной командой: pip install "fugue[duckdb,spark,polars]". Для Jupyter есть расширение с подсветкой синтаксиса: pip install fugue-jupyter, затем fugue-jupyter install startup. Вторая команда регистрирует Fugue при запуске Jupyter. В JupyterLab магическая команда ячейки %%fsql включается сама. В классическом Jupyter её включают вызовом setup() из fugue_notebook.
SQL-запросы в FugueSQL
Заголовок раздела «SQL-запросы в FugueSQL»FugueSQL создан для тех, кто любит SQL, но работает с DataFrame pandas, Spark и Dask. Он разбирает SQL и выполняет его на выбранном движке, поэтому аналитик думает о логике, а не о том, как её выполнить. Data scientist с кодом на pandas может перейти на Spark или Dask почти без усилий. С движком Spark, например, Fugue выполняет запросы через SparkSQL и PySpark. FugueSQL добавляет нестандартные команды, но полностью совместим со стандартным SQL, так что прежние знания SQL остаются в силе. Командам Big Data он упрощает поддержку кода: интерфейс один для всех платформ.
В примере авторов данные сохраняют в Parquet. Затем один и тот же запрос с командами LOAD, SELECT ... GROUP BY и PRINT выполняют на движке pandas и на Spark. Третий запрос на DuckDB отбирает книги одного автора и пишет результат в новый файл командой SAVE ... OVERWRITE. Наш вариант использует движки pandas и DuckDB, Spark для него не нужен (ch03_fugue.py):
# Один и тот же текст запроса. LOAD и PRINT — расширения FugueSQL query = f""" LOAD "{src}" SELECT author, COUNT(title) AS nb_books GROUP BY author ORDER BY author PRINT """ fa.fugue_sql(query, engine="pandas") fa.fugue_sql(query, engine="duckdb") # в книге здесь ещё engine="spark"PandasDataFrameauthor:str|nb_books:long----------+-------------Иванова |2Козлов |1Петров |1Total count: 3
DuckDataFrameauthor:str|nb_books:long----------+-------------Иванова |2Козлов |1Петров |1Total count: 3Текст запроса не изменился, поменялся только движок.
Не замена ли это pandasql? Авторы отвечают так: pandasql работает только поверх SQLite, а FugueSQL поддерживает несколько локальных движков — pandas, DuckDB, Spark, SQLite. На движке pandas запросы FugueSQL сразу превращаются в операции pandas, без передачи данных. DuckDB тоже отлично работает с pandas и почти не тратит время на передачу данных. Поэтому для локальной работы авторы советуют движки pandas и DuckDB.
Главное предупреждение раздела касается моделирования. Fugue, DuckDB и pandas обрабатывают данные быстро, но без хорошей модели данных никакая система не масштабируется. Хорошая модель задаёт структуру, связи сущностей, правильные типы и разумные индексы. Именно поэтому авторы посвятили моделированию главу 2.
Бонус: обучаем ML-модели на SQL
Заголовок раздела «Бонус: обучаем ML-модели на SQL»Звучит так, будто SQL заставляют делать то, для чего он не создан. Но библиотека dask-sql действительно открывает экосистему машинного обучения Python из SQL. Dask-sql — молодой экспериментальный SQL-движок поверх распределённой библиотеки Dask. Он соединяет Python и SQL и считает распределённо.
Ставится через pip install dask-sql. Работа начинается с контекста: c = Context(). В контексте выполняют обычные запросы с фильтрами, агрегатами и соединениями, а также особые команды для обучения и проверки моделей. Авторы читают открытый набор данных Iris в Dask DataFrame через dd.read_csv() и регистрируют его как таблицу iris методом c.create_table(). После этого к данным можно обращаться на SQL через c.sql("select * from iris").
Дальше идут расширения SQL, которые добавляет dask-sql:
| Команда | Что делает в примере книги |
|---|---|
CREATE OR REPLACE MODEL clustering WITH (...) AS (SELECT ...) | Обучает модель. Здесь model_class = 'sklearn.cluster.KMeans', n_clusters = 3, признаки — четыре размера цветка из iris |
SHOW MODELS | Показывает обученные модели контекста, как SHOW TABLES показывает таблицы |
DESCRIBE MODEL clustering | Выводит гиперпараметры модели |
SELECT * FROM PREDICT (MODEL clustering, SELECT ...) | Применяет модель к строкам: относит каждый из первых 100 цветков к кластеру |
CREATE EXPERIMENT first_experiment WITH (...) | Перебирает гиперпараметры через GridSearchCV из scikit-learn: здесь n_clusters из списка 2, 3, 4 |
EXPORT MODEL clustering WITH (format = 'pickle', location = './clustering.pkl') | Сохраняет модель в файл pickle, чтобы использовать её в другом месте |
Dask-sql позволяет брать классы моделей из сторонних библиотек, например scikit-learn. Pickle — двоичный формат Python для сохранения и загрузки объектов. Авторы уточняют, что n_clusters в эксперименте выбран лишь для демонстрации. В реальном ML-проекте перебирают те гиперпараметры, которые важны для задачи и алгоритма: классификации или регрессии.
Итог авторов: dask-sql — мощный и многообещающий инструмент. Он позволяет готовить данные, обучать и проверять модели на привычном SQL. Но библиотека ещё экспериментальная, поэтому пользоваться ею нужно осторожно.
Итоги главы
Заголовок раздела «Итоги главы»Авторы завершают главу мыслью, что SQL остаётся надёжной опорой в быстро меняющемся мире данных. Он работает и с простыми таблицами, и со сложными моделями для бизнеса, а базы данных продолжают развиваться. Но инструменты хороши ровно настолько, насколько хорош тот, кто ими пользуется. analytics engineer должен постоянно учиться и следить за развитием SQL, СУБД и анализа данных.
Авторы замечают и ещё одну вещь: данных всё больше, поэтому роли дата-инженера, аналитика и data scientist всё чётче расходятся. Местами они пересекаются, но объём и сложность данных требуют узких навыков. analytics engineering — широкая и интересная область, и каждый запрос даёт повод что-то исследовать.
- SQL живёт долго благодаря читаемости, декларативному стилю, строгим типам и движкам, которые постоянно становятся быстрее.
- Пирамида DIKW показывает путь от сырых данных к мудрости, а база данных хранит её нижний уровень.
- SQL делится на четыре языка:
DDLдля структуры,DMLдля данных,DCLдля прав иTCLдля транзакций.analytics engineerв основном пишетDML. - Ограничения (первичный и внешний ключ,
UNIQUE,CHECK,NOT NULL) защищают целостность данных прямо в базе. WHEREфильтрует строки до группировки, аHAVING— готовые группы после неё.- Вид
JOINрешает, какие строки без пары попадут в результат.CROSS JOINдаёт все возможные пары. Viewхранит запрос, а не данные. Она упрощает доступ, но тормозит при сложной логике и не даёт настоящей защиты.CTEразбивают запрос на именованные шаги с одной обязанностью. На этом стиле строятся моделиdbt.- Оконные функции считают ранги, накопительные итоги и значения соседних строк и не схлопывают строки.
- DuckDB, Polars и FugueSQL дают SQL-интерфейс к DataFrame. Но без хорошей модели данных никакой инструмент не масштабируется.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| СУБД (DBMS) | Программа, которая создаёт базу данных, хранит данные и даёт с ними работать |
ACID | Свойства надёжных транзакций: атомарность, согласованность, изоляция, долговечность |
OLTP / OLAP | Транзакционная нагрузка (много мелких операций) / аналитическая нагрузка (большие запросы для отчётов) |
DDL / DML | Язык определения структуры / язык работы с данными |
Ограничение (constraint) | Правило для данных столбца: первичный и внешний ключ, UNIQUE, CHECK, NOT NULL |
| первичный ключ | Столбец, который однозначно определяет строку: без дубликатов и NULL |
| внешний ключ | Столбец, значения которого должны быть в первичном ключе другой таблицы |
JOIN | Соединение таблиц по условию: INNER, LEFT, RIGHT, FULL, CROSS |
view | Виртуальная таблица: сохранённый запрос, который не хранит данные |
soft delete | Мягкое удаление: строку помечают флагом вместо того, чтобы стирать её |
CTE | Именованный подзапрос через WITH, на который можно ссылаться в запросе |
| оконная функция | Расчёт по окну строк, при котором строки не схлопываются |
| distributed SQL | Одна логическая база на многих узлах с масштабированием и устойчивостью к сбоям |
lazy evaluation | Ленивое выполнение: движок сначала оптимизирует весь запрос, потом считает |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Модели
dbt— этоSELECTсCTE. Пишите каждыйCTEс одной задачей и понятным именем: так модель легко проверять по частям. - Перед
LEFT JOINдумайте оgrain: если у одной строки слева несколько пар справа, строки размножатся, и суммы окажутся завышены. - Для поиска дубликатов и «последней версии строки» используйте
ROW_NUMBER() OVER (PARTITION BY ключ ORDER BY дата DESC). Вstaging-моделях это один из самых частых приёмов. - Ограничения в хранилище (
data warehouse) часто не проверяются движком. Те же правила (unique,not_null, связи) вdbtзадают тестами, о них речь в главе 4. viewхороша для лёгкой логики. Тяжёлый запрос, который читают часто, лучше сохранить таблицей: вdbtэто выборmaterialization.- DuckDB удобен, чтобы проверить SQL локально и написать unit-тесты на модели, не трогая хранилище.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. Таблица ниже не зависит от примеров выше.
Шаг 1. Создаём выручку по месяцам
Заголовок раздела «Шаг 1. Создаём выручку по месяцам»Две категории товаров, по шесть месяцев каждая:
CREATE TABLE monthly_sales ASSELECT c.category, m.month, CASE c.category WHEN 'Книги' THEN 100 + m.month * 10 ELSE 80 + (m.month % 3) * 25 END AS revenueFROM (VALUES ('Книги'), ('Курсы')) AS c(category)CROSS JOIN generate_series(1, 6) AS m(month);Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»SELECT COUNT(*) AS row_count, COUNT(DISTINCT category) AS categoriesFROM monthly_sales;
-- Дубликаты пары «категория + месяц»: запрос должен вернуть 0 строкSELECT category, month, COUNT(*) AS nFROM monthly_salesGROUP BY category, monthHAVING COUNT(*) > 1;Первый запрос вернёт 12 строк и 2 категории, второй — пустой результат.
Задания
Заголовок раздела «Задания»1. Для категории «Курсы» посчитайте, на сколько выручка изменилась по сравнению с прошлым месяцем.
Решение
SELECT category, month, revenue, revenue - LAG(revenue) OVER (PARTITION BY category ORDER BY month) AS changeFROM monthly_salesWHERE category = 'Курсы'ORDER BY month;┌──────────┬───────┬─────────┬────────┐│ category │ month │ revenue │ change │├──────────┼───────┼─────────┼────────┤│ Курсы │ 1 │ 105 │ NULL ││ Курсы │ 2 │ 130 │ 25 ││ Курсы │ 3 │ 80 │ -50 ││ Курсы │ 4 │ 105 │ 25 ││ Курсы │ 5 │ 130 │ 25 ││ Курсы │ 6 │ 80 │ -50 │└──────────┴───────┴─────────┴────────┘У первого месяца нет предыдущего, поэтому LAG возвращает NULL.
2. Найдите лучший месяц каждой категории. Используйте CTE и ROW_NUMBER().
Решение
WITH ranked AS ( SELECT category, month, revenue, ROW_NUMBER() OVER (PARTITION BY category ORDER BY revenue DESC, month) AS rn FROM monthly_sales)SELECT category, month, revenueFROM rankedWHERE rn = 1ORDER BY category;┌──────────┬───────┬─────────┐│ category │ month │ revenue │├──────────┼───────┼─────────┤│ Книги │ 6 │ 160 ││ Курсы │ 2 │ 130 │└──────────┴───────┴─────────┘У «Курсов» 130 бывает во 2-м и 5-м месяце. Второй ключ сортировки month выбирает более ранний месяц, поэтому результат всегда одинаковый.
3. Для категории «Книги» посчитайте накопительную выручку с начала периода.
Решение
SELECT category, month, revenue, SUM(revenue) OVER (PARTITION BY category ORDER BY month) AS running_totalFROM monthly_salesWHERE category = 'Книги'ORDER BY month;┌──────────┬───────┬─────────┬───────────────┐│ category │ month │ revenue │ running_total │├──────────┼───────┼─────────┼───────────────┤│ Книги │ 1 │ 110 │ 110 ││ Книги │ 2 │ 120 │ 230 ││ Книги │ 3 │ 130 │ 360 ││ Книги │ 4 │ 140 │ 500 ││ Книги │ 5 │ 150 │ 650 ││ Книги │ 6 │ 160 │ 810 │└──────────┴───────┴─────────┴───────────────┘С ORDER BY внутри OVER сумма идёт от первой строки окна до текущей.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему декларативный стиль SQL помогает работать в команде, где есть аналитики, инженеры и data scientists?
- Чем
WHEREотличается отHAVING? Когда условие нельзя перенести изHAVINGвWHERE? - В каком случае
LEFT JOINиINNER JOINдают разный результат? Приведите пример на авторах и книгах. - Почему
viewне даёт настоящей защиты данных и когда она начинает тормозить? - Когда стоит выбрать
RANK(), а когдаROW_NUMBER()? Что произойдёт при одинаковых значениях? - Почему авторы считают, что даже быстрые DuckDB и Fugue не спасут без хорошей модели данных?
Предыдущая: Моделирование данных для аналитики. Следующая: Трансформация данных в dbt.