

Redefining Data Engineering with AI — конспект книги
Redefining Data Engineering with AI: Vibe Engineering Your Way to Data Democracy — книга Ashok Singamaneni, Sarath Chandra Bandaru, Phani Vemuri и Aditya Chaturvedi (O’Reilly). Она о том, как меняется работа дата-инженера, когда AI пишет SQL, тесты и документацию. Сейчас книга вышла в формате Early Release: авторы публикуют главы по мере написания, а полное издание запланировано на январь 2027 года. Пока доступны 2 главы из 9, и наш конспект охватывает обе.
Это подробный пересказ на русском, а не перевод. За полным текстом идите в оригинал.
📥 Скачать конспект в EPUB — для телефона и электронной книги.
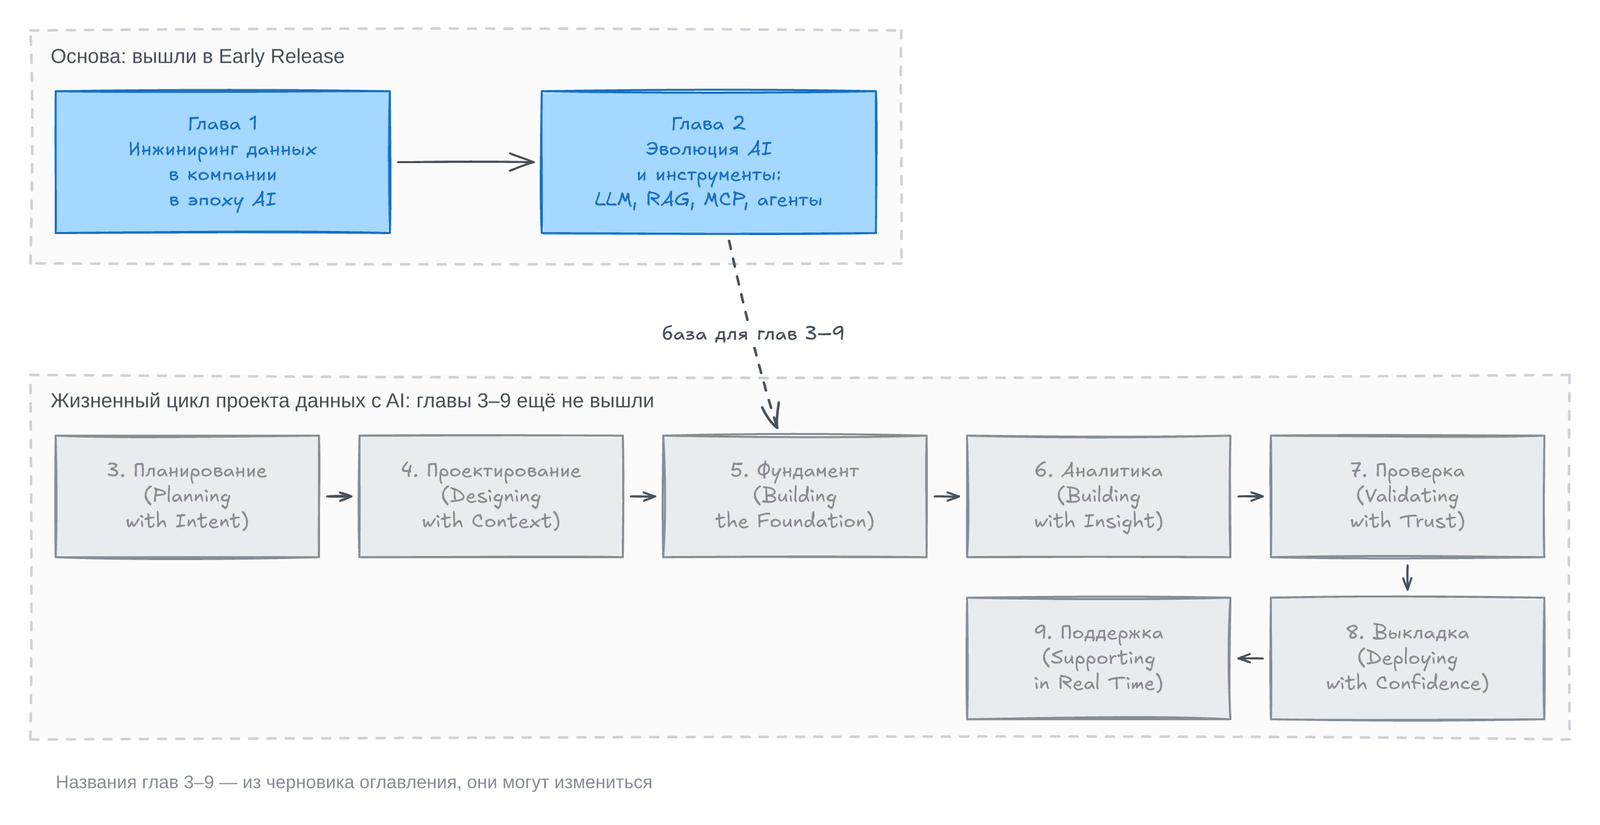
Как читать карту. Синие блоки — главы, которые уже вышли: первая объясняет, зачем компании инжиниринг данных в эпоху AI, вторая — какие инструменты AI есть. Серые блоки — следующие главы из черновика оглавления. Они идут по шагам проекта, от планирования до поддержки, и их названия ещё могут измениться.
О чём книга простыми словами
Заголовок раздела «О чём книга простыми словами»AI уже умеет писать шаблонный SQL, заготовки тестов и документацию. Многие поэтому решают, что дата-инженеры скоро станут не нужны. Авторы считают иначе: без надёжных данных AI в компании так и остаётся экспериментом. Модель знает только публичные данные, а о клиентах, заказах и правилах компании ей рассказывает дата-инженер через pipeline, RAG и MCP.
У быстрого AI есть и обратная сторона. Он порождает AI slop — код и документы, которые выглядят верно и проходят базовые проверки, но ошибаются по смыслу. Такие ошибки копятся как смысловой долг. Поэтому главной частью работы становится контроль со стороны человека: проверка смысла, data governance, оценка и чистка.
Главная модель книги такая. AI — напарник, а не замена. Рутину он берёт на себя, а дата-инженер отвечает за бизнес-логику, качество данных и правила доступа. Авторы называют такую совместную работу vibe engineering: человек сочетает данные, модель и собственное понимание бизнеса.
Что нужно знать заранее
Заголовок раздела «Что нужно знать заранее»- Основы инжиниринга данных:
pipeline, хранилище,ETL. Если их нет, начните с конспекта Fundamentals of Data Engineering. - Качество данных и
lineage: полезен конспект Data Quality Fundamentals. - SQL. Практика во второй главе написана на DuckDB.
- Python нужен, чтобы запустить два скрипта из второй главы.
- Опыт в ML не нужен: вторая глава сама объясняет, как устроены LLM. Подробнее о моделях — в конспекте AI Engineering.
Зачем читать
Заголовок раздела «Зачем читать»- Чтобы объяснить руководству, почему инжиниринг данных — основа AI, а не служба поддержки для аналитиков.
- Чтобы понять, что такое
data governanceи сколько оно приносит, по оценкам авторов. - Чтобы видеть, где AI действительно экономит время, а где создаёт
AI slop. - Чтобы получить план внедрения AI в команду: культура,
quality gate,shadow mode. - Чтобы разобраться в
RAG,MCPи агентах на примере из жизни, а не на абстракциях.
Как устроена книга
Заголовок раздела «Как устроена книга»В черновике оглавления 9 глав. Первые две дают основу, остальные идут по жизненному циклу проекта данных.
| Часть | Главы | О чём |
|---|---|---|
| Основа (вышли) | 1–2 | Зачем компании инжиниринг данных в эпоху AI. Какие инструменты AI есть и как они устроены |
| Жизненный цикл (ещё не вышли) | 3–9 | Планирование, проектирование, фундамент, аналитика, проверка, выкладка и поддержка с AI |
Первая глава ставит задачу: AI меняет работу, но не отменяет данные и правила. Вторая глава даёт инструменты, на которых строятся остальные главы. Конспект обновим, когда выйдут новые главы.
Главные идеи
Заголовок раздела «Главные идеи»| Идея | Глава |
|---|---|
| Код отвечает на вопрос «как», данные — на вопрос «что» | 1 |
Данными управляют как продуктом: пользователи, SLA, data contract | 1 |
Data governance устроено как три ветви власти: правила, исполнение, контроль | 1 |
| На общей платформе каждая следующая AI-задача стоит всё дешевле | 1 |
AI slop копится как смысловой долг, и его останавливает человек | 1 |
Transformer и scaling law объясняют рывок LLM | 2 |
RAG даёт модели знания компании без переобучения | 2 |
MCP — общий протокол для доступа AI к системам | 2 |
| Узкие агенты в команде надёжнее одного большого агента | 2 |
Как читать
Заголовок раздела «Как читать»- Новичок: читайте по порядку. Первая глава объясняет, зачем нужна профессия, а вторая — на чём строится AI.
- Analytics engineer: в первой главе важны разделы о
data productиAI slop, во второй — оprompt engineeringиRAG. - Дата-инженер: главное — вторая глава:
RAG,MCP, агенты и практика в DuckDB. В первой главе прочтите план внедрения AI в команду. - Руководитель: первая глава целиком:
ROIотdata governance, эффект платформы и роль культуры при внедрении AI.
Как работать с практикой
Заголовок раздела «Как работать с практикой»Практика есть только во второй главе, потому что в первой главе кода нет.
- SQL в DuckDB. Блоки идут по порядку в одной сессии
duckdbили на shell.duckdb.org. Задания повторяют идеи главы: продажи по категориям, поискchunkпо сходству и выбор документов для переиндексации. - Python. Два скрипта лежат в scripts/redefining-de-ai-code. Они используют только стандартную библиотеку и работают без платных API.
- Примеры из репозитория книги с
MCP serverи агентами пока не запускаются: репозиторий ещё не открыт, и для них нужен LLM API.
Разбор по главам
Заголовок раздела «Разбор по главам»| Глава | О чём |
|---|---|
| 1. Инжиниринг данных в компании в эпоху AI | Зачем компании инжиниринг данных и data governance, что AI упрощает и почему нужен контроль со стороны человека |
| 2. Эволюция AI и инструменты | Как появились LLM и как устроены prompt engineering, RAG, MCP, агенты и интерфейсы AI |
Следующая: Инжиниринг данных в компании в эпоху AI.