

Claude AI Bible, глава 17: Anthropic API
Главная мысль: API — основа всех продуктов Claude. Он нужен для работы без человека, внутри другой программы или в большом объёме, а для разговоров чат лучше и дешевле.
О чём глава
Заголовок раздела «О чём глава»Прошлые главы, вплоть до главы о MCP, говорили о готовых продуктах. API — это базовая платформа, на которой они построены. С ним вы уже не пользуетесь готовым продуктом, а строите своё. Поэтому дальше автор пишет для тех, кто не боится терминала и пары строк кода, а программистом быть необязательно. Темы главы: когда брать API, ключ, первый вызов, устройство запроса, история, streaming, цена, prompt caching, Batch API и ошибки.
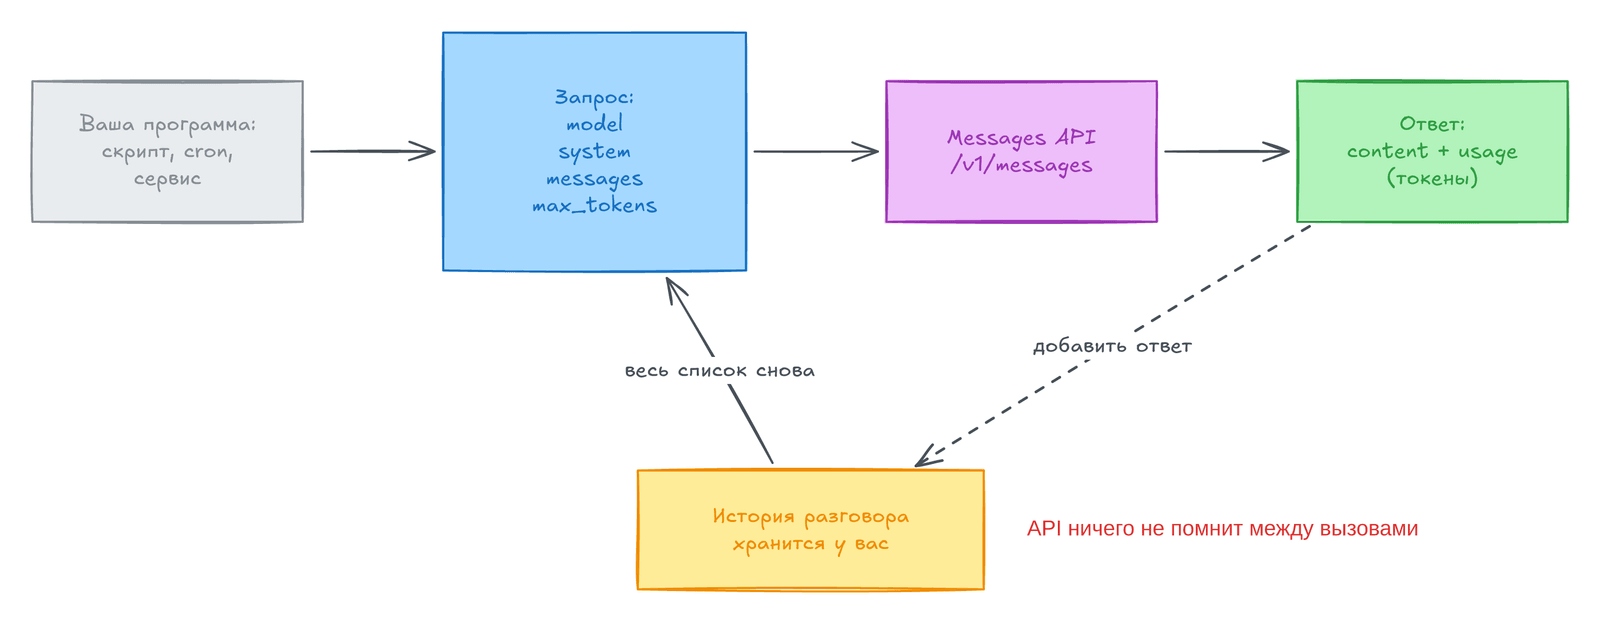
Схему читают слева направо, а потом по нижней петле: API ничего не помнит, поэтому историю каждый раз отправляете вы.
Когда API подходит, а когда нет
Заголовок раздела «Когда API подходит, а когда нет»Автор сначала отговаривает от API: самая дорогая ошибка — писать код там, где хватило бы подписки. Если работу ведёт человек, по одному разговору, то чат-приложение быстрее, дешевле и безопаснее. В нём уже есть загрузка файлов, память проекта и фиксированная цена за месяц, а на API то же самое строят неделями.
API нужен в трёх случаях: работа идёт без человека (по расписанию или событию), Claude работает внутри другой программы (читает из базы, пишет в CRM) или одна операция повторяется тысячи раз. Если чат вас устраивает, оставайтесь в нём. Но мысль «пусть это работает каждое утро» или «для каждой строки файла» означает, что пора на API.
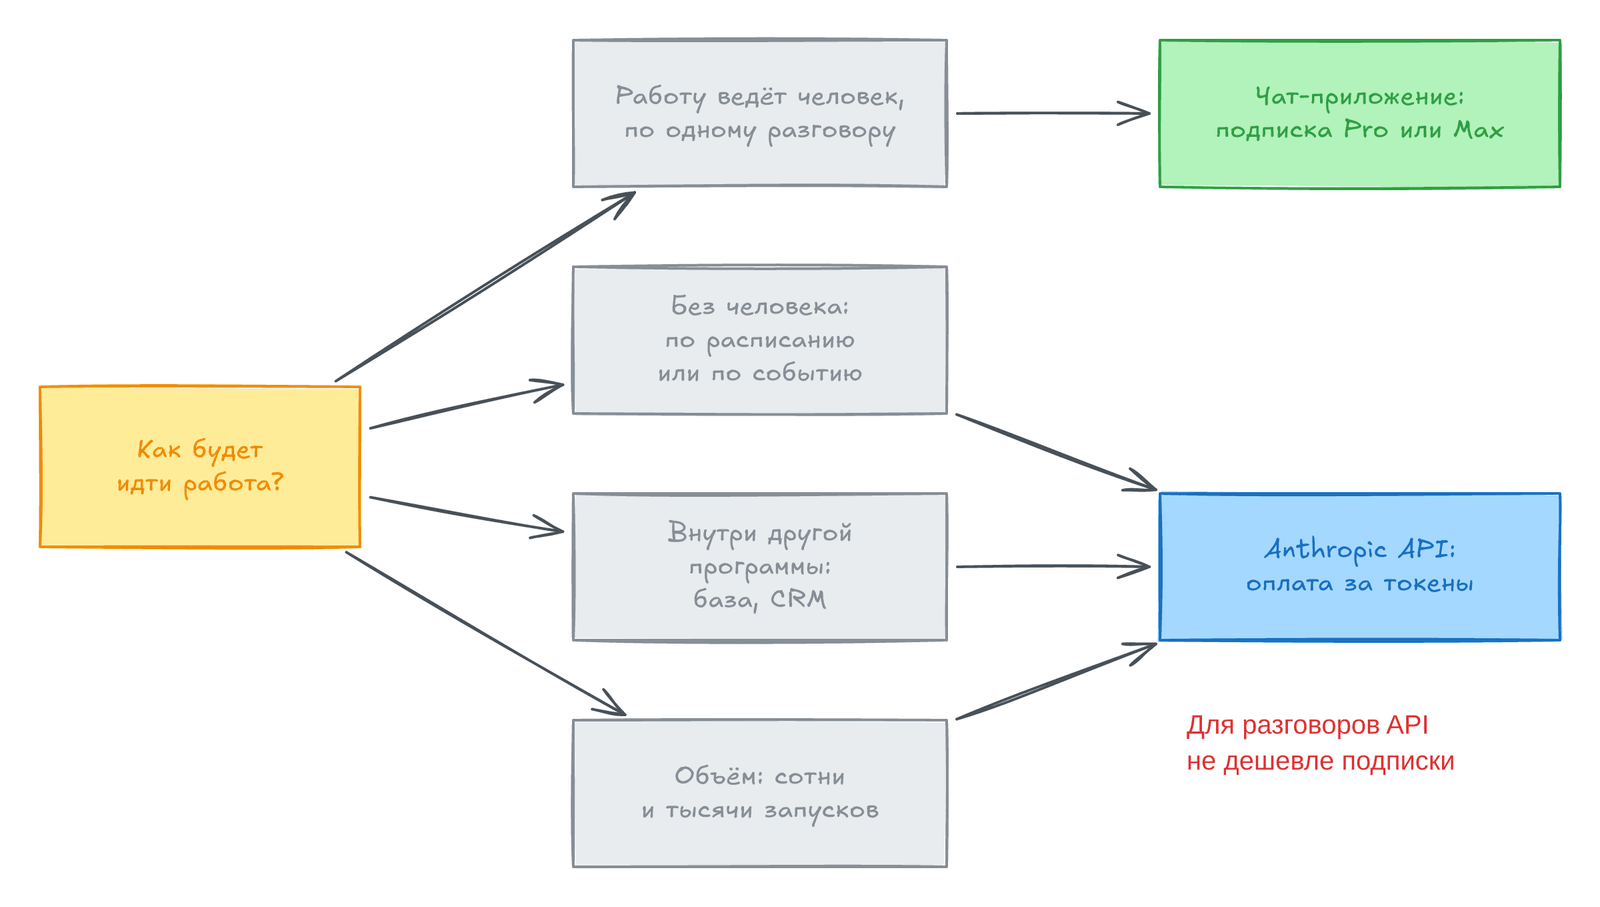
Многие считают API дешёвой заменой Pro или Max, но это ошибка. API оплачивается за токены и отдельно от подписки (глава 4), поэтому самодельный чат-бот обычно выходит дороже и хуже. API экономит на автоматизации и объёме, а не на разговорах.
Аккаунт и ключ без сожалений
Заголовок раздела «Аккаунт и ключ без сожалений»API оплачивается отдельно, через Anthropic Console (console.anthropic.com). Организацию компании автор советует заводить на общую почту, а не на личную.
API-ключ — это секретная строка sk-ant-..., по которой Anthropic узнаёт вас и выставляет счёт. Кто знает ключ, тот может тратить ваши деньги и читать, что ваше приложение отправляет Claude, поэтому правила такие:
- Не кладите ключ в код репозитория: боты постоянно ищут такие строки на GitHub.
- Храните его в переменной окружения, а на сервере — в менеджере секретов.
- Давайте каждому приложению свой ключ, чтобы при утечке отозвать только его.
- Задайте лимит расходов в Console и меняйте ключи по графику, особенно после ухода сотрудника.
Задание автора: создать ключ book-experiments и лимит $10, которого хватит на всю главу.
export ANTHROPIC_API_KEY="sk-ant-..." # ключ живёт в окружении, а не в кодеpip install anthropic==2.8.0Messages API и первый вызов
Заголовок раздела «Messages API и первый вызов»Почти всё идёт через один endpoint — Messages API: вы отправляете разговор с настройками и получаете следующее сообщение Claude. Даже вызов инструментов и зрение (vision) — вариации этого вызова. Автор показывает его через curl, а потом через Python SDK, который сам читает ключ из окружения и отдаёт текст как message.content[0].text. Новый запрос автор советует сначала собрать в Workbench, песочнице Console, а затем выгрузить оттуда готовый код.
Устройство запроса
Заголовок раздела «Устройство запроса»Большую часть работы несут четыре поля:
| Поле | Что задаёт |
|---|---|
model | Модель: claude-opus-4-8 для трудных задач, claude-sonnet-4-6 для обычных, claude-haiku-4-5-20251001 для массовых |
messages | Разговор: ходы с ролью user (вы) или assistant (Claude) |
system | System prompt: роль, правила и контекст на весь разговор |
max_tokens | Обязательный жёсткий потолок длины ответа в токенах |
Имена моделей меняются, их сверяют с docs.claude.com. Самое сильное поле — system, хотя новички о нём забывают: в примере автора оно делает из Claude аналитика грузовой компании, который называет допущение за каждой цифрой. А max_tokens — не цель, а предохранитель: он обрывает слишком длинный ответ и ограничивает цену вызова. Обычно Claude заканчивает ответ раньше.
Поле content бывает строкой или списком блоков для картинок и инструментов (глава 19). Из необязательных полей temperature (от 0 до 1) задаёт случайность: низкое значение нужно для извлечения и классификации, высокое — для идей. Кроме того, stop_sequences останавливает ответ на заданной строке, а metadata помечает запрос для учёта.
Пояснение: в SDK
anthropic2.8.0 уmessages.createнет аргументаtemperature. Прежде чем на него полагаться, проверьте документацию для своей модели.
Многошаговый разговор: память держите вы
Заголовок раздела «Многошаговый разговор: память держите вы»API не хранит состояние (stateless): между вызовами он ничего не помнит. Чтобы продолжить, вы добавляете в messages ответ Claude с ролью assistant, затем новый вопрос и отправляете всё заново. Автор видит в этом плюс, потому что вы решаете, что видит модель: историю можно обрезать, править и хранить в своей базе. Но каждый ход дороже прошлого, ведь вы снова платите за всю историю.
Если многошаговый разговор (multi-turn) ведёт себя странно, напечатайте messages. Роли должны чередоваться и начинаться с user, иначе будет ошибка.
Streaming
Заголовок раздела «Streaming»Без streaming API отдаёт ответ целиком, а со streaming текст приходит частями, как в чате. Человеку так кажется быстрее, а длинный ответ реже упирается в таймаут. В SDK text_stream отдаёт куски текста, а get_final_message() в конце возвращает весь ответ вместе с числом токенов. Однако для фоновых задач streaming только усложняет код.
Управление ценой
Заголовок раздела «Управление ценой»Платят за входные токены (всё, что отправили) и выходные (ответ), причём выходные дороже. Рычагов четыре:
- Модель. Это самый сильный рычаг: цены отличаются в разы. Opus нужен для трудного анализа и кода, Sonnet — для середины, Haiku — для массовой классификации и извлечения. Автор часто ставит Haiku первым проходом, а спорное отдаёт Sonnet или Opus.
- Низкий
max_tokens: ждёте абзац — ставьте 300, а не 4096. - Короткая история: старые ходы заменяют кратким пересказом или отправляют только несколько последних.
stop_sequences: генерация останавливается на метке вродеEND_OF_LIST.
Например, управляющая компания в Манчестере отвечала жильцам через Opus и платила около £400 в месяц. Около 70% писем были простыми, их отдали Haiku, сложные споры оставили Sonnet, а system prompt сделали строже, чтобы ответы стали короче. В итоге счёт упал ниже £60, а жильцы разницы не заметили.
Prompt caching
Заголовок раздела «Prompt caching»Если каждый вызов несёт тот же длинный system prompt или полис на 50 страниц, вы каждый раз платите за неизменный текст. Prompt caching хранит помеченное начало запроса у Anthropic. Первый вызов немного доплачивает за запись, а следующие платят за эту часть малую долю цены и отвечают быстрее.
Отсюда правило: стабильное — в начало, меняющееся — в конец. Срок жизни кэша и скидку автор советует сверять с документацией, потому что они меняются.
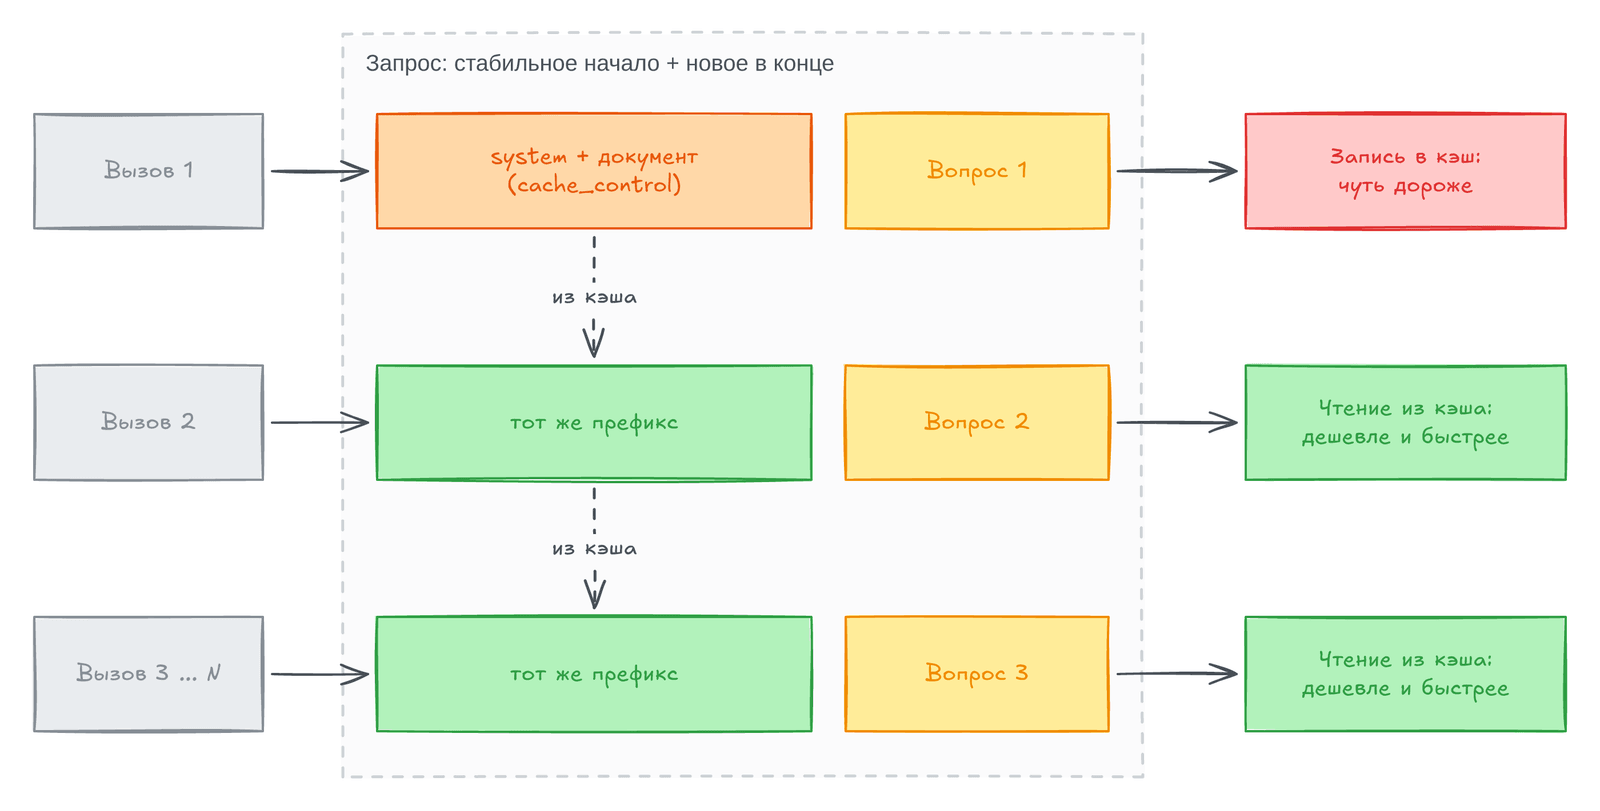
Ниже наш вариант запроса с кэшем. Это настоящий вызов: нужен ключ, и он стоит денег.
import anthropic
client = anthropic.Anthropic()  # ключ берётся из ANTHROPIC_API_KEYPOLICY = open("policy.txt", encoding="utf-8").read()  # тысячи токенов, одинаковы в каждом вызове
message = client.messages.create(    model="claude-sonnet-4-6",    max_tokens=1024,    system=[{"type": "text", "text": POLICY,             "cache_control": {"type": "ephemeral"}}],  # кэшировать это начало    messages=[{"role": "user", "content": "Покрывает ли полис протечку из лопнувшей трубы?"}],)print(message.content[0].text)
Batch API для больших асинхронных задач
Заголовок раздела «Batch API для больших асинхронных задач»Messages API синхронный, поэтому 10 000 вызовов в цикле идут медленно и упираются в лимиты. Batch API принимает их одним пакетом и обрабатывает в фоне, обычно за сутки. Вы теряете скорость, но получаете скидку и объём без забот о лимитах. Ответы сопоставляют со входом по custom_id. Если никто не ждёт каждый ответ, например при описании товаров для каталога или разметке 200 отзывов по темам, автор советует именно Batch API.
Лимиты, повторы и обработка ошибок
Заголовок раздела «Лимиты, повторы и обработка ошибок»Код, который ходит по сети, будет падать. Лимит запросов (rate limit) ограничивает запросы и токены в минуту и растёт с уровнем аккаунта (usage tier). Превышение даёт код 429, и это не баг, а просьба сбавить темп.
На 429, 500 и 529 (перегрузка) отвечают повтором запроса (retry) с паузой, которая каждый раз удваивается, плюс небольшая случайная добавка (backoff). SDK делает это сам. А вот 400 (плохой запрос), 401 (неверный ключ) и 403 (нет прав) повторять бесполезно, их надо исправить.
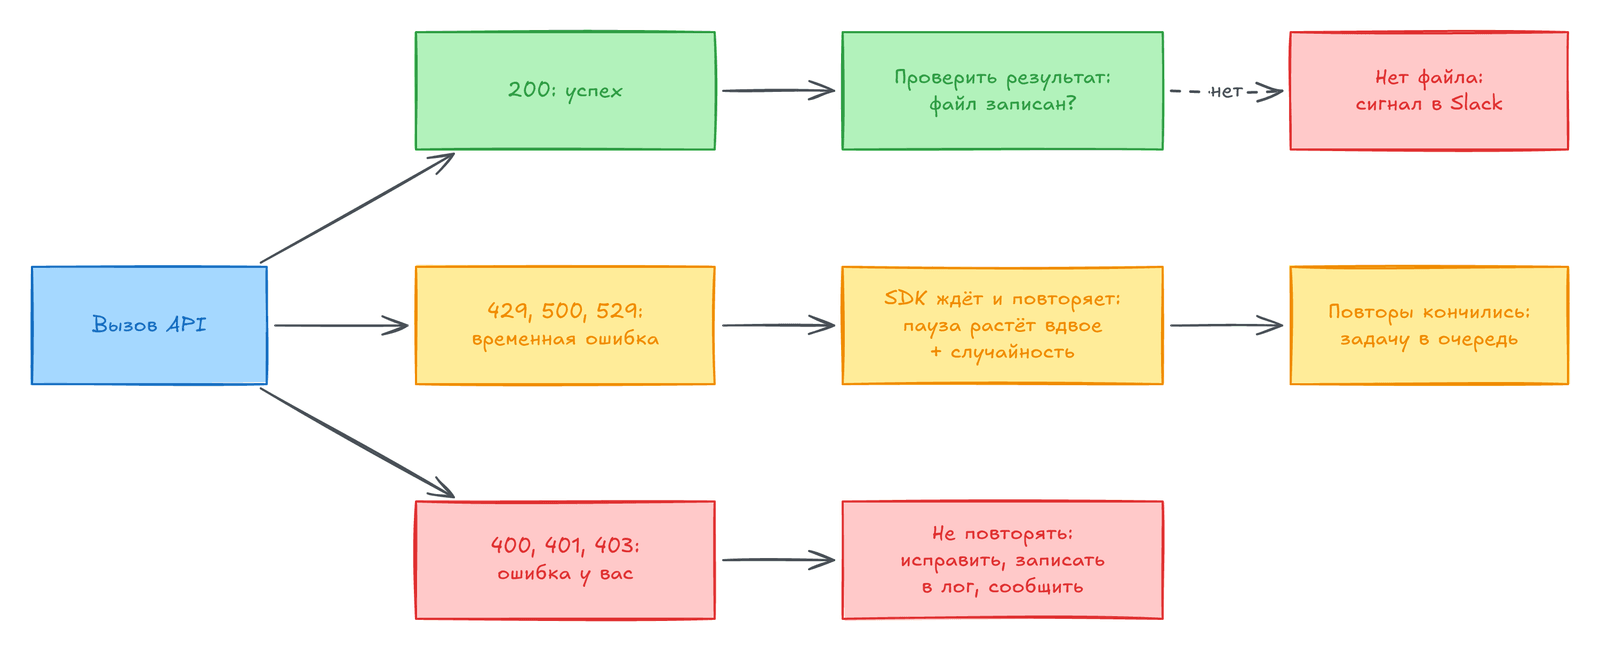
Итак, временные сбои повторяет SDK, постоянные громко пишут в лог, а успех задачи проверяют явно. Например, финтех в Сингапуре каждую ночь раскладывал транзакции по категориям. Однажды API отвечал 529, повторов в коде не было, и задача молча падала девять дней, а пустую папку с отчётами команда сочла признаком затишья. Исправление заняло полдня: повторы, сигнал в Slack при отсутствии файла и идемпотентность, чтобы повторный запуск не считал транзакцию дважды. Однако восстанавливать разметку за девять дней пришлось гораздо дольше.
Итоги главы
Заголовок раздела «Итоги главы»- API нужен для работы без человека, внутри других программ и в большом объёме, но для разговоров он не дешевле подписки.
- API-ключ хранят в окружении или менеджере секретов, свой на каждое приложение и с лимитом расходов.
- Запрос состоит из
model,messages, необязательногоsystemи обязательногоmax_tokens. - API не хранит состояние, поэтому вы отправляете и оплачиваете историю в каждом вызове.
- Самый сильный рычаг цены — выбор модели, затем
max_tokensи короткая история. Prompt cachingудешевляет повторяющееся начало запроса, аBatch APIменяет скорость на скидку.- Ошибки 429 и 5xx повторяют с
backoff, остальные ошибки 4xx исправляют, а сбой должен быть заметен.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Messages API | Главный endpoint: разговор на входе, сообщение Claude на выходе |
stateless | API не помнит прошлые вызовы |
streaming | Ответ приходит частями |
prompt caching | Неизменное начало запроса в кэше стоит дешевле |
Batch API | Пакет запросов в фоне со скидкой |
лимит запросов (rate limit) | Запросы и токены в минуту |
повтор запроса (retry) | Повтор после временной ошибки с паузой (backoff) |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Разметку тысяч строк отдавайте Haiku через
Batch API, а не циклу синхронных вызовов. - Ключ храните в секретах оркестратора (Airflow, CI), а не в коде DAG.
- Задача с LLM по расписанию проверяет свой результат, а её перезапуск не дублирует строки.
Код главы
Заголовок раздела «Код главы»Все примеры книги вызывают платный API, поэтому мы проверили их без ключа (ch17_api_mock.py). Работает настоящий SDK anthropic, но запросы ловит поддельный HTTP-транспорт, а ответы и токены (слово = токен) выдуманы.
def fake_api(request):    body = json.loads(request.content)       # что SDK отправил в API    calls.append(body)    status = plan.pop(0) if plan else 200   # заранее заданные коды ошибок    ...
client = anthropic.Anthropic(api_key="sk-ant-fake", max_retries=4,                             http_client=httpx2.Client(transport=httpx2.MockTransport(fake_api)))
1. Что уходит в API поля запроса: max_tokens, messages, model, system текст ответа: ответ номер 1 | usage: 14 / 32. История хранится у вас сообщений: 1, роли: u, input_tokens: 5 сообщений: 3, роли: u-a-u, input_tokens: 15 сообщений: 5, роли: u-a-u-a-u, input_tokens: 233. Ошибки и повторы перегрузка 529, 529, потом успех: попыток 3, итог: успех лимит 429 пять раз подряд: попыток 5, итог: RateLimitError: отложить задачу в очередь плохой запрос 400: попыток 1, итог: BadRequestError 400: не повторять, записать в логВходных токенов с каждым ходом больше. Ошибку 529 SDK повторил сам, на 429 сдался после пяти попыток, а 400 повторять не стал.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему самодельный чат-бот на API обычно не экономит деньги?
- Почему каждый ход разговора через API дороже прошлого, и что с этим делать?
- Когда
streamingнужен, а когда мешает? - Как сложить части запроса, чтобы
prompt cachingработал? - Какие ошибки API повторять, а какие нет, и почему?
Предыдущая: Model Context Protocol (MCP). Следующая: Claude Agent SDK.