

Redefining Data Engineering with AI, глава 2: Эволюция AI и инструменты
Главная мысль: рывок современным LLM дала архитектура transformer 2017 года, но сама модель знает только публичные данные. Чтобы она работала в компании, вокруг неё строят слои: prompt, RAG для внутренних знаний, MCP для доступа к системам и агентов. Дата-инженер отвечает за «память» AI: данные для модели должны быть свежими и точными.
О чём глава
Заголовок раздела «О чём глава»Глава отвечает на вопрос: какие инструменты AI уже есть и как они устроены. В первой главе авторы объяснили, зачем компании инжиниринг данных в эпоху AI, а здесь дают техническую базу для всей книги. Сквозной пример — библиотека: книги, полки, посетители и библиотекари.
- История LLM: от первых нейросетей до
transformer, GPT-3 и конкурентов. Prompt engineeringиvibe engineering.RAG,MCP, агенты и интерфейсы AI.
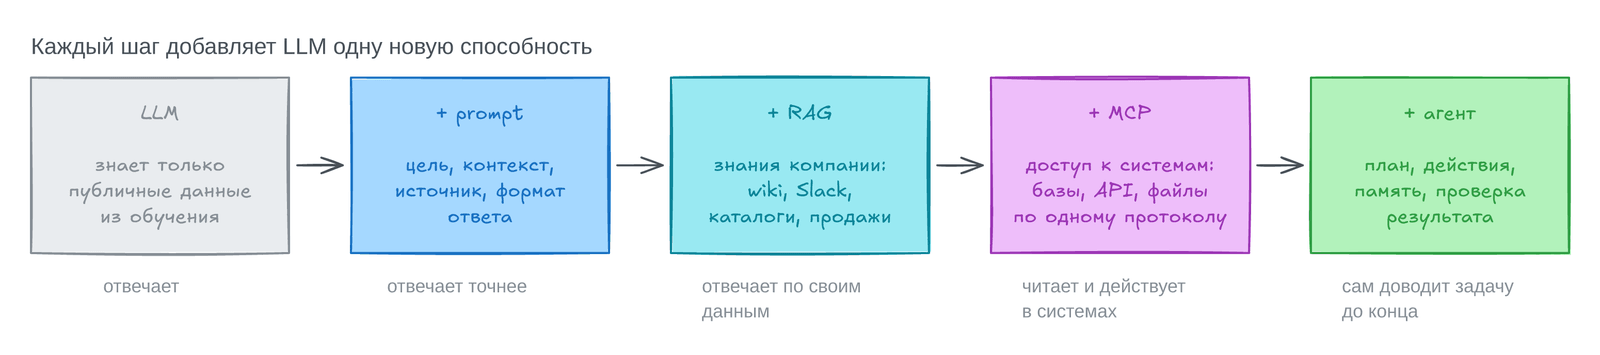
Схему читают слева направо: каждый блок добавляет модели одну способность, и глава разбирает их в том же порядке.
Откуда взялись LLM
Заголовок раздела «Откуда взялись LLM»Авторы сравнивают появление LLM с книгопечатанием: знания немногих стали доступны всем. Нейросети были и в 1980-х, но медленные и плохо масштабируемые. Рывок случился, когда сети научились обрабатывать текст параллельно. Ответ модель по-прежнему пишет слово за словом, но «видит» при этом весь контекст сразу.
Основа: от вычислителей к нейросетям
Заголовок раздела «Основа: от вычислителей к нейросетям»Первые компьютеры 1940–1950-х годов только считали по чужой инструкции. Алан Тьюринг спросил: можно ли сделать машину, которая сама учится и приспосабливается? С этого вопроса и началась история AI.
Нейросеть — это сеть связанных математических функций, которые работают как клетки мозга. Её так назвали не потому, что она копирует мозг, а потому, что повторяет принцип связей между его клетками. Чем больше данных получала сеть, тем больше связей (параметров) она формировала и тем умнее становилась. Но ранним сетям не хватало вычислений, хранилищ и алгоритмов.
В 1990-х машинное обучение вернулось как практический инструмент: машины учились на данных, а не по правилам. В 2006 году Джеффри Хинтон с командой возродил многослойные сети, и это направление назвали глубоким обучением (deep learning). Однако на практике большинство сетей ещё оставались неглубокими, в 1–3 скрытых слоя, и плохо понимали язык.
После успеха AlexNet в распознавании картинок глубокое обучение пришло в работу с текстом. Появились RNN, LSTM и GRU — сети, которые читают текст по порядку и стараются помнить прочитанное. Длинные тексты им не давались: пока сеть дочитывала текст до конца, его начало уже стиралось из её памяти. Нужна была модель, которая смотрит на всё предложение сразу.
Революция transformer
Заголовок раздела «Революция transformer»В 2017 году команда Google Research опубликовала статью «Attention Is All You Need» и ввела архитектуру transformer. Она отказалась от RNN в пользу self-attention — механизма, при котором каждое слово текста «смотрит» на все остальные. Так модель напрямую видит связь любых двух слов, даже если одно на первой странице, а другое на сотой.
Почему это масштабируется? Модель оценивает связь каждого слова с каждым одновременно. Это похоже на команду библиотекарей над огромной книгой: её не читает от корки до корки один человек, а каждый сразу спрашивает коллег, как его слово связано с их словами. У каждого слова при этом три роли:
| Роль | Что значит |
|---|---|
Query | что ищет это слово |
Key | с чем его сравнивают |
Value | какой смысл берут из найденного слова |
Модели не нужно «помнить» начало текста: она видит его целиком и сама решает, куда смотреть. В архитектуре есть и другие части: encoder читает вход, decoder порождает выход, positional encoding хранит порядок слов, а multi-head attention смотрит на текст с нескольких сторон сразу.
Авторы не уходят в математику. Им важно показать, что transformer — скачок, построенный на прежних архитектурах машинного обучения, и что развитие на нём не остановилось. В 2025 году Google опубликовала работу Nested Learning: модель учится на нескольких уровнях, один внутри другого, маленькими шагами. Цель — долгая память под конкретного пользователя, чтобы AI помнил ваши вкусы годами.
Что такое LLM
Заголовок раздела «Что такое LLM»Термин «LLM» появился около 2018 года и обозначал не одну архитектуру, а класс моделей. После transformer исследователи вывели scaling law: качество сети резко растёт с объёмом данных, числом параметров и вычислений. Масштаб стал главной стратегией, а transformer — её средством.
Итак, LLM — это семейство моделей, обученных на огромном корпусе текста. Они пишут текст, похожий на человеческий, и чаще всего построены на transformer. В книге слова «LLM» и «AI» — синонимы. Первой громкой моделью стала BERT от Google (2018). Она показала силу контекстных embedding, но текст сама не порождала: это только encoder.
Вехи развития
Заголовок раздела «Вехи развития»Взрыв начался в 2020 году с GPT-3 от OpenAI: 175 млрд параметров и 45 ТБ текста для обучения.
GPT-3: первая большая генеративная модель
Заголовок раздела «GPT-3: первая большая генеративная модель»GPT-3 — это transformer, который предсказывает следующий токен. Её сила в масштабе: модель писала эссе, код и песни, часто неотличимые от человеческих. Мир встретил её с восторгом и тревогой. GPT-3 показала, что большая модель решает новые задачи без настройки под каждую. Это называют zero-shot: задача решается без примеров в prompt.
У следующих версий, на которых работает ChatGPT, по словам авторов, уже триллионы параметров. С ними пришла мультимодальность. Модальность — это вид данных: текст, картинки, звук, видео. Дата-инженеры знают это разнообразие по большим данным. GPT-3 училась в основном на тексте и коде, а новые модели — и на других форматах, закодированных в понятный модели вид.
Позже модели научились рассуждать: решать задачи по шагам и объяснять каждый шаг. Появился few-shot: модель осваивает задачу по нескольким примерам в prompt. По мнению авторов, с этого момента AI начал «думать».
Конкуренты
Заголовок раздела «Конкуренты»Открытые модели и стартапы быстро догнали OpenAI. Авторы выделяют несколько семейств:
| Семейство | Что важно |
|---|---|
| Llama (Meta) | Открытые модели с 2023 года. Llama 3 (2024) бесплатна и спорит на тестах с закрытыми моделями |
| Claude (Anthropic) | С 2023 года, с упором на безопасность: полезный, честный, безвредный. Claude 3 (Haiku, Sonnet, Opus) добавил рассуждение, код и картинки |
| Qwen (Alibaba) | Модели разных размеров, сильные в рассуждении и в работе на многих языках |
| Hunyuan (Tencent) | Подход «модель знаний», а не только «модель языка» |
Следующим рубежом стало рассуждение. GPT-4 Turbo, Claude 3 Opus, DeepSeek-Coder и Qwen-Max решают задачи по шагам, пишут код, объясняют логику и ищут ошибки. Таких моделей учат на логических задачах, доказательствах и программировании. Мультимодальные GPT-4V, Claude 3 Sonnet и Gemini понимают картинки, звук и видео. Следующий шаг авторы видят в автономных агентах.
Prompt engineering
Заголовок раздела «Prompt engineering»Авторы предлагают небольшой эксперимент. Спросите чат от лица библиотекаря: «Как расставить книги?» Ответ будет общим: по алфавиту, жанру или цвету. Теперь добавьте детали: 200 книг в мягкой обложке, 50 больших в твёрдой, две полки, серии романов держать вместе, большие книги поставить вниз. В ответ придёт готовый пошаговый план. Разница в контексте и цели. Запрос к модели называют prompt, а умение составлять его точно — prompt engineering.
Модель видит prompt как токены. Токен — это кусок текста: слово, часть слова или символ. Долгой памяти у модели нет, её ограничивает context window — сколько токенов она видит за раз. Если токены — кирпичи, то context window — полка, и данные должны на ней поместиться.
Расплывчатый prompt даёт путаный и даже ложный ответ, а продуманный — точный. По мнению авторов, хороший prompt не хитрый, а ясный, и этому можно научиться. Они дают четыре правила.
Ясная цель
Заголовок раздела «Ясная цель»Начните с результата. Вместо «Напиши продающий текст» лучше: «Напиши текст на 150 слов о SaaS-продукте для средних компаний в США, сделай упор на ROI и добавь призыв к действию».
Контекст
Заголовок раздела «Контекст»Без контекста модель угадывает. Даже фраза «я тороплюсь» сообщает ей о ваших нуждах. Писать страницы не обязательно, но чем больше вы скажете сразу, тем лучше ответ. В инжиниринге данных контекст огромный, и как строить его шаг за шагом, авторы покажут дальше и в главе 3.
Источник
Заголовок раздела «Источник»Модель впитала весь интернет, включая фейки. Назовите надёжный источник. Вместо «Расскажи про AI в HR» лучше: «Опираясь на официальный блог Microsoft и экспертов LinkedIn, объясни, как AI меняет найм в 2025 году».
Ожидания от ответа
Заголовок раздела «Ожидания от ответа»Скажите, какой нужен формат и тон. Вместо «Напиши отчёт» лучше: «Резюме для руководства на 300 слов, уверенным тоном, 3 вывода и одна рекомендация».
Освоив основы, можно перейти к двум приёмам следующего уровня:
chain-of-thought— попросить модель рассуждать по шагам до ответа. Например: «Реши 3x + 5 = 14 по шагам, не пропускай очевидное и только в конце дай ответ».- Пошаговое уточнение — не останавливаться на первом ответе и просить: «Сделай короче и живее».
Авторы хотят не «выжать больше из AI», а вести его, и это нужно не только инженерам, но и аналитикам, менеджерам и HR.
Vibe engineering
Заголовок раздела «Vibe engineering»Что делать, когда AI ответил и пора действовать? Можно ли доверять ответу, если решение опирается на внутренние данные? Здесь авторы вводят vibe engineering — по их словам, самую спорную и самую нужную часть революции AI. Суть — согласовать данные, модели и интуицию человека, чтобы не только найти ответ, но и «почувствовать» верный путь. Вопрос меняется с «Верен ли ответ?» на «Совпадает ли ответ с моим чутьём?». Спорным подход делает то, что его трудно измерить, и он кажется субъективным.
Авторы предлагают видеть в AI команду инженеров разного уровня и каждый раз спрашивать, какую роль он сейчас играет:
| Роль AI | Что делает |
|---|---|
| Стажёр | Усваивает шаблоны |
| Разработчик среднего уровня | Пишет код по контексту |
| Старший разработчик | Подстраивается под prompt |
| Исследователь с PhD | Рассуждает и понимает, что стоит за вопросом |
Нужно знать, когда AI — инструмент, когда проводник, когда критик, а когда напарник. «Самым сильным будет не тот AI, который знает больше всех, а тот, который знает, когда сменить роль», — пишут авторы.
RAG: модель отвечает по данным компании
Заголовок раздела «RAG: модель отвечает по данным компании»LLM обучены на публичных данных, поэтому внутренних процессов и документов компании они не знают. Авторы сравнивают модель с новым сотрудником, который первым делом изучает, как всё устроено в компании. RAG (retrieval-augmented generation) делает то же для AI. Модель находит (retrieval) нужные фрагменты в базе знаний компании и отвечает с опорой на них. Работа идёт в три шага: найти документы (wiki, Slack, инструкции), закодировать их в удобный для поиска вид и сгенерировать ответ по найденному.
Почему не дообучить модель на своих данных (finetuning)? Обучение требует огромных вычислений, энергии и времени. У него есть и экологическая цена: по словам авторов, след обучения одной большой модели сравним с выбросами десятков машин, объехавших земной шар. А внутренние документы меняются постоянно, и переобучать модель после каждого изменения невыгодно.
Как устроен RAG
Заголовок раздела «Как устроен RAG»RAG — не новая архитектура, а прикладной слой поверх готовой LLM. Мозг модели он не меняет, но меняет то, на что она опирается в ответе.
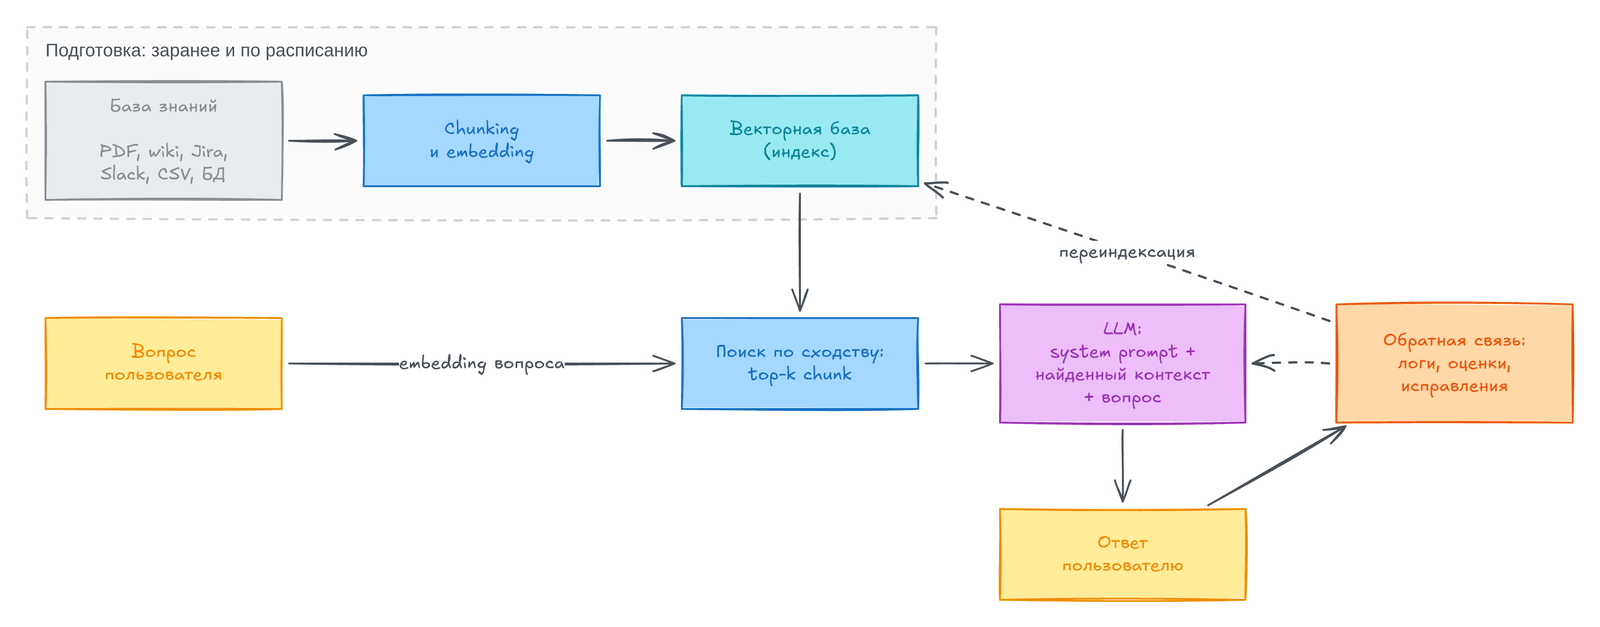
Верхний ряд — подготовка, её повторяют по расписанию. Нижний ряд работает при каждом вопросе, а пунктир — обратная связь.
База знаний
Заголовок раздела «База знаний»Сначала собирают внутренние данные: PDF, wiki (Confluence), переписку в Slack и почте, задачи в Jira, базы, выгрузки из CRM, API. Идеальная структура не нужна, но данные должны быть машиночитаемыми. Что значит «машиночитаемые», авторы объясняют через рекомендательные системы Spotify и Netflix. Для поиска похожих песен и фильмов появились векторные базы: данные превращают в векторы, а сходство считают как расстояние между ними. С этого шага начинается и RAG, который предложили исследователи Facebook.
Embedding и индексация
Заголовок раздела «Embedding и индексация»RAG ищет не по ключевым словам. Embedding — это числовой вектор, который передаёт смысл текста, и похожие по смыслу тексты лежат рядом. Векторы строит небольшая быстрая embedding-модель, а затем их индексируют в векторной базе. На вопрос «Каков статус проекта Феникс?» система находит документы, чьи векторы ближе всего к вектору вопроса.
LLM как мыслитель
Заголовок раздела «LLM как мыслитель»Найденные 1–5 документов отправляют в LLM вместе с вопросом как контекст. Документы часто не влезают в context window, поэтому их режут на chunk — небольшие фрагменты, как дата-инженеры режут большие данные для параллельной обработки. В модель уходят только самые подходящие фрагменты.
Трудность в том, чтобы резать, не теряя связей между кусками. Иначе модель не поймёт, как куски связаны, и даст ответ, верный по фактам, но бессвязный по смыслу. «Chunking без учёта смысла — как разрезать симфонию на клипы по 10 секунд: ноты на месте, гармонии нет», — пишут авторы. Поэтому главный вопрос — какая единица смысла подходит этому типу документа:
Стратегия chunking | Как режем | Для чего |
|---|---|---|
| По тексту | По абзацам, разделам или по 3–5 предложений | Статьи, отчёты, wiki |
| По коду | По функциям, классам, модулям | Репозитории, скрипты, документация API |
| Картинки | Признаки изображения (CLIP, BLIP) плюс текст из OCR | Диаграммы, чертежи, схемы архитектуры |
| Смешанный | Шаг инструкции вместе с рисунком к нему | Учебники, презентации |
| Скользящим окном | Соседние chunk перекрываются | Юридические и медицинские документы |
| По метаданным | Метки: тип документа, источник, раздел, уверенность | Любые, особенно разнородные. Метки помогают фильтровать и делать reranking |
Модель получает инструкцию вроде: «Отвечай только по контексту ниже. Если ответа в нём нет, так и скажи». Это system prompt — общая инструкция от разработчика, которая идёт вместе с вопросом. Авторы называют его guardrails — ограничением, которое запрещает модели додумывать.
Обратная связь и поддержка
Заголовок раздела «Обратная связь и поддержка»RAG ломают устаревшие документы, новые данные и галлюцинации. Галлюцинация — это правдоподобный, но выдуманный ответ: модель заполняет пробелы там, где не знает. Авторы советуют четыре меры:
- Переиндексация по расписанию. Частота зависит от того, как быстро меняются документы.
- Настройка поиска. Если находится не тот документ, поменяйте порог сходства или
embedding-модель. - Логи и мониторинг. Записывайте, какие документы нашлись на какой вопрос, чтобы видеть шаг с ошибкой.
- Обратная связь (
feedback loop). Исправления пользователей добавляйте в базу знаний.
Инструменты для RAG
Заголовок раздела «Инструменты для RAG»Строить всё с нуля не нужно. RAG собирают из готовых библиотек на каждом шаге: загрузка базы знаний, chunking, embedding и индексация, поиск, генерация ответа.
| Шаг | Инструменты |
|---|---|
Готовые блоки для всего RAG | LangChain, LlamaIndex, Haystack |
| Разбиение текста | RecursiveCharacterTextSplitter, MarkdownSplitter из LangChain и LlamaIndex |
| Разбиение картинок и видео | OpenCV, scikit-image, FFmpeg |
| Векторные базы | Pinecone, Chroma, FAISS |
Готовый RAG в облаке | Databricks и другие платформы с управляемой векторной базой |
Пробуем: библиотека с RAG
Заголовок раздела «Пробуем: библиотека с RAG»В репозитории книги (папка chapter-2) окружение ставят командой make dev-setup, а в файл .env вписывают ключ провайдера LLM: OpenAI, Anthropic, OpenRouter или LiteLLM. Опыт простой: в словаре лежат четыре выдуманные книги. Обычная LLM на вопрос об авторе одной из них выдумывает ответ или говорит, что не знает, а та же модель с RAG отвечает верно. Секрет в том, что данные книг добавлены в system prompt, а вопрос идёт отдельным сообщением с ролью user.
Затем 200 сгенерированных книг загружают в DuckDB, строят для них embedding и запускают ассистента. Его можно спросить обычным языком, какие книги лучше всего продаются в каждом отделе. Без AI, замечают авторы, на такой вопрос понадобились бы ingestion из CSV и SQL с группировкой и ранжированием.
Репозиторий книги пока закрыт, поэтому ниже наша версия опыта. Она работает без сети и ключей, а вместо embedding-модели использует игрушечный вектор: сколько раз в тексте встречается каждая основа слова (её первые пять букв). Главная часть — поиск по сходству и сборка запроса:
q = embed(question)ranked = sorted(index, key=lambda r: (-cosine(q, r[2]), r[0]["id"]))context = "\n".join(doc for _, doc, _ in ranked[:top_k])messages = [ {"role": "system", "content": "Ты помощник библиотеки. Отвечай ТОЛЬКО по каталогу ниже. " "Если ответа в каталоге нет, так и скажи.\n\n" + context}, {"role": "user", "content": question},]Полный скрипт: ch02_rag_library.py. Его настоящий вывод:
== 1. Chunking скользящим окном (6 слов, перекрытие 2)chunk 1: Практическое пособие: как дата-инженеру чинить ночнуюchunk 2: чинить ночную загрузку данных и неchunk 3: и не терять заказы.
== 2. Индексация: один документ на книгув индексе документов: 4
== 3. Поиск по сходствуLIB-02  0.212  Сад из стеклаLIB-01  0.000  Северный архивLIB-03  0.000  Ночной pipelineLIB-04  0.000  Последний трамвай
== 4. Что уходит в LLM[system] Ты помощник библиотеки. Отвечай ТОЛЬКО по каталогу ниже. Если ответа в каталоге нет, так и скажи.
Сад из стекла. Автор: Игорь Векшин. Год: 2024. Полка: C5. Ботаник выращивает стеклянные растения и узнаёт, что они хранят память о людях.[user] Кто написал книгу про стеклянный сад и на какой полке она стоит?
При chunking скользящим окном слова «чинить ночную» и «и не» попадают в два соседних chunk, и фраза не рвётся на границе. Косинусное сходство находит одну нужную книгу, и в модель уходит только она. Список messages можно передать в любой чат-API, например client.chat.completions.create(model=..., messages=messages).
Вывод авторов: настоящий RAG — это живая векторная база, и в этом новая обязанность дата-инженера. Он держит «память» AI свежей и точной: строит расписания, orchestration и pipeline для векторных баз, а отзывы пользователей возвращает в систему, чтобы галлюцинаций становилось меньше. AI — ещё один потребитель ваших pipeline. Источники из OLTP-баз, OLAP-кубов и потоков авторы разберут в главе 7.
MCP: общий язык для AI и систем
Заголовок раздела «MCP: общий язык для AI и систем»Снова библиотека. Посетитель просит у стойки книгу про AI 2025 года. Координатор поручает хранителю полок найти её («полка 48»), затем ведёт посетителя к кассе. У всех свои процессы, но они понимают друг друга, потому что говорят на общем языке. AI работает с десятками систем, у каждой свои форматы, и без стандарта он может неверно понять данные или выдумать результат. MCP (Model Context Protocol) — это открытый протокол, по которому AI-приложение подключает внешние инструменты и данные. Как HTTP связывает веб-сервисы, так MCP даёт AI единый способ спросить, получить ответ и действовать.
Как устроен MCP
Заголовок раздела «Как устроен MCP»MCP построен по схеме клиент — сервер на сообщениях JSON-RPC 2.0. Они идут через stdio (стандартный ввод и вывод) для локальных серверов или по HTTP с SSE для удалённых.
Пояснение: с весны 2025 года спецификация MCP заменила транспорт HTTP + SSE на Streamable HTTP. Идея та же: удалённый сервер общается с клиентом по HTTP.
Участников три:
MCP host— AI-приложение пользователя. Оно связывает пользователя, LLM и клиентов.MCP client— часть host, которая держит связь с однимMCP server. Клиент переводит запросы LLM в форматMCPи обратно. Такую роль играют, например, адаптеры LangChain.MCP server— внешняя программа, которая даёт AI структурированный доступ к базам, файлам, API или внутренним инструментам.
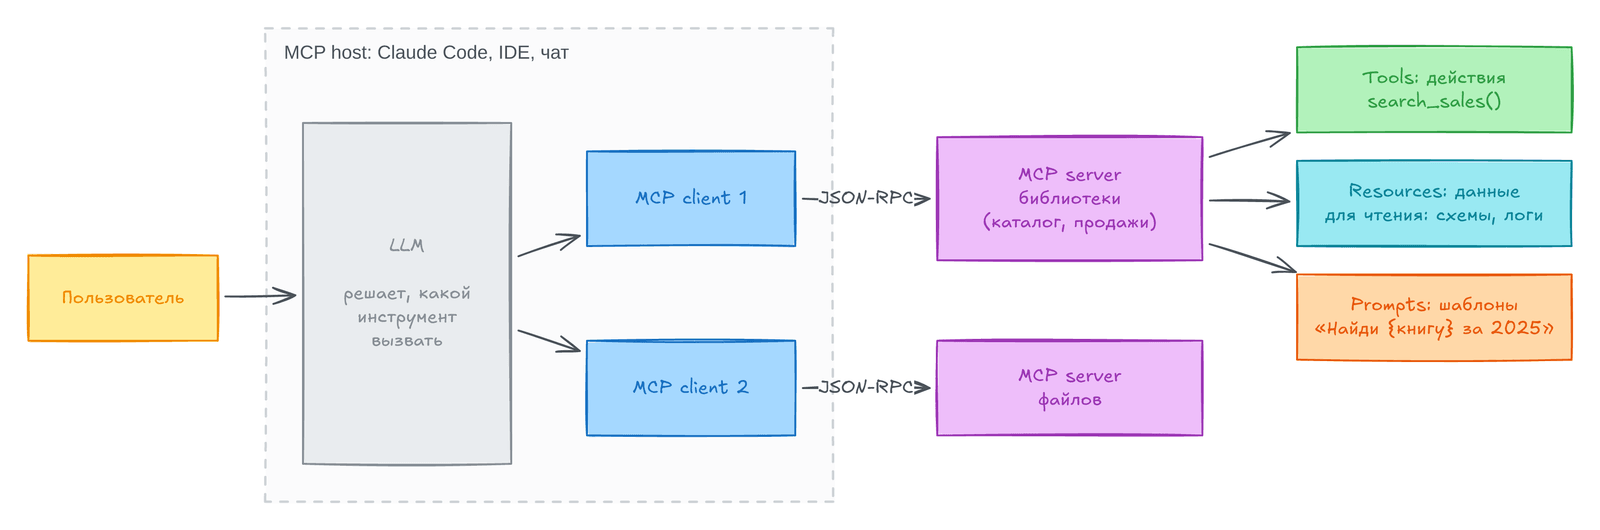
На схеме у каждого MCP server свой клиент внутри host, а справа — возможности, которые сервер отдаёт модели.
Примитивы MCP
Заголовок раздела «Примитивы MCP»| Примитив | Что это | Пример |
|---|---|---|
Tools | Действия, которые вызывает модель: запрос к базе, письмо, API. У каждого есть схема входа и выхода в JSON Schema | search_sales(book_id, region, limit) |
Resources | Данные только для чтения: файлы, логи, схемы баз | схема таблицы продаж |
Prompts | Готовые шаблоны запросов с переменными, которые можно раздать другим | «Найди {книгу} в разделе информатики за 2025 год» |
Пробуем: библиотека на одном MCP server
Заголовок раздела «Пробуем: библиотека на одном MCP server»Хранителю полок нужно найти книгу, проверить наличие и узнать полку, а кассе — цены, остатки и список книг, которые пора докупить. Всё это инструменты, и в примере книги они собраны в одном MCP server (library_server.py). LLM сама выбирает нужный инструмент по вопросу, а все участники работают в одном окне.
Отладочный клиент (make mcp-client) показывает списки инструментов (/tools) и ресурсов (/resources), так что видно, чего не хватает. Для обычной работы есть make mcp-assistant: это и есть MCP host. Свой клиент нужен, только если требуется больше контроля, например специалисту поддержки для отладки. Большинству хватает host.
Такая система не заменяет людей, а усиливает их, считают авторы. Координатор обслуживает больше посетителей, хранитель полок занимается каталогом, а не разовыми просьбами, касса — пополнением запасов.
Остаётся вопрос доступа: продажи должен видеть кассир, но не посетитель. Это тема data governance, а в примере её изображает переключатель доступа модели к продажам, которые подключены через RAG. Если он выключен, на вопрос о самой продаваемой книге в каждой категории ассистент уходит от ответа. Если включён — выдаёт список с числом проданных копий и выручкой. За это отвечает инструмент search_sales с фильтрами по книге, сегменту клиентов, региону и каналу:
@mcp.tool()def search_sales(book_id: str | None = None, region: str | None = None, channel: str | None = None, limit: int = 20) -> list[dict]: """Ищет записи о продажах по необязательным фильтрам.""" ...Это фрагмент из примера книги, без её репозитория он не запускается. Авторы уверены, что идея инструментов с контекстом переживёт смену стандартов.
Проблема: слишком много инструментов
Заголовок раздела «Проблема: слишком много инструментов»У прямых вызовов инструментов есть предел роста. Представьте посетителя (MCP host) за маленьким столом (context window), которому надо пересказать 100 книг. Перед каждой новой книгой он раскладывает на столе все прошлые пересказы и перечитывает их. Так и модель держит в контексте все промежуточные результаты, даже ненужные. Система работает медленнее, стоит дороже в токенах и чаще ошибается, потому что важное тонет в мусоре.
Выход — code execution, который сейчас часто называют skills. Модель получает не описания всех инструментов, а дерево файлов с их именами. Она читает описания только нужных и пишет код, который их вызывает, а данные обрабатываются в среде выполнения, мимо контекста модели. По данным, на которые ссылаются авторы, экономия токенов доходит до 98,7%.
В книге режимы сравнивают командами make mcp-compare-modes и make mcp-benchmark, в том числе с сотнями фиктивных инструментов, как в настоящей компании. Наша модель того же сравнения грубо считает токены (1 токен ≈ 4 символа) для задачи «найди книгу и посчитай её продажи»:
инструментов | прямые вызовы | code execution | экономия 8 | 7290 | 289 | 96.0% 50 | 12192 | 409 | 96.6% 200 | 29694 | 835 | 97.2%итог, который видит модель в обоих режимах: {'book_id': 'B001', 'rows': 300, 'copies': 884, 'revenue': 15470.0}Описания инструментов не грузятся заранее, а 300 сырых строк продаж остаются в среде выполнения, и модель видит только итог. Чем больше инструментов, тем больше выигрыш. Код: ch02_tool_tokens.py.
Среде выполнения нужны sandbox (изолированная среда, где код модели не навредит системе), мониторинг безопасности и скорости, а также доступ к файлам для состояния и описаний инструментов. Это добавляет работы и рисков, поэтому экономию токенов взвешивают против сложности инфраструктуры. Code execution оправдан, когда одному большому prompt нужно много инструментов. Но зачем такой огромный prompt, почему не разбить задачу на части? С этого вопроса, говорят авторы, начинается мир агентов.
Мир агентов
Заголовок раздела «Мир агентов»Настоящий скачок, по мнению авторов, в том, что AI не только отвечает, но и действует: запускает задачи и выстраивает цепочки шагов к цели. Так появляется agentic AI — системы, которые сами рассуждают, планируют и действуют. Агент работает лучше, когда задача разбита на логичные шаги и у него много контекста. В инженерии агенты быстро превращаются в агентов, которые пишут код, а книга сосредоточится на агентах для инжиниринга данных.
Знать устройство агента нужно, чтобы предсказывать его поведение и разбираться, когда что-то пошло не так. Все части главы собираются здесь в одну систему, и их можно подключать к любому фреймворку агентов.
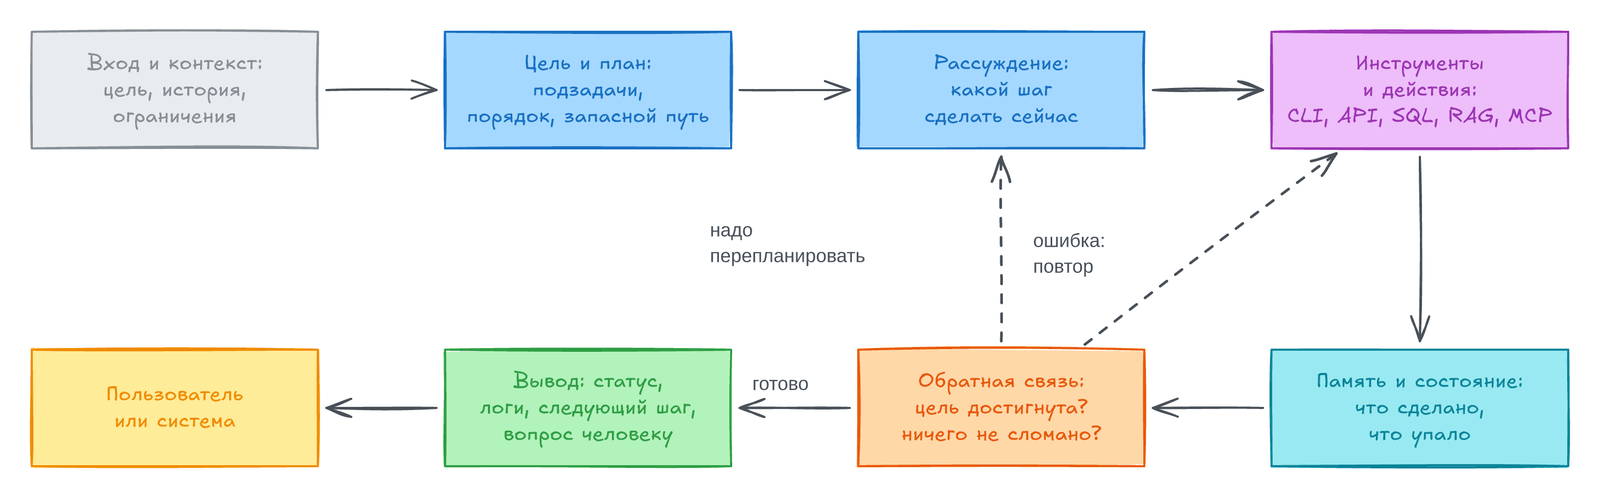
Верхний ряд — путь от цели к действию, нижний — проверка и выход. Три стрелки из обратной связи — три исхода: перепланировать, повторить шаг или сообщить, что задача выполнена.
- Вход и контекст:
prompt, цель, история, ограничения. Без контекста агент «летит вслепую», а в инжиниринге данных это путь к сломаннымpipeline. Приёмы работы с контекстом — в главах 3 и 4. - Цель и планирование: агент разбивает цель на подзадачи, порядок, зависимости и запасной путь. План может меняться, если не нашёлся файл или колонка пришла в неверном формате.
- Рассуждение: агент выбирает следующий шаг по текущему состоянию, прошлым результатам, инструментам и ограничениям.
- Инструменты и действия:
CLI, API, скрипты, базы, облака. Сюда подключаютRAGдля внутренних документов,MCPдля внешних систем и новые способы вызова инструментов. - Память и состояние: что сделано, что упало, какие были исправления и предпочтения пользователя. Память — это опыт агента, а не просто лог.
- Обратная связь: после каждого шага агент проверяет, достиг ли цели и не сломал ли что-то. Для этого ему дают инструкции: проверить схему, повторить упавший шаг, сообщить пользователю. Так разовое действие становится процессом, который сам себя исправляет.
- Вывод: статус, история выполнения для проверки человеком, следующие шаги или вопрос к человеку.
Агенты для данных часто работают цепочками. Чем уже обязанности агента, тем стабильнее он работает, поэтому модульность — ключ к надёжности.
Пробуем: один агент и команда агентов
Заголовок раздела «Пробуем: один агент и команда агентов»В примере книги make assistant запускает одного агента. На вопрос о самой продаваемой технической книге он находит продажи через RAG, а логи показывают каждый шаг. make multi-agent запускает мультиагентную систему: агент поиска, агент аналитики и агент рекомендаций. Агент-оркестратор разбирает вопрос, планирует шаги и вызывает нужных агентов, а те, что не нужны для этого вопроса, простаивают.
Интерфейсы AI
Заголовок раздела «Интерфейсы AI»В примерах главы с AI работали через CLI, но интерфейсов много:
| Вид интерфейса | Примеры | Для чего |
|---|---|---|
| Чаты | ChatGPT, Grok, Claude | Свободный диалог |
| Помощники в браузере | Gemini, Perplexity | Ответы со ссылками на источники |
Помощники в рабочих программах (copilot) | Adobe Firefly, Canva, Microsoft 365 Copilot | AI правит и автоматизирует прямо в привычном инструменте |
IDE с AI | GitHub Copilot, Cursor, Claude Code | Код, поиск документации через RAG, архитектура |
Системы, которые создают текст, картинки и код, называют GenAI. Для инженеров главный интерфейс — IDE: по сути, это MCP host и дом для агентов. Такие среды дают лучший вариант human-in-the-loop: человек утверждает действия агента или задаёт список разрешённых действий. С этой главы авторы работают и в таких средах.
До сих пор авторы смотрели на AI с оптимизмом, но не наивно: для них это осознанная точка старта. Дальше книга уходит от учебной библиотеки к масштабу и ограничениям настоящих систем данных.
Итоги главы
Заголовок раздела «Итоги главы»Transformerсself-attentionдал моделям видеть весь текст сразу, и это стало основой LLM.- Рост LLM держится на
scaling law: больше данных, параметров и вычислений дают лучшее качество. - Хороший
promptсодержит цель, контекст, источник и формат ответа. Vibe engineering, по мнению авторов, учит видеть в AI команду с разными ролями.RAGдаёт модели знания компании без переобучения:chunk,embedding, поиск по сходству,system prompt.- Качество
RAGдержится наchunking, переиндексации, логах и обратной связи, и это работа дата-инженера. MCPдаёт AI единый протокол через host, client, server и примитивыTools,Resources,Prompts.- Когда инструментов много,
code executionрезко снижает расход токенов ценой более сложной инфраструктуры. - Агент объединяет контекст, план, рассуждение, инструменты, память и обратную связь, а узкие агенты надёжнее одного большого.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
transformer | Архитектура на attention, основа почти всех LLM |
self-attention | Каждое слово текста «смотрит» на все остальные |
context window | Сколько токенов модель видит за раз |
system prompt | Общая инструкция модели от разработчика |
vibe engineering | Термин книги: работа с AI, где человек сочетает данные, модель и интуицию |
RAG | Модель отвечает с опорой на найденные документы |
chunk | Фрагмент документа для индексации |
embedding | Числовой вектор, который передаёт смысл текста |
| галлюцинация | Уверенный, но выдуманный ответ модели |
MCP | Открытый протокол подключения инструментов и данных к AI |
Tools, Resources, Prompts | Примитивы MCP: действия, данные для чтения, шаблоны |
code execution | Модель пишет код, который вызывает инструменты в sandbox |
agentic AI | AI, который планирует, действует и проверяет результат |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- База знаний AI-помощника — такой же потребитель данных, как BI: ей нужны
pipeline, расписание, мониторинг и владелец. - Планируйте переиндексацию по скорости изменения документов.
- Ставьте метаданные на каждый
chunk: источник, тип, раздел, дату. - Логируйте, какие
chunkнашлись на какой вопрос: без этого не понять, ошибся поиск или модель. - Доступ через
MCP— вопросdata governance: инструменты с чувствительными данными только нужным ролям. - Не давайте одному агенту сотни инструментов: делите задачу или используйте
code execution. - Всё, что меняет данные в проде, должен подтверждать человек.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку в одной сессии. Задания повторяют три идеи главы: вопрос «лучшие продажи по категориям», поиск chunk по сходству с фильтром по метаданным и проверку, какие документы пора переиндексировать.
Шаг 1. Создаём таблицы
Заголовок раздела «Шаг 1. Создаём таблицы»-- каталог: книга и категорияCREATE TABLE books ASSELECT * FROM (VALUES ('B01', 'Ночной pipeline', 'tech'), ('B02', 'SQL без страха', 'tech'), ('B03', 'Северный архив', 'fiction'), ('B04', 'Последний трамвай', 'fiction'), ('B05', 'Сад из стекла', 'fiction'), ('B06', 'Деньги и привычки', 'business')) AS t(book_id, title, category);
-- продажи: 60 строк, данные сгенерированыCREATE TABLE sales ASSELECT 'B0' || (1 + (i * i + i // 4) % 6) AS book_id, 1 + (i * i) % 5 AS qty, DATE '2025-01-01' + i::INTEGER AS sold_onFROM generate_series(1, 60) AS g(i);
-- chunk базы знаний с метаданными (source) и игрушечными embedding из 3 чиселCREATE TABLE chunks ASSELECT * FROM (VALUES (1, 'wiki', 'Ночную загрузку заказов перезапускают через Airflow', [0.9, 0.1, 0.0]::FLOAT[3]), (2, 'wiki', 'Права на витрину sales выдаёт владелец домена', [0.1, 0.8, 0.2]::FLOAT[3]), (3, 'slack', 'кто-нибудь знает, почему упала загрузка заказов?', [0.8, 0.2, 0.1]::FLOAT[3]), (4, 'wiki', 'Отпуск оформляют в кадровом портале', [0.0, 0.1, 0.9]::FLOAT[3])) AS t(chunk_id, source, text, emb);
-- когда документ менялся в последний разCREATE TABLE docs ASSELECT * FROM (VALUES ('runbook-orders', TIMESTAMP '2025-03-10 09:00'), ('access-policy', TIMESTAMP '2025-03-01 12:00'), ('vacation-howto', TIMESTAMP '2025-02-20 08:00')) AS t(doc_id, updated_at);
-- когда документ последний раз попал в векторную базуCREATE TABLE vector_index ASSELECT * FROM (VALUES ('runbook-orders', TIMESTAMP '2025-03-05 02:00'), ('access-policy', TIMESTAMP '2025-03-05 02:00')) AS t(doc_id, indexed_at);Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»-- orphan_sales должно быть 0: у каждой продажи есть книгаSELECT (SELECT count(*) FROM books) AS books, (SELECT count(*) FROM sales) AS sales_rows, (SELECT count(*) FROM sales WHERE book_id NOT IN (SELECT book_id FROM books)) AS orphan_sales;┌───────┬────────────┬──────────────┐│ books │ sales_rows │ orphan_sales ││ int64 │ int64 │ int64 │├───────┼────────────┼──────────────┤│ 6 │ 60 │ 0 │└───────┴────────────┴──────────────┘Шесть книг, 60 продаж, у каждой продажи есть книга в каталоге.
Задания
Заголовок раздела «Задания»1. Самая продаваемая книга в каждой категории. Именно этот вопрос в книге задают ассистенту на обычном языке. Напишите SQL, который он заменяет.
Решение
SELECT category, title, copiesFROM ( SELECT b.category, b.title, sum(s.qty)::INTEGER AS copies, row_number() OVER (PARTITION BY b.category ORDER BY sum(s.qty) DESC, b.title) AS rn FROM sales s JOIN books b USING (book_id) GROUP BY b.category, b.title)WHERE rn = 1ORDER BY category;┌──────────┬───────────────────┬────────┐│ category │ title │ copies ││ varchar │ varchar │ int32 │├──────────┼───────────────────┼────────┤│ business │ Деньги и привычки │ 38 ││ fiction │ Последний трамвай │ 35 ││ tech │ Ночной pipeline │ 40 │└──────────┴───────────────────┴────────┘row_number() нумерует книги внутри категории по числу проданных копий, и остаётся первая.
2. Поиск по сходству с фильтром по метаданным. Вектор вопроса «почему упала загрузка заказов?» — [0.85, 0.15, 0.05]. Найдите два самых близких chunk, но только из источника wiki.
Решение
SELECT chunk_id, text, round(array_cosine_similarity(emb, [0.85, 0.15, 0.05]::FLOAT[3]), 3) AS scoreFROM chunksWHERE source = 'wiki'ORDER BY score DESCLIMIT 2;┌──────────┬─────────────────────────────────────────────────────┬───────┐│ chunk_id │ text │ score ││ int32 │ varchar │ float │├──────────┼─────────────────────────────────────────────────────┼───────┤│ 1 │ Ночную загрузку заказов перезапускают через Airflow │ 0.996 ││ 2 │ Права на витрину sales выдаёт владелец домена │ 0.299 │└──────────┴─────────────────────────────────────────────────────┴───────┘Сообщение из Slack (chunk_id = 3) по смыслу тоже близко, но фильтр по метаданным его отсекает: в ответ идут только проверенные статьи wiki.
3. Какие документы пора переиндексировать? Найдите документы, которые изменились после последней индексации или ещё не попали в индекс.
Решение
SELECT d.doc_id, d.updated_at, i.indexed_atFROM docs d LEFT JOIN vector_index i USING (doc_id)WHERE i.indexed_at IS NULL OR d.updated_at > i.indexed_atORDER BY d.doc_id;┌────────────────┬─────────────────────┬─────────────────────┐│ doc_id │ updated_at │ indexed_at ││ varchar │ timestamp │ timestamp │├────────────────┼─────────────────────┼─────────────────────┤│ runbook-orders │ 2025-03-10 09:00:00 │ 2025-03-05 02:00:00 ││ vacation-howto │ 2025-02-20 08:00:00 │ NULL │└────────────────┴─────────────────────┴─────────────────────┘runbook-orders изменился после индексации, а vacation-howto в индекс не попал вовсе. Оба нужно отправить в переиндексацию.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему
RNNиLSTMплохо работали с длинными текстами и что изменилself-attention? - Чем
RAGлучшеfinetuning, когда внутренние документы компании меняются каждую неделю? - Какую стратегию
chunkingвы выберете для репозитория кода, а какую — для юридических договоров? Почему? - Когда стоит переходить от прямых вызовов инструментов к
code executionи чем за это придётся платить? - Почему авторы советуют строить цепочки узких агентов, а не одного агента на все задачи?
- Какие обязанности дата-инженера появляются, когда AI становится потребителем данных компании?
Предыдущая: Инжиниринг данных в компании в эпоху AI.