

Analytics Engineering with SQL and dbt, глава 6: Сквозной проект analytics engineering
Главная мысль: Авторы собирают всё из книги в один учебный проект. Сначала они моделируют операционную базу в MySQL и переносят данные в BigQuery Python-скриптом. Затем строят в dbt star schema с тестами и документацией, выкатывают её в production и отвечают на бизнес-вопросы короткими SQL-запросами.
О чём глава
Заголовок раздела «О чём глава»Это последняя глава книги. Она отвечает на вопрос, как приёмы из прошлых глав работают вместе на одной задаче: от сырых данных до отчёта. Глава опирается на моделирование данных из главы 2 и на dbt из глав 4 и 5. Авторы идут вширь: проходят все шаги, но не углубляются в детали. Требования упрощены, так что это учебное упражнение, а не готовая система.
Темы главы:
- постановка задачи: омниканальная аналитика;
- операционная модель: концептуальная, логическая и физическая;
- архитектура и Python-скрипт
ETLиз MySQL в BigQuery; - аналитическая модель: бизнес-процессы, факты, измерения, атрибуты,
grain; - хранилище данных в
dbt:staging, измерения, факты; - тесты, документация и развёртывание;
- анализ данных на SQL.
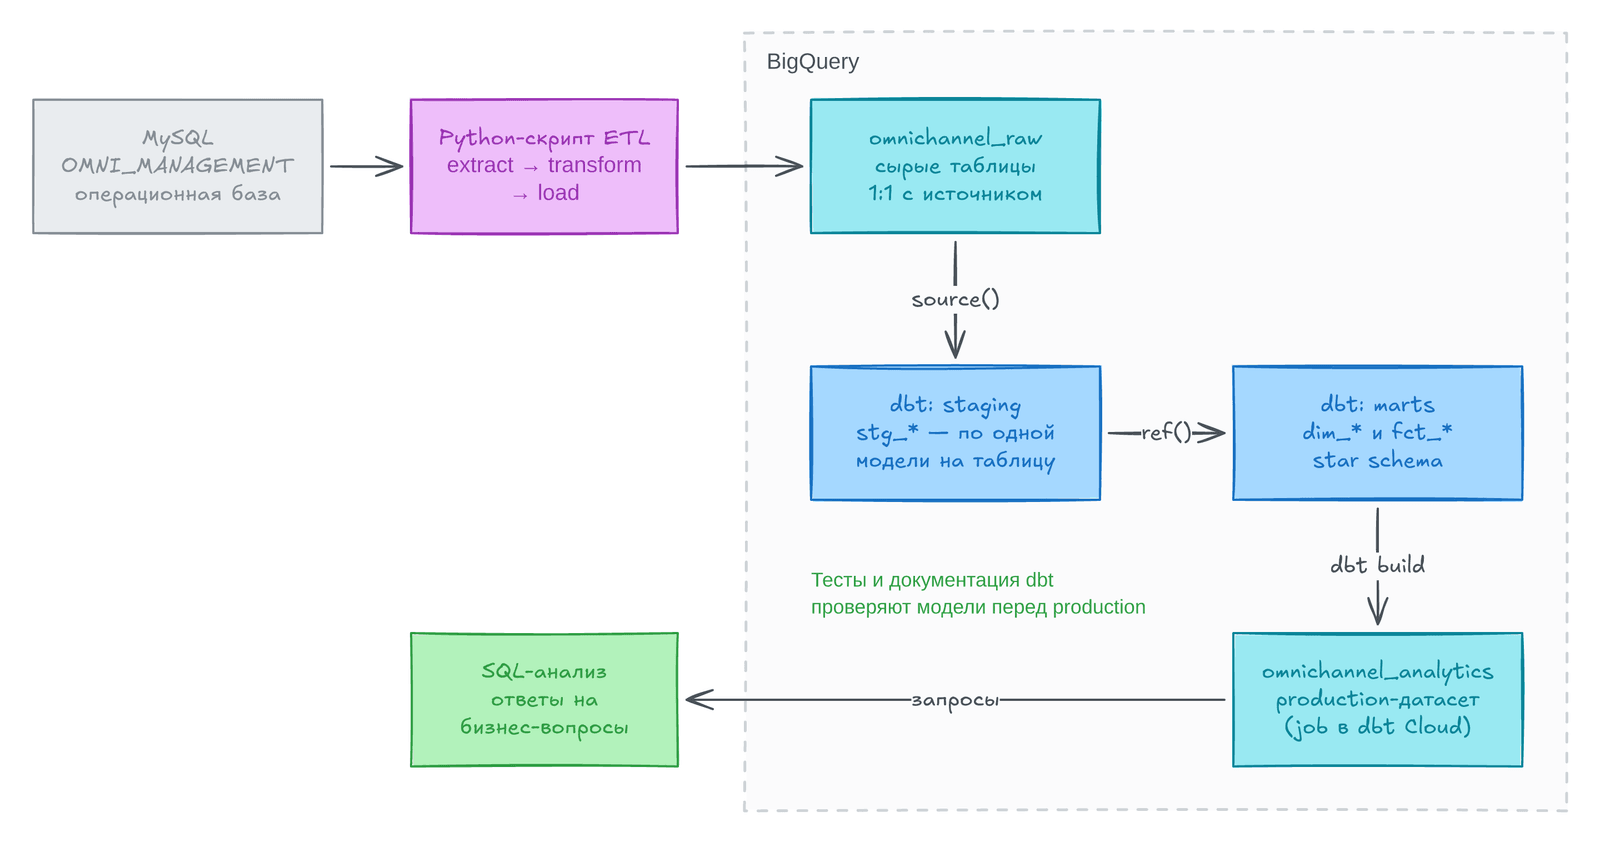
Схему читают по стрелкам: от операционной базы в MySQL до SQL-запросов к production-датасету.
Постановка задачи: омниканальная аналитика
Заголовок раздела «Постановка задачи: омниканальная аналитика»Компания хочет улучшить опыт клиентов: общение с ними должно быть удобным и персональным в любом канале. Омниканальный подход — это когда клиент приходит через сайт, мобильное приложение или службу поддержки, а компания видит его путь целиком. Для этого нужны данные четырёх видов:
- профиль клиента: имя, email и телефон;
- взаимодействия по каналам, чтобы понимать предпочтения и потребности клиента;
- заказы: дата, сумма и способ оплаты. По ним ищут возможности для
cross-sellиupsell, то есть продажи сопутствующих и более дорогих товаров; - товары: название, категория и цена, чтобы точнее настраивать маркетинг и акции.
Анализ этих данных должен показать, как улучшить омниканальную стратегию, повысить удовлетворённость клиентов и помочь бизнесу расти.
Операционное моделирование данных
Заголовок раздела «Операционное моделирование данных»Авторы начинают с операционной базы, потому что она — фундамент для всех следующих шагов. Они берут задокументированные требования к учётной базе и проходят три классических этапа: концептуальную, логическую и физическую модель.
Концептуальная модель
Заголовок раздела «Концептуальная модель»На этом этапе вместе с заказчиками выделяют главные сущности, их атрибуты и связи. В модели три сущности: клиент (Customer), канал (Channel) и товар (Products). Их соединяют две связи:
- «Покупает» (Buy) показывает, какой клиент купил какой товар и в каком канале. Каналы нужны, чтобы сравнивать их эффективность.
- «Посещает» (Visit) показывает, какие каналы посещал клиент.
У каждой сущности и у каждой связи есть свои атрибуты: например, у клиента это имя и email.
Логическая модель
Заголовок раздела «Логическая модель»Логическая модель превращает концептуальную ERD (диаграмму сущностей и связей) в структуру таблиц. Правила простые:
- сущность становится таблицей, а её атрибуты — колонками;
- связь N:1 оформляют внешним ключом;
- связь M:N выносят в отдельную таблицу.
Так модель почти сама собой получается нормализованной. В итоге выходит пять таблиц: три для сущностей (Customers, Products, Channels) и две для связей. Для простоты связи переименованы: Buy стала Purchase history, а Visit — Visit history.
Физическая модель
Заголовок раздела «Физическая модель»Физическая модель привязана к конкретной СУБД, здесь это MySQL. Логическую модель переводят в типы и ограничения MySQL с учётом её правил и лимитов. Схема ниже объединяет три рисунка книги: на ней пять таблиц, типы, ключи и связи.
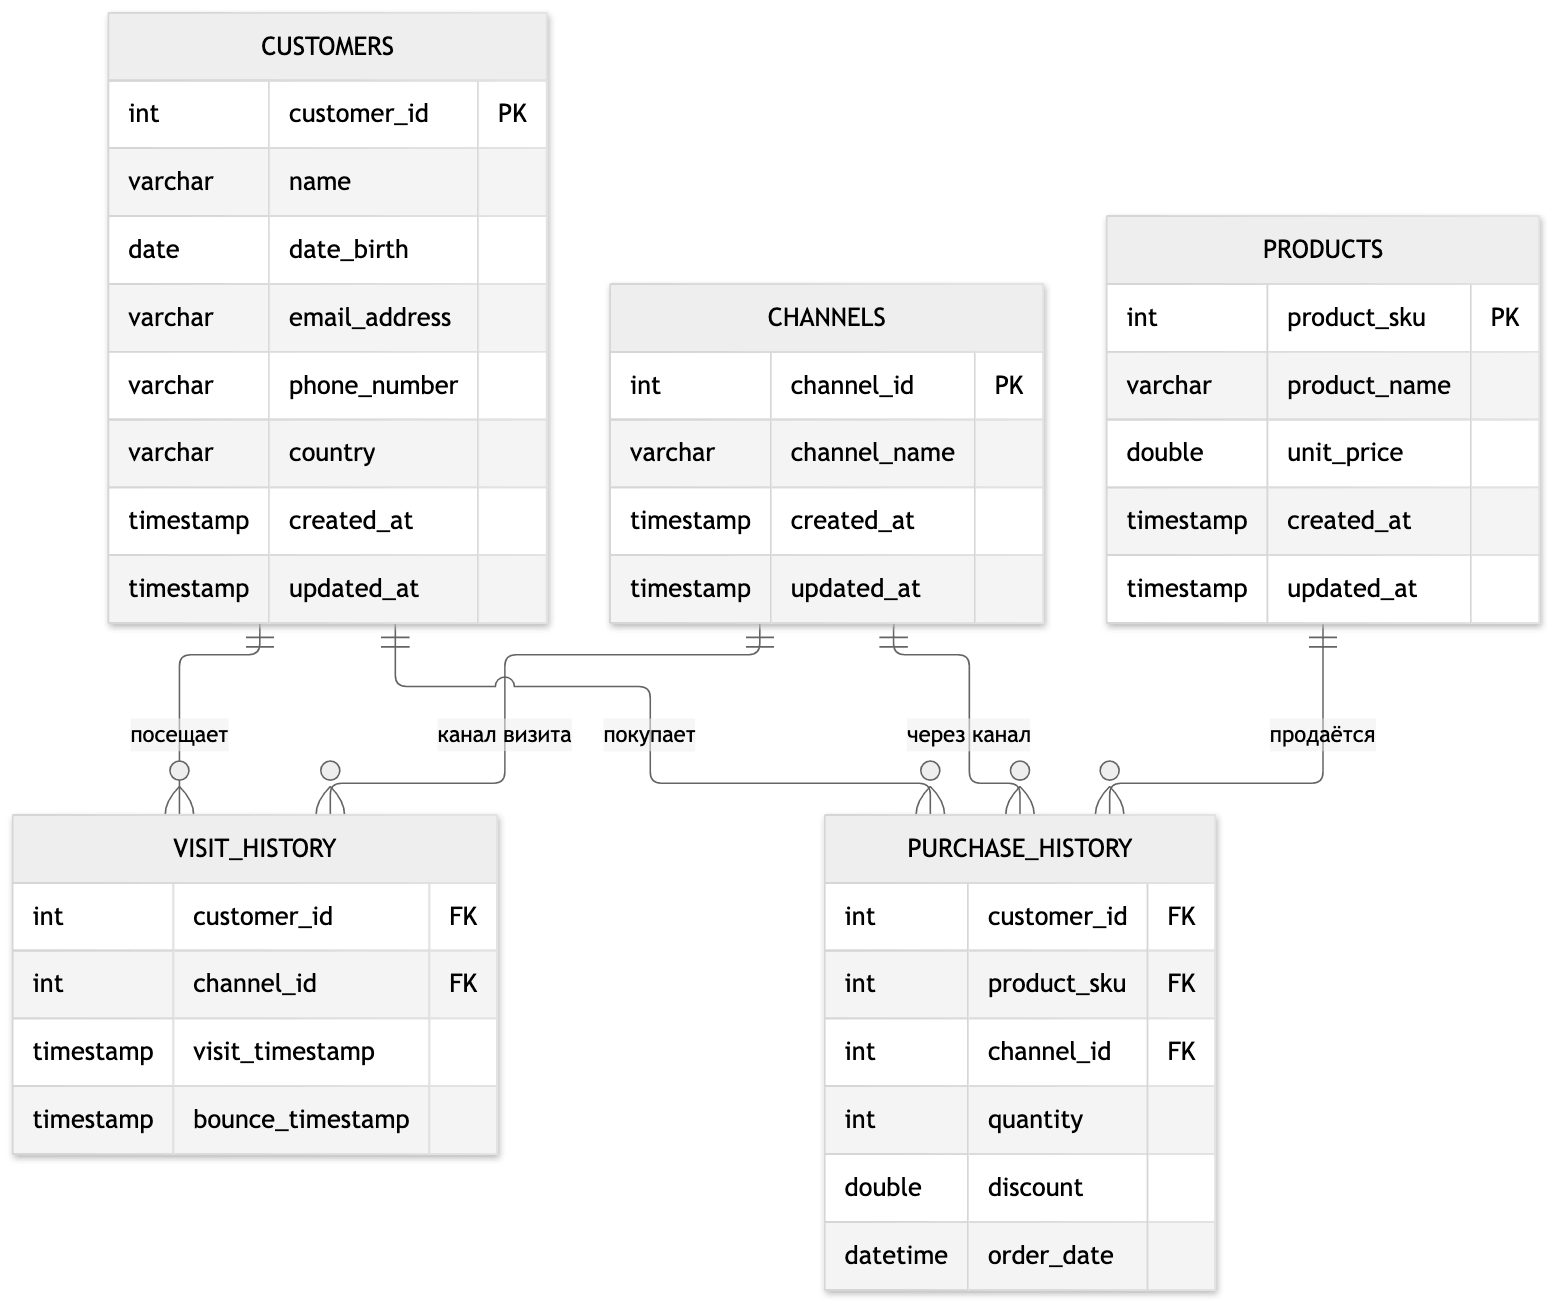
Дальше модель переводят в DDL-скрипты. Сначала создают базу OMNI_MANAGEMENT, затем три основные таблицы, затем две таблицы связей. Ниже наш сокращённый вариант на диалекте DuckDB. В MySQL вместо схемы будет CREATE DATABASE, у ключей появится AUTO_INCREMENT, а у UPDATED_AT — ON UPDATE CURRENT_TIMESTAMP.
CREATE SCHEMA omni_management;CREATE TABLE omni_management.channels ( channel_id INTEGER PRIMARY KEY, channel_name VARCHAR(150), created_at TIMESTAMP DEFAULT current_timestamp, updated_at TIMESTAMP DEFAULT current_timestamp);CREATE TABLE omni_management.purchase_history ( customer_id INTEGER, product_sku INTEGER, channel_id INTEGER REFERENCES omni_management.channels (channel_id), quantity INTEGER, discount DOUBLE DEFAULT 0, order_date TIMESTAMP NOT NULL, created_at TIMESTAMP DEFAULT current_timestamp, updated_at TIMESTAMP DEFAULT current_timestamp);INSERT INTO omni_management.channels (channel_id, channel_name) VALUES (1, 'Website');INSERT INTO omni_management.purchase_history (customer_id, product_sku, channel_id, quantity, order_date)VALUES (1, 101, 1, 2, TIMESTAMP '2024-03-01 10:15:00');SELECT channel_id, quantity, discount FROM omni_management.purchase_history;┌────────────┬──────────┬──────────┐│ channel_id │ quantity │ discount ││ int32 │ int32 │ double │├────────────┼──────────┼──────────┤│ 1 │ 2 │ 0.0 │└────────────┴──────────┴──────────┘Авторы объясняют несколько решений в этом коде:
customer_id,product_skuиchannel_id— первичные ключи своих таблиц: customers, products и channels. В MySQL они растут сами благодаряAUTO_INCREMENT.- В книге у каждой команды создания таблицы стоит
IF NOT EXISTS: таблица создаётся, только если её ещё нет. Поэтому скрипт можно запускать повторно без ошибок. - Во всех таблицах есть служебные колонки
CREATED_ATиUPDATED_AT. Они готовят базу к инкрементальной выгрузке, а многиеCDC-инструменты (Change Data Capture, захват изменений) без них не работают. - В
purchaseHistoryтри внешних ключа: на клиентов, товары и каналы.discountпо умолчанию равен 0, потому что покупка без скидки — норма.order_dateобъявленаNOT NULL: у заказа всегда есть дата. - В
visitHistoryзаписано время визита и время отказа (bounce), то есть ухода из канала без каких-либо действий. - Внешние ключи обеспечивают ссылочную целостность. Если вставить заказ с
channel_id = 9, DuckDB ответит ошибкойViolates foreign key constraint.
Авторы признают, что проектировать операционные базы с нуля — не работа аналитика и analytics engineer. Но понимать такое моделирование полезно. Аналитик видит весь pipeline и знает, откуда пришли данные и как они устроены. Поэтому ему проще работать с дата-инженерами, искать проблемы в pipeline и предлагать улучшения в операционном слое.
Архитектура решения
Заголовок раздела «Архитектура решения»Архитектура намеренно «тонкая» (схема в начале страницы). Python-скрипт забирает данные из MySQL, превращает даты в строки и отправляет их в датасет omnichannel_raw в BigQuery. Дальше dbt строит из сырых таблиц модели для star schema, а аналитики пишут к ней SQL-запросы прямо в BigQuery.
Скрипт имитирует ETL-задачу и состоит из четырёх функций:
| Функция | Что делает |
|---|---|
data_pipeline_mysql_to_bq(**kwargs) | Подключается к MySQL, получает список таблиц и для каждой вызывает три шага ниже |
extract_table_from_mysql | Extract: выполняет select * from <таблица> через pd.read_sql и возвращает DataFrame |
transform_data_from_table | Transform: находит колонки с датами (datetime.date) и превращает их в строки, иначе pandas_gbq даёт конфликт типов |
load_data_into_bigquery | Load: пишет DataFrame в dataset.table через pandas_gbq.to_gbq с if_exists='replace', то есть заменяет таблицу целиком |
Параметры подключения к MySQL и BigQuery передают словарём через **kwargs. Этот синтаксис Python передаёт функции любое число именованных аргументов, и их не нужно перечислять в сигнатуре.
Список таблиц скрипт читает из information_schema — служебной базы MySQL с метаданными о таблицах, колонках, индексах и правах.
Авторы предупреждают: выгружать всё через select * можно только в учебном примере. В жизни строки лучше брать инкрементально, по условию «updated_at или created_at позже прошлой выгрузки». Дату прошлой выгрузки хранят в отдельной таблице метаданных.
Наш вариант работает без MySQL и BigQuery: обе базы — SQLite в памяти, нужна только стандартная библиотека Python. Логика та же, полный скрипт лежит в scripts/analytics-engineering-code/ch06_etl.py.
def transform_rows(cols, rows):    """Transform: даты превращаем в строки, как в книге (там это нужно для pandas_gbq)."""    return [tuple(str(v) if isinstance(v, date) else v for v in row) for row in rows]

def pipeline(source, target):    # Список таблиц берём из метаданных (в MySQL - information_schema.tables)    tables = [r[0] for r in source.execute(        "SELECT name FROM sqlite_master WHERE type = 'table' ORDER BY name")]    for table in tables:        cols, rows = extract_table(table, source)        rows = transform_rows(cols, rows)        load_table(target, table, cols, rows)        print(f"Загружена таблица {table}, строк: {len(rows)}")
Загружена таблица channels, строк: 3Загружена таблица customers, строк: 2Загружена таблица purchase_history, строк: 2[(1, 'Анна', '1990-04-12', 'text'), (2, 'Иван', '1985-11-03', 'text')]Последняя строка показывает, что дата рождения пришла в приёмник строкой (text).
Аналитическое моделирование данных
Заголовок раздела «Аналитическое моделирование данных»Аналитическая модель описывает бизнес так, чтобы его было удобно анализировать. Авторы напоминают четыре шага:
- Найти бизнес-процессы: ключевые операции, потоки данных и связи между отделами. Так видно, где данные рождаются, меняются и используются.
- Выделить факты и измерения. Факты — это то, что измеряют и считают: продажи, заказы, трафик сайта. Измерения дают фактам контекст и описывают их.
- Описать атрибуты каждого измерения. У товара это, например, цвет, размер, вес и цена, а у клиента — возраст, пол и место жительства.
- Выбрать
grainфактов, то есть уровень детализации одной строки. В рознице это может быть отдельная покупка или итог за день, неделю, месяц. Выбор зависит от целей анализа, доступных данных и нужной детализации.
Бизнес-процессы
Заголовок раздела «Бизнес-процессы»Интервью с заказчиками выявили две цели. Первая — следить за продажами по каналам. Вторая — следить за визитами и долей отказов (bounce rate) по каналам, чтобы видеть, какие каналы приводят трафик и где люди уходят, ничего не сделав.
Отсюда два бизнес-процесса:
- учёт продаж собирает данные о продажах в разных каналах: сайт, мобильное приложение, Instagram. Он помогает оптимизировать каналы и прогнозировать продажи;
- анализ эффективности сайта собирает данные о визитах и отказах. Для него нужны инструменты веб-аналитики, которые следят за поведением пользователей.
Факты и измерения
Заголовок раздела «Факты и измерения»Из двух процессов авторы выводят четыре измерения и две таблицы фактов:
| Таблица | Что описывает | Зачем |
|---|---|---|
dim_channels | Каналы продаж и маркетинга: сайт, Instagram, мобильное приложение | Сравнить выручку и эффективность каналов |
dim_products | Товары | Найти лидеров продаж и слабые категории |
dim_customers | Клиенты | Понять предпочтения и поведение покупателей |
dim_date | Даты | Увидеть тренды и сезонность |
fct_purchase_history | Покупки; связана с каналами, товарами, клиентами и датой | Анализ продаж в любом разрезе |
fct_visit_history | Визиты; связана с каналами, клиентами и датой | Вовлечённость, трафик, эффект кампаний |
Этого уже достаточно, чтобы нарисовать star schema. Атрибуты и иерархии авторы уточняют на следующем шаге.
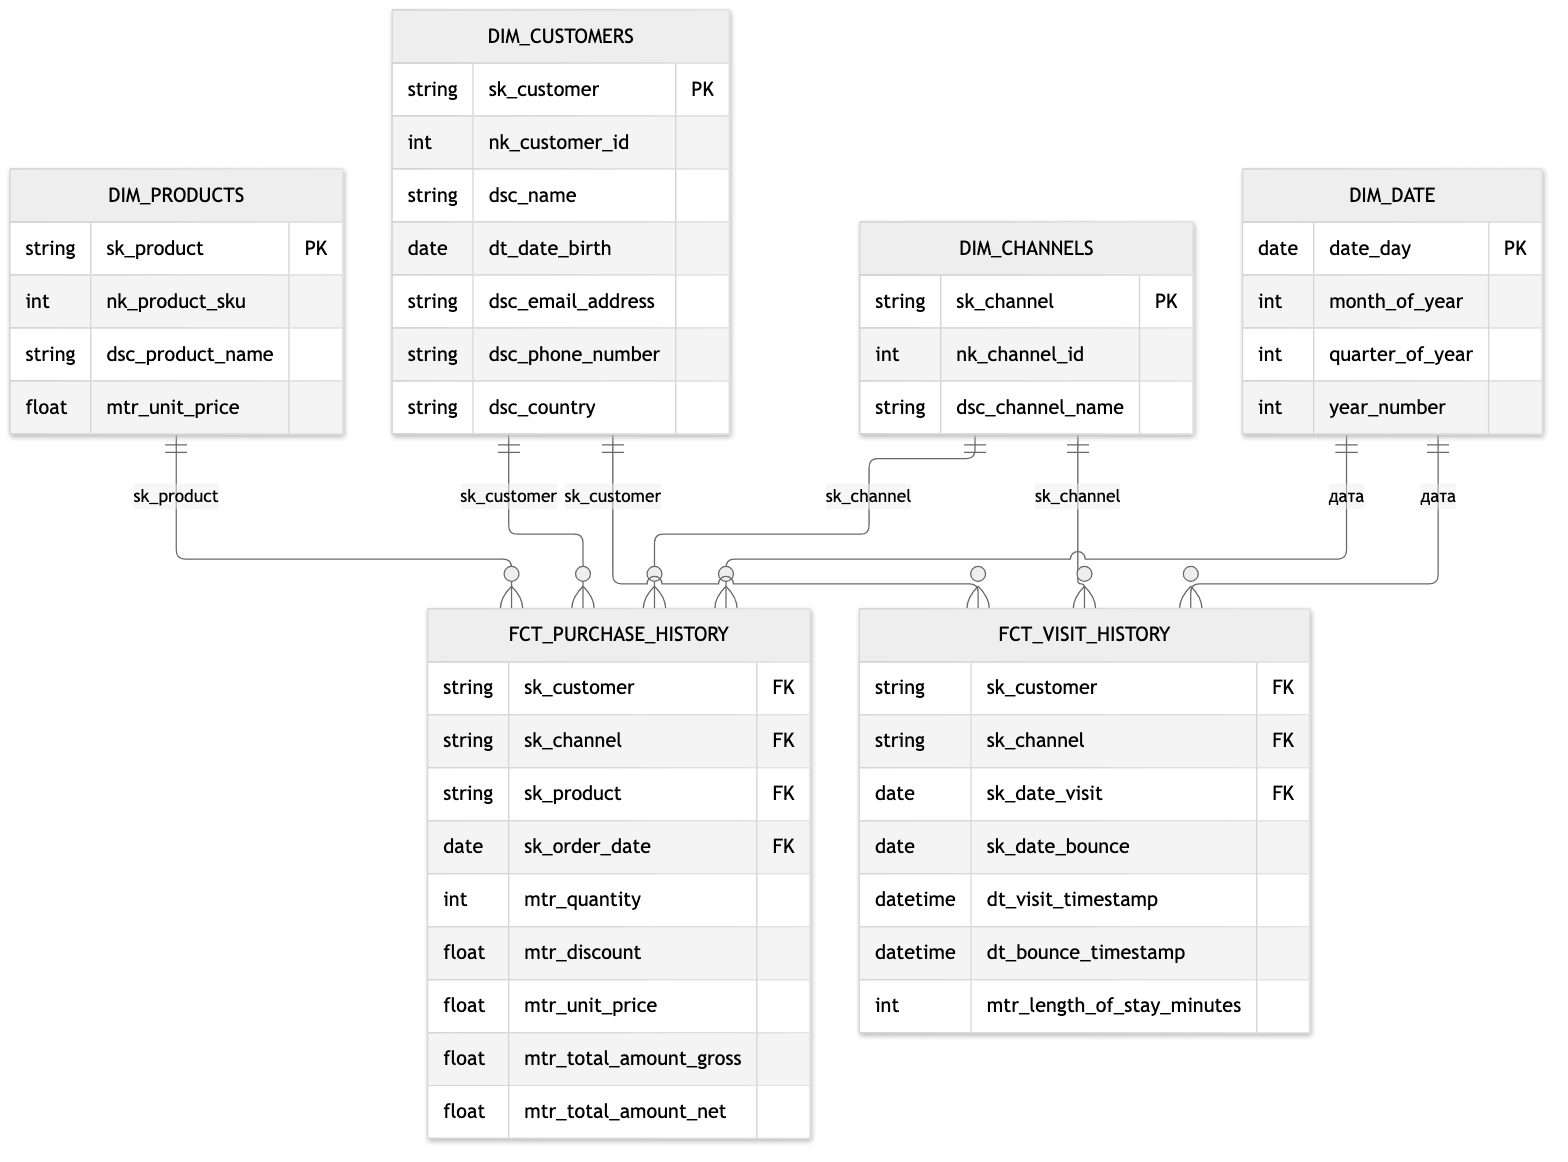
На схеме две звезды с общими лучами. Три измерения — dim_channels, dim_customers и dim_date — это conformed dimension, то есть измерения, общие для нескольких таблиц фактов. Они дают одинаковые срезы в обеих звёздах, поэтому продажи и визиты можно анализировать вместе.
Атрибуты измерений
Заголовок раздела «Атрибуты измерений»Атрибуты описывают свойства каждого измерения и дают больше деталей для анализа. Во всех измерениях повторяется одна схема:
surrogate key(sk_) — уникальный ключ строки внутри хранилища;natural key(nk_) — ключ из исходной системы, по нему измерение связывают с внешними данными;- описательные поля.
По измерениям состав такой:
dim_channels:sk_channel,nk_channel_idиdsc_channel_name. Название канала, по мнению авторов, самое интересное поле для анализа.dim_products:sk_product,nk_product_sku,dsc_product_nameи ценаmtr_unit_priceдля анализа цен и расчёта выручки.dim_customers:sk_customer,nk_customer_id, имя, дата рождения, email, телефон и страна. Эти поля нужны для сегментации, персонального маркетинга и анализа поведения.dim_date: сама дата, а также месяц, квартал и год для анализа по периодам.
Авторы отдельно объясняют, зачем нужен surrogate key. Это искусственный ключ, не связанный с самими данными. Он уникален и стабилен: не меняется, даже если поменялся natural key в исходной системе. С ним проще соединять таблицы, интегрировать данные и строить индексы.
Grain фактов
Заголовок раздела «Grain фактов»Последний шаг — выбрать grain. Он должен давать достаточно деталей для анализа, но не перегружать модель и не замедлять запросы.
- В
fct_purchase_historyодна строка — одна покупка клиента. Так можно разбирать отдельные транзакции, искать тренды в поведении клиентов и анализировать товары. - В
fct_visit_historyодна строка — один визит клиента через конкретный канал.
Из детального grain потом можно получить агрегаты за день, неделю или месяц. Они занимают меньше места и помогают увидеть общие тренды, сезонность и итоги по нескольким измерениям.
Хранилище данных в dbt
Заголовок раздела «Хранилище данных в dbt»Инфраструктура уже есть: BigQuery подключили на этапе архитектуры. Осталось создать проект dbt и связать его с BigQuery и GitHub. Пошаговая настройка описана в главе 4, поэтому здесь её пропускают.
Цель раздела — превратить аналитическую модель в модели dbt. Параллельно авторы пишут YAML-файлы, чтобы пользоваться функциями ref() и source() и соблюдать принцип DRY (Don’t Repeat Yourself — не повторяться). Ещё нужен слой staging: из него строят измерения и факты.
Соглашение об именах
Заголовок раздела «Соглашение об именах»Чтобы хранилище было понятным, все объекты называют по одним правилам. Префикс сразу говорит, что перед вами:
| Префикс | Где | Значение |
|---|---|---|
stg | таблица или CTE | слой staging |
dim | таблица | измерение |
fct | таблица | таблица фактов |
sk / nk | колонка | surrogate key / natural key |
mtr | колонка | метрика, число |
dsc | колонка | описание, текст |
dt | колонка | дата и время |
Слой staging
Заголовок раздела «Слой staging»Структура проекта простая: в папке models/ всего две папки, staging/ и marts/. YAML-файлы разделены, как советует глава 4: один для source, другой для моделей. Файл _omnichannel_raw_sources.yml лежит в staging/ и объявляет пять сырых таблиц датасета omnichannel_raw:
version: 2sources: - name: omnichannel schema: omnichannel_raw tables: - name: Channels - name: Customers - name: Products - name: VisitHistory - name: PurchaseHistoryПояснение: в книге у
sourceесть строкаdatabase: my-gcp-project(проект BigQuery). Мы её убрали: в DuckDB нет такого проекта, иdbtберёт текущую базу.
Для каждой сырой таблицы есть своя staging-модель. Все пять устроены одинаково: CTE выбирает нужные колонки через source(), а внешний SELECT отдаёт результат.
-- models/staging/stg_channels.sqlwith raw_channels as ( select channel_id, channel_name, created_at, updated_at from {{ source('omnichannel', 'Channels') }})select * from raw_channelsВторой файл, _omnichannel_raw_models.yml, просто перечисляет пять моделей stg_*. По словам авторов, он даёт понятную картину слоя и помогает управлять его моделями.
Измерения
Заголовок раздела «Измерения»Измерения строят в папке marts/ из staging-моделей. Каждая модель переименовывает колонки по соглашению и добавляет surrogate key. Ключ считает функция generate_surrogate_key() из пакета dbt_utils: она получает список колонок natural key и строит из них хеш.
-- models/marts/dim_products.sqlwith stg_dim_products as ( select product_sku as nk_product_sku, product_name as dsc_product_name, unit_price as mtr_unit_price, created_at as dt_created_at, updated_at as dt_updated_at from {{ ref('stg_products') }})select {{ dbt_utils.generate_surrogate_key(['nk_product_sku']) }} as sk_product, *from stg_dim_productsdim_date устроена иначе: её не берут из staging. Всю таблицу дат генерирует macro из пакета dbt_date — {{ dbt_date.get_date_dimension("2022-01-01", "2024-12-31") }}. Он сам создаёт колонки и строки за весь диапазон.
Пакеты нужно установить. Их перечисляют в packages.yml, затем запускают dbt deps и dbt build и проверяют, что измерения появились в BigQuery:
packages: - package: dbt-labs/dbt_utils version: 1.1.1 - package: calogica/dbt_date version: [">=0.7.0", "<0.8.0"]Таблицы фактов
Заголовок раздела «Таблицы фактов»fct_purchase_history отвечает на первый бизнес-процесс — продажи по каналам. Модель берёт строки из stg_purchase_history и переименовывает колонки в CTE. Затем через LEFT JOIN с тремя измерениями она находит surrogate key клиента, канала и товара. Если natural key не нашёлся в измерении, COALESCE() ставит '-1'. Дату заказа приводят к DATE, и она служит ключом к dim_date. Ещё модель считает две метрики:
mtr_total_amount_gross— сумма без скидки: количество × цена;mtr_total_amount_net— сумма со скидкой: количество × цена × (1 − скидка).
Например, 2 куртки по 129,99 со скидкой 0,15 дают 259,98 без скидки и 220,98 со скидкой.
-- models/marts/fct_purchase_history.sqlwith stg_fct_purchase_history as ( select customer_id as nk_customer_id, channel_id as nk_channel_id, product_sku as nk_product_sku, cast(order_date as date) as dt_order_date, quantity as mtr_quantity, discount as mtr_discount from {{ ref('stg_purchase_history') }})select coalesce(dcust.sk_customer, '-1') as sk_customer, coalesce(dchan.sk_channel, '-1') as sk_channel, coalesce(dprod.sk_product, '-1') as sk_product, fct.dt_order_date as sk_order_date, fct.mtr_quantity, fct.mtr_discount, dprod.mtr_unit_price, round(fct.mtr_quantity * dprod.mtr_unit_price, 2) as mtr_total_amount_gross, round(fct.mtr_quantity * dprod.mtr_unit_price * (1 - fct.mtr_discount), 2) as mtr_total_amount_netfrom stg_fct_purchase_history as fctleft join {{ ref('dim_customers') }} as dcust on fct.nk_customer_id = dcust.nk_customer_idleft join {{ ref('dim_channels') }} as dchan on fct.nk_channel_id = dchan.nk_channel_idleft join {{ ref('dim_products') }} as dprod on fct.nk_product_sku = dprod.nk_product_skufct_visit_history отвечает на второй процесс — визиты и отказы. Так же, как таблица покупок, она соединяется с измерениями клиентов и каналов и хранит дату и время визита и отказа. Метрика mtr_length_of_stay_minutes — это длительность визита в минутах от визита до отказа, в BigQuery её считает DATE_DIFF(..., MINUTE). Она помогает понять, где люди уходят быстро, и снизить долю отказов.
Пояснение: у
COALESCE(..., '-1')есть подвох. В измерениях из книги нет строки с ключом'-1', поэтому такой заказ провалит тестrelationshipsиз следующего раздела. Обычно в каждое измерение добавляют строку «неизвестно» с этим ключом. Это можно проверить в задании 3 ниже.
Тесты, документация и развёртывание
Заголовок раздела «Тесты, документация и развёртывание»Авторы напоминают, что в dbt тесты и документацию пишут вместе с моделями. Здесь их вынесли в отдельный раздел только для ясности.
Тесты проверяют связи между фактами и измерениями, согласованность данных и правильность расчётных метрик. Нужны оба вида тестов:
singular testпроверяет конкретную вещь: одну метрику или связь одного факта с измерением;generic testпроверяет общие правила и следит, чтобы модели работали правильно в разных ситуациях: по разным измерениям, периодам и сценариям.
Документация нужна для передачи знаний и поддержки. В ней описывают назначение, структуру и допущения модели, логику трансформаций и бизнес-правила. Авторы советуют писать её в тех же YAML-файлах.
Последний шаг — выход в production: модели разворачивают в рабочей среде и настраивают регулярное обновление. Перед полным запуском полезно прогнать тесты в среде, похожей на production, и собрать отзывы пользователей.
Generic-тесты
Заголовок раздела «Generic-тесты»Первая группа — generic test в файле _omnichannel_marts.yml слоя marts. Они проверяют два правила:
- в каждом измерении
surrogate keyуникален и не пустой (unique,not_null), а вdim_dateтак проверяютdate_day; - каждый
surrogate keyв таблице фактов есть в своём измерении (relationships).
version: 2models: - name: dim_customers columns: - name: sk_customer tests: [unique, not_null] - name: fct_purchase_history columns: - name: sk_customer tests: - relationships: to: ref('dim_customers') field: sk_customerТесты запускают командой dbt test. В книге все они проходят.
Singular-тесты
Заголовок раздела «Singular-тесты»Вторая группа — singular test для метрик фактов. Каждый тест — это отдельный SQL-файл в папке tests/, и он падает, если запрос вернул хотя бы одну строку:
assert_mtr_total_amount_gross_is_positive.sql: суммаmtr_total_amount_grossпо клиенту, каналу и товару не бывает отрицательной;assert_mtr_unit_price_is_equal_or_lower_than_mtr_total_amount_gross.sql: цена единицы не больше суммы без скидки. Дляmtr_total_amount_netтакой тест не подходит, потому что скидка уменьшает сумму;assert_mtr_length_of_stay_is_positive.sql: длительность визита не отрицательна. Иначе отказ записан раньше визита, а такого быть не может.
-- tests/assert_mtr_length_of_stay_is_positive.sqlselect sk_customer, sk_channel, sum(mtr_length_of_stay_minutes) as mtr_length_of_stay_minutesfrom {{ ref('fct_visit_history') }}group by 1, 2having mtr_length_of_stay_minutes < 0Чтобы запустить только их, без generic test, есть команда dbt test --select test_type:singular.
Документация
Заголовок раздела «Документация»Описания добавляют в тот же _omnichannel_marts.yml: поле description у модели и у колонок. Например, про dim_customers написано, что там все клиенты, включая гостей, которые оформили заказ без регистрации. В книге описаны только колонки с тестами, чтобы пример был короче, но для остальных колонок всё делается так же. Потом dbt docs generate строит сайт документации, где у каждой модели есть своя страница.
Развёртывание в production
Заголовок раздела «Развёртывание в production»В dbt Cloud создают среду (environment) Production с датасетом omnichannel_analytics. Затем создают job:
- задают имя и выбирают среду Production;
- ставят флажок «Generate docs on run»;
- в командах пишут
dbt build, а под нимdbt test; - остальное оставляют по умолчанию.
Затем job запускают вручную, проверяют логи и смотрят в BigQuery: там должны появиться все модели.
Анализ данных на SQL
Заголовок раздела «Анализ данных на SQL»Когда star schema готова, начинается анализ. Такая модель позволяет просто взять метрики из фактов и добавить к ним атрибуты измерений. Авторы показывают четыре запроса к omnichannel_analytics:
| Вопрос | Приём | Вывод в книге |
|---|---|---|
| Сумма продаж со скидкой по кварталам | fct_purchase_history + dim_date, GROUP BY по году и кварталу | Лучший — II квартал 2023 года, худший — I квартал 2024-го |
| Среднее время визита по каналам | fct_visit_history + dim_channels, ROUND(AVG(...), 2) | На сайте люди проводят больше времени, чем в приложении и Instagram |
| Топ-3 товара в каждом канале | Два CTE: суммы по товару и каналу, затем RANK() OVER (PARTITION BY канал ORDER BY сумма DESC). Три канала дают девять строк | Лидеры: куртка-бомбер в приложении (€389,97), кожаная сумка на сайте (€449,97), кроссовки в Instagram (€271,97) |
| Топ-3 покупателя в мобильном приложении | CTE, ORDER BY и LIMIT 3 вместо оконной функции | Лучший покупатель потратил €389,97, ему можно написать письмо с благодарностью |
Вывод авторов: star schema делает даже сложные бизнес-вопросы простыми. Но главная польза — когда такие запросы строят на CTE: код становится структурированным и читаемым, а промежуточные результаты можно переиспользовать. Оконные функции дают ещё больше: они считают агрегаты по разделам данных и помогают увидеть тренды, рейтинги и сравнения. Твёрдое знание SQL, навыки моделирования и понимание инструментов вроде dbt вместе дают основу для роста в analytics engineering.
Заключение книги
Заголовок раздела «Заключение книги»Базы данных и SQL авторы называют фундаментом аналитики. Но требования выросли, и в аналитику пришло сложное моделирование: теперь важно рассказать историю бизнеса и предвидеть будущие потребности. dbt для авторов — не просто дополнение к SQL, ведь он меняет совместную работу, тестирование и документацию. Аналитика они сравнивают с Шерлоком Холмсом, который собирает историю из разрозненных улик, а dbt — с его помощником Ватсоном.
Итоги главы
Заголовок раздела «Итоги главы»- Проект проходит весь путь данных: операционная база, загрузка, хранилище, тесты, production и SQL-анализ.
- Операционную базу моделируют в три этапа: концептуальная модель, логическая и физическая под MySQL.
- Простой Python-скрипт
ETLберёт список таблиц изinformation_schemaи заменяет таблицы в BigQuery целиком; в жизни выгрузку лучше делать инкрементальной. - Аналитическая модель строится в четыре шага: бизнес-процессы, факты и измерения, атрибуты,
grain. - Два бизнес-процесса дают две таблицы фактов и четыре измерения, три из которых —
conformed dimension. - Соглашение об именах (
stg,dim,fct,sk,nk,mtr,dsc,dt) делает хранилище понятным и единообразным. generic testпроверяет ключи и связи, аsingular test— бизнес-правила для метрик.star schemaиCTEс оконными функциями превращают бизнес-вопросы в короткие запросы.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Омниканальная аналитика | Анализ пути клиента через все каналы: сайт, приложение, поддержку |
ERD | Диаграмма сущностей и связей |
| Служебные колонки | CREATED_AT и UPDATED_AT: когда строку создали и изменили |
CDC | Change Data Capture: захват изменений в исходной базе |
information_schema | Служебная схема СУБД с метаданными о таблицах и колонках |
conformed dimension | Измерение, общее для нескольких таблиц фактов |
surrogate key | Искусственный ключ строки в хранилище |
natural key | Ключ строки из исходной системы |
grain | Что означает одна строка таблицы фактов |
Отказ (bounce) | Уход из канала без каких-либо действий |
| Соглашение об именах | Правила префиксов для таблиц и колонок |
job | Запланированный запуск команд dbt в dbt Cloud |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Добавляйте
created_atиupdated_atво все таблицы исходной базы, которые вы контролируете. Без них нельзя сделать инкрементальную загрузку. - Начинайте хранилище с бизнес-процессов и
grain, а не с таблиц исходной системы. - Договоритесь о префиксах колонок до первой модели. Переименовывать сотни колонок потом дорого.
- Если в фактах есть
COALESCE(..., '-1'), добавьте строку'-1'в каждое измерение, иначе тестrelationshipsупадёт. - Пишите тесты на ключи для каждого измерения и
singular testна каждую расчётную метрику.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. Мы повторим проект в миниатюре: сырой слой, модели в виде обычного SQL, тесты и запросы.
Шаг 1. Создаём сырые таблицы
Заголовок раздела «Шаг 1. Создаём сырые таблицы»-- Сырой слой (в книге - датасет omnichannel_raw)CREATE TABLE raw_channels ASSELECT * FROM (VALUES (1, 'Website'), (2, 'Mobile App'), (3, 'Instagram')) t(channel_id, channel_name);
CREATE TABLE raw_products ASSELECT * FROM (VALUES (101, 'Кожаная сумка', 149.99), (102, 'Куртка-бомбер', 129.99), (103, 'Кроссовки', 89.99), (104, 'Худи', 59.99), (105, 'Кепка', 19.99)) t(product_sku, product_name, unit_price);
CREATE TABLE raw_customers ASSELECT * FROM (VALUES (1, 'Анна', 'anna@example.com'), (2, 'Иван', 'ivan@example.com'), (3, 'Мария', 'maria@example.com'), (4, 'Олег', 'oleg@example.com'), (5, 'Елена', 'elena@example.com')) t(customer_id, name, email_address);
CREATE TABLE raw_purchase_history ASSELECT customer_id, product_sku, channel_id, quantity, discount, CAST(order_ts AS TIMESTAMP) AS order_dateFROM (VALUES (1, 101, 1, 1, 0.10, '2023-04-03 10:15'), (2, 102, 2, 2, 0.00, '2023-05-20 18:40'), (3, 103, 3, 1, 0.00, '2023-06-11 12:05'), (1, 104, 2, 3, 0.05, '2023-08-02 09:30'), (4, 101, 1, 2, 0.15, '2023-11-24 20:10'), (5, 105, 3, 4, 0.00, '2023-12-01 14:00'), (2, 103, 2, 1, 0.00, '2024-01-15 11:45'), (3, 102, 1, 1, 0.20, '2024-02-03 16:20'), (5, 104, 1, 2, 0.00, '2024-04-09 13:00'), (4, 103, 3, 2, 0.10, '2024-05-17 19:55'), (1, 105, 2, 1, 0.00, '2024-06-30 08:25'), (3, 101, 2, 1, 0.00, '2024-07-04 21:10')) t(customer_id, product_sku, channel_id, quantity, discount, order_ts);
CREATE TABLE raw_visit_history ASSELECT customer_id, channel_id, CAST(visit_ts AS TIMESTAMP) AS visit_timestamp, CAST(bounce_ts AS TIMESTAMP) AS bounce_timestampFROM (VALUES (1, 1, '2023-04-03 10:02', '2023-04-03 10:20'), (2, 2, '2023-05-20 18:31', '2023-05-20 18:44'), (3, 3, '2023-06-11 11:58', '2023-06-11 12:03'), (4, 1, '2023-11-24 19:50', '2023-11-24 20:16'), (5, 3, '2023-12-01 13:55', '2023-12-01 13:57'), (2, 2, '2024-01-15 11:40', '2024-01-15 11:49'), (3, 1, '2024-02-03 16:00', '2024-02-03 16:31'), (1, 2, '2024-06-30 08:20', NULL)) t(customer_id, channel_id, visit_ts, bounce_ts);Шаг 2. Строим модели
Заголовок раздела «Шаг 2. Строим модели»Это то, что dbt получил бы после компиляции Jinja: вместо source() и ref() стоят имена таблиц.
-- staging: одна view на одну сырую таблицу (в dbt - stg_*.sql с source())CREATE VIEW stg_channels AS SELECT channel_id, channel_name FROM raw_channels;CREATE VIEW stg_products AS SELECT product_sku, product_name, unit_price FROM raw_products;CREATE VIEW stg_customers AS SELECT customer_id, name, email_address FROM raw_customers;CREATE VIEW stg_purchase_history AS SELECT * FROM raw_purchase_history;CREATE VIEW stg_visit_history AS SELECT * FROM raw_visit_history;
-- Измерения. md5 от natural key - так работает dbt_utils.generate_surrogate_keyCREATE TABLE dim_channels ASSELECT md5(CAST(channel_id AS VARCHAR)) AS sk_channel,       channel_id AS nk_channel_id, channel_name AS dsc_channel_nameFROM stg_channels;
CREATE TABLE dim_products ASSELECT md5(CAST(product_sku AS VARCHAR)) AS sk_product,       product_sku AS nk_product_sku, product_name AS dsc_product_name,       unit_price AS mtr_unit_priceFROM stg_products;
CREATE TABLE dim_customers ASSELECT md5(CAST(customer_id AS VARCHAR)) AS sk_customer,       customer_id AS nk_customer_id, name AS dsc_name, email_address AS dsc_email_addressFROM stg_customers;
-- Аналог dbt_date.get_date_dimension("2022-01-01", "2024-12-31")CREATE TABLE dim_date ASSELECT CAST(d AS DATE) AS date_day, year(d) AS year_number,       quarter(d) AS quarter_of_year, month(d) AS month_of_yearFROM generate_series(TIMESTAMP '2022-01-01', TIMESTAMP '2024-12-31', INTERVAL 1 DAY) g(d);
-- ФактыCREATE TABLE fct_purchase_history ASSELECT COALESCE(dcust.sk_customer, '-1') AS sk_customer,       COALESCE(dchan.sk_channel, '-1') AS sk_channel,       COALESCE(dprod.sk_product, '-1') AS sk_product,       CAST(f.order_date AS DATE) AS sk_order_date,       f.quantity AS mtr_quantity,       f.discount AS mtr_discount,       dprod.mtr_unit_price,       ROUND(f.quantity * dprod.mtr_unit_price, 2) AS mtr_total_amount_gross,       ROUND(f.quantity * dprod.mtr_unit_price * (1 - f.discount), 2) AS mtr_total_amount_netFROM stg_purchase_history fLEFT JOIN dim_customers dcust ON f.customer_id = dcust.nk_customer_idLEFT JOIN dim_channels dchan ON f.channel_id = dchan.nk_channel_idLEFT JOIN dim_products dprod ON f.product_sku = dprod.nk_product_sku;
CREATE TABLE fct_visit_history ASSELECT COALESCE(dcust.sk_customer, '-1') AS sk_customer,       COALESCE(dchan.sk_channel, '-1') AS sk_channel,       CAST(v.visit_timestamp AS DATE) AS sk_date_visit,       v.visit_timestamp AS dt_visit_timestamp,       v.bounce_timestamp AS dt_bounce_timestamp,       date_diff('minute', v.visit_timestamp, v.bounce_timestamp) AS mtr_length_of_stay_minutesFROM stg_visit_history vLEFT JOIN dim_customers dcust ON v.customer_id = dcust.nk_customer_idLEFT JOIN dim_channels dchan ON v.channel_id = dchan.nk_channel_id;
Шаг 3. Проверяем
Заголовок раздела «Шаг 3. Проверяем»Каждый запрос считает строки, которые нарушают правило. Везде должен быть 0.
-- Тесты как в dbt: каждый запрос считает «плохие» строки, норма - 0SELECT 'unique + not_null: dim_customers.sk_customer' AS test, count(*) - count(DISTINCT sk_customer) AS failures FROM dim_customersUNION ALLSELECT 'relationships: fct_purchase_history -> dim_customers', count(*) FROM fct_purchase_history WHERE sk_customer NOT IN (SELECT sk_customer FROM dim_customers)UNION ALLSELECT 'relationships: fct_visit_history -> dim_channels', count(*) FROM fct_visit_history WHERE sk_channel NOT IN (SELECT sk_channel FROM dim_channels)UNION ALLSELECT 'singular: mtr_total_amount_gross >= 0', count(*) FROM fct_purchase_history WHERE mtr_total_amount_gross < 0UNION ALLSELECT 'singular: mtr_length_of_stay_minutes >= 0', count(*) FROM fct_visit_history WHERE mtr_length_of_stay_minutes < 0;┌──────────────────────────────────────────────────────┬──────────┐│ test │ failures ││ varchar │ int64 │├──────────────────────────────────────────────────────┼──────────┤│ unique + not_null: dim_customers.sk_customer │ 0 ││ relationships: fct_purchase_history -> dim_customers │ 0 ││ relationships: fct_visit_history -> dim_channels │ 0 ││ singular: mtr_total_amount_gross >= 0 │ 0 ││ singular: mtr_length_of_stay_minutes >= 0 │ 0 │└──────────────────────────────────────────────────────┴──────────┘Шаг 4. Первый вопрос бизнеса
Заголовок раздела «Шаг 4. Первый вопрос бизнеса»Запрос из книги: среднее время визита по каналам.
-- Пример 6-30: среднее время визита по каналамSELECT dc.dsc_channel_name, ROUND(AVG(fct.mtr_length_of_stay_minutes), 2) AS avg_length_of_stay_minutesFROM fct_visit_history fctLEFT JOIN dim_channels dc ON fct.sk_channel = dc.sk_channelGROUP BY dc.dsc_channel_nameORDER BY avg_length_of_stay_minutes DESC;┌──────────────────┬────────────────────────────┐│ dsc_channel_name │ avg_length_of_stay_minutes ││ varchar │ double │├──────────────────┼────────────────────────────┤│ Website │ 25.0 ││ Mobile App │ 11.0 ││ Instagram │ 3.5 │└──────────────────┴────────────────────────────┘Как и в книге, дольше всего люди остаются на сайте. Визит без отказа (NULL) AVG пропускает.
Задания
Заголовок раздела «Задания»1. Посчитайте сумму продаж со скидкой по годам и кварталам. Какой квартал лучший?
Решение
SELECT dd.year_number, dd.quarter_of_year, ROUND(SUM(fct.mtr_total_amount_net), 2) AS sum_total_amount_with_discountFROM fct_purchase_history fctLEFT JOIN dim_date dd ON dd.date_day = fct.sk_order_dateGROUP BY dd.year_number, dd.quarter_of_yearORDER BY dd.year_number, dd.quarter_of_year;┌─────────────┬─────────────────┬────────────────────────────────┐│ year_number │ quarter_of_year │ sum_total_amount_with_discount ││ int64 │ int64 │ decimal(38,2) │├─────────────┼─────────────────┼────────────────────────────────┤│ 2023 │ 2 │ 484.96 ││ 2023 │ 3 │ 170.97 ││ 2023 │ 4 │ 334.94 ││ 2024 │ 1 │ 193.98 ││ 2024 │ 2 │ 301.95 ││ 2024 │ 3 │ 149.99 │└─────────────┴─────────────────┴────────────────────────────────┘Лучший — II квартал 2023 года, как и в книге. Квартал берём из dim_date, а не считаем из даты заказа.
2. Найдите два самых продаваемых товара в каждом канале с помощью RANK().
Решение
WITH base_cte AS ( SELECT dp.dsc_product_name, dc.dsc_channel_name, ROUND(SUM(fct.mtr_total_amount_net), 2) AS sum_total_amount FROM fct_purchase_history fct LEFT JOIN dim_products dp ON dp.sk_product = fct.sk_product LEFT JOIN dim_channels dc ON dc.sk_channel = fct.sk_channel GROUP BY dc.dsc_channel_name, dp.dsc_product_name),ranked_cte AS ( SELECT *, RANK() OVER (PARTITION BY dsc_channel_name ORDER BY sum_total_amount DESC) AS rank_total_amount FROM base_cte)SELECT * FROM ranked_cteWHERE rank_total_amount <= 2ORDER BY dsc_channel_name, rank_total_amount;┌──────────────────┬──────────────────┬──────────────────┬───────────────────┐│ dsc_product_name │ dsc_channel_name │ sum_total_amount │ rank_total_amount ││ varchar │ varchar │ decimal(38,2) │ int64 │├──────────────────┼──────────────────┼──────────────────┼───────────────────┤│ Кроссовки │ Instagram │ 251.97 │ 1 ││ Кепка │ Instagram │ 79.96 │ 2 ││ Куртка-бомбер │ Mobile App │ 259.98 │ 1 ││ Худи │ Mobile App │ 170.97 │ 2 ││ Кожаная сумка │ Website │ 389.97 │ 1 ││ Худи │ Website │ 119.98 │ 2 │└──────────────────┴──────────────────┴──────────────────┴───────────────────┘PARTITION BY начинает рейтинг заново в каждом канале, поэтому на канал приходится по две строки.
3. Добавьте в факты заказ клиента 99, которого нет в dim_customers, и запустите тест relationships. Что он покажет?
Решение
-- Заказ клиента 99, которого нет в dim_customersINSERT INTO fct_purchase_historySELECT COALESCE(dcust.sk_customer, '-1'), dchan.sk_channel, dprod.sk_product,       DATE '2024-07-10', 1, 0, dprod.mtr_unit_price,       dprod.mtr_unit_price, dprod.mtr_unit_priceFROM (SELECT 99 AS customer_id, 2 AS channel_id, 105 AS product_sku) fLEFT JOIN dim_customers dcust ON f.customer_id = dcust.nk_customer_idLEFT JOIN dim_channels dchan ON f.channel_id = dchan.nk_channel_idLEFT JOIN dim_products dprod ON f.product_sku = dprod.nk_product_sku;
-- Тест relationshipsSELECT sk_customer, count(*) AS failuresFROM fct_purchase_historyWHERE sk_customer NOT IN (SELECT sk_customer FROM dim_customers)GROUP BY sk_customer;┌─────────────┬──────────┐│ sk_customer │ failures ││ varchar │ int64 │├─────────────┼──────────┤│ -1 │ 1 │└─────────────┴──────────┘COALESCE спас строку от NULL, но ключа '-1' нет в измерении, и тест падает. Решение — добавить в dim_customers строку «неизвестный клиент» с ключом '-1'.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Зачем
analytics engineerразбираться в моделировании операционной базы, если он её не проектирует? - Почему служебные колонки
CREATED_ATиUPDATED_ATважны для будущей выгрузки данных? - Как два бизнес-процесса привели к двум таблицам фактов? Почему
dim_productsне сталаconformed dimension? - Когда стоит выбрать
grain«одна покупка», а когда — дневной агрегат? - Чем
singular testотличается отgeneric test? Приведите по примеру из главы. - Что произойдёт с тестом
relationships, еслиCOALESCEпоставит в факт ключ'-1', и как это исправить?
Предыдущая: dbt: продвинутые темы. Это последняя глава книги.