

Analytics Engineering with SQL and dbt, глава 4: Трансформация данных в dbt
Главная мысль: dbt отвечает за шаг T в ELT. Вы пишете обычные SELECT-запросы, а dbt превращает их в таблицы и view в хранилище, сам определяет порядок запуска, проверяет данные тестами, собирает документацию и запускает всё по расписанию. Глава проводит через весь путь на учебной базе Jaffle Shop: от настройки dbt Cloud до job в рабочей среде.
О чём глава
Заголовок раздела «О чём глава»Глава отвечает на вопрос: как устроен dbt и как на нём построить проект от сырых таблиц до готовых витрин. В главе 3 авторы разбирали SQL для аналитики. Здесь этот SQL становится кодом проекта: с контролем версий, тестами и документацией. Слои staging, intermediate и mart пришли из главы 2, а здесь их строят руками.
Темы главы:
- принципы, на которых построен
dbt, и его место в потоке данных; - dbt Cloud: настройка с BigQuery и GitHub, интерфейс и IDE;
- структура проекта и YAML-файлы:
dbt_project.yml,packages.yml,profiles.yml; model,source,source freshness, тесты,analysis,seedи документация;- команды
dbtиselection syntax; jobи развёртывание в рабочую среду.
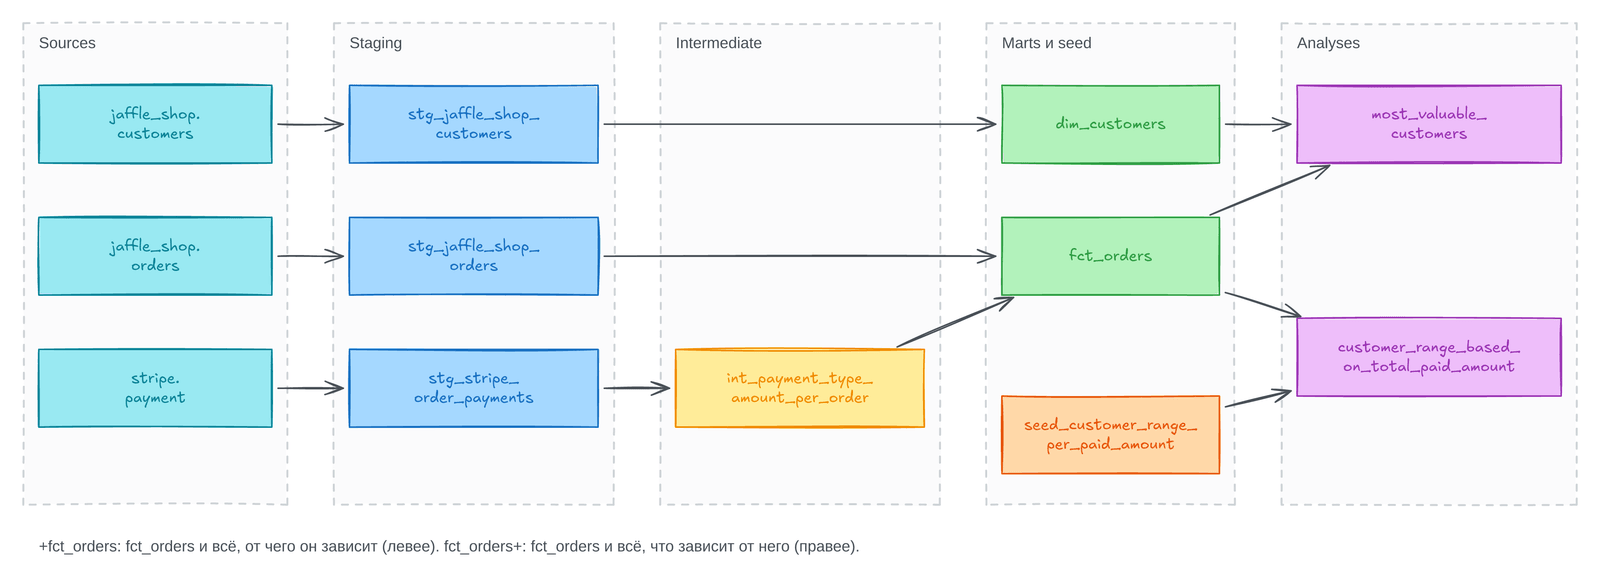
Схема показывает весь проект главы. Данные идут слева направо: из сырых таблиц через staging и intermediate в mart-модели, а оттуда в аналитические запросы. Это и есть граф lineage, который dbt строит сам.
Философия dbt
Заголовок раздела «Философия dbt»Задачи обработки данных становятся сложнее, поэтому нужны инструменты, которые упрощают работу и при этом сохраняют качество данных. Авторы сводят философию dbt к набору принципов:
| Принцип | Что это значит |
|---|---|
| Всё в коде | Трансформации описывают кодом, а не мышкой в графическом интерфейсе и не разрозненными скриптами. Код можно обсуждать, версионировать и автоматизировать |
| Модульность | Модели, macro и тесты собирают в пакеты и переиспользуют. Проект легче поддерживать и наращивать |
Трансформация — это SELECT | Модель — это SELECT-запрос. Порог входа низкий: достаточно знать SQL |
| Декларативный язык | Аналитик описывает, какой результат нужен, а dbt сам решает, как его создать в базе |
| Инкрементальная сборка | Можно обновлять только изменённую часть данных, а не пересчитывать всё. Это быстрее и дешевле |
| Документация как код | Описания моделей и колонок лежат рядом с кодом проекта |
| Тесты и проверки | Встроенный механизм тестов проверяет, что данные отвечают правилам бизнеса |
| Контроль версий | dbt тесно работает с Git: история изменений, совместная работа, откат |
| Работа внутри платформы | dbt использует возможности Snowflake, BigQuery, Redshift и других платформ для масштаба и скорости |
| Открытый код | Сообщество большое, функции расширяют своими macro и пакетами |
| Отделение трансформации от загрузки | dbt не извлекает и не загружает данные. Он преобразует то, что другой инструмент уже загрузил в платформу |
В итоге dbt создаёт среду, где дата-инженеры, аналитики и data scientists вместе преобразуют данные, следят за их качеством и получают выводы для бизнеса.
Поток данных с dbt
Заголовок раздела «Поток данных с dbt»Где место dbt в общей картине? Исходные системы отдают данные, EL-инструмент загружает их в платформу данных (BigQuery, Snowflake, Databricks, Redshift и другие), а dbt превращает сырые таблицы в модели для отчётов и анализа.
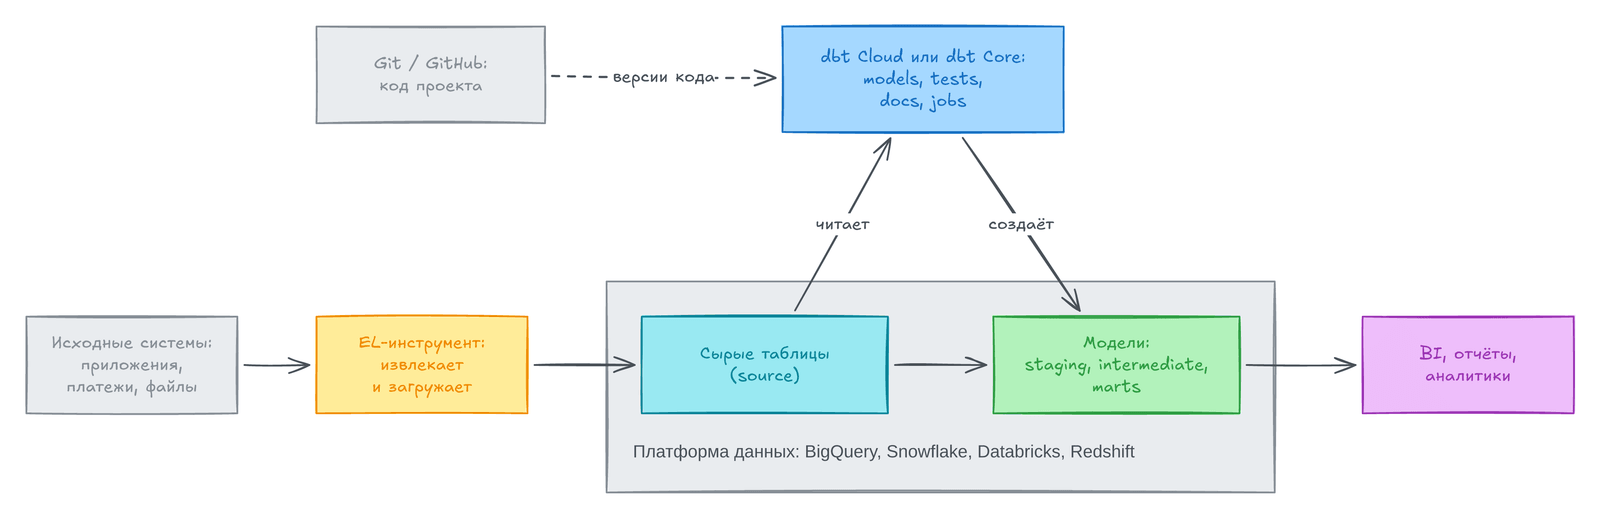
Схему читают слева направо. Обратите внимание: данные не уходят из платформы. dbt только отправляет в неё SQL, а таблицы создаёт сама платформа.
Для этой работы есть два продукта:
- dbt Cloud — облачный сервис от dbt Labs;
- dbt Core — CLI-инструмент с открытым кодом, его ставят на свои серверы или запускают локально.
Пример главы такой: pipeline периодически берёт данные из BigQuery и объединяет таблицы. Первые две таблицы объединяют в одну, а по пути данные чистят. Этот шаг выполняет dbt, поэтому нужен проект dbt. В книге весь код пишут в dbt Cloud: так быстрее всего начать, а под капотом там работает тот же dbt Core с теми же командами.
dbt Cloud
Заголовок раздела «dbt Cloud»dbt Cloud — это облачная версия dbt для разработки и запуска аналитического кода. В ней можно ставить job по расписанию, следить за их ходом, смотреть логи и метрики. Ещё там есть контроль версий, тесты, документация и подключения к Snowflake, BigQuery, Redshift.
Почти всё это умеет и dbt Core. Но его нужно настраивать и обслуживать на своей инфраструктуре. Авторы сравнивают так: dbt Core похож на Airflow на своём сервере EC2, а dbt Cloud похож на управляемый сервис Amazon MWAA. Во втором случае эксплуатацию берёт на себя поставщик, и вы тратите время на аналитику, а не на серверы.
Настройка dbt Cloud с BigQuery и GitHub
Заголовок раздела «Настройка dbt Cloud с BigQuery и GitHub»Авторы советуют учиться на практике и шаг за шагом настраивают рабочую среду. Порядок такой:
- Зарегистрироваться в dbt Cloud. Откроется страница настройки проекта: подключение к платформе данных и к репозиторию кода.
- В Google Cloud создать проект (в книге
dbt-analytics-engineer) и открыть BigQuery. - Проверить публичные данные dbt Labs: таблицы
dbt-tutorial.jaffle_shop.customers,dbt-tutorial.jaffle_shop.ordersиdbt-tutorial.stripe.payment. - Создать сервисный аккаунт
dbt-userс ролью BigQuery Admin и скачать для него JSON-ключ. Ключ — это аналог логина и пароля к базе. - В dbt Cloud выбрать BigQuery, загрузить JSON-файл и нажать «test». Если проверка не прошла, скорее всего, проблема в ключе: его стоит создать заново.
- Подключить GitHub: создать репозиторий и разрешить dbt Cloud доступ к нему.
- Нажать «Initialize dbt project», выполнить в IDE тестовый запрос через Preview и сделать первый
commitкнопкой «Commit and push».
Авторы предупреждают: эти шаги взяты из документации адаптера BigQuery и со временем меняются. Сверяйтесь с актуальной документацией dbt.
Перед подключением GitHub авторы объясняют, как правильно работать с Git. GitHub — это платформа, которая хранит Git-репозитории и помогает работать над кодом вместе. Советы такие:
- Делайте
commitчасто, даже для мелких правок. Одинcommit— одно логическое изменение, без смеси несвязанных правок. - Пишите понятные сообщения: что изменили и зачем.
- Ведите работу в отдельных
branchдля каждой функции или исправления. - Перед
pushделайтеpull, чтобы работать поверх свежего кода и реже ловить конфликты. - Проверяйте свой код до
commit, если в команде принят обзор кода. - Исключайте лишние файлы через
.gitignore: артефакты сборки, временные файлы. - Авторы предпочитают
rebaseвместоmerge: история получается чище. - Не сохраняйте в историю незаконченную работу и отладочный код, для этого есть
git stash. - Ставьте теги на важные точки: релизы, этапы.
- Договоритесь в команде о правилах для
pull requestи конфликтов и запишите их в README. - Умейте отменять изменения:
git revert,git reset,git reflog. - Храните копию в удалённом репозитории и продолжайте изучать
Git:cherry-pick, интерактивныйrebase, hooks.
Основные термины и команды Git собраны ниже. У каждой команды много дополнительных опций, полный список есть в официальной документации.
| Термин | Что значит | Команда |
|---|---|---|
| Репозиторий | Папка проекта со всеми файлами, историей и branch | — |
branch | Отдельное направление разработки, не мешает основному коду | git branch <имя> |
pull request | Предложение влить изменения в основную branch с обзором кода | — |
stash | Временно убрать незаконченные правки, не делая commit | git stash |
commit | Сохранённый набор изменений в определённый момент | git commit -m "..." |
add | Добавить изменения в следующий commit | git add . или git add <путь> |
fork | Своя копия чужого репозитория на GitHub | — |
clone | Локальная копия удалённого репозитория | git clone <url> |
push / pull | Отправить свои изменения / получить чужие | git push, git pull |
status, log, diff | Состояние рабочей папки, история, разница версий | git status, git log, git diff |
merge / rebase | Слить branch / перенести commit на новую базу | git merge, git rebase |
checkout | Переключиться на другую branch или commit | git checkout <имя> |
Интерфейс dbt Cloud
Заголовок раздела «Интерфейс dbt Cloud»После входа dbt Cloud показывает приветствие и историю запусков job. Сначала она пустая. В верхнем меню есть несколько разделов:
- Develop — главное место работы. Здесь пишут модели, тесты и документацию.
- Deploy — меню для рабочей среды. В нём четыре пункта:
- Run History: история запусков
jobсо статусом, длительностью, средой, шагами, логами и артефактами.jobвdbt— это автоматическая задача: запустить модели, тесты или собрать документацию. - Jobs: настройка автоматизации, включая
CI/CD, без ручного запуска команд. - Environments: среды. Их два типа: development и deployment. Среду разработки
dbtсоздаёт сам при настройке проекта. - Data Sources: состояние свежести
source. Страница заполняется сама, еслиjobпроверяет свежесть. По ней видно, выполняются лиSLA, принятые в компании.
- Run History: история запусков
- Documentation — документация проекта. Если команда её ведёт, она отвечает на вопросы: что значат эти данные, как считаются метрики, откуда пришли данные.
Справа вверху есть переключатель проектов, меню помощи (чат с командой dbt, документация, сообщество в Slack и обсуждения на GitHub) и настройки. В настройках три раздела:
- Account Settings: проекты, пользователи и права доступа, оплата;
- Profile Settings: личные данные, связанные аккаунты (GitHub, GitLab, Slack, SSO), учётные данные платформы и ключ API;
- Notification Settings: оповещения в Slack или на почту, когда
jobпрошёл, упал или отменён.
dbt Cloud IDE
Заголовок раздела «dbt Cloud IDE»IDE — это основная часть dbt Cloud: здесь пишут код, тесты и документацию. Авторы делят экран на пять зон:
- Git и документация. Здесь видно, что изменилось с прошлого
commit, и здесь выполняют командыGit:commit,push, откат. Рядом есть значок, который открывает собранную документацию проекта. - File Explorer. Дерево проекта: файлы
.sql,.ymlи другие. - Редактор. Здесь пишут код и YAML-файлы. Можно открыть несколько файлов сразу.
- Информационное окно. Кнопка Preview компилирует запрос, выполняет его в платформе и показывает результат. Compile только превращает Jinja в чистый SQL. Build появляется только в некоторых файлах и собирает выбранные модели, тесты,
seedиsnapshot. Вкладка Lineage показывает граф зависимостей открытой модели. - Командная строка. Здесь запускают
dbt run,dbt testи другие команды и смотрят логи.
Структура проекта dbt
Заголовок раздела «Структура проекта dbt»Проект dbt — это папка с файлами, шаблонами кода и правилами именования. В этих файлах лежит весь аналитический код, тесты, документация и настройки, которые говорят dbt, как работать.
Хороший проект требует усилий. Он должен собрать знания разных отделов и отражать цели всей компании. Поэтому нужны ясные и последовательные правила. Авторы подчёркивают: структуру можно менять под себя, но изменения нужно явно описать для всех участников и строго соблюдать. В книге используют стандартную структуру, которую dbt создаёт при инициализации:
root/├─ analyses/├─ dbt_packages/├─ logs/├─ macros/├─ models/│ └─ example/├─ seeds/├─ snapshots/├─ target/├─ tests/├─ .gitignore├─ dbt_project.yml└─ README.mdНазначение каждой папки:
| Папка или файл | Для чего |
|---|---|
analyses/ | Запросы для аудита и разовых проверок. Например, искать расхождения при переносе логики из старой системы. Jinja и контроль версий работают, но объекты в базе не создаются |
dbt_packages/ | Установленные пакеты. Пакет — это отдельный проект dbt, который решает одну задачу и переиспользуется. Код становится более DRY (Don’t Repeat Yourself) |
logs/ | Логи проекта, если в dbt_project.yml не указано другое |
macros/ | macro — куски кода на Jinja, которые вызывают много раз, как функции в языках программирования. Подробно — в главе 5 |
models/ | Обязательная папка. Модель — это SQL-файл с SELECT, который превращает сырые данные в итоговые. Имя файла становится именем таблицы или view (или ничего не создаётся, если модель ephemeral) |
seeds/ | CSV-файлы со справочниками, которые редко меняются и которых нет в исходных системах: почтовые индексы и регионы, список тестовых адресов почты для исключения |
snapshots/ | snapshot-модели. Они хранят историю изменений строк изменяемой таблицы по схеме SCD типа 2. Подробно — в главе 5 |
target/ | Скомпилированный SQL после dbt run, dbt compile, dbt test |
tests/ | singular test, которые проверяют связи нескольких моделей. Большая часть тестов при этом живёт в YAML рядом с моделями |
dbt_project.yml | Главный файл. По нему dbt понимает, что папка — это проект, и берёт настройки |
.gitignore, README.md | Обычные файлы Git: что не сохранять в репозиторий и описание проекта для других разработчиков |
База Jaffle Shop
Заголовок раздела «База Jaffle Shop»Для примеров нужна база, и авторы берут Jaffle Shop. В ней две таблицы: клиенты (customers) и заказы (orders). Рядом лежит третья таблица из Stripe с платежами по заказам (payment). Все три — это сырые данные. Авторы выбрали эту базу, потому что dbt Labs держит её публично в BigQuery и использует в своих курсах.
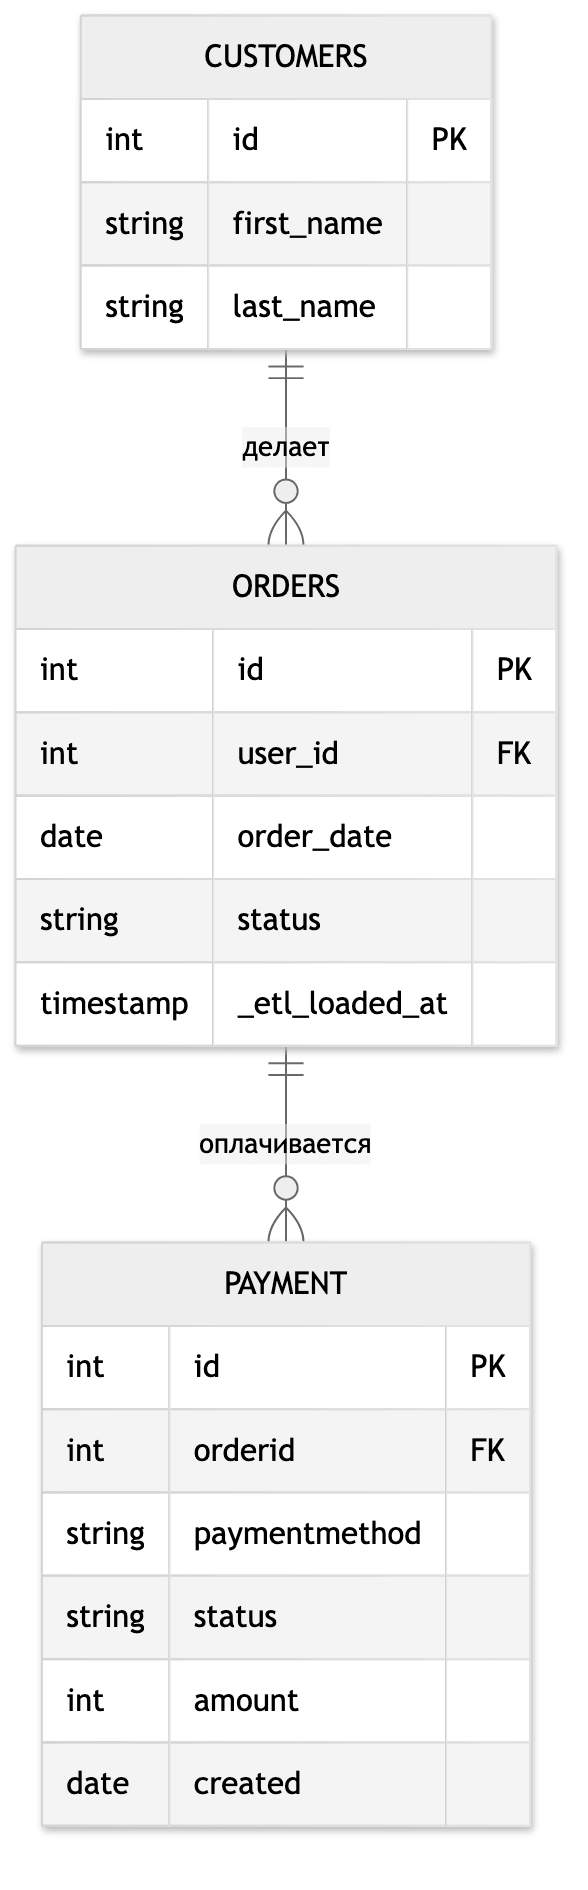
Читается схема так: у одного клиента может быть много заказов, у одного заказа — много попыток оплаты.
Пояснение: BigQuery нужен, только чтобы повторить шаги книги. Весь код этой страницы мы проверили локально на DuckDB с адаптером
dbt-duckdb. Наши данные сгенерированы и меньше оригинала, но структура таблиц та же. Проект лежит в scripts/analytics-engineering-code/ch04_jaffle.
YAML-файлы
Заголовок раздела «YAML-файлы»YAML — это формат данных, который легко читает человек. Его часто используют для конфигураций. В dbt YAML описывает свойства и настройки моделей, snapshot, seed, тестов, source и всего проекта.
Файлы верхнего уровня, такие как dbt_project.yml и packages.yml, должны иметь строгие имена и лежать в корне. Остальные YAML-файлы можно раскладывать как угодно. Главное — держаться одних правил, ясно понимать цель и записать, как и почему файлы разложены именно так. Рекомендации авторов:
- Не держите всё в одном файле. Технически так можно, но в большом проекте трудно найти нужную настройку, а изменения в
Gitтрудно читать. - Лучше подход «один конфиг на папку»: в каждой папке моделей свой YAML для её моделей и отдельный YAML для
source. - Документацию в Markdown (
doc block) тоже кладите по одному файлу.mdна папку моделей. - Подчёркивание в начале имени поднимает файл наверх списка, так его проще найти.
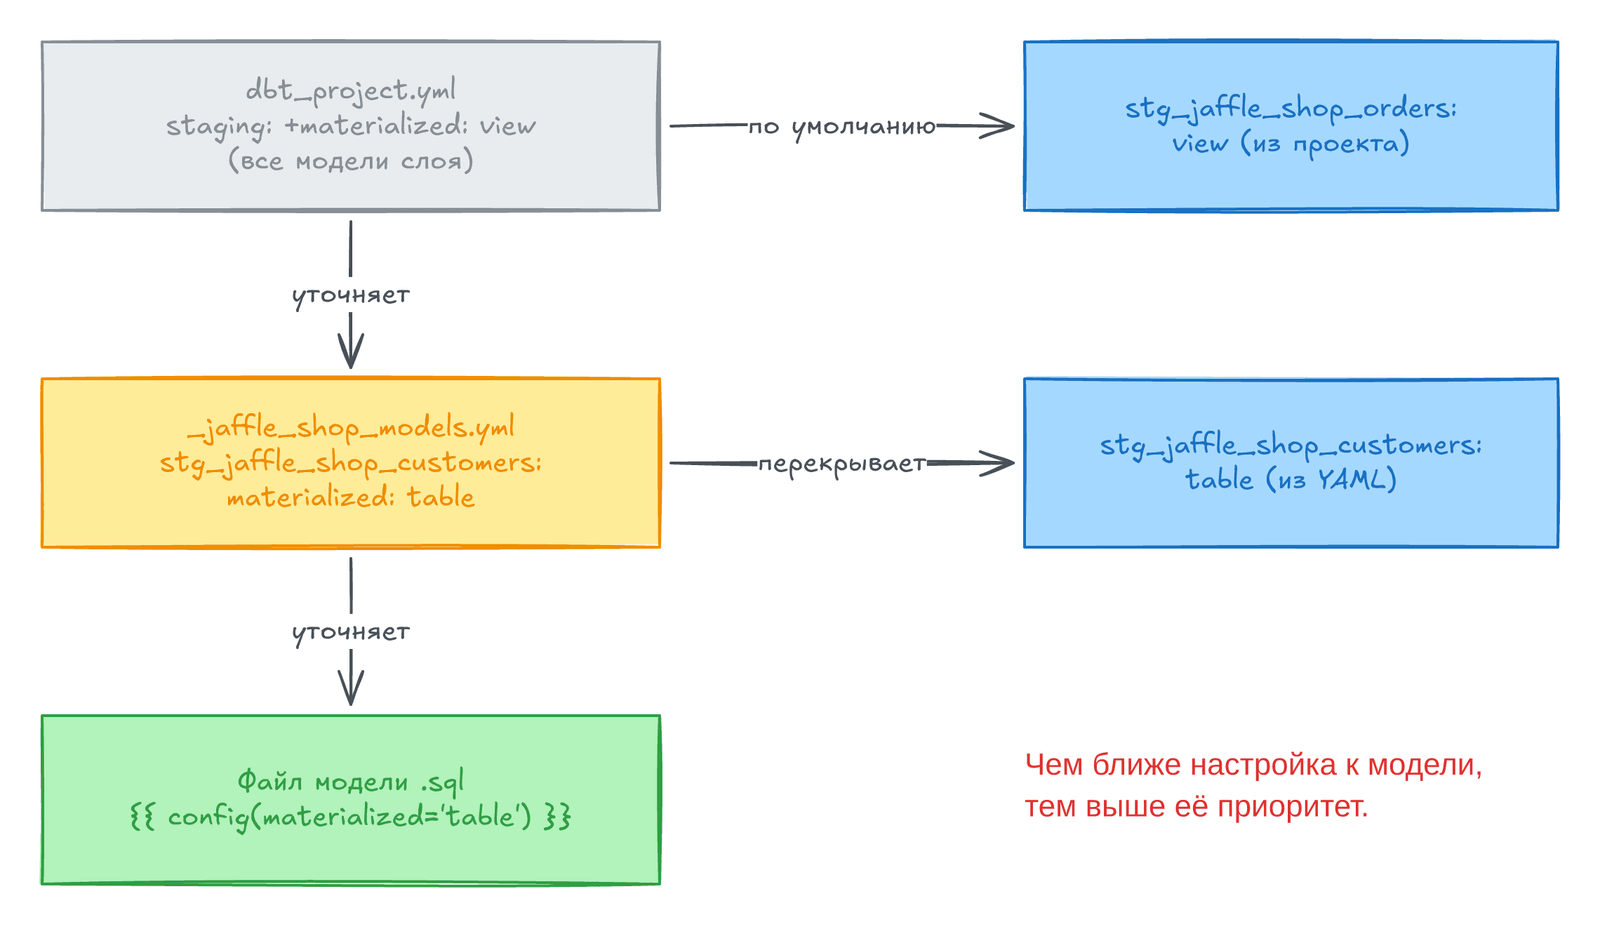
models/└─ staging/ ├─ jaffle_shop/ │ ├─ _jaffle_shop_docs.md │ ├─ _jaffle_shop_models.yml │ ├─ _jaffle_shop_sources.yml │ ├─ stg_jaffle_shop_customers.sql │ └─ stg_jaffle_shop_orders.sql └─ stripe/ ├─ _stripe_docs.md ├─ _stripe_models.yml ├─ _stripe_sources.yml └─ stg_stripe_order_payments.sqlНастройки по умолчанию задают в dbt_project.yml на уровне папок, а исключения — ближе к модели. Так работает cascading scope priority: более конкретная настройка перекрывает общую. Например, все staging-модели по умолчанию становятся view. Но в _jaffle_shop_models.yml можно сказать, что одна модель должна быть таблицей, и остальной проект от этого не изменится.
dbt_project.yml
Заголовок раздела «dbt_project.yml»Это один из важнейших файлов. Он лежит в корне и хранит главные настройки. Все объекты наследуют их, пока не перекроют на уровне модели. Основные поля:
| Поле | Обязательно | Смысл |
|---|---|---|
name | да | Имя проекта. Его стоит поменять на своё и использовать то же имя в разделе models |
version | да | Версия вашего проекта (не версия dbt) |
config-version | да | Версия формата конфигурации, сейчас 2 |
profile | да | Профиль подключения к платформе данных |
[folder]-paths | нет | Пути к папкам: model-paths, seed-paths, macro-paths и другие |
target-path | нет | Куда писать скомпилированный SQL |
clean-targets | нет | Какие папки удаляет dbt clean |
models | нет | Настройки моделей по умолчанию |
В нашем проекте dbt_project.yml задаёт materialization для каждого слоя. materialization — это способ, которым dbt сохраняет модель в базе: view, table, incremental или ephemeral.
# Настройки по умолчанию для каждого слояmodels: jaffle_book: staging: +materialized: view intermediate: +materialized: view marts: +materialized: tableПрефикс + появился в dbt 0.17.0. Он ясно отделяет настройку от имени папки внутри dbt_project.yml.
packages.yml
Заголовок раздела «packages.yml»Пакет — это готовый проект dbt с моделями и macro, который решает типовую задачу. После установки его модели и macro становятся частью вашего проекта. Порядок такой:
- Создать
packages.ymlрядом сdbt_project.yml. - Перечислить пакеты. Их берут из dbt Hub, из Git-репозитория (GitHub, GitLab) или из локальной папки.
- Выполнить
dbt deps. По умолчанию пакеты попадут вdbt_packages/.
packages: - package: dbt-labs/dbt_utils # из dbt Hub version: 1.3.0 # или из Git-репозитория: # - git: "https://github.com/dbt-labs/dbt-utils.git" # revision: 1.3.0 # или из локальной папки: # - local: /opt/dbt/bigqueryОдин и тот же пакет можно подключить только одним способом, поэтому варианты закомментированы. Мы проверили dbt deps для Hub и для Git.
profiles.yml
Заголовок раздела «profiles.yml»Файл profiles.yml нужен, если вы запускаете dbt локально через CLI. Для dbt Cloud он не нужен. В нём лежат параметры подключения к платформе. Файл хранят вне проекта, чтобы учётные данные не попали в репозиторий. Если секреты лежат в переменных среды, файл можно и версионировать.
При запуске dbt читает dbt_project.yml, берёт оттуда имя профиля и ищет его в profiles.yml. Профилей может быть сколько угодно, но обычно делают один на проект или на платформу. Вот наш профиль для DuckDB:
# Подключение к локальной базе DuckDB (вместо BigQuery из книги)jaffle_book: target: dev outputs: dev: type: duckdb path: jaffle.duckdb threads: 4Что здесь есть:
- Имя профиля должно совпадать с полем
profileвdbt_project.yml. targetвыбирает среду. Например, при разработке каждый работает в своём датасете, а в рабочей среде все таблицы лежат в одном. По умолчаниюtargetравенdev.typeзадаёт платформу: BigQuery, Snowflake, Redshift, DuckDB.- Параметры подключения зависят от платформы. Для BigQuery в книге это
method: service-account,project,datasetиkeyfile(путь к JSON-ключу). threads— сколько моделейdbtстроит параллельно.dbtстроит граф зависимостей (DAG), и число потоков — это максимум путей по графу, которые идут одновременно. Приthreads: 1модели строятся строго по одной. Приthreads: 4— до четырёх сразу, но без нарушения зависимостей.
Модели — это место, где специалист по данным проводит больше всего времени в dbt. Обычно это SELECT в файле .sql. Чтобы строить их хорошо, нужно понимать моделирование данных. Как говорилось в главе 2, моделирование превращает сырые данные компании в данные, которые отвечают на вопросы отделов и приносят бизнесу пользу.
Второй важный принцип — модульность. Задачу делят на независимые модули, которые можно собирать в разных сочетаниях. Так проще управлять сложностью, и система становится гибче. data product тоже строят не одним куском, а по частям. В типичном проекте dbt три слоя:
staging: первые строительные блоки. Слой служит интерфейсом к исходным системам, так же как API служит интерфейсом к внешним данным. Здесь данные переименовывают, чистят, приводят к стандарту и делают мелкие преобразования.intermediate: модели междуstagingиmart. Здесь делают тяжёлые преобразования и сводят данные из разных систем.mart: модели, которые собирают модули в цельную картину важных для бизнеса сущностей. Приdimensional modelingздесь лежат таблицы фактов и измерений. Факты — это повторяющиеся события с числовыми показателями (заказы, клики, движение товара), а измерения их описывают (клиенты, товары, география). Витрины часто делят по отделам: финансы, маркетинг, логистика. Авторы советуют держать и общую витринуcoreс главными фактами и измерениями компании.
Начнём со staging. В models/staging/ создают папки jaffle_shop и stripe и по SQL-файлу на таблицу. Папку example удаляют, чтобы не мешала. Вот наша модель платежей:
-- staging: понятные имена и два простых признакаselect id as payment_id, orderid as order_id, paymentmethod as payment_method, case when paymentmethod in ('credit_card', 'paypal', 'gift_card') then 'credit' else 'cash' end as payment_type, status, amount, status = 'success' as is_completed_payment, created as created_datefrom {{ source('stripe', 'payment') }}Модели клиентов и заказов устроены проще: они только переименовывают колонки: id в customer_id у клиентов и в order_id у заказов, а user_id у заказов — тоже в customer_id. В книге сначала пишут прямые имена таблиц (dbt-tutorial.stripe.payment), а функцию source() вводят позже. Мы сразу показываем итоговый вариант.
Модели строят командой dbt run. Если что-то пошло не так, причину покажут логи, сводные или подробные. По умолчанию dbt создаёт модели как view. Это меняют блоком config() в начале файла модели:
{{ config(materialized='table') }}Но лучше держать такие настройки в YAML, как советуют авторы. В книге сначала через dbt_project.yml задают view для моделей папки jaffle_shop и таблицы для моделей папки stripe. Потом всем staging-моделям задают view, а для одной модели перекрывают это в _jaffle_shop_models.yml:
models: - name: stg_jaffle_shop_customers config: materialized: table # перекрывает view из dbt_project.ymlПосле dbt run модель клиентов в базе становится таблицей, а остальные staging-модели остаются view. Это и есть cascading scope priority на практике.
Слои intermediate и mart, функция ref()
Заголовок раздела «Слои intermediate и mart, функция ref()»Задача бизнеса такая: смотреть заказы по клиентам, с суммой успешных платежей по заказу и отдельно суммами наличными (cash) и картой (credit). Для этого нужно сменить grain с платежа на заказ. Такую сложную операцию лучше вынести в отдельную модель ещё до слоя mart, и для неё как раз нужен слой intermediate:
-- intermediate: меняем grain с платежа на заказwith order_payments as (    select * from {{ ref('stg_stripe_order_payments') }})
select    order_id,    sum(case when payment_type = 'cash' and status = 'success'             then amount else 0 end) as cash_amount,    sum(case when payment_type = 'credit' and status = 'success'             then amount else 0 end) as credit_amount,    sum(case when status = 'success' then amount end) as total_amountfrom order_paymentsgroup by order_id
Здесь впервые появляется Jinja: функция ref() ссылается на другую модель. У неё два плюса:
ref()строит зависимости между моделями. При запускеdbtподставляет полное имя объекта из настроек среды. Поэтому один и тот же код работает и в вашей среде разработки, и у коллеги, хотя схемы у вас разные.- По этим ссылкам
dbtстроит графlineage: откуда приходят данные модели и куда уходят.
Повтор условия на успешный статус в каждом CASE WHEN может показаться антипаттерном. Авторы объясняют: в данных есть все заказы с любым статусом платежа, но финансовый анализ в примере нужен только по успешным платежам, поэтому условие стоит в каждой сумме.
Затем строят слой mart. Нужна таблица измерений клиентов и таблица фактов заказов. Задача полезна многим отделам, поэтому папку называют marts/core. dim_customers просто берёт staging-модель клиентов. fct_orders соединяет заказы с суммами платежей:
with orders as (    select * from {{ ref('stg_jaffle_shop_orders') }}),
payment_type_orders as (    select * from {{ ref('int_payment_type_amount_per_order') }})
select    ord.order_id,    ord.customer_id,    ord.order_date,    pto.cash_amount,    pto.credit_amount,    pto.total_amount,    case when ord.status = 'completed' then 1 else 0 end as is_order_completedfrom orders as ordleft join payment_type_orders as pto    on ord.order_id = pto.order_id
Настройки по умолчанию для трёх слоёв задают в dbt_project.yml (блок выше), затем выполняют dbt run. Авторы предупреждают о частой ошибке «depends on a node named … which was not found». Она значит, что модель, от которой зависит текущая, ещё не создана в платформе. Недостающую модель строят отдельно: dbt run --select <имя_модели>. После сборки во вкладке Lineage для fct_orders виден поток данных и зависимости выше и ниже по потоку.
Sources
Заголовок раздела «Sources»source в dbt — это сырые данные в вашей платформе, которые туда загрузил EL-инструмент. Их нужно отличать от исходных систем в привычном смысле. Те бывают внутренними (транзакции, клиенты, продажи, товары) и внешними (данные партнёров, интернета, исследований рынка, конкурентов, демографии). source в dbt может включать и те и другие, но определение другое: это то, что дата-инженеры уже положили в платформу. На этих данных строится вся аналитика.
Прямые имена таблиц в моделях работают, но плохо переносят изменения. Если таблицу переименуют или перенесут, придётся править много файлов. source решает это: таблицы описывают один раз в YAML, указывая базу, схему и таблицы.
sources: - name: stripe schema: stripe tables: - name: paymentВ модели вместо имени таблицы пишут {{ source('stripe', 'payment') }}. Это работает как ref(), только ссылается на описание из YAML. Команда dbt compile (или кнопка Compile) показывает, что получится на самом деле. dbt заменяет source() на полное имя таблицы, и именно этот SQL уходит в платформу:
-- staging: только переименование колонокselect id as customer_id, first_name, last_namefrom "jaffle"."jaffle_shop"."customers"Это реальный результат dbt compile для stg_jaffle_shop_customers в нашем проекте на DuckDB. Ещё один плюс: теперь source-таблицы видны в графе lineage как начальные точки.
Source freshness
Заголовок раздела «Source freshness»Свежесть — важная часть качества данных. Устаревшие данные ведут к неверным выводам и плохим решениям. dbt проверяет свежесть тестом source freshness. Для него нужно служебное поле с временем загрузки строки. По нему dbt считает возраст данных и выдаёт предупреждение или ошибку.
- name: orders loaded_at_field: _etl_loaded_at freshness: warn_after: {count: 12, period: hour} error_after: {count: 24, period: hour}Поле _etl_loaded_at не нужно переносить в модели: тест проверяет сырые данные. loaded_at_field говорит, какое поле смотреть, а freshness задаёт правила. Если данным больше 12 часов, будет предупреждение, а если больше 24 — ошибка. Запуск:
dbt source freshness1 of 1 WARN freshness of jaffle_shop.orders .................................... [WARN in 0.01s]Предупреждение ожидаемо. В книге, как и в наших данных, последняя загрузка была 16 часов назад, а это больше порога в 12 часов. Если поднять warn_after до 17 часов, тест пройдёт. В логе виден запрос, который dbt выполнил, и по нему удобно разбираться. Позже в книге проверку свежести автоматизируют.
analytics engineer отвечает за точность и надёжность данных, иначе аналитике не доверяют. Но даже при лучших практиках исключения будут, ведь данные меняются по объёму, типам и структуре. На больших объёмах нужен масштабируемый способ быстро находить такие исключения. dbt позволяет легко добавлять тесты по всему потоку данных и узнавать о поломке раньше пользователей. В разработке тесты проверяют, что код даёт нужный результат. В рабочей среде их запускают автоматически и шлют оповещение при падении.
Тест в dbt — это утверждение о данных: модель даёт ожидаемый результат. Авторы уточняют его место. В тестировании ПО различают верификацию и валидацию. Тесты dbt в основном про верификацию: данные следуют принятым шаблонам и структуре. Они не проверяют тонкую логику преобразований, как это делают unit-тесты в разработке ПО. Отчасти они проверяют и совместную работу компонентов, когда несколько моделей запускают вместе. Но всех случаев такие тесты не покрывают, поэтому для полного тестирования могут понадобиться другие инструменты.
В dbt два вида тестов: generic test и singular test.
Generic tests
Заголовок раздела «Generic tests»generic test — это самые простые и хорошо масштабируемые тесты. Обычно не нужно писать новую логику: хватает пары строк YAML для модели или колонки. Можно писать и свои generic test. Встроенных четыре:
| Тест | Что проверяет |
|---|---|
unique | Все значения колонки уникальны |
not_null | В колонке нет NULL |
accepted_values | Все значения колонки входят в указанный список |
relationships | Все значения колонки есть в колонке другой модели (ссылочная целостность) |
Все четыре удобно попробовать на модели заказов. unique и not_null ставят на order_id, accepted_values проверяет статусы, а relationships проверяет, что каждый customer_id есть в модели клиентов:
- name: stg_jaffle_shop_orders columns: - name: order_id data_tests: [unique, not_null] - name: status data_tests: - accepted_values: values: [completed, shipped, returned, placed, return_pending] - name: customer_id data_tests: - relationships: to: ref('stg_jaffle_shop_customers') field: customer_idПояснение: в книге ключ называется
tests:. Сdbt1.8 его переименовали вdata_tests:, старое имя пока работает. В 1.8 появились и настоящие unit-тесты (unit_tests:), так что ограничение, о котором пишут авторы, частично снято.
Авторы специально начинают со списка из четырёх статусов, без return_pending. Команда dbt test тогда падает:
1 of 14 FAIL 1 accepted_values_stg_jaffle_shop_orders_status__completed__shipped__returned__placed [FAIL 1 in 0.04s]Done. PASS=13 WARN=0 ERROR=1 SKIP=0 NO-OP=0 TOTAL=14Как найти причину? В логах раскрывают упавший тест и открывают Details. Там лежит запрос, которым dbt проверял данные. Его внутреннюю часть копируют в редактор и выполняют. Запрос показывает лишний статус return_pending. Его добавляют в список, и после этого все тесты проходят:
Done. PASS=14 WARN=0 ERROR=0 SKIP=0 NO-OP=0 TOTAL=14Кроме встроенных тестов, много других есть в пакетах. Авторы называют обязательными dbt_utils от dbt Labs и dbt_expectations, сделанный по мотивам Python-библиотеки Great Expectations.
Singular tests
Заголовок раздела «Singular tests»singular test — это файл .sql в папке tests/. Он нужен, когда встроенные тесты не подходят. Правило простое: запрос ищет плохие строки, и тест падает, если вернулась хотя бы одна. Проверим, что ни у одного заказа нет отрицательной суммы. Тест ставят на intermediate-слой, потому что там были преобразования, которые могли исказить данные:
-- singular test: падает, если запрос вернул хотя бы одну строкуselect order_id, total_amountfrom {{ ref('int_payment_type_amount_per_order') }}where total_amount < 0Тесты можно запускать выборочно:
dbt test # все тестыdbt test --select test_type:singular # только singulardbt test --select int_payment_type_amount_per_order # тесты одной моделиdbt test --select assert_total_payment_amount_is_positive # один тестПодробнее о выборе — в разделе о selection syntax ниже.
Тесты для sources
Заголовок раздела «Тесты для sources»Тесты можно ставить не только на модели, но и на source. Свежесть вы уже проверили, а теперь добавим generic test и singular test. Так появляется уверенность, что сырые данные соответствуют ожиданиям. Правила те же: generic test описывают в YAML-файле source, singular test пишут в .sql.
В YAML source на id клиентов и заказов ставят unique и not_null, на статус — accepted_values, и запускают dbt test --select source:jaffle_shop. singular test повторяет проверку суммы, но по сырой таблице платежей: группирует amount по заказу и ищет отрицательные суммы через having. Его запускают командой dbt test --select source:stripe. Все тесты проходят.
Analyses
Заголовок раздела «Analyses»В папке analyses/ хранят разовые запросы, запросы для аудита, обучения или рефакторинга. Например, в них смотрят, во что скомпилируется код, прежде чем менять модели. analysis — это SQL-шаблон: dbt run его не выполняет, но dbt compile компилирует Jinja. Код при этом остаётся под контролем версий.
Пример: вы не хотите строить новую модель, но хотите сохранить запрос на будущее. Авторы ищут 10 самых ценных клиентов по сумме оплат в завершённых заказах. У нас клиентов всего восемь, поэтому мы берём трёх:
-- analysis: dbt его компилирует, но не создаёт объект в базеwith fct_orders as (    select * from {{ ref('fct_orders') }}),
dim_customers as (    select * from {{ ref('dim_customers') }})
select cust.customer_id, cust.first_name, sum(ord.total_amount) as global_paid_amountfrom fct_orders as ordleft join dim_customers as cust on ord.customer_id = cust.customer_idwhere ord.is_order_completed = 1group by cust.customer_id, cust.first_nameorder by global_paid_amount desclimit 3┌─────────────┬────────────┬────────────────────┐│ customer_id │ first_name │ global_paid_amount ││ int32 │ varchar │ int128 │├─────────────┼────────────┼────────────────────┤│ 2 │ Борис │ 67 ││ 4 │ Глеб │ 49 ││ 8 │ Зоя │ 43 │└─────────────┴────────────┴────────────────────┘seed — это небольшой CSV-файл с редко меняющимися данными. Команда dbt seed загружает его в платформу как таблицу, а в моделях к нему обращаются через ref(), как к любой модели. Применений много: коды стран (PT — Португалия, US — США), почтовые индексы и регионы, тестовые адреса для исключения, диапазоны цен. Авторы предупреждают: большие или часто меняющиеся данные в seed не кладут. Для них нужен другой способ загрузки, например через SFTP или API.
Пример продолжает задачу из analyses: теперь всех клиентов с завершёнными заказами делят на классы Regular, Bronze, Silver и Gold по сумме оплат. Сначала создают seed:
min_range,max_range,classification0,10,Regular10,30,Bronze30,50,Silver50,1000000,GoldПосле dbt seed в analyses/ пишут запрос. Он считает сумму на клиента и соединяет её с диапазонами из seed:
left join ranges as r on t.global_paid_amount >= r.min_range and t.global_paid_amount < r.max_range┌─────────────┬────────────────────┬────────────────┐│ customer_id │ global_paid_amount │ classification ││ int32 │ int128 │ varchar │├─────────────┼────────────────────┼────────────────┤│ 2 │ 67 │ Gold ││ 3 │ NULL │ NULL ││ 4 │ 49 │ Silver ││ 7 │ 18 │ Bronze ││ 8 │ 43 │ Silver │└─────────────┴────────────────────┴────────────────┘В книге границы записаны как 0–9.999, 10–29.999 и так далее, а сравнение идёт через >= и <=. Сумма вроде 9,9995 тогда не попадёт ни в один класс. Мы взяли полуоткрытые интервалы: нижняя граница включается, верхняя нет. Клиент 3 без класса — это не ошибка соединения: его единственный завершённый заказ не оплачен (подробнее в практике).
Документация
Заголовок раздела «Документация»Документацию все считают важной, но часто не пишут: «не сейчас», «нет времени». Она кажется бюрократией или лишней нагрузкой. Авторы приводят доводы за неё:
- Она упрощает онбординг, передачу дел и найм. Новичка не бросают одного: процессы, стандарты и технические решения записаны.
- Она даёт единую версию правды: определения, процессы, инструкции. Пользователи сами находят ответы.
- Она убирает двойную работу: сделанное можно переиспользовать.
- Она делает знания общими, и работа не встаёт, когда ключевого человека нет.
- Она нужна для контроля качества, процессов и требований регуляторов.
Одна из причин, почему документацию не любят, в том, что её ведут отдельно от разработки, в другом инструменте. В dbt иначе: документацию пишут в том же проекте, что и код. Часть её dbt создаёт сам, например граф lineage по ref() и source(). Другая часть ручная: описания моделей и колонок в YAML или Markdown.
Опишем fct_orders и dim_customers. В папке marts/core создают _core_models.yml со свойством description:
- name: fct_orders description: Заказы для анализа, один заказ на строку. columns: - name: order_id description: Первичный ключ заказа. data_tests: [unique, not_null] - name: customer_id description: Внешний ключ на dim_customers. - name: total_amount description: Сумма успешных платежей по заказу. - name: is_order_completed description: "{{ doc('is_order_completed_docblock') }}"Для подробного описания подходит doc block — именованный фрагмент Markdown. Его пишут в файле .md рядом с моделями, а в YAML на него ссылаются через doc():
{% docs is_order_completed_docblock %}Флаг завершённого заказа. Считается по статусу заказа.
| is_order_completed | значение                     ||--------------------|------------------------------|| 0                  | заказ ещё не завершён        || 1                  | заказ завершён (`completed`) |{% enddocs %}
Документацию собирают командой dbt docs generate. В dbt Cloud её открывает значок книги рядом с именем branch. Что есть на сайте документации:
- Обзор с деревом проекта: модели, тесты,
seedи другое. Эту страницу можно настроить под себя. - Страница модели. В блоке Details видны метаданные: тип (
materialization), язык, число строк, размер. Ниже идут описание модели и колонки. Типы колонок заполняются сами, описания берутся из YAML, аdoc blockраскрывается по клику на колонку. - Зависимости. Раздел Referenced By показывает, кто использует модель (ниже по потоку), а Depends On — от кого она зависит (выше по потоку).
- Код модели в исходном виде с Jinja и в скомпилированном.
- Граф
lineageпо синей кнопке. Он показывает весь путь данных отsourceиintermediate-моделей доanalysis.
Ещё одна полезная настройка — persist_docs. Она записывает описания таблиц и колонок прямо в базу. Тогда их видят и те, у кого нет доступа к dbt Cloud.
Команды dbt и selection syntax
Заголовок раздела «Команды dbt и selection syntax»dbt — это прежде всего инструмент командной строки. Его команды запускают трансформации, тесты, сборку документации и управляют проектом.
Основные команды
Заголовок раздела «Основные команды»dbt runвыполняет модели. По зависимостям и настройкам проекта он сам определяет, что запускать и в каком порядке.dbt testзапускает тесты и проверяет, что данные отвечают правилам бизнеса.dbt docs generateсобирает документацию: описания моделей и колонок, связи между моделями.dbt buildв одной команде строитseed, модели иsnapshotи запускает тесты в порядке графа. Если тест модели падает, зависящие от неё модели пропускаются.
Другие полезные команды:
| Команда | Что делает |
|---|---|
dbt seed | Загружает CSV из seeds/ в платформу |
dbt snapshot | Сохраняет историю изменений по snapshot-моделям |
dbt deps | Ставит пакеты из packages.yml |
dbt clean | Удаляет папки из clean-targets, например target/ |
dbt compile | Компилирует Jinja в SQL, ничего не запуская в базе |
dbt run-operation | Запускает macro как отдельную операцию |
dbt source freshness | Проверяет свежесть source |
dbt ls | Выводит список ресурсов проекта |
dbt retry | Повторяет последнюю команду с места сбоя |
dbt debug | Проверяет установку и подключение к платформе |
dbt parse | Разбирает проект без запуска, полезно для проверки синтаксиса |
dbt clone | Клонирует выбранные модели из указанного состояния (state) |
dbt init | Создаёт новый проект |
Selection syntax
Заголовок раздела «Selection syntax»Проект растёт, и запускать всё каждый раз уже неудобно. selection syntax позволяет точно указать, какие ресурсы включить или исключить. Основные приёмы:
| Приём | Пример | Что выберет |
|---|---|---|
Путь и * | dbt run --select "models/marts/core/*" | Все ресурсы в папке core |
| Тег | dbt run --select tag:marketing | Ресурсы с тегом marketing (теги ставят в YAML) |
| Имя модели | dbt run --select fct_orders | Одну модель |
| Зависимости выше | dbt run --select +fct_orders | fct_orders и всё, от чего она зависит |
| Зависимости ниже | dbt run --select fct_orders+ | fct_orders и всё, что зависит от неё |
| Обе стороны | dbt run --select +fct_orders+ | Всю цепочку вокруг модели |
| Пакет | dbt run --select my_package.some_model | Ресурсы внутри пакета |
Элементы можно сочетать, и здесь важна разница. Пробел между элементами означает объединение: --select tag:marketing fct_orders выберет и всё с тегом marketing, и fct_orders. Запятая означает пересечение: --select tag:marketing,fct_orders выберет fct_orders, только если у неё есть этот тег. Есть и другие флаги: --exclude, --selector, --defer. Они дают ещё более тонкий контроль.
Jobs и развёртывание
Заголовок раздела «Jobs и развёртывание»До сих пор вся работа шла в среде разработки, а команды запускались вручную. Среда разработки важна: она позволяет менять проект, не трогая рабочую среду. Но теперь код нужно вывести в продакшен и автоматизировать. Для этого его переносят в основную branch (обычно main) и в отдельную рабочую схему, например dbt_analytics_engineering.core в BigQuery. Затем настраивают job с расписанием. Это важная часть CI/CD: команды выполняются с той частотой, которая нужна бизнесу.
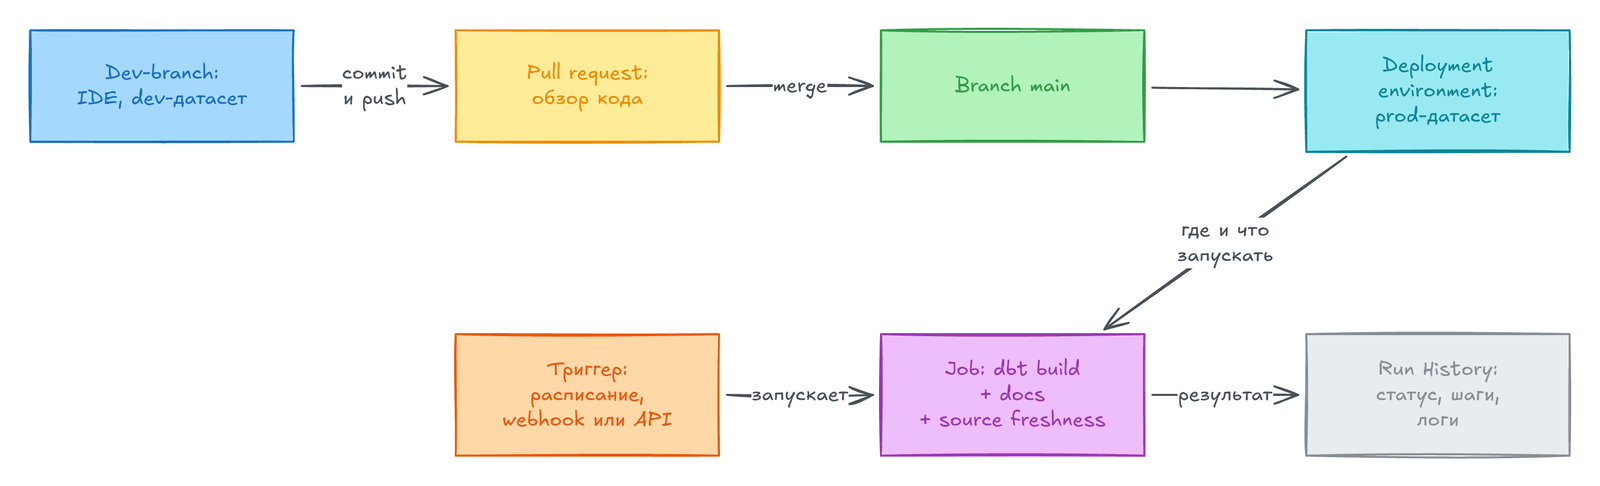
Верхний ряд схемы — путь кода, нижний — запуск job. Сначала все изменения сохраняют кнопкой «Commit and sync» с понятным сообщением. Затем создают pull request. Авторы подчёркивают: pull request — это не просто уведомление коллег, а важный шаг обзора и интеграции. Команда смотрит код, даёт отзыв и вместе решает, отвечает ли изменение целям и стандартам проекта. После этого branch вливают в main.
Потом настраивают среду развёртывания (меню Deploy, пункт Environments, кнопка Create Environment):
- Оставить последнюю версию
dbtи не включать запуск из своейbranch, потому что код уже вmain. - Назвать среду Deployment.
- Указать датасет рабочей среды, в книге это
dbt_analytics_engineer_prod.
Затем создают job (меню Deploy, пункт Jobs, кнопка Create New Job):
- Задать имя.
- Выбрать среду Deployment и наследовать её версию
dbt. Target Name оставить по умолчанию. Это имя полезно, если логика должна различать среды: в рабочей среде делать одно, в разработке другое.threadsтоже оставить по умолчанию. - В Execution Settings поставить Run Timeout 0 (
dbtне прервёт долгий запуск) и не ссылаться на другие запуски (defer). Включить «Generate docs on run» и «Run source freshness», тогда в командах достаточно однойdbt build. - Выбрать триггер. Их три: расписание в
dbt, webhook или вызов API. В книге выбрано расписание раз в час.
job сохраняют и запускают кнопкой Run Now или ждут расписания. В Run History открывают Run Overview. Там видно статус, кто или что запустил job, commit, документацию, source и среду, а ещё время начала, конца и длительность. Самое полезное — Run Steps: список всех выполненных команд с логом каждого шага. По ним разбирают проблемы.
Авторы подводят итог: job позволяют автоматизировать трансформации и выводить проекты в продакшен, и такой подход выдерживает рост проекта. Аналитику, дата-инженеру и analytics engineer dbt помогает держать модели точными и свежими.
Итоги главы
Заголовок раздела «Итоги главы»dbtотвечает за шаг T вELT: модели — этоSELECT-запросы, а таблицы иviewсоздаёт сама платформа данных.- dbt Cloud — это управляемый сервис с IDE,
jobи документацией, а dbt Core — бесплатный CLI, который нужно обслуживать самим. - Проект держится на соглашениях: стандартные папки, слои
staging,intermediate,martи один YAML-файл на папку. - Настройки задают по умолчанию в
dbt_project.ymlи перекрывают ближе к модели, поcascading scope priority. ref()иsource()связывают модели, делают код переносимым между средами и строят графlineage.source freshnessпредупреждает, если сырые данные устарели больше допустимого порога.generic testпишут в YAML, аsingular test— в SQL. Оба проверяют данные, а не логику кода.analysisхранит запросы под контролем версий без объектов в базе, аseedзагружает небольшие справочники из CSV.- Документация пишется в YAML и Markdown рядом с кодом, и
dbtдополняет её типами колонок иlineage. selection syntaxвыбирает часть проекта, аjobв среде развёртывания запускает его по расписанию.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| dbt Cloud / dbt Core | Облачный сервис dbt Labs / бесплатный CLI с открытым кодом |
model | SELECT-запрос в файле .sql, который dbt создаёт как таблицу или view |
materialization | Способ хранения модели: view, table, incremental, ephemeral |
staging / intermediate / mart | Слои проекта: подготовка, промежуточная логика, итог для бизнеса |
ref() | Ссылка на другую модель; строит зависимости и lineage |
source | Описанная в YAML сырая таблица; в коде — source() |
source freshness | Проверка возраста сырых данных по полю времени загрузки |
generic test | Готовый тест из YAML: unique, not_null, accepted_values, relationships |
singular test | SQL-файл в tests/, который должен вернуть 0 строк |
analysis | SQL-шаблон в analyses/, который компилируют, но не запускают в dbt run |
seed | Небольшой CSV, который dbt seed загружает как таблицу |
doc block | Именованный фрагмент Markdown для описаний в документации |
cascading scope priority | Правило: более конкретная настройка перекрывает общую |
selection syntax | Язык выбора ресурсов для команд: имена, теги, пути, + |
job | Запланированный запуск команд dbt в среде развёртывания |
threads | Сколько моделей dbt строит параллельно |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Начните проект со слоёв
staging,intermediate,martи правил именованияstg_,int_,fct_,dim_. Запишите эти правила в README. - Ни одного прямого имени таблицы в моделях: только
source()иref(). Тогда переезд схемы — это правка одного YAML. - Повесьте
uniqueиnot_nullна ключ каждой модели, аsource freshness— на каждую сырую таблицу с полем загрузки. - Падение
accepted_valuesчасто означает не ошибку, а новый статус в исходной системе. Найдите его запросом из лога и решите, добавлять ли его в список. - Перед
pull requestзапускайтеdbt build --select <модель>+, чтобы проверить и модель, и всё, что от неё зависит. - Держите справочники в
seed, только если они маленькие и меняются редко. Остальное загружайте через EL-инструмент.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. Здесь те же данные, что в нашем проекте dbt, а модели записаны как обычные view и таблицы. Так выглядит SQL после компиляции.
Шаг 1. Создаём данные и модели
Заголовок раздела «Шаг 1. Создаём данные и модели»-- Сырые данные: три таблицы в двух схемах, как jaffle_shop и stripe в книгеCREATE SCHEMA IF NOT EXISTS jaffle_shop;CREATE SCHEMA IF NOT EXISTS stripe;
CREATE OR REPLACE TABLE jaffle_shop.customers ASSELECT * FROM (VALUES (1, 'Анна', 'Ветрова'), (2, 'Борис', 'Кузнецов'), (3, 'Вера', 'Орлова'), (4, 'Глеб', 'Соколов'), (5, 'Дина', 'Морозова'), (6, 'Егор', 'Лебедев'), (7, 'Жанна', 'Новикова'), (8, 'Зоя', 'Павлова')) AS t(id, first_name, last_name);
-- 20 заказов; _etl_loaded_at: загрузка была 16 часов назадCREATE OR REPLACE TABLE jaffle_shop.orders ASSELECT i AS id, 1 + (i * 3) % 8 AS user_id, DATE '2024-01-01' + i * 3 AS order_date, CASE WHEN i % 7 = 0 THEN 'return_pending' WHEN i % 5 = 0 THEN 'returned' WHEN i % 9 = 0 THEN 'placed' WHEN i % 4 = 0 THEN 'shipped' ELSE 'completed' END AS status, now() - INTERVAL 16 HOUR AS _etl_loaded_atFROM (SELECT CAST(range AS INTEGER) AS i FROM range(1, 21));
-- 1-2 платежа на заказ; часть платежей неуспешна (fail)CREATE OR REPLACE TABLE stripe.payment ASSELECT row_number() OVER (ORDER BY o.id, p.n) AS id, o.id AS orderid, CASE (o.id + p.n) % 5 WHEN 0 THEN 'credit_card' WHEN 1 THEN 'paypal' WHEN 2 THEN 'gift_card' WHEN 3 THEN 'bank_transfer' ELSE 'coupon' END AS paymentmethod, CASE WHEN (o.id * p.n) % 6 = 0 THEN 'fail' ELSE 'success' END AS status, (o.id * 7 + p.n * 3) % 25 + 1 AS amount, o.order_date AS createdFROM jaffle_shop.orders AS oCROSS JOIN LATERAL (SELECT unnest(range(1, 2 + o.id % 2)) AS n) AS p;-- Модели проекта как обычные view: так выглядит SQL после компиляции dbtCREATE VIEW stg_jaffle_shop_customers ASSELECT id AS customer_id, first_name, last_name FROM jaffle_shop.customers;
CREATE VIEW stg_jaffle_shop_orders ASSELECT id AS order_id, user_id AS customer_id, order_date, status, _etl_loaded_atFROM jaffle_shop.orders;
CREATE VIEW stg_stripe_order_payments ASSELECT id AS payment_id, orderid AS order_id, paymentmethod AS payment_method, CASE WHEN paymentmethod IN ('credit_card', 'paypal', 'gift_card') THEN 'credit' ELSE 'cash' END AS payment_type, status, amount, status = 'success' AS is_completed_payment, created AS created_dateFROM stripe.payment;
CREATE VIEW int_payment_type_amount_per_order ASSELECT order_id, sum(CASE WHEN payment_type = 'cash' AND status = 'success' THEN amount ELSE 0 END) AS cash_amount, sum(CASE WHEN payment_type = 'credit' AND status = 'success' THEN amount ELSE 0 END) AS credit_amount, sum(CASE WHEN status = 'success' THEN amount END) AS total_amountFROM stg_stripe_order_paymentsGROUP BY order_id;
CREATE TABLE fct_orders ASSELECT o.order_id, o.customer_id, o.order_date, p.cash_amount, p.credit_amount, p.total_amount, CASE WHEN o.status = 'completed' THEN 1 ELSE 0 END AS is_order_completedFROM stg_jaffle_shop_orders AS oLEFT JOIN int_payment_type_amount_per_order AS p ON o.order_id = p.order_id;
CREATE TABLE dim_customers ASSELECT customer_id, first_name, last_name FROM stg_jaffle_shop_customers;Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»Первый запрос — это тест unique для fct_orders, он должен вернуть 0 строк. Второй сверяет размеры: в fct_orders одна строка на заказ, пустых ключей нет, а платежей больше, чем строк: платежи одного заказа сведены в одну строку.
SELECT order_id, count(*) AS n FROM fct_orders GROUP BY order_id HAVING count(*) > 1;SELECT count(*) AS fct_rows, count(DISTINCT order_id) AS distinct_ids, count(*) FILTER (WHERE order_id IS NULL) AS null_ids, (SELECT count(*) FROM stripe.payment) AS paymentsFROM fct_orders;┌──────────┬───────┐│ order_id │ n ││ int32 │ int64 │├──────────┴───────┤│ 0 rows │└──────────────────┘┌──────────┬──────────────┬──────────┬──────────┐│ fct_rows │ distinct_ids │ null_ids │ payments ││ int64 │ int64 │ int64 │ int64 │├──────────┼──────────────┼──────────┼──────────┤│ 20 │ 20 │ 0 │ 30 │└──────────┴──────────────┴──────────┴──────────┘Задания
Заголовок раздела «Задания»1. Тест accepted_values вручную. Напишите запрос, который делает то же, что тест со списком completed, shipped, returned, placed: показывает статусы вне списка и число заказов с ними.
Решение
SELECT status, count(*) AS ordersFROM stg_jaffle_shop_ordersWHERE status NOT IN ('completed', 'shipped', 'returned', 'placed')GROUP BY status;┌────────────────┬────────┐│ status │ orders ││ varchar │ int64 │├────────────────┼────────┤│ return_pending │ 2 │└────────────────┴────────┘Тест падает из-за двух заказов со статусом return_pending, как и в книге. generic test в dbt компилируется в похожий запрос и падает, если тот вернул строки.
2. source freshness вручную. Посчитайте, сколько часов прошло с последней загрузки jaffle_shop.orders, и выведите pass, warn или error по порогам 12 и 24 часа.
Решение
SELECT date_diff('hour', max(_etl_loaded_at), now()) AS hours_old, CASE WHEN date_diff('hour', max(_etl_loaded_at), now()) >= 24 THEN 'error' WHEN date_diff('hour', max(_etl_loaded_at), now()) >= 12 THEN 'warn' ELSE 'pass' END AS freshnessFROM jaffle_shop.orders;┌───────────┬───────────┐│ hours_old │ freshness ││ int64 │ varchar │├───────────┼───────────┤│ 16 │ warn │└───────────┴───────────┘16 часов больше 12, но меньше 24, поэтому получается warn. Тот же результат дал dbt source freshness выше.
3. Классы клиентов по seed. Создайте таблицу диапазонов, как seed, и найдите класс каждого клиента с завершёнными заказами. Почему у одного клиента класс пустой?
Решение
CREATE TABLE seed_customer_range_per_paid_amount ASSELECT * FROM (VALUES (0, 10, 'Regular'), (10, 30, 'Bronze'),                      (30, 50, 'Silver'), (50, 1000000, 'Gold'))             AS t(min_range, max_range, classification);
WITH total_per_customer AS ( SELECT customer_id, sum(total_amount) AS global_paid_amount FROM fct_orders WHERE is_order_completed = 1 GROUP BY customer_id)SELECT t.customer_id, c.first_name, t.global_paid_amount, r.classificationFROM total_per_customer AS tJOIN dim_customers AS c USING (customer_id)LEFT JOIN seed_customer_range_per_paid_amount AS r ON t.global_paid_amount >= r.min_range AND t.global_paid_amount < r.max_rangeORDER BY t.customer_id;┌─────────────┬────────────┬────────────────────┬────────────────┐│ customer_id │ first_name │ global_paid_amount │ classification ││ int32 │ varchar │ int128 │ varchar │├─────────────┼────────────┼────────────────────┼────────────────┤│ 2 │ Борис │ 67 │ Gold ││ 3 │ Вера │ NULL │ NULL ││ 4 │ Глеб │ 49 │ Silver ││ 7 │ Жанна │ 18 │ Bronze ││ 8 │ Зоя │ 43 │ Silver │└─────────────┴────────────┴────────────────────┴────────────────┘Посмотрим платежи завершённого заказа клиента 3:
SELECT order_id, payment_method, status, amountFROM stg_stripe_order_paymentsWHERE order_id IN (SELECT order_id FROM fct_orders WHERE customer_id = 3 AND is_order_completed = 1);┌──────────┬────────────────┬─────────┬────────┐│ order_id │ payment_method │ status │ amount ││ int32 │ varchar │ varchar │ int64 │├──────────┼────────────────┼─────────┼────────┤│ 6 │ gift_card │ fail │ 21 │└──────────┴────────────────┴─────────┴────────┘Единственный платёж упал (fail). Поэтому total_amount в intermediate-модели равен NULL: в сумме нет ELSE 0, а успешных платежей у заказа нет, поэтому складывать нечего. NULL не попадает ни в один диапазон. Это хороший повод для singular test, который ищет завершённые заказы без оплаты.
Весь проект dbt из главы можно собрать одной командой: bash scripts/analytics-engineering-code/ch04_run.sh. Скрипт создаёт сырые данные, запускает dbt seed, dbt run, dbt test, dbt source freshness и оба analysis. Описание и версии лежат в scripts/analytics-engineering-code.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему авторы говорят, что
dbtотделяет трансформацию от загрузки? Что делает EL-инструмент, а чтоdbt? - Когда стоит выбрать dbt Cloud, а когда dbt Core?
- Зачем нужен слой
intermediate, если ту же логику можно написать прямо вfct_orders? - Почему
ref()иsource()лучше прямых имён таблиц? Назовите два довода. - Модель в
dbt_project.ymlнастроена какview, а в YAML своей папки — какtable. Чем она станет и почему? - Почему тесты
dbtне заменяют unit-тесты, и что изменилось сdbt1.8?
Предыдущая: SQL для аналитики. Следующая: dbt: продвинутые темы.