

Claude AI Bible, глава 3: Claude против конкурентов
Главная мысль: в 2026 году все передовые модели хороши, а лидер меняется от задачи к задаче и от квартала к кварталу. Поэтому важно не выбрать «лучшую» модель навсегда, а знать характер каждой и уметь быстро проверить их на своей работе.
О чём глава
Заголовок раздела «О чём глава»Вторая глава сравнивала модели внутри семейства Claude, а эта сравнивает Claude с конкурентами. Автор сразу предупреждает: книга о Claude, но он не будет говорить, что Claude всегда побеждает. Читателю нужна честная карта рынка, а не агитация. Темы: вред верности одной модели, признаки сравнения, шесть конкурентов, экосистема, benchmark, проверка за 15 минут, работа с несколькими моделями и цена перехода.
Почему верность одной модели вредна
Заголовок раздела «Почему верность одной модели вредна»Многие выбирают AI-ассистента как любимую кофейню: однажды понравилось, и дальше все задачи идут туда по привычке. Такая привычка скрывает две вещи. Вы не видите задач, где другая модель справилась бы лучше, и пропускаете прогресс: и ваша модель, и её конкуренты за год стали другими.
Прыгать между сервисами автор тоже не советует. Его позиция: одна основная модель, которую вы знаете глубоко, и открытый взгляд на остальные. Отдельную задачу можно отдать другой модели, а выбор стоит пересматривать, когда рынок меняется.
Как сравнивать модели и не обманывать себя
Заголовок раздела «Как сравнивать модели и не обманывать себя»Обычно модели сравнивают по первому впечатлению, и твёрдое мнение вырастает из трёх случайных prompt. Полезное сравнение идёт по шести признакам.
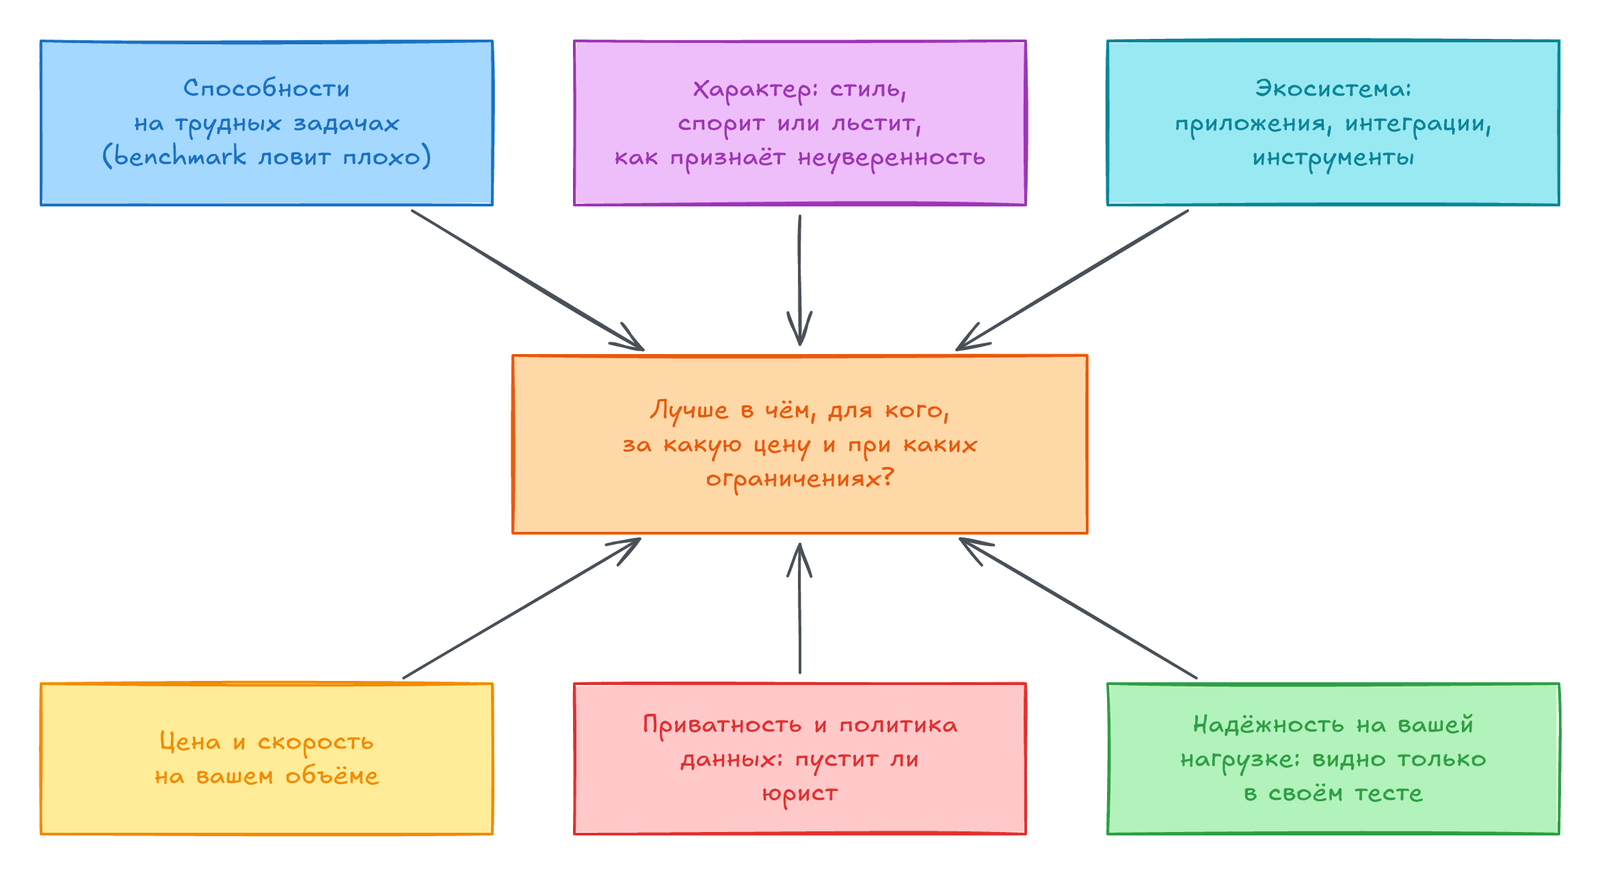
Каждый признак на схеме уточняет вопрос, какая модель лучше. Способности пытаются измерить benchmark, но получается плохо. Характер модели (спорит ли она или льстит, как признаёт неуверенность) важен каждый день, но его нет ни в одном рейтинге. Экосистема вокруг модели часто важнее самой модели, о ней — отдельный раздел ниже. Цена и скорость решают, годится ли модель для большого объёма, а политика данных — пустит ли её юрист. Надёжность на вашей нагрузке покажет только свой тест.
Ни одна модель не побеждает по всем осям сразу: она может лидировать в текстах и отставать в математике или стоить дешевле, но работать медленнее. Поэтому вопрос «какая лучше?» автор считает неверным. Правильный вопрос: лучше в чём, для кого, за какую цену и при каких ограничениях.
Claude и GPT от OpenAI
Заголовок раздела «Claude и GPT от OpenAI»GPT — самый известный AI и главный соперник Claude. Его сила — охват: огромная аудитория и экосистема разработчиков, быстрые релизы, сильные общие способности. Многие инструменты изначально построены вокруг GPT.
По опыту автора, Claude чаще сильнее в большом коде и долгих agentic-задачах, где важна последовательность многих шагов. Его тексты сдержаннее, и он охотнее спорит и признаёт неуверенность, чем льстит. Модели идут почти вровень, а выбор зависит от задачи и от экосистемы, в которой вы уже работаете.
Claude и Google Gemini
Заголовок раздела «Claude и Google Gemini»Главное преимущество Gemini — сам Google. Модель встроена в поиск, Android, почту и документы миллиардов людей, а исторически делает ставку на очень большой контекст и мультимодальность. Claude сильнее в долгих рассуждениях и коде, и его стиль многим нравится больше. Но для компании, которая живёт в Google Workspace, встроенность Gemini — разумная причина выбрать его.
Claude и Meta Llama
Заголовок раздела «Claude и Meta Llama»Llama — открытая модель (open-weight): веса можно скачать и запустить на своём железе. Это нужно, если данные не должны покидать вашу инфраструктуру, если модель нужно глубоко дообучить или если при огромном объёме дорого платить за каждый токен. Claude сильнее на самых трудных задачах и не требует своей инфраструктуры. Выбор идёт между контролем и удобством. Многие зрелые команды держат открытую модель для массовой работы, а Claude — для трудных задач, и автор называет это хорошей инженерией.
Claude и Mistral
Заголовок раздела «Claude и Mistral»Французская Mistral известна эффективными моделями, открытыми и коммерческими. В Европе у неё особый вес: многим организациям важен суверенитет данных и европейский партнёр. Claude сильнее на трудных задачах, и набор инструментов вокруг него шире, но европейским компаниям автор советует не списывать Mistral из-за американских обзоров.
Claude и DeepSeek
Заголовок раздела «Claude и DeepSeek»Китайская DeepSeek показала, что сильные модели можно делать намного дешевле, и её открытые модели давят на цены всей отрасли. Но здесь важна юрисдикция поставщика: от неё зависят регулирование, правила работы с данными, иногда геополитика, а значит, можно ли вам вообще использовать модель. Для западной компании с чувствительными данными это серьёзный фактор, а для любителя с локальной открытой версией — нет. Автор советует оценить этот вопрос честно, без паники и без игнорирования.
Claude и xAI Grok
Заголовок раздела «Claude и xAI Grok»Grok — самый новый крупный игрок. Он быстро вырос и связан с крупной социальной сетью, поэтому видит текущие обсуждения в реальном времени. Его стиль намеренно менее строгий, а у Claude характер предсказуемее и инструменты зрелее.
Экосистема часто важнее модели
Заголовок раздела «Экосистема часто важнее модели»Две передовые модели могут отличаться по «интеллекту» чуть-чуть, а инструменты вокруг них — очень сильно. Выбирая модель, вы выбираете приложения, интеграции с документами, таблицами и браузером, фреймворки для агентов и сообщество. Поэтому модель с небольшим перевесом, но слабой экосистемой легко проигрывает чуть более слабой модели с удобными инструментами. Модель — это двигатель, а ездите вы на машине, пишет автор.
Anthropic много вложила в экосистему: Claude Code, агенты для браузера и таблиц, MCP для подключения внешних данных, платформа для разработчиков. Правильный вопрос — какая система целиком (модель, инструменты, интеграции) подходит вашей работе. Ответ на него останется верным, когда рейтинги поменяются.
Проблема с benchmark
Заголовок раздела «Проблема с benchmark»Benchmark — это стандартный набор задач для сравнения моделей. Если модель провалила многие тесты, она, скорее всего, слабая. Но им доверяют слишком сильно, и причин не доверять четыре:
- под фиксированный тест модель можно «натаскать», как школа натаскивает учеников только на экзамен;
- разрыв между лидерами обычно крошечный и для вашего выбора ничего не значит;
- тест далёк от вашей работы: олимпиадная математика ничего не говорит о письмах клиентам;
- рейтинг прошлого квартала уже может быть неверен.
Поэтому benchmark годится как грубый фильтр «кто среди передовых», а мелкие различия стоит игнорировать. Графики самих поставщиков автор прямо называет рекламой: компания сама выбирает тесты и версии конкурентов.
Пример из книги: агентство в Сан-Паулу перевело команду на лидера популярного рейтинга, не проверив его на своих текстах для бразильских клиентов. Через полгода младшая копирайтерша прогнала те же задания через другую модель и получила заметно лучшие тексты на португальском, и честное сравнение это подтвердило. Проверка заняла один день, и сделать её стоило в начале.
Проверка за 15 минут
Заголовок раздела «Проверка за 15 минут»Для выбора модели не нужна научная методика: хватит пятнадцати минут и дисциплины.
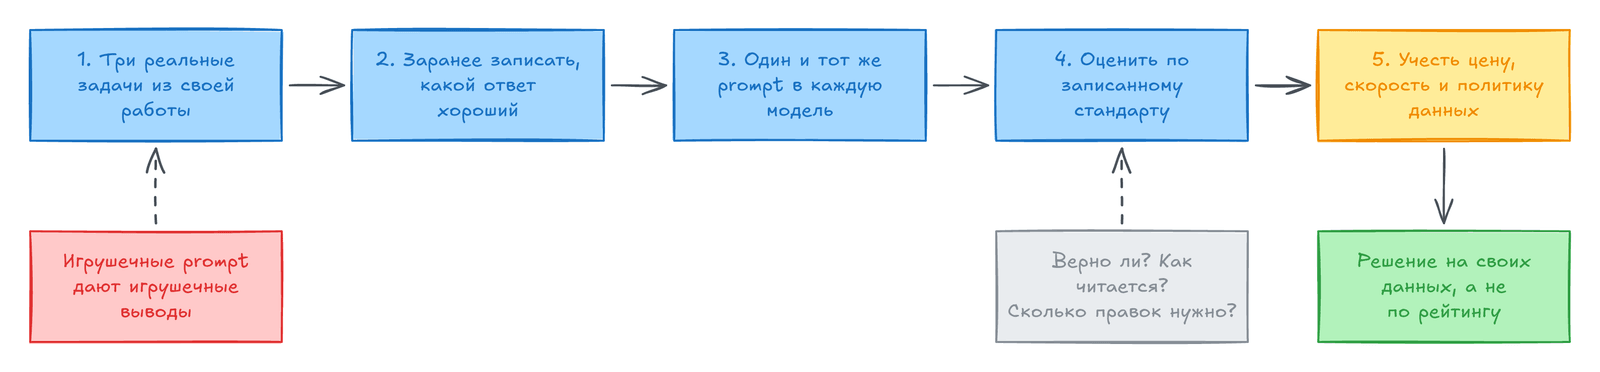
Схема идёт слева направо:
- Возьмите три задачи из своей работы: настоящий текст, грязные данные, реальный баг.
- До запуска запишите, какой ответ хороший, чтобы судить по стандарту, а не по ощущению.
- Прогоните задачи через каждую модель с одним и тем же
prompt. - Оцените: кто решил задачу, чей ответ читается лучше, где меньше правок.
- Учтите цену, скорость и политику данных.
Автор советует провести проверку на этой неделе. Смысл не в вечном победителе, а в привычке выбирать по фактам, а не по репутации.
Несколько моделей сразу
Заголовок раздела «Несколько моделей сразу»Выбирать только одну модель не обязательно. Самые сильные процессы автора используют две модели, чтобы получить результат, которого не даст ни одна из них по отдельности.
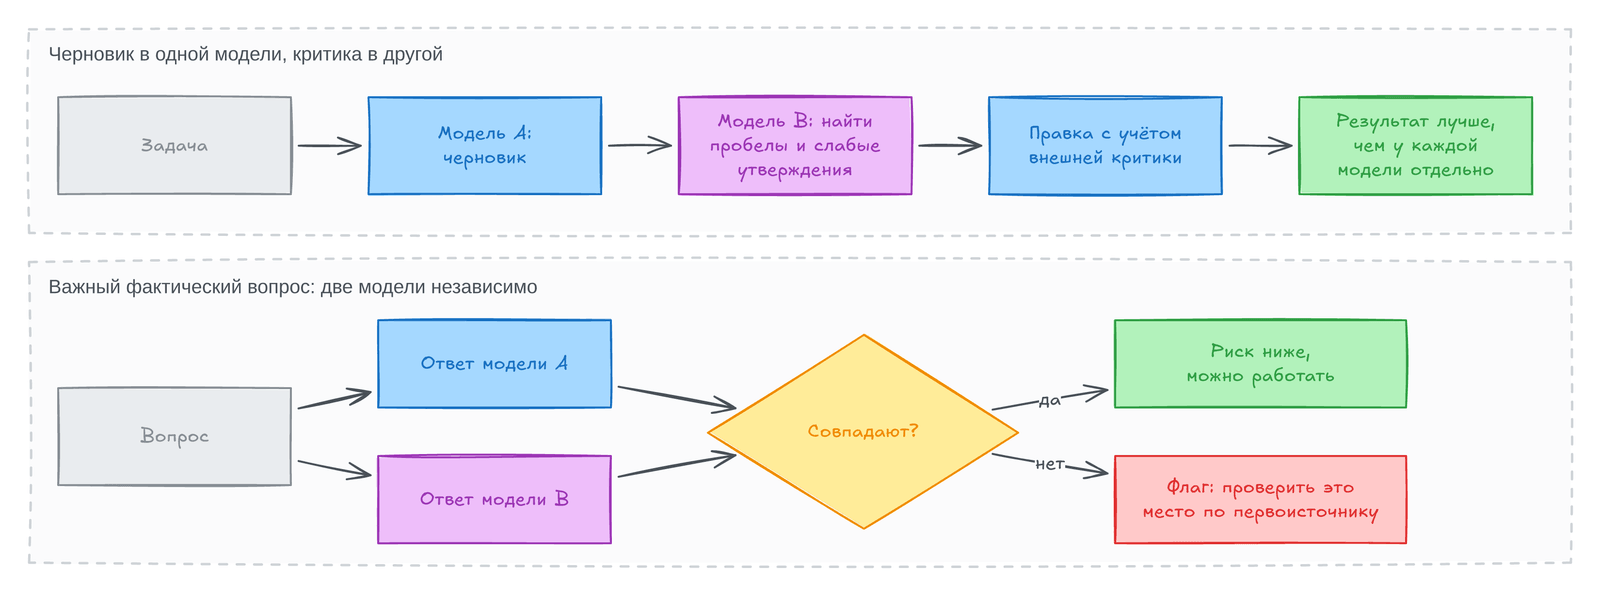
Верхняя полоса схемы — приём «черновик, потом критика». Одна модель пишет, другая ищет пробелы и бездоказательные утверждения. У неё другое обучение, поэтому она видит то, что первая пропустила. Так же можно генерировать идеи в одной модели, а отбирать в другой.
Нижняя полоса — проверка фактов. Уверенный ответ одной модели может оказаться галлюцинацией, и поймать её нечем. Если же две модели отвечают по-разному, это сигнал: именно это место нужно сверить с первоисточником.
Цена перехода: lock-in как шкала
Заголовок раздела «Цена перехода: lock-in как шкала»Привязка к поставщику (lock-in) — это не выбор «да или нет», а шкала: степенью привязки можно управлять. Держит не модель, а всё вокруг неё: отлаженные prompt, интеграции, процессы команды, привычки. Поэтому модель на 10% лучше не стоит перехода, если он съест недели перестройки.
Автор советует вкладываться глубоко, но оставлять себе возможность уйти: записывать prompt и процессы, использовать открытые стандарты подключения инструментов и иногда проверять конкурентов.
Миф о переносе prompt
Заголовок раздела «Миф о переносе prompt»Частая ошибка: отлаженный prompt переносят на новую модель без изменений, получают результат хуже и решают, что модель плохая. На самом деле prompt был подогнан под старую модель, а модели по-разному реагируют на формулировки, формат и system prompt. Поэтому при переходе заложите время на подстройку: обычно правок немного.
Итоги главы
Заголовок раздела «Итоги главы»- Лидер среди передовых моделей меняется по задачам и кварталам, поэтому важно распределять работу между моделями, а не искать вечного победителя.
- Модели сравнивают по шести признакам: способности, характер, экосистема, цена и скорость, приватность, надёжность.
- У каждого конкурента своя сила: охват у GPT, Google у Gemini, открытые веса у Llama, суверенитет у Mistral, цена у DeepSeek, реальное время у Grok.
- Экосистема вокруг модели часто важнее разницы в «интеллекте».
Benchmarkгодится как грубый фильтр, а графики поставщиков — это реклама.- Проверка за 15 минут на своих задачах говорит больше любого рейтинга.
- Расхождения двух моделей показывают, какие места нужно проверить.
- При смене модели
promptподстраивают, а не копируют.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
Benchmark | Стандартный набор задач для сравнения моделей |
| Экосистема | Приложения, интеграции и инструменты вокруг модели |
| Открытая модель | Модель с доступными весами, её запускают у себя |
| Суверенитет данных | Данные и поставщик под нужной юрисдикцией |
Привязка к поставщику (lock-in) | Чем больше построено вокруг модели, тем дороже уйти |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Перед выбором модели для
pipeline(разбор логов, генерация SQL) прогоните 3 реальных примера через 2 модели. - Храните
promptв git рядом с кодом, чтобы их было легко подстроить под другую модель. - Для чувствительных данных сначала проверьте политику данных, а потом качество.
- Если две модели по-разному описывают схему или данные, проверьте это место запросом к самим данным.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Какие две вещи скрывает привычка отдавать все задачи одной модели?
- Почему вопрос «какая модель лучшая?» неверен и чем его заменить?
- Когда открытая модель вроде Llama подходит лучше Claude?
- Зачем записывать стандарт хорошего ответа до проверки?
- Когда переход на модель, которая лучше на 10%, не оправдан?
Предыдущая: Семейство моделей Opus, Sonnet и Haiku. Следующая: Планы, цены и приватность.