

Analytics Engineering with SQL and dbt — конспект книги
Analytics Engineering with SQL and dbt: Building Meaningful Data Models at Scale — книга Rui Machado и Hélder Russa (O’Reilly, декабрь 2023). Она объясняет, кто такой analytics engineer и как он превращает сырые данные в хранилище данных в понятные и проверенные модели. Главные инструменты книги — SQL и dbt, а главная тема — моделирование данных. В книге 6 глав.
Это подробный пересказ на русском, а не перевод. За полным текстом идите в оригинал.
📥 Скачать конспект в EPUB — для телефона и электронной книги.
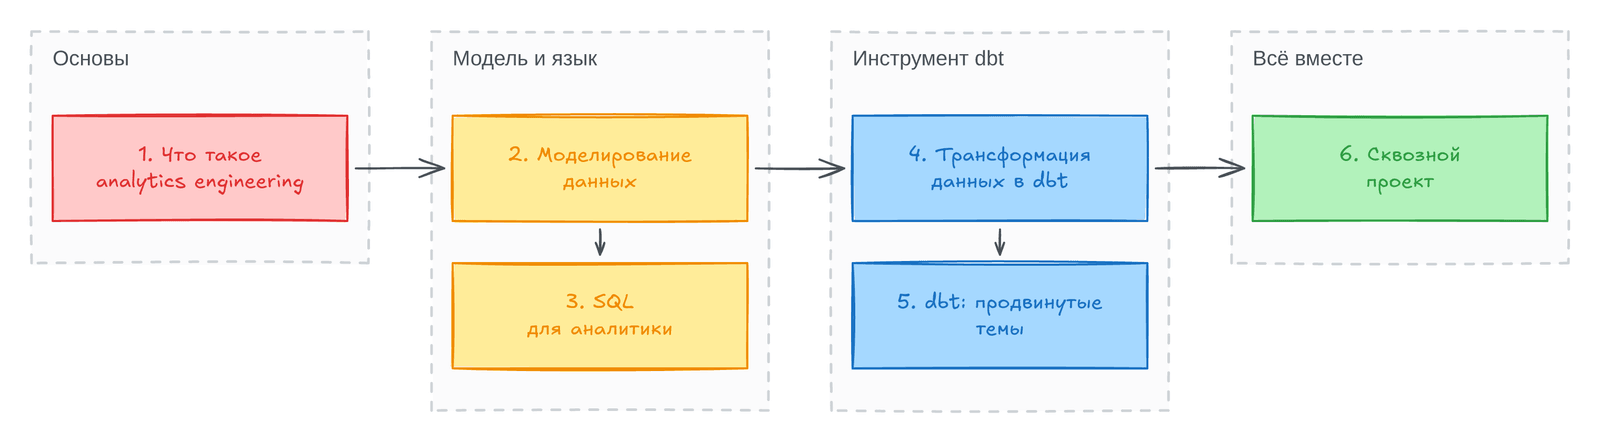
Читайте карту слева направо. Сначала книга объясняет, откуда взялась роль и зачем она нужна (глава 1). Затем она даёт два фундамента: модель данных и язык SQL (главы 2–3). На них строится инструмент dbt: сначала основы, потом продвинутые приёмы (главы 4–5). В конце все части собираются в один проект (глава 6).
О чём книга простыми словами
Заголовок раздела «О чём книга простыми словами»Облачные хранилища изменили работу с данными. Раньше данные сначала чистили в ETL-инструменте и только потом загружали. Теперь сырые данные сразу попадают в хранилище по схеме ELT, а преобразуют их уже внутри. Поэтому появилась работа, которую не делает ни дата-инженер, ни аналитик данных: превратить сырые таблицы в модели, которым бизнес может доверять. Её делает analytics engineer.
Авторы считают, что в погоне за новыми инструментами индустрия забыла о моделировании данных. Но без хорошей модели аналитика получается противоречивой, и никакой инструмент это не исправит. Поэтому книга возвращает классику: нормализацию, dimensional modeling по Kimball, Data Vault. По словам авторов, analytics engineering — не отдельный мир, а продолжение BI на современных инструментах.
Главная модель книги проста: код трансформаций пишут как программу, то есть модулями, под контролем версий, с тестами и документацией. В dbt каждая модель — это SELECT-запрос. Модели делят на слои staging, intermediate и mart и связывают через ref(), а dbt сам строит граф зависимостей и запускает модели в нужном порядке.
Что нужно знать заранее
Заголовок раздела «Что нужно знать заранее»- SQL на базовом уровне:
SELECT,WHERE,GROUP BY. Глава 3 повторяет основы, но быстро. Начните с практики по SQL или с нашей страницы об SQL. - Что такое хранилище данных и
ETL. Основу даёт страница о хранилищах и страница об ETL. - Основы моделирования. Глава 2 объясняет всё с нуля. Для глубины подойдёт конспект The Data Warehouse Toolkit и наша страница о моделировании.
Gitна уровнеcommitиbranch. Он нужен в главах 4 и 6. Если нужна основа, пройдите практику по Git.- Python нужен только для чтения. Он встречается в главах 1, 3 и 6, но глубоко его знать не нужно.
Зачем читать
Заголовок раздела «Зачем читать»- Понять роль. Книга чётко отделяет
analytics engineerот дата-инженера и аналитика данных и показывает, где он работает. - Освоить моделирование. Три этапа моделирования, нормализация,
star schema,snowflake schemaиData Vaultразобраны на одном сквозном примере. - Пройти весь
dbt. Модели,source, тесты,seed, документация,job, а затемincremental-модели,snapshot,macroиsemantic layer. - Увидеть проект целиком. Глава 6 проводит от операционной базы в MySQL до
star schemaв BigQuery и SQL-ответов на бизнес-вопросы. - Подтянуть SQL для аналитики.
JOIN,view,CTEи оконные функции, а также SQL поверх DataFrame в DuckDB и Polars.
Как устроена книга
Заголовок раздела «Как устроена книга»| Блок | Главы | О чём |
|---|---|---|
| Основы | 1 | Как менялась аналитика, облако, жизненный цикл аналитики, роль analytics engineer, data mesh, ETL и ELT |
| Модель и язык | 2–3 | Моделирование данных от 3NF до Data Vault и medallion architecture. SQL от DDL до оконных функций |
Инструмент dbt | 4–5 | Проект dbt на базе Jaffle Shop: модели, тесты, документация, job. Затем materialization, snapshot, Jinja, пакеты, semantic layer |
| Всё вместе | 6 | Сквозной проект омниканальной аналитики: от MySQL до star schema и SQL-анализа |
Блоки опираются друг на друга. Глава 1 ставит задачу: сырые данные уже в хранилище, и из них нужно сделать модели. Главы 2 и 3 дают то, без чего dbt бесполезен: умение спроектировать модель и записать её на SQL. Главы 4 и 5 показывают, как dbt превращает эти запросы в проект с тестами и документацией. А глава 6 повторяет весь путь на одном примере, поэтому её удобно читать последней.
Главные идеи
Заголовок раздела «Главные идеи»| Идея | Где разбирается |
|---|---|
Analytics engineer появился благодаря ELT и соединяет дата-инженеров и аналитиков данных | Глава 1 |
| Качество данных нужно на каждом из шести этапов жизненного цикла аналитики | Глава 1 |
Нормализация подходит для OLTP, а для аналитики модели денормализуют: star schema | Глава 2 |
Монолитный SQL-скрипт заменяют модульной моделью из слоёв staging, intermediate и mart | Глава 2 |
Medallion architecture дополняет dimensional modeling, а не заменяет его | Глава 2 |
CTE разбивают запрос на шаги с одной задачей, и на этом стиле строятся модели dbt | Глава 3 |
ref() и source() строят граф lineage и делают код переносимым между средами | Глава 4 |
Тесты в dbt проверяют данные, а не логику кода | Глава 4 |
Incremental-модель обрабатывает только новые строки, а snapshot хранит историю по SCD2 | Глава 5 |
Semantic layer определяет метрики один раз для всех потребителей | Глава 5 |
Аналитическую модель строят в четыре шага: бизнес-процесс, факты и измерения, атрибуты, grain | Глава 6 |
Как читать
Заголовок раздела «Как читать»- Новичок в данных: читайте по порядку. Если SQL слабый, начните с главы 3, а потом вернитесь к главам 1 и 2.
Analytics engineerили аналитик данных, который переходит наdbt: главы 2, 4 и 5 дают основу, а глава 6 — готовый пример проекта.- Дата-инженер: главы 1 и 2 объясняют, что ждут от модели потребители, а главы 4 и 5 — как устроен
dbt, который вы будете запускать и поддерживать. - Руководитель команды данных: главы 1 и 6. Первая объясняет роль и её место в
data mesh, вторая показывает, как выглядит проект от начала до конца.
Как работать с практикой
Заголовок раздела «Как работать с практикой»В книге примеры идут на BigQuery и dbt Cloud. Мы заменили их на DuckDB, поэтому всё запускается локально и бесплатно.
- В конце каждой главы есть раздел «Практика в DuckDB»: несколько упражнений с проверкой и скрытым решением. Нужен только DuckDB CLI.
- Полные проекты
dbtи Python-скрипты лежат в репозитории сайта, в папкеscripts/analytics-engineering-code/. Там жеREADME.mdс командами запуска. Для проектовdbtнуженdbt-duckdb. - Вывод на страницах получен настоящим запуском, так что его можно сверить со своим.
Разбор по главам
Заголовок раздела «Разбор по главам»| Глава | Какой вопрос решает |
|---|---|
| 1. Что такое analytics engineering | Откуда взялась роль analytics engineer и почему её главный инструмент — dbt? |
| 2. Моделирование данных для аналитики | Как спроектировать модель данных и разложить её на модули в dbt? |
| 3. SQL для аналитики | Какой SQL нужен, чтобы писать модели: JOIN, view, CTE, оконные функции? |
| 4. Трансформация данных в dbt | Как построить проект dbt с моделями, тестами, документацией и запуском по расписанию? |
| 5. dbt: продвинутые темы | Как ускорить модели и убрать повторы кода: incremental, snapshot, macro, пакеты, semantic layer? |
| 6. Сквозной проект analytics engineering | Как пройти весь путь от операционной базы до ответов на бизнес-вопросы? |