

Claude AI Bible, глава 2: Семейство моделей Opus, Sonnet и Haiku
Главная мысль: у Claude три уровня моделей. Начинайте с Sonnet, на Opus переходите, когда Sonnet не справляется, а простую массовую работу отдавайте Haiku.
О чём глава
Заголовок раздела «О чём глава»В главе 1 автор объяснил, как работает модель. Теперь он отвечает на вопрос, какую модель Claude брать для какой задачи. Почти все отправляют любые задачи в самую мощную модель. Ответы выглядят нормально, поэтому никто не замечает, что работа стоит в разы дороже и идёт медленнее. В главе: три модели, context window, extended thinking, зрение (vision), схема выбора, скорость, prompt caching, вывод моделей из работы и сравнение моделей на своей задаче.
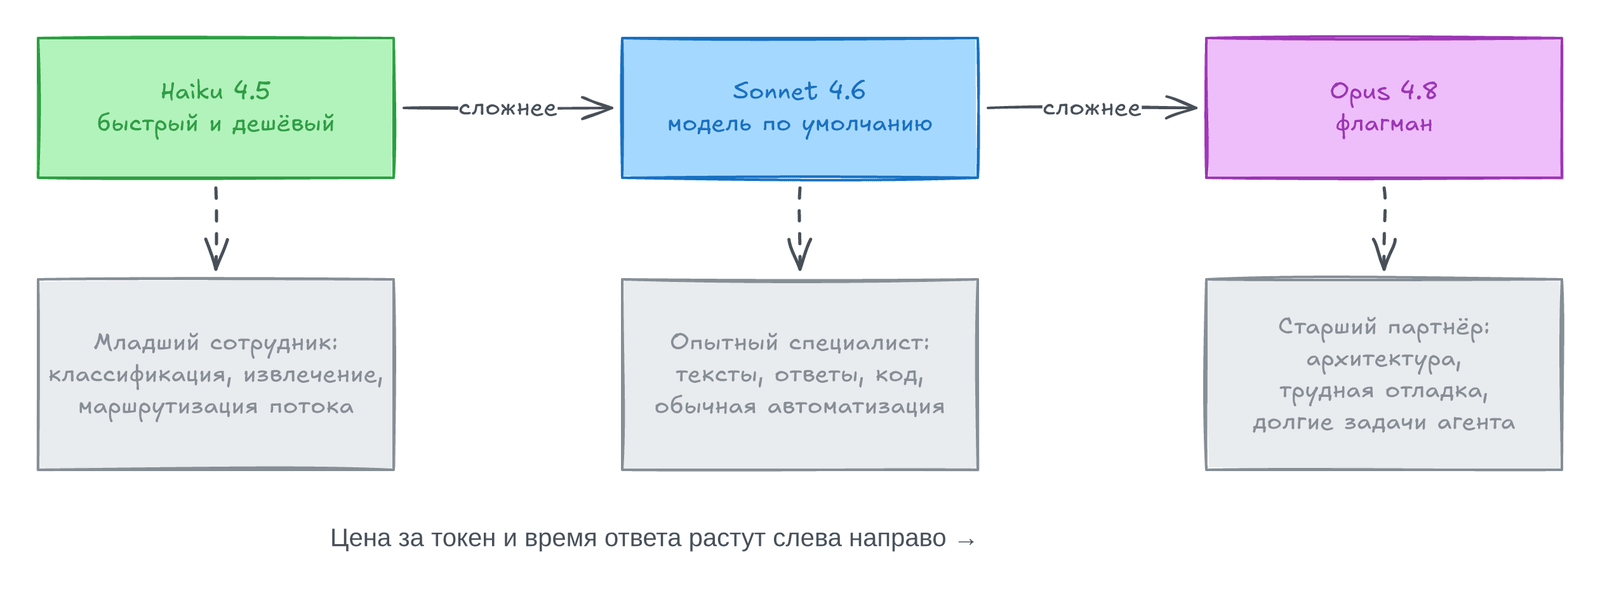
Чем сложнее задача, тем правее модель на схеме: цена выше, а ответ приходит дольше.
Названия подсказывают выбор
Заголовок раздела «Названия подсказывают выбор»Модели названы по литературным жанрам. Opus — большое произведение: Opus 4.8 — флагман для трудных задач, где верный ответ ценнее низкой цены. Сонет — рабочая форма средней длины: Sonnet 4.6 решает основную массу задач. Хокку — три строки: Haiku 4.5 быстро и дёшево отвечает на тысячи простых запросов.
Номера версий будут расти, а соотношение уровней останется, поэтому автор советует запоминать уровни, а не номера версий. Имена в API: claude-opus-4-8, claude-sonnet-4-6, claude-haiku-4-5-20251001.
Автор сравнивает семейство с консалтинговой фирмой. Opus — старший партнёр: его зовут на задачи, от которых зависит судьба компании, а не вычитывать письма. Sonnet — опытный специалист, который делает основную работу. Haiku — толковый младший сотрудник: быстро разбирает поток простых задач и знает, когда звать старших. Фирма, которая шлёт партнёра на каждую встречу, разоряется. Так же переплачивает тот, кто отправляет в Opus каждый запрос.
Opus 4.8: старший партнёр
Заголовок раздела «Opus 4.8: старший партнёр»Opus нужен, когда в задаче много связанных частей и ранняя ошибка портит все следующие шаги. Примеры автора: отладка, где причина далеко от симптома; проектирование архитектуры; юридический или финансовый сценарий со многими условиями; творческая работа; долгая задача агента без проверки человеком. У агента разница в качестве накапливается: чуть лучшее решение на каждом из сорока шагов отделяет готовую работу от путаницы. Но Opus самый дорогой за токен и самый медленный.
Ловушка. В чате по подписке перерасход скрыт: просто быстрее кончаются лимиты. В API он виден сразу. Одна команда пропускала через флагман весь pipeline поддержки и тратила примерно в пять раз больше нужного: простую классификацию тикетов делала та же модель, что решала трудные случаи. Классификацию перевели на Haiku, и счёт упал больше чем вдвое без потери качества. Вывод автора: берите самую дешёвую модель, которая справляется, и повышайте уровень, только когда видите провал.
Sonnet 4.6: модель по умолчанию
Заголовок раздела «Sonnet 4.6: модель по умолчанию»Главная мысль главы: для большинства задач подходит Sonnet. Он достаточно быстрый, дешёвый и сильный для текстов, пересказов, ответов на вопросы, большей части кода и долгого рабочего разговора. Разница с Opus видна только на по-настоящему трудном рассуждении, поэтому на обычных задачах вы платите за то, чего не увидите. Правило автора: каждую новую задачу начинайте с Sonnet. Если он спотыкается на каком-то типе задач, повысьте этот тип до Opus, а если для простой массовой задачи он избыточен, отдайте её Haiku.
Haiku 4.5: быстро, дёшево, много
Заголовок раздела «Haiku 4.5: быстро, дёшево, много»Haiku нужен для простых частых задач и там, где задержка (latency) важнее глубины. Это классификация писем, извлечение сумм из десяти тысяч счетов, маршрутизация запросов, первый проход модерации. Звать на них самую мощную модель — всё равно что звать хирурга клеить пластырь. Трудную задачу Haiku решит уверенно, но посредственно. Поэтому ему подходит работа массовая, чётко описанная и такая, где редкую ошибку поймает другая часть системы.
Продуманные системы используют все три модели сразу. Haiku решает лёгкие 80% запросов, сложное передаёт Sonnet, а самые трудные случаи уходят к Opus. Автор называет такую многоуровневую маршрутизацию (tiered routing) самым сильным способом снизить стоимость.
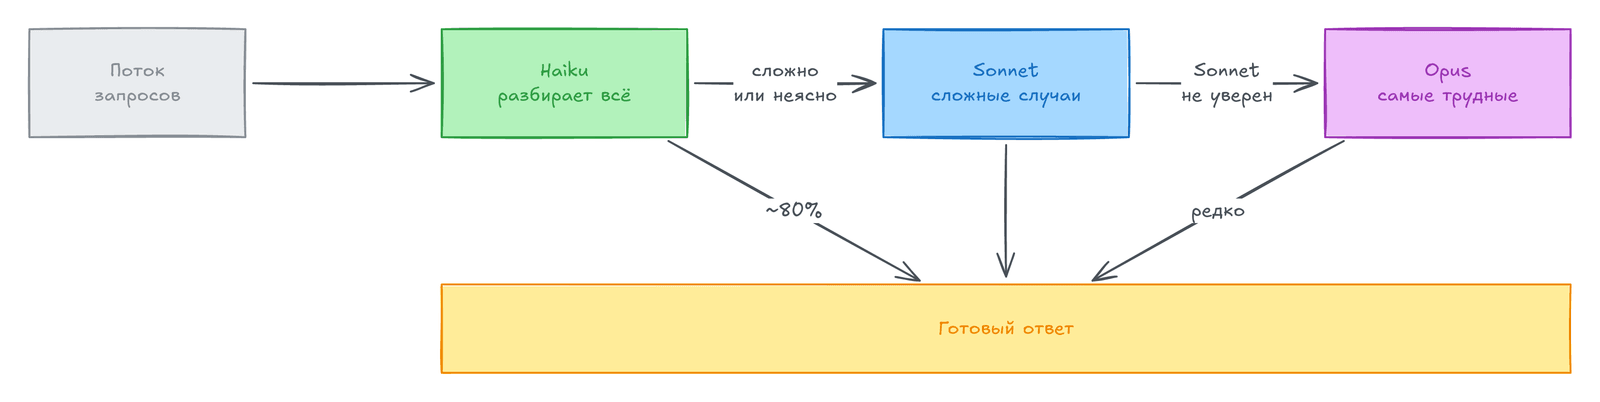
Каждая модель отвечает сама, если уверена, иначе передаёт запрос дальше.
Что даёт большой context window
Заголовок раздела «Что даёт большой context window»context window — рабочий стол модели: сколько токенов запроса и ответа она видит за раз. У Claude это порядка 200 тысяч токенов, примерно книга в 300 страниц. Цифры меняются, их проверяют на docs.claude.com. Большое окно избавляет от лишней работы: документ больше не режут на куски, а задают вопросы сразу по всему договору или модулю кода.
Автор даёт два предупреждения. Во-первых, середину огромного prompt модель читает хуже начала и конца, поэтому важную деталь ставьте на видное место или называйте прямо. Во-вторых, каждый токен стоит денег, поэтому вставлять целый документ ради одного абзаца — значит незаметно и постоянно переплачивать. Упражнение: вставьте свой самый длинный документ в Sonnet и задайте три вопроса, которые связывают разные разделы.
Extended thinking: медленнее, но дешевле
Заголовок раздела «Extended thinking: медленнее, но дешевле»extended thinking — режим, в котором модель сначала рассуждает по шагам, а потом отвечает. По пути она ловит свои ошибки, поэтому на трудных задачах точность заметно растёт. Режим окупается в многошаговой логике, расчётах, отладке и планировании: найти и переделать неверный ответ дороже, чем оплатить лишние токены рассуждения. На простых задачах он только тратит время и деньги, ведь токены размышления оплачиваются. Включайте его, если задача трудная, первый ответ всё равно пришлось бы проверять или ошибка дорого стоит.
Зрение: модель видит картинки
Заголовок раздела «Зрение: модель видит картинки»Модели Claude мультимодальные: им можно дать скриншот ошибки, фото доски после встречи, график или бланк, и они разберут, что там. Ограничения два: мелкий текст и плотные таблицы модель читает не идеально, поэтому важные данные проверяйте, а в чате она изображения не редактирует.
Схема выбора, которую легко запомнить
Заголовок раздела «Схема выбора, которую легко запомнить»Первый вопрос — насколько трудно рассуждение:
| Задача | С чего начать |
|---|---|
| Трудная, многошаговая, ошибка дорого стоит | Opus с extended thinking |
| Обычная работа: тексты, код, вопросы | Sonnet |
| Простая и массовая: классификация, извлечение | Haiku |
Дальше решают факты, а не самолюбие: не справляется Sonnet — повысьте задачу до Opus, избыточен — понизьте до Haiku. Большинство делает наоборот: из смутной тревоги берёт самую мощную модель и не проверяет, нужна ли она.
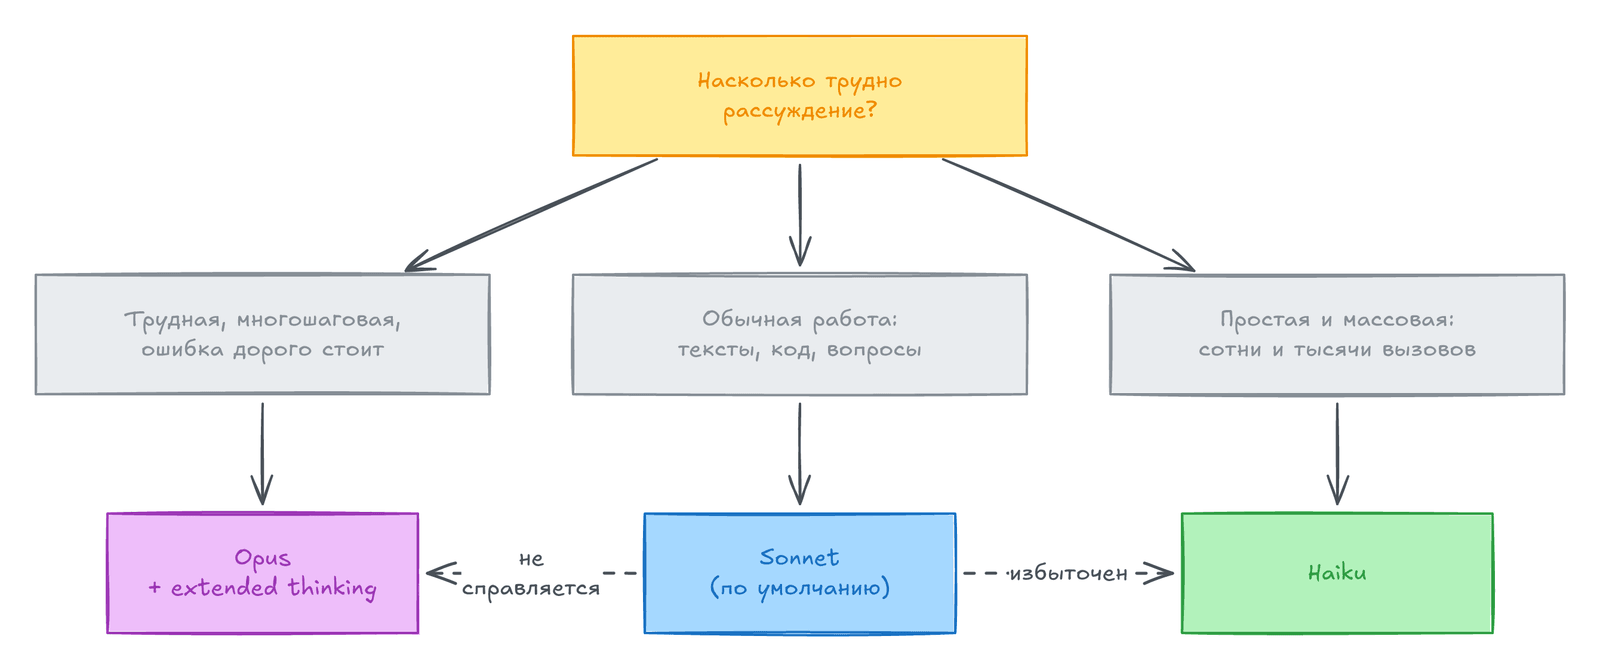
Сплошные стрелки показывают стартовую модель, пунктир — сдвиг после проверки.
Случай из практики. Стартап из Лиссабона проверял договоры, и бюджет на AI кончался к третьей неделе месяца. Каждый пункт шёл через флагман, даже шаблонный. Дешёвую модель поставили сортировать пункты на «шаблон» и «нужна проверка», и до дорогой модели доходил только второй вид. Качество не изменилось, а затраты упали примерно на две трети.
Скорость — тоже качество
Заголовок раздела «Скорость — тоже качество»Скорость — третья ось выбора после качества и цены. Если человек ждёт ответа, задержка становится частью продукта, и быстрая модель может выиграть у чуть более сильной. Фоновую работу никто не ждёт, поэтому там важны цена и качество, а в API для неё есть Batch API: ответ приходит позже, но стоит дешевле. Спрашивайте про каждую задачу: ждёт ли кто-то ответа?
Prompt caching: скрытый способ сэкономить
Заголовок раздела «Prompt caching: скрытый способ сэкономить»prompt caching позволяет не платить полную цену за большой неизменный контекст в каждом запросе. Например, ассистенту поддержки каждый раз нужен один и тот же справочник на 50 страниц: с кэшем эта часть в повторных запросах стоит намного дешевле. Кэш меняет и выбор модели: задача, которую держали на Haiku ради цены, с кэшем может уложиться в бюджет на Sonnet.
Как модели уходят на покой
Заголовок раздела «Как модели уходят на покой»Старые модели сначала объявляют к отключению — это вывод модели из работы (deprecation), — а потом отключают. Проблемы бывают у тех, кто жёстко прописал версию модели глубоко в системе и забыл о ней. Советы автора для API:
- держите имя модели в одном параметре конфигурации, а не в сорока файлах;
- следите за объявлениями на docs.claude.com, их публикуют заранее;
- проверяйте новую версию на своих задачах до перехода: на ваших
promptона может вести себя иначе.
Выбирайте по цене ошибки, а не по важности
Заголовок раздела «Выбирайте по цене ошибки, а не по важности»«Это важно для меня» и «здесь нужен флагман» — разные вещи. Письмо другу в горе очень важно, но не требует сложной логики, а скучная сверка двух финансовых таблиц может её требовать. Спросите себя, что будет, если ответ окажется чуть неверным. Если вы заметите и поправите, хватит дешёвой модели. Если неверное число незаметно попадёт в решение, берите флагман.
A/B-тест моделей на своей задаче
Заголовок раздела «A/B-тест моделей на своей задаче»benchmark и чужие мнения — только отправная точка. Метод автора:
- Возьмите 3–5 разных реальных примеров частой задачи.
- Заранее запишите, как выглядит хороший ответ.
- Прогоните примеры через Sonnet, Opus и Haiku с одним
promptи сравните. - Проверьте: дешёвая модель правда провалилась? Окупает ли дорогая свою цену? Разница устойчива или её дал один случай?
Иногда Sonnet не хуже Opus, иногда Haiku не тянет задачу. Проверка занимает минут пятнадцать и заменяет догадку фактами.
Итоги главы
Заголовок раздела «Итоги главы»- Opus 4.8 — для самого трудного рассуждения, Sonnet 4.6 — для большинства задач, Haiku 4.5 — для быстрой массовой работы.
- Начинайте с Sonnet и сдвигайте задачу вверх или вниз только по результатам.
- Многоуровневая маршрутизация через три модели сильнее всего снижает стоимость.
- Большой
context windowэкономит работу, но лишние токены стоят денег. extended thinkingокупается на трудных задачах и бесполезен на простых.- Если ответа ждёт человек, скорость важна, а фоновую работу выгоднее отдать в
Batch API. - Имя модели держат в одном месте конфигурации.
- Модель выбирают по цене ошибки и проверяют на своих примерах.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| флагман | Самая сильная и дорогая модель семейства, сейчас это Opus |
extended thinking | Модель рассуждает по шагам перед ответом |
многоуровневая маршрутизация (tiered routing) | Дешёвая модель разбирает поток, сложное уходит к сильной |
prompt caching | Повторяющийся контекст стоит дешевле |
вывод модели из работы (deprecation) | Объявленная дата отключения модели |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Классификацию и извлечение полей через LLM в
pipelineначинайте с Haiku. - Ночную обработку отправляйте через
Batch API. - Имя модели держите в конфигурации, чтобы вывод модели из работы не сломал загрузку.
- Сравнение моделей устройте как тест данных: примеры, ожидаемый ответ, три прогона.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему перерасход на флагман долго остаётся незамеченным?
- Когда задачу повышают до Opus, а когда понижают до Haiku?
- Почему не стоит заполнять
context windowдо края? - Когда
extended thinkingокупается? - Чем важность задачи отличается от цены ошибки?
Предыдущая: Машина с совестью. Следующая: Claude против конкурентов.