

Analytics Engineering with SQL and dbt, глава 2: Моделирование данных для аналитики
Главная мысль: Хорошая аналитика начинается с модели данных. Авторы проводят читателя от нормализованных таблиц для транзакций к dimensional modeling, Data Vault и medallion architecture. Главный практический вывод — строить модель из небольших модулей: в dbt это слои staging, intermediate и mart, связанные через ref().
О чём глава
Заголовок раздела «О чём глава»В главе 1 авторы описали роль analytics engineer и место dbt в работе с данными. Теперь они отвечают на вопрос, как устроить сами данные, чтобы их было легко анализировать. Темы главы:
- три этапа моделирования: концептуальный, логический и физический;
- нормализация и разница между системами для транзакций и для аналитики;
star schema,snowflake schemaиData Vault;- проблемы монолитной модели и принципы модульной;
- слои моделей в
dbt, тесты, документация и отладка; lakehouseиmedallion architecture.
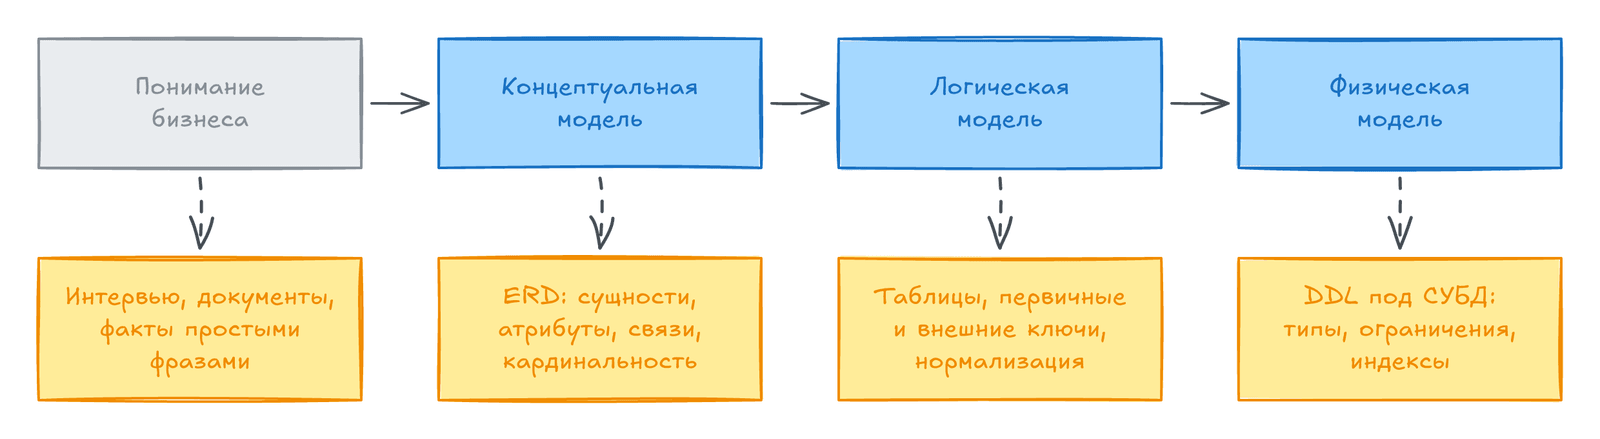
Схема показывает путь, по которому глава идёт в первой половине: от разговоров с бизнесом к готовым таблицам в базе.
Зачем аналитике модель данных
Заголовок раздела «Зачем аналитике модель данных»Моделирование данных описывает структуру данных: какие есть сущности, какие у них атрибуты и как они связаны. Важная часть моделирования — нормализация. Это способ убрать дублирование и повысить целостность данных: данные делят на логические части и хранят в отдельных таблицах.
Для аналитики модель — это фундамент. Когда аналитик понимает связи между сущностями, он без ошибок соединяет таблицы и считает агрегаты. Без продуманной модели данные легко понять неправильно, а без нормализации появляются аномалии и противоречия.
Авторы делают ставку на две технологии: SQL и dbt. SQL позволяет создавать таблицы, менять данные и читать их, поэтому на нём удобно описывать даже сложные связи. dbt добавляет к SQL каркас для всего проекта: в нём пишут логику преобразований, бизнес-правила и переиспользуемые части кода — модели (model). Проект dbt живёт в системе контроля версий, поэтому модели легко проверять, повторять и разбирать вместе.
Ещё одна сильная сторона связки — тесты и документация. Тесты в dbt не похожи на unit-тесты из разработки ПО: это привычные аналитику проверочные запросы, которые ищут нарушения качества и бизнес-правил. Документация объясняет логику и допущения модели.
Коротко о моделировании данных
Заголовок раздела «Коротко о моделировании данных»Модель базы данных — это чертёж, который отражает часть реального мира или бизнеса, его процессы и правила. Но до чертежа нужно понять сам бизнес: как он работает, какими словами говорит, какие у него процессы. Требования собирают через интервью, разбор документов и изучение процессов.
На этом этапе авторы советуют опираться на письменный язык. Факты бизнеса стоит записывать однозначными фразами, а сложные фразы — дробить на простые: подлежащее, глагол, прямое дополнение. Например: «Автор пишет книгу», «Категория классифицирует книгу». Лоуренс Корр в книге Agile Data Warehouse Design предлагает ещё рисовать на доске и заполнять шаблоны (canvas) вместе с бизнесом. Это помогает глубже разобраться в требованиях.
Затем идут три этапа моделирования: концептуальный, логический и физический. Авторы показывают их на одном примере — базе данных книжного издательства.
Концептуальный этап
Заголовок раздела «Концептуальный этап»Сначала определяют цель базы: какие задачи и требования она должна закрыть. Потом собирают требования у заказчиков и экспертов: какие нужны данные, связи и ограничения. После этого выделяют сущности — главные объекты, которые будут в базе, — и описывают их атрибуты и связи.
Уже здесь применяют лёгкую нормализацию, чтобы не было лишних повторов, и определяют ключи: первичный ключ делает запись уникальной, а внешний связывает таблицы.
Чаще всего концептуальную модель рисуют в виде ERD. ERD (entity-relationship diagram) — это диаграмма «сущность — связь»: на ней видны сущности, связи между ними и кардинальность этих связей.
В примере издательство O’Reilly хочет хранить выпущенные книги, их авторов и даты будущих выпусков. После интервью с менеджерами находят три сущности:
| Сущность | Что описывает | Атрибуты |
|---|---|---|
| Book | Книга издательства. У книги ровно одна категория | book_id, название, дата выхода, ISBN, цена, категория |
| Author | Автор, который писал для издательства | author_id, имя, email, биография |
| Category | Категория книг | category_id, название |
Кардинальность — это то, сколько экземпляров одной сущности может быть связано с экземплярами другой. Авторы перечисляют четыре типа связей:
- один к одному: например, если бы у каждой книги был ровно один автор, а у автора — ровно одна книга;
- один ко многим: в категории много книг, но у книги одна категория;
- многие к одному: то же, но с другой стороны — один издатель выпускает много книг;
- многие ко многим: у одного читателя много книг, и одну книгу читают многие.
В примере издательства нашлись две связи. Книга и категория связаны как «один ко многим». Книга и автор связаны как «многие ко многим»: у книги может быть несколько авторов, а автор пишет несколько книг. Эта связь и описывает публикацию: у автора выходит книга. Связи принято называть глаголами из жизни: не «Книга — Категория», а «Классифицирует», не «Книга — Автор», а «Публикует».
На ERD из книги сущности нарисованы прямоугольниками, связи — ромбами, атрибуты — отдельными блоками. Ключевые атрибуты, которые однозначно определяют сущность, подчёркнуты. Кардинальность подписывают символами 1, M и N, где N означает заранее неизвестное число связей. Мы перерисовали эту модель сразу в виде логической схемы ниже.
Логический этап
Заголовок раздела «Логический этап»На логическом этапе данные нормализуют: убирают повторы, повышают целостность и готовят основу для быстрых запросов. Результат — нормализованная логическая модель, которая точно отражает связи и зависимости между сущностями.
Этап состоит из двух шагов. Сначала ERD перестраивают и улучшают, ещё не привязываясь к конкретному типу базы. Затем улучшенную ERD переводят в выбранную логическую модель. Авторы выбирают реляционную модель, а не документную или графовую. Тогда каждая сущность становится таблицей, атрибуты — столбцами, а ключ сущности — первичным ключом. Такая схема ещё не зависит от конкретной СУБД.
Для перевода авторы дают простой алгоритм:
- сущность E становится таблицей T с тем же именем;
- первичный ключ E становится первичным ключом T;
- простые атрибуты E становятся столбцами T;
- для связи «многие к одному» в таблице T1 появляется внешний ключ на первичный ключ T2, а атрибуты связи переходят в T1;
- для связи «многие ко многим» создают отдельную таблицу связи (
cross-reference table). Её первичный ключ состоит из первичных ключей обеих таблиц, которые одновременно служат внешними ключами. Атрибуты связи переходят в эту таблицу.
В примере Authors, Books и Category сразу становятся таблицами. Для связи книги с категорией в books добавляют внешний ключ category_id. Для связи книги с автором создают таблицу publishes с составным ключом из book_id и author_id. Даты публикации — атрибуты самой связи, поэтому они хранятся в этой же таблице.
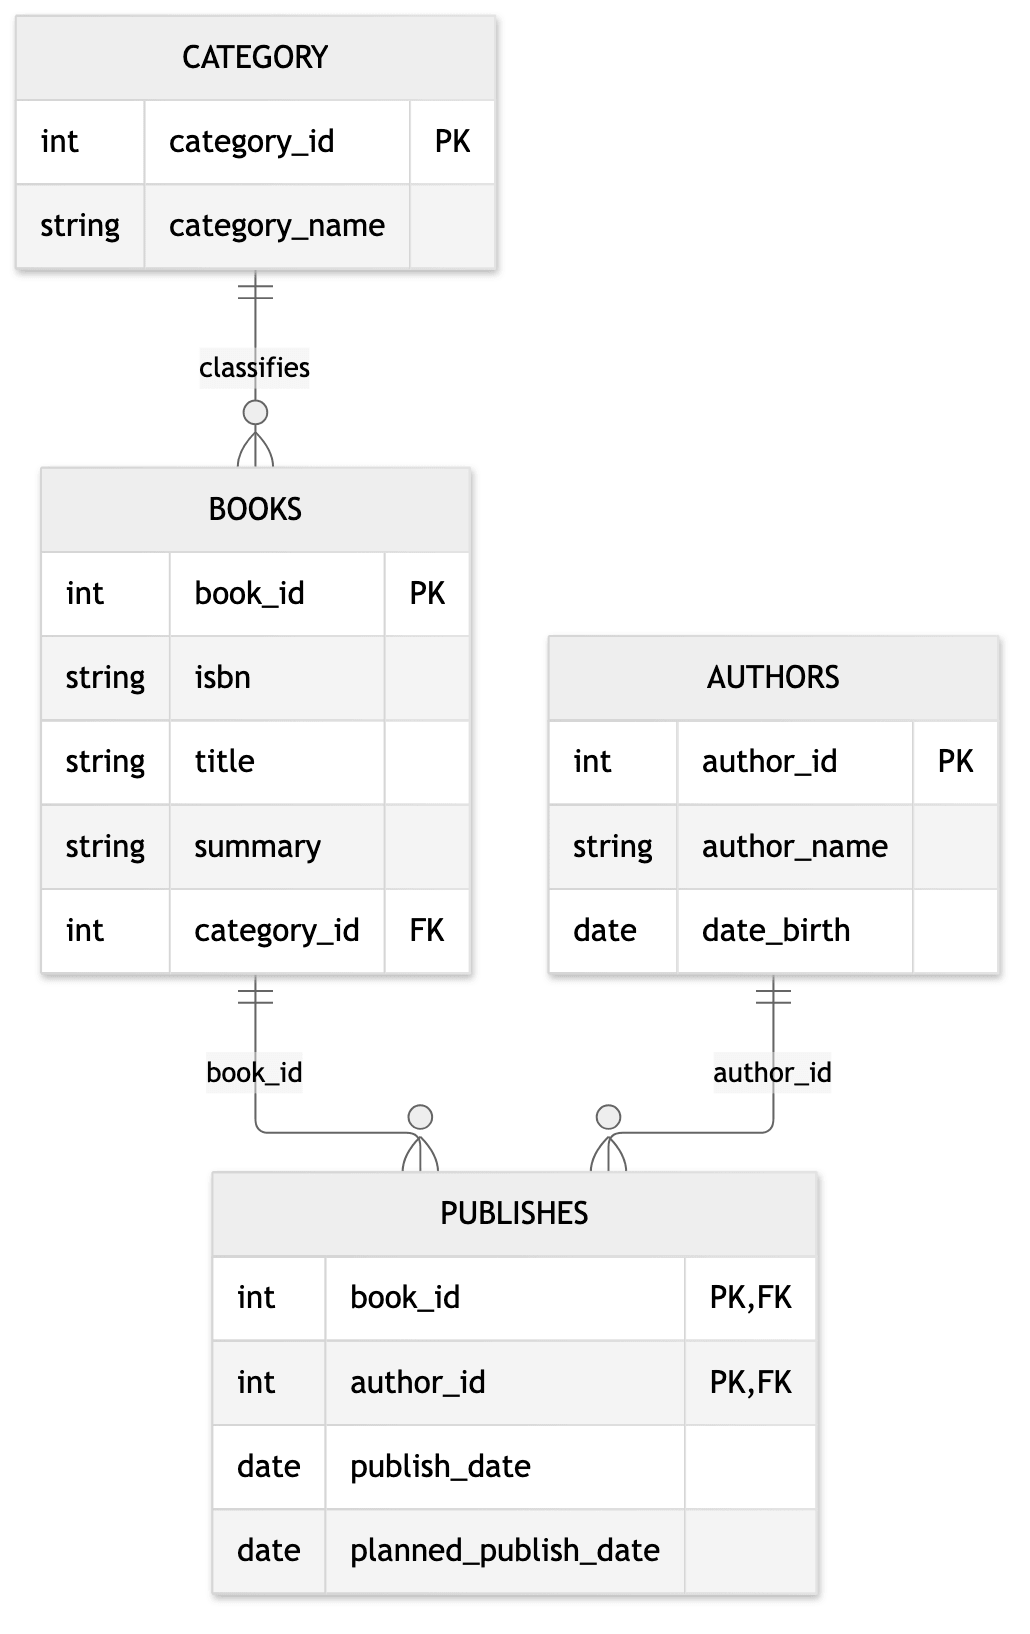
Таблица publishes превращает связь «многие ко многим» в две связи «один ко многим».
Физический этап
Заголовок раздела «Физический этап»Физический этап переводит логическую модель в конкретную базу. Здесь выбирают структуры хранения, индексы и типы данных, чтобы данные быстро записывались и читались. Логическая модель отвечает на вопрос «что храним», а физическая — «как именно это хранится».
Авторы берут MySQL. Каждому столбцу подбирают тип по его домену значений. Ключи — целые числа INT, названия — строки переменной длины VARCHAR(255). Для ISBN хватает VARCHAR(13), потому что код ISBN состоит из 13 символов. Ниже наша версия той же схемы для DuckDB:
CREATE TABLE category (    category_id   INTEGER PRIMARY KEY,    category_name VARCHAR(255));
CREATE TABLE books (    book_id     INTEGER PRIMARY KEY,    isbn        VARCHAR(13),          -- ISBN всегда 13 символов    title       VARCHAR(50),    summary     VARCHAR(255),    category_id INTEGER REFERENCES category (category_id));
CREATE TABLE authors (    author_id   INTEGER PRIMARY KEY,    author_name VARCHAR(255),    date_birth  DATE);
-- Таблица связи «многие ко многим»: ключ из двух внешних ключейCREATE TABLE publishes (    book_id              INTEGER REFERENCES books (book_id),    author_id            INTEGER REFERENCES authors (author_id),    publish_date         DATE,    planned_publish_date DATE,    PRIMARY KEY (book_id, author_id));
Процесс нормализации
Заголовок раздела «Процесс нормализации»Нормализация идёт по шагам, и каждый шаг делает структуру строже. Авторы начинают с одной таблицы books, где в каждой строке лежат название книги, имя автора, год выхода и жанр.
| Шаг | Правило | Что делают в примере |
|---|---|---|
| 1NF, первая нормальная форма | В каждой ячейке одно атомарное значение, нет повторяющихся групп | Авторов выносят в таблицу authors. В books остаётся author_id вместо полного имени |
| 2NF, вторая нормальная форма | Каждый неключевой столбец зависит от всего первичного ключа | Таблицу делят на books (ID и название), authors и bookDetails (год и жанр) |
| 3NF, третья нормальная форма | Нет транзитивных зависимостей: неключевой столбец не зависит от другого неключевого | Жанры выносят в таблицу genres. bookDetails хранит genre_id вместо названия жанра |
Транзитивная зависимость — это зависимость через посредника: столбец C зависит от B, а B — от ключа A. Если таких цепочек нет, каждое значение хранится в одном месте. Бывают и более строгие формы, 4NF и 5NF, для сложных зависимостей.
Структуры в 3NF типичны для OLTP-систем (online transaction processing). Это системы для транзакций: заказы клиентов, банковские переводы, расчёт зарплаты. Нормализация даёт им три выгоды:
- Меньше дублирования и выше целостность. Каждая таблица отвечает за свою задачу, таблицы связаны первичными и внешними ключами. Поле повторяется в разных таблицах только если это ключ или служебное поле вроде времени создания.
- Быстрые чтение и запись. Мало повторов и чёткие связи позволяют обрабатывать огромное число мелких транзакций с малой задержкой.
- Только актуальные данные. Запись о клиенте всегда хранит его текущие имя и телефон, то есть база отражает положение дел сейчас.
В аналитике всё иначе. Пользователи хотят получать данные без длинных цепочек JOIN, которые неизбежно возникают после нормализации. OLTP-систему оптимизируют под запись, чтобы веб-приложение не тормозило, а аналитическую — под чтение. Аналитическая база хранит не только текущие данные, но и историю, то есть служит архивом. К тому же она часто собирает данные из нескольких OLTP-систем, чтобы показать бизнес-процесс целиком.
Всё, что описано выше, относится к моделированию для OLTP. Дальше глава переходит к подходам для OLAP, то есть для аналитики.
Dimensional modeling
Заголовок раздела «Dimensional modeling»Dimensional modeling — это подход к моделированию данных под аналитику и отчёты. Он хорошо подходит для хранилищ данных (data warehouse) и BI. Модель состоит из таблиц фактов (fact table) с измеримыми данными и таблиц измерений (dimension table) с описанием контекста. Самые известные схемы — star schema и snowflake schema: они упрощают сложные запросы.
У истоков хранилищ данных стоят Билл Инмон и Ральф Кимбалл. Инмона называют отцом хранилищ данных, Кимбалла — отцом dimensional modeling. Их подходы долго спорили друг с другом:
| Инмон | Кимбалл | |
|---|---|---|
| Что строим | Одно централизованное хранилище на всю компанию | Несколько витрин данных (data mart) для отделов |
| Как храним | Реляционная модель в 3NF | Многомерная модель: star schema и snowflake schema |
| Главный довод | Реляционная модель даёт единые данные для всей компании, и витрины из неё строить легко | Многомерная модель понятна пользователям: её легко анализировать, агрегировать и в ней проще искать расхождения в данных |
| Доступ аналитики | Только через витрины, а не к хранилищу напрямую | Аналитические системы читают модель напрямую |
Витрина данных (data mart) — это часть хранилища, которая обслуживает нужды одного отдела или направления бизнеса.
Дальше авторы разбирают три техники: star schema, snowflake schema и Data Vault. Data Vault придумал Дэн Линстедт в 2000 году, и в последние годы он становится популярнее. Её структура ближе к нормализованной: она не совпадает с подходом Инмона, но похожа на него.
Star schema
Заголовок раздела «Star schema»Star schema — самый распространённый подход в реляционных хранилищах для анализа и отчётов. В нём каждая таблица — либо таблица измерений, либо таблица фактов.
Таблица измерений описывает бизнес-сущности: товары, людей, места, понятия и время. Почти в каждой star schema есть измерение дат с полным набором дат для анализа. В таблице измерений есть один или несколько ключевых столбцов, которые однозначно определяют сущность, и описательные столбцы.
Таблица фактов хранит наблюдения или события: заказы, остатки на складе, курсы валют, температуру. В ней есть ключи измерений, которые ссылаются на таблицы измерений, и числовые показатели (measure). Набор ключей задаёт, по каким измерениям можно анализировать факты. Например, таблица плановых продаж с ключами Date и ProductKey позволяет смотреть план по времени и по товарам.
Grain таблицы фактов — это то, что означает одна её строка. Он следует из значений ключей измерений. Если в таблице плановых продаж Date всегда хранит первое число месяца, то grain — «месяц и товар»: одна строка — это план на один месяц для одного товара.
Авторы строят star schema из той же таблицы books с полями book_id, title, author, publication_year и genre. Сначала выделяют измерения — атрибуты отдельных бизнес-сущностей. Как и при нормализации, это книги, авторы и жанры: dimBooks, dimAuthors и dimGenres. Затем создают таблицу фактов factBookPublish с ключами трёх измерений и годом публикации.
С именами авторы советуют не мудрить. Измерение называют по сущности: dimBook или просто books, dimAuthor, dimGenre. Таблицу фактов называют по событию или measure: factBookSales или salesFact.
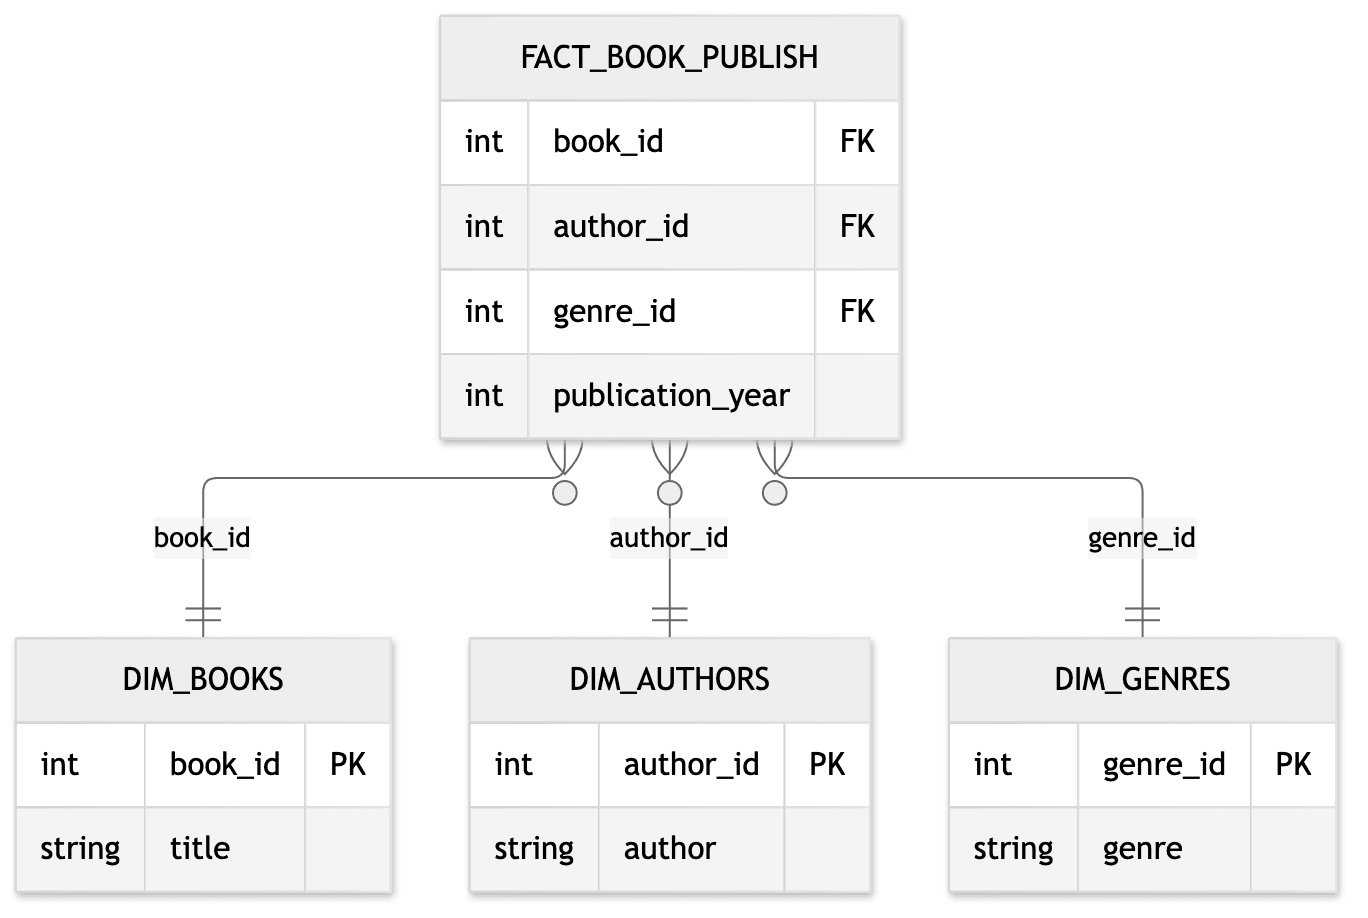
Таблица фактов в центре, измерения вокруг — отсюда и название «звезда». Теперь публикации легко фильтровать по жанру, автору или году. Например, так считают число публикаций по жанрам:
CREATE TABLE dim_genres (genre_id INTEGER PRIMARY KEY, genre VARCHAR);INSERT INTO dim_genres VALUES (1, 'Базы данных'), (2, 'Программирование');
CREATE TABLE fact_book_publish (    book_id INTEGER, author_id INTEGER, genre_id INTEGER, publication_year INTEGER);-- У книги 103 жанр 3, которого пока нет в dim_genresINSERT INTO fact_book_publish VALUES    (101, 1, 1, 2021), (102, 1, 1, 2022), (103, 2, 3, 2023),    (104, 3, 2, 2022), (105, 2, 1, 2024);
SELECT COALESCE(g.genre, 'Нет данных') AS genre, COUNT(*) AS total_publicationsFROM fact_book_publish AS fLEFT JOIN dim_genres AS g ON g.genre_id = f.genre_idGROUP BY 1ORDER BY total_publications DESC, genre;┌──────────────────┬────────────────────┐│ genre │ total_publications ││ varchar │ int64 │├──────────────────┼────────────────────┤│ Базы данных │ 3 ││ Нет данных │ 1 ││ Программирование │ 1 │└──────────────────┴────────────────────┘Факты с измерениями обычно соединяют через LEFT JOIN. Так в результат попадают все строки фактов, даже если для какой-то нет пары в измерении. Пропуск закрывают через COALESCE, который подставляет значение по умолчанию: -1 или «Нет данных». Кроме того, с LEFT JOIN измерения можно пополнять постепенно: когда в измерение приходят новые записи, старые факты не теряются, и отчёты остаются согласованными.
Простая денормализованная «звезда» удобна для агрегатов и поддерживает drill-down (переход к деталям) и roll-up (переход к общим итогам). Её легко подключить к Tableau, Power BI или Looker.
Авторы признают, что их пример не до конца показывает денормализацию. Если у книги всегда ровно один жанр, жанр можно положить прямо в dimBooks и обойтись без отдельной таблицы.
Snowflake schema
Заголовок раздела «Snowflake schema»Snowflake schema нормализована сильнее, чем star schema: таблицы измерений в ней разбиты на несколько связанных таблиц. Это повышает целостность и уменьшает дублирование.
Возьмём интернет-магазин с измерением customers: ID, имя и адрес клиента. В snowflake schema его делят на customers (ID и имя) и addresses (ID, улица, город, индекс). Если у нескольких клиентов один адрес, он хранится один раз. Зато чтобы получить имя клиента вместе с адресом, нужен лишний JOIN. Запросы становятся сложнее, но для больших данных со сложными связями такая схема бывает полезна: она лучше нормализована и гибче в управлении данными.
Сравним две схемы:
| Star schema | Snowflake schema | |
|---|---|---|
| Измерения | Денормализованы, есть повторы | Нормализованы, разбиты на уровни |
| Запросы | Проще и быстрее: меньше JOIN | Сложнее: больше JOIN |
| Хранение | Нужно больше места | Меньше повторов |
| Изменения | Труднее обновлять и искать ошибки | Легче приспособить к новым требованиям |
| Когда выбирать | Важны простота и скорость анализа | Требования к данным часто меняются |
Из-за этих минусов у каждой схемы в жизни часто встречаются гибридные модели: в целом это «звезда», но часть измерений нормализуют. Выбор зависит от задач.
Пример — измерение местоположения клиентов. В star schema это одна таблица dimLocation, где страна, регион и город лежат рядом. В snowflake schema иерархию разбивают на четыре таблицы: dimLocation, dimCity, dimState и dimCountry, связанные первичными и внешними ключами.
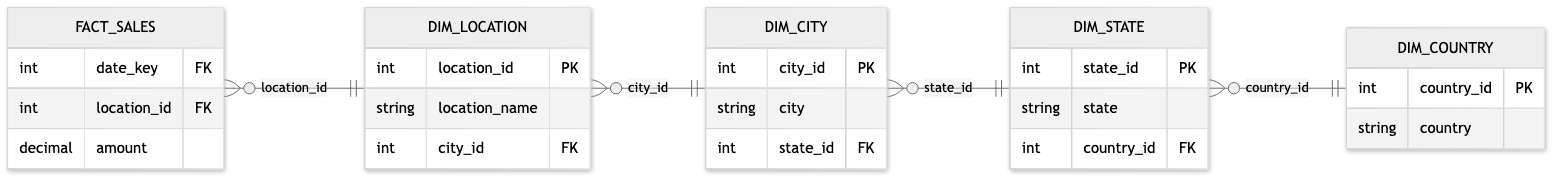
С таблицей фактов связана только одна таблица иерархии — dimLocation. Остальные уровни идут цепочкой от самого детального к самому общему: место, город, регион, страна.
Data Vault
Заголовок раздела «Data Vault»Data Vault 2.0 не относится к dimensional modeling, но авторы считают его важным. Он сочетает элементы 3NF и dimensional modeling, чтобы построить логическое хранилище для всей компании, и работает с данными любой структуры. Главная его черта — модель растёт модулями и по шагам, а сырые данные связываются через бизнес-ключи. Поэтому хранилище выдерживает большие объёмы, новые требования бизнеса и смену исходных систем.
Модель состоит из трёх видов таблиц:
Hub— бизнес-сущность: клиент, товар, место. Хранит уникальные бизнес-ключи. Бизнес-ключ — это идентификатор из самого бизнеса, например номер книги или ИНН клиента. Описательные атрибуты отделены от ключа, поэтому их изменения не ломают целостность ключа.Link— связь между сущностями, обычно «многие ко многим» или сложная. Хранит внешние ключи связанныхhubи служит мостом между ними без дублирования данных.Satellite— описательные атрибутыhubилиlink, привязанные к ним внешним ключом.Satelliteхранит меняющиеся во времени данные и всю их историю. У одногоhubможет быть несколькоsatelliteдля разных наборов атрибутов.
В примере с books бизнес-ключ — book_id, а сущность одна, поэтому link не нужен. Авторы создают hubBooks с ключом книги и hash key (хешем бизнес-ключа) и satBooks с автором, годом и жанром. Первичный ключ satellite состоит из ключа книги и даты загрузки. Поэтому изменения атрибутов добавляются новыми строками, а старые записи не меняются.
Пояснение: в книге в
hubлежит и описательный столбецTitle, а первичный ключ — целое число. В стандартномData Vault 2.0первичный ключhub— этоhash key, а все описательные атрибуты живут вsatellite. Код ниже следует стандарту.
CREATE TABLE hub_books (    book_hash_key VARCHAR PRIMARY KEY,   -- md5 от бизнес-ключа    book_id       INTEGER,               -- бизнес-ключ    load_date     TIMESTAMP,    record_source VARCHAR);
CREATE TABLE sat_books (    book_hash_key VARCHAR REFERENCES hub_books (book_hash_key),    load_date     TIMESTAMP,    title         VARCHAR,    author        VARCHAR,    genre         VARCHAR,    PRIMARY KEY (book_hash_key, load_date)  -- новая версия = новая строка);
INSERT INTO hub_books VALUES (md5('101'), 101, TIMESTAMP '2024-01-10 00:00:00', 'crm');INSERT INTO sat_books VALUES    (md5('101'), TIMESTAMP '2024-01-10 00:00:00', 'SQL с нуля', 'Анна Петрова', 'Программирование'),    (md5('101'), TIMESTAMP '2024-03-05 00:00:00', 'SQL с нуля', 'Анна Петрова', 'Базы данных');
SELECT h.book_id, s.load_date, s.genreFROM hub_books AS hJOIN sat_books AS s USING (book_hash_key)ORDER BY s.load_date;┌─────────┬─────────────────────┬──────────────────┐│ book_id │ load_date │ genre ││ int32 │ timestamp │ varchar │├─────────┼─────────────────────┼──────────────────┤│ 101 │ 2024-01-10 00:00:00 │ Программирование ││ 101 │ 2024-03-05 00:00:00 │ Базы данных │└─────────┴─────────────────────┴──────────────────┘Жанр книги поменялся, но обе версии остались в satellite.
Монолитная модель
Заголовок раздела «Монолитная модель»До недавнего времени модель данных часто была одним огромным SQL-скриптом на тысячи строк. В лучшем случае его делили на несколько скриптов или хранимых процедур и запускали по очереди из Python. Хуже того, об этих скриптах мало кто знал в компании. Поэтому тот, кому нужна похожая модель, начинал с нуля и не мог опереться на чужую работу.
Авторы называют такой подход монолитным, или традиционным. Каждый потребитель данных заново строил свои преобразования от сырых данных до отчёта. Отсюда типичные проблемы:
- у скриптов нет контроля версий;
- зависимости между
viewтрудно отслеживать; - новые таблицы и
viewстроят прямо от сырых данных до отчёта, поэтому код почти не переиспользуют; - идемпотентность соблюдают не везде, и на больших таблицах появляются дубли (идемпотентность — свойство, при котором повторный запуск даёт тот же результат);
backfill, то есть пересчёт данных за прошлые периоды, превращается в сложную ручную работу.
Знакомый многим сценарий: в production что-то сломалось, вы делаете простую правку, и она вызывает цепочку ошибок по всей системе. В монолите все части тесно связаны, поэтому проблему трудно найти и изолировать. Изменение в одном месте неожиданно бьёт по другому, и любую правку страшно делать.
Монолит мешает и развитию: подключить новую исходную систему или технологию всё труднее. Команда боится сломать важное и работает слишком осторожно, а это замедляет разработку.
Выход — модульная модель. Здесь сильно помог dbt: он делит единую модель на отдельные модули, у каждого свой SQL-код и свои зависимости. Модули можно разрабатывать, тестировать и отлаживать по отдельности. Поэтому правка в одном модуле не ломает всю систему, и изменения вносить безопаснее. Подробно dbt разобран в главе 4.
Модульные модели данных
Заголовок раздела «Модульные модели данных»В разработке ПО модульность давно стала нормой. Большую задачу делят на шаги, и это даёт несколько выгод:
| Выгода | В чём она |
|---|---|
| Управляемость | Небольшую задачу проще держать в голове, чем всю программу |
| Командная работа | Части программы пишут разные люди, а потом собирают вместе. Это быстрее и позволяет специализацию |
| Качество кода | Программист отвечает за свою часть и может довести её до ума, поэтому в целой программе меньше ошибок |
| Повторное использование | Проверенный модуль не пишут заново, а вызывают там, где нужна та же функция |
| Читаемость и надёжность | Код разложен по задачам, его легко найти и отладить, поэтому он реже ломается |
В мире данных модульность прижилась только в последние годы. Авторы объясняют это тем, что архитектура данных и разработка ПО долго жили отдельно. Сейчас они сближаются, и те же выгоды работают для аналитики. Если разбить сложную структуру данных на модули, ими проще управлять на разных уровнях детализации. Модули можно переиспользовать, а это даёт единые результаты и меньше повторов.
Авторы выделяют три принципа модульного моделирования:
- декомпозиция — разбить модель на небольшие управляемые части;
- абстракция — спрятать детали реализации за понятным интерфейсом;
- повторное использование — делать части, которые работают в разных местах системы.
Модульную модель можно получить нормализацией, средствами хранилища данных или виртуализацией данных. Например, нормализация сама раскладывает данные по таблицам в зависимости от их смысла и связей.
Но удобнее всего это делать в dbt. Декомпозицию дают отдельные файлы моделей и macro — переиспользуемые функции на Jinja. Абстракцию даёт единый способ обращаться к исходным данным, а повторное использование — общий код для разных моделей. Кроме того, в dbt есть тесты и документация, а через materialization можно настроить скорость каждой части модели.
У модульности есть и минусы. Цельную систему иногда проще оптимизировать: меньше переносов данных и расхода памяти, а оптимизатор базы может сам улучшить SQL. Цепочка «сначала view, потом из неё таблица» порой работает хуже. Обычно выгоды модульности перевешивают, но есть ещё риск: файлов становится больше, а значит, больше объектов, у которых должен быть владелец и которые однажды придётся удалить. Без зрелого data governance легко получить множество модульных таблиц без хозяина, а с ними трудно разбираться при сбоях.
Модульные модели в dbt
Заголовок раздела «Модульные модели в dbt»Когда проект растёт, модулями становится трудно управлять вручную. Здесь и помогает dbt. С модульным подходом каждый, кто строит или использует данные, опирается на работу коллег и не начинает каждый раз с сырых данных.
С dbt модель становится набором частей. Преобразования, которые нужны в нескольких моделях, выносят в общие модели и ссылаются на них из разных мест.
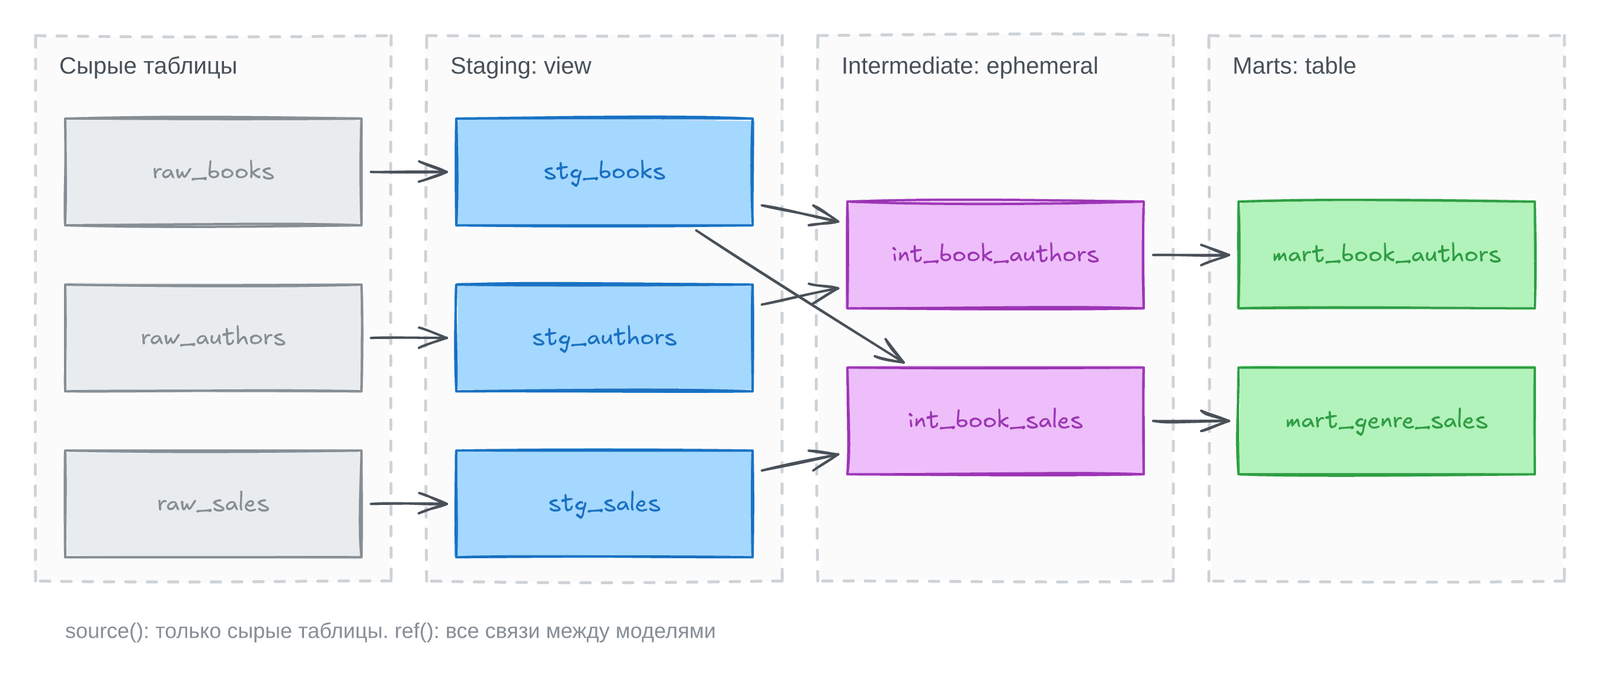
Схема читается слева направо. Одна staging-модель (stg_books) нужна двум intermediate-моделям, и её не пишут дважды. Такой многоуровневый граф (DAG, направленный ациклический граф зависимостей) показывает, как слои логики строятся друг на друге.
Но сам по себе dbt не гарантирует модульность и понятный DAG. Структура графа зависит от того, как команда понимает модель данных и насколько единообразно воплощает это понимание в коде. Авторы советуют следить за правилами именования, читаемостью, удобством отладки и оптимизации во всех слоях: staging, intermediate и mart.
Ссылки на модели
Заголовок раздела «Ссылки на модели»Jinja — это язык шаблонов, который позволяет вставлять в SQL логику и вычисления. Главный приём модульности в dbt — ссылка на модель через {{ ref() }}. По этим ссылкам dbt сам находит зависимости между моделями и запускает их в правильном порядке.
Функцию {{ source() }} авторы советуют использовать редко: только там, где модель впервые берёт сырые данные из базы. Ссылаться напрямую на таблицы, которые создал не dbt, не стоит: это ломает модульность. Связи между моделями задают только через ref(), тогда изменения выше по цепочке правильно доходят до моделей ниже.
В примере книги модель заказов соединяет {{ ref('orders') }} и {{ ref('customers') }} по customer_id и добавляет к заказу имя и email клиента. Модель customers при этом просто выбирает столбцы из сырой таблицы raw_customers.
Без такой структуры сложные данные, например еженедельные заказы товаров, превращаются в клубок SQL-запросов. Если же разложить преобразования по слоям от исходных таблиц до витрин, pipeline становится понятным: каждый слой решает свою задачу, и его можно улучшать отдельно.
Staging-модели
Заголовок раздела «Staging-модели»Staging-слой — основа для всех более сложных моделей. Каждая staging-модель соответствует одной исходной таблице один к одному. Преобразований здесь должно быть мало. Допустимы:
- приведение типов;
- переименование столбцов;
- простые вычисления, например перевод единиц;
- категоризация через
CASE WHEN.
Staging-модели обычно хранят как view. Так модели ниже по цепочке всегда видят свежие данные, а место и деньги на хранение не тратятся. JOIN в этом слое лучше не делать, чтобы не повторять одни и те же вычисления: соединения уместнее в следующих слоях. Агрегаты здесь тоже вредны: они схлопывают строки и закрывают доступ к деталям исходных данных.
Staging-модели помогают соблюдать принцип DRY (Don't Repeat Yourself, «не повторяйся»). Преобразование, которое нужно всегда, переносят как можно выше по цепочке. Например, если суммы всегда хранятся в центах, а нужны в долларах, деление и смену типа делают один раз в staging. Дальше все модели берут готовое значение.
-- models/staging/stg_books.sqlSELECT book_id, title, author_id, genre, publication_year, price_cents / 100.0 AS price -- центы в доллары, один раз для всех моделейFROM {{ source('raw', 'books') }}Так первичная подготовка данных отделена от дальнейшей обработки, а все следующие слои получают единый вид данных.
Base-модели
Заголовок раздела «Base-модели»Base-модели обычно играют ту же роль, что и staging: они напрямую читают сырые данные в хранилище. Иногда в них добавляют и другие шаги преобразования, если проекту это нужно. В документации dbt название «base» сменили на «staging». Слово «base» звучит как «самый первый шаг» и сковывает, а «staging» описывает роль слоя свободнее.
Intermediate-модели
Заголовок раздела «Intermediate-модели»Intermediate-слой собирает атомарные блоки из staging в более сложные модели. Они важны для бизнеса, но обычно не попадают напрямую в дашборды и приложения. Цель слоя — соединить разные сущности и забрать на себя сложность, чтобы витрины оставались простыми.
Авторы советуют начинать с ephemeral-модели. Такая модель не создаёт объект в базе: dbt встраивает её код как CTE в модели, которые на неё ссылаются. У этого есть минусы. Модель нельзя выбрать напрямую, поэтому её трудно отлаживать. Кроме того, на неё не могут ссылаться macro, вызванные через run-operation. Поэтому иногда лучше хранить её как view. Такие view полезно класть в отдельную схему, а не в основную схему из профиля dbt: так проще поддерживать порядок и права доступа.
Есть и сигнал о плохом дизайне. Если на одну intermediate-модель ссылается много моделей, возможно, её логику лучше превратить в macro.
-- models/intermediate/int_book_authors.sql{{ config(materialized='ephemeral') }}
WITH books AS (    SELECT * FROM {{ ref('stg_books') }}),authors AS (    SELECT * FROM {{ ref('stg_authors') }})SELECT b.book_id, b.title, b.genre, b.price, a.author_id, a.author_nameFROM books AS bJOIN authors AS a ON a.author_id = b.author_id
Модель ссылается на две staging-модели через ref(), поэтому dbt сам понимает, что их нужно построить раньше.
Mart-модели
Заголовок раздела «Mart-модели»Mart-модели — верхний слой. Они собирают данные из разных частей модели в цельную картину бизнес-сущности и отдают её пользователям через дашборды и приложения.
Витрины обычно хранят как таблицы, чтобы запросы пользователей выполнялись быстро. Если таблица строится слишком долго или дорого, её делают incremental-моделью: тогда при каждом запуске обрабатываются только новые данные. Витрина должна быть простой. Если в ней нужно много JOIN, это повод пересмотреть intermediate-слой.
-- models/marts/mart_book_authors.sql{{ config(materialized='table') }}
WITH book_counts AS (    SELECT author_id, author_name, COUNT(*) AS total_books    FROM {{ ref('int_book_authors') }}    GROUP BY author_id, author_name)SELECT * FROM book_counts
Витрина считает число книг у каждого автора. Это таблица, поэтому её пересобирают, когда нужно отразить изменения в исходных данных.
Тесты моделей данных
Заголовок раздела «Тесты моделей данных»Тесты в dbt проверяют точность и надёжность моделей и исходных данных. Тест — это SQL-запрос, который ищет строки, нарушающие правило. Если запрос вернул хотя бы одну строку, тест упал.
В dbt два вида тестов:
Singular test | Generic test | |
|---|---|---|
| Что это | Отдельный SQL-файл для одной конкретной проверки | Параметризованный тест, который подключают ко многим моделям и столбцам |
| Пример | Нет ли NULL в таблице фактов, верно ли прошло преобразование | Значения не отрицательные, связи между таблицами целы |
| Где подключают | Лежит в папке tests/ и запускается сам | Пишут один раз, а применяют в YAML-файлах моделей |
Пояснение: в книге оба примера тестов записаны в YAML, а
generic testописан прямо в YAML со своими полями. В текущемdbtтак не работает:singular test— это SQL-файл, аgeneric testпишут блоком{% test %}и подключают в YAML. Ниже код в современном синтаксисе.
Singular test проверяет, что у каждой книги есть автор:
-- tests/assert_books_have_author.sql-- Тест падает, если запрос вернул хотя бы одну строкуSELECT b.book_idFROM {{ ref('stg_books') }} AS bLEFT JOIN {{ ref('stg_authors') }} AS a ON a.author_id = b.author_idWHERE a.author_id IS NULLGeneric test проверяет, что в столбце нет отрицательных значений. Его пишут один раз, а применяют к любым моделям:
-- tests/generic/non_negative.sql{% test non_negative(model, column_name) %}SELECT *FROM {{ model }}WHERE {{ column_name }} < 0{% endtest %}version: 2models: - name: stg_books columns: - name: price data_tests: - not_null - non_negativeОдин и тот же тест можно подключить к столбцам amount и quantity в разных моделях без копирования логики. Нужно только положить файл теста в ту папку, где его ищет проект, как в примере выше.
Документация данных
Заголовок раздела «Документация данных»Документация — ещё одна обязательная часть моделирования. Каждый в компании, включая бизнес-пользователей, должен понимать метрики вроде ARR (годовая регулярная выручка), NPS (индекс лояльности клиентов) или MAU (активные пользователи за месяц). Без этого решения на основе данных не работают.
В dbt можно описать, как считается метрика и на какие данные она опирается, и тогда пользователи разбираются в данных сами. Авторы документируют модель nps_metrics прямо в SQL-файле: в комментарии описаны зависимости и способ расчёта.
/* nps_metrics: Net Promoter Score по оценкам клиентов от 0 до 10. Promoters: 9–10, Passives: 7–8, Detractors: 0–6. NPS = % promoters − % detractors. */WITH feedback(customer_id, rating) AS ( VALUES (1, 10), (2, 9), (3, 9), (4, 8), (5, 7), (6, 6), (7, 3), (8, 10), (9, 5), (10, 9)),categorized AS ( SELECT CASE WHEN rating >= 9 THEN 'promoter' WHEN rating >= 7 THEN 'passive' ELSE 'detractor' END AS category FROM feedback)SELECT ROUND(100.0 * (COUNT(*) FILTER (WHERE category = 'promoter') - COUNT(*) FILTER (WHERE category = 'detractor')) / COUNT(*)) AS npsFROM categorized;┌────────┐│ nps ││ double │├────────┤│ 20.0 │└────────┘Пять промоутеров и три критика из десяти дают 50% − 30% = 20. Затем документацию всего проекта собирают одной командой:
dbt docs generateКоманда строит HTML-документацию проекта, которую можно разместить на сервере для всех сотрудников.
Отладка и оптимизация моделей
Заголовок раздела «Отладка и оптимизация моделей»Первый совет по скорости — внимательно разбирать сами запросы. Помогает планировщик запросов базы, например PostgreSQL: он показывает, где запрос тратит больше всего времени.
Второй совет — разбивать сложный запрос на части, например на CTE. Затем каждую часть можно сделать отдельной моделью: лёгкие вычисления хранить как view, а тяжёлые — как таблицы. Способ хранения задают в блоке config. По словам авторов, правильный выбор materialization заметно ускоряет запросы, а хранение тяжёлых шагов как таблиц иногда даёт очень большой выигрыш.
Вот запрос, разбитый на шаги: соединение, фильтр и агрегат.
WITH joined AS ( -- шаг 1: соединяем таблицы SELECT f.book_id, f.publication_year, g.genre FROM fact_book_publish AS f JOIN dim_genres AS g ON g.genre_id = f.genre_id),filtered AS ( -- шаг 2: фильтруем строки SELECT * FROM joined WHERE publication_year >= 2022),aggregated AS ( -- шаг 3: считаем агрегат SELECT genre, COUNT(*) AS books FROM filtered GROUP BY genre)SELECT * FROM aggregated ORDER BY genre;┌──────────────────┬───────┐│ genre │ books ││ varchar │ int64 │├──────────────────┼───────┤│ Базы данных │ 2 ││ Программирование │ 1 │└──────────────────┴───────┘Каждый шаг делает одно дело, поэтому логику легче читать и поддерживать. По словам авторов, база может оптимизировать план для каждой CTE отдельно.
Отладка моделей, которые хранятся как таблицы, требует тщательной проверки. Нужно убедиться, что модель выглядит как ожидалось и её значения совпадают с результатом того же SQL-запроса, выполненного напрямую, без сохранения в таблицу. Для этого таблицу иногда пересобирают целиком, как будто она не инкрементальная:
dbt run --full-refresh --select monthly_revenueФлаг --full-refresh запускает модель так, словно она строится впервые. Авторы советуют в первые дни после изменения запускать параллельно полный пересчёт и incremental-версию и сравнивать результаты. Например, модель месячной выручки давно работает в production и ей доверяют. Если её поменяли, сравнение двух версий подтвердит, что цифры выручки не разошлись. Подробнее о моделях, тестах и документации в dbt — в главах 4 и 5.
Medallion architecture
Заголовок раздела «Medallion architecture»Хранилища данных хорошо служат BI, но плохо работают с неструктурированными и разнородными данными. Data lake хранят файлы любого формата, но в них нет транзакций, контроля качества и согласованности, поэтому они не оправдали ожиданий. А компаниям нужна одна система для SQL-аналитики, мониторинга в реальном времени, data science и машинного обучения, в том числе для новых задач AI.
Поэтому компании держат сразу несколько систем: data lake, хранилище и специальные базы. Данные приходится копировать между ними, а это сложно и медленно. Ответом стал lakehouse. Он сочетает сильные стороны data lake и хранилища: структуры и управление как в хранилище, но поверх дешёвого облачного хранилища и в открытых форматах — Delta Lake, Iceberg или Hudi.
Чем эти форматы лучше старых, авторы показывают по шагам:
| Формат | Плюсы | Минусы |
|---|---|---|
| CSV | Простой | Нет типов у столбцов |
| JSON | Гибкая структура | Типы непостоянны |
| Parquet, Avro, ORC | Колоночные (кроме Avro), строгие типы | Нет ACID (кроме ORC в отдельных случаях), задуманы для Hadoop в своём дата-центре |
| Delta Lake, Iceberg, Hudi | ACID, частые изменения вместе с большим потоком аналитических запросов | — |
ACID — это четыре свойства надёжных транзакций: атомарность, согласованность, изоляция и долговечность.
Ключевые возможности lakehouse:
- транзакции для одновременного чтения и записи;
- контроль схемы и
data governance; - прямое подключение BI-инструментов;
- раздельное хранение и вычисления, поэтому их масштабируют независимо;
- открытые форматы, разные типы данных и нагрузок;
- часто потоковая обработка, без отдельной системы для реального времени.
В итоге дата-инженеры, analytics engineer, аналитики и ML-инженеры работают в одной системе.
Именно в мире lakehouse и открытых форматов появилась medallion architecture. Это способ разложить данные в lakehouse по слоям так, чтобы качество данных росло от слоя к слою. Слоёв обычно три:
Bronze— первая точка для данных из внешних систем. Таблицы повторяют структуру исходных таблиц как есть и добавляют служебные столбцы: время загрузки, ID процесса. Слой отвечает за CDC (change data capture, захват изменений), хранит архив исходных данных иlineage, помогает аудиту и позволяет пересчитать данные, не читая исходную систему заново.Silver— слой, где данные изbronzeсводят и очищают: сопоставляют, объединяют, приводят к единому виду. Получается цельный взгляд на ключевые сущности и транзакции: единый справочник клиентов и магазинов, транзакции без дублей, таблицы соответствий. Этот слой служит основой для self-service аналитики, ad hoc отчётов и ML. Он может быть устроен как модель в 3NF,star schema,Data Vaultилиsnowflake schema.Gold— слой с ответами на бизнес-вопросы. Он агрегирует данные изsilverи отдаёт их BI-инструментам и ML-приложениям.
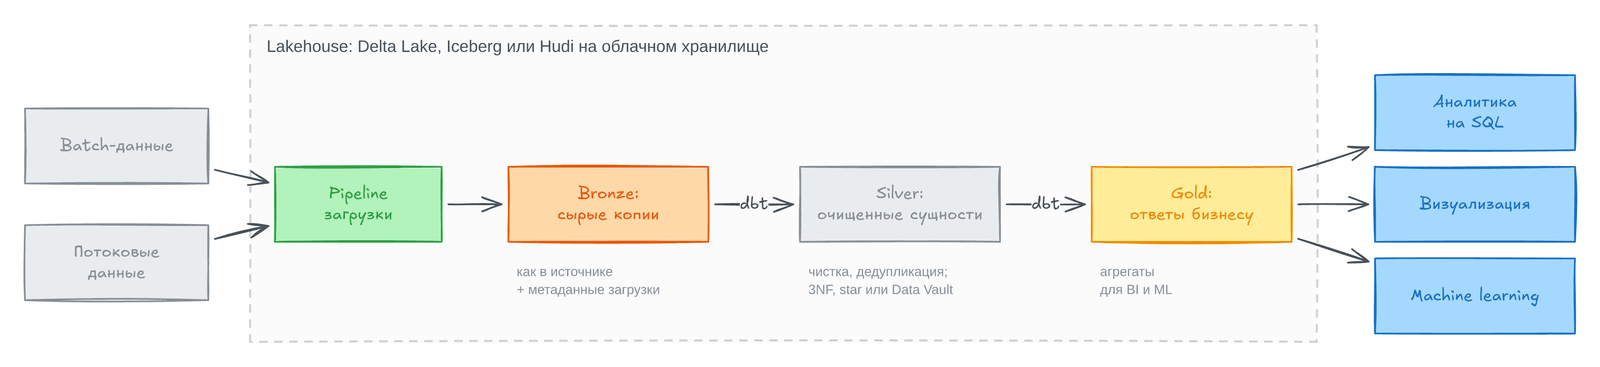
Схема показывает, где работает dbt: он отвечает за переходы между слоями. По пути от bronze к gold данные загружают, очищают, обогащают и агрегируют. Авторы считают это шагом вперёд по сравнению с хранилищем из staging и dimensional-слоя. Один data lake без хранилища проигрывает ещё сильнее: в нём работа часто сводится к раскладке файлов, а не к построению понятных слоёв данных.
При этом medallion architecture не заменяет dimensional modeling. Схемы и таблицы в каждом слое зависят от частоты и типа обновлений и от того, как данные будут использовать. Medallion architecture лишь задаёт, как разложить данные по трём слоям, чтобы модель была модульной.
Analytics engineer полезно понимать lakehouse и medallion architecture: иногда здесь проходит большая часть работы — от проектирования таблиц слоя до скриптов на dbt, которые переводят данные из слоя в слой. Но важность этих знаний зависит от платформы. Например, в Snowflake данные часто грузят в собственные таблицы, а не в Iceberg, и тогда знание lakehouse — приятный плюс, а не обязательное требование.
Итоги главы
Заголовок раздела «Итоги главы»- Модель данных строят в три этапа: концептуальный (ERD с сущностями и связями), логический (таблицы и ключи) и физический (DDL под конкретную СУБД).
- Нормализация до 3NF убирает дублирование и подходит для OLTP-систем, где важны быстрые мелкие транзакции и актуальные данные.
Star schemaставит таблицу фактов в центр и окружает её денормализованными измерениями: запросы получаются простыми и быстрыми.Snowflake schemaнормализует измерения, экономит место и гибче к изменениям, но требует большеJOIN.Data Vaultделит данные наhub,linkиsatelliteи хранит всю историю изменений, поэтому выдерживает частую смену исходных систем.- Монолитный SQL-скрипт трудно менять и отлаживать, а модульная модель из небольших переиспользуемых частей решает эту проблему.
- В
dbtмодели делят на слоиstaging(view),intermediate(ephemeral) иmart(таблица) и связывают черезref(). Medallion architectureраскладывает данные вlakehouseпо слоямbronze,silverиgoldи не заменяетdimensional modeling, а дополняет его.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| ERD | Диаграмма «сущность — связь»: сущности, атрибуты, связи и их кардинальность |
| Кардинальность | Сколько экземпляров одной сущности связано с экземплярами другой: 1:1, 1:N, N:N |
| Таблица связи | Отдельная таблица для связи «многие ко многим» с составным ключом из двух внешних ключей |
| Нормализация | Разбиение таблиц по шагам 1NF, 2NF, 3NF, чтобы убрать дублирование |
Таблица фактов (fact table) | Измеримые события и ключи измерений |
Таблица измерений (dimension table) | Описание контекста фактов: книга, автор, дата |
grain | Что означает одна строка таблицы фактов |
Data Vault | Модель из hub (бизнес-ключи), link (связи) и satellite (атрибуты с историей) |
staging-модель | Слой один к одному над исходной таблицей: типы, имена, простые вычисления |
intermediate-модель | Слой, который соединяет сущности и забирает сложность у витрин |
mart-модель | Итоговая модель для дашбордов и приложений, обычно таблица |
ephemeral-модель | Модель без объекта в базе, встраивается как CTE |
lakehouse | Хранилище со свойствами хранилища данных поверх облачного хранилища в открытых форматах |
medallion architecture | Слои bronze, silver, gold с растущим качеством данных |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Не тащите 3NF из OLTP-базы прямо в отчёты: аналитикам нужна
star schemaили широкие витрины. - Факты с измерениями соединяйте через
LEFT JOINи закрывайте пропуски черезCOALESCE, иначе строки фактов тихо пропадут. - В
stagingделайте только переименование, типы и простые вычисления, а всё, что нужно всегда (центы в доллары), — один раз. - Между моделями используйте только
ref(), аsource()— лишь вstaging: тогдаdbtстроит верныйDAG. - После изменения
incremental-модели несколько дней сравнивайте её с полным пересчётом через--full-refresh. - У каждой новой модели должен быть владелец, иначе модульность превратится в множество брошенных таблиц.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. Мы вручную повторим слои, которые dbt собрал бы из моделей выше.
Шаг 1. Создаём сырые таблицы
Заголовок раздела «Шаг 1. Создаём сырые таблицы»CREATE TABLE raw_authors ASSELECT * FROM (VALUES (1, 'Анна Петрова'), (2, 'Иван Смирнов'), (3, 'Мария Козлова')) AS t(author_id, author_name);
CREATE TABLE raw_books ASSELECT * FROM (VALUES (101, 'SQL с нуля', 1, 'Базы данных', 2021, 4500), (102, 'Моделирование данных', 1, 'Базы данных', 2022, 5200), (103, 'dbt на практике', 2, 'Инструменты', 2023, 3900), (104, 'Python для аналитика', 3, 'Программирование', 2022, 2990), (105, 'Хранилища данных', 2, 'Базы данных', 2024, 6100), (106, 'Черновик без автора', 4, 'Инструменты', 2025, 1500)) AS t(book_id, title, author_id, genre, publication_year, price_cents);Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»SELECT (SELECT COUNT(*) FROM raw_books) AS books, (SELECT COUNT(*) FROM raw_authors) AS authors, (SELECT COUNT(*) FROM raw_books AS b WHERE NOT EXISTS (SELECT 1 FROM raw_authors AS a WHERE a.author_id = b.author_id) ) AS books_without_author;┌───────┬─────────┬──────────────────────┐│ books │ authors │ books_without_author ││ int64 │ int64 │ int64 │├───────┼─────────┼──────────────────────┤│ 6 │ 3 │ 1 │└───────┴─────────┴──────────────────────┘У книги 106 нет автора в справочнике. Это сделано нарочно: так видно, что делает LEFT JOIN.
Задания
Заголовок раздела «Задания»- Создайте
staging-слой какview:stg_booksс ценой в долларах вместо центов иstg_authors. Покажите три самые дорогие книги.
Решение
CREATE VIEW stg_books ASSELECT book_id, title, author_id, genre, publication_year,       price_cents / 100.0 AS priceFROM raw_books;
CREATE VIEW stg_authors ASSELECT author_id, author_name FROM raw_authors;
SELECT title, price FROM stg_books ORDER BY price DESC LIMIT 3;┌──────────────────────┬────────┐│ title │ price ││ varchar │ double │├──────────────────────┼────────┤│ Хранилища данных │ 61.0 ││ Моделирование данных │ 52.0 ││ SQL с нуля │ 45.0 │└──────────────────────┴────────┘Перевод цен сделан один раз в staging: дальше все запросы берут готовый столбец price.
- Постройте
intermediate-слойint_books_with_authors(сохраните книги без автора) и витринуmart_author_booksкак таблицу: число книг и средняя цена по автору.
Решение
CREATE VIEW int_books_with_authors ASSELECT b.book_id, b.price,       COALESCE(a.author_name, 'Неизвестный автор') AS author_nameFROM stg_books AS bLEFT JOIN stg_authors AS a ON a.author_id = b.author_id;
CREATE TABLE mart_author_books ASSELECT author_name, COUNT(*) AS total_books, ROUND(AVG(price), 2) AS avg_priceFROM int_books_with_authorsGROUP BY author_name;
SELECT * FROM mart_author_books ORDER BY total_books DESC, author_name;┌───────────────────┬─────────────┬───────────┐│ author_name │ total_books │ avg_price ││ varchar │ int64 │ double │├───────────────────┼─────────────┼───────────┤│ Анна Петрова │ 2 │ 48.5 ││ Иван Смирнов │ 2 │ 50.0 ││ Мария Козлова │ 1 │ 29.9 ││ Неизвестный автор │ 1 │ 15.0 │└───────────────────┴─────────────┴───────────┘Благодаря LEFT JOIN и COALESCE книга 106 не потерялась и попала в отдельную строку.
- Напишите проверку в стиле
singular test: в витрине должна быть ровно одна строка на автора. Запрос должен вернуть 0 строк.
Решение
SELECT author_name, COUNT(*) AS rows_per_authorFROM mart_author_booksGROUP BY author_nameHAVING COUNT(*) > 1;┌─────────────┬─────────────────┐│ author_name │ rows_per_author ││ varchar │ int64 │├─────────────┴─────────────────┤│ 0 rows │└───────────────────────────────┘Пустой результат означает, что тест прошёл: grain витрины — один автор.
Код из раздела про dbt проверен скриптом scripts/analytics-engineering-code/ch02_check_dbt.py. Он подставляет вместо ref() и source() имена таблиц и запускает модели на этих данных в DuckDB.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему таблица связи для «многие ко многим» получает составной первичный ключ, и куда попадают атрибуты самой связи?
- Почему 3NF хороша для OLTP, но неудобна для аналитики?
- Когда стоит выбрать
snowflake schemaвместоstar schema, и чем вы за это заплатите? - Зачем в
Data Vaultописательные атрибуты вынесены изhubвsatellite? - Почему в
stagingне делаютJOINи агрегаты, и когдаintermediate-модель лучше сделатьview, а неephemeral? - Чем
medallion architectureотличается отstar schema, и почему одна не заменяет другую?
Предыдущая: Что такое analytics engineering. Следующая: SQL для аналитики.