

Analytics Engineering with SQL and dbt, глава 1: Что такое analytics engineering
Главная мысль: Облачные хранилища и подход ELT изменили работу с данными. Сырые данные теперь сразу попадают в хранилище, и кто-то должен превратить их в чистые, проверенные и понятные модели. Этим занимается analytics engineer, а его главный инструмент — dbt.
О чём глава
Заголовок раздела «О чём глава»Это первая глава книги, поэтому она отвечает на базовый вопрос: что такое analytics engineering и откуда взялась эта роль. Авторы проходят путь от первых хранилищ данных до облака и dbt. По дороге они вводят понятия, на которые опираются следующие главы. Темы главы:
- история аналитики: от Inmon и Kimball до modern data stack;
- зачем аналитике базы данных и почему BI нельзя подключать прямо к рабочей базе;
- облако: выгоды и риски;
- жизненный цикл аналитики (
data analytics lifecycle); - роль и обязанности
analytics engineer; data mesh,data productи местоdbtв них;ETLиELT, хранимые процедуры, Airflow иdbt.
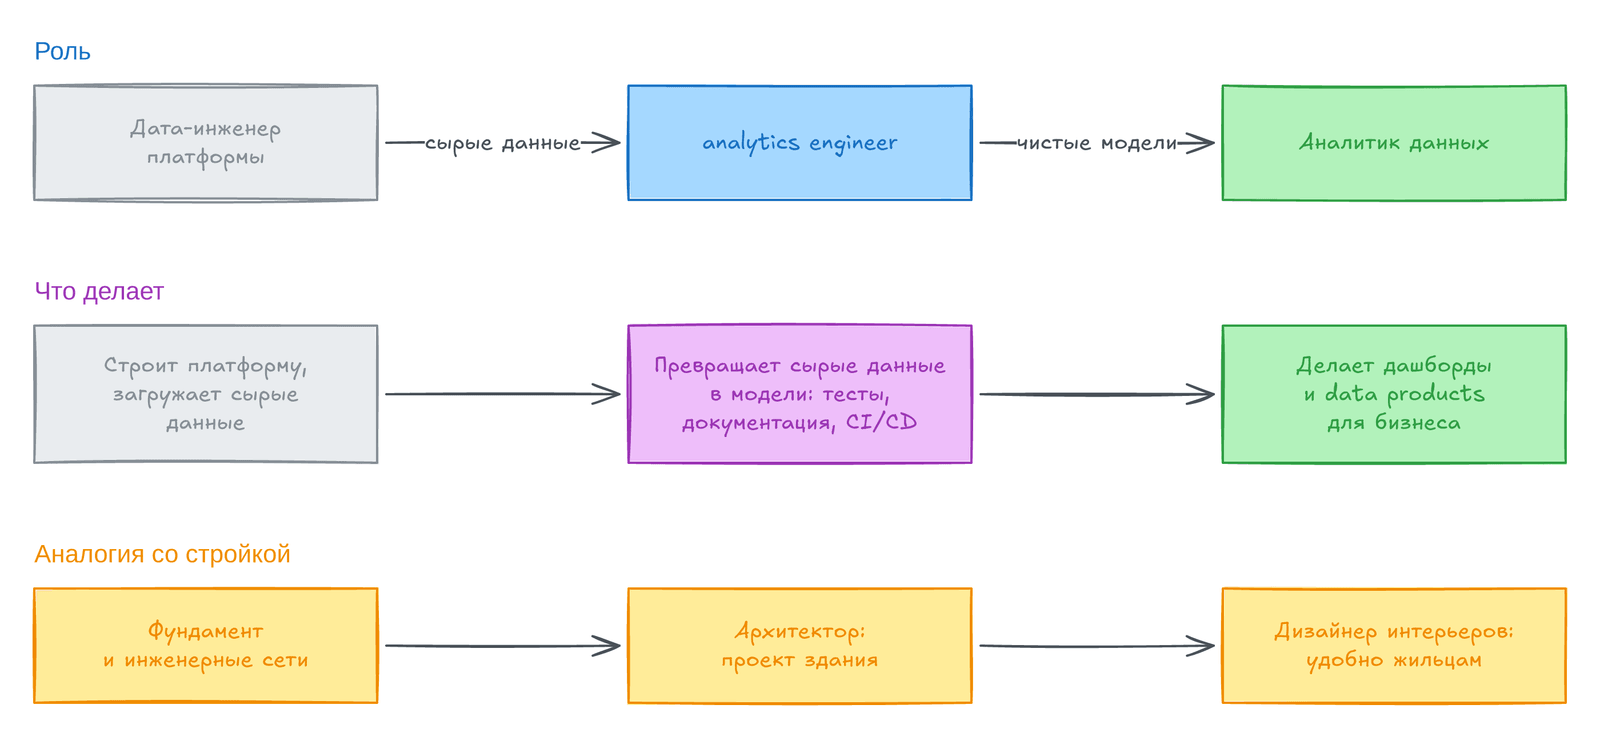
Схему читаем слева направо: данные идут от платформы через analytics engineer к аналитику. Нижний ряд — аналогия авторов со стройкой, о ней рассказано в разделе о новой роли.
Как менялась аналитика
Заголовок раздела «Как менялась аналитика»Авторы начинают с короткой истории. В 1980-х появились хранилища данных (data warehouse), и Bill Inmon дал им первую прочную теорию. В 1996 году Ralph Kimball выпустил книгу The Data Warehouse Toolkit и заложил основы dimensional modeling (наш конспект: The Data Warehouse Toolkit).
В 2000-х Google и Amazon столкнулись с огромными объёмами данных. Так появились Google File System и Apache Hadoop, а вместе с ними эпоха Big Data Engineering. Затем пришли публичные облака. В 2012 году AWS выпустил Amazon Redshift, который сочетал OLAP и привычную реляционную базу. Сначала Redshift требовал от администраторов ручной работы: очистки (vacuum) и масштабирования. Позже Redshift, Google BigQuery и Snowflake взяли эту работу на себя.
Следующий шаг — modern data stack: Airflow, dbt, Looker. Профессия «Big Data engineer» ушла, и её место заняла более широкая роль дата-инженера. Этот сдвиг описал Maxime Beauchemin, создатель Airflow и Superset, в статье «The Rise of the Data Engineer».
Сегодня дата-инженер отвечает за моделирование, качество, безопасность, архитектуру и оркестрацию и берёт практики из разработки ПО. Главные языки — Python и SQL, но встречаются Java, Scala и Go.
Компании переходят к децентрализованным командам и self-service платформам, поэтому дата-инженеры расходятся в две стороны. Одни уходят в техническую платформу, другие работают ближе к бизнесу и превращают сырые данные в ценную информацию. Из второй группы и выросло analytics engineering.
Базы данных и их влияние на analytics engineering
Заголовок раздела «Базы данных и их влияние на analytics engineering»Мир данных сегодня трудно охватить целиком. Инструментов стало слишком много. Agile и кросс-функциональные команды ускорили проекты, но работу разных команд и ролей стало труднее согласовать. А data science и BI добавили свои сложные методы. Данных стало больше, и приходят они быстрее, например от IoT-устройств. Поэтому без командной работы и постоянного обучения не обойтись.
Так было не всегда. Десятилетиями данные хранили и анализировали в электронных таблицах. Когда бизнес усложнился, пришла первая революция — базы данных. База данных — это упорядоченный набор структурированной информации в компьютере. Правила хранения задаёт схема (schema), и по ней данные легко найти и прочитать.
Для аналитики базы важны по двум причинам. Во-первых, они хранят и быстро отдают большие объёмы данных. Во-вторых, они следят за целостностью (data integrity), поэтому анализ получается точным. Авторы выделяют два главных применения:
- Хранилище данных. Это большое централизованное хранилище для удобного анализа. Данные из рабочих систем и других баз очищают и сводят в единую модель, обычно
star schemaилиData Vault. - Data mining. Статистика и машинное обучение ищут в больших наборах данных закономерности и делают прогнозы.
Базы данных помогли появиться data science: data scientists получили удобный доступ к большим наборам данных. А Tableau и Power BI легко подключаются к базам и показывают результаты наглядно.
Но здесь и прячется проблема, ради которой нужна новая роль. Часто BI-инструмент подключают прямо к рабочей базе, точнее к её реплике (OLTP — база для транзакций приложения). На маленьких данных и простых запросах это работает. Когда данных и сложных запросов становится больше, отчёты начинают тормозить.
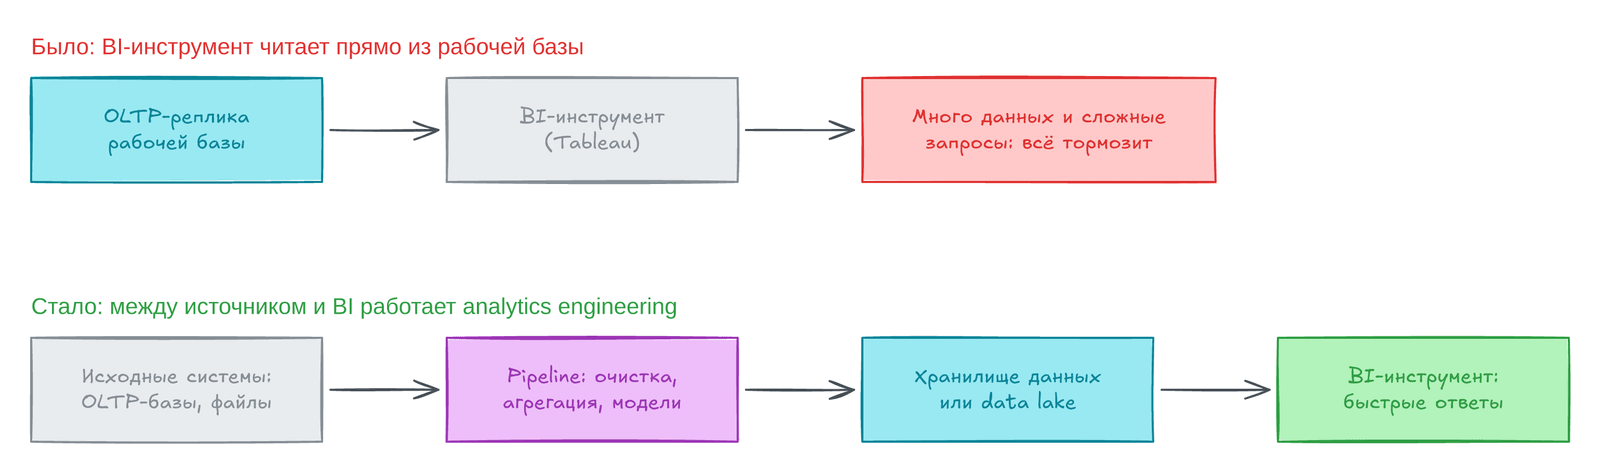
Верхний ряд схемы показывает старый путь, нижний — путь с analytics engineering. Analytics engineer строит pipeline, который забирает данные из исходных систем, очищает и агрегирует их и кладёт в хранилище данных или data lake. После этого BI работает с готовыми данными быстро. Иначе говоря, analytics engineering соединяет сырые данные и полезные выводы.
Облако и его влияние на analytics engineering
Заголовок раздела «Облако и его влияние на analytics engineering»Последние десятилетия принесли много кризисов: экономических, геополитических, медицинских, климатических. Бизнес всё равно ищет прибыль и рост, но время людей стало дороже. Поэтому компании выбирают управляемые и serverless-сервисы, которым не нужен штат администраторов баз данных.
Создание, визуализацию и анализ бизнес-данных называют аналитикой данных (data analytics), а раньше называли business intelligence (BI). Авторы разводят термины: BI — часть аналитики, нацеленная на бизнес-решения, а аналитика данных включает ещё продуктовую, операционную и другие виды.
Аналитика дорога: нужны серверы, лицензии и специалисты. В кризис решения on-premises (на своих серверах) теряют привлекательность: они требуют больших вложений, хуже масштабируются и менее гибки. Облачные решения закрывают те же задачи, но запускаются быстрее и дешевле на старте. Поэтому Microsoft, Google и Amazon делают облачные инструменты, например Microsoft Fabric.
dbt от dbt Labs авторы называют гибридным продуктом. Как и Hadoop, это open source, поэтому его можно развернуть и в облаке, и на своих серверах. Облачная версия работает с Azure, GCP и AWS.
У облака есть риски, и авторы перечисляют их:
| Риск | В чём суть |
|---|---|
| Приватность данных | Трудно проверить, что поставщик соблюдает законы |
| Потеря контроля | Данные зависят от чужой инфраструктуры |
| Неполное удаление | Удалённые данные могут остаться у поставщика |
| Внутренний доступ | Сотрудники поставщика могут увидеть данные |
| Доступность | Сбой у поставщика останавливает аналитику |
| Сложные цены | Трудно предсказать счёт |
| Зависимость от поставщика | Уйти к другому поставщику дорого |
Данные в облаке собраны в одном месте, поэтому они привлекают атаки. Тем не менее авторы считают, что переход в облако скоро станет не выбором, а необходимостью. Риски снижают стандартами безопасности, контролем затрат и стратегией данных (data strategy): планом, как компания управляет облаком, технологиями, процессами, людьми и правилами. Компания с такой стратегией получает заметное преимущество перед компаниями без неё. К тому же облачная платформа ускоряет внедрение AI, потому что все нужные данные лежат в одном месте.
Жизненный цикл аналитики
Заголовок раздела «Жизненный цикл аналитики»Жизненный цикл аналитики (data analytics lifecycle) — это шаги, которые превращают сырые данные в удобные data product: наборы данных, дашборды, отчёты, API или веб-приложения. Он нужен потому, что одни и те же данные используют разные люди с разными целями. Директору хватит нескольких ключевых метрик, а менеджеру среднего звена нужен подробный ежедневный отчёт. Значит, продукты должны строиться на общей основе по единым правилам.
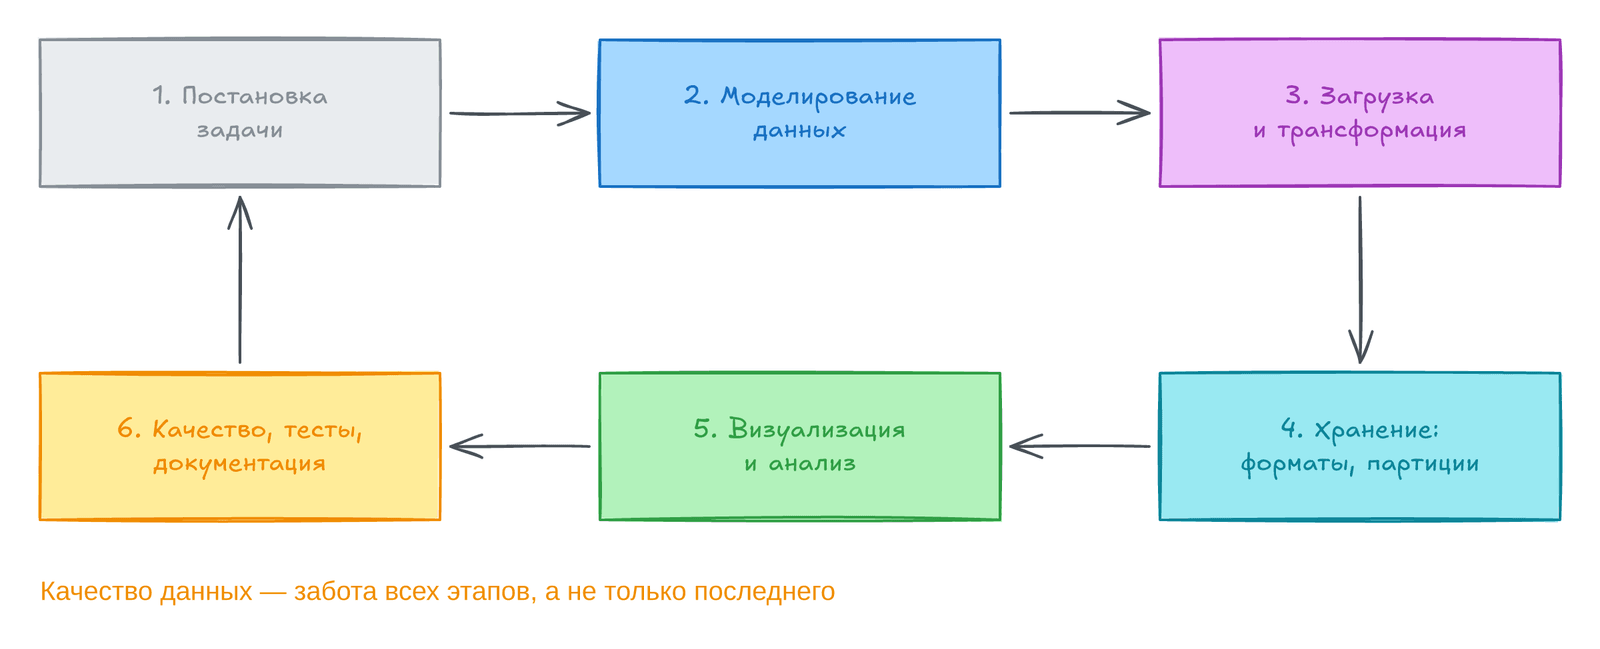
Этапы идут по кругу, и после шестого цикл начинается снова:
- Постановка задачи. Понять бизнес-цель, доступные данные и нужные ресурсы.
- Моделирование данных. Выбрать технику моделирования под задачу:
star schema,Data Vault, полностью денормализованную модель или «diamond strategy». Подробно — в главе 2. - Загрузка и трансформация. Привести данные исходных систем к моделям. При подходе schema-on-write данные сразу преобразуют в модели при записи. При подходе schema-on-read данные кладут почти как есть, а тяжёлые преобразования делают в следующих слоях платформы.
- Хранение и структура. Выбрать формат файлов (Parquet, Delta Lake, Iceberg), партиционирование и место хранения: объектное хранилище вроде S3 или хранилище данных вроде Redshift, BigQuery, Snowflake.
- Визуализация и анализ. Исследовать данные и строить дашборды для решений. Этот этап делают вместе с бизнесом.
- Качество, тесты и документация. На схеме это последний шаг, но качество — забота всего пути. Нужны проверки, тесты в
pipelineи описание всех преобразований, чтобы бизнес доверял моделям.
В dbt документация и тесты делаются параллельно с моделями, а не в конце (подробнее — в главе 4). Цикл нужен, чтобы компания решала нужную задачу на нужных данных и получала точные и надёжные результаты.
Новая роль: analytics engineer
Заголовок раздела «Новая роль: analytics engineer»Analytics engineer — новая ветвь дата-инженеров. Он строит и поддерживает модели данных и pipeline, чтобы аналитики и data scientists занимались сложным анализом.
Роль появилась из-за перехода от ETL к ELT. В старой схеме ETL данные преобразовывали до загрузки (schema-on-write). В ELT данные сначала попадают в хранилище и только потом преобразуются (schema-on-read). Так появилось место для очень технического аналитика, который знает бизнес и умеет превращать сырые данные в чистые модели. В мире ETL для этой работы нужен был человек с навыками и разработчика, и аналитика, а таких найти гораздо труднее.
Analytics engineer стоит между дата-инженерами платформы и аналитиками данных. Его задача — давать компании проверенные, свежие и описанные наборы данных, чтобы люди сами отвечали на свои вопросы. Он применяет практики разработки (контроль версий, CI/CD) и при этом умеет говорить с бизнесом.
Авторы предлагают аналогию со стройкой, которую показывает нижний ряд главной схемы:
- Дата-инженер платформы — фундамент: надёжная инфраструктура, «трубы» и «электрика».
- Analytics engineer — архитектор. Он берёт фундамент и проектирует здание под бизнес-модель: от моделей данных до дашбордов.
- Аналитик данных — дизайнер интерьеров. Он делает здание удобным для тех, кто в нём живёт, то есть для потребителей данных.
Обязанности analytics engineer
Заголовок раздела «Обязанности analytics engineer»Главных обязанностей две. Первая — проектировать модели и структуры в базах и хранилищах, которые выдерживают большие и сложные наборы данных. Вторая — строить и поддерживать pipeline в центральное хранилище.
Реже встречается работа с машинным обучением. Analytics engineer выясняет требования data scientists, помогает выбрать алгоритмы и следит, чтобы модель обучалась на правильных данных. Если он не строит модели сам, то делает pipeline со свежими обучающими и тестовыми данными. Он также готовит офлайн-оценку моделей и сочетает их метрики с бизнес-метриками в мониторинге.
Кроме того, в списке обязанностей у авторов есть такие пункты:
- проверять качество данных, отслеживать потоки и защищать данные;
- разворачивать решения в AWS, GCP или Azure и следить за затратами;
- ускорять хранилища,
pipelineи ML-модели; - писать на Python, R, SQL и Spark;
- следить за новыми технологиями и улучшать платформу.
Итак, роль требует технических навыков, умения решать задачи и понимания бизнеса. Analytics engineer должен понимать и техническую, и бизнес-сторону data science и помогать data scientists и IT понимать друг друга.
Аналитика в data mesh
Заголовок раздела «Аналитика в data mesh»Data mesh — это подход к стратегии данных, при котором доменные команды бизнеса сами владеют своими данными и сервисами доступа к ним. Они не зависят только от центральной команды данных. Монолитная архитектура данных распадается на независимые сервисы, и каждый можно разрабатывать, разворачивать и масштабировать отдельно.
Авторы видят в этом несколько плюсов. Инфраструктура масштабируется по частям, а изолированных копий данных становится меньше. Каждая команда выбирает свои инструменты, но пользуется общими центральными сервисами, поэтому двигается быстрее. Кроме того, монолит делится на сервисы данных с понятными границами, и data governance становится проще.
Analytics engineer в data mesh строит общие модели данных для многих команд: описанные, защищённые и легко находимые. Он также внедряет правила data governance и вместе с владельцами данных выполняет требования регуляторов. Главное — сменить мышление: данные больше не центральный ресурс, а набор распределённых сервисов.
Data products
Заголовок раздела «Data products»Data product — это приложение, которое даёт доступ к выводам из данных. Оно помогает принимать бизнес-решения или даже принимает их автоматически. Важно, чтобы его данные могли использовать другие приложения, внутренние и внешние. Примеры от авторов:
- REST API для запросов к бизнес-модели данных;
pipeline, который собирает и обрабатывает данные из разных систем;data lakeсо структурированными и неструктурированными данными;- инструмент визуализации, который помогает понять данные.
Data product можно собрать из микросервисов: маленьких независимых сервисов с API, которые переиспользуют по всей компании.
dbt как основа data mesh
Заголовок раздела «dbt как основа data mesh»dbt — это open source инструмент, которым команды создают, тестируют и поддерживают сервисы данных. У каждой модели появляется понятный интерфейс, и другие команды могут её использовать. Для data mesh важны такие возможности dbt:
| Возможность | Что даёт |
|---|---|
| Моделирование | Модели пишут на знакомом SQL, поэтому дата-инженеры и аналитики работают вместе |
| Тесты | Ошибки находят рано, и сервисы данных остаются надёжными |
| Документация | Другие команды понимают модели и используют их |
lineage | Видно, откуда пришли данные модели и где они используются |
data governance | Можно ввести правила доступа, lineage и проверки качества |
Авторы предупреждают, что главное в analytics engineering — модели данных, а data mesh подходит не всем. Многие успешные проекты на dbt начинают с одной star schema и приходят к data mesh позже, когда данных и потребностей становится больше.
Сердце analytics engineering
Заголовок раздела «Сердце analytics engineering»Трансформация данных — это перевод данных из одного формата или структуры в другую, чтобы ими было удобно пользоваться. Данные очищают, агрегируют или обогащают. Это ключевой шаг жизненного цикла, и dbt здесь популярен: он быстро делает сложные преобразования и работает вместе с Airflow.
Авторы называют dbt «гембой» для аналитиков. Гемба по-японски значит «настоящее место», то есть место, где создаётся ценность: ценность появляется, когда данные преобразованы и отданы в удобном виде.
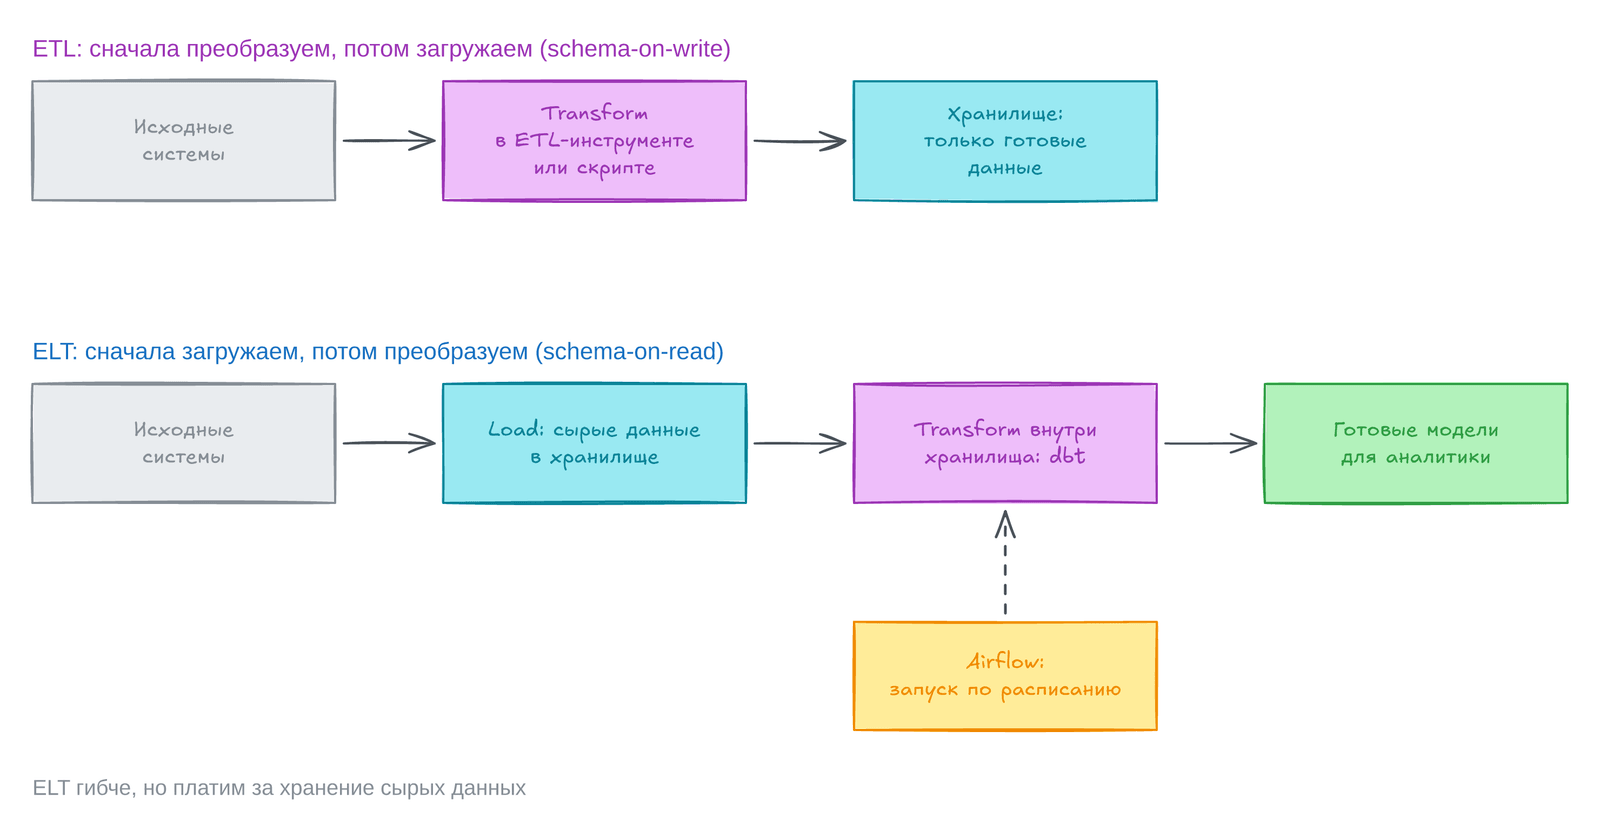
Схема сравнивает два порядка шагов. В ETL данные извлекают, преобразуют под структуру цели и только потом загружают в хранилище данных или data lake. В ELT данные сначала загружают в хранилище и преобразуют уже там. Этот подход новее и гибче: он поддерживает больше задач, вплоть до аналитики почти в реальном времени.
Минус ELT в том, что хранить и загружать сырые данные дороже. Многие компании принимают эти затраты ради гибкости, поэтому ELT стал популярен вместе с облачными хранилищами. При любом подходе без очистки и стандартизации данные будут неточными или неполными, а решения — плохими.
Старые процессы
Заголовок раздела «Старые процессы»Старые (legacy) процессы ETL были сложными и долгими. Их писали вручную, поэтому они часто ломались и плохо масштабировались. Они не успевали за новыми системами и требованиями бизнеса. С ростом объёма, разнообразия и скорости данных их вытесняет ELT.
Раньше ETL делали двумя способами: своими скриптами или визуальными ETL-инструментами. Например, SQL-скрипты вместе с Java или C# читали реляционную базу, преобразовывали данные в коде и загружали в хранилище. Другой вариант — Oracle Data Integrator или IBM InfoSphere DataStage. Оба способа трудно поддерживать, и обычно для них держат отдельную команду разработчиков.
SQL и хранимые процедуры для ETL/ELT
Заголовок раздела «SQL и хранимые процедуры для ETL/ELT»Многие платформы делали ETL на хранимых процедурах в SQL Server или Oracle. Хранимая процедура — это готовый SQL-код, который хранится в базе и запускается много раз. Смотря по направлению потока данных, её запускают в исходной или в целевой базе.
В книге процедура копирует таблицу во временную, меняет значения через UPDATE и вставляет результат в целевую таблицу. В DuckDB хранимых процедур нет, поэтому покажем те же три шага обычным SQL:
-- Источник и цельCREATE TABLE source_orders ASSELECT * FROM (VALUES    (1, ' anna ', 120.00),    (2, 'Boris',  NULL),    (3, 'vera',   210.00)) AS t(order_id, customer, amount);CREATE TABLE target_orders AS SELECT * FROM source_orders WHERE false;
-- Extract: копируем сырые строки во временную таблицуCREATE TEMP TABLE tmp_orders AS SELECT * FROM source_orders;
-- Transform: меняем данные на местеUPDATE tmp_ordersSET customer = upper(trim(customer)),    amount   = coalesce(amount, 0);
-- Load: переносим результат в целевую таблицуINSERT INTO target_orders SELECT * FROM tmp_orders;
SELECT * FROM target_orders ORDER BY order_id;┌──────────┬──────────┬──────────────┐│ order_id │ customer │ amount ││ int32 │ varchar │ decimal(5,2) │├──────────┼──────────┼──────────────┤│ 1 │ ANNA │ 120.00 ││ 2 │ BORIS │ 0.00 ││ 3 │ VERA │ 210.00 │└──────────┴──────────┴──────────────┘Это учебный пример. Настоящий процесс ещё проверяет данные, обрабатывает NULL и ошибки и пишет лог. Основы SQL разобраны в главе 3. Авторы предупреждают о минусах процедур: нужны узкие знания, решение плохо масштабируется, его трудно связать с другими системами и трудно отлаживать.
ETL-инструменты
Заголовок раздела «ETL-инструменты»ETL-инструмент — это программа, которая ускоряет создание pipeline. Она даёт визуальный интерфейс, SDK или библиотеку с готовым кодом для извлечения, преобразования и загрузки данных. Компании используют такие инструменты, чтобы автоматически переносить данные из многих систем в центральное хранилище.
Airflow — популярная open source платформа для запуска pipeline по расписанию. Её создали в Airbnb, и она ценится за гибкость и масштаб. Pipeline в Airflow описывают на Python в виде DAG. DAG (directed acyclic graph) — это граф задач со стрелками, в котором нет циклов. Наш вариант примера из книги: две задачи, запуск раз в час, вторая ждёт первую.
from datetime import datetime, timedelta
from airflow.providers.standard.operators.bash import BashOperatorfrom airflow.sdk import DAG
default_args = {    "owner": "analytics",    "depends_on_past": False,          # запуск не ждёт успеха прошлого запуска    "retries": 1,                      # одна повторная попытка при сбое    "retry_delay": timedelta(minutes=5),}
with DAG(    dag_id="hourly_demo",    start_date=datetime(2026, 1, 1),    schedule=timedelta(hours=1),       # раз в час    catchup=False,    default_args=default_args,) as dag:    print_date = BashOperator(task_id="print_date", bash_command="date")    pause = BashOperator(task_id="pause", bash_command="sleep 5", retries=3)
    print_date >> pause                # pause стартует только после успеха print_date
Проверка без сервера Airflow (ch01_check_dag.py разбирает файл через DagBag):
ошибки импорта: нетtasks: print_date >> pauseрасписание: 1:00:00retries: {'print_date': 1, 'pause': 3}Первая задача печатает дату. Вторая ждёт пять секунд, и у неё три повторные попытки вместо одной из общих настроек.
Пояснение: в книге DAG написан для Airflow 2 (
airflow.operators.bash_operator,schedule_interval). В Airflow 3 этих имён нет, поэтому код обновлён под Airflow 3.1. Файлы:scripts/analytics-engineering-code/ch01_simple_dag.pyиch01_check_dag.py.
У Airflow два ограничения, пишут авторы. Его сложно настроить и поддерживать на больших pipeline. Кроме того, он не создан для трансформации данных, и для неё нужен дополнительный код или инструменты. Эту задачу решает dbt: он даёт простой интерфейс и правила для трансформаций, а вместе с Airflow получается полное решение ETL/ELT.
Революция dbt
Заголовок раздела «Революция dbt»dbt — это open source инструмент командной строки, который упрощает трансформацию и моделирование данных. Airflow создаёт, запускает и отслеживает потоки задач. Вместе они делят работу: Airflow запускает dbt по расписанию, а dbt выполняет трансформации. Так команда управляет всем pipeline от извлечения до загрузки, а данные остаются свежими.
Пример авторов — модель, которая считает общую выручку как сумму по всем заказам. Model в dbt — это файл с SELECT-запросом и шаблонами Jinja. Наша версия считает ещё и число заказов:
{{ config(materialized='table') }}
-- общая выручка: сумма по всем заказамselect    sum(orders.revenue) as total_revenue,    count(*)            as orders_cntfrom {{ ref('orders') }} as orders
config(materialized='table') просит dbt сохранить результат как таблицу. ref('orders') ссылается на другую модель или seed: dbt сам подставит имя таблицы и запомнит зависимость. Результат dbt seed и dbt run на DuckDB (пять заказов из seeds/orders.csv, скрипт scripts/analytics-engineering-code/ch01_dbt_run.sh):
┌───────────────┬────────────┐│ total_revenue │ orders_cnt ││ double │ int64 │├───────────────┼────────────┤│ 500.0 │ 5 │└───────────────┴────────────┘Авторы называют главные плюсы dbt. Код трансформаций можно переиспользовать, поддерживать и тестировать, поэтому команде проще работать вместе и ошибок меньше. Кроме того, dbt работает с оркестраторами: Airflow, Dagster, Prefect и dbt Cloud. Оркестратор вместе с ним обновляет данные и выкатывает новую логику трансформаций так же, как CI/CD выкатывает код в разработке ПО. Подробно dbt разобран в главе 4.
Итоги главы
Заголовок раздела «Итоги главы»- Работа с данными прошла путь от электронных таблиц и хранимых процедур к облаку, Airflow и
dbt. - BI, подключённый прямо к рабочей базе, тормозит на больших данных, поэтому нужны
pipelineи хранилище данных. - Облако дешевле на старте и гибче, но несёт риски: приватность, зависимость от поставщика, сложные цены.
- Жизненный цикл аналитики состоит из шести этапов, а качество данных нужно на каждом из них.
Analytics engineerпоявился благодаряELT: сырые данные уже в хранилище, и их нужно превратить в модели.- Эта роль соединяет дата-инженеров платформы и аналитиков данных и применяет практики разработки.
- В
data meshanalytics engineerстроит общие модели как сервисы и следит заdata governance. dbtделает SQL-трансформации переиспользуемыми, тестируемыми и описанными, а Airflow запускает их по расписанию.- Инструменты меняются, но главные задачи остаются: получить данные, сохранить качество, хранить их эффективно и отдать бизнесу вовремя.
- В центре всей цепочки стоит моделирование данных, ему посвящена следующая глава.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
analytics engineering | Дисциплина между дата-инженерией и анализом: превращать сырые данные в чистые модели |
analytics engineer | Специалист, который строит, тестирует и описывает модели данных в хранилище |
Хранилище данных (data warehouse) | Централизованное хранилище, созданное для анализа |
| OLTP | Рабочая база приложения, рассчитанная на транзакции, а не на аналитику |
ETL | Извлечь, преобразовать, загрузить: трансформация до хранилища |
ELT | Извлечь, загрузить, преобразовать: трансформация внутри хранилища |
| Schema-on-write / schema-on-read | Структура задаётся при записи данных / при чтении |
Жизненный цикл аналитики (data analytics lifecycle) | Шесть этапов от постановки задачи до контроля качества |
data mesh | Подход, в котором данными владеют доменные команды |
data product | Данные или сервис, который отдаёт выводы другим людям и системам |
| DAG | Граф задач без циклов, так Airflow описывает pipeline |
model | SELECT-запрос в файле, который dbt превращает в таблицу или view |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Если отчёты в BI тормозят, проверьте, не смотрят ли они прямо в реплику рабочей базы. Вынесите расчёты в модели в хранилище.
- В
ELTсохраняйте сырые данные как есть, а очистку делайте моделями. Так любую ошибку можно исправить и пересчитать. - Пишите тесты и документацию вместе с моделью, а не «потом»: так советует жизненный цикл аналитики.
- Не начинайте с
data mesh. Одна хорошаяstar schemaнаdbtчасто даёт больше пользы. - Делите работу: Airflow (или другой оркестратор) запускает,
dbtпреобразует. - Храните модели в
Gitи проверяйте изменения черезpull requestиCI/CD.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. Мы повторим подход ELT: сырые данные уже в базе, а очистку делает одна модель-запрос.
Шаг 1. Создаём сырые заказы
Заголовок раздела «Шаг 1. Создаём сырые заказы»CREATE TABLE raw_orders ASSELECT * FROM (VALUES (101, ' anna ', 'paid', 120.00, DATE '2026-03-01'), (102, 'Boris', 'paid', 75.50, DATE '2026-03-01'), (103, 'anna', 'cancelled', 40.00, DATE '2026-03-02'), (104, 'vera ', 'paid', 210.00, DATE '2026-03-02'), (105, 'boris', 'paid', NULL, DATE '2026-03-03'), (106, 'Vera', 'paid', 54.50, DATE '2026-03-03')) AS t(order_id, customer, status, amount, ordered_at);Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»SELECT count(*) AS rows_total, count(*) FILTER (amount IS NULL) AS amount_null, count(*) FILTER (status = 'cancelled') AS cancelled, count(DISTINCT customer) AS customer_spellingsFROM raw_orders;┌────────────┬─────────────┬───────────┬────────────────────┐│ rows_total │ amount_null │ cancelled │ customer_spellings ││ int64 │ int64 │ int64 │ int64 │├────────────┼─────────────┼───────────┼────────────────────┤│ 6 │ 1 │ 1 │ 6 │└────────────┴─────────────┴───────────┴────────────────────┘Шесть строк, но шесть разных написаний имён для трёх клиентов. Одна сумма пустая, один заказ отменён.
Задания
Заголовок раздела «Задания»1. Сделайте view stg_orders: имена без пробелов и в верхнем регистре, пустая сумма равна 0, отменённые заказы убраны. Сравните с процедурой выше: что проще перезапустить?
Решение
CREATE VIEW stg_orders ASSELECT order_id,       upper(trim(customer))  AS customer,       coalesce(amount, 0)    AS amount,       ordered_atFROM raw_ordersWHERE status <> 'cancelled';
SELECT * FROM stg_orders ORDER BY order_id;┌──────────┬──────────┬───────────────┬────────────┐│ order_id │ customer │ amount │ ordered_at ││ int32 │ varchar │ decimal(12,2) │ date │├──────────┼──────────┼───────────────┼────────────┤│ 101 │ ANNA │ 120.00 │ 2026-03-01 ││ 102 │ BORIS │ 75.50 │ 2026-03-01 ││ 104 │ VERA │ 210.00 │ 2026-03-02 ││ 105 │ BORIS │ 0.00 │ 2026-03-03 ││ 106 │ VERA │ 54.50 │ 2026-03-03 │└──────────┴──────────┴───────────────┴────────────┘Один SELECT не меняет сырые данные, поэтому его можно запускать сколько угодно раз. Так работает модель в dbt.
2. Посчитайте выручку и число заказов по клиентам поверх stg_orders, как модель total_revenue выше, но с разбивкой.
Решение
SELECT customer, count(*) AS orders_cnt, sum(amount) AS revenueFROM stg_ordersGROUP BY customerORDER BY revenue DESC;┌──────────┬────────────┬───────────────┐│ customer │ orders_cnt │ revenue ││ varchar │ int64 │ decimal(38,2) │├──────────┼────────────┼───────────────┤│ VERA │ 2 │ 264.50 ││ ANNA │ 1 │ 120.00 ││ BORIS │ 2 │ 75.50 │└──────────┴────────────┴───────────────┘После очистки осталось три клиента. Модель читает другую модель, а не сырую таблицу: в dbt это была бы ссылка ref('stg_orders').
3. Напишите проверку в духе dbt: запрос должен вернуть 0 строк, если order_id в stg_orders уникален и не пуст.
Решение
SELECT order_id, count(*) AS cntFROM stg_ordersGROUP BY order_idHAVING count(*) > 1 OR order_id IS NULL;┌──────────┬───────┐│ order_id │ cnt ││ int32 │ int64 │├──────────┴───────┤│ 0 rows │└──────────────────┘Пустой результат значит, что проверка прошла. Так устроены generic test unique и not_null в dbt.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему BI-инструмент, подключённый к реплике рабочей базы, начинает тормозить при росте данных?
- Как переход от
ETLкELTсоздал рольanalytics engineer? - Почему качество данных — забота всех этапов жизненного цикла, а не только последнего?
- Когда облако выгоднее своих серверов, а когда его риски перевешивают?
- Когда компании стоит переходить к
data mesh, а когда хватит однойstar schema? - Зачем запускать
dbtиз Airflow, еслиdbtумеет сам выполнять модели?
Предыдущая: Обзор книги. Следующая: Моделирование данных для аналитики.