

Analytics Engineering with SQL and dbt, глава 5: dbt: продвинутые темы
Главная мысль: Базового dbt хватает, чтобы строить модели из view и table. Но на больших данных и в больших проектах нужны другие приёмы: incremental-модели, snapshot для истории, Jinja и macro против повторов кода, готовые пакеты и semantic layer с общими метриками. Всё это делает модели быстрее и дешевле, а код — проще в поддержке.
О чём глава
Заголовок раздела «О чём глава»В главе 4 авторы собрали первый проект dbt на данных магазина jaffle_shop. Теперь они берут тот же проект и показывают, как сделать его эффективнее. Код становится короче и следует принципу DRY (Don’t Repeat Yourself — не повторяй код). Темы главы:
- все виды
materialization:table,view,ephemeral,incremental,materialized view; snapshot— история изменений строк;- динамический SQL на Jinja;
macro— переиспользуемые функции;- пакеты, в первую очередь
dbt_utils; semantic layerи MetricFlow.
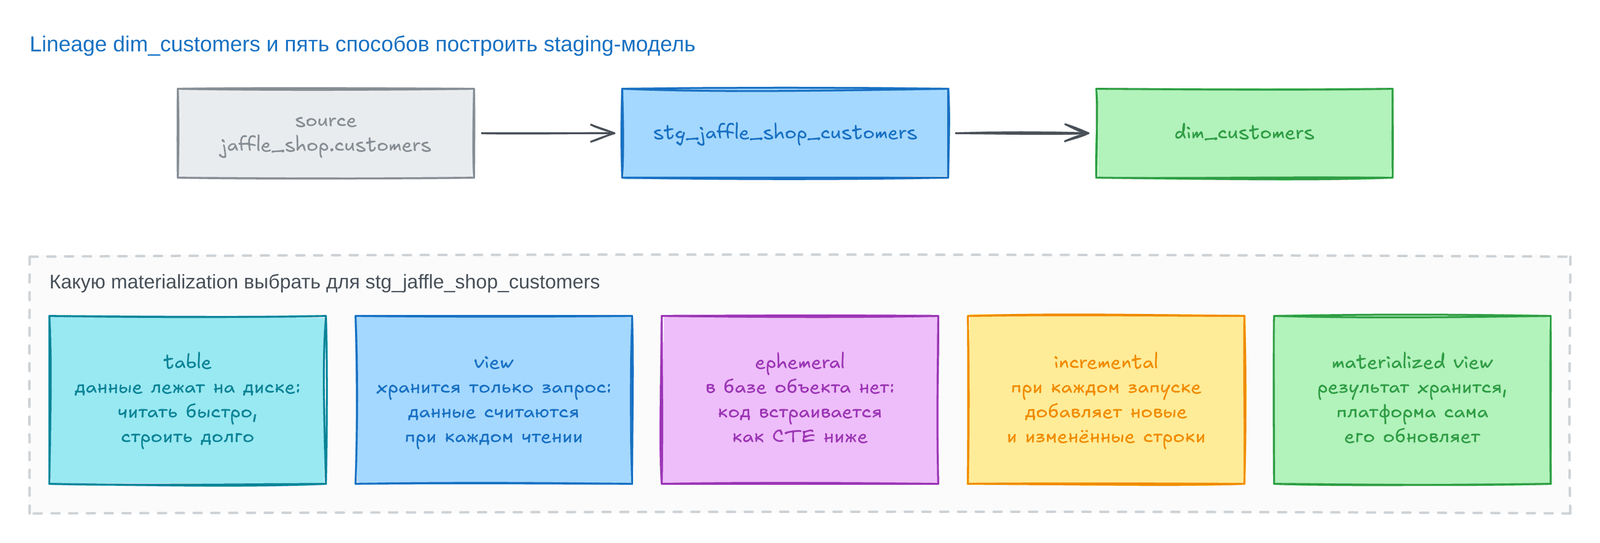
Верхний ряд схемы — это lineage модели dim_customers: исходная таблица, staging-модель и измерение. Нижний ряд показывает, во что dbt может превратить staging-модель.
Виды materialization
Заголовок раздела «Виды materialization»Materialization — это способ, которым dbt сохраняет модель в платформе данных. Правильный выбор ускоряет модели: запрос не приходится считать заново при каждом обращении. Вид выбирают под задачу. Например, incremental подходит, когда таблицу нужно только дополнять.
Рядом стоит snapshot. Он похож на materialization, но это не модель: он сохраняет состояние данных на момент запуска. Поэтому snapshot намеренно не идемпотентен, в отличие от остального dbt.
Table, view и ephemeral
Заголовок раздела «Table, view и ephemeral»Авторы проверяют три вида на одной модели, stg_jaffle_shop_customers. Для этого меняют одну строку в YAML-файле _jaffle_shop_models.yml.
| Вид | Что лежит в базе | Плюсы | Минусы | Где использовать |
|---|---|---|---|---|
table | Данные на диске | Быстрое чтение | Долгая сборка | Слой marts, большие объёмы и много запросов |
view | Только текст запроса | Сборка мгновенная, можно скрыть столбцы и строки | Данные считаются при каждом чтении, ответ медленнее | Упрощение сложных запросов, промежуточные шаги |
ephemeral | Ничего | Не засоряет базу | Нельзя запросить напрямую, трудно отлаживать | Лёгкие преобразования |
Ephemeral-модель не создаёт объект в базе. dbt вставляет её код в каждую модель ниже по lineage как CTE. Поэтому её нельзя открыть в базе и проверить отдельно. Авторы предупреждают: если таких моделей много, отладка усложняется, а модели ниже собираются дольше.
Посмотреть на это можно в скомпилированном SQL. Скомпилированный SQL — это запрос после того, как dbt подставил Jinja и ссылки ref. Так в нашем проекте выглядит настройка:
version: 2models: - name: stg_jaffle_shop_customers config: materialized: ephemeral # в базе объекта нет, модель станет CTE - name: stg_jaffle_shop_orders config: materialized: incremental incremental_strategy: merge unique_key: order_id columns: - name: order_id data_tests: [unique, not_null] - name: stg_stripe_order_payments config: materialized: viewА так dbt скомпилировал dim_customers. Код staging-модели оказался внутри, в CTE с префиксом __dbt__cte__:
with  __dbt__cte__stg_jaffle_shop_customers as (select    id as customer_id,    first_name,    last_namefrom "ch05"."raw"."customers"), customers as (    select * from __dbt__cte__stg_jaffle_shop_customers)
select customer_id, first_name, last_namefrom customers
Если бы stg_jaffle_shop_customers была view, в запросе стояло бы просто select * from "main"."stg_jaffle_shop_customers".
Incremental-модели
Заголовок раздела «Incremental-модели»Incremental-модель обрабатывает только новые и изменённые строки, а не всю исходную таблицу. Это ускоряет pipeline, особенно когда данных много и они часто обновляются.
Авторы делают incremental модель заказов stg_jaffle_shop_orders. В YAML для этого нужны три настройки:
materialized: incremental— обязательная, без неё модель не станетincremental;incremental_strategy: merge— стратегия загрузки. Есть и другие:appendиinsert_overwrite;unique_key: order_id— ключ, по которому новые строки сравниваются со старыми.
При стратегии merge строка с уже известным order_id обновляется, а строка с новым ключом добавляется. В обычном запуске бывает и то и другое сразу.
Вторая часть — сам SQL модели. Фильтр по времени загрузки обёрнут в условие Jinja:
select    id as order_id,    user_id as customer_id,    order_date,    status,    _etl_loaded_atfrom {{ source('jaffle_shop', 'orders') }}
{% if is_incremental() %}-- при повторном запуске берём только новые и изменённые строкиwhere _etl_loaded_at >= (select max(_etl_loaded_at) from {{ this }}){% endif %}
is_incremental() — встроенный macro. Он возвращает true, только если выполнены три условия: модель настроена как incremental, таблица уже есть в базе и запуск идёт без флага --full-refresh. Тогда в запрос попадает where. Он оставляет строки, у которых _etl_loaded_at не меньше максимального значения в текущей таблице. {{ this }} — ссылка на саму модель.
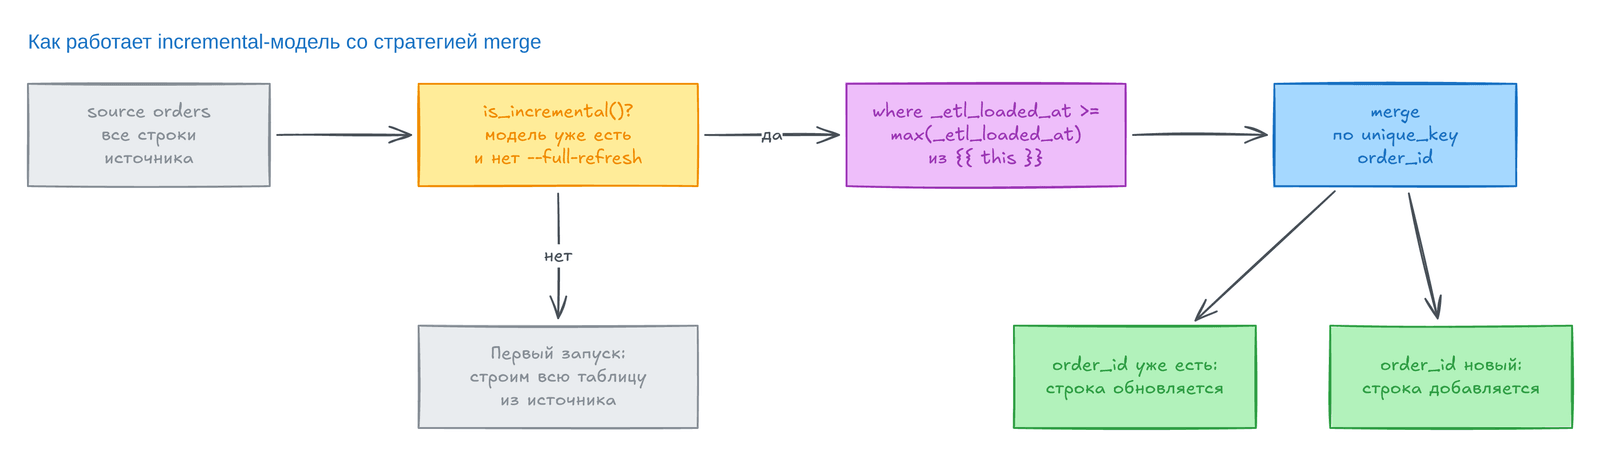
Первый запуск строит таблицу целиком, а каждый следующий сливает свежие строки с таблицей по order_id.
Мы запустили модель дважды. Между запусками заказ 3 сменил статус с placed на shipped, и появился заказ 5:
order_id customer_id order_date status _etl_loaded_at1 1 2024-02-27 completed 2024-03-01 08:00:002 2 2024-02-28 completed 2024-03-01 08:00:003 1 2024-02-29 shipped 2024-03-02 08:00:004 3 2024-03-01 placed 2024-03-01 08:00:005 2 2024-03-02 placed 2024-03-02 08:00:00Строка заказа 3 обновилась, строка заказа 5 добавилась, остальные остались как были. Авторы называют два главных плюса такого подхода. Первый — деньги: платформа не делает лишнюю работу, поэтому тратит меньше ресурсов. Второй — свежесть: модель держит данные в актуальном состоянии и при потоковых, и при периодических обновлениях.
Materialized views
Заголовок раздела «Materialized views»Materialized view — объект базы, который хранит результат запроса как настоящую таблицу. В отличие от обычной таблицы, платформа сама периодически обновляет его по изменениям в исходных данных. Пересобирать его вручную не нужно, поэтому он хорош там, где важна низкая задержка.
Авторы видят в materialized view преемника incremental-моделей. На некоторых платформах можно заменить ими все incremental-модели. Тогда не нужно описывать стратегию загрузки: обновлением занимается платформа. Но у этого есть цена: вы теряете тонкий контроль над логикой обновления и над тем, когда оно запускается.
В Postgres, Redshift, Databricks и BigQuery (с dbt 1.7) достаточно указать в YAML materialized: materialized_view. В Snowflake похожий объект называется dynamic table, и настройка будет materialized: dynamic_table.
models: - name: stg_jaffle_shop_customers config: materialized: materialized_view # в Snowflake: dynamic_tableПояснение: DuckDB не поддерживает
materialized view, поэтому этот блок мы не запускали. Поддержкаmaterialized viewзависит от адаптера вашей платформы.
Snapshots
Заголовок раздела «Snapshots»Snapshot — копия данных на определённый момент. Он нужен, когда исходная таблица меняется на месте, а анализу нужны прошлые состояния. Ещё он помогает при отладке: видно, что изменилось.
В dbt snapshot реализует SCD2 над изменяемой исходной таблицей. SCD2 (slowly changing dimension type 2) — это способ хранить каждую версию строки отдельно, с периодом, когда она была верной. Пример авторов: в заказах есть только текущий статус. А чтобы измерять время на каждом этапе и искать узкие места, нужны все статусы, через которые прошёл заказ.
Snapshot — это select внутри блока {% snapshot %} в файле из папки snapshots:
{% snapshot orders_status_snapshot %}{{ config( target_schema='snapshots', unique_key='id', strategy='timestamp', updated_at='_etl_loaded_at', )}}select * from {{ source('jaffle_shop', 'orders') }}{% endsnapshot %}Что значат настройки:
| Настройка | Смысл |
|---|---|
target_schema | Схема для таблицы snapshot. Её можно держать отдельно от рабочих данных и бэкапить. Вместе с target_database можно выбрать и другую базу |
unique_key | Первичный ключ строки. Он должен быть уникальным |
strategy | timestamp или check. Авторы советуют timestamp: он не ломается, когда в таблице появляются новые столбцы |
updated_at | Для timestamp: столбец с временем изменения строки |
check_cols | Для check: список столбцов, которые dbt сравнивает со старыми значениями. Эту стратегию берут, когда времени изменения нет или ему нельзя верить |
Запускает snapshot команда dbt snapshot (или dbt build). dbt создаёт схему snapshots и добавляет к данным четыре служебных столбца:
| Столбец | Что хранит |
|---|---|
dbt_scd_id | Уникальный ключ каждой версии строки, нужен самому dbt |
dbt_updated_at | Значение updated_at строки на момент записи версии |
dbt_valid_from | С какого момента версия действует. По нему версии сортируют |
dbt_valid_to | Когда версия перестала действовать. У текущей версии здесь NULL |
Вот наш snapshot после двух запусков. У заказа 3 теперь две версии, и видно, когда статус сменился:
id status dbt_valid_from dbt_valid_to1 completed 2024-03-01 08:00:00 NULL2 completed 2024-03-01 08:00:00 NULL3 placed 2024-03-01 08:00:00 2024-03-02 08:00:003 shipped 2024-03-02 08:00:00 NULL4 placed 2024-03-01 08:00:00 NULL5 placed 2024-03-02 08:00:00 NULLБольше деталей, например как обрабатывать строки, удалённые в исходной системе (hard deletes), есть в документации dbt Developer Hub.
Динамический SQL на Jinja
Заголовок раздела «Динамический SQL на Jinja»Jinja — шаблонизатор для Python. Обычно на нём собирают HTML-страницы, а в dbt он делает SQL динамическим. Главная возможность — подставлять в шаблон переменные и выражения, а не прописывать значения жёстко.
Первый пример авторов — разное поведение в разных средах. В разработке незачем читать всю историю, поэтому в запрос добавляют условие: если target.name не prod, берём только последние три месяца. target — это профиль подключения, с которым запущен dbt. Позже мы вынесем это условие в macro.
Второй пример — циклы. В главе 4 модель int_payment_type_amount_per_order считала сумму по каждому типу оплаты вручную, отдельным столбцом. С Jinja список типов задают один раз, а столбцы генерирует цикл for:
{%- set payment_types = ['cash', 'credit'] -%}Чтобы добавить новый тип оплаты, достаточно дописать его в список. После компиляции код почти не отличается от написанного вручную. Конструкции Jinja в этом примере:
| Синтаксис | Для чего | Пример |
|---|---|---|
{% ... %} | Инструкции: переменные, условия, циклы | {% set ... %}, {% for ... %}, {% if ... %} |
{{ ... }} | Выражение, результат которого попадает в SQL | {{ payment_type }}_amount даёт cash_amount |
{# ... #} | Комментарий, в SQL не попадает | {# новый тип добавить сюда #} |
{%- ... -%} | Дефис убирает пробелы и переносы с этой стороны | {%- endfor %} |
Авторы советуют изучить Jinja глубже по официальной документации о дизайне шаблонов.
SQL macro
Заголовок раздела «SQL macro»Macro — переиспользуемый кусок кода на Jinja. Он хранится в отдельном файле в папке macros, поэтому его можно вызывать из любой модели и любого файла проекта. Macro принимает аргументы и меняет поведение под них. Его можно вызвать вручную, автоматически или в ответ на действия пользователя.
Первый macro авторов складывает два числа. Он показывает синтаксис, а не пользу:
{% macro sum_two_values(x, y) -%}select {{ x + y }}{%- endmacro %}Вызов {{ sum_two_values(13, 89) }} после компиляции даёт:
select 102Вместо чисел можно передать переменные из {% set %}, и результат будет тот же.
Список типов оплаты в одном месте
Заголовок раздела «Список типов оплаты в одном месте»Теперь практический пример. Список типов оплаты не стоит объявлять в каждой модели. Авторы выносят его в macro get_payment_types(), который через return отдаёт список ["cash", "credit"]. В модели остаётся строка {%- set payment_types = get_payment_types() -%}.
Авторы отмечают в этом примере две вещи. Во-первых, обычно macro принимает аргументы: таблицу, настройки, флаги. Пример без аргументов нетипичен. Во-вторых, функция return возвращает список. Без неё macro вернул бы строку.
Но список всё ещё пишут вручную. Авторы улучшают macro в два шага: сначала берут значения из самих данных, затем делают код модульным. Первый шаг выглядит так:
- Внутри
macroобъявляют запросselect distinct payment_type .... - Выполняют его функцией
run_queryи сохраняют ответ в переменную. - Проверяют флаг
execute. Он истинен, когдаdbtдействительно выполняет SQL, а не только разбирает проект. Тогда берут первый столбец ответа, иначе возвращают пустой список. - Возвращают список в модель.
Второй шаг: запрос выносят в общий macro get_column_values(column_name, table_name). Он вернёт уникальные значения любого столбца любой таблицы. get_payment_types() и get_payment_methods() становятся вызовами в одну строку. Файл авторы переименовывают в get_distinct_by_column.sql, чтобы имя говорило о назначении.
{# Общий макрос: уникальные значения столбца column_name в таблице table_name #}{% macro get_column_values(column_name, table_name) %}    {% set relation_query %}        select distinct {{ column_name }} from {{ table_name }} order by 1    {% endset %}    {% set results = run_query(relation_query) %}    {% if execute %}        {% set results_list = results.columns[0].values() %}    {% else %}        {% set results_list = [] %}    {% endif %}    {{ return(results_list) }}{% endmacro %}
{% macro get_payment_types() %}    {{ return(get_column_values('payment_type', ref('stg_stripe_order_payments'))) }}{% endmacro %}
{% macro get_payment_methods() %}    {{ return(get_column_values('payment_method', ref('stg_stripe_order_payments'))) }}{% endmacro %}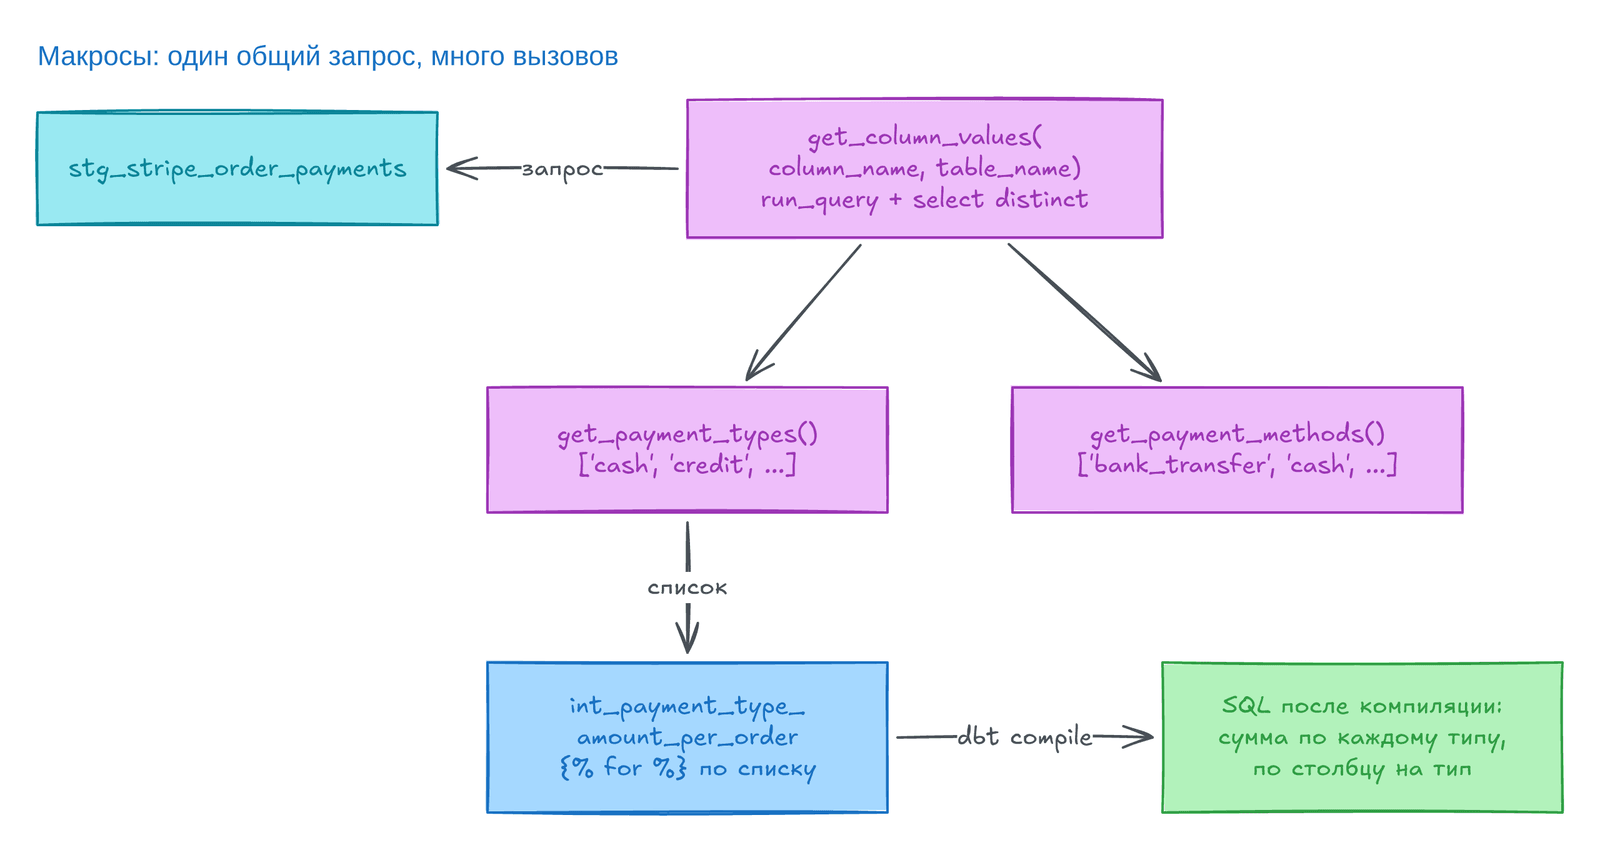
Модель вызывает get_payment_types(), а цикл строит по столбцу на каждый тип:
{# Список типов оплаты берём из данных: новый тип станет новым столбцом сам #}{%- set payment_types = get_payment_types() -%}
with payments as (    select * from {{ ref('stg_stripe_order_payments') }})
select    order_id,    {%- for payment_type in payment_types %}    sum(case when payment_type = '{{ payment_type }}' and status = 'success'             then amount else 0 end) as {{ payment_type }}_amount,    {%- endfor %}    sum(case when status = 'success' then amount end) as total_amountfrom paymentsgroup by order_id
Мы проверили, что это работает. Во втором прогоне в данных появился новый тип оплаты gift_card, и dbt сам добавил столбец, хотя код модели не менялся:
select order_id, sum(case when payment_type = 'cash' and status = 'success' then amount else 0 end) as cash_amount, sum(case when payment_type = 'credit' and status = 'success' then amount else 0 end) as credit_amount, sum(case when payment_type = 'gift_card' and status = 'success' then amount else 0 end) as gift_card_amount, sum(case when status = 'success' then amount end) as total_amountfrom paymentsgroup by order_idФильтр для среды разработки
Заголовок раздела «Фильтр для среды разработки»Ещё один полезный macro ограничивает данные вне рабочей среды. Это то же условие на target.name, но теперь его можно вызвать из любой модели и передать столбец и число месяцев:
{# Вне среды deploy берём только последние nbr_months_of_data месяцев #}{% macro limit_dataset_if_not_deploy_env(column_name, nbr_months_of_data) %}{% if target.name != 'deploy' %}where {{ column_name }} > current_date - interval {{ nbr_months_of_data }} month{% endif %}{% endmacro %}Вызов {{ limit_dataset_if_not_deploy_env('ord.order_date', 3) }} ставят в конце fct_orders, после left join. В среде dev скомпилированный запрос заканчивается фильтром:
from orders as ordleft join payment_type_orders as pto on ord.order_id = pto.order_id
where ord.order_date > current_date - interval 3 month
В среде deploy фильтра нет, и модель читает все данные:
from orders as ordleft join payment_type_orders as pto on ord.order_id = pto.order_idТак разработчик меньше нагружает платформу, а данных всё равно хватает для проверок. Если трёх месяцев мало, можно взять 12, 24 или 36.
Наконец, авторы напоминают, что можно переопределять встроенные macro самого dbt. Самый известный пример — generate_schema_name: он решает, в какую схему попадёт модель. Если переписать его, имена схем будут следовать соглашениям вашей компании.
Пакеты dbt
Заголовок раздела «Пакеты dbt»Пакет (package) — это готовый код, который можно подключить к проекту: модели, тесты, macro и другие ресурсы. Пакеты перечисляют в файле packages.yml, а dbt ставит их в папку dbt_packages. Авторы видят в пакетах четыре пользы: связанный код лежит вместе, его пишут один раз и используют везде, детали реализации скрыты от остального проекта, а работой можно делиться с сообществом.
Ставят пакеты из трёх мест: публичный dbt Hub, Git или локальная папка.
Установка пакетов
Заголовок раздела «Установка пакетов»Установка проходит в четыре шага:
- Создать
packages.yml, если его ещё нет. - Добавить в него пакет. Перед этим нужно проверить требования пакета: версию
dbt, другие пакеты, системные зависимости. - Выполнить
dbt deps. Команда ставит пакет и его зависимости. - Проверить, что всё работает, например командой
dbt test.
Самый популярный пакет — dbt_utils. На dbt Hub для каждого пакета есть готовый фрагмент для packages.yml. Авторы ставят версию 1.1.1, мы — более новую 1.3.0:
packages: - package: dbt-labs/dbt_utils version: 1.3.0Если dbt deps сообщает о несовместимости, смените версию пакета или возьмите похожий пакет.
Что внутри dbt_utils
Заголовок раздела «Что внутри dbt_utils»dbt_utils делает и поддерживает dbt Labs, создатели dbt. В нём собраны функции для частых задач (списки столбцов, даты, обработка NULL), средства отладки и тестирования, а также macro для преобразований и проверок. Пакет постоянно получает новые функции.
Пакеты внутри macro и моделей
Заголовок раздела «Пакеты внутри macro и моделей»Macro из пакета вызывают с именем пакета в начале: {{ dbt_utils.date_spine(...) }}. Первый пример — date_spine. Он генерирует ряд дат без пропусков, от начальной даты и не включая конечную. Такой ряд нужен, например, для измерения dim_date. Мы построили на нём модель календаря, которая понадобится semantic layer ниже:
{{ config(materialized='table') }}
{{ dbt_utils.date_spine(    datepart="day",    start_date="cast('2024-02-01' as date)",    end_date="cast('2024-04-01' as date)") }}
days first_day last_day60 2024-02-01 2024-03-31Второй пример — safe_divide. Нужно посчитать долю оплаты наличными в заказе, но у некоторых заказов total_amount равен 0, и деление упадёт с ошибкой. Если знаменатель равен 0 или NULL, safe_divide вернёт NULL вместо ошибки:
select order_id, cash_amount, total_amount, {{ dbt_utils.safe_divide('cash_amount', 'total_amount') }} as cash_sharefrom {{ ref('fct_orders') }}order_id cash_amount total_amount cash_share1 10.00 25.00 0.42 0.00 20.00 0.03 0.00 30.00 0.04 0.00 0.00 NULL5 0.00 25.00 0.0У заказа 4 сумма равна нулю, и вместо ошибки получился NULL. Авторы советуют ещё два пакета: dbt_expectations для описания и проверки ожиданий к данным и dbt_date для расчётов с датами.
dbt semantic layer
Заголовок раздела «dbt semantic layer»Semantic layer — это слой между сырыми данными и выводами из них. Он переводит сложные структуры базы на язык, понятный всем: от аналитиков до руководителей. Ещё слой отвечает за целостность и надёжность данных, поэтому им можно верить.
Чем semantic layer в dbt отличается от других? Во многих инструментах связи задают явно: какой ключ слева, какой справа. В dbt вместо этого вводят entities. По ним semantic layer сам находит связи между моделями, то есть рёбра графа данных. Например, в таблице клиентов customer_id — первичный ключ, а в таблице заказов customer_id объявлен как внешний entity. Из этого получается связь. Узлов в графе обычно меньше, чем рёбер, поэтому описывать узлы проще, чем каждую связь. Код получается в духе DRY, метрики и dimensions можно сочетать свободнее, а SQL выходит чище.
Основа слоя — две вещи: semantic model и метрики. Semantic model описывает модель через три элемента:
| Элемент | Что это | Пример |
|---|---|---|
entity | Объект бизнеса с ID. ID служит ключом для связи с другими semantic model | order_id, customer |
dimension | Атрибут, по которому режут данные при анализе | order_date, is_order_completed |
measure | Числовое поле с агрегацией. Даёт одинаковый расчёт во всех отчётах | total_amount (sum), customers_with_orders (count_distinct) |
Метрики (metrics) строят поверх measures. Они и есть то, чем бизнес измеряет результат.
Пример авторов основан на fct_orders. Нужны общая сумма оплат, суммы наличными и в кредит, число заказов и число клиентов с заказами. Разрезы — по дню заказа и по признаку завершённости:
version: 2
semantic_models:  - name: orders    description: Таблица фактов заказов, одна строка на заказ.    model: ref('fct_orders')    defaults:      agg_time_dimension: order_date    entities:      - name: order_id        type: primary      - name: customer        type: foreign        expr: customer_id    dimensions:      - name: order_date        type: time        type_params:          time_granularity: day      - name: is_order_completed        type: categorical    measures:      - name: total_amount        agg: sum      - name: order_count        expr: 1        agg: sum      - name: cash_amount        agg: sum      - name: credit_amount        agg: sum      - name: customers_with_orders        agg: count_distinct        expr: customer_id
metrics:  - name: order_total    label: Order Total    type: simple    type_params:      measure: total_amount  - name: order_count    label: Orders    type: simple    type_params:      measure: order_count  - name: completed_orders    label: Completed Orders    type: simple    type_params:      measure: order_count    filter: |      {{ Dimension('order_id__is_order_completed') }} = 1
Пояснение: в книге нет блока
defaultsи модели календаря. Без них нашdbtверсии 1.12 не принимаетsemantic model: каждойmeasureнужен столбец времени, а MetricFlow нуженtime spine. Фильтр у нас= 1, потому чтоis_order_completedхранит 1 и 0.
Сам YAML ничего не считает. Нужен семантический движок, который читает определения и строит по ним запросы. В dbt это MetricFlow. Авторы сравнивают MetricFlow с движком документации dbt. YAML-описание модели само по себе тоже ничего не делает, а движок документации превращает его в сайт документации и тесты.
Авторы определяют три метрики: order_total (сумма заказов), order_count (число заказов) и completed_orders. Третья использует ту же measure, что и order_count, но с фильтром по dimension завершённости. Запрос mf query --metrics order_total --explain показывает SQL, который построил MetricFlow:
SELECT SUM(total_amount) AS order_totalFROM "ch05"."main"."fct_orders" orders_src_10000А без --explain MetricFlow сразу считает метрики:
order_total order_count completed_orders------------- ------------- ------------------ 100 5 2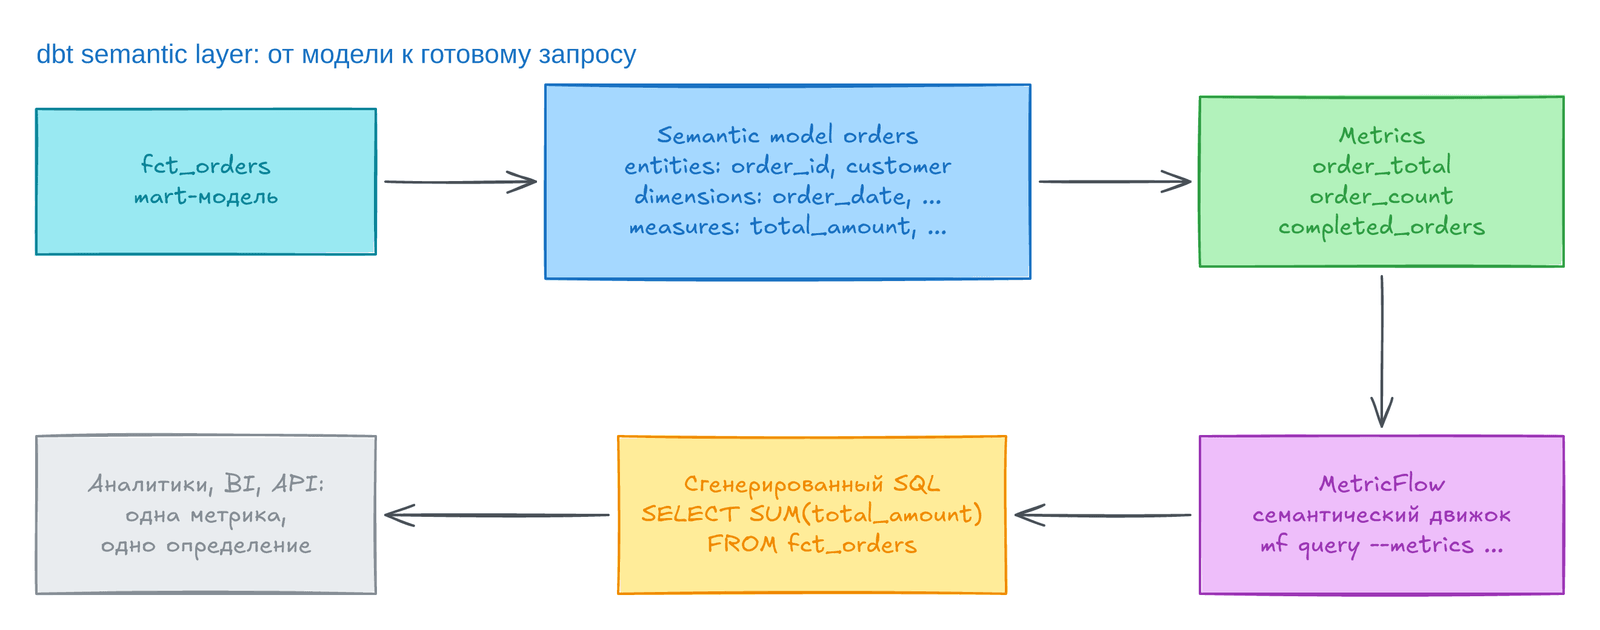
Авторы отмечают, что mf query удобен для обучения. Для всей компании лучше подходят API, которые даёт dbt. Инструкции по установке меняются, поэтому их стоит брать на странице «Set Up the dbt Semantic Layer». Главное в итоге: метрика order_total определена в одном месте. Если таблица заказов изменится, исправить нужно только это определение, а все отчёты покажут одинаковую сумму.
Итоги главы
Заголовок раздела «Итоги главы»Materializationвыбирают под задачу:tableдля быстрого чтения,viewдля простых шагов,ephemeralдля лёгкой логики, которая встраивается какCTE.Incremental-модель обрабатывает только новые строки. Её строят из трёх частей:materialized: incremental, стратегии загрузки сunique_keyи фильтра внутриis_incremental().Materialized viewпередаёт обновление платформе: работы меньше, но и контроля над логикой меньше.Snapshotхранит историю строк по схемеSCD2со столбцамиdbt_valid_fromиdbt_valid_to. Стратегияtimestampпредпочтительнееcheck.- Jinja добавляет в SQL переменные, условия и циклы, поэтому столбцы можно генерировать из списка.
Macroвыносит повторяющийся код в одно место. Сrun_queryон берёт значения прямо из данных, и новый тип оплаты становится столбцом без правки кода.- Пакеты вроде
dbt_utilsдают готовые решения:date_spineдля календаря,safe_divideдля деления без ошибок. Semantic layerопределяет метрики один раз черезentities,dimensionsиmeasures, а MetricFlow строит по ним SQL.- Авторы называют темы за пределами главы: blue/green, canary и shadow деплой, паттерн Write-Audit-Publish (WAP), связи
dbtс другими инструментами и проекты из нескольких частей.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
materialization | Способ, которым dbt сохраняет модель: table, view, ephemeral, incremental, materialized view |
incremental-модель | Модель, которая при каждом запуске обрабатывает только новые и изменённые строки |
materialized view | Сохранённый результат запроса, который платформа обновляет сама. В Snowflake — dynamic table |
snapshot | Таблица истории строк по схеме SCD2 |
macro | Переиспользуемая функция на Jinja в папке macros |
пакет (package) | Готовая библиотека macro, моделей и тестов, ставится через dbt deps |
semantic layer | Слой с общими определениями метрик над моделями |
entity, dimension, measure | Ключ связи, атрибут для разреза и агрегируемое число в semantic model |
| MetricFlow | Семантический движок dbt: строит SQL для метрик |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Начинайте с
view, переводите модель вtable, когда её часто читают, и вincremental, когда полная пересборка стала долгой или дорогой. - В
incremental-модели всегда задавайтеunique_key. Без него повторно пришедшие строки задвоятся. - Фильтр
>=по времени загрузки повторно берёт строки с максимальным временем, которые уже есть в таблице. Со стратегиейmergeэто безопасно, сappendдаст дубли. - Заводите
snapshotдля изменяемых таблиц с самого начала: историю, которую не сохранили, потом не восстановить. - Не копируйте одинаковый SQL между моделями. Повтор — сигнал вынести код в
macroили взять готовый изdbt_utils. - Помните, что
run_queryвmacroвыполняет запрос при каждой компиляции. На большой таблице это заметно замедляетdbt compile.
Код главы
Заголовок раздела «Код главы»Весь код главы собран в маленький проект на dbt-duckdb: scripts/analytics-engineering-code/ch05_dbt/. Скрипт ch05_run.py создаёт данные и делает два прогона dbt build. Весь вывод выше взят из этого запуска.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. Здесь мы руками повторяем то, что dbt делает за нас: merge, SCD2 и разворот по типам оплаты.
Шаг 1. Создаём таблицы
Заголовок раздела «Шаг 1. Создаём таблицы»-- текущая incremental-модель заказовCREATE TABLE orders ASSELECT * FROM (VALUES (1, 'completed', TIMESTAMP '2024-03-01 08:00'), (2, 'completed', TIMESTAMP '2024-03-01 08:00'), (3, 'placed', TIMESTAMP '2024-03-01 08:00')) t(order_id, status, loaded_at);
-- свежая порция строк из исходной таблицыCREATE TABLE orders_batch ASSELECT * FROM (VALUES (3, 'shipped', TIMESTAMP '2024-03-02 08:00'), (4, 'placed', TIMESTAMP '2024-03-02 08:00')) t(order_id, status, loaded_at);
-- все состояния заказов, которые мы видели при загрузкахCREATE TABLE order_history ASSELECT * FROM (VALUES (3, 'placed', TIMESTAMP '2024-03-01 08:00'), (3, 'shipped', TIMESTAMP '2024-03-02 08:00'), (3, 'completed', TIMESTAMP '2024-03-04 08:00'), (4, 'placed', TIMESTAMP '2024-03-02 08:00')) t(order_id, status, loaded_at);
-- оплаты заказовCREATE TABLE payments ASSELECT * FROM (VALUES (1, 'cash', 'success', 10.0), (1, 'credit', 'success', 15.0), (2, 'credit', 'fail', 20.0), (2, 'credit', 'success', 20.0), (3, 'cash', 'success', 0.0)) t(order_id, payment_type, status, amount);Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»SELECT 'orders' AS t, count(*) AS n FROM ordersUNION ALL SELECT 'orders_batch', count(*) FROM orders_batchUNION ALL SELECT 'order_history', count(*) FROM order_historyUNION ALL SELECT 'payments', count(*) FROM payments;┌───────────────┬───┐│ t │ n │├───────────────┼───┤│ orders │ 3 ││ orders_batch │ 2 ││ order_history │ 4 ││ payments │ 5 │└───────────────┴───┘Задания
Заголовок раздела «Задания»1. Сделайте то, что делает incremental_strategy: merge: влейте orders_batch в orders по order_id. Известные заказы обновите, новые добавьте.
Решение
MERGE INTO orders AS tUSING orders_batch AS sON t.order_id = s.order_idWHEN MATCHED THEN UPDATE SET status = s.status, loaded_at = s.loaded_atWHEN NOT MATCHED THEN INSERT VALUES (s.order_id, s.status, s.loaded_at);
SELECT * FROM orders ORDER BY order_id;┌──────────┬───────────┬─────────────────────┐│ order_id │ status │ loaded_at │├──────────┼───────────┼─────────────────────┤│ 1 │ completed │ 2024-03-01 08:00:00 ││ 2 │ completed │ 2024-03-01 08:00:00 ││ 3 │ shipped │ 2024-03-02 08:00:00 ││ 4 │ placed │ 2024-03-02 08:00:00 │└──────────┴───────────┴─────────────────────┘Заказ 3 обновился до shipped, заказ 4 добавился. Заказы 1 и 2 не изменились.
2. Постройте из order_history таблицу в стиле snapshot: столбцы valid_from и valid_to. У текущей версии valid_to должен быть NULL.
Решение
SELECT order_id, status, loaded_at AS valid_from, lead(loaded_at) OVER (PARTITION BY order_id ORDER BY loaded_at) AS valid_toFROM order_historyORDER BY order_id, valid_from;┌──────────┬───────────┬─────────────────────┬─────────────────────┐│ order_id │ status │ valid_from │ valid_to │├──────────┼───────────┼─────────────────────┼─────────────────────┤│ 3 │ placed │ 2024-03-01 08:00:00 │ 2024-03-02 08:00:00 ││ 3 │ shipped │ 2024-03-02 08:00:00 │ 2024-03-04 08:00:00 ││ 3 │ completed │ 2024-03-04 08:00:00 │ NULL ││ 4 │ placed │ 2024-03-02 08:00:00 │ NULL │└──────────┴───────────┴─────────────────────┴─────────────────────┘valid_to каждой версии равен valid_from следующей. У последней версии следующей нет, поэтому там NULL. Так же устроены dbt_valid_from и dbt_valid_to.
3. Напишите SQL, который генерирует цикл Jinja: по столбцу на каждый тип оплаты (только успешные платежи) и общая сумма. Добавьте долю наличных, которая не падает при сумме 0, как safe_divide.
Решение
SELECT order_id, sum(CASE WHEN payment_type = 'cash' AND status = 'success' THEN amount ELSE 0 END) AS cash_amount, sum(CASE WHEN payment_type = 'credit' AND status = 'success' THEN amount ELSE 0 END) AS credit_amount, sum(CASE WHEN status = 'success' THEN amount END) AS total_amount, round(cash_amount / nullif(total_amount, 0), 2) AS cash_shareFROM paymentsGROUP BY order_idORDER BY order_id;┌──────────┬─────────────┬───────────────┬──────────────┬────────────┐│ order_id │ cash_amount │ credit_amount │ total_amount │ cash_share │├──────────┼─────────────┼───────────────┼──────────────┼────────────┤│ 1 │ 10.0 │ 15.0 │ 25.0 │ 0.4 ││ 2 │ 0.0 │ 20.0 │ 20.0 │ 0.0 ││ 3 │ 0.0 │ 0.0 │ 0.0 │ NULL │└──────────┴─────────────┴───────────────┴──────────────┴────────────┘Неудачный платёж заказа 2 не попал в сумму. У заказа 3 сумма 0, и nullif превратил деление в NULL: так и работает safe_divide.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему
ephemeral-модели усложняют отладку и когда лучше сделать модельview? - Какие три условия должны выполниться, чтобы
is_incremental()вернулtrue? Что произойдёт при первом запуске? - Чем стратегия
mergeотличается отappend, и почему фильтр>=безопасен только сmerge? - Когда стоит заменить
incremental-модель наmaterialized view, а когда лучше этого не делать? - Почему авторы советуют стратегию
timestampдляsnapshot, и когда нужнаcheck? - Зачем
macroget_column_valuesпроверяет флагexecute?
Предыдущая: Трансформация данных в dbt. Следующая: Сквозной проект analytics engineering.