

Crafting Engineering Strategy, глава 16: Стратегия миграции сервисов
Главная мысль: четыре инженера перевели больше 1000 сервисов на новую платформу и взяли на себя большую часть работы, а не раздали её 2000 коллег. Они сделали это без поддержки руководителей: нашли острую проблему пользователей и сделали решение удобным.
О чём глава
Заголовок раздела «О чём глава»В главе 15 автор показал Wardley mapping. Теперь он разбирает полный кейс из своей практики: стратегию миграции сервисов в Uber в 2014 году. Глава состоит из трёх документов, которые переписаны по памяти.
- Документ 16–1: сама стратегия.
- Документ 16–2: модель, почему
provisioningидёт медленно. - Документ 16–3:
Wardley mapоркестрации.
Оценку этой стратегии автор даёт в главе 23.
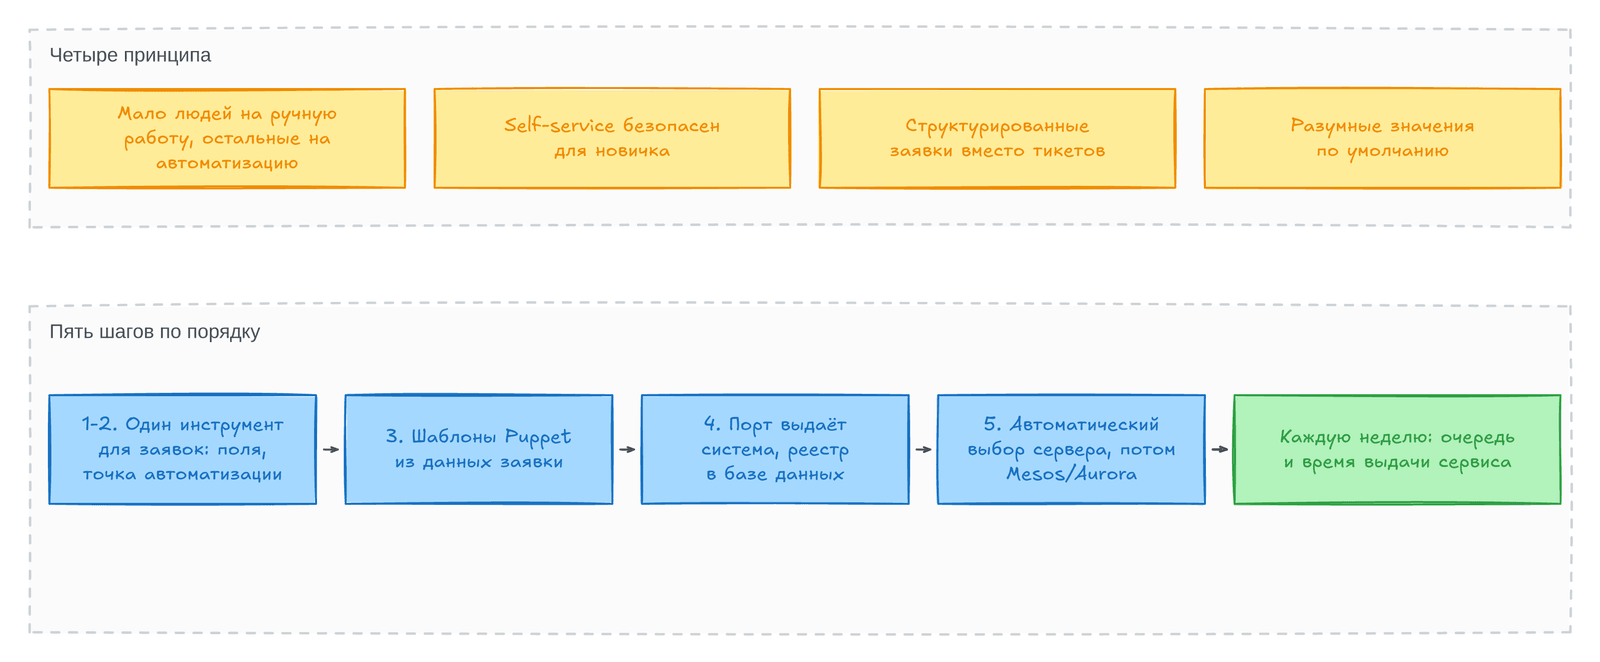
Сверху принципы, снизу пять шагов по порядку и недельная проверка, которая показывает, работает ли план.
Контекст и как читать документы
Заголовок раздела «Контекст и как читать документы»В начале 2014 года автор пришёл в Uber руководить командой Infrastructure. В ней была подкоманда provisioning сервисов, и больше четырёх человек в ней никогда не работало. Это пример стратегии снизу, без спонсора-руководителя.
Документы написаны от лица команды в 2014 году. Чтобы применить стратегию, читайте сверху вниз. Чтобы понять, как о ней думали, читайте в обратном порядке: исследование, диагноз, уточнение, политика. Эту схему автор описал в главе 11.
Документ 16–1: стратегия миграции
Заголовок раздела «Документ 16–1: стратегия миграции»Политика и план
Заголовок раздела «Политика и план»Команда приняла четыре принципа:
- Мало людей на ручную работу. На ручной
provisioningостаётся один инженер, остальные делают автоматизацию. Ручная выдача на время станет хуже. Но без автоматизации её навсегда задавит поток заявок от новых инженеров. - Self-service безопасен для новичка. Сейчас одна правка в Puppet или Clusto может сломать production. В новом решении это недопустимо.
- Структурированные заявки вместо тикетов. Неполные данные в тикетах больше всего задерживают выдачу. Форма заявки одновременно убирает ошибки и становится интерфейсом будущей автоматизации: выигрыш получается дважды.
- Значения по умолчанию вместо вопросов. Команды новых проектов спешат и не знают будущих требований. Поэтому система предлагает разумные настройки, а пересмотреть их легко при переходе из разработки в production.
Из принципов выросли пять шагов:
- Внутренний инструмент вместо тикетов в Phabricator. У него есть схема обязательных полей.
- Тот же инструмент становится точкой автоматизации шагов, и процесс заявки потом не меняется.
- Инструмент создаёт шаблоны Puppet из данных заявки. Так пропадает ручная правка, где появляются опечатки.
- Порты выдаёт система. Повтор порта ломает маршрутизацию живого сервиса, поэтому выдачу портов автоматизируют полностью первой. Реестр портов переезжает из вики в базу данных с проверками.
- Сервер для сервиса выбирает автоматика, чтобы не нагружать и без того занятые серверы. Она готовится к переходу на Mesos/Aurora.
Раз в неделю смотрят размер очереди и время выдачи сервиса. Автор пишет в сноске: без права приказывать приходится продумать все детали, и лучший способ — долго проверять стратегию (strategy testing). Стратегии снизу следуют, только пока она работает, поэтому её приходится уточнять всё время.
Уточнение (Refine)
Заголовок раздела «Уточнение (Refine)»Команда построила модель онбординга сервисов (system model). Она показала три вещи: команда отстаёт всё сильнее, найм в неё не спасает, единственный выход — self-service. Даже полное устранение ошибок и рост команды в 5 раз не помогали.
Диагноз (Diagnose)
Заголовок раздела «Диагноз (Diagnose)»- Команды хотят уйти из монолита: приходит 2–3 заявки в неделю, и поток растёт примерно линейно с числом инженеров. Монолитом никто не занимается, работа в нём — главный источник боли, и предложить инженерам что-то, кроме нового сервиса, команда не может.
- Организация удваивается каждые шесть месяцев. Через год придёт 8–12 заявок в неделю.
- В команде четыре инженера, и новых людей ей не дадут. SRE заняты, на них нельзя рассчитывать.
- Выдача сервиса занимает около недели из-за множества кругов уточнений. Работа с полными данными занимает 3–4 часа: Puppet, метаданные в Clusto, порты, серверы.
- Защиты почти нет, поэтому легко вызвать аварию. Обучать всех инструменту не получится: за полгода придёт столько же новых людей, а менеджеры product engineering не хотят тратить на это время.
- Все согласны, что почти все компоненты выдачи сервисов надо заменить как можно скорее. Но плана нет, и никто за это не отвечает. Команде придётся обходить их или менять самой.
- Разработку нового сервиса нужно разблокировать срочно, а выход в production редко спешит.
- Соседняя команда изучает Mesos и Aurora, но сроков нет.
Исследование (Explore)
Заголовок раздела «Исследование (Explore)»Серверы стоят в собственных датацентрах. Они описаны в Puppet, а метаданные хранит Clusto от Digg. Инфраструктура стареет, но замену выбрать непросто. Против облака выступали многие, включая CEO. Зато можно заменить Puppet на что-то вроде Docker, а метаданные перевести на Mesos/Aurora или Kubernetes.
Команда читала статьи о Borg и Mesos и расспрашивала бывших инженеров Twitter, которые знали Mesos/Aurora. Опытных пользователей Kubernetes на парке 10 000+ серверов найти не удалось. У Mesos/Aurora больше установок, но у неё нет крупного покровителя, кроме Twitter. У Kubernetes есть Google, но промышленных запусков почти нет. Serverless выглядит перспективным, однако реальных примеров ещё мало.
Документ 16–2: модель онбординга
Заголовок раздела «Документ 16–2: модель онбординга»Модель собрана на пакете lethain/systems. Модель — это набор запасов (stock), между которыми перетекают заявки.
Что показала модель
Заголовок раздела «Что показала модель»- Даже без ошибок очередь заявок растёт. Значит, проблема не в том, как работает команда, а в самом подходе.
- Найм не решает задачу: команда в 5 раз больше всё равно не разбирает очередь.
- Остаётся убрать ручную работу полностью, то есть self-service. Найм полезен, только если его направить на создание self-service и успеть обучить людей быстрее, чем растёт поток.
Набросок и рассуждение
Заголовок раздела «Набросок и рассуждение»В наброске заявка проходит шесть стадий: от запроса до выделенного сервера. На схеме есть ссылки (links) — они не переливают заявки, а влияют на другой запас: найм влияет на число инженеров, а они — на число заявок. Потом добавили ошибки: два вида «нет данных» и ошибку в шаблоне Puppet.
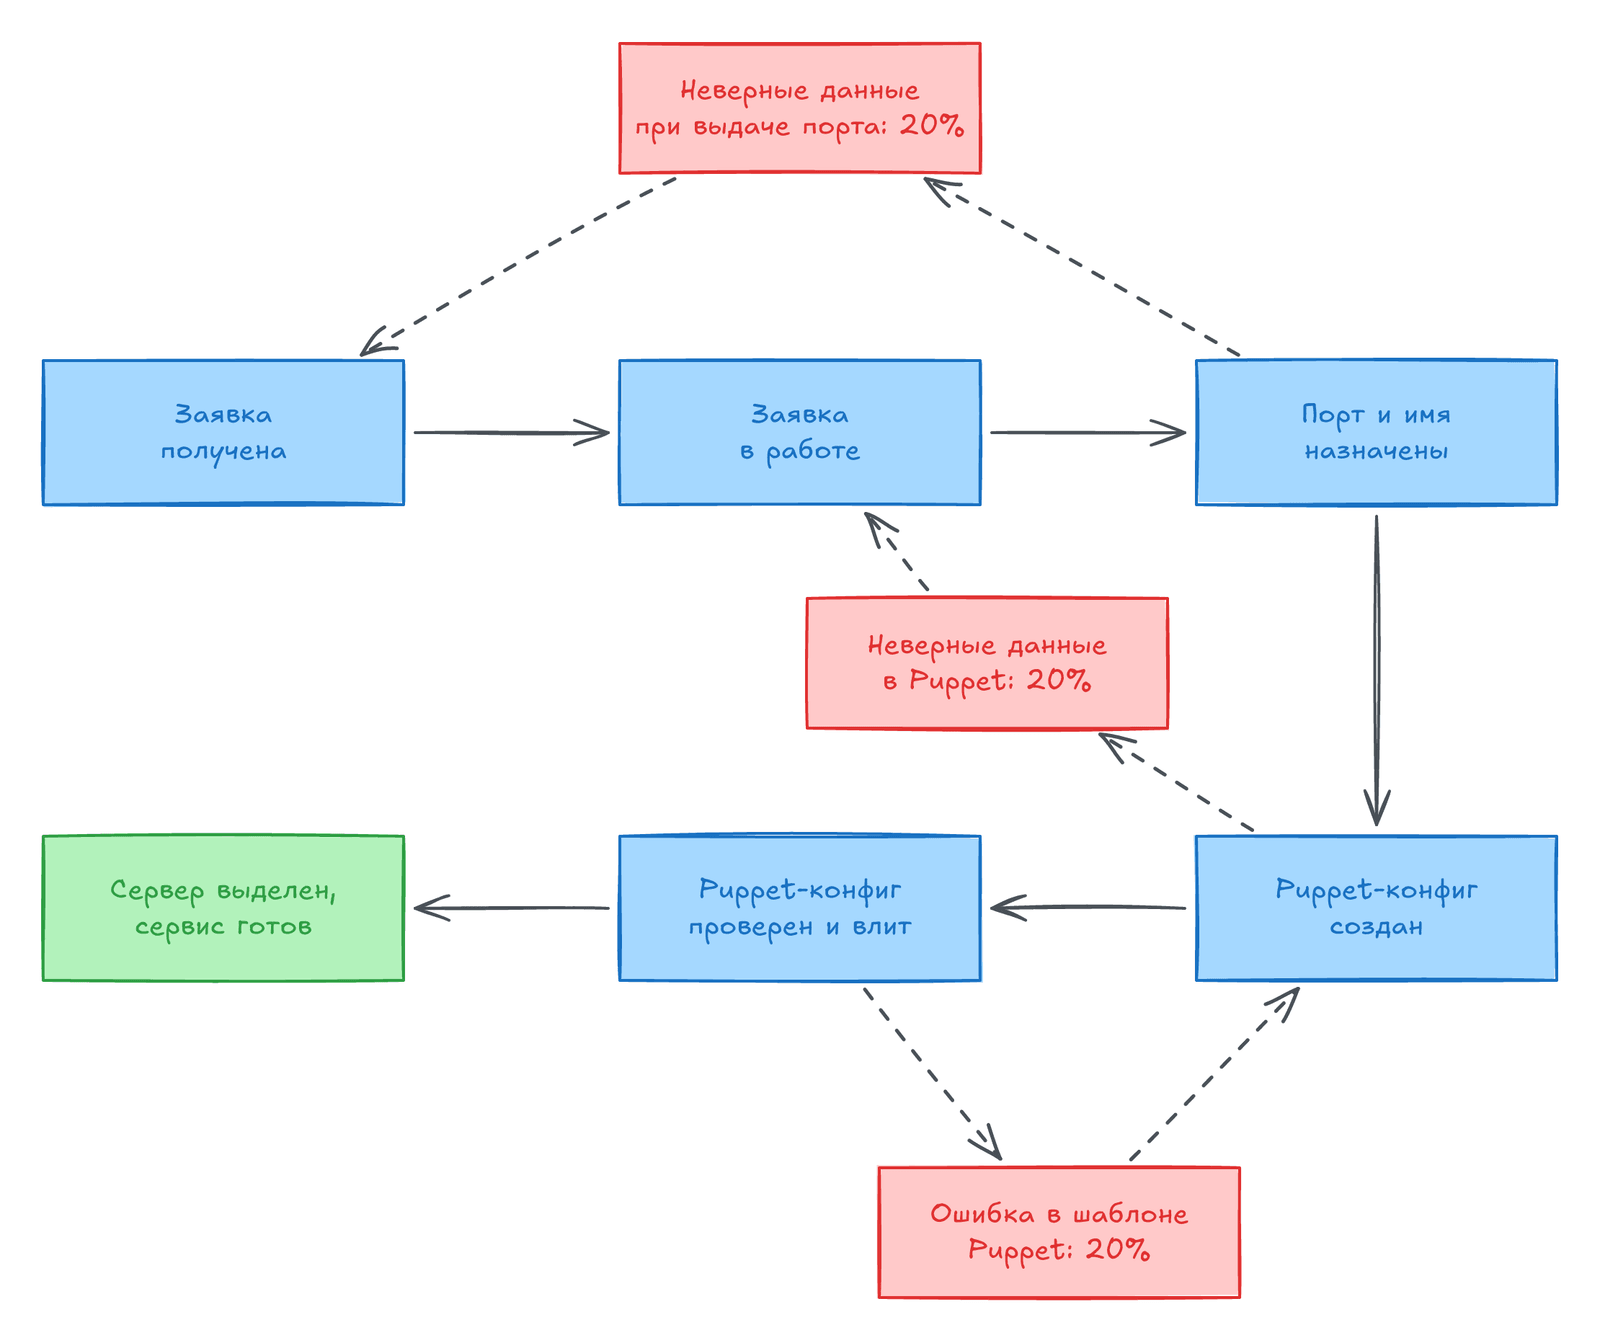
Схема показывает путь заявки и три петли возврата. Ошибки накладываются: готовая почти до конца заявка может вернуться из Puppet в начало, и прогресс теряется.
Уже по наброску видно три вещи:
- Число product-инженеров растёт, а инфраструктурных инженеров не прибавляется. Поэтому нужно либо остановить найм, либо сделать self-service, либо придумать, как отбить охоту создавать сервисы.
- Доля ошибок сильно влияет на результат, особенно «нет данных».
- Такие ошибки дороже, чем в модели, потому что их решают сразу несколько команд. Ошибки Puppet, наоборот, дешевле: их исправляет одна команда за короткий цикл.
Модель и эксперименты
Заголовок раздела «Модель и эксперименты»Сначала собрали идеальный путь: запасы соединены потоками с Leak(1.0).
Пояснение:
Leak(0.8)означает, что из запаса за раунд уходит 80% его содержимого в следующий. Остальное можно отправить по другому потоку, например назад как ошибку.
В идеальном случае очередь растёт: команда берёт в работу максимум 10 заявок за раунд. Затем добавили три ошибки по 20%, и пропускная способность заметно упала.
Вот минимальная версия модели и её результат:
from systems.parse import parse  # pip install systems==0.1.0
SPEC = """HiringRate(10)ProductEngineers(1000)[PotentialHires] > ProductEngineers @ HiringRate[PotentialServices] > RequestedServices(10) @ ProductEngineers / 10RequestedServices > InflightServices(0, 10) @ Leak(1.0)InflightServices > PortNameAssigned @ Leak(1.0)PortNameAssigned > PuppetGenerated @ Leak(0.8)PortNameAssigned > RequestedServices @ Leak(0.2)PuppetGenerated > PuppetConfigMerged @ Leak(0.8)PuppetGenerated > InflightServices @ Leak(0.2)PuppetConfigMerged > ServerCapacityAllocated @ Leak(0.8)PuppetConfigMerged > PuppetGenerated @ Leak(0.2)"""
last = parse(SPEC).run(rounds=50)[-1]print("очередь заявок:", last["RequestedServices"])print("сервисов выдано:", last["ServerCapacityAllocated"])
очередь заявок: 5831.0сервисов выдано: 357Затем в модели меняли по одному параметру. Результат автор показывает на графиках, а мы запустили сценарии сами (50 раундов, все остальные параметры как выше). Скрипт: scripts/crafting-engineering-strategy-code/ch16_onboarding_model.py.
Сценарий очередь готово1. Без ошибок, 10 заявок в раунд 5735.0 4602. Ошибки по 20% 5831.0 3573. Больше ошибок на порту: 50% 6068.0 1354. Больше ошибок в Puppet: 50% 5831.0 3505. Больше ошибок при слиянии: 50% 5831.0 3226. Команда выросла в 5 раз (50 заявок) 4338.0 16667. Self-service (без лимита) 211.0 4928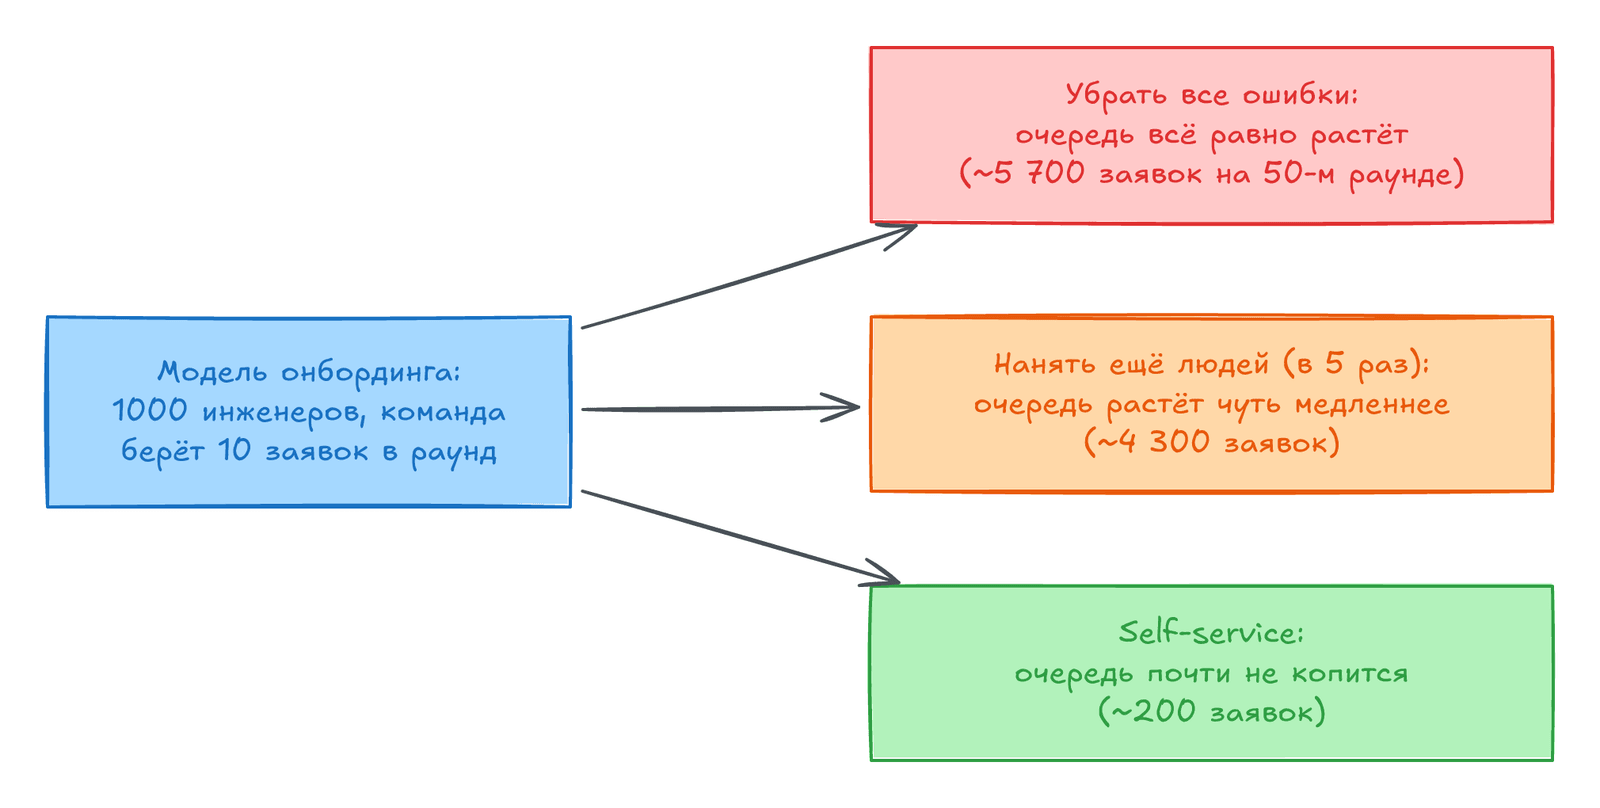
Устранение ошибок и найм почти не помогают, self-service решает задачу.
Выводы упражнений такие:
- Какая ошибка важнее. Команда ждала, что хуже всех ошибки Puppet, потому что они отбрасывают далеко назад. Оказалось, что больше всего вредит ошибка в самом начале: за ней идут другие ошибки, и они накапливаются. В нашем прогоне это видно: при 50% ошибок на порту выдано 135 сервисов, а не 357.
- Найм. Рост команды в 5 раз даёт эффект, но очередь остаётся огромной.
- Self-service. Если убрать лимит заявок в работе за раунд, очередь перестаёт расти.
Итог автора: нужно рано исправлять главные ошибки и переходить на self-service.
Документ 16–3: Wardley map оркестрации
Заголовок раздела «Документ 16–3: Wardley map оркестрации»Карта показывает, как должна измениться оркестрация (service orchestration), пока трафик Uber удваивается каждые шесть месяцев.
Сегодня участвуют три команды. Команда provisioning соединяет приложения product-инженеров с серверами, которыми занимается Server Operations. Когда добавляют серверы, приложения этого не замечают.
В цепочке три проблемы: дешёвое масштабирование, надёжный деплой и быстрый деплой. Все три упираются в планирование ресурсов и метаданные кластера. От них зависят маршрутизация запросов, раскладка сервисов по серверам, деплой и автомасштабирование.
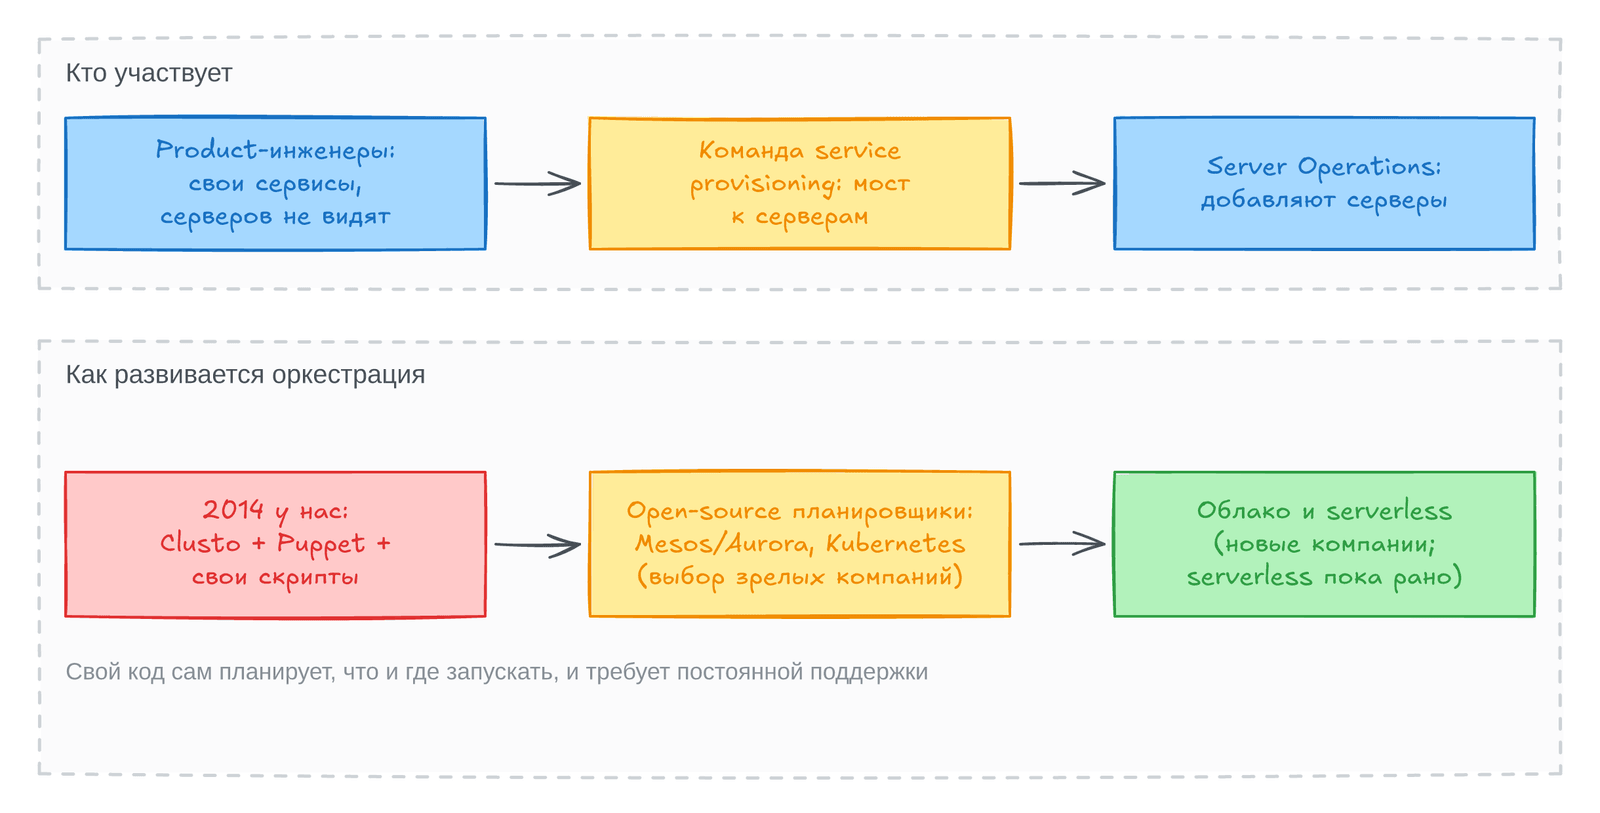
Схема показывает три команды сверху и путь развития оркестрации снизу: от своих скриптов к планировщикам и облаку.
Uber решал задачу связкой Clusto, Puppet и собственных скриптов. Это работало, но требовало постоянной поддержки. Главный вопрос: писать свои алгоритмы раскладки (bin packing) или взять готовое. Индустрия идёт двумя путями: облачные провайдеры и планировщики с открытым кодом, такие как Mesos и Kubernetes. Компании с пятилетним опытом инфраструктуры почти без исключений берут планировщики, чтобы потом мигрировать в облако. Новые компании сразу идут в облако. В стороне остаются только гиганты вроде Google и компании, которые боятся любых перемен. Вывод карты: держаться за Clusto и Puppet дорого и не по пути индустрии.
Итоги главы
Заголовок раздела «Итоги главы»- Маленькая команда может вести стратегию без руководителя, если решает острую проблему пользователей.
- Без права приказывать стратегия держится на удобстве: решение должно быть таким, чтобы им хотели пользоваться.
- План строится от диагноза: рост заявок, нехватка людей, неполные данные и опасные инструменты.
- Структурированная заявка даёт двойной выигрыш: меньше ошибок сейчас и готовый интерфейс для автоматизации.
- Автоматизировать сначала нужно самое рискованное, то есть выдачу портов.
- Модель показала, что найм и устранение ошибок не останавливают рост очереди, а self-service останавливает.
- Пробный прогон модели меняет интуицию: самой важной оказалась ранняя ошибка, а не самая дорогая на вид.
- Карта подсказала не писать свой планировщик, а идти к открытым системам и облаку.
- Стратегия сработала отлично, но оставила разработчикам очень неудобную среду. Это и привело автора к идее фаз стратегии: она хороша вначале и приносит проблемы позже.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
provisioning | Выдача инфраструктуры новому сервису: конфиг, порт, сервер |
self-service | Команды сами создают сервис без помощи платформенной команды |
| структурированная заявка | Заявка с обязательными полями вместо тикета со свободным текстом |
system model | Модель из запасов и потоков, которую можно запускать и менять |
service orchestration | Управление тем, где и как запускаются сервисы |
bin packing | Алгоритм раскладки сервисов по серверам |
| фазы стратегии | Стратегия может хорошо работать вначале и вредить потом (см. главу 23) |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Если у вас растёт поток однотипных заявок к платформенной команде, найм не поможет. Сначала проверьте, можно ли убрать ручной шаг.
- Дайте заявкам схему: обязательные поля и проверки. Это и уменьшает ошибки, и готовит автоматизацию.
- Автоматизируйте сначала то, что ломает production: выдачу портов, имён и доступов.
- Проверяйте гипотезы простой моделью, прежде чем просить людей или время. Для
pipelineданных работает та же логика: очередь на ручные шаги растёт, если вход быстрее выхода. - Ставьте разумные значения по умолчанию, чтобы новый проект запускался без вопросов, и пересматривайте их на переходе в production.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему команда оставила на ручной
provisioningтолько одного инженера, хотя из-за этого ручная выдача ухудшилась? - Чем структурированная заявка полезна дважды?
- Почему даже наём команды в 5 раз не решил проблему очереди?
- Какая ошибка в модели оказалась самой вредной и почему это не совпало с ожиданием?
- Почему в диагнозе нет «обучить всех инженеров» как решения?
- Как
Wardley mapповлияла на выбор между своим планировщиком и открытыми системами?
Предыдущая: Wardley mapping. Следующая: Стратегия внедрения LLM.