

Designing Data-Intensive Applications, глава 14: Поступать правильно: этика данных
Главная мысль: многие данные — это данные о людях. Поэтому инженер отвечает не только за то, как работает система, но и за то, как она влияет на людей. Алгоритмы могут закрепить дискриминацию, а сбор данных стал массовой слежкой, и авторы призывают собирать меньше данных и раньше их удалять.
О чём глава
Заголовок раздела «О чём глава»Это последняя глава книги. Прошлые главы, до философии потоковых систем, учили строить надёжные и масштабируемые системы. Здесь авторы делают шаг назад и спрашивают, что эти системы делают с людьми. Темы главы:
- предиктивная аналитика: предвзятость, ответственность, петли обратной связи;
- слежка (
surveillance), согласие и свобода выбора; - что такое приватность и кому она на деле принадлежит;
- данные как актив и власть, уроки промышленной революции, законы.
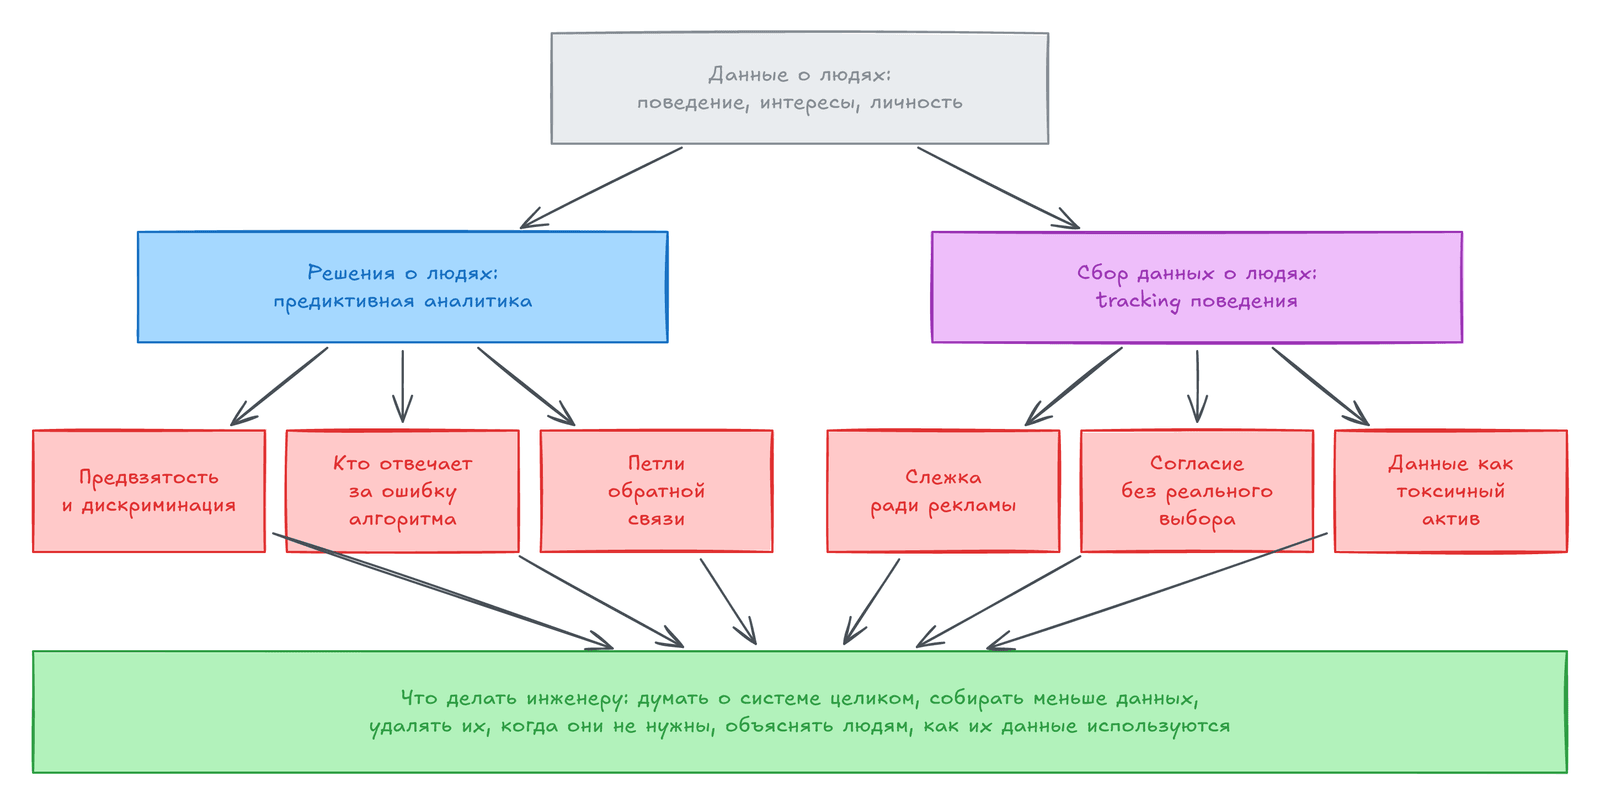
Схема показывает две ветки главы: решения о людях и сбор данных о людях. Обе ведут к выводу внизу: что может сделать инженер.
Зачем инженеру этика
Заголовок раздела «Зачем инженеру этика»У каждой системы есть цель, а у каждого действия есть последствия, задуманные и случайные. Авторы считают, что инженеры обязаны продумать эти последствия и не причинять вреда. Многие наборы данных описывают людей, их поведение и личность, поэтому с ними нужно обращаться с уважением.
Есть кодексы для инженеров, например ACM Code of Ethics, но их редко обсуждают и применяют. Из-за этого команды порой легкомысленно относятся к приватности. Технология сама по себе не хорошая и не плохая: важно, как её используют. Поэтому ответственность за последствия лежит на инженере.
В этике нет точных определений, и «хорошо» каждый толкует по-своему. Рассуждать об этике трудно, но игнорировать её нельзя. Этика — это не чек-лист, а постоянное размышление вместе с людьми, которых касается система, и ответственность за результат.
Предиктивная аналитика
Заголовок раздела «Предиктивная аналитика»Предиктивная аналитика (predictive analytics) — это прогнозы на основе данных. Прогноз погоды никому не вредит. Но прогноз, совершит ли осуждённый новое преступление или вернёт ли человек кредит, прямо меняет его жизнь.
Логика бизнеса понятна: упущенная сделка стоит дёшево, а плохой кредит или плохой сотрудник дорого, поэтому при сомнении выгоднее сказать «нет». Но человек с меткой «рискованный», верной или ошибочной, получает «нет» везде: в работе, страховке, съёме жилья, банке, даже в авиаперелётах. Такое исключение из общества назвали «алгоритмической тюрьмой». Суд исходит из презумпции невиновности, а алгоритм исключает человека без доказательств вины и почти без права обжаловать решение.
Предвзятость и дискриминация
Заголовок раздела «Предвзятость и дискриминация»Люди тоже предвзяты, и есть надежда, что решения на основе данных будут честнее. Но модель не просто исполняет правила человека: она сама выводит правила из данных. Эти правила непрозрачны: данные показывают корреляцию, но не объясняют её причину. Если в данных есть систематическая предвзятость (bias), модель, скорее всего, выучит её и усилит.
Закон запрещает различать людей по защищённым признакам: полу, возрасту, этнической принадлежности, убеждениям. Но другие признаки бывают с ними связаны. Например, в районах с расовой сегрегацией почтовый индекс и даже IP-адрес хорошо предсказывают расу. Поэтому над верой в честную модель на предвзятых данных шутят: машинное обучение — это «отмывание денег для предвзятости».
Модель лишь переносит прошлое в будущее. Если прошлое было несправедливым, она закрепит эту несправедливость. Чтобы будущее стало лучше, нужно моральное воображение, а оно есть только у людей. Данные и модели должны быть инструментами, а не хозяевами.
Пояснение: если модель скоринга получает колонку
zip_code, удаление колонкиethnicityне делает её нейтральной: индекс несёт ту же информацию.
Ответственность и подотчётность
Заголовок раздела «Ответственность и подотчётность»Человека за ошибку можно призвать к ответу, а его решение можно обжаловать. А кто отвечает за ошибку алгоритма? Кто виноват в аварии беспилотного автомобиля? Сможете ли вы объяснить судье, как ваша ML-модель отказала человеку в кредите? Авторы настаивают, что вину нельзя переложить на алгоритм.
Плохой кредитный рейтинг портит жизнь, но он хотя бы опирается на реальную историю долгов человека, а ошибку в ней можно исправить. ML-скоринг берёт намного больше данных и намного менее прозрачен. Разница видна по вопросу, на который отвечает система:
| Подход | Вопрос | Риск |
|---|---|---|
| Кредитный рейтинг | Как вы сами вели себя в прошлом? | Ошибку в записи можно исправить |
| Предиктивная аналитика | Кто похож на вас и как вели себя такие люди? | Стереотип: человек попадает не в ту группу, исправить почти нельзя |
Кроме того, прогноз статистический. Если средняя продолжительность жизни 80 лет, это не значит, что вы умрёте в 80-й день рождения. Так и модель может быть верна в среднем, но ошибаться для конкретного человека.
Слепая вера в данные опасна. Нужно не усиливать старые предубеждения, а делать алгоритмы прозрачными и исправлять их ошибки. Одна и та же аналитика может найти тех, кому нужна помощь, а может помочь хищному бизнесу продать уязвимым людям дорогие займы.
Петли обратной связи
Заголовок раздела «Петли обратной связи»Даже рекомендательные системы создают проблемы. Если сервис показывает человеку только близкие ему мнения, возникают эхо-камеры, где растут дезинформация и поляризация.
Ещё опаснее самоусиливающаяся петля обратной связи (feedback loop): прогноз меняет то, что он предсказывает. Пример: работодатели смотрят кредитный рейтинг. Хороший работник попадает в беду не по своей вине и пропускает платежи. Рейтинг падает, работу найти труднее, денег становится меньше, и рейтинг падает ещё ниже.
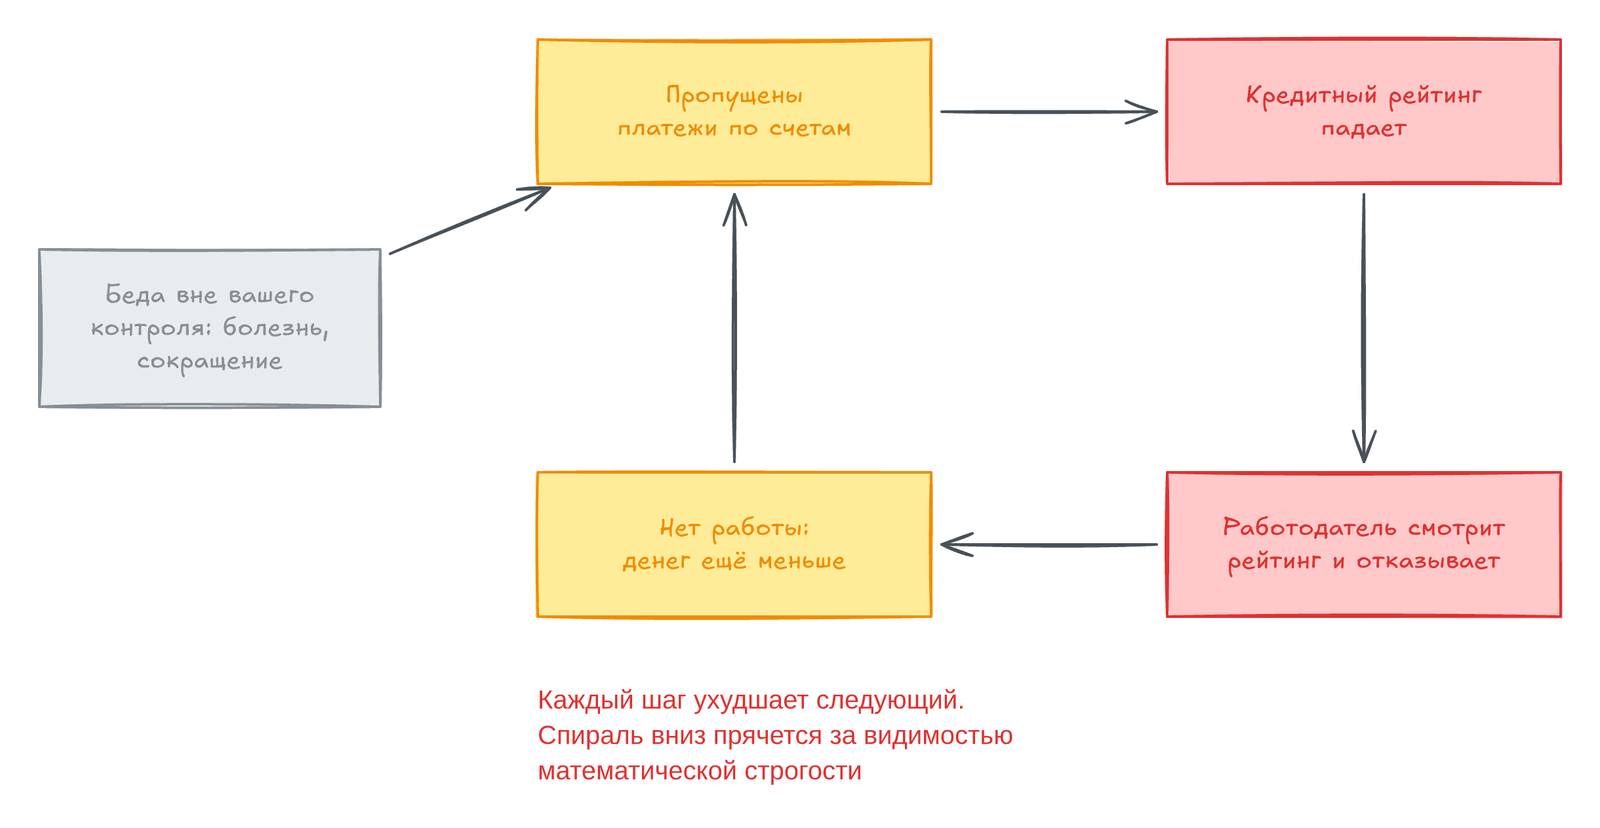
Стрелки идут по кругу: каждый шаг ухудшает следующий. Авторы называют это спиралью вниз: её запускают вредные допущения, а видимость математической строгости их прячет. Другой пример — заправки в Германии: с алгоритмическими ценами конкуренция упала, а цены выросли, потому что алгоритмы научились сговариваться.
Не каждую петлю можно предвидеть. Но многие видны, если думать о системе целиком, вместе с людьми вокруг неё. Это называют системным мышлением (systems thinking). Полезно спросить: усиливает ли система разрыв между людьми (богатые богатеют, бедные беднеют) или борется с несправедливостью?
Приватность и отслеживание
Заголовок раздела «Приватность и отслеживание»Этические проблемы есть и в самом сборе данных. Если пользователь сам ввёл данные ради своей цели, система оказывает ему услугу, и он клиент. Если же его действия записывают как побочный эффект (tracking), у сервиса появляются свои интересы, и они могут расходиться с интересами пользователя.
Часть tracking полезна пользователям: клики улучшают поиск, а A/B-тесты — интерфейс. Но при рекламной модели настоящие клиенты — рекламодатели. Данных собирают всё больше и хранят долго, чтобы построить профиль каждого человека. Для таких отношений есть более мрачное слово — слежка (surveillance).
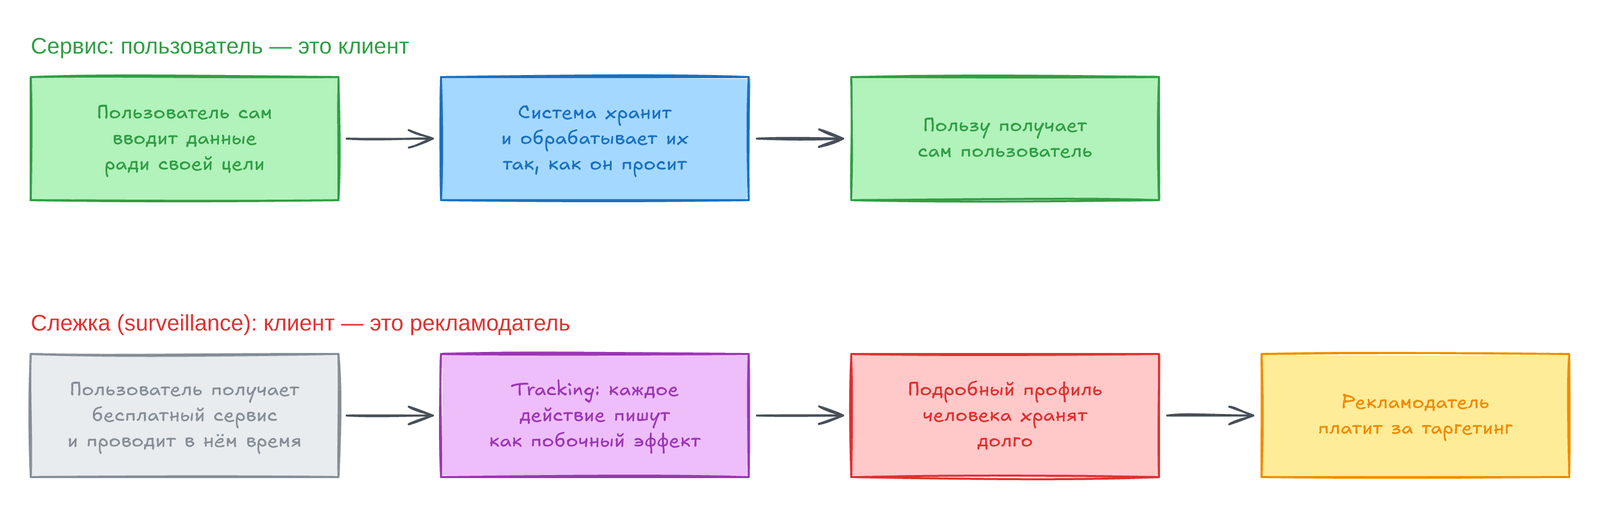
Верхняя строка — сервис, где данные работают на пользователя. Нижняя — слежка, где цепочка заканчивается рекламодателем.
Авторы предлагают заменить слово «данные» на «слежка»: «мы собираем потоки слежки и храним их в хранилище слежки». Фразы сразу звучат иначе. Авторы признают, что это резко, и в шутку называют книгу Designing Surveillance-Intensive Applications.
Мы построили крупнейшую инфраструктуру слежки в истории. Микрофон с выходом в интернет есть почти в каждом доме: смартфон, умная колонка, радионяня, детская игрушка. Сбор данных о местоположении, переписке, покупках и здоровье стал почти неизбежным. Компания может заметить болезнь человека раньше, чем он сам.
Даже самые жёсткие диктатуры прошлого могли только мечтать о трекере в кармане у каждого, а мы носим его добровольно, потому что польза огромна. Возможно, вам «нечего скрывать», но так повезло не всем. А вместе с предиктивной аналитикой слежка перестаёт быть безобидной: данные о вождении уже влияют на цену страховки, а датчик в смарт-часах позволяет угадать, какой пароль вы печатаете.
Согласие и свобода выбора
Заголовок раздела «Согласие и свобода выбора»Можно возразить, что пользователь сам принял условия и получил полезный сервис. Но у этого довода три слабых места:
- Не весь
trackingнужен пользователю. Клики в поиске улучшают продукт, а рекламные профили служат тем, кто платит за рекламу. - Люди не понимают, на что соглашаются. Политики приватности скорее запутывают. Данные одного человека говорят и о других, которые ничего не подписывали. А производные наборы данных, где данные всех пользователей объединены с записями о поведении и внешними источниками, пользователь понять не может.
- Договориться нельзя. Условия задаёт сервис, а пользователь не может выбрать, сколько данных отдать.
GDPR (General Data Protection Regulation, регламент ЕС о защите данных) требует, чтобы согласие было свободным, конкретным, информированным и однозначным. Отказ не должен вредить пользователю, а заранее поставленные галочки и молчание согласием не считаются. Есть и другие основания для обработки, например законный интерес (legitimate interest) при борьбе с мошенничеством. Но интернет-сервисы чаще всего опираются на согласие.
Отказаться от сервиса тоже трудно. Если сервис нужен для обычной социальной жизни, а у него есть сетевой эффект, пользоваться им фактически обязательно. Платформы к тому же удерживают людей приёмами азартных игр. Отказ доступен лишь тем, у кого есть время и знания, чтобы разобраться в политике приватности, и кто может позволить себе упустить общение и рабочие возможности, которые даёт сервис. Для остальных слежка неизбежна.
Приватность и использование данных
Заголовок раздела «Приватность и использование данных»Говорят, что «приватность умерла», раз люди сами выкладывают всё в соцсети. Авторы с этим не согласны. Приватность — это не тайна всего, а право решать, что раскрыть, кому и что оставить в секрете. Человек с редкой болезнью охотно отдаст данные исследователям, но не страховой компании.
Слежка не уничтожает это право, а передаёт его компании: «доверьтесь нам». Компания держит результаты слежки в секрете, потому что огласка выглядела бы жутко и навредила бы её бизнесу. Личное раскрывается косвенно, например через таргетинг рекламы на людей с определённой болезнью. Пусть человека в такой группе нельзя опознать, решает о раскрытии уже не он, а компания ради прибыли.
Многие компании не хотят выглядеть жутко. Поэтому они не спрашивают, насколько их сбор данных вторгается в жизнь людей, а лишь следят, как их видят пользователи. Авторы советуют ждать, что данные окажутся ошибочными или неуместными, например напомнят о болезненном событии. Что уместно, а что нет, решает человек: алгоритм этого не понимает, пока его прямо не научат. Поэтому механизмы для этих сбоев надо строить заранее.
Настройки приватности решают лишь, что видят другие пользователи. Сам сервис видит всё и анализирует данные глубже, чем видно снаружи. Слежка была всегда, но раньше она была дорогой и ручной. Врачи и адвокаты тоже знают личное, но их ограничивают этика и закон. Интернет-сервисы собирают чувствительные данные в огромном масштабе без осмысленного согласия, и такого перехода прав от людей к компаниям в истории не было.
Данные как актив и власть
Заголовок раздела «Данные как актив и власть»Поведенческие данные иногда называют data exhaust («выхлоп»), будто это отходы. Авторы смотрят наоборот: если сервис живёт за счёт рекламы, активность пользователя — это его труд, а приложение лишь приманка для сбора данных.
Данные — ценный актив. Брокеры данных (data broker) тайно скупают и перепродают их, а стартапы оценивают по числу пользователей, то есть по тому, за сколькими людьми они могут следить. Данные хотят и государства: через сделки, давление, закон или кражу. При банкротстве их продают с остальным имуществом, а утечки случаются пугающе часто.
Поэтому критики называют данные «токсичным активом»: возможно, это не новая нефть, а новый уран. Даже если вы не злоупотребите данными, их может украсть преступник, слить сотрудник или потребовать будущий режим. «Ставить технологии, которые однажды помогут полицейскому государству, — плохая гражданская гигиена», — пишет Брюс Шнайер. Знание — сила, и компании с огромными данными получают большую власть над нашей жизнью.
Вспомним промышленную революцию
Заголовок раздела «Вспомним промышленную революцию»Информационную эпоху часто сравнивают с промышленной революцией. Та дала рост и подняла уровень жизни, но принесла грязный воздух и грязную воду, тяжёлый труд и детский труд в шахтах. Защита появилась нескоро: экологические нормы, охрана труда, санитарный контроль. Бизнесу стало дороже, но общество очень выиграло.
У информационной эпохи тоже есть тёмная сторона. По мысли Шнайера, данные — это загрязнение нашей эпохи, а защита приватности — её экологическая задача. Внуки будут судить нас по тому, как мы с ней справились. «Давайте сделаем так, чтобы они нами гордились», — пишут авторы.
Законы и саморегуляция
Заголовок раздела «Законы и саморегуляция»GDPR требует собирать личные данные только для указанных и явных целей и только в нужном объёме. Это минимизация данных (data minimization). Она прямо противоречит философии big data: собрать всё, объединить и искать новые идеи. GDPR немного изменил онлайн-рекламу, но применяют его слабо, и культура отрасли почти не изменилась.
Компании говорят, что регулирование мешает инновациям, и отчасти они правы: анализ медицинских данных может спасать жизни, а слишком жёсткие правила его тормозят. Найти баланс трудно.
Главное, по мнению авторов, — сдвиг культуры. Пользователи не метрики для оптимизации, а люди, которые заслуживают уважения. Отрасли нужно самой ограничивать сбор данных и объяснять людям, как их данные используют. Контроль над своими данными похож на национальный парк: без защиты его уничтожат, и проиграют все. Тотальную слежку ещё можно остановить.
Первый шаг — собирать меньше и удалять данные, как только они не нужны. Данные, которых у вас нет, нельзя слить, украсть или отдать по требованию.
Путь книги
Заголовок раздела «Путь книги»В конце авторы кратко проходят по всей книге: компромиссы архитектуры и нефункциональные требования, модели данных и хранение, кодирование, репликация, sharding, транзакции, проблемы распределённых систем и консенсус, пакетная и потоковая обработка. Список глав со ссылками есть в обзоре книги.
Последняя глава показала, что данные могут приносить пользу, но могут и вредить: принимать решения, которые трудно обжаловать, вести к дискриминации, делать слежку нормой и утекать. Авторы заканчивают призывом строить мир, который относится к людям по-человечески и с уважением.
Итоги главы
Заголовок раздела «Итоги главы»- Многие данные описывают людей, поэтому инженер отвечает и за последствия своей системы.
- Человек с ошибочной меткой риска может попасть в «алгоритмическую тюрьму» и получать отказ за отказом.
- Модель на предвзятых данных усиливает предвзятость, даже если защищённые признаки убрали.
- Вину за решение нельзя переложить на алгоритм: решение должно быть объяснимым и исправимым.
- Петли обратной связи делают прогноз самосбывающимся, а системное мышление помогает заметить их заранее.
- При рекламной модели
trackingстановится слежкой, а согласие редко бывает свободным. - Приватность — это право решать, что раскрыть, и слежка передаёт это право компании.
- Данные — токсичный актив, поэтому лучшая защита — собирать меньше и удалять раньше.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
Предиктивная аналитика (predictive analytics) | Прогнозы о людях на основе данных |
Предвзятость (bias) | Систематический перекос в данных, который модель усиливает |
Петля обратной связи (feedback loop) | Прогноз меняет реальность и сам себя подтверждает |
Системное мышление (systems thinking) | Взгляд на систему целиком, вместе с людьми |
Tracking | Запись действий пользователя как побочный эффект |
Слежка (surveillance) | Tracking в интересах тех, кто платит за сервис |
Минимизация данных (data minimization) | Собирать только то, что нужно для явной цели |
Брокер данных (data broker) | Компания, которая скупает и перепродаёт данные о людях |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Помечайте колонки с персональными данными в каталоге и ограничивайте к ним доступ.
- Перед тем как добавить поле в
pipeline, спросите, зачем оно нужно. - Задайте срок хранения сырых событий. Удаление должно доходить до витрин и бэкапов.
- Проверяйте признаки модели на заменители защищённых: индекс, район, язык браузера.
- Для решений о людях храните версию модели, входы и причину решения.
- В России персональные данные регулирует закон 152-ФЗ, и ограничение целью в нём тоже есть.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему удаление колонки с расой не делает модель честной?
- Чем кредитный рейтинг отличается от прогноза «кто похож на вас»?
- Как работает петля обратной связи с кредитным рейтингом и наймом?
- Когда
tracking— услуга, а когда — слежка? - Почему согласие часто нельзя считать свободным?
- Почему данные называют токсичным активом, и что авторы предлагают делать?
Предыдущая: Философия потоковых систем. Это последняя глава книги: вернуться к обзору.