

Designing Data-Intensive Applications, глава 3: Модели данных и языки запросов
Главная мысль: модель данных определяет, какие задачи в приложении решаются просто, а какие неудобно. Реляционная, документная и графовая модели хороши для разных видов связей между данными. Event sourcing и DataFrame дают ещё два взгляда на те же данные: один удобен для записи, другой — для анализа и ML.
О чём глава
Заголовок раздела «О чём глава»Глава отвечает на вопрос: в какой форме хранить данные приложения и как их запрашивать. В главе 2 авторы разбирали требования к системе, а теперь сравнивают сами модели данных:
- реляционную и документную модели, нормализацию и виды связей;
- схемы для аналитики:
star schema,snowflake schema,one big table; - графовые модели и языки Cypher, SPARQL, Datalog, GraphQL;
event sourcingиCQRS;- DataFrame, матрицы и массивы.
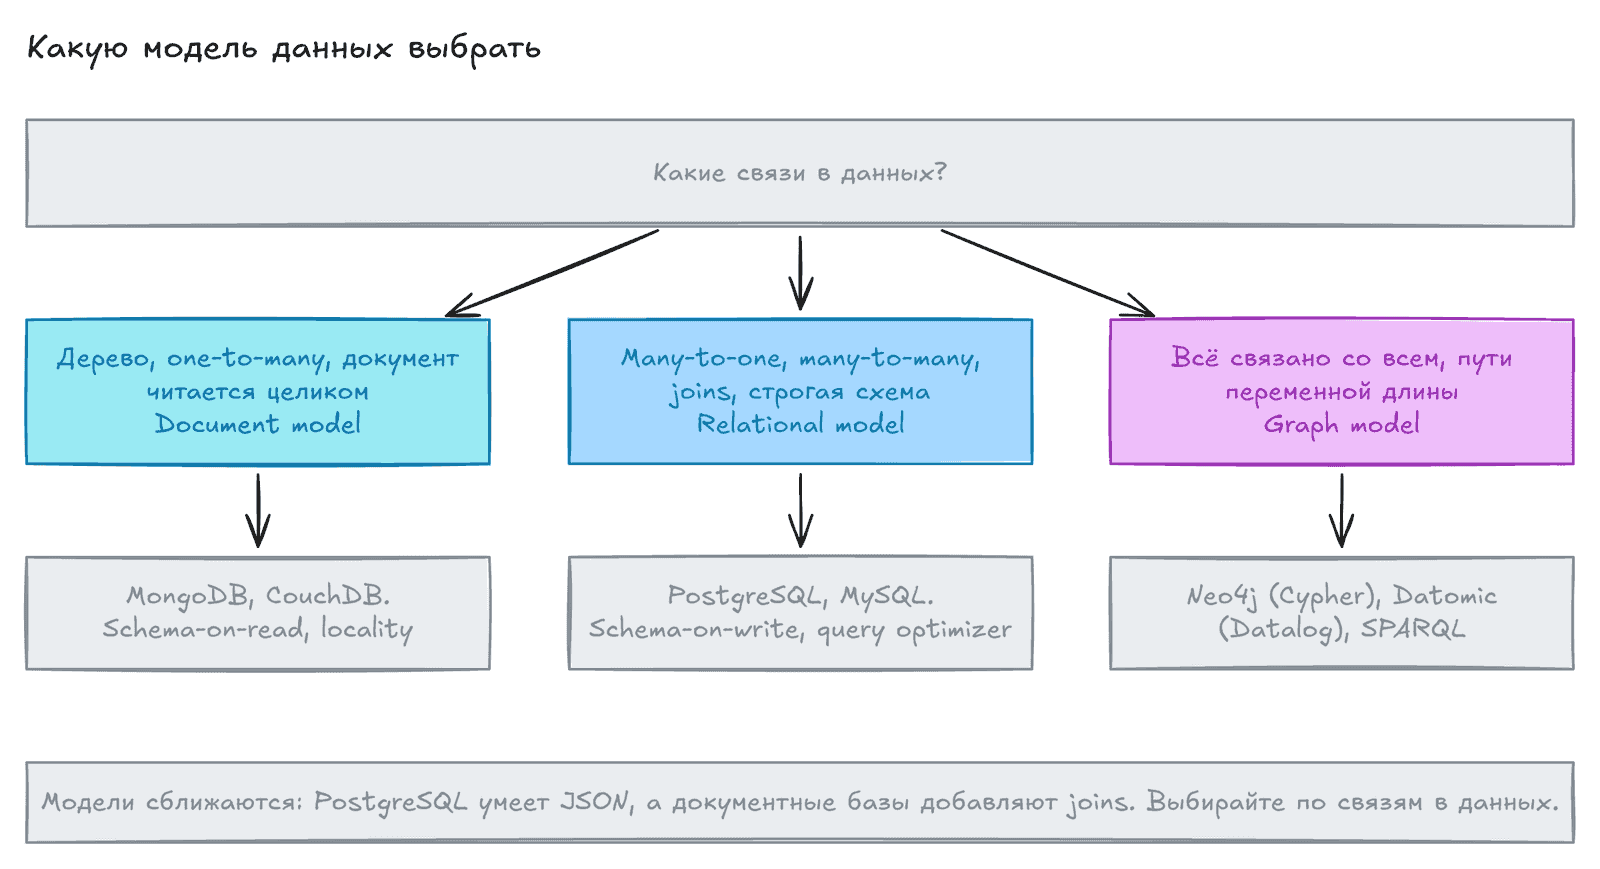
Схема читается сверху вниз: сначала смотрим, какие связи преобладают в данных, затем выбираем модель.
Слои моделей данных
Заголовок раздела «Слои моделей данных»Авторы называют модель данных, возможно, самой важной частью разработки ПО: она влияет и на код, и на то, как мы думаем о задаче. Приложение строится слоями, и каждый слой выражает данные через модель слоя ниже:
- Разработчик описывает реальный мир объектами, структурами данных и API.
- Чтобы сохранить их, он выбирает универсальную модель: JSON-документы, таблицы или граф. Им посвящена глава.
- Авторы базы решают, как хранить эти данные в байтах. Об этом глава 4.
- Инженеры по железу превращают байты в ток, свет и магнитные поля.
Каждый слой прячет сложность нижних за чистой моделью, поэтому команда вендора базы и разработчики приложения могут работать вместе. Одни запросы легко выразить в одной модели и трудно в другой, и глава сравнивает эти компромиссы.
Декларативные языки запросов
Заголовок раздела «Декларативные языки запросов»Многие языки главы (SQL, Cypher, SPARQL, Datalog) — декларативные. Декларативный язык — это язык, в котором вы описываете нужный результат: условия, сортировку, группировку. Как его получить, решает оптимизатор запросов (query optimizer): он выбирает индексы, алгоритмы join и порядок шагов.
В Python или Java вы бы писали алгоритм с точным порядком операций. Декларативный запрос короче, но главное — он прячет детали движка. Поэтому база может ускорять запросы, например выполнять их параллельно на многих ядрах и машинах, а ваш код не меняется.
Реляционная модель против документной
Заголовок раздела «Реляционная модель против документной»Самая известная модель сегодня — модель SQL. В её основе — реляционная модель Эдгара Кодда (Edgar Codd) 1970 года: данные лежат в отношениях (в SQL это таблицы), а отношение — это неупорядоченный набор кортежей (в SQL это строки). Сначала многие сомневались, что её можно реализовать эффективно. Но к середине 1980-х реляционные СУБД и SQL стали главным инструментом для данных с регулярной структурой, а бизнес-аналитика держится на них до сих пор.
Конкурентов было много: сетевая (network) и иерархическая (hierarchical) модели в 1970-х, объектные базы в конце 1980-х и 1990-х, XML-базы в 2000-х. Вокруг каждого был шум, но ни один не задержался. Вместо этого SQL вобрал другие типы данных: XML, JSON и графы.
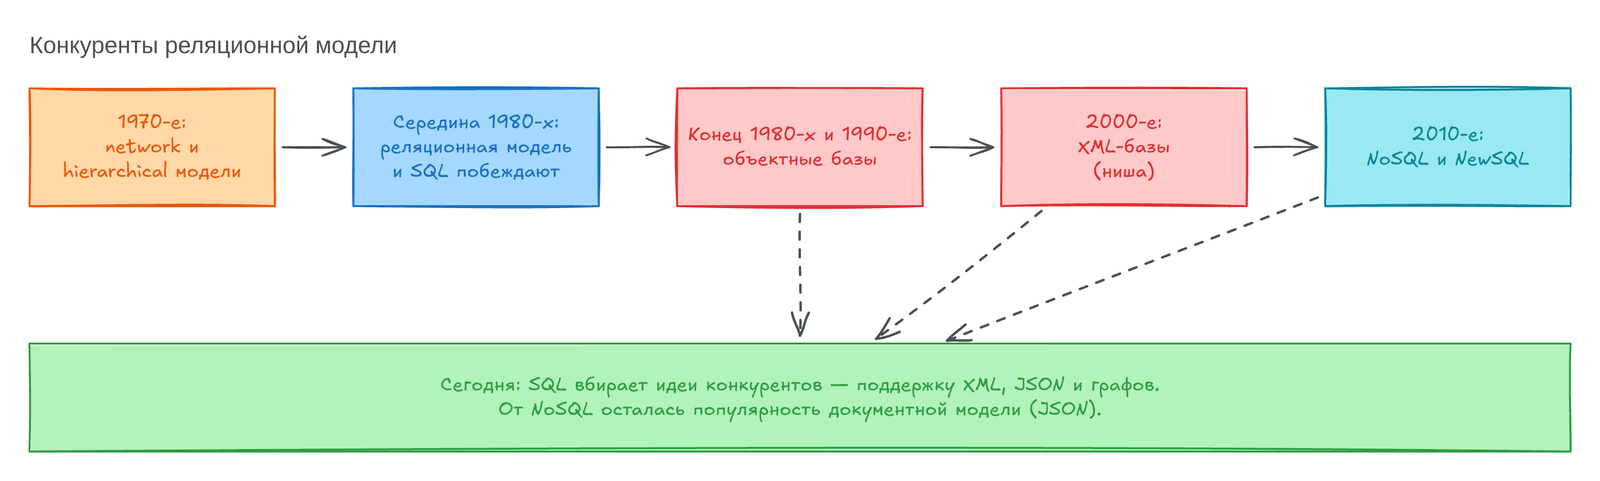
Схема читается слева направо по десятилетиям, а пунктир показывает, что идеи конкурентов попали в SQL.
В 2010-х модным словом стал NoSQL — набор идей о новых моделях данных, гибких схемах, масштабе и открытых лицензиях. Базы NewSQL обещали масштаб NoSQL вместе с транзакциями реляционных баз. Когда эти идеи стали общепринятыми, сами термины почти забыли. Главный след NoSQL — популярность документной модели, которая обычно хранит данные как JSON. Её продвигали MongoDB и Couchbase, а теперь JSON умеют и большинство реляционных баз. Принято считать, что JSON гибче жёстких таблиц, и авторы разбирают аргументы этого спора.
Несоответствие объектов и таблиц
Заголовок раздела «Несоответствие объектов и таблиц»Код обычно пишут на объектно-ориентированных языках. Если данные лежат в таблицах, между объектами и строками нужен неудобный слой перевода. Этот разрыв называют impedance mismatch: термин взят из электроники, где сигнал плохо проходит между цепями с разным сопротивлением.
ORM: плюсы и минусы
Заголовок раздела «ORM: плюсы и минусы»ORM (object-relational mapping) — это фреймворк, который переводит объекты в строки таблиц и обратно, например ActiveRecord или Hibernate. Он сокращает шаблонный код, но его критикуют:
- ORM не прячет разницу между моделями полностью, и думать приходится об обеих.
- ORM обычно используют только в OLTP-приложениях. А инженеры данных, которые готовят данные для аналитики, работают с самими таблицами. Поэтому дизайн схемы важен и при ORM.
- Многие ORM работают только с реляционными базами, а поисковых и графовых систем не знают.
- Схема, которую ORM генерирует сам, бывает неудобной и медленной, а её настройка съедает выгоду от ORM.
- С ORM легко написать медленный запрос, например получить проблему
N+1.
Проблема N+1 выглядит так. Нужно показать N комментариев с именами авторов. В SQL вы сделали бы один join. ORM же может сделать запрос за комментариями и потом отдельный запрос к users на каждый комментарий, то есть N+1 запрос. Чтобы этого избежать, ORM надо явно попросить загрузить авторов вместе с комментариями.
Плюсы у ORM тоже есть: он убирает шаблонный код в простых и частых случаях, кэширует результаты запросов и помогает с миграциями схемы.
Документная модель для связей one-to-many
Заголовок раздела «Документная модель для связей one-to-many»Пример авторов — резюме, как профиль в LinkedIn. Имя и фамилия встречаются в профиле один раз и становятся столбцами таблицы users. Но мест работы, периодов учёбы и контактов бывает много. Это связи one-to-many (один ко многим), и в реляционной схеме их выносят в таблицы positions, education, contact_info с внешним ключом (foreign key) на users. Те же данные можно записать одним JSON-документом, который ближе к объектам в коде:
{ "user_id": 251, "first_name": "Анна", "last_name": "Петрова", "headline": "Data Engineer", "region_id": "ru:77", "positions": [ {"job_title": "Data Engineer", "organization": "Ромашка"}, {"job_title": "BI Developer", "organization": "Лютик"} ], "education": [ {"school_name": "МГУ", "start": 2012, "end": 2017} ], "contact_info": {"website": "https://example.com"}}Некоторые считают, что JSON уменьшает impedance mismatch, а отсутствие схемы называют плюсом. О минусах JSON как формата кодирования (encoding) — в главе 5.
Главный плюс документа — локальность. Чтобы собрать профиль из таблиц, нужно несколько запросов или громоздкий join, а в документе всё лежит в одном месте. Связи one-to-many образуют дерево, и JSON делает его явным. Такую связь иногда зовут one-to-few: мест работы обычно немного. Если связанных элементов тысячи, например комментарии к посту знаменитости, лучше отдельная таблица.
Нормализация, денормализация и join
Заголовок раздела «Нормализация, денормализация и join»В профиле регион записан как region_id, а не текстом. В примере книги это ID вместо строки «Washington, DC, United States». Стандартный список регионов даёт одинаковое написание, нет путаницы между одноимёнными местами, имя легко поменять и перевести в одном месте. А поиск людей с восточного побережья США найдёт этот профиль: в списке регионов записано, что Вашингтон там.
Хранить ID или текст — это вопрос нормализации. Нормализация — это хранение понятной человеку информации в одном месте, а все остальные записи ссылаются на неё по ID. Если текст копируют в каждую запись, данные денормализованы. ID ничего не значит для людей, поэтому ему не нужно меняться. А всё понятное человеку однажды изменится, и тогда придётся обновлять все копии: это больше кода, записей и места, а ещё риск, что часть копий останется старой.
Минус нормализации в том, что ID при показе надо превратить в текст ещё одним поиском. В реляционной модели это join:
CREATE TABLE regions (id VARCHAR PRIMARY KEY, region_name VARCHAR);INSERT INTO regions VALUES    ('ru:77', 'Москва, Россия'),    ('ru:78', 'Санкт-Петербург, Россия');
CREATE TABLE users (id INTEGER PRIMARY KEY, name VARCHAR, region_id VARCHAR);INSERT INTO users VALUES    (251, 'Анна Петрова', 'ru:77'),    (252, 'Иван Смирнов', 'ru:77'),    (253, 'Олег Ким', 'ru:78');
SELECT users.*, regions.region_nameFROM usersJOIN regions ON users.region_id = regions.idWHERE users.id = 251;┌───────┬──────────────┬───────────┬────────────────┐│ id │ name │ region_id │ region_name ││ int32 │ varchar │ varchar │ varchar │├───────┼──────────────┼───────────┼────────────────┤│ 251 │ Анна Петрова │ ru:77 │ Москва, Россия │└───────┴──────────────┴───────────┴────────────────┘Документные базы связывают с денормализацией: в JSON легко добавить лишние поля, а join поддерживается слабо или никак. Тогда его делают в коде: сначала читают документ с ID, потом вторым запросом документ по этому ID. В MongoDB есть оператор $lookup:
db.users.aggregate([ { $match: { _id: 251 } }, { $lookup: { from: "regions", localField: "region_id", foreignField: "_id", as: "region" } }])Компромиссы нормализации
Заголовок раздела «Компромиссы нормализации»В резюме компания и вуз — просто строки, и это денормализация. Допустим, мы хотим показывать логотип компании. При денормализации URL логотипа лежит в каждом профиле, и при смене логотипа все копии надо искать и обновлять. При нормализации у компании своя сущность с именем и логотипом, а резюме ссылается на её ID.
Общее правило такое: нормализованные данные быстрее писать, но медленнее читать из-за join. Денормализованные быстрее читать, но запись дороже, а места нужно больше. Денормализацию полезно считать производными данными (derived data, глава 1): нужен процесс, который обновляет копии. Если он упадёт посреди работы, копии разойдутся. Помогают атомарные транзакции (глава 8), но не все базы дают их для нескольких документов. Другой путь — потоковая обработка (глава 12).
Нормализация обычно лучше для OLTP, где быстрыми должны быть и чтения, и обновления. Аналитике чаще подходит денормализация: данные обновляют пакетами, а важна скорость чтения. В системах малого и среднего масштаба нормализация часто лучше всего, и только в очень больших системах join становится дорогим.
Денормализация в социальной сети
Заголовок раздела «Денормализация в социальной сети»В главе 2 материализованная лента служила кэшем дорогого join постов и подписок, а fan-out поддерживал её согласованность. Но в X (бывший Twitter) лента хранит не текст постов, а только ID поста, ID автора и немного данных о репостах. По сути это заранее посчитанный результат запроса:
SELECT posts.id, posts.sender_id FROM postsJOIN follows ON posts.sender_id = follows.followee_idWHERE follows.follower_id = current_userORDER BY posts.timestamp DESCLIMIT 1000Поэтому при чтении ленты сервис всё равно делает два join: по ID поста достаёт текст и число лайков, а по ID автора — имя и аватар. Этот поиск по ID называют hydrating, и это join в коде приложения. Копировать лайки и аватары в ленту нет смысла: они меняются слишком часто, а объём хранения сильно вырос бы.
Пример показывает, что join при чтении не мешает масштабу: такой поиск по ID хорошо распараллеливается, и его цена не зависит от числа подписок. Вывод авторов: часто лучше денормализовать одни данные и оставить нормализованными другие. Смотрите, как часто меняются данные и сколько стоят чтения и записи, включая выбросы вроде звёзд с миллионами подписчиков. Нормализация и денормализация — не хорошо и не плохо, а компромисс (trade-off).
Связи many-to-one и many-to-many
Заголовок раздела «Связи many-to-one и many-to-many»Места работы — связь one-to-many. Поле region_id — связь many-to-one: в регионе живёт много людей, но человек живёт в одном регионе. Если сделать компании сущностями, появится связь many-to-many: человек работал в нескольких компаниях, а в компании много сотрудников. В реляционной модели её хранят в связующей таблице (join table): строка positions связывает один user_id с одним org_id.
Такие связи плохо помещаются в самодостаточный документ. В документной модели профиль остаётся документом, а на компании ссылаются по ID:
{ "user_id": 251, "first_name": "Анна", "positions": [ {"start": 2021, "end": 2026, "job_title": "Data Engineer", "org_id": 513}, {"start": 2017, "end": 2021, "job_title": "BI Developer", "org_id": 514} ]}Связь many-to-many читают в обе стороны: где работал человек и кто работал в компании. Можно хранить ссылки с двух сторон, но это денормализация, и копии могут разойтись. Нормализованный путь — хранить связь в одном месте и строить вторичные индексы (глава 4): в таблице на user_id и org_id, а в документе на поле org_id внутри массива. Многие базы такие индексы умеют.
Star и snowflake: схемы для аналитики
Заголовок раздела «Star и snowflake: схемы для аналитики»Хранилища данных (data warehouse) обычно реляционные, и для них есть привычные схемы: star schema, snowflake schema, размерное моделирование (dimensional modeling) и one big table (OBT). ETL-процессы переводят в них данные из операционных систем.
В центре star schema лежит таблица фактов (fact table), например fact_sales продуктовой сети. Каждая строка — событие: покупка товара или, для сайта, клик. Факты хранят отдельными событиями ради гибкости анализа, поэтому таблица фактов бывает огромной, вплоть до петабайт. Часть её столбцов — атрибуты вроде цены продажи и закупки. Остальные — внешние ключи на таблицы измерений (dimension table), которые отвечают на вопросы «кто, что, где, когда, как и почему». Например, dim_product хранит артикул, бренд и категорию товара. Даже дату выносят в измерение, чтобы хранить, например, признак праздника и сравнивать продажи в праздники и будни.
Название «звезда» пошло от картинки: факты в центре, измерения вокруг, как лучи. В snowflake schema измерения разбиты дальше: бренды и категории лежат в своих таблицах. Она нормализованнее, но аналитикам проще со звездой. Подробно star schema разобрана в конспекте The Data Warehouse Toolkit.
Таблицы хранилища широкие: в таблице фактов бывают сотни столбцов, а dim_store может хранить даже площадь магазина и расстояние до трассы. Связи в таких схемах в основном many-to-one: много продаж одного товара в одном магазине. Связи других видов обычно денормализуют, чтобы упростить запросы. Например, чек из нескольких товаров не хранят отдельно: это просто строки с одним покупателем, магазином и временем.
OBT идёт дальше: поля измерений вливают прямо в таблицу фактов, то есть заранее считают join. Места нужно больше, зато запросы иногда быстрее. В аналитике это не страшно: исторические данные почти не меняются, поэтому проблем согласованности, как в OLTP, мало.
Когда какую модель выбирать
Заголовок раздела «Когда какую модель выбирать»За документную модель говорят гибкая схема, локальность и близость к объектам кода. За реляционную — join и связи many-to-one и many-to-many. Если данные — дерево one-to-many, которое читают целиком, берите документ. В реляционной модели пришлось бы применить shredding (разбить документ на несколько таблиц), а это даёт громоздкую схему и сложный код.
Но на вложенный элемент документа нельзя сослаться напрямую, только как «второе место работы пользователя 251». В реляционной модели у каждой строки свой ID. Зато порядок элементов, который задаёт пользователь (задачи в трекере), документ хранит просто как JSON-массив. В таблицах для этого нужны приёмы: перенумерация целого столбца, связный список или дробные индексы (fractional indexing).
Гибкость схемы в документной модели
Заголовок раздела «Гибкость схемы в документной модели»Документные базы и JSON в реляционных базах обычно не проверяют схему: в документ можно добавить любые поля. Такие базы зовут schemaless, но это неточно. Код ждёт определённую структуру, значит схема есть, только неявная. Точнее говорить так:
schema-on-read— схема неявная и применяется только при чтении;schema-on-write— схема явная, и база проверяет её при записи.
Это похоже на динамическую и статическую типизацию в языках, и спор так же не имеет победителя. Разница видна при смене формата. Допустим, полное имя хранилось одним полем, а теперь нужны имя и фамилия отдельно. В документной базе новые документы пишут с новыми полями, а старые обрабатывают при чтении:
if (user && user.name && !user.first_name) { // документы, записанные до 8 декабря 2023, не имеют first_name user.first_name = user.name.split(" ")[0];}Минус в том, что старые форматы должна понимать каждая часть приложения. В базе со schema-on-write делают миграцию (в DuckDB и PostgreSQL функция называется split_part, в MySQL — substring_index):
ALTER TABLE users ADD COLUMN first_name VARCHAR DEFAULT NULL;UPDATE users SET first_name = split_part(name, ' ', 1);SELECT id, name, first_name FROM users ORDER BY id;┌───────┬──────────────┬────────────┐│ id │ name │ first_name ││ int32 │ varchar │ varchar │├───────┼──────────────┼────────────┤│ 251 │ Анна Петрова │ Анна ││ 252 │ Иван Смирнов │ Иван ││ 253 │ Олег Ким │ Олег │└───────┴──────────────┴────────────┘Добавить столбец со значением по умолчанию обычно быстро даже в большой таблице. А UPDATE переписывает каждую строку и на большой таблице медленный. Есть инструменты для миграций в фоне, но такие миграции всё равно остаются трудной операцией. Обходной путь — добавить столбец с NULL и заполнять его при чтении, как в документной базе.
Schema-on-read выгодна для разнородных данных: когда типов объектов слишком много для отдельных таблиц или структуру задают внешние системы, которые вы не контролируете. Если же у всех записей одна структура, схема полезна: она её документирует и защищает. Подробнее о schema evolution — в главе 5.
Локальность данных при чтении и записи
Заголовок раздела «Локальность данных при чтении и записи»Документ обычно хранится одной строкой: JSON, XML или двоичный формат вроде BSON в MongoDB. Если документ часто читают целиком, такая локальность (locality) ускоряет чтение: с таблицами понадобилось бы несколько поисков по индексам. Но база загружает документ целиком, даже если нужен маленький кусок, а при обновлении обычно переписывает его целиком. Поэтому документы советуют держать небольшими.
Локальность есть не только у документов. Google Spanner позволяет хранить строки дочерней таблицы вложенными в родительскую. В Oracle похожая функция называется multi-table index cluster tables, а в wide-column базах (Bigtable, HBase) ту же задачу решают семейства столбцов (column families).
Языки запросов к документам
Заголовок раздела «Языки запросов к документам»Реляционные базы почти все понимают SQL, а документные устроены по-разному: одни дают только доступ по ключу, другие — индексы по полям и богатые языки. Для XML есть XQuery и XPath, для JSON — JSON Pointer и JSONPath. Ещё пример — aggregation pipeline в MongoDB. Сравним его с SQL. Морской биолог хочет знать, сколько акул он видел в каждом месяце:
WITH observations(observation_timestamp, family, num_animals) AS ( VALUES (TIMESTAMP '2026-01-05 10:00', 'Sharks', 3), (TIMESTAMP '2026-01-20 16:30', 'Sharks', 4), (TIMESTAMP '2026-01-21 08:15', 'Dolphins', 12), (TIMESTAMP '2026-02-02 11:00', 'Sharks', 1))SELECT date_trunc('month', observation_timestamp) AS observation_month, sum(num_animals) AS total_animalsFROM observationsWHERE family = 'Sharks'GROUP BY observation_monthORDER BY observation_month;┌───────────────────┬───────────────┐│ observation_month │ total_animals ││ date │ int128 │├───────────────────┼───────────────┤│ 2026-01-01 │ 7 ││ 2026-02-01 │ 1 │└───────────────────┴───────────────┘Функция date_trunc('month', ...) округляет время до начала месяца. Тот же запрос в MongoDB:
db.observations.aggregate([ { $match: { family: "Sharks" } }, { $group: { _id: { year: { $year: "$observationTimestamp" }, month: { $month: "$observationTimestamp" } }, totalAnimals: { $sum: "$numAnimals" } } }]);По выразительности aggregation pipeline близок к подмножеству SQL, но его синтаксис основан на JSON, а не похож на английские фразы, как в SQL. Авторы считают это делом вкуса.
Сближение документных и реляционных баз
Заголовок раздела «Сближение документных и реляционных баз»Со временем две модели сблизились. Реляционные базы добавили JSON, операторы для него и индексы по полям документа. MongoDB, Couchbase и RethinkDB добавили join, вторичные индексы и декларативные языки. Это хорошо: документным базам нужны ссылки в реляционном стиле, а реляционным местами нужна гибкая схема. Кстати, ещё Кодд допускал похожее под названием nonsimple domains: значение в строке может быть вложенной таблицей. Это то же, что JSON в SQL, только на 30 лет раньше.
Графовые модели данных
Заголовок раздела «Графовые модели данных»Если в данных в основном связи one-to-many, подходит документ. Если же связей many-to-many очень много и они сложные, данные естественнее моделировать как граф. Граф состоит из вершин (vertices, nodes) и рёбер (edges, relationships). Примеры: социальный граф (люди и знакомства), веб-граф (страницы и ссылки), дороги (перекрёстки и пути). Для них есть известные алгоритмы: навигатор ищет кратчайший путь, а PageRank оценивает популярность страницы.
Граф хранят списком смежности (adjacency list), где вершина знает ID соседей, или матрицей смежности (adjacency matrix) из нулей и единиц. Список удобен для обхода, матрица — для ML.
Граф не обязан быть однородным. Facebook держит один граф с людьми, местами, событиями и комментариями, а поисковики строят графы знаний (knowledge graphs) о компаниях, людях и местах. Дальше авторы разбирают модели property graph (Neo4j, Memgraph, KùzuDB) и triple store (Datomic, AllegroGraph). По выразительности они почти равны, а Amazon Neptune умеет обе. Из языков запросов авторы разбирают четыре: Cypher, SPARQL, Datalog и GraphQL, а также графовые запросы в SQL.
Сквозной пример — небольшой граф. Люси (Lucy) из Айдахо и Ален (Alain) из Сен-Ло во Франции женаты и живут в Лондоне. Люди и места — вершины, связи — рёбра.
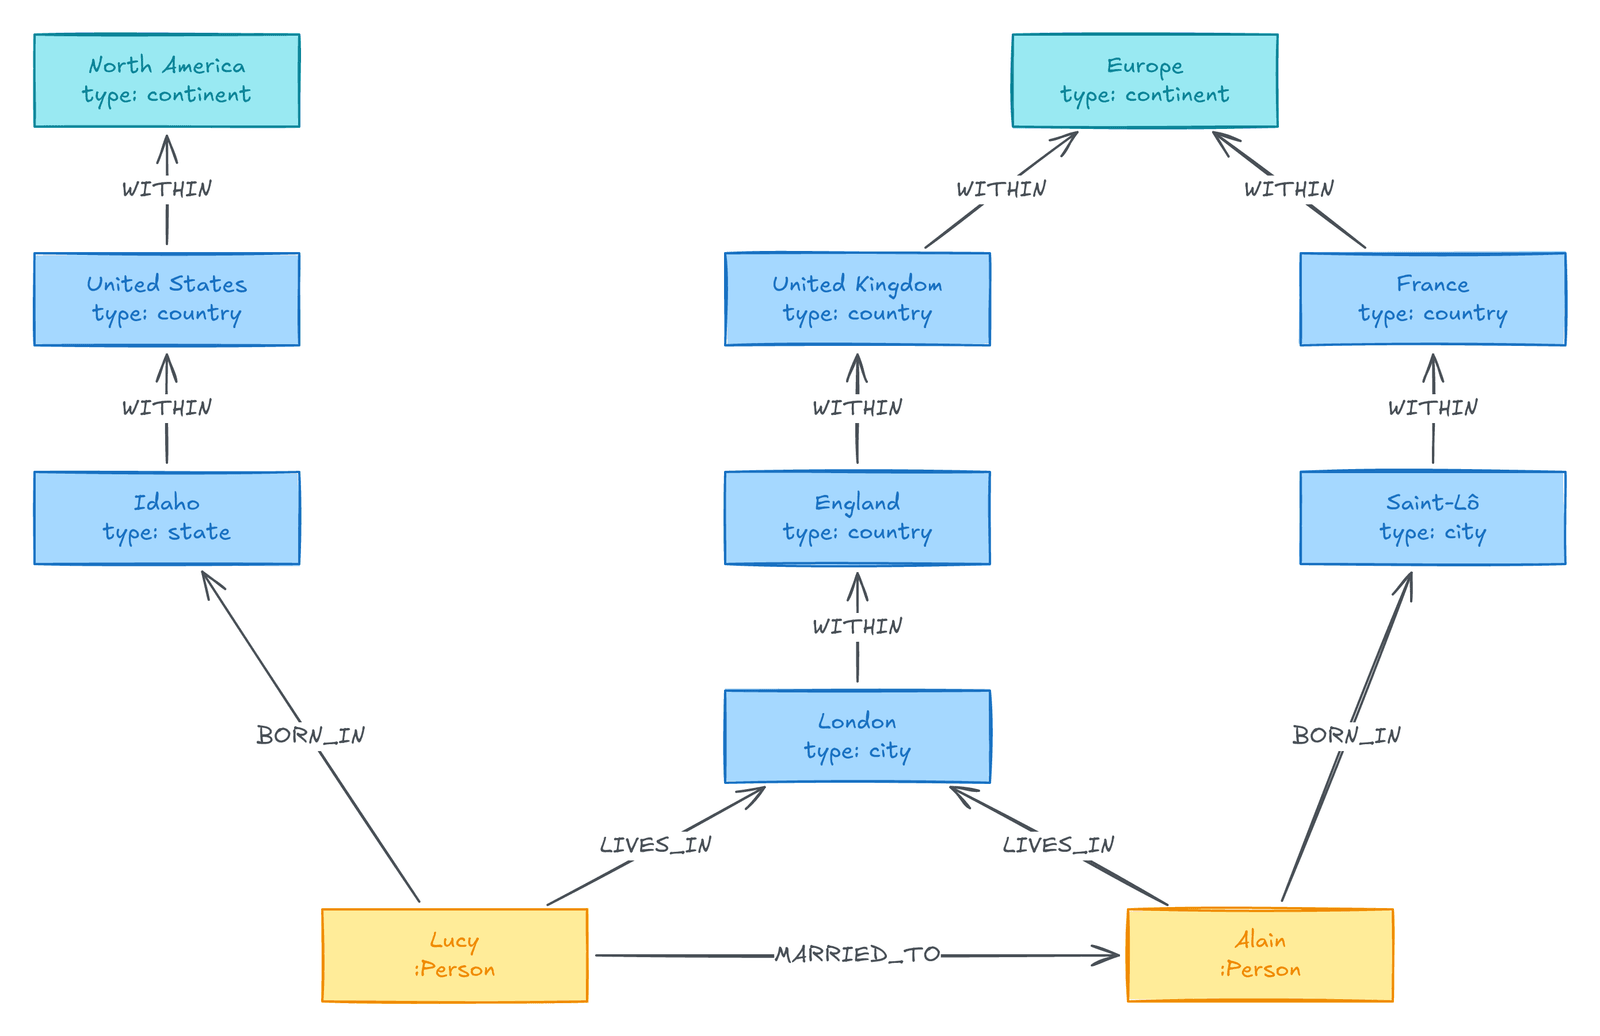
Стрелки — рёбра с метками. WITHIN ведёт от места к более крупному месту, BORN_IN и LIVES_IN — от человека к месту. Граф упрощён: в книге есть ещё промежуточные уровни регионов.
Property graph
Заголовок раздела «Property graph»В модели property graph у вершины есть уникальный ID, метка (label) с типом объекта, входящие и исходящие рёбра и свойства (пары ключ-значение). У ребра есть ID, начальная вершина (tail vertex), конечная вершина (head vertex), метка вида связи и свойства.
Такое хранилище можно представить двумя таблицами: вершины и рёбра. Мы создадим их в разделе про SQL ниже. Важные свойства модели:
- Любая вершина может быть связана с любой: схема не ограничивает связи.
- По вершине быстро находятся и входящие, и исходящие рёбра, поэтому граф можно обходить в обе стороны. Для этого нужны индексы на обе вершины ребра.
- Разные метки позволяют хранить в одном графе много видов данных и не терять чистоту модели.
Таблица рёбер — это обобщённая связующая таблица many-to-many, где лежат связи многих видов. Ограничение графа: ребро связывает только две вершины. Связь трёх сущностей требует дополнительной вершины или гиперграфа (hypergraph).
Зато граф гибок. В примере легко выразить то, что трудно в таблицах: разное административное деление стран, страну внутри страны и разную детализацию (Люси живёт в городе, а родилась в штате). Граф легко расширить. Например, добавьте вершину на каждый аллерген и ребро от человека к аллергену, если у него аллергия. Затем свяжите аллергены с вершинами продуктов, в которых они есть. Тогда запрос найдёт, что каждому человеку можно есть. Поэтому граф хорошо переносит эволюцию приложения.
Язык запросов Cypher
Заголовок раздела «Язык запросов Cypher»Cypher — это язык запросов для property graph. Его создали для Neo4j и сделали открытым стандартом openCypher. Его поддерживают Memgraph, KùzuDB, Amazon Neptune, Apache AGE и другие, а название взято у персонажа «Матрицы». Создадим левую часть графа:
CREATE (namerica :Location {name: 'North America', type: 'continent'}), (usa :Location {name: 'United States', type: 'country'}), (idaho :Location {name: 'Idaho', type: 'state'}), (lucy :Person {name: 'Lucy'}), (idaho) -[:WITHIN]-> (usa) -[:WITHIN]-> (namerica), (lucy) -[:BORN_IN]-> (idaho)Имена вроде usa и idaho живут только внутри запроса. Стрелка (idaho) -[:WITHIN]-> (usa) создаёт ребро с меткой WITHIN от idaho к usa. Теперь найдём всех, кто переехал из США в Европу:
MATCH (person) -[:BORN_IN]-> () -[:WITHIN*0..]-> (:Location {name: 'United States'}), (person) -[:LIVES_IN]-> () -[:WITHIN*0..]-> (:Location {name: 'Europe'})RETURN person.nameЗапрос ищет вершину person, у которой ребро BORN_IN ведёт к месту, откуда по цепочке рёбер WITHIN можно дойти до United States. Ребро LIVES_IN той же вершины должно так же вести к Europe. Выполнить запрос можно по-разному: перебрать всех людей или пойти с другого конца, найти по индексу вершины США и Европы и двигаться назад по входящим рёбрам. Запрос декларативный, поэтому путь выбирает оптимизатор.
Графовые запросы в SQL
Заголовок раздела «Графовые запросы в SQL»Графовые данные в SQL запрашивать можно, но трудно. Каждое ребро — это join с таблицей рёбер. Обычно число join известно заранее, а в графе может понадобиться пройти неизвестное число рёбер. В примере это -[:WITHIN*0..]->: «пройти по WITHIN ноль или больше раз», как * в регулярных выражениях. Люди могут жить на улице, в городе или регионе, и до страны бывает разное число шагов.
В SQL путь переменной длины выражают рекурсивным CTE (WITH RECURSIVE). Вот тот же запрос в DuckDB, свойства лежат в столбце JSON:
CREATE TABLE vertices (vertex_id INTEGER PRIMARY KEY, label VARCHAR, properties JSON);INSERT INTO vertices VALUES    (1,   'location', '{"name": "North America", "type": "continent"}'),    (2,   'location', '{"name": "United States", "type": "country"}'),    (3,   'location', '{"name": "Idaho", "type": "state"}'),    (4,   'location', '{"name": "Europe", "type": "continent"}'),    (5,   'location', '{"name": "United Kingdom", "type": "country"}'),    (6,   'location', '{"name": "England", "type": "country"}'),    (7,   'location', '{"name": "London", "type": "city"}'),    (8,   'location', '{"name": "France", "type": "country"}'),    (9,   'location', '{"name": "Saint-Lô", "type": "city"}'),    (100, 'person',   '{"name": "Lucy"}'),    (101, 'person',   '{"name": "Alain"}');
CREATE TABLE edges (    edge_id     INTEGER PRIMARY KEY,    tail_vertex INTEGER REFERENCES vertices (vertex_id),  -- откуда идёт ребро    head_vertex INTEGER REFERENCES vertices (vertex_id),  -- куда идёт ребро    label       VARCHAR);INSERT INTO edges VALUES    (1, 2, 1, 'within'), (2, 3, 2, 'within'),    (3, 5, 4, 'within'), (4, 6, 5, 'within'), (5, 7, 6, 'within'),    (6, 8, 4, 'within'), (7, 9, 8, 'within'),    (8, 100, 3, 'born_in'), (9, 100, 7, 'lives_in'),    (10, 101, 9, 'born_in'), (11, 101, 7, 'lives_in'),    (12, 100, 101, 'married_to');
WITH RECURSIVE -- все места внутри United States (включая саму страну) in_usa(vertex_id) AS ( SELECT vertex_id FROM vertices WHERE label = 'location' AND (properties->>'name') = 'United States' UNION SELECT edges.tail_vertex FROM edges JOIN in_usa ON edges.head_vertex = in_usa.vertex_id WHERE edges.label = 'within' ), -- все места внутри Europe in_europe(vertex_id) AS ( SELECT vertex_id FROM vertices WHERE label = 'location' AND (properties->>'name') = 'Europe' UNION SELECT edges.tail_vertex FROM edges JOIN in_europe ON edges.head_vertex = in_europe.vertex_id WHERE edges.label = 'within' ), -- люди, которые родились где-то в США born_in_usa(vertex_id) AS ( SELECT edges.tail_vertex FROM edges JOIN in_usa ON edges.head_vertex = in_usa.vertex_id WHERE edges.label = 'born_in' ), -- люди, которые живут где-то в Европе lives_in_europe(vertex_id) AS ( SELECT edges.tail_vertex FROM edges JOIN in_europe ON edges.head_vertex = in_europe.vertex_id WHERE edges.label = 'lives_in' )SELECT vertices.properties->>'name' AS nameFROM verticesJOIN born_in_usa ON vertices.vertex_id = born_in_usa.vertex_idJOIN lives_in_europe ON vertices.vertex_id = lives_in_europe.vertex_id;┌─────────┐│ name ││ varchar │├─────────┤│ Lucy │└─────────┘Запрос сначала собирает все места внутри США и внутри Европы, повторяя шаг по входящим рёбрам within, пока появляются новые вершины. Потом он находит людей, родившихся в первом наборе и живущих во втором, и пересекает их через join.
На Cypher запрос занимает 4 строки, а на SQL в книге — 31. Это показывает, как важен выбор модели и языка. И это только начало: в SQL нужно ещё обрабатывать циклы в графе и выбирать обход в ширину или в глубину. Есть и другие графовые языки: hierarchical-запросы в Oracle, GSQL, PGQL. В 2024 году вышел ISO-стандарт GQL на основе Cypher. Авторы надеются, что со временем он сделает графовые базы единообразнее.
Triple store и SPARQL
Заголовок раздела «Triple store и SPARQL»Модель triple store почти равна property graph, только слова другие. Все данные хранятся тройками (субъект, предикат, объект), например (Jim, likes, bananas). Некоторым базам нужны ещё метаданные: Amazon Neptune хранит четвёрки с ID графа, Datomic — пятёрки с ID транзакции и признаком удаления. Но основа та же.
Субъект — это вершина. Объект бывает двух видов. Если объект — число или строка, то предикат и объект — это свойство вершины: (lucy, birthYear, 1989). Если объект — другая вершина, то предикат — это ребро: (lucy, marriedTo, alain). Вот данные в формате Turtle (подмножество Notation3), где точка с запятой перечисляет несколько фактов о субъекте:
@prefix : <urn:example:>._:lucy a :Person; :name "Lucy"; :bornIn _:idaho._:idaho a :Location; :name "Idaho"; :type "state"; :within _:usa._:usa a :Location; :name "United States"; :type "country"; :within _:namerica._:namerica a :Location; :name "North America"; :type "continent".Имена _:lucy нужны только внутри файла, чтобы понять, какие тройки говорят об одной вершине.
Semantic Web
Заголовок раздела «Semantic Web»Triple store во многом вырос из Semantic Web. Это проект начала 2000-х: публиковать в интернете данные не только для людей, но и в машиночитаемом виде. В задуманном виде проект не прижился. Но его наследие живёт в JSON-LD, онтологиях биомедицины, протоколе Open Graph (превью ссылок), Wikidata и Schema.org. Тройки могут быть хорошей внутренней моделью и без Semantic Web.
Модель данных RDF
Заголовок раздела «Модель данных RDF»Turtle — один из способов записать данные в модели RDF (Resource Description Framework). Есть и другие, например более длинный RDF/XML, а Apache Jena переводит между ними. Модель задумана для данных всего интернета, поэтому предикаты часто — URI вроде <http://my-company.com/namespace#within>. Тогда ваши данные можно объединить с чужими без конфликта смыслов. URI не обязан открываться: это просто пространство имён, и его задают один раз в начале файла.
Язык запросов SPARQL
Заголовок раздела «Язык запросов SPARQL»SPARQL (читается «спаркл») — это язык запросов к RDF. Он старше Cypher, и Cypher взял у него сопоставление с шаблонами, поэтому они похожи:
PREFIX : <urn:example:>SELECT ?personName WHERE { ?person :name ?personName. ?person :bornIn / :within* / :name "United States". ?person :livesIn / :within* / :name "Europe".}Переменные начинаются с ?. Cypher-шаблон -[:BORN_IN]-> () -[:WITHIN*0..]-> в SPARQL записывается как :bornIn / :within*. RDF не различает свойства и рёбра, поэтому свойство ищут тем же синтаксисом, что и ребро. Шаблон ?usa :name "United States". находит любую вершину, у которой имя (свойство name) равно United States. SPARQL поддерживают Amazon Neptune, AllegroGraph, Blazegraph, OpenLink Virtuoso и Apache Jena.
Datalog: рекурсивные реляционные запросы
Заголовок раздела «Datalog: рекурсивные реляционные запросы»Datalog намного старше SPARQL и Cypher: он вырос из академических работ 1980-х. Его знают мало, но авторы считают его очень выразительным языком для сложных запросов. Его используют Datomic, LogicBlox, CozoDB и LIquid от LinkedIn. Datalog основан на реляционной модели, но рекурсия делает его сильным в графах.
Данные в Datalog — факты (facts), и каждый факт — строка таблицы: location(2, "United States", "country") значит, что в location есть такая строка. Рёбра становятся таблицами из двух столбцов: born_in(100, 3) — Люси (ID 100) родилась в Айдахо (ID 3):
location(1, "North America", "continent").location(2, "United States", "country").location(3, "Idaho", "state").within(2, 1). /* США в Северной Америке */within(3, 2). /* Айдахо в США */person(100, "Lucy").born_in(100, 3). /* Люси родилась в Айдахо */Запрос пишут правилами (rules). Datalog — подмножество Prolog:
within_recursive(LocID, PlaceName) :- location(LocID, PlaceName, _).   /* Правило 1 */within_recursive(LocID, PlaceName) :- within(LocID, ViaID),            /* Правило 2 */                                      within_recursive(ViaID, PlaceName).
migrated(PName, BornIn, LivingIn) :- person(PersonID, PName),          /* Правило 3 */                                     born_in(PersonID, BornID),                                     within_recursive(BornID, BornIn),                                     lives_in(PersonID, LivingID),                                     within_recursive(LivingID, LivingIn).
us_to_europe(Person) :- migrated(Person, "United States", "Europe").  /* Правило 4 *//* us_to_europe содержит строку "Lucy". */
Правило выводит из фактов виртуальную таблицу, как view в SQL. Часть до :- задаёт имя и столбцы таблицы, а часть после — шаблоны, которым должны соответствовать строки. Например, шаблон person(PersonID, PName) совпадает со строкой person(100, "Lucy"), и переменные получают значения. Если совпали все шаблоны, левая часть как будто добавляется в базу. Так правила работают шаг за шагом:
- Есть факт
location(1, "North America", ...), и правило 1 выводитwithin_recursive(1, "North America"). - Есть
within(2, 1), и правило 2 выводитwithin_recursive(2, "North America"): США в Северной Америке. - Есть
within(3, 2), и правило 2 выводитwithin_recursive(3, "North America"): Айдахо тоже там.
Правило 3 находит людей с местом рождения и местом жительства, а правило 4 оставляет тех, кто переехал из США в Европу. Ответ тот же, что у Cypher и SPARQL. Datalog требует другого мышления: запрос собирают правило за правилом, как код из функций. Правила могут вызывать сами себя, как правило 2, и это позволяет обходить граф.
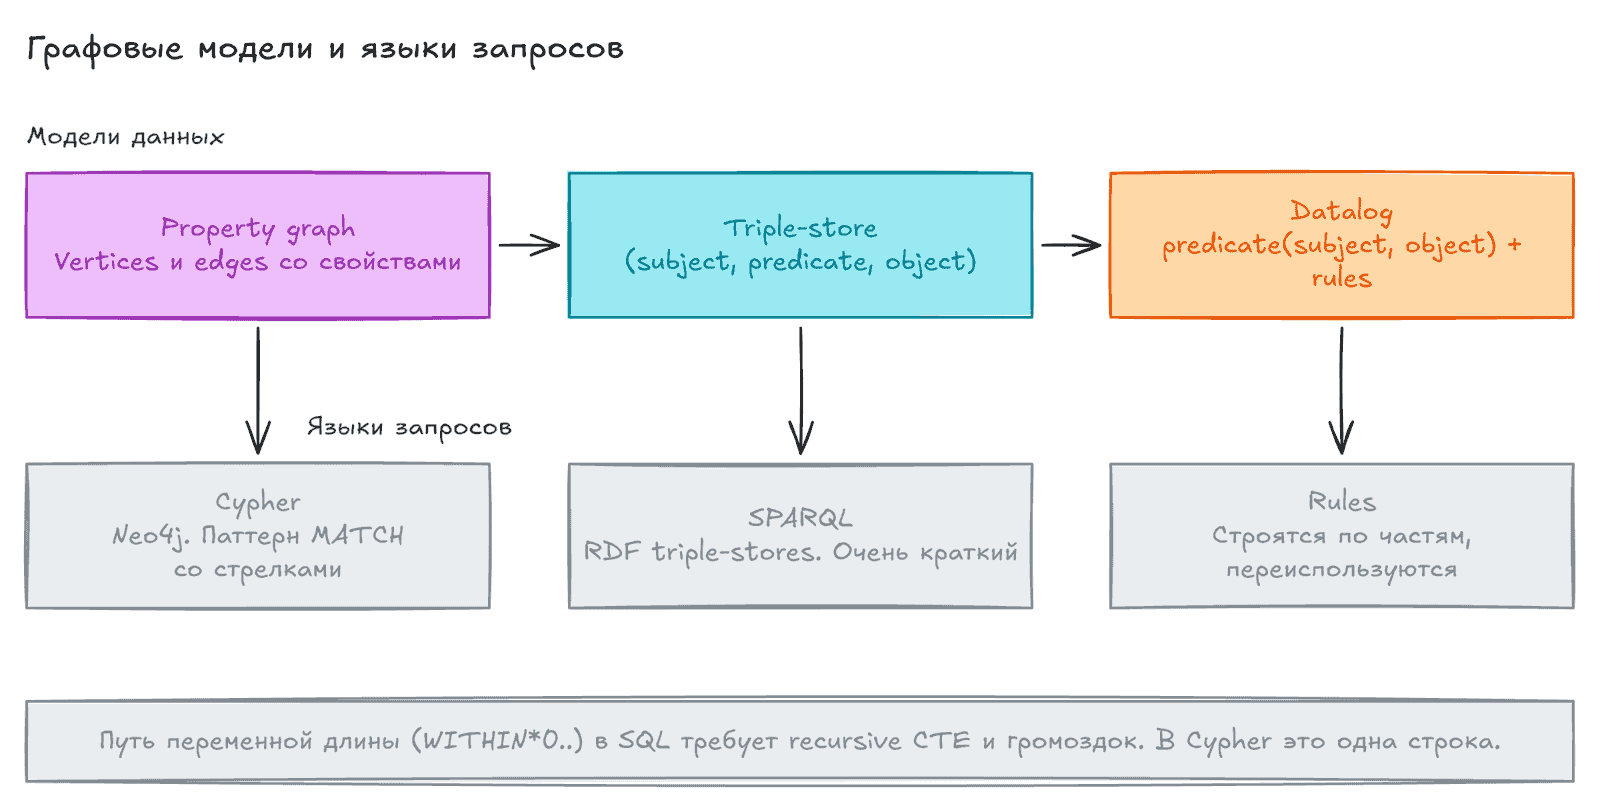
Схема сводит графовые модели и их языки. Нижний блок напоминает главный вывод: путь переменной длины в SQL выразить можно, но громоздко.
GraphQL
Заголовок раздела «GraphQL»GraphQL по замыслу намного беднее остальных языков главы. Он нужен для OLTP: клиент (мобильное приложение или фронтенд) запрашивает JSON-документ ровно с теми полями, которые нужны интерфейсу. Клиент меняет запросы без изменений API на сервере. Цена такой гибкости: нужны инструменты, которые переводят запросы во внутренние REST- или gRPC-вызовы, и приходится решать вопросы авторизации, лимитов и скорости.
Язык ограничен намеренно: запросы приходят из недоверенных источников, и тяжёлый запрос мог бы перегрузить сервер. Поэтому в GraphQL нет рекурсии и произвольных условий поиска вроде «родился в США и живёт в Европе», если владельцы сервиса специально их не добавили.
Пример — чат вроде Slack: каналы, 50 последних сообщений, автор каждого и, для ответа, исходное сообщение:
query ChatApp { channels { name recentMessages(latest: 50) { timestamp content sender { fullName imageUrl } replyTo { content sender { fullName } } } }}Ответ повторяет структуру запроса: в нём ровно запрошенные поля. Если интерфейсу понадобится аватар автора исходного сообщения, клиент просто добавит imageUrl в запрос. Имя и аватар автора повторяются в каждом его сообщении, а исходное сообщение копируется в ответ. GraphQL сознательно принимает больший ответ ради простоты интерфейса: иначе клиенту пришлось бы делать лишние запросы.
На сервере данные могут лежать нормализованно, и сервер делает join по ID. Но клиент может запросить только те join, которые объявлены в схеме GraphQL. Несмотря на название, GraphQL работает поверх базы любого типа: реляционной, документной или графовой.
Event sourcing и CQRS
Заголовок раздела «Event sourcing и CQRS»Во всех моделях выше данные читают в той же форме, в какой пишут. Но в сложном приложении одна форма не подходит для всех видов чтения. Тогда данные пишут в одной форме и выводят из неё другие, удобные для чтения. Мы видели эту идею в главе 1, и ETL — её пример.
Для записи проще всего журнал событий (event log). Каждое событие — самодостаточная строка (например, JSON) с меткой времени, которую дописывают в конец. События неизменяемы: их не меняют и не удаляют, а только добавляют новые.
Пример — система для конференции. Участники платят картой, компании покупают места пачкой и платят по счёту, часть мест держат для спикеров, брони отменяют, а организатор может сменить зал. Даже число свободных мест посчитать трудно.
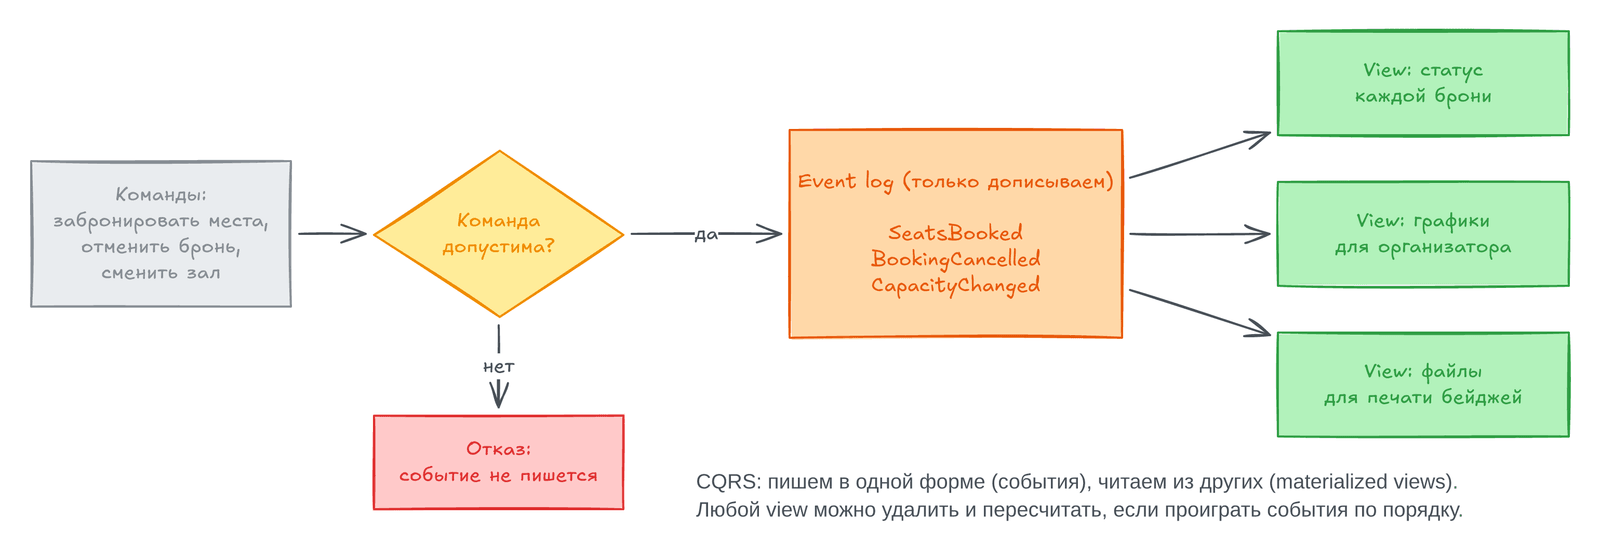
Схема читается слева направо: в журнал попадает только допустимая команда, а из журнала обновляются представления для чтения.
Каждое изменение (открыли регистрацию, забронировали место, отменили бронь) сначала записывают как событие. Затем обновляются materialized view, их также называют проекциями (projections) или моделями для чтения (read models). Одно представление хранит статус брони, другое — графики для организатора, третье — файлы для печати бейджей.
Event sourcing — это подход, в котором события — источник истины, а каждое изменение состояния записано событием. CQRS (command query responsibility segregation) — это принцип: выводить отдельные представления для чтения из формы для записи. Термины пришли из DDD, но идея старая, например репликация конечного автомата (глава 10).
Запрос пользователя — это команда (command). Её сначала проверяют, например хватает ли мест. Только допустимая команда становится фактом и событием в журнале. Поэтому consumer, который строит представление, не вправе отклонить событие. События называют в прошедшем времени («места забронированы»): даже если бронь потом отменят, она была, а отмена — отдельное событие.
Event sourcing похож на таблицу фактов: и там, и там события прошлого. Но у фактов одинаковые столбцы, а событий много типов. И таблица фактов не упорядочена, а в журнале порядок важен: отмена до бронирования бессмысленна.
Плюсы event sourcing и CQRS
Заголовок раздела «Плюсы event sourcing и CQRS»- События объясняют намерение. «Бронь отменена» понятнее, чем «в строке 4001 столбец
activeстал false, а вpaymentsдобавлен возврат». - Представления воспроизводимы. Их можно удалить и пересчитать, обработав те же события в том же порядке. Ошибку в коде представления исправляют и строят представление заново.
- Много представлений под разные запросы. Они могут жить в любой базе и модели, быть денормализованы или даже храниться только в памяти.
- Легко развивать систему. Новое представление строится из старого журнала, можно добавлять новые типы событий и новое поведение, например предлагать освободившееся место из листа ожидания.
- Ошибки исправляются без потерь. Ошибочное событие отменяют новым событием, и представления исправятся сами. Необратимых действий становится меньше.
- Журнал — это аудит. Это важно в регулируемых отраслях.
- Высокий
throughputзаписи. Журнал пишет последовательно и поглощает всплески, а представления догоняют в своём темпе.
Минусы event sourcing и CQRS
Заголовок раздела «Минусы event sourcing и CQRS»- Внешние данные. Если представление переводит цену по курсу из внешнего источника, при пересчёте в другой день результат изменится. Курс надо класть в событие или брать исторический курс на момент события.
- Удаление личных данных. По GDPR пользователь может потребовать удалить данные, а события неизменяемы. Данные можно хранить вне событий или шифровать и удалять ключ (
crypto-shredding), но пересчёт тогда сложнее. - Побочные эффекты. При перестройке представления не стоит заново слать письма с подтверждением.
Event sourcing строят на любой базе или на специальных системах: EventStoreDB, MartenDB, Axon Framework. Журнал можно хранить в message broker вроде Apache Kafka, а представления обновлять потоковой обработкой (глава 12). Главное требование одно: все представления обрабатывают события строго в порядке журнала. В распределённой системе это нелегко (глава 10).
DataFrame, матрицы и массивы
Заголовок раздела «DataFrame, матрицы и массивы»Некоторые модели встречаются в основном в аналитике и науке, а не в OLTP: DataFrame и многомерные массивы чисел. DataFrame есть в R, Pandas, Apache Spark, Dask и других системах. На нём готовят данные для ML, исследуют их и строят графики.
DataFrame похож на таблицу: его можно фильтровать, группировать, применять функцию ко всем строкам и соединять с другим DataFrame (там join называют merge). Но вместо SQL с ним работают серией команд. Так и работает data scientist: шаг за шагом он приводит данные к форме, в которой можно ответить на его вопросы (wrangling). Чаще всего он работает со своей копией данных.
Частая задача — превратить реляционные данные в матрицу, которую ждут ML-алгоритмы. Например, таблицу оценок фильмов превращают в матрицу «пользователь × фильм», как сводную таблицу (pivot table). Матрица разреженная (sparse): многих оценок нет, и это нормально. Столбцов может быть тысячи, что неудобно для реляционной базы, но легко для DataFrame и NumPy. Мы сделаем это в практике ниже.
Матрица хранит только числа. Даты переводят в дробные числа, а категории кодируют через one-hot encoding: на каждое значение (комедия, драма, ужасы) заводят столбец и ставят 1 в столбце нужного значения. Дальше работает линейная алгебра, на которой стоят многие ML-алгоритмы, например рекомендации фильмов.
Есть и массивные базы (array databases), например TileDB, для научных данных: растров, медицинских снимков, наблюдений телескопов. В финансах DataFrame хранит временные ряды цен и сделок. DataFrame популярны у data scientist, поэтому их добавили и во фреймворки пакетной обработки Spark и Flink. К ним авторы вернутся в главе 11.
Итоги главы
Заголовок раздела «Итоги главы»- Реляционная модель остаётся важной, особенно в хранилищах данных, где
star schemaи SQL повсюду. - Документная модель подходит для самодостаточных документов с редкими связями между ними.
- Графовые модели нужны, когда всё связано со всем, а запросы идут по цепочкам связей с помощью рекурсии в Cypher, SPARQL или Datalog.
- DataFrame служит мостом между таблицами и матрицами для ML и статистики.
- Одну модель можно выразить через другую, но неудобно, как граф в SQL.
- Базы расширяются в соседние модели: JSON в реляционных базах,
joinв документных, графы в SQL. Event sourcingхранит неизменяемый журнал событий, аCQRSвыводит из негоmaterialized viewдля чтения.- Схема есть всегда, вопрос лишь в том, явная она (при записи) или неявная (при чтении).
- Вне главы остались геномные базы, двойная бухгалтерия (TigerBeetle), блокчейны и полнотекстовый поиск (глава 4).
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Декларативный язык запросов | Описывает результат, а способ выбирает оптимизатор |
impedance mismatch | Разрыв между объектами в коде и таблицами |
ORM, N+1 | Перевод объектов в таблицы; ошибка ORM с запросом на каждый элемент |
| Нормализация / денормализация | Данные в одном месте и ссылки по ID / копии ради скорости чтения |
hydrating | Подстановка данных по ID в коде, join вне базы |
star schema / snowflake schema | Факты в центре и измерения вокруг / измерения разбиты дальше |
one big table (OBT) | Измерения влиты в таблицу фактов |
schema-on-read / schema-on-write | Схема неявная при чтении / явная при записи |
property graph, triple store | Граф с метками и свойствами / тройки (субъект, предикат, объект) |
| Рекурсивный CTE | WITH RECURSIVE: путь переменной длины в SQL |
event sourcing | События — источник истины |
CQRS | Отдельные представления для чтения из формы для записи |
materialized view | Сохранённое представление, которое обновляется из событий |
one-hot encoding | Столбец на каждое значение категории, 1 в нужном |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Выбирайте модель по связям в данных. Дерево, которое читают целиком: документ. Много общих справочников и many-to-many: реляционная модель. Сложные цепочки связей: граф.
Schema-on-readне отменяет схему: она просто живёт в коде. Дляpipelineфиксируйте контракт полей, иначе ломаются потребители.- Нормализуйте справочники и храните ID. Денормализуйте осознанно и решите, кто поддерживает согласованность копий.
- Для аналитики с JSON-событиями полезны полуструктурированные типы в хранилище (JSON в PostgreSQL и аналогах). Но поля, по которым фильтруете, выносите в отдельные столбцы.
- Предпочитайте декларативные запросы (SQL): их оптимизирует и распараллеливает движок. Пишите императивный код, только если декларативного запроса не хватает.
- Рекурсивные иерархии (категории, оргструктура, lineage таблиц) в SQL делайте через рекурсивный CTE. Если таких обходов много, подумайте о графовой базе.
One big tableв хранилище ускоряет дашборды, но хранит копии измерений. Это нормально для исторических данных, но при изменении атрибута измерения таблицу придётся пересобрать.- Журнал событий (CDC, Kafka) — хороший источник истины для аналитики: витрины можно удалить и пересчитать. Для этого обработка должна быть детерминированной, без вызовов внешних API с плавающим результатом.
- Не пишите личные данные в неизменяемые журналы без плана удаления: заранее решите, где они лежат и как их стереть по запросу.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. Мы построим маленький event sourcing для конференции и превратим таблицу оценок в матрицу, как в разделе про DataFrame.
Шаг 1. Создаём журнал событий и оценки
Заголовок раздела «Шаг 1. Создаём журнал событий и оценки»CREATE OR REPLACE TABLE booking_events ASSELECT * FROM (VALUES (1, TIMESTAMP '2026-03-01 09:00', 'CapacitySet', NULL, 100), (2, TIMESTAMP '2026-03-02 10:15', 'SeatsBooked', 'B1', 30), (3, TIMESTAMP '2026-03-02 11:40', 'SeatsBooked', 'B2', 50), (4, TIMESTAMP '2026-03-03 08:05', 'BookingCancelled', 'B1', 30), (5, TIMESTAMP '2026-03-04 14:20', 'CapacitySet', NULL, 80), (6, TIMESTAMP '2026-03-05 09:30', 'SeatsBooked', 'B3', 20)) AS t(event_id, event_time, event_type, booking_id, seats);
CREATE OR REPLACE TABLE movies ASSELECT * FROM (VALUES ('Матрица', 'sci-fi'), ('Амели', 'comedy'), ('Чужой', 'horror'), ('Брат', 'drama')) AS t(movie, genre);
CREATE OR REPLACE TABLE ratings ASSELECT * FROM (VALUES ('u1', 'Матрица', 5), ('u1', 'Чужой', 4), ('u2', 'Амели', 3), ('u2', 'Брат', 5), ('u2', 'Матрица', 4), ('u3', 'Чужой', 2)) AS t(user_id, movie, rating);События названы в прошедшем времени, как советуют авторы. Событие CapacitySet — организатор сменил зал и вместимость.
Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»SELECT event_type, count(*) AS eventsFROM booking_eventsGROUP BY event_typeORDER BY event_type;
-- отмена брони, которой нет в журнале: должно вернуть 0 строкSELECT c.event_id, c.booking_idFROM booking_events cWHERE c.event_type = 'BookingCancelled' AND NOT EXISTS ( SELECT 1 FROM booking_events b WHERE b.event_type = 'SeatsBooked' AND b.booking_id = c.booking_id AND b.event_id < c.event_id );┌──────────────────┬────────┐│ event_type │ events ││ varchar │ int64 │├──────────────────┼────────┤│ BookingCancelled │ 1 ││ CapacitySet │ 2 ││ SeatsBooked │ 3 │└──────────────────┴────────┘┌──────────┬────────────┐│ event_id │ booking_id ││ int32 │ varchar │├──────────┴────────────┤│ 0 rows │└───────────────────────┘Задания
Заголовок раздела «Задания»1. Представление «статус каждой брони». Постройте из журнала view booking_status: номер брони, число мест и статус active или cancelled.
Решение
CREATE OR REPLACE VIEW booking_status ASSELECT booking_id,       max(seats) FILTER (WHERE event_type = 'SeatsBooked') AS seats,       CASE WHEN bool_or(event_type = 'BookingCancelled') THEN 'cancelled'            ELSE 'active' END AS statusFROM booking_eventsWHERE booking_id IS NOT NULLGROUP BY booking_id;
SELECT * FROM booking_status ORDER BY booking_id;┌────────────┬───────┬───────────┐│ booking_id │ seats │ status ││ varchar │ int32 │ varchar │├────────────┼───────┼───────────┤│ B1 │ 30 │ cancelled ││ B2 │ 50 │ active ││ B3 │ 20 │ active │└────────────┴───────┴───────────┘Это обычный view: он не хранит данные, а каждый раз выводит их из журнала. Удалите его и создайте заново, и результат будет тем же.
2. Представление «свободные места». Посчитайте вместимость, занятые места и свободные места. Учтите, что действует последнее событие CapacitySet.
Решение
WITH capacity AS ( -- действует последнее по порядку событие CapacitySet SELECT seats AS capacity FROM booking_events WHERE event_type = 'CapacitySet' ORDER BY event_id DESC LIMIT 1),taken AS ( SELECT sum(CASE event_type WHEN 'SeatsBooked' THEN seats WHEN 'BookingCancelled' THEN -seats ELSE 0 END) AS taken FROM booking_events)SELECT capacity, taken, capacity - taken AS free_seatsFROM capacity, taken;┌──────────┬────────┬────────────┐│ capacity │ taken │ free_seats ││ int32 │ int128 │ int128 │├──────────┼────────┼────────────┤│ 80 │ 70 │ 10 │└──────────┴────────┴────────────┘Свободно 10 мест. Если перепутать порядок и взять первое событие CapacitySet (ORDER BY event_id), вместимость будет 100, а свободных мест — 30. Так видно, почему в event sourcing порядок событий важен.
3. От таблицы к матрице. Превратите ratings в матрицу «пользователь × фильм», а жанры фильмов закодируйте через one-hot encoding.
Решение
PIVOT ratings ON movie USING first(rating) GROUP BY user_id ORDER BY user_id;
PIVOT movies ON genre USING count(*) GROUP BY movie ORDER BY movie;┌─────────┬───────┬───────┬─────────┬───────┐│ user_id │ Амели │ Брат │ Матрица │ Чужой ││ varchar │ int32 │ int32 │ int32 │ int32 │├─────────┼───────┼───────┼─────────┼───────┤│ u1 │ NULL │ NULL │ 5 │ 4 ││ u2 │ 3 │ 5 │ 4 │ NULL ││ u3 │ NULL │ NULL │ NULL │ 2 │└─────────┴───────┴───────┴─────────┴───────┘┌─────────┬────────┬───────┬────────┬────────┐│ movie │ comedy │ drama │ horror │ sci-fi ││ varchar │ int64 │ int64 │ int64 │ int64 │├─────────┼────────┼───────┼────────┼────────┤│ Амели │ 1 │ 0 │ 0 │ 0 ││ Брат │ 0 │ 1 │ 0 │ 0 ││ Матрица │ 0 │ 0 │ 0 │ 1 ││ Чужой │ 0 │ 0 │ 1 │ 0 │└─────────┴────────┴───────┴────────┴────────┘Первая матрица разреженная: NULL значит, что пользователь фильм не оценивал. Вторая таблица — one-hot encoding: в каждой строке ровно одна единица.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему документная модель хорошо хранит резюме, но плохо подходит для связей many-to-many между людьми и компаниями?
- Когда денормализация оправдана, а когда вредит? Почему X хранит в ленте только ID постов, а не их текст?
- Чем
schema-on-readотличается отschema-on-write? Когда первая удобнее? - Почему запрос с путём переменной длины в SQL намного длиннее, чем в Cypher?
- Почему GraphQL намеренно не поддерживает рекурсию и произвольные условия поиска?
- Почему в
event sourcingважен порядок событий и что мешает пересчитывать представления, если обработка зависит от внешних данных?
Предыдущая: Нефункциональные требования. Следующая: Хранение и извлечение данных.