

Engineering Leadership: The Hard Parts, глава 10: Метрики, которые важны
Главная мысль: метрика нужна, чтобы отвечать на вопрос и помогать решать, а не чтобы украшать слайд. Лучше всего относиться к метрикам как к продукту: у них есть клиенты, владелец и обратная связь. Метрики измеряют команды, а не людей, иначе их начнут обманывать.
О чём глава
Заголовок раздела «О чём глава»Глава отвечает на вопрос «как рассказать о работе инженеров цифрами и не навредить». Предыдущая глава была про совместные практики и принятие решений. Здесь автор показывает, как выбрать метрики и не испортить ими команду. Темы: проектирование метрик, набор DORA, скорость команды, люди и закон Гудхарта, поддержка метрик и ИИ.
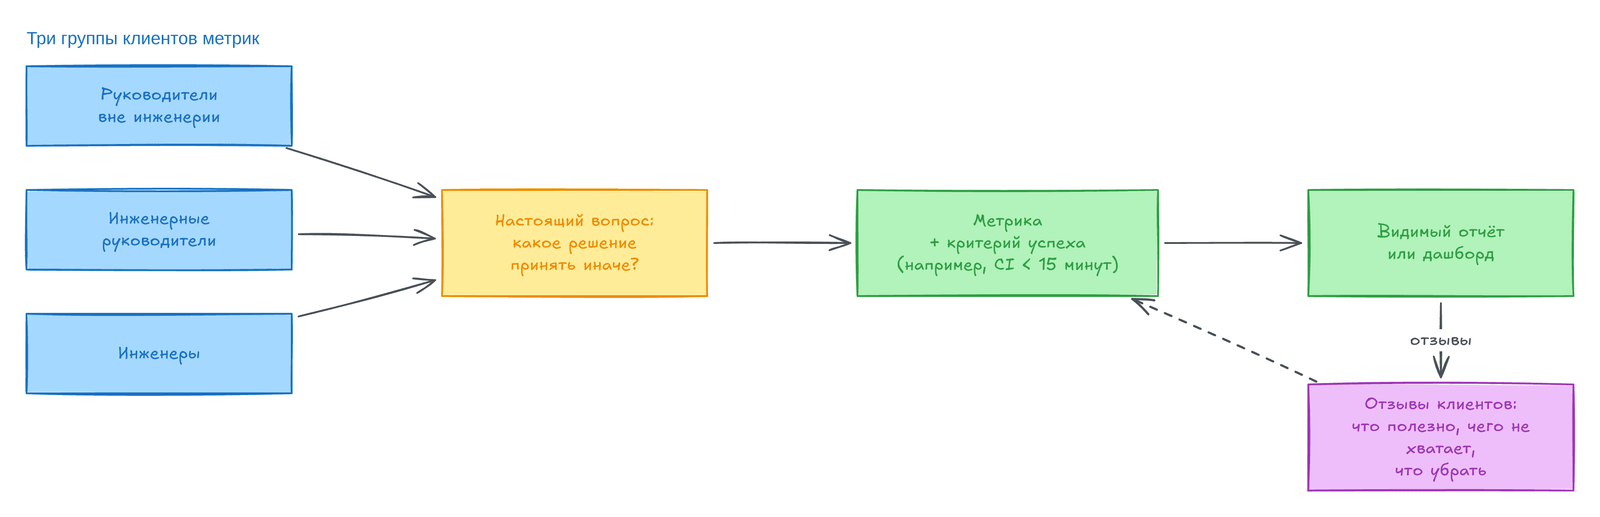
Схема читается слева направо: клиенты задают вопросы, вы находите настоящий вопрос, получаете метрику с критерием успеха и показываете её. Отзывы возвращаются и меняют метрику.
Зачем вообще измерять
Заголовок раздела «Зачем вообще измерять»В хаотичной среде просто удержать всё на плаву — уже победа, и новые отчёты кажутся роскошью. Но без измерений вы не знаете, стало ли лучше: остаётся ощущение, а не реальность. У хороших метрик две задачи:
- Показать проблему, пока она мала и её легко исправить.
- Показать, работают ли улучшения. Новый CI/CD-pipeline кажется победой, но сократил ли он время выкладки и число сбоев?
Есть и тёмная сторона: плохо применённые метрики создают неверные стимулы, демотивируют людей и дают результат хуже, чем отсутствие метрик.
Пример Эйприл. Три senior-инженера PixelCurl по-разному ответили, как дела у команды: «backend держит 10 000 запросов в секунду», «фичи делаются вечность», «баз данных без сбоев». Эйприл ввела
cycle timeфичи от тикета до production. Средний cycle time оказался 47 дней: фичи ходили между изолированными инженерами, которые не могли проверить код друг друга.
Метрики как продукт
Заголовок раздела «Метрики как продукт»Собрать данные и вывести их на дашборд легко: в observability 90% проекта уходит на инфраструктуру и лишь 10% — на анализ. Но данные ещё не знание. Поэтому автор советует считать метрики продуктом. У них есть клиенты: вы и стейкхолдеры, например руководство. Метрика не обязана быть идеальной сразу, но должна служить пользователям и улучшаться.
Проектируйте осознанно
Заголовок раздела «Проектируйте осознанно»Начните с вопроса: кому нужна метрика и зачем. Вопрос должен отвечать на реальную потребность бизнеса, а не быть ещё одним слоем сбора данных без цели. Клиентов три группы, и угадывать их нужды не надо, их можно спросить:
| Клиент | Что ему нужно |
|---|---|
| Инженеры | В 95% случаев метрики о том, как они работают и что им мешает |
| Инженерные руководители (и вы) | Узкие места и что улучшать |
| Руководители вне инженерии | Затраты, отдача от инвестиций, скорость |
Ловушка «хочу» и «нужно»
Заголовок раздела «Ловушка «хочу» и «нужно»»Клиенты часто просят то, что звучит впечатляюще, а не то, что помогает. Джеймс рассказывает про CEO, который просмотрел последние pull request в GitHub и объявил двух инженеров самыми продуктивными: они закоммитили тысячи строк кода, а другие — сотни. Но это frontend-разработчики, которые коммитят npm-пакеты, JavaScript и CSS. Backend-инженеры пишут меньше строк по природе работы.
Пример Эйприл. Вице-президент назвал Маркуса «MVP» за сплошь зелёный график вкладов в GitHub. Эйприл проверила: Маркус делал 50 коммитов в день (форматирование, WIP), Дерек один в неделю, но с протестированной фичей. На её вопрос «какое решение вы бы приняли иначе?» вице-президент ответил: «Никакое». Тогда она перешла на
deployment frequencyиchange failure rate.
Похожие вопросы звучат часто: какая команда самая продуктивная, сколько часов работают инженеры. Не высмеивайте спрашивающего: он пытается измерить область, в которой не уверен. Объясните вежливо, почему метрика вроде строк кода (типичная vanity metric) слишком проста, и предложите лучшую.
Дальше найдите настоящий вопрос. За «какая команда самая продуктивная» обычно стоят предсказуемость поставки и узкие места. Спросите: какие решения помогут принять ответы и что вы сделаете иначе. Часто всё сводится к вопросу «У нас всё хорошо?»: достигнем ли мы целей, получаем ли отдачу от денег, достаточно ли качество.
Как строить вопросы
Заголовок раздела «Как строить вопросы»Сгруппируйте собранное по темам. Общий вопрос («приемлема ли наша скорость разработки?») разбивается на подвопросы по уровням:
- руководство: как быстро мы выпускаем софт;
- инженерное руководство: сколько story points выпускаем, насколько точны оценки;
- инженеры: какой
cycle timeу задачи, сколько длятся CI/CD-запуски.
Начинайте с общей картины и спускайтесь вниз. У каждого ответа должны быть метрика и измеримый критерий успеха. Автор разбирает такой пример:
| Компонент | Пример |
|---|---|
| Вопрос | Сколько длятся CI и CI/CD-запуски на сборку, тесты и выкладку? |
| Критерий успеха | Тесты CI идут меньше 15 минут, запуск CI/CD вместе с выкладкой меньше 30 минут |
| Метрики | Время CI-тестов, время CI/CD-запуска |
| Цель поддержки | В 95% запусков критерии выполняются |
Выберите метрики под свой контекст
Заголовок раздела «Выберите метрики под свой контекст»Нужно ли отслеживать всё? Нет. Перегрузка метриками так же вредна, как их отсутствие. Вам нужен небольшой набор, а не склад. Основа здесь — DORA (DevOps Research and Assessment): метрики проверены временем, говорят о результатах и считаются в большинстве существующих инструментов. Их четыре:
deployment frequency— как часто вы выкладываете в production;lead time for changes— время от коммита до работы в production;change failure rate— доля выкладок, которым нужно срочное исправление;time to restore service— как быстро вы восстанавливаетесь после сбоя.
Они балансируют скорость и качество и касаются того, что важно клиентам и руководству. Затем добавьте одну-две метрики под главную боль:
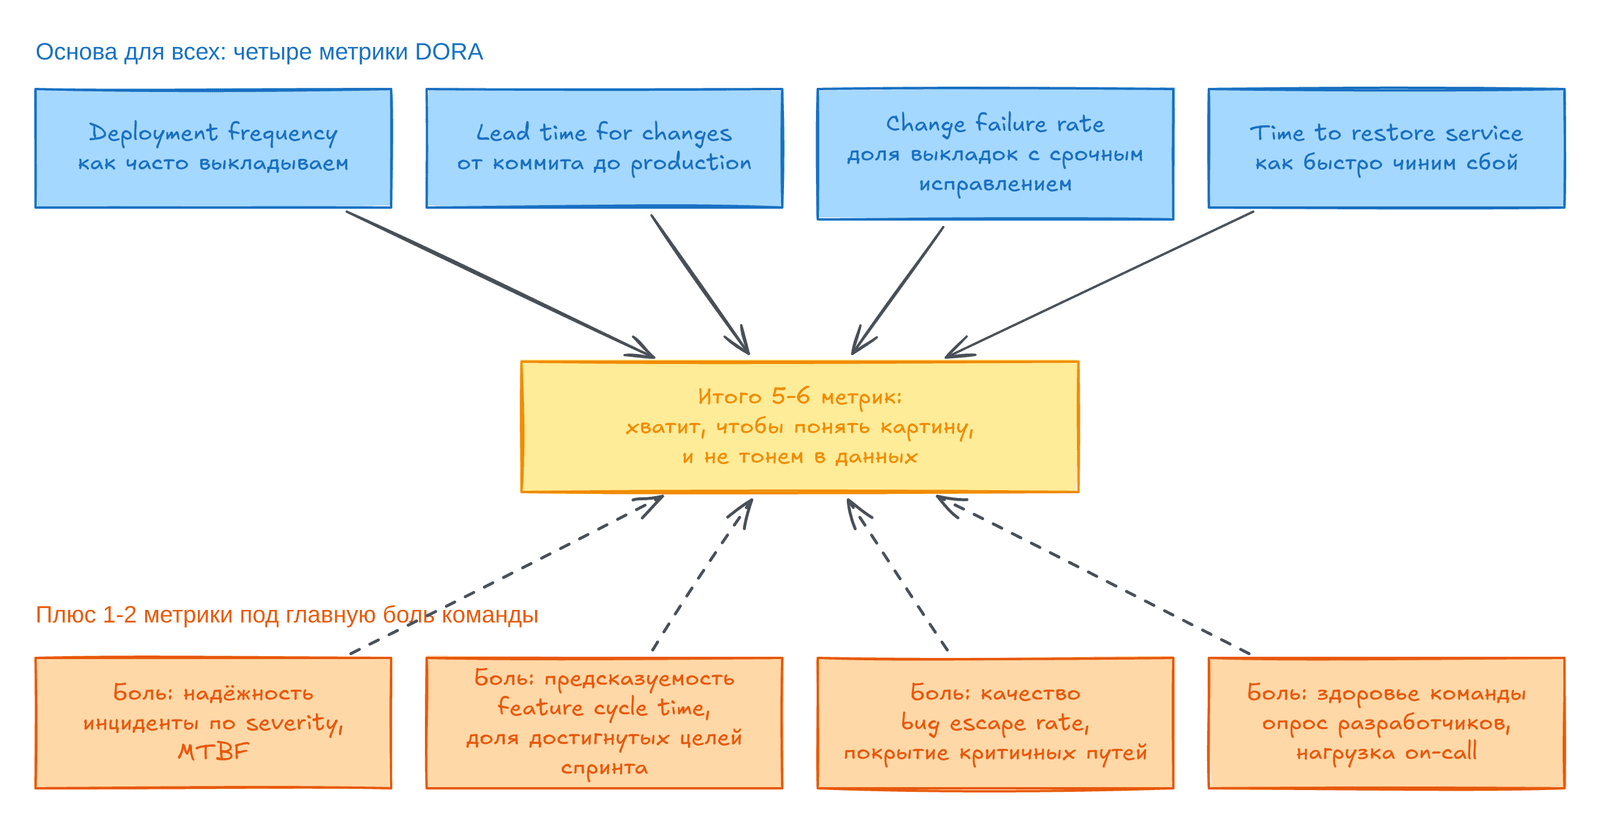
Четыре метрики DORA идут всегда, нижний ряд зависит от боли. Вместе получается пять-шесть метрик: этого хватает для понимания, и команда не тонет в данных. Порядок внедрения:
- Начать с малого: четыре метрики DORA на существующих инструментах.
- Собрать базовые данные за 4–6 недель, до любых изменений.
- Добавить контекст, когда DORA стабильны.
- Раз в квартал смотреть, какие метрики влияют на решения, а какие нет.
Цель не в максимуме по одной метрике, а в балансе: лучшие долгосрочные результаты у команд, которые оптимизируют устойчивую поставку ценного и надёжного софта.
Что вы уже измеряете
Заголовок раздела «Что вы уже измеряете»Данных обычно больше, чем кажется: Git даёт lead time, CI/CD показывает выкладки, трекер даёт cycle time, мониторинг даёт данные для time to restore service. Change failure rate считают по инцидентам или алертам.
Джеймс видел команды, готовые купить дорогую платформу метрик. Потом они связали Jira, GitHub и CircleCI и посчитали все четыре метрики DORA без новых инструментов. Выбор build versus buy всё равно встанет: начните с малого и проверьте, что выбор помогает. Лучшее решение — то, которым команда реально пользуется.
Скорость команды: самая неверно используемая метрика
Заголовок раздела «Скорость команды: самая неверно используемая метрика»Скорость команды (velocity) показывает, сколько работы команда закрывает за спринт. Автор прямо говорит: это инструмент планирования загрузки, а не метрика продуктивности. Сравнивать по ней команды так же бессмысленно, как расход топлива у спорткара и грузовика.
Почему скорость идёт не туда
Заголовок раздела «Почему скорость идёт не туда»- Оценка эффективности. «У A 50 points, у B 30, значит A лучше». Points произвольны и свои у каждой команды: у B могут быть сложнее задачи или больше технический долг.
- Цели по прошлому пику. «Один раз было 45, это теперь база». Команды раздувают оценки или режут углы, и растёт технический долг.
- Сравнение команд. Команды оценивают по-разному и решают разные задачи.
Джеймс рассказывает, как организация «стандартизировала» story points ради сравнимости. Команды спорили об оценках, а не о технике, и менеджмент отказался от затеи.
Пример Эйприл. Предшественница вывесила личные points на доске лидеров: Маркус дробил задачи, Сара завышала оценки, Дерек перестал стараться. Эйприл сняла доску и стала считать скорость команды приватно, по скользящему среднему за три спринта.
Как использовать скорость правильно
Заголовок раздела «Как использовать скорость правильно»- Планируйте по ней загрузку: «по средней скорости в следующий спринт возьмём примерно пять историй».
- Следите за резкими падениями и скачками: это повод разобраться.
- Держите её внутри команды и не несите наверх.
Цель не в максимальной скорости, а в ценном качественном софте в устойчивом темпе. Одна команда считала её приватно. Когда скорость упала на 40% за два спринта, они честно обсудили причину и нашли технический долг в критичном компоненте. Метрика их не судила, поэтому они спокойно убедили product owner выделить спринт на долг.
Человеческая сторона метрик
Заголовок раздела «Человеческая сторона метрик»Метрики служат людям, а не наоборот. Чтобы получать улучшение вместо страха, нужна психологическая безопасность.
Измеряйте команды, не людей. Личные метрики почти всегда создают нездоровую конкуренцию. Но это не значит игнорировать личную работу: важно различать измерение человека и поиск того, кому нужна поддержка. Проблемы человека почти всегда видны в качественных сигналах раньше, чем в цифрах:
- Ревью кода: его
pull requestпостоянно требуют большой переделки. - Сотрудничество: он молчит в обсуждениях и не помогает коллегам.
- Поставка: он срывает обязательства спринта и тратит на похожие задачи больше времени, чем другие.
- Передача знаний: он не может ясно объяснить свою работу и не учится на обратной связи.
Метрики как контекст, а не приговор. Если cycle time команды вырос и у одного человека проблемы с ревью, это повод для коучинга, а не для оценки.
Поддержка, а не слежка. Цель в том, чтобы увидеть, кому нужна помощь: ментор, обучение или ясные требования. Говорите «чем я могу помочь тебе?», а не «у тебя низкие цифры».
Привлекайте команду к выбору метрик. Люди поддерживают то, что помогли создать.
Культура без поиска виноватых (blameless culture). Когда что-то ломается, ищите, чему научиться, а не кого обвинить. Причины часто системные: неясные требования, технический долг, пробелы в знаниях. Метрики этого не покажут.
Пример Эйприл. Она замерила время ревью по ревьюерам. Дерек оказался втрое медленнее других. Когда Эйприл показала эту метрику всем, он стал одобрять код без проверки, и пропущенных в production багов стало втрое больше. Оказалось, что его ревью ловили 89% багов до production, а быстрые ревьюеры пропускали критичные ошибки. Эйприл стала мерить командное время ревью вместе с долей пропущенных багов и поставила Дерека в пару к джуниорам.
Лучшие выводы о человеке дают встречи один на один (one-on-one), отзывы коллег и наблюдение за работой. Метрики дополняют эти разговоры, но не заменяют их.
Количество и качество
Заголовок раздела «Количество и качество»Цифры показывают часть картины, а причина может быть не технической. Добавьте в ретроспективы вопросы о настроении, спросите клиентов (NPS или три смайлика после закрытия тикета). Лучшие выводы дают тренды вместе с объяснениями.
Люди меняют поведение из-за метрик
Заголовок раздела «Люди меняют поведение из-за метрик»Команда не только читает метрики, но и меняет под них поведение.
Закон Гудхарта
Заголовок раздела «Закон Гудхарта»Закон Гудхарта гласит: «когда мера становится целью, она перестаёт быть хорошей мерой». Если мерить только число фич или доступность, команда сосредоточится на них в ущерб остальному. То же верно для затрат, как в главе 7: погоня за экономией потом стоит дороже. Помогает смотреть и на объём, и на результат (outcome): важно не только число фич, но и нужны ли они клиентам.
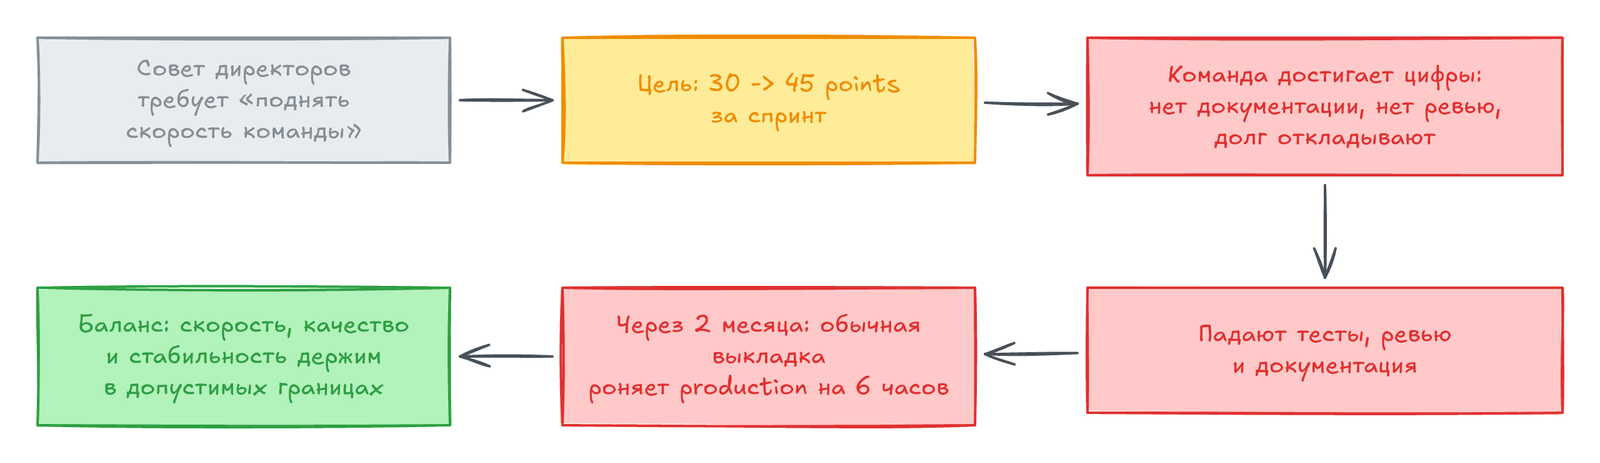
Схема читается по змейке: сначала вправо, потом вниз и влево. Цепочка такая: требование совета директоров, цифра, падение качества, простой и наконец исправление.
Пример Эйприл. Совет директоров потребовал «улучшить скорость», и Эйприл подняла points с 30 до 45. Команда достигла цифры без документации, без ревью «тривиальных» правок и с отложенным долгом. Через два месяца обычная выкладка уронила production на 6 часов. Эйприл показала связь: когда скорость стала целью, упали тестовое покрытие, тщательность ревью и документация. Она ввела баланс метрик (
balanced scorecard): скорость, качество и стабильность в допустимых границах.
К этому близок эффект ожиданий (demand characteristics): человек догадывается, зачем его измеряют, и бессознательно меняет поведение.
Метрика без контекста
Заголовок раздела «Метрика без контекста»Метрика без контекста бессмысленна или вводит в заблуждение. Объясняйте, что она измеряет и что значит её значение, особенно выброс: иначе аудитория додумает сама, и не то, что вы хотели.
«Что измеряют, то и делают»
Заголовок раздела ««Что измеряют, то и делают»»Фраза звучит хорошо, но то, что не измеряют, остаётся без внимания. Возникает невидимая работа: наставничество, документация, внимательное ревью. Если метрики только про скорость и фичи, на второй план уходят погашение технического долга, улучшение безопасности и обновление инфраструктуры: эта работа не двигает измеряемые цифры.
Мерить всё не нужно: это хаос и усталость от метрик. Прямо скажите, чего вы не измеряете и почему это важно, и раз в квартал меняйте фокус-метрики. Оставьте время на неизмеряемое: знаменитые «20% времени» в Google были признанием того, что не всё ценное можно мерить.
Сделайте метрики видимыми
Заголовок раздела «Сделайте метрики видимыми»Метрика в дашборде, который никто не открывает, не существует. Покажите ключевые метрики на общих экранах, шлите отчёты в каналы команды и обсуждайте на встречах. Форма может быть любой, например отчёты для воркшопов, но смотрите, как аудитория читает метрики, и меняйте их, если люди путаются.
Метрики нужно поддерживать, как код
Заголовок раздела «Метрики нужно поддерживать, как код»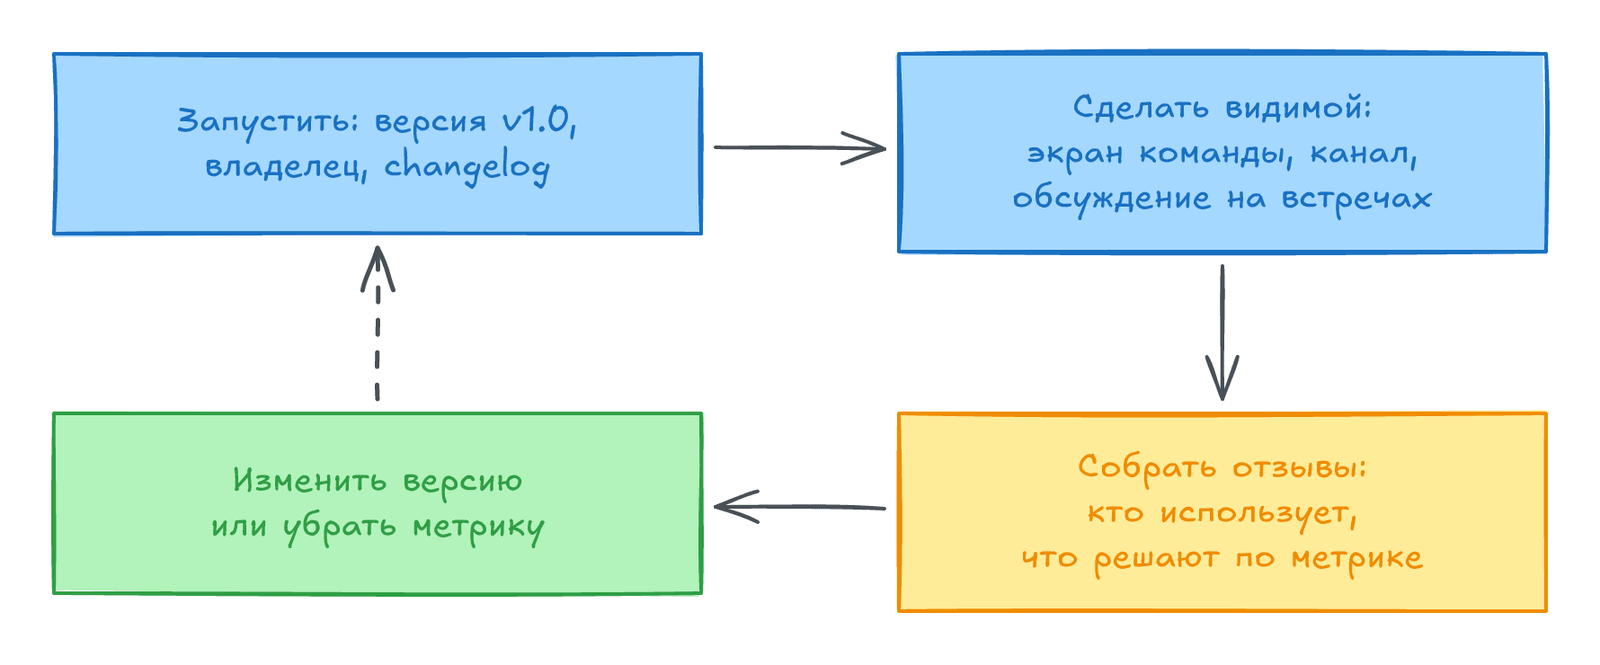
Схема показывает цикл: запуск, видимость, отзывы, изменение или удаление.
- Версии и changelog. Записывайте, что и почему меняли. Мелкие правки дают минорную версию (с v1.1 на v1.2), ломающие сравнение с историей мажорную (с v1.0 на v2.0).
- Ясный владелец. Без владельца метрики незаметно ломаются. Он следит за качеством данных и связью с целями команды. Это не значит, что всё делает один человек, но он работает как продакт-менеджер метрик.
- Слушайте пользователей. Встречи, опросы, наблюдение, какие метрики влияют на решения. Метрики, полезные только в теории, убирайте: лучше меньше, но ценнее.
- Следите за средой. Источники данных и практики меняются: после перехода на trunk-based development метрики
pull requestпридётся обновить. - Выводите метрики из обращения. Перед удалением проверьте, использует ли её кто-то и сохранена ли история.
ИИ не меняет подход к метрикам
Заголовок раздела «ИИ не меняет подход к метрикам»Когда ИИ-инструменты входят в разработку, подход остаётся прежним: нужны сбалансированные метрики. Меняются измерения: сравнивайте работу с ИИ и без него по эффективности и качеству, меряйте удовлетворённость инструментами, дефекты, сроки фич, объём сгенерированного кода. Появляется и новое измерение: доверие инженеров к коду и подсказкам ИИ. Без доверия инструменты не приживутся.
Пример Эйприл. Вице-президент ждал, что Copilot удвоит скорость. Эйприл разделила метрики на работу с ИИ и без: ИИ ускорил шаблонный код втрое, а сложную логику почти нет. Джуниоры выпускали на 40% быстрее, но с вдвое большим числом багов. Она добавила метрики: долю кода ИИ, прошедшего ревью, и время на отладку подсказок.
Итоги главы
Заголовок раздела «Итоги главы»- Без измерений нельзя узнать, улучшилась ли команда: метрики показывают проблемы рано и проверяют улучшения.
- Метрики стоит делать как продукт: с клиентами, вопросом, критерием успеха и обратной связью.
- За просьбой «покажите продуктивность» обычно стоит вопрос «у нас всё хорошо?». Ответьте на него, а не на запрошенную цифру.
- Основа набора — это четыре метрики
DORAплюс одна-две под главную боль: всего пять-шесть. - Сначала посмотрите, что уже есть в Git, CI/CD, трекере и мониторинге, и только потом покупайте платформу.
- Скорость команды служит для планирования загрузки внутри команды, а не для сравнения команд и людей.
- Мерьте команды, а не людей: метрики дают контекст для разговора, но не заменяют его.
- Закон Гудхарта: метрика, ставшая целью, портится. Защита: баланс скорости, качества и стабильности и время на неизмеряемое.
- Метрикам нужны версии, владелец, видимость и удаление, когда они устарели.
- ИИ меняет конкретные измерения, но не подход.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
DORA | Четыре метрики поставки: deployment frequency, lead time for changes, change failure rate, time to restore service |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Для pipeline данных начните с DORA: как часто выкладываете, сколько идёт от коммита до production, какая доля выкладок ломает данные, как быстро чините.
- Поставьте критерий успеха для CI (например, тесты dbt меньше 15 минут) и следите, что он выполняется в 95% запусков.
- Не публикуйте метрики по людям: время ревью или число коммитов инженера.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему автор советует считать метрики продуктом? Кто их клиенты?
- Руководитель просит показать, какой инженер самый продуктивный. Что вы ответите и какие два вопроса зададите?
- Из чего состоит набор метрик по совету автора и почему не стоит отслеживать всё?
- Почему скорость команды не годится для сравнения команд? Как её применять правильно?
- Как закон Гудхарта сработал в истории Эйприл со скоростью 45 points? Как защититься от него?
- Что такое невидимая работа и как не дать ей исчезнуть из-за метрик?
Предыдущая: Совместные практики и принятие решений. Следующая: Собираем всё вместе.