

Designing Data-Intensive Applications, глава 13: Философия потоковых систем
Главная мысль: ни один инструмент не закрывает все задачи, поэтому приложение собирают из нескольких систем. Авторы предлагают связывать их через упорядоченный журнал событий: одна система хранит исходные данные, остальные выводятся из неё. Корректность такой сборки дают не распределённые транзакции, а сквозные идентификаторы запросов, идемпотентность и регулярная проверка данных.
О чём глава
Заголовок раздела «О чём глава»Эта глава спорнее остальных: авторы не сравнивают подходы, а защищают один взгляд на построение систем. Они собирают идеи всей книги (надёжность, масштабируемость, простоту сопровождения из главы 2) и развивают событийную архитектуру из главы 12. Главные темы:
- интеграция разных систем через производные данные и журнал событий;
- пакетная и потоковая обработка как способ поддерживать и перестраивать производные данные;
unbundling— «разборка» базы данных на отдельные инструменты;- приложения вокруг потока данных (
dataflow),write pathиread path; - корректность:
end-to-end argument, ограничения уникальности, своевременность и целостность, аудит.
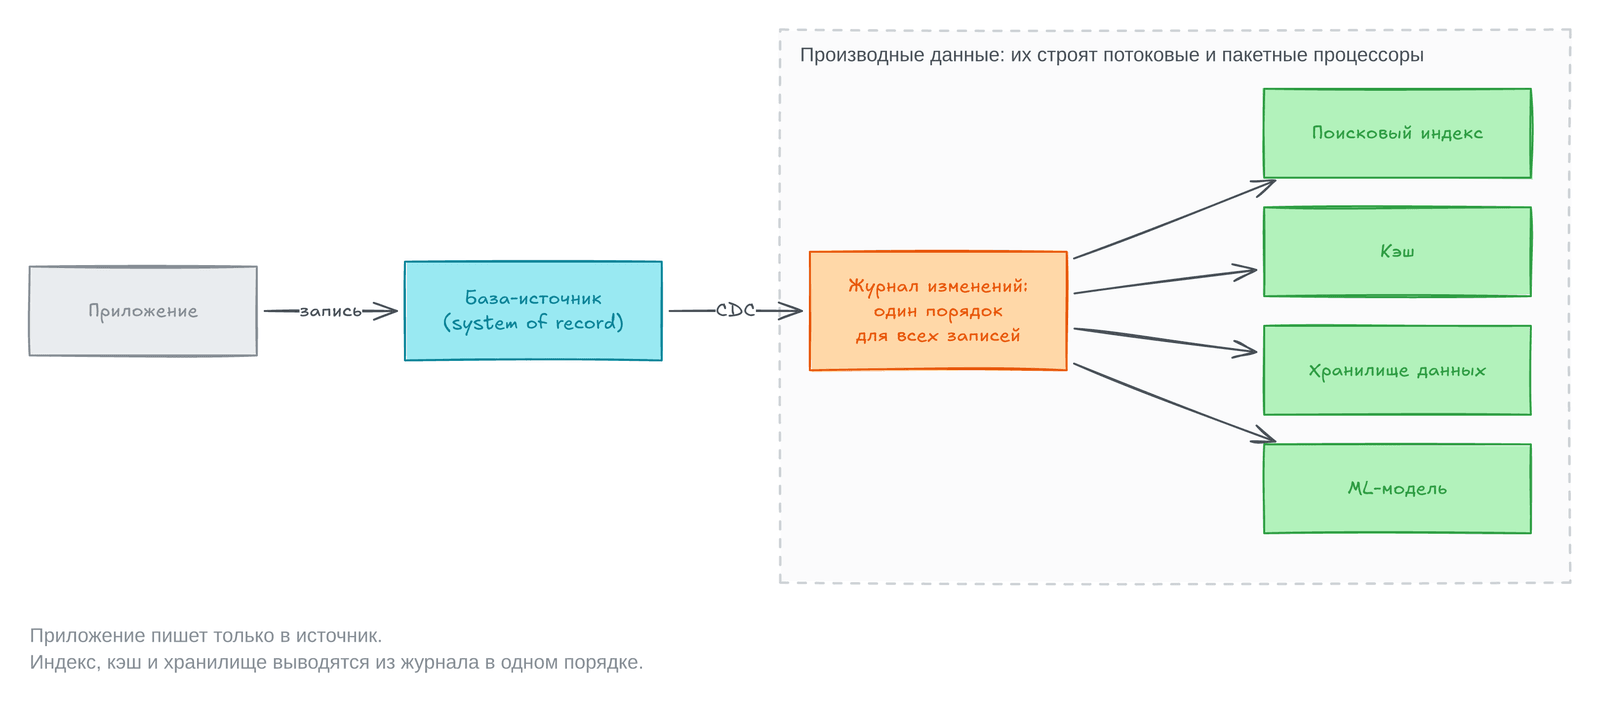
Схему читаем слева направо. Приложение пишет только в одну базу. Всё справа — производные данные: их строят из журнала изменений, и каждую копию можно перестроить заново.
Интеграция данных
Заголовок раздела «Интеграция данных»У каждой задачи есть несколько решений со своими компромиссами (trade-off): для хранения есть журнальные движки, B-tree и колоночное хранение, для репликации — схемы с одним leader, с несколькими или без него. Программа обычно выбирает один подход: сделать надёжным даже один путь кода трудно, а продукт, который закрывает всё подряд, каждую функцию делает хуже специализированного инструмента. Поэтому даже «универсальная» база рассчитана на свой тип нагрузки.
Отсюда две задачи. Первая — понять, какой инструмент подходит к каким условиям; продавцы о слабых местах молчат, и предыдущие главы дают вопросы, чтобы читать между строк. Вторая — в сложном приложении данные используют по-разному, одна программа не подходит для всех способов, и систему приходится собирать из нескольких частей.
Как объединить специализированные инструменты через производные данные
Заголовок раздела «Как объединить специализированные инструменты через производные данные»Типичный пример — OLTP-база и поисковый индекс. Встроенного полнотекстового поиска PostgreSQL хватит простому приложению, но для сложного поиска нужны специальные инструменты. А поисковый индекс плохо подходит как надёжный источник истины, поэтому многие приложения держат обе системы.
Чем больше представлений у данных, тем труднее интеграция. Данные бывают нужны ещё в хранилище данных (data warehouse), в кэшах и денормализованных копиях, в ML-моделях и рекомендациях, а по их изменениям отправляют уведомления.
Как рассуждать о потоках данных
Заголовок раздела «Как рассуждать о потоках данных»Если одни данные лежат в нескольких системах, нужно ясно описать входы и выходы: куда данные пишут сначала и какое представление из чего выводится.
Например, приложение пишет только в основную базу (system of record), а CDC (change data capture) забирает её изменения и в том же порядке применяет к индексу. Если CDC — единственный путь в индекс, индекс целиком выводится из базы и согласован с ней (если в коде нет ошибок).
Если же приложение само пишет и в базу, и в индекс, возникает проблема dual writes из главы 12: две системы применяют конфликтующие записи в разном порядке. Ни одна из них не отвечает за порядок, и они могут разойтись навсегда.
Решение — пропустить весь ввод через одну систему, которая задаёт порядок записей, и строить остальные представления в том же порядке. Это репликация через конечный автомат (state machine replication) из главы о консенсусе. Важен сам принцип единого порядка, а CDC это или журнал event sourcing — второстепенно. Обновление из журнала обычно можно сделать детерминированным и идемпотентным, поэтому после сбоя систему легко восстановить.
Производные данные или распределённые транзакции
Заголовок раздела «Производные данные или распределённые транзакции»Классический способ согласовать системы — распределённые транзакции и two-phase commit (2PC). Цель та же, средства разные: транзакции применяют изменения атомарно через протокол commit, а журнальные системы достигают корректности детерминированными повторами и идемпотентностью.
Главное различие в свежести чтения. Транзакция обычно гарантирует, что после записи вы сразу прочитаете новое значение. Производные системы обновляются асинхронно, и такой гарантии у них по умолчанию нет.
Распределённые транзакции успешно работают там, где готовы платить за их медленность и сложность эксплуатации. Но у XA — стандарта распределённых транзакций между разными системами — плохая отказоустойчивость и низкая скорость. Лучший протокол, возможно, и можно придумать, но внедрить его во все инструменты трудно, и скоро это не случится.
Поэтому авторы считают производные данные на основе журнала самым перспективным способом интеграции. При этом чтение своих записей (read-your-writes) — полезная гарантия, и просто сказать всем «eventual consistency неизбежна, привыкайте» бесполезно, если не объяснить, как с ней жить. Дальше авторы ищут середину между двумя подходами.
Пределы полного порядка
Заголовок раздела «Пределы полного порядка»Для небольшой системы журнал с полным порядком строится легко: так работает любая база с одним leader. Но с ростом нагрузки появляются пределы:
- Полный порядок обычно требует одного узла-
leader. Еслиthroughputбольше, чем тянет одна машина, журнал делят наshard, и порядок событий в разныхshardне определён. - В нескольких регионах у каждого дата-центра обычно свой
leader, потому что синхронная координация между ними слишком медленная. Порядок событий из разных дата-центров не определён. - У микросервисов, которые хранят состояние отдельно, нет общего порядка событий.
- Приложения, которые меняют состояние на клиенте сразу и работают офлайн, почти наверняка видят события не в том порядке, что сервер.
Формально задача называется total order broadcast, и она равносильна консенсусу. Большинство алгоритмов консенсуса рассчитаны на то, что одного узла хватает на весь поток, и делить работу по упорядочиванию не умеют.
Порядок событий и причинность
Заголовок раздела «Порядок событий и причинность»Если события не связаны причинно, порядок неважен. Все изменения одного объекта тоже легко упорядочить: их направляют в один shard по ID объекта. Но причинная связь бывает скрытой.
Пример из соцсети. Пара рассталась: один удаляет другого из друзей и потом пишет друзьям грубое сообщение о бывшем партнёре, рассчитывая, что тот его не увидит. Но если дружбы хранятся в одной системе, а сообщения в другой, сервис уведомлений может обработать сообщение раньше удаления из друзей и уведомить бывшего партнёра.
По сути, уведомления — это join сообщений со списком друзей, то есть та же проблема join, который зависит от времени, что и в главе 12. Простого ответа нет, есть отправные точки:
- Логические метки времени дают полный порядок без координации, но получателю всё равно нужно обрабатывать события не по порядку и передавать метаданные.
- Можно записать событие «что видел пользователь перед решением» с уникальным ID, и следующие события сошлются на него.
- Алгоритмы разрешения конфликтов помогают с состоянием, но не с внешними эффектами вроде уведомлений.
Пакетная и потоковая обработка
Заголовок раздела «Пакетная и потоковая обработка»Цель интеграции — чтобы данные в правильном виде попали во все нужные места. Пакетные и потоковые процессоры читают, преобразуют, соединяют, агрегируют данные и обучают модели. Их выход — производные данные: индексы, материализованные представления, рекомендации, метрики. Главное различие между ними одно: поток не ограничен, а у пакетного задания вход конечный.
Поддержка производного состояния
Заголовок раздела «Поддержка производного состояния»Пакетная обработка близка к функциональному стилю: детерминированные чистые функции без побочных эффектов, неизменяемый вход и выход, который только дописывается. Потоковая устроена так же, но добавляет управляемое отказоустойчивое состояние.
Такие функции полезны не только для отказоустойчивости: с ними проще понять потоки данных во всей компании. Индекс, модель или кэш удобно считать результатом pipeline, который выводит одно из другого.
Производные системы можно обновлять и синхронно, как база обновляет вторичный индекс в той же транзакции. Но надёжность систем на журналах держится на асинхронности: сбой в одной части остаётся локальным. Распределённая транзакция отменяется, если упал любой участник, и так разносит сбой по системе.
Вторичный индекс в системе с sharding часто пересекает границы shard: запись приходится слать в несколько из них или чтение — во все. Такая связь между частями тоже надёжнее и лучше масштабируется, если индекс обновлять асинхронно.
Повторная обработка данных при развитии приложения
Заголовок раздела «Повторная обработка данных при развитии приложения»Потоковая обработка быстро отражает изменения в представлениях, а пакетная позволяет заново обработать накопленную историю и получить новые представления. Без повторной обработки schema evolution ограничена простыми шагами вроде нового необязательного поля. С ней набор данных можно перестроить в совсем другую модель.
Авторы приводят пример из железных дорог. В Англии XIX века конкурировали разные стандарты ширины колеи. Единый стандарт выбрали в 1846 году, и старые пути переделывали, не закрывая линий. К пути добавляли третий рельс, и по нему ходили поезда обеих колей, а когда все поезда переводили на стандарт, лишний рельс снимали. Это дорого, поэтому нестандартная колея кое-где осталась, например у системы BART под Сан-Франциско.
С данными так же: старая и новая схема живут рядом как два производных представления одних данных. Сначала на новое переводят немного пользователей и ищут ошибки, потом долю увеличивают и в итоге удаляют старое. Каждый шаг легко отменить, поэтому команда смелее вносит изменения и движется быстрее.
Объединение пакетной и потоковой обработки
Заголовок раздела «Объединение пакетной и потоковой обработки»Ранней попыткой объединить два вида обработки была lambda-архитектура, но из-за многих проблем её почти перестали использовать. Новые системы делают и пакетные, и потоковые вычисления в одном движке — это иногда называют kappa-архитектурой. Для этого нужны три возможности:
| Возможность | Зачем она нужна |
|---|---|
| Повтор исторических событий через тот же движок | Журнальный message broker умеет перечитывать сообщения, а некоторые потоковые процессоры читают вход из распределённой файловой системы или объектного хранилища |
Семантика exactly-once | Выход такой же, как если бы сбоев не было. Как и в пакетной обработке, частичный выход упавших задач отбрасывают |
| Окна по времени события, а не по времени обработки | При повторной обработке истории время обработки ничего не значит. Например, Apache Beam описывает такие вычисления, а запускают их Apache Flink или Google Cloud Dataflow |
Unbundling: разборка базы данных
Заголовок раздела «Unbundling: разборка базы данных»Базы данных, пакетные и потоковые процессоры и операционные системы по сути делают одно: хранят данные и дают их обрабатывать. Различий на практике много: например, каталог из 10 миллионов мелких файлов для файловой системы — проблема, а 10 миллионов записей для базы — норма.
Unix и реляционные базы подошли к задаче с разных сторон. Unix дал низкоуровневую абстракцию над железом: каналы (pipes) и файлы как последовательности байт. Базы спрятали устройство диска, конкурентный доступ и восстановление за SQL и транзакциями.
Unix «проще» как тонкая обёртка над железом, а база «проще» тем, что короткий декларативный запрос использует оптимизатор, индексы и репликацию, и автору запроса не нужно знать их устройство. Спор идёт с 1970-х: движение NoSQL можно понять как перенос подхода Unix в распределённое OLTP-хранение. Авторы хотят взять лучшее от обоих.
Как собрать хранение данных из частей
Заголовок раздела «Как собрать хранение данных из частей»В книге мы видели много функций баз данных:
- вторичные индексы для быстрого поиска по значению поля;
- материализованные представления — заранее вычисленный кэш результатов запросов;
- журналы репликации, которые держат копии данных на других узлах в актуальном виде;
- полнотекстовые индексы для поиска по словам, встроенные в некоторые реляционные базы.
Те же темы были в главах 11 и 12: полнотекстовые индексы, материализованные представления и CDC. Функции внутри баз похожи на производные системы из пакетных и потоковых процессоров.
Создание индекса
Заголовок раздела «Создание индекса»При CREATE INDEX база читает согласованный снимок таблицы, сортирует значения полей и пишет индекс. Затем она догоняет записи, пришедшие после снимка, и дальше обновляет индекс при каждой транзакции.
Это почти то же, что запуск новой реплики-follower или старт CDC с начального снимка. По сути, CREATE INDEX заново обрабатывает данные и выводит из них новое представление.
Метабаза данных всего
Заголовок раздела «Метабаза данных всего»С этой точки зрения поток данных всей компании похож на одну огромную базу. Пакетный, потоковый или ETL-процесс, который переносит данные из одного места и формата в другое, делает то же, что подсистема обновления индексов.
Пакетные и потоковые процессоры — это сложные триггеры, хранимые процедуры и обновление материализованных представлений, а производные системы — разные типы индексов. Только эти функции выполняют разные программы на разных машинах под управлением разных команд.
Если ни одна модель данных не подходит для всех способов доступа, собрать инструменты в цельную систему можно двумя путями:
| Путь | Что объединяет | Как работает | Традиция |
|---|---|---|---|
Федеративная база данных (federated database, polystore) | Чтение | Один интерфейс запросов над многими движками хранения. Примеры: foreign data wrapper в PostgreSQL, движки федеративных запросов Trino, Hoptimator, Xorq. Приложения по-прежнему могут ходить в движки напрямую | Реляционная: одна система, высокоуровневый язык, красивая семантика, сложная реализация |
Разобранная база данных (unbundled database) | Запись | Изменения надёжно доходят до всех систем через CDC и журналы событий, даже при сбоях. Это как вынести поддержку индексов из базы наружу | Unix: маленькие инструменты делают одно дело хорошо, общаются через простой низкоуровневый API (каналы) и собираются языком высокого уровня (shell) |
Как заставить unbundling работать
Заголовок раздела «Как заставить unbundling работать»Федерация и unbundling — две стороны одной задачи. Отобразить одну модель данных в другую для чтения вполне реально, а синхронизировать запись в несколько систем гораздо труднее, поэтому авторы сосредоточены на записи.
Транзакции внутри одной системы работают. Например, некоторые потоковые процессоры внутри используют распределённые транзакции для exactly-once. Но между системами разных разработчиков (потоковый процессор и key-value хранилище или поисковый индекс) стандартного протокола нет. Поэтому на границе технологий асинхронный журнал событий с идемпотентными consumer гораздо проще и надёжнее.
Главное преимущество интеграции через журнал — слабая связанность. Она работает на двух уровнях:
- Уровень системы. Если
consumerтормозит или упал, журнал копит сообщения, а остальные работают дальше. Починенныйconsumerдогонит журнал и ничего не потеряет. Синхронные распределённые транзакции, наоборот, превращают локальный сбой в большую аварию. - Уровень людей. Команды независимо развивают свои компоненты и общаются через ясные интерфейсы. Журнал событий как интерфейс сохраняет довольно сильные свойства согласованности (долговечность и порядок событий) и при этом подходит почти для любых данных.
Разобранные или цельные системы
Заголовок раздела «Разобранные или цельные системы»Даже если unbundling станет будущим, базы никуда не денутся: они хранят состояние потоковых процессоров и отдают результаты обработки. Специализированные движки, например в хранилищах данных, тоже останутся.
У сборки есть цена: у каждой программы свой порог входа и свои странности, поэтому частей должно быть как можно меньше. Цельный продукт на своей нагрузке работает быстрее и предсказуемее. Строить под ненужный масштаб — преждевременная оптимизация, которая запирает в негибкой архитектуре.
Цель unbundling — не обогнать отдельную базу, а обслужить более широкий круг нагрузок, комбинируя несколько баз. Речь о широте, а не о глубине. Если одна технология делает всё нужное, берите её.
Инструменты для сборки становятся лучше: Debezium извлекает потоки изменений из многих баз, протокол Kafka стал стандартом де-факто, а движки инкрементального обновления представлений (incremental view maintenance) поддерживают кэши сложных запросов.
Приложения вокруг потока данных
Заголовок раздела «Приложения вокруг потока данных»Идея не нова. В электронной таблице формула в ячейке пересчитывается сама при изменении любого входа. Того же мы хотим от систем данных: изменилась запись — обновились все зависящие от неё индексы и кэши, а мы просто доверяем, что это работает.
Выходит, системам данных ещё есть чему поучиться у электронной таблицы VisiCalc 1979 года. Но они ещё должны быть отказоустойчивыми, масштабируемыми и объединять технологии разных команд: ждать, что всё напишут на одном языке, нереалистично.
Код приложения как функция вывода
Заголовок раздела «Код приложения как функция вывода»Когда один набор данных выводится из другого, он проходит через функцию преобразования:
- Вторичный индекс — простая функция. Для каждой строки она выбирает значения индексируемых столбцов и сортирует по ним.
- Полнотекстовый индекс строят функции обработки языка (разбиение на слова, стемминг, синонимы) плюс обратный индекс (
inverted index). - ML-модель выводится из обучающих данных через извлечение признаков и статистику, а её прогнозы — из новых данных и параметров.
- Кэш хранит данные в том виде, в каком их покажет интерфейс. Меняется интерфейс — меняют правила заполнения кэша и перестраивают его.
Функцию вторичного индекса встроили в базы (CREATE INDEX). Сложный полнотекстовый поиск требует настройки, а построение признаков (feature engineering) в ML сильно зависит от приложения. Для нестандартной функции нужен свой код, и здесь базы слабы: триггеры, хранимые процедуры и пользовательские функции всегда были в них на втором плане.
Код отдельно от состояния
Заголовок раздела «Код отдельно от состояния»В теории база могла бы запускать любой код, как ОС. На практике база плохо подходит для нужд разработки: зависимости, контроль версий, постепенное обновление (rolling upgrade), мониторинг, сетевые вызовы. Kubernetes, Docker, Mesos и YARN созданы именно для запуска кода и делают это гораздо лучше.
Большинство веб-приложений — сервисы без состояния (stateless): любой запрос может попасть на любой сервер, а состояние живёт в базе. Логику не кладут в базу, а постоянное состояние — в приложение. В функциональном программировании шутят: «Мы верим в отделение Чёрча от государства» (Алонзо Чёрч создал лямбда-исчисление, в котором нет изменяемого состояния, state).
В такой модели база — изменяемая общая переменная, доступная по сети. Но на изменения переменной в большинстве языков нельзя подписаться (шаблон observer приходится писать самому). Базы унаследовали этот пассивный подход: чтобы узнать об изменениях, приходится повторять запрос (polling), а подписка только начинает появляться.
Dataflow: состояние и код работают вместе
Заголовок раздела «Dataflow: состояние и код работают вместе»В подходе dataflow база — уже не пассивная переменная. Код отвечает на изменение состояния в одном месте изменением в другом. Эту идею мы видели в CDC, модели акторов, триггерах и инкрементальном обновлении представлений. Разобрать базу значит применить эту идею к производным данным вне основной базы с помощью потоковых процессоров и систем сообщений.
Поддержка производных данных требует двух свойств, и журнальный message broker их даёт:
- Порядок изменений. Если из одного журнала строят несколько представлений, они должны обрабатывать события в одном порядке, иначе разойдутся.
- Отказоустойчивость. Потеря даже одного сообщения навсегда рассинхронизирует производные данные с источником. Надёжными должны быть и доставка сообщений, и обновление производного состояния.
Эти требования жёсткие, но гораздо дешевле и надёжнее распределённых транзакций. Современные потоковые процессоры дают такие гарантии в большом масштабе и запускают любой код приложения как операторы. Операторы соединяются, как утилиты Unix через каналы: на входе и на выходе — потоки изменений состояния.
Потоковые процессоры и сервисы
Заголовок раздела «Потоковые процессоры и сервисы»Сегодня приложение обычно делят на сервисы с синхронными запросами (REST API). Их главный плюс — организационный: команды работают независимо. Потоковые операторы похожи на микросервисы, но общаются односторонними асинхронными потоками. Это даёт и отказоустойчивость, и скорость. Пример: покупатель платит в одной валюте, цена в другой, и нужен текущий курс.
- Микросервисы. Код обработки покупки запрашивает курс у сервиса курсов или в базе.
- Dataflow. Код обработки покупки заранее подписан на поток обновлений курса и при каждом изменении записывает курс в локальную базу. При покупке он просто читает эту локальную базу.
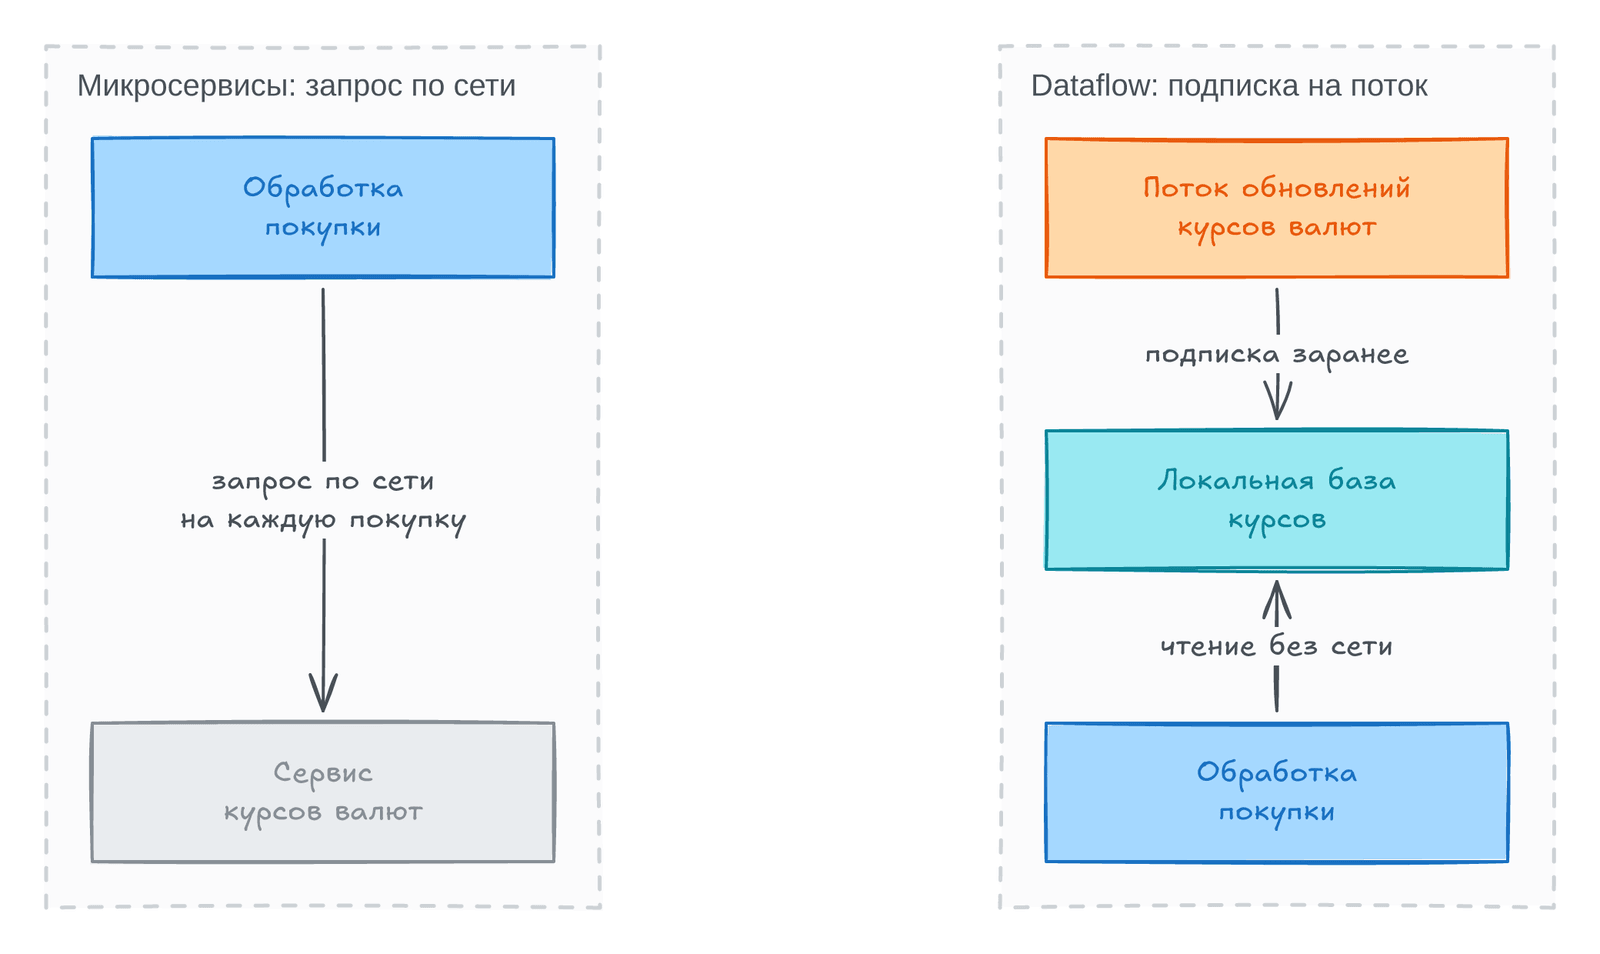
Слева каждая покупка ждёт сетевой запрос, справа его заменяет чтение локальной базы, иногда в том же процессе. Локальный кэш курса в микросервисе пришлось бы обновлять опросом или подпиской на поток, а это и есть dataflow. Самый быстрый и надёжный сетевой запрос — тот, которого нет. Вместо RPC получается потоковый join покупок с изменениями курса.
Этот join зависит от времени: при повторной обработке покупок нужен исторический курс на момент покупки. Эту проблему придётся решать при любом подходе. Подписка на изменения приближает нас к модели электронной таблицы, и авторы считают это направление перспективным, хотя открытых вопросов много.
Наблюдение за производным состоянием
Заголовок раздела «Наблюдение за производным состоянием»Процесс, который создаёт производные данные и держит их свежими, авторы называют write path: записанные данные проходят этапы обработки, и в итоге каждое представление их учитывает. Производные данные создают, чтобы читать. Это read path: при запросе мы читаем производные данные, обрабатываем и строим ответ.
Write path вычисляют заранее, даже если никто не спрашивал. Read path выполняется только по запросу. На языке функционального программирования это энергичные (eager) и ленивые (lazy) вычисления. Производные данные — место встречи двух путей и баланс между работой при записи и при чтении.
Материализованные представления и кэширование
Заголовок раздела «Материализованные представления и кэширование»Пример — полнотекстовый индекс. Write path обновляет записи индекса для каждого слова документа. Read path ищет слова запроса и применяет булеву логику (AND, OR для синонимов).
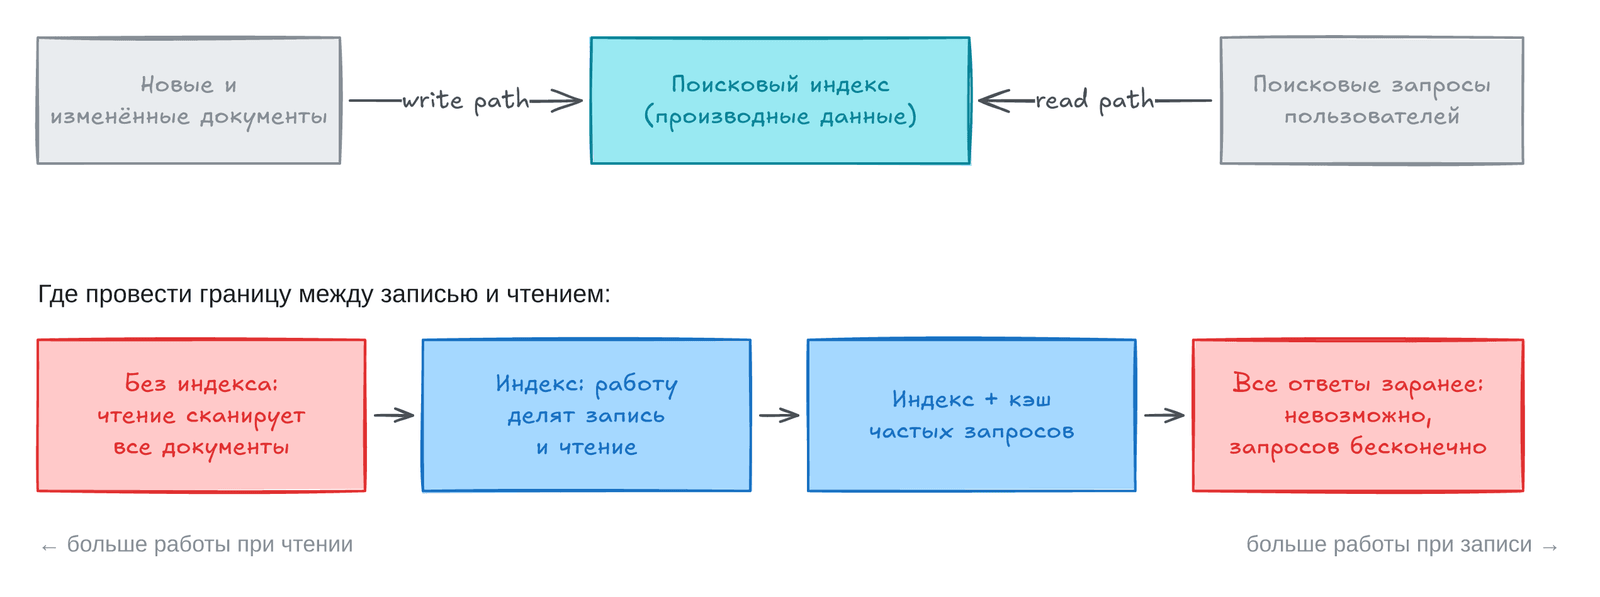
Верхняя строка показывает, что индекс — точка встречи двух путей. Нижняя строка показывает, куда можно сдвинуть границу:
- Без индекса запрос сканирует все документы, как
grep. Запись почти ничего не стоит, но при большом числе документов чтение очень дорогое. - Все ответы заранее. Чтение было бы дешёвым, но запись — невероятно дорогой. Возможных запросов бесконечно много (или экспоненциально много от числа слов), поэтому вычислить все ответы нельзя.
- Кэш частых запросов. Ответы на фиксированный набор популярных запросов считают заранее, а редкие запросы идут в индекс. Такой кэш можно назвать и материализованным представлением: его надо обновлять, когда появляется документ, который должен попасть в ответ на один из частых запросов.
Значит, индекс — не единственная возможная граница между записью и чтением. Роль кэшей, индексов и материализованных представлений проста: они сдвигают эту границу. Мы делаем больше работы при записи, заранее вычисляя результаты, чтобы меньше работать при чтении.
Эту задачу книга разбирала в главе 2 на примере ленты соцсети, где граница для знаменитостей проходит иначе. «Через 500 страниц мы вернулись к началу», — пишут авторы.
Клиенты с состоянием и офлайн-работой
Заголовок раздела «Клиенты с состоянием и офлайн-работой»Границу можно двигать и в другом месте. Раньше браузер без интернета почти ничего не умел. Сегодня одностраничные JavaScript-приложения и мобильные приложения хранят много состояния на устройстве и не ходят на сервер ради каждого действия.
Как мы видели в главе о репликации (sync engines и local-first софт), локальное состояние позволяет работать офлайн и синхронизироваться в фоне. При медленной мобильной связи это большой плюс.
Тогда состояние на устройстве — кэш состояния сервера. Пиксели на экране — материализованное представление объектов модели в клиенте, а эти объекты — локальная реплика состояния в дата-центре.
Отправка изменений клиенту
Заголовок раздела «Отправка изменений клиенту»Обычная веб-страница читает данные один раз и не подписана на обновления, поэтому её состояние — устаревший кэш до перезагрузки (RSS — тоже просто опрос). Server-sent events (API EventSource) и WebSockets держат открытое соединение, по которому сервер сам шлёт изменения браузеру.
Так write path продлевается до самого пользователя: начальное состояние клиент получает через read path, а дальше — потоком изменений. Если устройство было офлайн, оно поступает как consumer журнального message broker из главы 12: переподключается и продолжает с сохранённого offset. Каждое устройство — маленький подписчик маленького потока событий.
Сквозные потоки событий
Заголовок раздела «Сквозные потоки событий»React и Elm уже перерисовывают интерфейс при изменении состояния. Если пускать в этот конвейер и изменения от сервера, получится сквозной write path: от действия на одном устройстве через журналы и потоковые процессоры до интерфейса на другом, с задержкой меньше секунды. Мессенджеры и онлайн-игры уже так работают.
Мешает то, что модель «запрос — ответ» встроена в базы, библиотеки, фреймворки и протоколы. Запрос с одним ответом поддерживают все, а подписку на поток ответов — немногие. Переход к модели публикации и подписки (publish/subscribe) потребует много работы, но интерфейсы станут отзывчивее, а офлайн-режим лучше.
Чтение — тоже событие
Заголовок раздела «Чтение — тоже событие»Хранилище, куда потоковый процессор пишет производные данные, — граница между путями: оно даёт произвольный доступ к данным без сканирования журнала. Некоторые фреймворки дают запрашивать и внутреннее состояние процессора, и тогда он сам становится простой базой.
Авторы идут дальше: запросы на чтение тоже можно представить как поток событий и пустить через процессор вместе с записями. Процессор отвечает на событие чтения результатом в выходной поток.
Это stream-table join потока запросов с базой: каждое событие чтения идёт в shard с нужными данными, как при join по ключу. Разовый запрос проходит через join и забывается, а подписка — это постоянный join с прошлыми и будущими событиями.
Журнал чтений помогает отслеживать причинность: по нему видно, что видел пользователь перед решением. Например, на покупку влияют показанные дата доставки и наличие товара. Хранить чтения дорого, и как снизить затраты — открытый вопрос. Но если запросы уже логируют для эксплуатации, сделать лог источником запросов несложно.
Обработка данных из нескольких shard
Заголовок раздела «Обработка данных из нескольких shard»Для запроса к одному shard такая схема избыточна. Зато так можно выполнять сложные запросы по многим shard на готовой инфраструктуре потоковых процессоров.
Так работал distributed RPC в Storm: например, считали, сколько людей видели URL, объединяя подписчиков всех авторов этого URL по многим shard. Другой пример — антифрод: для оценки покупки нужна цепочка join с базами репутации IP, email и адресов, каждая со своим sharding.
Движки запросов в хранилищах данных устроены внутри похоже, и для таких запросов обычно проще взять готовую базу, чем писать их на потоковом процессоре. Но запросы как потоки — вариант для очень больших систем, которые упираются в пределы готовых решений.
Стремление к корректности
Заголовок раздела «Стремление к корректности»Если сервис без состояния только читает данные, ошибку легко исправить: починили баг, перезапустили. Базы данных созданы, чтобы помнить (более или менее) вечно, поэтому последствия ошибки в них тоже могут остаться навсегда.
Около сорока лет главным инструментом корректности были свойства транзакций: атомарность, изоляция и долговечность. Но эта основа слабее, чем кажется: вспомните путаницу со слабыми уровнями изоляции. Где-то от транзакций отказались ради масштаба и получили запутанную семантику. О согласованности много говорят, но определяют её плохо.
Трудно даже понять, безопасно ли запускать приложение с таким уровнем изоляции или настройкой репликации. Простые решения работают без нагрузки и сбоев, но в тяжёлых условиях в них много тонких ошибок. Эксперименты Jepsen Кайла Кингсбери показали, что реальное поведение некоторых продуктов при сбоях сети сильно расходится с заявленным. А приложение ещё должно правильно пользоваться запутанными настройками баз.
Если потеря данных иногда допустима, жить проще. Если нет, есть serializability и атомарный commit, но они дороги: обычно работают в одном дата-центре и ограничивают масштаб. Транзакции не исчезнут, но авторы ищут и другие способы думать о корректности в архитектуре потоков данных.
End-to-end argument для баз данных
Заголовок раздела «End-to-end argument для баз данных»Даже serializability не спасёт, если в приложении баг, который пишет неверные данные или удаляет нужные. Это довод в пользу неизменяемых данных, которые только дописываются: код с ошибкой не может уничтожить хорошие данные. Но и неизменяемость — не панацея.
Однократное выполнение операции
Заголовок раздела «Однократное выполнение операции»При обработке сообщения после сбоя можно сдаться и потерять данные или повторить. Но первая попытка могла пройти, а подтверждение потерялось, и тогда сообщение обработают дважды. Двойная обработка — тоже порча: двойное списание денег или завышенный счётчик.
Семантика exactly-once (или effectively-once) значит, что итоговый эффект такой, как будто сбоев не было. Лучший способ — идемпотентность: один и много запусков дают одинаковый эффект. Для неидемпотентной по природе операции это требует труда: хранить ID уже применённых операций и использовать fencing при переключении узлов.
Подавление дублей
Заголовок раздела «Подавление дублей»Дубли подавляют не только в потоках. TCP нумерует пакеты, переотправляет потерянные и удаляет дубли, но только внутри одного соединения.
Пусть клиент по соединению с базой переводит деньги, как в первой части SQL-примера ниже. Транзакция привязана к соединению. Если сеть пропала после COMMIT, но до ответа, клиент не знает, прошла ли транзакция.
Клиент переподключится и повторит транзакцию, но это уже вне защиты TCP. Транзакция не идемпотентна, и вместо $11 уйдёт $22. Такой код — стандартный пример атомарности, но он неверен: повтор переводит деньги дважды. Настоящие банки так не работают. Ниже наша версия на DuckDB.
2PC отвязывает транзакцию от соединения, но и этого мало: остаётся сеть между устройством пользователя и сервером. Запрос POST ушёл по слабой мобильной связи, ответ потерялся, пользователь видит ошибку и подтверждает «Отправить форму ещё раз?». Шаблон Post/Redirect/Get не помогает при тайм-ауте. Для сервера и базы повтор — новый запрос и новая транзакция.
Уникальный идентификатор запроса
Заголовок раздела «Уникальный идентификатор запроса»Чтобы запрос был идемпотентным через несколько сетевых переходов, нужно смотреть на весь его путь. Клиент создаёт уникальный ID запроса (UUID в скрытом поле формы или хеш полей формы). Двойной POST несёт один ID, его передают до самой базы и выполняют запрос с таким ID только раз.
-- Без request_id: повтор после потерянного ответаCREATE TABLE accounts (account_id INTEGER PRIMARY KEY, balance DECIMAL(10,2));INSERT INTO accounts VALUES (1234, 100.00), (4321, 100.00);
BEGIN TRANSACTION;UPDATE accounts SET balance = balance + 11.00 WHERE account_id = 1234;UPDATE accounts SET balance = balance - 11.00 WHERE account_id = 4321;COMMIT;-- клиент не получил ответ и повторил те же командыBEGIN TRANSACTION;UPDATE accounts SET balance = balance + 11.00 WHERE account_id = 1234;UPDATE accounts SET balance = balance - 11.00 WHERE account_id = 4321;COMMIT;SELECT 'без request_id' AS вариант, account_id, balance FROM accounts ORDER BY account_id;
-- С request_id: таблица запросов с уникальным ключомUPDATE accounts SET balance = 100.00;CREATE TABLE requests (    request_id   VARCHAR PRIMARY KEY,  -- уникальный ключ запроса от клиента    from_account INTEGER,    to_account   INTEGER,    amount       DECIMAL(10,2));BEGIN TRANSACTION;INSERT INTO requests VALUES ('0286fdb8-d7e1-423f-b40b-792b3608036c', 4321, 1234, 11.00);UPDATE accounts SET balance = balance + 11.00 WHERE account_id = 1234;UPDATE accounts SET balance = balance - 11.00 WHERE account_id = 4321;COMMIT;-- повтор с тем же request_id: INSERT падает, COMMIT откатывает транзакциюBEGIN TRANSACTION;INSERT INTO requests VALUES ('0286fdb8-d7e1-423f-b40b-792b3608036c', 4321, 1234, 11.00);UPDATE accounts SET balance = balance + 11.00 WHERE account_id = 1234;UPDATE accounts SET balance = balance - 11.00 WHERE account_id = 4321;COMMIT;
SELECT 'с request_id' AS вариант, account_id, balance FROM accounts ORDER BY account_id;SELECT count(*) AS запросов FROM requests;
Вывод duckdb 1.4.3 (балансы после каждой части):
┌────────────────┬────────────┬───────────────┐│ вариант │ account_id │ balance ││ varchar │ int32 │ decimal(10,2) │├────────────────┼────────────┼───────────────┤│ без request_id │ 1234 │ 122.00 ││ без request_id │ 4321 │ 78.00 │└────────────────┴────────────┴───────────────┘Constraint Error: Duplicate key "request_id: 0286fdb8-d7e1-423f-b40b-792b3608036c" violates primary key constraint.TransactionContext Error: Current transaction is aborted (please ROLLBACK)TransactionContext Error: Current transaction is aborted (please ROLLBACK)┌──────────────┬────────────┬───────────────┐│ вариант │ account_id │ balance ││ varchar │ int32 │ decimal(10,2) │├──────────────┼────────────┼───────────────┤│ с request_id │ 1234 │ 111.00 ││ с request_id │ 4321 │ 89.00 │└──────────────┴────────────┴───────────────┘┌──────────┐│ запросов ││ int64 │├──────────┤│ 1 │└──────────┘Полный скрипт: scripts/ddia-code/ch13_request_id.sql, запуск duckdb < scripts/ddia-code/ch13_request_id.sql. В книге ограничение добавляют через ALTER TABLE ... ADD UNIQUE, а DuckDB так не умеет, поэтому ключ задан сразу в CREATE TABLE.
Всё держится на уникальности request_id: повторный INSERT падает, и транзакция отменяется. Базы правильно соблюдают уникальность даже на слабой изоляции, а проверка «прочитать, потом вставить» в приложении без serializability может сломаться (write skew и phantom).
Таблица requests заодно служит журналом событий для event sourcing или CDC. Балансы можно не обновлять в той же транзакции, а вывести из события в consumer ниже по потоку, если событие обработано ровно один раз, что снова обеспечивает ID.
End-to-end argument
Заголовок раздела «End-to-end argument»Подавление дублей — частный случай end-to-end argument, который в 1984 году сформулировали Зальцер, Рид и Кларк. Смысл такой: функцию можно сделать полностью и правильно, только если участвует приложение на концах канала связи. Сама система связи даёт разве что неполную версию, полезную для скорости.
Ни TCP, ни транзакции, ни exactly-once в потоковом процессоре не спасают от повторного запроса пользователя после тайм-аута. Нужен ID, который проходит путь от клиента до базы.
Так же с целостностью: контрольные суммы Ethernet, TCP и TLS не ловят порчу из-за багов на концах соединения или на дисках, нужны сквозные контрольные суммы. И с шифрованием: пароль Wi-Fi защищает от соседей, TLS — от атак в сети, но от взлома сервера защищает только сквозное шифрование.
Низкоуровневые механизмы всё равно полезны: они снижают вероятность проблем выше (без TCP HTTP-запросы часто приходили бы испорченными). Просто их одних мало для сквозной корректности.
Сквозное мышление в системах данных
Заголовок раздела «Сквозное мышление в системах данных»Сильные гарантии базы не освобождают приложение от сквозных мер, например от подавления дублей. Жаль, что правильной абстракции для отказоустойчивости верхнего уровня пока не нашли.
Долго такой абстракцией были транзакции: они сводят множество проблем (конкурентные записи, падения, обрывы сети) к двум исходам, commit или abort. Но они дороги, особенно между разнородными системами. Без них отказоустойчивость пишут в коде приложения, а рассуждать о конкурентности и частичных отказах трудно, и такие механизмы обычно работают неправильно. Поэтому нужны абстракции, которые дают сквозную корректность и сохраняют скорость в большой распределённой среде.
Соблюдение ограничений
Заголовок раздела «Соблюдение ограничений»Сквозное подавление дублей обеспечил ID запроса. А как быть с другими ограничениями?
Начнём с уникальности: уникальное имя пользователя или email, одно имя файла в каталоге, одно место в самолёте на человека. Похожи и другие ограничения: баланс не уходит в минус, нельзя продать больше товара, чем на складе, бронирования переговорной не пересекаются.
Уникальность требует консенсуса
Заголовок раздела «Уникальность требует консенсуса»В распределённой системе уникальность требует консенсуса: из одновременных запросов с одним значением система должна принять один, а остальные отклонить.
Обычно все решения принимает один узел-leader. Это работает, пока вас устраивает гнать все запросы через него и пока он жив. Алгоритмы вроде Raft безопасно выбирают нового leader и не допускают split brain.
Масштабировать проверку можно через sharding по уникальному значению: по ID запроса или по хешу имени пользователя. Асинхронная репликация с несколькими leader не подходит: разные leader примут конфликтующие записи. Чтобы отклонять нарушения сразу, нужна синхронная координация.
Уникальность через журнал сообщений
Заголовок раздела «Уникальность через журнал сообщений»Общий журнал даёт всем consumer один порядок сообщений, то есть total order broadcast, равносильный консенсусу. Потоковый процессор читает shard журнала последовательно в одном потоке. Если журнал разбит по уникальному значению, процессор детерминированно решает, какая из конфликтующих операций была первой. Пример с одним именем пользователя:
- Каждый запрос имени становится сообщением и дописывается в
shardпо хешу имени. - Потоковый процессор читает запросы по порядку и хранит в локальной базе занятые имена. Если имя свободно, он помечает его занятым и пишет в выходной поток сообщение об успехе. Если имя занято, он пишет сообщение об отказе.
- Клиент, запросивший имя, следит за выходным потоком и ждёт ответа на свой запрос.
Это тот же консенсус через общий журнал из главы 10. Он масштабируется добавлением shard и подходит для многих ограничений. Принцип: записи, которые могут конфликтовать, идут в один shard и обрабатываются по очереди, а логика проверки может быть любой.
Запрос, который затрагивает несколько shard
Заголовок раздела «Запрос, который затрагивает несколько shard»Сложнее, когда операция затрагивает несколько shard. В переводе денег их может быть три: с ID запроса, со счётом получателя и со счётом плательщика.
Классическая база потребует атомарного commit по трём shard. Появится координация между ними, и throughput упадёт.
Ту же корректность дают журналы с sharding и потоковые процессоры. Пример: проверить, что на счёте-источнике хватает денег, и атомарно перевести сумму получателю, удержав комиссию.
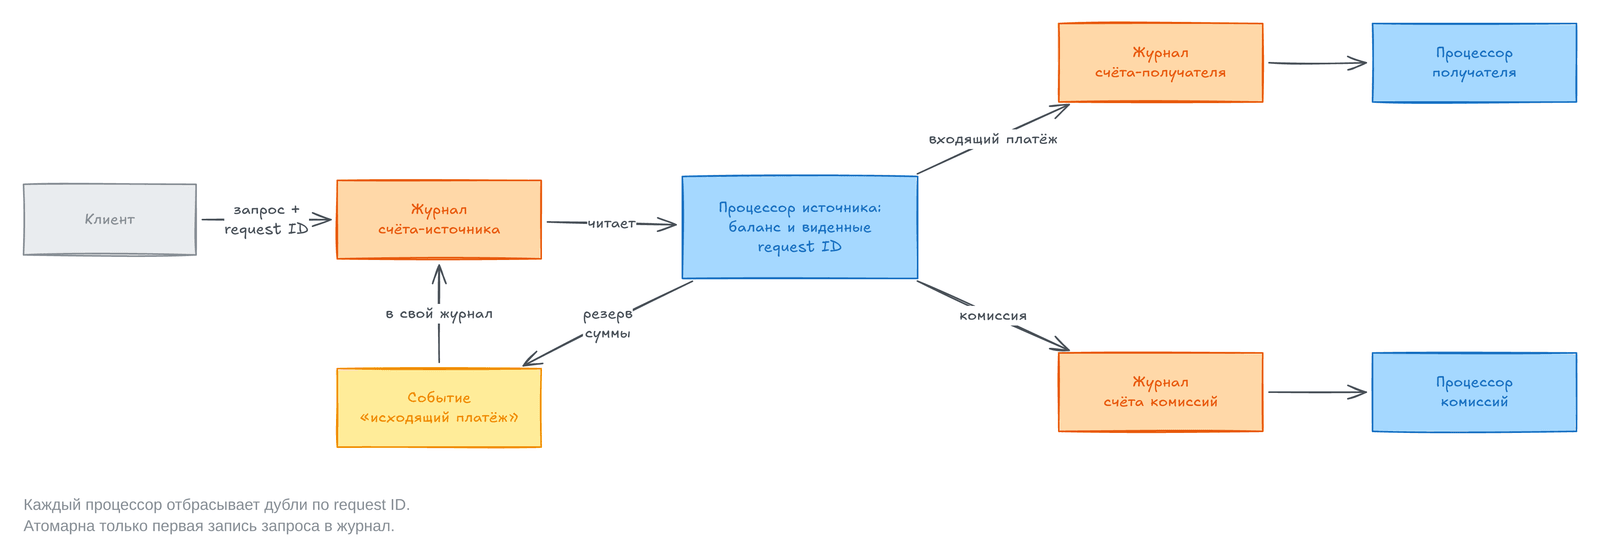
Процесс идёт так:
- Клиент даёт запросу на перевод уникальный ID и дописывает его в
shardжурнала по ID счёта-источника. - Процессор источника ведёт локальную базу, целиком выведенную из журнала: баланс счёта и ID обработанных запросов. Для нового ID он проверяет баланс. Если денег хватает, он резервирует сумму и пишет события с тем же ID: исходящий платёж — в свой же журнал, входящий платёж — в журнал получателя, комиссию — в журнал счёта комиссий.
- Событие исходящего платежа возвращается к процессору источника. По ID он узнаёт зарезервированный платёж и проводит его, а дубли отбрасывает.
- Журналы получателя и комиссий читают независимые задачи. Они обновляют своё состояние и тоже отбрасывают дубли по ID.
Счета могли бы лежать и в одном shard. Требования только такие: события счёта обрабатываются строго по порядку журнала с семантикой at-least-once (хотя бы один раз), а процессоры детерминированы.
Если процессор источника упадёт, выходные сообщения могли уйти, а могли и не уйти. После восстановления он снова обработает тот же запрос, примет то же решение и отправит те же сообщения с тем же ID, а дубли отбросят ниже по потоку.
Атомарность даёт не транзакция, а атомарная запись исходного запроса в журнал. Как только это событие записано, все следующие события когда-нибудь появятся, возможно с дублями. С семантикой exactly-once проще: локальное состояние процессора откатывается вместе с повторно обработанными сообщениями.
Пользователь узнаёт результат, подписавшись на журнал источника: там появится исходящий платёж или событие «платёж отклонён». Итог: каждый запрос применяется ровно один раз к обоим счетам даже при сбоях, и протокол атомарного commit не нужен.
Своевременность и целостность
Заголовок раздела «Своевременность и целостность»Транзакционная система показывает запись сразу после commit; формально это строгая serializability (strict serializability). В цепочке потоковых процессоров это не так: producer не ждёт обработки. Клиент может ждать результата в выходном потоке, но проверка баланса верна и без этого ожидания: оно нужно только, чтобы сообщить пользователю, прошёл ли платёж.
Авторы показывают, что слово «согласованность» смешивает два разных требования:
Своевременность (timeliness) | Целостность (integrity) | |
|---|---|---|
| Что значит | Пользователь видит систему в актуальном состоянии | Нет порчи: данные не потеряны, нет противоречивых и ложных данных |
| Пример нарушения | Чтение с отстающей реплики (лаг репликации) | Индекс без части записей; деньги списаны, но не дошли |
| Сколько длится нарушение | Временно: хватит подождать и повторить | Навсегда: ожидание не поможет, нужны явная проверка и ремонт |
| Связь с известными терминами | «Consistency» в теореме CAP — это linearizability, сильная форма своевременности. Слабее — чтение своих записей | «Consistency» в ACID обычно означает целостность на уровне приложения. Атомарность и долговечность — инструменты целостности |
Коротко: eventual consistency допускает нарушения своевременности, а нарушение целостности — это вечная несогласованность. Обычно целостность гораздо важнее: нарушение своевременности раздражает, а нарушение целостности может стать катастрофой.
Пример — выписка по карте. Никого не удивит, что вчерашних покупок в ней ещё нет: банки проводят операции асинхронно. Но плохо, если баланс не равен сумме операций плюс прошлый баланс или если деньги списали с вас, но не заплатили продавцу.
Корректность систем на потоках данных
Заголовок раздела «Корректность систем на потоках данных»Транзакции ACID дают сразу и своевременность (linearizability), и целостность (атомарный commit), поэтому разница между ними не видна. Потоковые системы их разделяют. Своевременности нет, если специально не ждать ответа: пользователь может запросить платёж и сразу не увидеть его на счёте.
Зато целостность для них — центральное свойство. Exactly-once, отказоустойчивая доставка и подавление дублей нужны именно для неё: потерянное или дважды сработавшее событие её нарушает.
Надёжные потоковые системы сохраняют целостность без распределённых транзакций, а значит, дают сопоставимую корректность при лучшей скорости и надёжности. Для этого служат четыре приёма:
- содержимое операции записи — одно сообщение, которое легко записать атомарно (это хорошо сочетается с
event sourcing); - все остальные обновления состояния выводятся из этого сообщения детерминированными функциями, как в хранимых процедурах;
- ID запроса от клиента проходит через все уровни обработки и даёт сквозное подавление дублей и идемпотентность;
- сообщения неизменяемы, а производные данные время от времени можно пересчитать, и так проще восстанавливаться после багов.
Мягкие ограничения
Заголовок раздела «Мягкие ограничения»Строгая уникальность требует консенсуса через один узел на shard, и потоковая обработка это не обходит.
Однако многие реальные бизнесы допускают нарушения того, что кажется жёстким ограничением:
- Если заказали больше товара, чем есть на складе, можно дозаказать, извиниться и дать скидку. То же пришлось бы делать, если погрузчик раздавит часть товара, так что процесс извинения всё равно нужен.
- Авиакомпании и отели сознательно продают больше мест, чем есть, и держат компенсации: возврат денег, повышение класса, номер в соседнем отеле. Те же процессы нужны при отмене рейса из-за погоды или забастовки.
- Если клиент снял больше, чем было на счёте, банк берёт плату за овердрафт, а дневной лимит ограничивает риск.
- Когда данные объединяют из разных компаний, расхождения неизбежны и нужны механизмы исправления. Пример — расчёты между банками.
Исправление нарушения задним числом называют компенсирующей транзакцией (compensating transaction). Цена извинения часто мала: письмо не вернуть, но можно отправить исправление, двойное списание с карты можно вернуть. Деньги из банкомата вернуть труднее, хотя крайний вариант — коллекторы.
Приемлема ли цена — решение бизнеса. Если да, проверять все ограничения до записи слишком строго: можно записать оптимистично и проверить потом. Проверку стоит сделать только перед действиями, после которых восстановиться дорого.
Таким приложениям нужна целостность (нельзя потерять бронь или деньги), но не своевременность проверки. Это похоже на разрешение конфликтов записи из главы о репликации.
Системы без координации
Заголовок раздела «Системы без координации»Итак, у нас два наблюдения:
- Системы на потоках данных сохраняют целостность производных данных без атомарного
commit,linearizabilityи синхронной координации междуshard. - Строгая уникальность требует своевременности и координации, но многим приложениям хватает мягких ограничений, которые можно временно нарушить и исправить потом. Главное, чтобы всё время сохранялась целостность.
Значит, системы на потоках данных могут обслуживать многие приложения без координации (coordination-avoiding) и при этом давать сильную целостность. Они быстрее и отказоустойчивее систем с синхронной координацией.
Например, такая система может работать в нескольких дата-центрах с несколькими leader и асинхронной репликацией. Каждый регион работает независимо. Своевременность слабая (без координации нет linearizability), а целостность сильная.
Serializability остаётся полезной в малом масштабе, а XA не нужен. Синхронную координацию добавляют только там, где без неё никак, например перед необратимой операцией.
Координация уменьшает число извинений за несогласованность, но снижает доступность и добавляет извинений за простои. Ноль извинений недостижим, нужно найти свой баланс.
Доверяй, но проверяй
Заголовок раздела «Доверяй, но проверяй»Обсуждение корректности опиралось на модель системы (system model). Мы допускаем, что процессы падают, питание пропадает, а сеть задерживает сообщения. Но мы считаем, что данные после fsync не теряются, память не портится, а процессор правильно умножает.
Это разумно, но на деле сбои — вопрос вероятностей, а не «возможно или невозможно». Мы уже видели порчу данных в памяти, на диске и в сети. При большом масштабе даже очень маловероятное случается.
Целостность при багах в программах
Заголовок раздела «Целостность при багах в программах»Есть и баги, которые не поймают контрольные суммы. Старые версии MySQL неправильно соблюдали уникальность, а serializability в PostgreSQL когда-то допускала write skew, хотя это проверенные годами базы. В менее зрелых программах всё хуже.
Баги редки и их исправляют, но до этого они портят данные. В коде приложений багов гораздо больше, и многие приложения даже не используют внешние ключи и ограничения уникальности.
Согласованность в смысле ACID верна, только если в транзакции нет багов. Если приложение небезопасно работает на слабой изоляции, целостность не гарантирована.
Не верьте обещаниям вслепую
Заголовок раздела «Не верьте обещаниям вслепую»Поэтому рано или поздно данные испортятся, и нужен способ узнать об этом, исправить и найти источник. Проверку целостности данных называют аудитом (auditing). В финансах аудит особенно важен, потому что там все знают: ошибки случаются.
Зрелые системы управляют и маловероятными рисками. HDFS и Amazon S3 не доверяют дискам: фоновые процессы перечитывают файлы, сверяют с репликами и переносят между дисками, чтобы поймать тихую порчу.
Чтобы убедиться, что данные на месте, их нужно прочитать и проверить. По той же причине надо иногда пробовать восстановиться из бэкапа, иначе вы узнаете о его поломке слишком поздно.
Подход «доверяй, но проверяй» с постоянным самоаудитом пока редкость: многие системы считают свои гарантии абсолютными. Авторы ждут больше систем, которые сами проверяют свою целостность.
Проектирование под аудит
Заголовок раздела «Проектирование под аудит»Если транзакция меняет несколько объектов, потом трудно понять, зачем: журнал вставок и обновлений не объясняет причину, а вызов логики приложения повторить нельзя.
В event sourcing ввод пользователя — одно неизменяемое событие, а изменения состояния выводятся из него детерминированно: тот же журнал через ту же версию кода даст тот же результат.
Поэтому происхождение данных (provenance) понятно. Журнал событий проверяют хешами, а производное состояние — повторным запуском процессоров или параллельным избыточным выводом. Детерминированный поток ещё и упрощает отладку: можно воспроизвести точные условия сбоя, своего рода отладка с time travel.
Снова end-to-end argument
Заголовок раздела «Снова end-to-end argument»Если нельзя доверять каждой части, целостность нужно проверять регулярно, иначе порча обнаружится поздно и дорого. Лучше проверять сквозным способом: проверка всего pipeline от края до края неявно проверяет все диски, сети и сервисы на пути.
Как и автотесты, такие проверки быстро находят баги и снижают риск изменений. Когда менять не страшно, система быстрее развивается.
Инструменты для аудита
Заголовок раздела «Инструменты для аудита»Немногие системы данных ставят аудит на первое место. Отдельная таблица аудита не гарантирует целостность ни себя, ни базы. Журнал транзакций можно подписывать аппаратным модулем безопасности (HSM), но это не доказывает, что в него попали правильные транзакции.
Блокчейны вроде Bitcoin и Ethereum — общие журналы только для дописывания с криптографической проверкой. Транзакции в них — события, смарт-контракты — по сути потоковые процессоры. В отличие от консенсуса из главы 10, они устойчивы к византийским сбоям (Byzantine fault tolerance): реплики постоянно проверяют друг друга и работают, даже если у части узлов испорчены данные.
Для большинства приложений блокчейн слишком дорог, но его инструменты годятся и в облегчённом виде. Дерево Меркла (Merkle tree) — дерево хешей, которое быстро доказывает, что запись есть в наборе. Certificate Transparency проверяет сертификаты TLS через такие журналы и деревья Меркла без консенсуса, с одним leader на журнал. Авторы ждут, что такие алгоритмы аудита шире войдут в системы данных, если их удастся сделать масштабируемыми и быстрыми.
Итоги главы
Заголовок раздела «Итоги главы»- Ни один инструмент не закрывает все сценарии, поэтому приложение собирают из нескольких систем, и главная задача — интеграция данных между ними.
- Надёжный способ интеграции: одна система хранит исходные данные (
system of record), остальные выводятся из её журнала изменений в едином порядке. - Повторная обработка истории позволяет менять модель данных постепенно: старое и новое представление живут рядом, и каждый шаг можно отменить.
- Производный набор данных — граница между
write pathиread path. Индексы, кэши и материализованные представления сдвигают работу с чтения на запись. - Слои вроде TCP и транзакций не дают сквозной корректности. Нужен
request ID, который проходит путь от клиента до базы. - Ограничения можно соблюдать через журнал: конфликтующие записи идут в один
shard, и процессор обрабатывает их по очереди. - Своевременность и целостность — разные свойства. Целостность обычно важнее, и потоковые системы сохраняют её без координации.
- Данные и железо подводят, поэтому целостность нужно регулярно проверять сквозным аудитом, а не верить гарантиям вслепую.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
system of record | Система, которая хранит исходную, авторитетную версию данных. Новые данные пишут сначала сюда |
Производные данные (derived data) | Данные, полученные преобразованием других данных: индекс, кэш, материализованное представление, модель. Их можно перестроить заново |
unbundling | Разборка базы данных на отдельные инструменты, которые связаны журналами событий |
write path / read path | Работа, которую делают заранее при записи / работа, которую делают при запросе |
total order broadcast | Доставка всех сообщений всем узлам в одном порядке. Равносильна консенсусу |
end-to-end argument | Корректность функции может обеспечить только приложение на концах системы, а не её нижние слои |
request ID | Уникальный ID запроса от клиента. По нему отбрасывают дубли на каждом шаге |
Своевременность (timeliness) | Пользователь видит актуальное состояние системы. Нарушение временное |
Целостность (integrity) | Нет потерянных, противоречивых или ложных данных. Нарушение постоянное |
Компенсирующая транзакция (compensating transaction) | Изменение, которое исправляет нарушенное ограничение задним числом |
Аудит (auditing) | Проверка целостности данных, чтобы найти порчу и её источник |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Назначьте для каждого набора данных одну систему-источник. Хранилище, поисковый индекс и кэши стройте из её
CDC-потока, а не черезdual writesиз приложения. - Делайте каждый шаг
pipelineдетерминированным и идемпотентным. Тогда повтор после сбоя безопасен, а таблицу можно перестроить с нуля. - Меняйте модель данных через параллельное представление: соберите новую витрину рядом со старой, переключите часть потребителей, сравните и только потом удалите старую.
- Генерируйте ID события или запроса как можно ближе к источнику и храните его в каждой таблице. По нему делайте
MERGEили удаление дублей при загрузке. - Разделяйте своевременность и целостность в SLA: «данные отстают на час» — это нормально, «сумма в витрине не равна сумме в источнике» — это авария.
- Добавьте сквозные проверки: сверку сумм и числа строк между источником и витриной, тестовое восстановление из бэкапа. Не полагайтесь только на гарантии инструментов.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему запись только в основную базу и
CDCлучше, чем запись приложением в базу и индекс одновременно? - Когда полный порядок событий построить нельзя, и как тогда сохранить причинность, например в истории с удалением из друзей?
- Почему кэш, индекс и материализованное представление называют способами сдвинуть границу между
write pathиread path? - Почему транзакция с
serializabilityне защищает от двойного перевода денег, и как это исправляетrequest ID? - Как перевод денег через журналы и потоковые процессоры остаётся атомарным без
two-phase commit? - Когда бизнес может обойтись мягким ограничением и компенсирующей транзакцией, а когда нужна синхронная координация?
Предыдущая: Потоковая обработка. Следующая: Поступать правильно: этика данных.