

Designing Data-Intensive Applications, глава 8: Транзакции
Главная мысль: транзакция объединяет несколько чтений и записей в одну операцию: либо выполняется всё, либо ничего. Но гарантии сильно зависят от уровня изоляции, и многие базы по умолчанию дают слабую изоляцию, при которой возникают трудноуловимые баги. От всех гонок защищает только serializability, а транзакции на нескольких узлах требуют протокола two-phase commit.
О чём глава
Заголовок раздела «О чём глава»Глава отвечает на вопрос, что именно обещает транзакция и сколько это стоит. В главе 7 данные делили на shard. Здесь видно, что запись, которая задевает несколько объектов или несколько shard, требует особой защиты. Темы главы:
- что значат буквы ACID и почему «ACID» стал почти маркетинговым словом;
- зачем нужны транзакции над несколькими объектами;
- слабые уровни изоляции
read committedиsnapshot isolation, устройство MVCC; - гонки:
dirty read,dirty write,read skew,lost update,write skew,phantom; - три способа получить
serializability: последовательное выполнение,2PLи SSI; - распределённые транзакции,
two-phase commit(2PC), XA и обработка сообщенийexactly-once.
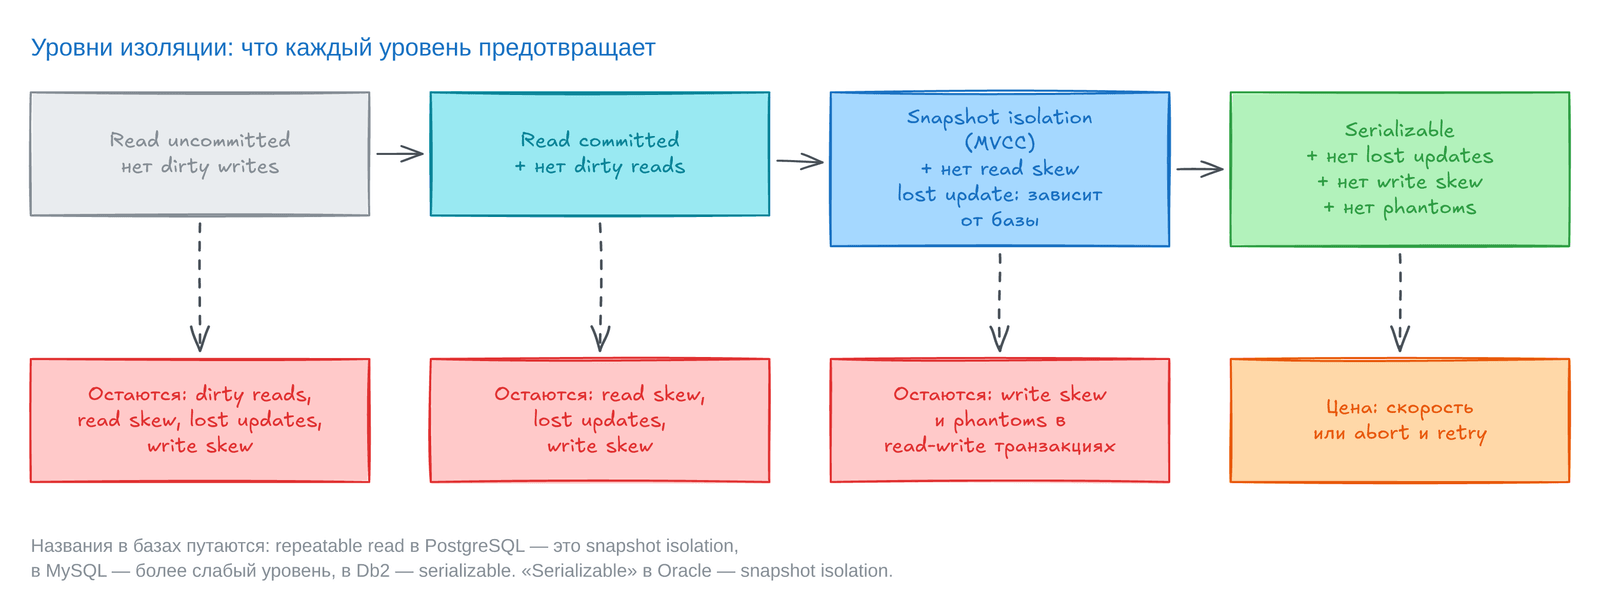
Схема читается слева направо: каждый следующий уровень добавляет защиту от новой аномалии. Под каждым уровнем указано, что он ещё пропускает.
Что такое транзакция
Заголовок раздела «Что такое транзакция»В реальных системах ломается многое. База или её диск может отказать посреди записи, приложение может упасть на полпути, сеть может отрезать приложение от базы. Несколько клиентов пишут одновременно и затирают изменения друг друга, клиент читает наполовину обновлённые данные, а гонки между клиентами порождают странные баги. Надёжная система должна всё это переживать, но продумать и протестировать каждый сбой трудно. Уже несколько десятилетий главный инструмент здесь — транзакции.
Транзакция — это способ сгруппировать несколько чтений и записей в одну логическую единицу. Либо она успешна и делает commit, либо падает и делает abort (откат). После abort приложение может спокойно повторить попытку и не думать о частичном отказе, когда одни операции прошли, а другие нет.
Авторы напоминают, что транзакции — не закон природы. Их придумали, чтобы упростить работу приложения с базой: база берёт на себя часть сбоев и гонок. Такие обещания называют гарантиями безопасности (safety guarantees). Не всем приложениям они нужны, и иногда их выгодно ослабить ради скорости или доступности. Но транзакции избавляют от многих бед: например, скандал с системой Horizon в британской почте (глава 2), вероятно, вырос из того, что в бухгалтерской системе не было ACID-транзакций.
Почти все реляционные базы следуют стилю IBM System R, первой SQL-базы 1975 года, и транзакции в MySQL, PostgreSQL, Oracle и SQL Server на неё удивительно похожи. В конце 2000-х NoSQL-базы принесли новые модели данных, репликацию и sharding по умолчанию, а транзакции стали их главной жертвой: от них отказались или назвали так гораздо более слабые гарантии. Появилось мнение, что транзакции не масштабируются. Позже оно оказалось ошибочным: базы класса NewSQL (CockroachDB, TiDB, Spanner, FoundationDB, YugabyteDB) сочетают sharding с консенсусом (глава 10) и дают строгие гарантии ACID при большом throughput. Но и это не значит, что транзакции нужны всем: у них есть и плюсы, и ограничения.
Что значит ACID
Заголовок раздела «Что значит ACID»ACID — это атомарность (atomicity), согласованность (consistency), изоляция (isolation) и долговечность (durability). Термин придумали в 1983 году Тео Хердер и Андреас Ройтер. На практике ACID в одной базе не равен ACID в другой, особенно в части изоляции, поэтому, по словам авторов, «ACID» стал в основном маркетинговым термином. Системы без этих гарантий иногда называют BASE (basically available, soft state, eventual consistency). Авторы шутят, что единственный разумный смысл BASE — «не ACID».
Атомарность
Заголовок раздела «Атомарность»В многопоточном коде атомарная операция означает, что другой поток не увидит её промежуточный результат. В ACID атомарность не про конкурентный доступ: им занимается буква I. Она описывает другую ситуацию: клиент делает несколько записей, а после части из них случается сбой — упал процесс, оборвалась сеть, заполнился диск или нарушилось ограничение. Тогда база отменяет транзакцию и выбрасывает все её записи.
Без атомарности после ошибки неясно, какие изменения применились, и повтор может создать дубли. С ней приложение знает: отменённая транзакция ничего не изменила, её можно повторить. Авторы замечают, что точнее было бы назвать это свойство «отменяемостью» (abortability).
Согласованность
Заголовок раздела «Согласованность»Слово consistency перегружено, у него минимум пять значений:
| Где встречается | Что значит |
|---|---|
| Репликация (глава 6) | Согласованность реплик, eventual consistency |
| Согласованный snapshot | Снимок базы на один момент: в нём есть и запись, и всё, что было до неё |
Consistent hashing | Способ rebalancing из главы 7 |
Теорема CAP | Здесь это linearizability |
| ACID | База в «хорошем» состоянии с точки зрения приложения |
Согласованность в ACID — это инварианты, то есть утверждения о данных, которые всегда должны быть верны. Например, в бухгалтерии дебет и кредит по всем счетам должны сходиться. Если транзакция начинает с верного состояния и не нарушает инварианты, они остаются верными. Часть инвариантов база проверяет сама, если их объявить: внешние ключи, уникальность, CHECK, иногда триггеры. Сложные правила база выразить не может, и за них отвечает приложение. Поэтому буква C зависит скорее от приложения, чем от базы.
Изоляция
Заголовок раздела «Изоляция»Если клиенты одновременно работают с одними записями, возникают гонки (race condition). Пример: два клиента увеличивают счётчик. Каждый читает 42, прибавляет 1 и пишет 43, хотя после двух прибавлений должно быть 44.
Изоляция в ACID значит, что одновременные транзакции не мешают друг другу. Учебники определяют её как serializability: результат такой, будто транзакции шли строго по очереди. Но это дорого, поэтому многие базы используют более слабые уровни. Oracle вообще не реализует настоящую serializability: его уровень «serializable» на деле — snapshot isolation.
Долговечность
Заголовок раздела «Долговечность»Долговечность — это обещание, что зафиксированные данные не пропадут при сбое. На одном узле это запись на HDD или SSD. Обычная запись в файл сначала идёт в буфер памяти, поэтому базы вызывают fsync, ведут write-ahead log (WAL) для восстановления и часто хранят контрольные суммы, чтобы находить испорченные записи журнала. В реплицированной базе долговечность может значить копию на нескольких узлах. В любом случае база сообщает об успехе только после записи. Идеальной долговечности нет: если уничтожены все диски и бэкапы, база ничего не спасёт.
Репликация и долговечность
Заголовок раздела «Репликация и долговечность»Долговечность понимали как запись на ленту, потом на диск, теперь как репликацию. Идеального варианта нет:
- Данные на диске умершей машины не потеряны, но недоступны. Реплицированная система остаётся доступной.
- Коррелированный сбой (отключение питания, баг, который роняет все узлы на одних и тех же входных данных) роняет все реплики сразу, и данные только в памяти теряются. Поэтому диск важен и при репликации.
- При асинхронной репликации последние записи могут пропасть, если
leaderнедоступен. - SSD при отключении питания иногда нарушают гарантии, и даже
fsyncне всегда работает. В прошивках бывают баги: диски отказывали ровно через 32 768 часов работы. Даже PostgreSQL больше 20 лет вызывалfsyncневерно. - Взаимодействие движка хранения с файловой системой порождает трудные баги, и ошибка на одной реплике иногда переходит на другие.
- Данные могут незаметно портиться так долго, что испорчены и реплики, и свежие бэкапы.
- У 30–80% SSD за первые четыре года появляется плохой блок. У HDD плохих секторов меньше, но полный отказ чаще. Изношенный SSD без питания теряет данные за недели или месяцы.
Вывод: абсолютных гарантий нет, есть способы снизить риск — диск, репликация, бэкапы. Их нужно использовать вместе.
Операции над одним и несколькими объектами
Заголовок раздела «Операции над одним и несколькими объектами»Атомарность даёт гарантию «всё или ничего» при ошибке. Изоляция гарантирует, что другая транзакция увидит либо все записи транзакции, либо ни одной. Это важно, когда несколько частей данных должны оставаться синхронными.
Пример из почтового сервиса: число непрочитанных писем можно считать запросом SELECT COUNT(*) FROM emails WHERE recipient_id = 2 AND unread_flag = true. Если писем много, это медленно, и число хранят в отдельном счётчике. Это денормализация: при новом письме счётчик нужно увеличить. Если пользователь 2 смотрит ящик между вставкой письма и обновлением счётчика, он видит непрочитанное письмо при нулевом счётчике. Изоляция это исключает. Атомарность нужна, если обновление счётчика упало: тогда вставка письма тоже откатывается. Авторы советуют мысленно заменить счётчик балансом, а письмо платежом, чтобы оценить риск.
Реляционная база понимает, какие операции входят в транзакцию, по TCP-соединению: всё между BEGIN TRANSACTION и COMMIT. Если соединение оборвалось, транзакцию отменяют. Во многих нереляционных базах такой группировки нет. Даже операция над несколькими ключами (multi-put) может пройти для одних ключей и не пройти для других.
Запись одного объекта
Заголовок раздела «Запись одного объекта»Атомарность и изоляция важны и для одного объекта. Если вы пишете JSON-документ на 20 KB и сеть оборвалась после 10 KB, не сохранит ли база обрывок? Не смешаются ли старое и новое значение при отключении питания? Увидит ли другой клиент половину документа? Поэтому почти все движки хранения дают атомарность (через журнал) и изоляцию (через блокировку объекта) для одного объекта на одном узле.
Некоторые базы дают атомарный инкремент, который избавляет от цикла «прочитать — изменить — записать» (read-modify-write), и условную запись, аналог compare-and-set (CAS). Они помогают против lost update, но это не транзакции в обычном смысле. Например, «lightweight transactions» в Cassandra и ScyllaDB дают linearizability и условную запись только для одного объекта.
Зачем нужны транзакции над несколькими объектами
Заголовок раздела «Зачем нужны транзакции над несколькими объектами»Часто записи в несколько объектов нужно согласовать:
- Внешние ключи в реляционной модели и рёбра в графовой: ссылки между новыми записями должны оставаться верными.
- В документной модели без
JOINданные денормализуют, и при обновлении приходится менять несколько документов сразу. - Вторичный индекс — отдельный объект. Без изоляции запись может появиться в одном индексе и ещё не появиться в другом.
Без транзакций такие приложения писать можно, но обработка ошибок и гонок сильно усложняется. Альтернативы авторы разбирают в главе 13.
Ошибки и abort
Заголовок раздела «Ошибки и abort»Базы с ACID построены на идее: лучше отменить транзакцию целиком, чем оставить её наполовину. Хранилища с репликацией без leader действуют иначе, по принципу «сделаю сколько смогу», и восстанавливаться приходится приложению. Многие разработчики думают только об удачном сценарии: Rails ActiveRecord и Django не повторяют отменённые транзакции, а показывают ошибку. Обидно, ведь откат нужен именно для безопасного повтора.
Но и у повтора есть подводные камни:
- Транзакция могла пройти, а потерялось лишь подтверждение. Без дедупликации повтор выполнит её дважды.
- Если причина в перегрузке, повтор её усилит. Ограничивайте число повторов и используйте
exponential backoff. - Повторять стоит временные ошибки (
deadlock, нарушение изоляции, обрыв сети,failover), а не постоянные вроде нарушения ограничения. - Побочные эффекты вне базы, например отправка письма, происходят даже при
abort. Согласовать несколько систем помогаетtwo-phase commit. - Если клиент упал во время повтора, его данные пропадут.
Слабые уровни изоляции
Заголовок раздела «Слабые уровни изоляции»Гонки появляются, только когда одна транзакция читает данные, которые меняет другая, или обе меняют одно и то же. Тестами такие баги ловятся плохо: они зависят от неудачного совпадения времени и редко воспроизводятся. Изоляция должна скрыть эту сложность, но serializability стоит производительности. Поэтому базы часто используют слабые уровни, которые защищают лишь от части проблем.
Это не теория. Гонки из-за слабой изоляции обанкротили биржу биткоинов, привели к проверкам финансовых аудиторов и испортили данные клиентов. Совет «берите ACID-базу для финансов» не помогает: многие такие базы тоже по умолчанию используют слабую изоляцию. К тому же злоумышленник может нарочно послать пачку параллельных запросов в API, чтобы вызвать гонку. Поэтому такие баги нужно предотвращать систематически.
Read committed
Заголовок раздела «Read committed»Базовый уровень изоляции — read committed. Он гарантирует, что нет dirty read (вы читаете только зафиксированные данные) и нет dirty write (вы перезаписываете только зафиксированные данные).
Нет dirty read
Заголовок раздела «Нет dirty read»Dirty read — это когда транзакция видит чужие записи до их commit. При read committed записи транзакции становятся видны другим только после commit, и все сразу. Это важно по двум причинам. Во-первых, иначе другая транзакция увидит часть изменений, как в примере с письмом и счётчиком, и примет неверное решение. Во-вторых, если транзакция отменится, читатель окажется с данными, которых не было, и его тоже придётся отменять (каскадная отмена, cascading abort).
Нет dirty write
Заголовок раздела «Нет dirty write»Dirty write — это перезапись незафиксированного значения другой транзакции. Read committed его не допускает: вторая запись ждёт, пока первая транзакция закончится. Пример из книги: Aaliyah и Bryce одновременно покупают одну машину на сайте. Покупка — это обновление объявления и отправка счёта. При dirty write машина достаётся Bryce, а счёт уходит Aaliyah.
Однако от гонки со счётчиком read committed не спасает: там вторая запись идёт уже после commit первой, так что это не dirty write. О защите от неё — в разделе про lost update.
Как устроен read committed
Заголовок раздела «Как устроен read committed»Это уровень по умолчанию в Oracle, PostgreSQL, SQL Server и многих других базах. От dirty write защищают блокировкой строки: транзакция берёт её перед изменением и держит до конца. От dirty read можно защититься той же блокировкой на миг чтения, но тогда одна долгая запись остановит многих читателей, и замедление расползётся по приложению. Так всё же делают IBM Db2 и SQL Server с read_committed_snapshot=off. Чаще база хранит две версии изменённой строки: старую зафиксированную, которую видят все, и новую, которая станет видна после commit.
Ещё слабее уровень read uncommitted: он защищает от dirty write, но не от dirty read. Он может быть быстрее, ведь хранить две версии не нужно.
Snapshot isolation и repeatable read
Заголовок раздела «Snapshot isolation и repeatable read»Даже на read committed гонки возможны. У Aaliyah $1000 на двух счетах, по $500. Транзакция переводит $100 с одного на другой. Если Aaliyah смотрит балансы в этот момент, она может увидеть первый счёт до зачисления ($500), а второй после списания ($400). Кажется, что $100 исчезли. Это read skew, частный случай неповторяемого чтения (nonrepeatable read): повторное чтение первого счёта даст $600. На read committed это допустимо, ведь каждое значение было зафиксировано. Авторы отмечают, что skew здесь значит аномалию во времени, а не перекос нагрузки, как в главе 7.
Для Aaliyah это мелочь: она обновит страницу. Но есть случаи, где такое недопустимо:
- Бэкапы. Копия большой базы делается часами, пока в неё пишут. При восстановлении несогласованность, например исчезнувшие деньги, станет постоянной.
- Аналитика и проверки целостности. Запросы, которые сканируют большую часть базы, дают бессмысленный результат, если видят её части в разные моменты.
Решение — snapshot isolation: каждая транзакция читает согласованный snapshot, то есть все данные, зафиксированные к её началу, и не видит более поздних изменений. Это особенно полезно для бэкапов и аналитики. Варианты есть в PostgreSQL, MySQL/InnoDB, Oracle, SQL Server; Oracle, TiDB и Aurora DSQL даже сделали её своим самым сильным уровнем. Облачные хранилища данных (data warehouse) вроде BigQuery тоже её используют.
MVCC: несколько версий строки
Заголовок раздела «MVCC: несколько версий строки»Как и read committed, snapshot isolation защищает от dirty write блокировками, но чтение блокировок не требует. Принцип такой: читатели не блокируют писателей, а писатели — читателей. Для этого база хранит несколько зафиксированных версий строки, ведь разные транзакции видят базу в разные моменты. Технику называют multiversion concurrency control (MVCC).
В PostgreSQL каждая транзакция получает возрастающий номер (txid), и всё, что она пишет, помечается этим номером. Номер 32-битный и переполняется примерно через 4 миллиарда транзакций, от чего данные защищает процесс vacuum. У строки есть поля inserted_by и deleted_by. Удалённую строку не стирают, а помечают номером удалившей транзакции. Позже сборка мусора (garbage collection, GC) удаляет версии, которые никому не нужны.
Обновление превращается в удаление и вставку. Если транзакция 13 списывает $100 со счёта 2, в таблице появляются две строки: $500 «удалена транзакцией 13» и $400 «вставлена транзакцией 13». Версии одной строки связаны в список, чтобы запрос мог их перебрать.
Правила видимости
Заголовок раздела «Правила видимости»Какие версии видит читающая транзакция, решают номера транзакций:
- Записи транзакций, которые ещё шли в момент её старта, игнорируются, даже если те потом сделают
commit. - Записи транзакций с большим номером, то есть начавшихся позже, игнорируются.
- Записи отменённых транзакций игнорируются всегда, поэтому их не нужно сразу удалять.
- Все остальные записи видны.
Иначе говоря, строка видна, если вставившая её транзакция была зафиксирована до старта читателя, а удаление либо не было, либо ещё не было зафиксировано к этому моменту. Например, транзакция 12 видит на счёте 2 $500: и удаление, и вставку сделала более поздняя транзакция 13. Поскольку база не меняет данные на месте, а добавляет новую версию при каждом изменении, она даёт согласованный snapshot с небольшими накладными расходами. Эти правила можно проверить в разделе «Практика в DuckDB» ниже.
Индексы и snapshot isolation
Заголовок раздела «Индексы и snapshot isolation»Обычно запись индекса указывает на одну из версий строки, и запрос перебирает версии в поисках видимой. GC удаляет старые версии вместе с их записями в индексе. PostgreSQL не трогает индекс, если новая версия помещается на ту же страницу, а другие базы хранят только разницу между версиями.
CouchDB, Datomic и LMDB используют неизменяемый B-tree (copy-on-write): изменённые страницы и их родителей до корня копируют, а остальные страницы общие. Каждая запись создаёт новый корень, и каждый корень — готовый snapshot. Фильтровать по номерам транзакций не нужно, но нужен фоновый процесс для compaction и GC.
Путаница с названиями
Заголовок раздела «Путаница с названиями»Snapshot isolation в PostgreSQL называется «repeatable read», а в Oracle — «serializable». А «repeatable read» в MySQL значит MVCC слабее snapshot isolation, в Db2 — serializability. Причина в стандарте SQL: он опирается на определения System R 1975 года, когда snapshot isolation ещё не придумали. В стандарте есть похожий уровень repeatable read, и PostgreSQL называет так свой уровень, чтобы соответствовать стандарту. Определения стандарта неоднозначны, а формальному определению из научной литературы большинство баз не соответствует. По словам авторов, никто толком не знает, что значит repeatable read.
Как не потерять обновление
Заголовок раздела «Как не потерять обновление»Самый известный конфликт двух пишущих транзакций — lost update, как в примере со счётчиком. Он возникает в цикле read-modify-write: две транзакции читают значение, меняют его, и вторая запись затирает первую. Так бывает со счётчиками и балансами, с добавлением элемента в список внутри JSON-документа, с двумя людьми, которые одновременно сохраняют вики-страницу целиком.
Атомарные операции записи
Заголовок раздела «Атомарные операции записи»Лучшее решение, если задача им поддаётся, — атомарная операция обновления в базе. Такой запрос безопасен в большинстве реляционных баз, его можно проверить в DuckDB:
CREATE TABLE counters (key VARCHAR PRIMARY KEY, value INTEGER);INSERT INTO counters VALUES ('foo', 42);-- два «клиента» прибавляют по 1 атомарной операциейUPDATE counters SET value = value + 1 WHERE key = 'foo';UPDATE counters SET value = value + 1 WHERE key = 'foo';SELECT value FROM counters WHERE key = 'foo';┌───────┐│ value ││ int32 │├───────┤│ 44 │└───────┘MongoDB так же атомарно меняет часть документа, Redis — структуры данных. Произвольную правку текста так не выразить: для неё есть алгоритмы из главы 6. Атомарную операцию делают через эксклюзивную блокировку объекта или выполняют все такие операции в одном потоке. Беда в том, что ORM легко порождает небезопасный read-modify-write вместо атомарной операции.
Явные блокировки
Заголовок раздела «Явные блокировки»Если атомарной операции не хватает, приложение блокирует объекты само. В многопользовательской игре нужно проверить, что ход соответствует правилам, а это логика приложения. Поэтому фигуру блокируют:
BEGIN TRANSACTION;SELECT * FROM figuresWHERE name = 'robot' AND game_id = 222FOR UPDATE; -- заблокировать найденные строки до конца транзакции-- приложение проверяет ход, затем меняет позицию фигурыUPDATE figures SET position = 'c4' WHERE id = 1234;COMMIT;FOR UPDATE блокирует все строки, которые вернул запрос. Это работает, но блокировку легко забыть в одном месте кода. Кроме того, блокировки нескольких объектов грозят deadlock: транзакции ждут друг друга. Базы находят deadlock и отменяют одну из транзакций, а приложение её повторяет.
Автоматическое обнаружение lost update
Заголовок раздела «Автоматическое обнаружение lost update»Атомарные операции и блокировки заставляют такие циклы идти по очереди. Другой путь — дать им идти параллельно, а когда менеджер транзакций заметит lost update, отменить транзакцию, чтобы она повторила свой цикл. База делает это дёшево вместе со snapshot isolation. Так работают repeatable read в PostgreSQL, serializable в Oracle и snapshot isolation в SQL Server. Repeatable read в MySQL/InnoDB этого не делает, и некоторые авторы считают, что поэтому он не даёт настоящей snapshot isolation. Плюс подхода в том, что его нельзя забыть, как блокировку. Но отменённые транзакции приложение должно повторять.
Условная запись (compare-and-set)
Заголовок раздела «Условная запись (compare-and-set)»В базах без транзакций бывает условная запись: изменение применяется, только если значение не изменилось с момента чтения. Например, UPDATE wiki_pages SET content = 'new content' WHERE id = 1234 AND content = 'old content'. Безопасно ли это, зависит от реализации. Удобнее держать номер версии и обновлять только при совпадении. Это называют оптимистичной блокировкой (optimistic locking):
CREATE TABLE wiki_pages (id INTEGER PRIMARY KEY, content VARCHAR, version INTEGER);INSERT INTO wiki_pages VALUES (1234, 'old content', 7);-- оба пользователя открыли страницу версии 7; первый сохраняетUPDATE wiki_pages SET content = 'текст Aaliyah', version = version + 1WHERE id = 1234 AND version = 7 RETURNING id, version;-- второй сохраняет позже: версия уже 8, строка не обновитсяUPDATE wiki_pages SET content = 'текст Bryce', version = version + 1WHERE id = 1234 AND version = 7 RETURNING id, version;┌───────┬─────────┐│ id │ version ││ int32 │ int32 │├───────┼─────────┤│ 1234 │ 8 │└───────┴─────────┘┌───────┬─────────┐│ id │ version ││ int32 │ int32 │├───────┴─────────┤│ 0 rows │└─────────────────┘Второй UPDATE вернул 0 строк, и приложение должно перечитать страницу и повторить. Тонкость: по правилам MVCC чужая новая версия может быть не видна. Поэтому многие базы делают исключение и показывают чужие записи в условии WHERE у UPDATE и DELETE.
Разрешение конфликтов при репликации
Заголовок раздела «Разрешение конфликтов при репликации»Блокировки и условная запись предполагают одну актуальную копию данных. При репликации с несколькими leader или без leader её нет, поэтому эти приёмы не работают. Такие базы допускают несколько конфликтующих версий (siblings) и потом сливают их. Слияние спасает от lost update, если операции коммутативны, то есть дают один результат в любом порядке: прибавление к счётчику, добавление в множество. На этом построены CRDT из главы 6. Но условную запись коммутативной не сделать, а метод last write wins (LWW), который часто стоит по умолчанию, теряет обновления.
Write skew и phantoms
Заголовок раздела «Write skew и phantoms»Бывают и более тонкие конфликты. Пример: приложение для дежурств врачей. На смене должен оставаться хотя бы один дежурный. Aaliyah и Bryce дежурят вместе, оба заболели и почти одновременно нажимают «уйти с дежурства». Каждая транзакция проверяет, что дежурных двое или больше. База работает со snapshot isolation, обе проверки видят 2, и обе транзакции снимают своего врача. После двух commit на смене никого нет.
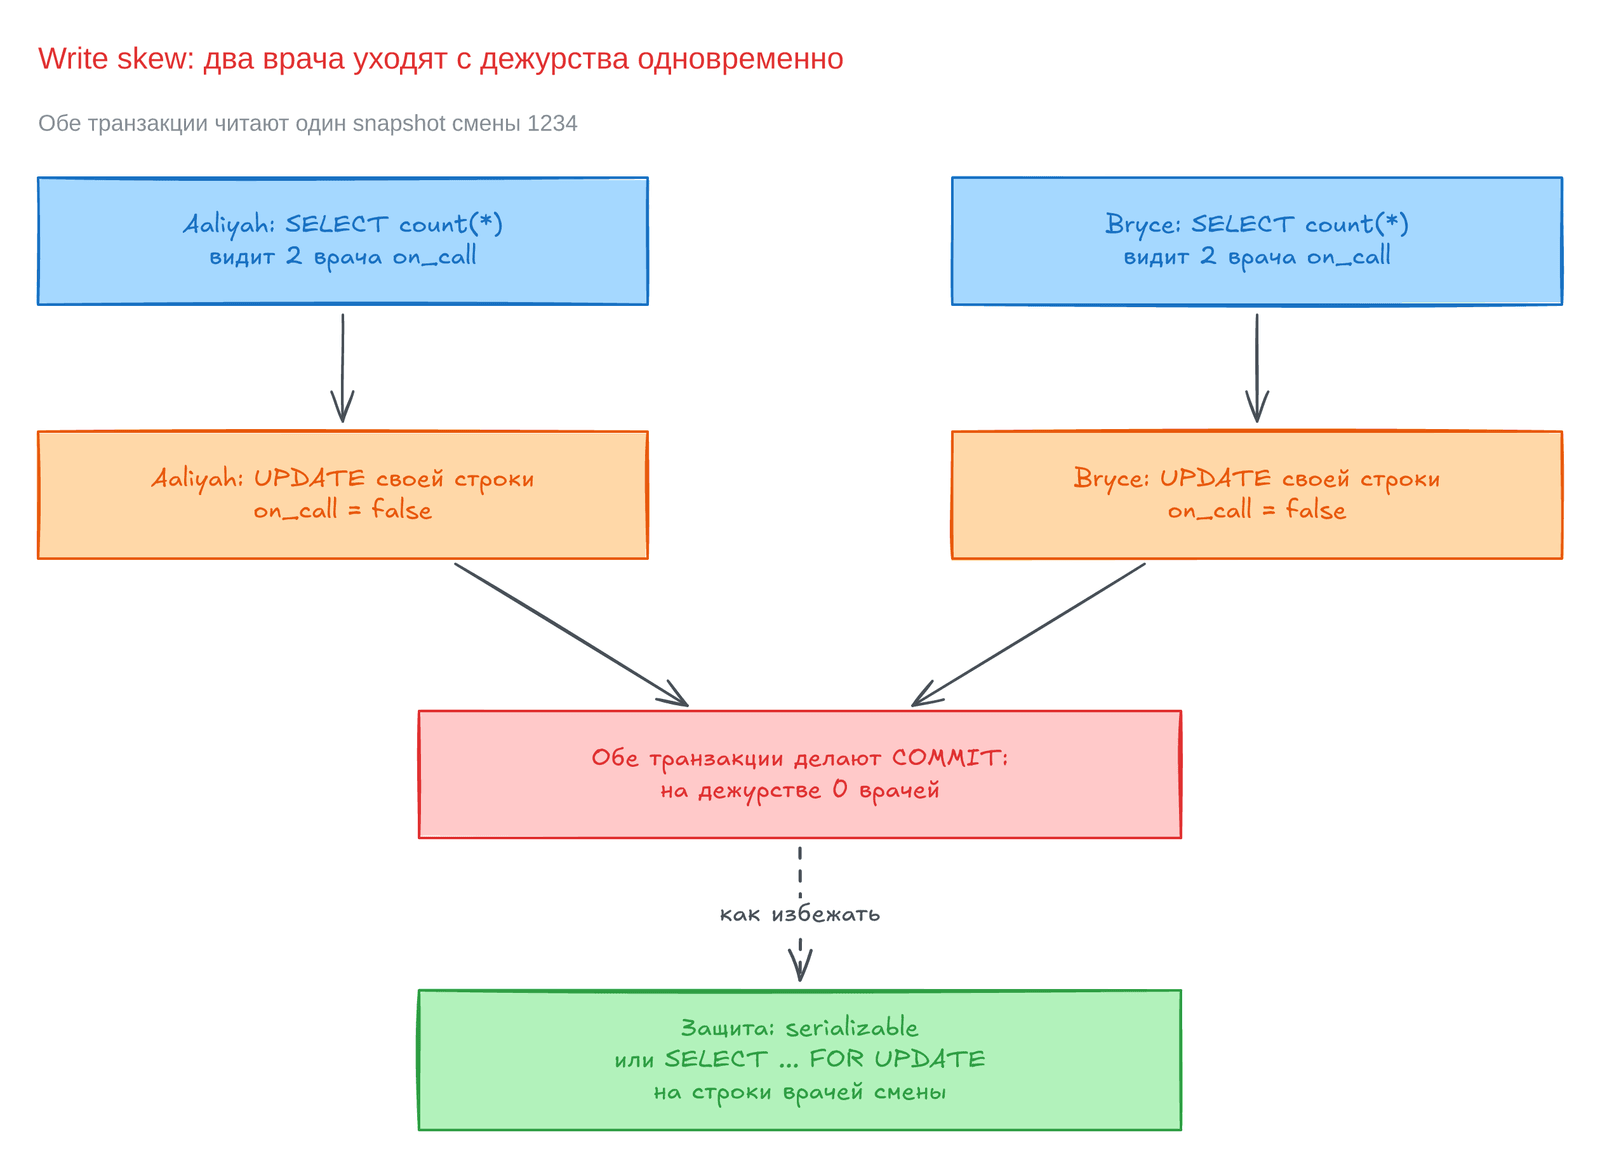
Две колонки на схеме — две транзакции. Каждая по отдельности корректна, но вместе они нарушают правило, потому что опирались на один snapshot.
Что такое write skew
Заголовок раздела «Что такое write skew»Это write skew. Это не dirty write и не lost update: транзакции меняют разные строки. Но это гонка: если бы транзакции шли по очереди, второй врач не смог бы уйти. Write skew — обобщение lost update: транзакции читают одни объекты и меняют часть из них, возможно разные. Если меняют один и тот же, выходит dirty write или lost update.
Способов защиты меньше:
- Атомарные операции над одним объектом не помогают.
- Автоматическое обнаружение
lost updateтоже:write skewне ловят ниrepeatable readв PostgreSQL и MySQL, ни «serializable» в Oracle, ниsnapshot isolationв SQL Server. Нужна настоящаяserializability. - Ограничение на несколько объектов («хотя бы один дежурный») большинство баз не поддерживает, разве что через триггеры или материализованные представления.
- Если
serializableнедоступен, остаётся явно заблокировать строки, от которых зависит решение:SELECT * FROM doctors WHERE on_call = true AND shift_id = 1234 FOR UPDATE, а затемUPDATEсвоей строки.
Мы проверили сценарий в PostgreSQL 14. Скрипт ch08_write_skew.sh запускает две транзакции параллельно: врачи читают число дежурных, ждут и снимают себя. На repeatable read (то есть snapshot isolation) обе проходят. На serializable одна получает ошибку:
== REPEATABLE READAaliyah видит на дежурстве: 2Bryce видит на дежурстве: 2итог: на дежурстве 0== SERIALIZABLEAaliyah видит на дежурстве: 2Bryce видит на дежурстве: 2ошибка: could not serialize access due to read/write dependencies among transactionsитог: на дежурстве 1Другие примеры write skew
Заголовок раздела «Другие примеры write skew»- Бронирование переговорок. Приложение ищет пересекающиеся брони и, если их нет, создаёт встречу.
Snapshot isolationне мешает другому пользователю параллельно вставить конфликтующую бронь. - Многопользовательская игра. Блокировка одной фигуры не мешает поставить две разные фигуры на одну клетку.
- Выбор имени пользователя. Проверка «имя свободно?» небезопасна, но здесь просто помогает ограничение уникальности.
- Двойная трата. Две траты вставляют параллельно, каждая проверка баланса проходит, а в сумме баланс уходит в минус.
Phantoms и write skew
Заголовок раздела «Phantoms и write skew»Все примеры устроены одинаково. Сначала SELECT проверяет условие по строкам. Потом приложение решает, продолжать ли. Наконец, оно пишет (INSERT, UPDATE, DELETE) и делает commit. Запись меняет предпосылку решения: повторный SELECT дал бы другой результат.
С врачами помогает SELECT FOR UPDATE, потому что запись меняет одну из прочитанных строк. В остальных примерах проверяют отсутствие строк, а запись такую строку добавляет. Если SELECT ничего не вернул, блокировать нечего. Это и есть phantom: запись одной транзакции меняет результат поиска другой. Snapshot isolation защищает от phantom в запросах только на чтение, но в транзакциях с записью он порождает хитрые случаи write skew. SQL, который генерирует ORM, тоже склонен к таким случаям.
Материализация конфликтов
Заголовок раздела «Материализация конфликтов»Если блокировать нечего, можно создать объект для блокировки. Для переговорок заводят таблицу слотов: строка на каждую комнату и каждые 15 минут на полгода вперёд. Транзакция бронирования блокирует нужные слоты через SELECT FOR UPDATE, потом проверяет пересечения и вставляет бронь. Это называют материализацией конфликтов. Но приём трудный, легко ошибиться, а механизм конкурентности просачивается в модель данных. Авторы советуют его только как крайнюю меру: обычно лучше serializable.
Serializability
Заголовок раздела «Serializability»Картина печальная. Уровни изоляции трудно понять, и в разных базах они разные. По коду трудно понять, безопасен ли он на данном уровне. Хороших инструментов для поиска гонок нет, а тесты их почти не ловят. Так обстоят дела с 1970-х, и всё это время исследователи советуют одно: используйте serializable.
Serializable — самый сильный уровень: транзакции могут идти параллельно, но результат такой же, как при выполнении по одной. Если транзакции корректны по отдельности, они корректны и вместе. Почему его используют не все? Ответ в цене реализации. Сегодня его получают тремя способами: буквально последовательным выполнением, two-phase locking и оптимистичными методами вроде SSI.
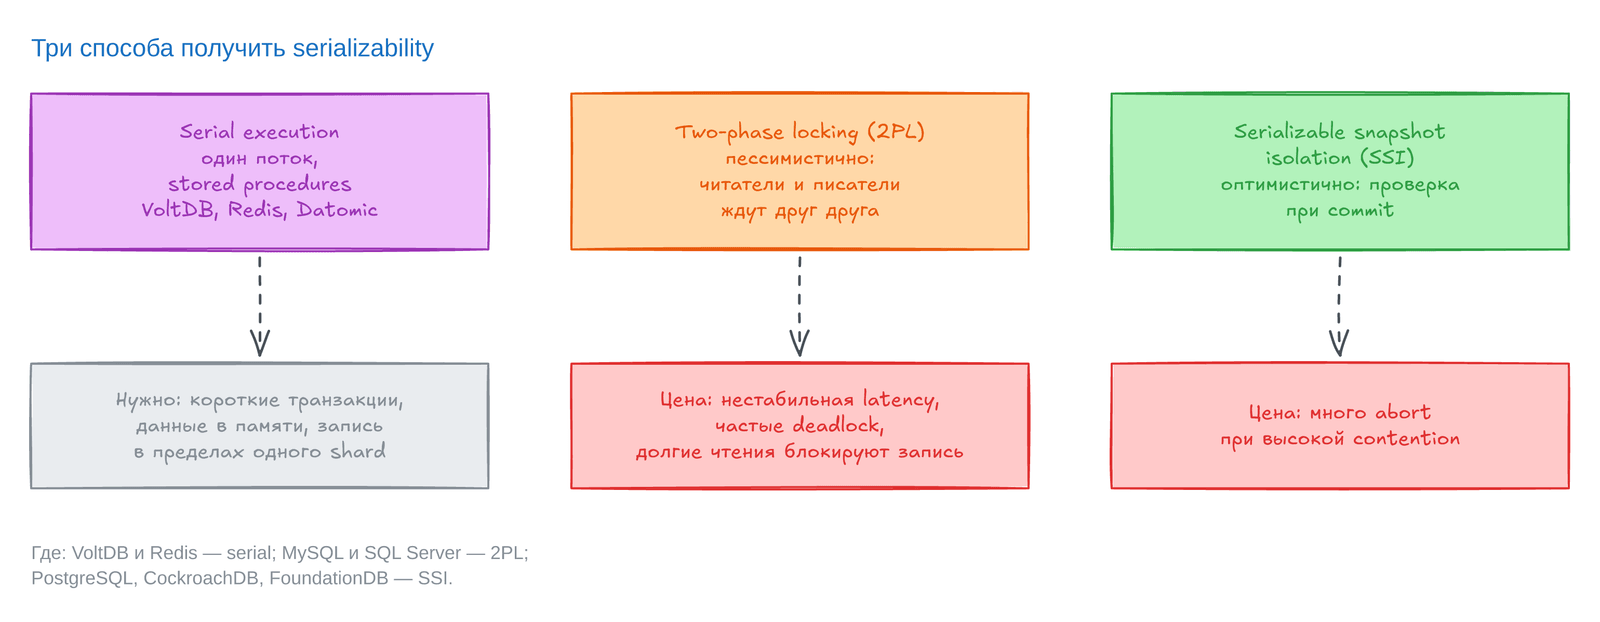
В верхнем ряду схемы — три способа и их идея, в нижнем — ограничения или цена каждого.
Буквально последовательное выполнение
Заголовок раздела «Буквально последовательное выполнение»Самый простой способ избежать гонок — выполнять транзакции по одной в одном потоке. Тогда изоляция serializable обеспечена по определению. Эту идею признали реальной только в 2000-х, по двум причинам. Во-первых, память подешевела, и активный набор данных часто помещается в RAM. Во-вторых, OLTP-транзакции обычно короткие, а долгую аналитику можно выполнять по snapshot вне последовательного цикла. Так работают VoltDB/H-Store, Redis и Datomic. Без координации блокировок они иногда быстрее конкурентных систем, но их throughput ограничен одним ядром.
Транзакции в хранимых процедурах
Заголовок раздела «Транзакции в хранимых процедурах»Сначала думали, что транзакция охватит весь сценарий пользователя, например покупку авиабилета от поиска до оплаты. Но люди отвечают медленно, и база не может держать тысячи простаивающих транзакций. Поэтому в вебе транзакция укладывается в один HTTP-запрос.
Но транзакции остались интерактивными: приложение шлёт запрос, читает ответ, шлёт следующий. Много времени уходит на сеть, и однопоточная база почти всё время ждала бы приложение. Поэтому однопоточные системы не допускают интерактивных транзакций. Приложение либо ограничивается одним запросом, либо заранее отправляет весь код транзакции в базу как хранимую процедуру (stored procedure). Если данные в памяти, процедура выполняется очень быстро, без ожидания сети и диска.
Плюсы и минусы хранимых процедур
Заголовок раздела «Плюсы и минусы хранимых процедур»У хранимых процедур, которые входят в стандарт SQL с 1999 года, плохая репутация:
- У каждого вендора свой устаревший язык (PL/SQL, T-SQL, PL/pgSQL) без экосистемы библиотек.
- Код в базе труднее отлаживать, версионировать, выкатывать, тестировать и мониторить.
- Одну базу делят многие серверы приложений, поэтому плохая процедура вредит сильнее, чем плохой код в приложении.
- В мультитенантной системе чужой код в процессе базы небезопасен.
Но современные реализации используют обычные языки: VoltDB — Java или Groovy, Datomic — Java или Clojure, Redis — Lua, MongoDB — JavaScript. Процедуры полезны и там, где логику больше негде разместить, например за GraphQL-прокси, который открывает базу напрямую.
VoltDB использует процедуры и для репликации: он выполняет ту же процедуру на каждой реплике. Поэтому процедуры должны быть детерминированными, а текущее время брать через специальные API. Это называют state machine replication, о нём рассказывает глава 10.
Sharding
Заголовок раздела «Sharding»Чтобы выйти за пределы одного ядра, данные делят на shard, и у каждого shard свой поток. Если каждая транзакция работает в одном shard, throughput растёт линейно с числом ядер. Но транзакцию между несколькими shard нужно координировать, и она намного медленнее: VoltDB сообщает примерно о 1000 таких записей в секунду, и новые машины этого не меняют. Простые данные ключ-значение делятся легко, а данные с несколькими вторичными индексами требуют много координации.
Итого последовательное выполнение подходит, если транзакции маленькие и быстрые, активные данные помещаются в память, а поток записей тянет одно ядро или делится по shard без координации.
Two-phase locking (2PL)
Заголовок раздела «Two-phase locking (2PL)»Около 30 лет для serializability применяли один алгоритм — two-phase locking (2PL). Авторы предупреждают: 2PL и 2PC — совсем разные вещи. 2PL даёт изоляцию, а 2PC — атомарный commit в распределённой базе.
2PL похож на блокировки против dirty write, но требования к блокировкам намного строже. Читать объект могут несколько транзакций сразу, но запись требует эксклюзивного доступа. Если A прочитала объект, B ждёт конца A, прежде чем писать. Если A записала объект, B ждёт, прежде чем читать: старую версию, как в MVCC, читать нельзя. Значит, писатели блокируют читателей, и наоборот, в отличие от snapshot isolation. Зато 2PL защищает от всех гонок выше, включая lost update и write skew.
Как устроен 2PL
Заголовок раздела «Как устроен 2PL»2PL используют serializable в MySQL/InnoDB и SQL Server и repeatable read в Db2. У каждого объекта есть блокировка в разделяемом (shared) или эксклюзивном (exclusive) режиме. Для чтения берут разделяемую: её могут держать многие, но не при чужой эксклюзивной. Для записи берут эксклюзивную, и тогда никто другой не держит никакой. Транзакция, которая сначала читала, а потом пишет, повышает блокировку до эксклюзивной. Взятые блокировки держат до commit или abort. Отсюда название: в первой фазе блокировки только берут, во второй, в конце, отпускают все. Блокировок много, поэтому часто бывает deadlock. База его находит и отменяет одну из транзакций.
Скорость 2PL
Заголовок раздела «Скорость 2PL»Главный минус 2PL — скорость. Throughput и время ответа заметно хуже, чем при слабой изоляции, в основном из-за меньшей параллельности. Например, транзакция, которая читает всю таблицу для бэкапа или аналитики, берёт разделяемую блокировку на всю таблицу и надолго закрывает её для записи. Поэтому задержка (latency) при 2PL нестабильна и велика на высоких перцентилях: одна медленная транзакция может остановить всю систему. Deadlock случается чаще, чем на read committed, и вся работа отменённой транзакции делается заново.
Predicate lock
Заголовок раздела «Predicate lock»База с serializable должна защищать и от phantom. В примере с переговорками, пока одна транзакция ищет брони комнаты 123 с 12:00 до 13:00, другая не должна вставлять пересекающуюся бронь этой комнаты. Для этого нужна предикатная блокировка (predicate lock): она принадлежит не строке, а всем объектам, подходящим под условие поиска. Читатель берёт разделяемую блокировку на условие. Писатель проверяет, подходит ли старое или новое значение под чужую предикатную блокировку, и если да, ждёт. Главное, что блокировка действует и на объекты, которых ещё нет. 2PL с предикатными блокировками даёт настоящую serializability.
Index-range lock
Заголовок раздела «Index-range lock»Предикатные блокировки медленные: проверять совпадения при большом числе блокировок долго. Поэтому базы используют index-range lock (next-key locking) — упрощённое приближение. Упрощать безопасно, если новое условие шире старого: вместо «комната 123 с полудня до часу» блокируют «комнату 123 в любое время» или «все комнаты с полудня до часу». База вешает разделяемую блокировку на запись индекса room_id или на диапазон индекса по времени. Транзакция, которая хочет вставить пересекающуюся бронь, должна обновить ту же часть индекса и натыкается на блокировку. Это менее точно, чем предикат, зато намного дешевле. Если подходящего индекса нет, база блокирует всю таблицу: медленно, но безопасно.
Serializable snapshot isolation (SSI)
Заголовок раздела «Serializable snapshot isolation (SSI)»Итак, serializability либо медленная (2PL), либо плохо масштабируется (последовательное выполнение), а слабые уровни быстры, но подвержены гонкам. Serializable snapshot isolation (SSI) даёт полную serializability при небольшой потере скорости по сравнению со snapshot isolation. Его описали в 2008 году. Сегодня SSI и похожие алгоритмы используют PostgreSQL (уровень serializable), SQL Server Hekaton, HyPer, CockroachDB, FoundationDB и BadgerDB.
Пессимистичный и оптимистичный подход
Заголовок раздела «Пессимистичный и оптимистичный подход»2PL пессимистичен: если что-то может пойти не так, лучше подождать. Последовательное выполнение — крайний пессимизм: по сути, каждая транзакция держит эксклюзивную блокировку всей базы. Этот пессимизм компенсируют тем, что каждая транзакция выполняется очень быстро. SSI оптимистичен: транзакции идут без ожидания, а перед commit база проверяет, не нарушена ли изоляция, и если нарушена, отменяет транзакцию.
При высокой конкуренции (contention) оптимизм проигрывает: отменяется много транзакций, а повторы добавляют нагрузку. Но при запасе мощности и умеренной конкуренции он обычно быстрее. Конкуренцию снижают коммутативные операции: прибавления к счётчику без чтения не конфликтуют. SSI построен на snapshot isolation и добавляет алгоритм, который находит конфликты между чтениями и записями.
Решения на устаревшей предпосылке
Заголовок раздела «Решения на устаревшей предпосылке»В примерах write skew транзакция читает данные и по ним решает, что записать. При snapshot isolation к commit прочитанное может устареть: предпосылка «дежурят двое» уже неверна. База не знает, как приложение использует результат, поэтому считает: если результат запроса изменился, записи могли стать неверными. Ей нужно ловить два случая: чтение устаревшей версии MVCC и запись, которая меняет уже прочитанное.
Обнаружение устаревших чтений MVCC
Заголовок раздела «Обнаружение устаревших чтений MVCC»В примере книги транзакция 43 видит у Aaliyah on_call = true, потому что транзакция 42, снявшая её с дежурства, ещё не зафиксирована. Но к commit транзакции 43 транзакция 42 уже зафиксирована, и предпосылка 43 неверна. База запоминает, какие чужие записи транзакция проигнорировала по правилам видимости. Перед commit она проверяет, не зафиксированы ли они, и если да, отменяет транзакцию.
Отменять сразу при чтении не стоит. Транзакция может оказаться только читающей, и тогда ей ничего не грозит. А транзакция 42 может ещё отмениться. Без лишних отмен SSI сохраняет возможность долгих чтений из согласованного snapshot.
Обнаружение записей, которые меняют прочитанное
Заголовок раздела «Обнаружение записей, которые меняют прочитанное»Второй случай похож на index-range lock, только блокировка никого не задерживает. Транзакции 42 и 43 ищут дежурных смены 1234, и база отмечает на записи индекса shift_id = 1234, что они это читали. Отметки хранят, пока не закончатся все параллельные транзакции. Когда транзакция пишет, она ищет в индексах недавних читателей этих данных. Это похоже на блокировку записи на диапазон ключей, но блокировка не ждёт, пока читатели завершатся, а только сообщает им, что прочитанное могло устареть. Транзакция 42 делает commit первой и успешно. Когда commit хочет сделать 43, конфликтующая запись 42 уже зафиксирована, и 43 отменяют.
Скорость SSI
Заголовок раздела «Скорость SSI»Важно, насколько подробно отслеживать чтения и записи: точный учёт дорог, грубый отменяет лишние транзакции. Иногда транзакция может прочитать данные, которые перезаписала другая, и всё же можно доказать, что результат serializable. PostgreSQL использует эту теорию, чтобы реже отменять транзакции зря.
В отличие от 2PL, транзакции не ждут чужих блокировок, поэтому задержка предсказуема, а чтения идут без блокировок. В отличие от последовательного выполнения, SSI не ограничен одним ядром: FoundationDB распределяет поиск конфликтов по многим машинам. Насколько велики накладные расходы по сравнению со snapshot isolation, спорят. Доля отмен сильно влияет на скорость, поэтому транзакции чтения-записи должны быть короткими, а долгие транзакции только на чтение допустимы.
Распределённые транзакции
Заголовок раздела «Распределённые транзакции»Если транзакция затрагивает несколько узлов (несколько shard или глобальный вторичный индекс), она распределённая. Управление конкурентностью здесь похоже на одноузловое, а вот атомарность — новая трудность.
На одном узле атомарность обеспечивает порядок записи на диск: сначала данные, потом запись о commit. Если запись о commit дошла до диска, транзакция зафиксирована даже после сбоя, если нет — откатывается. Решает всё одно устройство — контроллер одного диска.
На нескольких узлах нельзя просто разослать commit и зафиксировать транзакцию на каждом. На одних узлах она пройдёт, а на других нет: где-то нарушено ограничение, где-то запрос потерялся в сети, где-то узел упал до записи о commit. Отозвать зафиксированную транзакцию нельзя, ведь её данные уже видят другие транзакции. Нужно, чтобы все узлы вместе сделали commit или abort. Это задача атомарного commit (atomic commitment).
Two-phase commit (2PC)
Заголовок раздела «Two-phase commit (2PC)»Two-phase commit (2PC) — классический алгоритм атомарного commit на нескольких узлах. Его используют внутри баз, а приложениям он доступен через транзакции XA (например, в Java Transaction API). В 2PC есть координатор (coordinator, менеджер транзакций), часто это библиотека внутри процесса приложения. Узлы базы называют участниками (participants).
Приложение читает и пишет данные на участниках как обычно. Когда оно готово к commit, координатор начинает фазу 1 и спрашивает каждого участника через prepare, готов ли он. Если все ответили «да», в фазе 2 координатор рассылает commit. Если хоть один ответил «нет», всем уходит abort. Авторы сравнивают это со свадьбой: регистратор спрашивает каждого, согласен ли он, и только после двух «да» объявляет пару супругами.
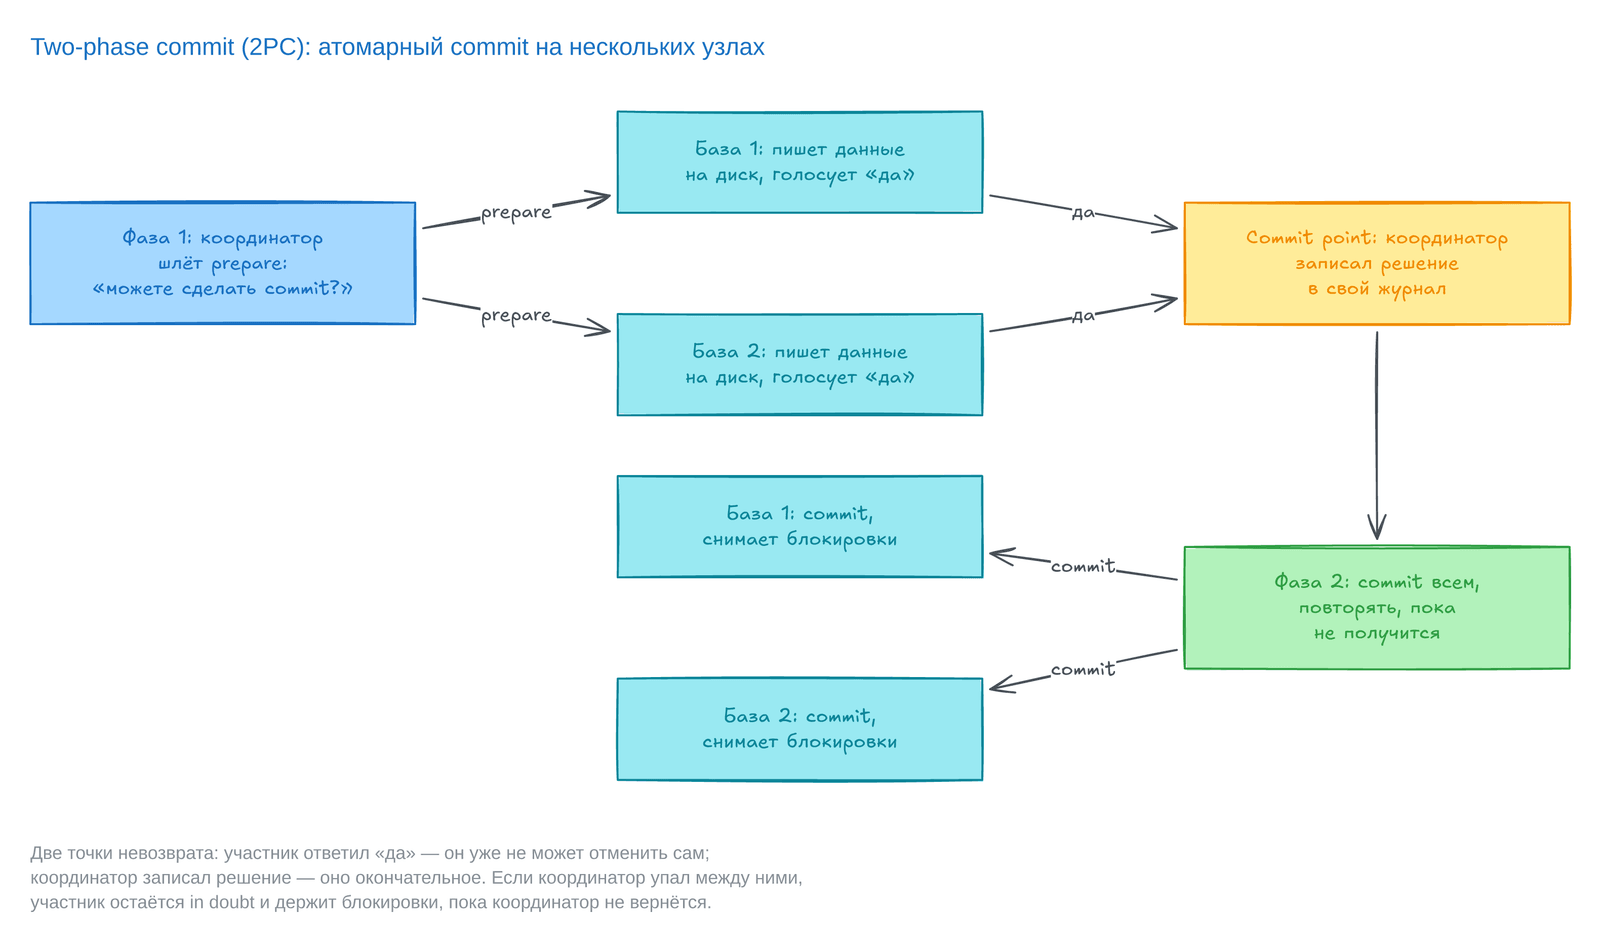
Схема читается слева направо, затем вниз по правой колонке. Жёлтый блок — commit point: после него решение уже не изменить.
Система обещаний
Заголовок раздела «Система обещаний»Почему две фазы работают, а одна нет? Разберём процесс подробнее:
- Приложение получает у координатора глобально уникальный номер транзакции.
- На каждом участнике открывается обычная транзакция с этим номером. До
prepareкоординатор или любой участник может её отменить. - Координатор шлёт всем
prepare. Если какой-то запрос не прошёл, он шлёт всемabort. - Участник пишет все данные на диск и проверяет конфликты и ограничения. Отвечая «да», он обещает сделать
commitпри любых обстоятельствах, то есть отказывается от права наabort. - Координатор принимает решение (
commit, только если все сказали «да») и пишет его в свой журнал на диске. Это точка фиксации (commit point). - Координатор рассылает решение и повторяет запрос бесконечно, пока не получится. Упавший участник сделает
commitпосле восстановления.
Итак, есть две точки невозврата: «да» участника и решение координатора. Эти обещания и дают атомарность. На одном узле оба события сливаются в одно — запись о commit в журнал. В свадебной аналогии: если вы упали в обморок после «да», брак всё равно заключён, и, очнувшись, вы можете спросить регистратора о статусе транзакции.
Сбой координатора
Заголовок раздела «Сбой координатора»Если координатор упал до prepare, участник может спокойно отменить транзакцию. Но после ответа «да» он сам уже ничего не решает и ждёт координатора. Такую транзакцию называют in doubt (под вопросом). Пример из книги: координатор решил сделать commit, база 2 получила его, а до базы 1 запрос не дошёл. Если база 1 отменит транзакцию по таймауту, она разойдётся с базой 2. Сама сделать commit она тоже не может: другой участник мог сказать «нет».
Поэтому 2PC завершается, только когда координатор восстановится и прочитает журнал. Транзакции без записи о commit в журнале отменяются. Значит, точка фиксации 2PC сводится к обычному одноузловому commit на координаторе. Если журнал координатора потерян, остаётся только ручное решение администратора. Если пропала лишь последняя часть журнала, координатор может отменить уже зафиксированные транзакции и нарушить атомарность.
Three-phase commit
Заголовок раздела «Three-phase commit»2PC — блокирующий протокол: он может застрять в ожидании координатора. Неблокирующий three-phase commit (3PC) предполагает ограниченные задержки сети и времени ответа. В реальных системах их нет (глава 9), и 3PC атомарность не гарантирует. На практике лучше заменить одноузлового координатора отказоустойчивым консенсусом (глава 10).
Распределённые транзакции между разными системами
Заголовок раздела «Распределённые транзакции между разными системами»У распределённых транзакций неоднозначная репутация. Они дают важную гарантию, но их критикуют за проблемы в эксплуатации и низкую скорость, и многие облачные сервисы их не поддерживают. Главные расходы 2PC — лишние fsync и пересылки по сети. Важно различать два вида:
- Внутри одной базы. Узлы работают на одном ПО: YugabyteDB, TiDB, FoundationDB, Spanner, VoltDB, Cassandra, MySQL Cluster NDB. Такие транзакции могут использовать любые оптимизации и часто работают неплохо.
- Разнородные. Участники — разные технологии, например базы двух вендоров или база и
message broker. Это намного сложнее.
Обработка сообщений exactly-once
Заголовок раздела «Обработка сообщений exactly-once»Разнородная транзакция позволяет подтвердить сообщение из очереди тогда и только тогда, когда транзакция базы, которая его обработала, зафиксирована. Если сломалось что-то одно, отменяется всё, и брокер доставит сообщение снова. Так сообщение фактически обрабатывается ровно один раз, даже после нескольких попыток. Это семантика exactly-once. Но все затронутые системы должны поддерживать один протокол: если почтовый сервер не умеет 2PC, письмо при повторе может уйти дважды.
Транзакции XA
Заголовок раздела «Транзакции XA»X/Open XA — стандарт 2PC между разными технологиями, появился в 1991 году. Его поддерживают PostgreSQL, MySQL, Db2, SQL Server, Oracle и брокеры ActiveMQ, HornetQ, MSMQ, IBM MQ. XA — не сетевой протокол, а C API для связи с координатором. В Java его реализует JTA через драйверы JDBC и JMS. Драйвер сообщает базе, что операция входит в распределённую транзакцию, и даёт координатору функции для prepare, commit и abort.
Координатор обычно библиотека в процессе приложения, которая хранит решения в журнале на локальном диске. Если приложение упало, координатор погибает с ним, и подготовленные транзакции участников застревают in doubt. Сервер приложения нужно перезапустить, чтобы библиотека прочитала журнал. База сама связаться с координатором не может.
Блокировки на время in doubt
Заголовок раздела «Блокировки на время in doubt»Застрявшая транзакция опасна из-за блокировок. Она держит эксклюзивные блокировки на изменённые строки, а при serializable на 2PL ещё и разделяемые на прочитанные. Отпустить их можно только после commit или abort. Если координатор поднимался 20 минут, блокировки держатся 20 минут, а если его журнал потерян — вечно. Всё это время другие транзакции не могут изменить, а иногда и прочитать эти строки, и большие части приложения становятся недоступны.
Восстановление после сбоя координатора
Заголовок раздела «Восстановление после сбоя координатора»На практике бывают «осиротевшие» транзакции in doubt, исход которых координатор не может определить, например из-за испорченного журнала. Перезагрузка базы не поможет: правильная реализация 2PC сохраняет их блокировки и после перезапуска. Остаётся ручная работа администратора: найти, где транзакция уже зафиксирована или отменена, и применить тот же исход к остальным участникам. Делать это, скорее всего, придётся в стрессе посреди аварии. Во многих реализациях XA есть аварийный выход — эвристические решения (heuristic decisions), когда участник решает сам. Авторы подчёркивают, что «эвристический» здесь — эвфемизм для «вероятно, нарушающий атомарность».
Проблемы транзакций XA
Заголовок раздела «Проблемы транзакций XA»Одноузловой координатор — единая точка отказа, а его журнал на диске сервера приложений становится не менее важным, чем сами базы. Координатор можно реплицировать, но координатор и участники в XA общаются только через код приложения, поэтому единой точкой отказа остаётся само приложение. Исправить это могло бы что-то вроде durable execution из главы 5, но таких инструментов, судя по всему, нет. Кроме того, XA — наименьший общий знаменатель: он не находит deadlock между системами и не работает с SSI. Согласованность разнородных систем всё равно нужна, и другое решение авторы показывают дальше, в главе 12.
Распределённые транзакции внутри базы
Заголовок раздела «Распределённые транзакции внутри базы»Внутренние распределённые транзакции — определяющая черта баз NewSQL: CockroachDB, TiDB, Spanner, FoundationDB, YugabyteDB. Их поддерживает и Kafka. Многие такие системы используют 2PC для записи в несколько shard, но без проблем XA, потому что им не нужно стыковаться с чужими технологиями. Главные проблемы XA они решают так:
- координатор реплицируют с автоматическим
failover; - координатор и
shardобщаются напрямую, без кода приложения; - участвующие
shardреплицируют, чтобы реже отменять транзакции из-за сбоя; - атомарный
commitсвязывают с распределённым управлением конкурентностью, которое находитdeadlockи даёт согласованное чтение междуshard.
Координатор и shard обычно реплицируют алгоритмами консенсуса (глава 10), которые переключаются между узлами без участия человека. Между shard возможны и snapshot isolation, и SSI.
Ещё раз об exactly-once
Заголовок раздела «Ещё раз об exactly-once»Для exactly-once распределённые транзакции на самом деле не нужны. Хватит транзакций внутри одной базы:
- У каждого сообщения есть уникальный ID, а в базе — таблица обработанных ID. Обработку начинают с транзакции, которая проверяет ID. Если он уже есть, сообщение подтверждают брокеру и выбрасывают.
- Если ID нет, его добавляют, обрабатывают сообщение в той же транзакции и делают
commit. - После
commitсообщение подтверждают брокеру. - После подтверждения ID можно удалить отдельной транзакцией.
Сбой до commit отменит транзакцию, и брокер повторит доставку. При сбое после commit, но до подтверждения, повтор увидит ID и выбросит сообщение. Старый ID после сбоя на последнем шаге лишь занимает место. Если повтор начался до отмены первой попытки, ограничение уникальности не даст вставить ID дважды. Запись ID делает обработку идемпотентной, то есть безопасной для повтора. Похожий приём использует Kafka Streams (глава 12). Внутренние распределённые транзакции всё равно полезны для масштабирования: ID могут лежать в одном shard, а данные — в других.
Итоги главы
Заголовок раздела «Итоги главы»Наша сводка аномалий и уровней, которые от них защищают:
| Аномалия | Что происходит | Где уже нет |
|---|---|---|
Dirty read | Клиент читает чужие незафиксированные записи | read committed и выше |
Dirty write | Клиент перезаписывает чужие незафиксированные данные | Почти во всех реализациях |
Read skew | Клиент видит части базы в разные моменты | snapshot isolation (MVCC) |
Phantom | Запись меняет результат чужого поиска по условию | Для чтения — snapshot isolation; при write skew — index-range lock или serializable |
Lost update | Два цикла read-modify-write, одна запись затирает другую | Часть реализаций snapshot isolation, SELECT FOR UPDATE, serializable |
Write skew | Решение по прочитанному, но к записи предпосылка неверна | Только serializable |
- Транзакция сводит большой класс сбоев и гонок к простому
abort, после которого приложение повторяет попытку. - ACID в разных базах значит разное: атомарность — это отменяемость, согласованность зависит от приложения, а идеальной долговечности не бывает.
Read committedзащищает отdirty readиdirty write, но допускаетread skew,lost updateиwrite skew.Snapshot isolationна основе MVCC даёт согласованный snapshot для бэкапов и аналитики, но не защищает отwrite skew.- Названия уровней путаются:
repeatable readв PostgreSQL, MySQL и Db2 означает три разные вещи. Serializabilityполучают тремя способами: последовательным выполнением,2PLи SSI.2PLдаёт нестабильную задержку, а SSI оптимистично отменяет транзакции с устаревшей предпосылкой.2PCдаёт атомарныйcommitна нескольких узлах, но при сбое координатора транзакции остаютсяin doubtи держат блокировки.- Внутри одной базы распределённые транзакции работают хорошо, между разными технологиями (XA) — плохо, а
exactly-onceможно получить через идемпотентность.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
commit / abort | Зафиксировать транзакцию / отменить её записи |
| Атомарность | «Всё или ничего» при сбое: отменённая транзакция ничего не меняет |
| Инвариант | Правило о данных, которое должно выполняться всегда |
| Долговечность | Зафиксированные данные не пропадают после сбоя |
serializability | Результат такой же, как при выполнении транзакций по очереди |
snapshot isolation | Транзакция читает согласованный snapshot на момент своего начала |
| MVCC | Несколько версий строки, чтобы читатели и писатели не блокировали друг друга |
dirty read / dirty write | Чтение или перезапись чужих незафиксированных данных |
read skew | Транзакция видит части базы в разные моменты |
lost update | Одна из двух параллельных записей read-modify-write теряется |
write skew | Решение по прочитанному, предпосылка которого к записи неверна |
phantom | Запись одной транзакции меняет результат поиска другой |
two-phase locking (2PL) | Блокировки на чтение и запись держатся до конца транзакции |
predicate lock / index-range lock | Блокировка по условию поиска / её приближение по индексу |
| SSI | Оптимистичная serializability: проверка конфликтов при commit |
two-phase commit (2PC) | Атомарный commit на нескольких узлах: prepare, затем commit |
in doubt | Участник сказал «да», но не знает решения координатора |
exactly-once | Сообщение влияет на результат ровно один раз, даже при повторах |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Узнайте, какой уровень изоляции реально у вашей базы по умолчанию.
repeatable readиserializableв разных системах значат разное. - Не пишите read-modify-write в коде приложения (особенно в ORM). Используйте атомарный
UPDATEилиFOR UPDATE. - Проверки вида «если такой строки нет, создать» опасны. Используйте ограничение уникальности или уровень serializable.
- Повторяйте транзакцию при временных ошибках (deadlock, нарушение изоляции), с backoff и лимитом повторов. Делайте операции идемпотентными: повтор не должен дублировать данные.
- Для бэкапов, долгой аналитики и выгрузок в хранилище нужен согласованный snapshot. Иначе данные получатся несогласованными.
- В
pipelineбез транзакций (многие NoSQL, потоки) сами следите за расхождением денормализованных данных и источника. - Загрузку из
message brokerв хранилище делайте идемпотентной: храните ID сообщения в целевой таблице с ограничением уникальности. Это проще и надёжнее, чем XA. - При уровне
serializableповторяйте транзакцию целиком, а не один упавший запрос.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. Мы смоделируем правила видимости MVCC обычными таблицами: в настоящей базе они спрятаны внутри движка.
Шаг 1. Создаём версии строк
Заголовок раздела «Шаг 1. Создаём версии строк»Транзакция 13 переводит $100 со счёта 2 на счёт 1. Пополнение счёта 3 на $50 сделала транзакция 11, которая ещё шла, когда стартовала транзакция 12. А строку счёта 4 вставила транзакция 10, и её отменили.
CREATE TABLE txns (txid INTEGER PRIMARY KEY, status VARCHAR);INSERT INTO txns VALUES (3, 'committed'), (5, 'committed'), (10, 'aborted'), (11, 'committed'), (13, 'committed');-- какие транзакции ещё шли, когда стартовал читательCREATE TABLE in_progress_at_start (reader INTEGER, txid INTEGER);INSERT INTO in_progress_at_start VALUES (12, 11);CREATE TABLE account_versions (account_id INTEGER, balance INTEGER, inserted_by INTEGER, deleted_by INTEGER);INSERT INTO account_versions VALUES (1, 500, 3, 13), (1, 600, 13, NULL), (2, 500, 5, 13), (2, 400, 13, NULL), (3, 200, 3, 11), (3, 250, 11, NULL), (4, 999, 10, NULL);-- запись транзакции w видна читателю r по правилам 1-3CREATE MACRO visible(w, r) AS w IS NOT NULL AND w < r AND w IN (SELECT txid FROM txns WHERE status = 'committed') AND w NOT IN (SELECT txid FROM in_progress_at_start WHERE reader = r);Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»У счетов 1–3 по две версии, у счёта 4 одна, от отменённой транзакции.
SELECT account_id, count(*) AS versionsFROM account_versions GROUP BY account_id ORDER BY account_id;┌────────────┬──────────┐│ account_id │ versions ││ int32 │ int64 │├────────────┼──────────┤│ 1 │ 2 ││ 2 │ 2 ││ 3 │ 2 ││ 4 │ 1 │└────────────┴──────────┘Задания
Заголовок раздела «Задания»1. Покажите балансы, которые видит транзакция 12. Строка видна, если её вставка видна, а удаление не видно.
Решение
SELECT account_id, balance FROM account_versionsWHERE visible(inserted_by, 12) AND NOT visible(deleted_by, 12)ORDER BY account_id;┌────────────┬─────────┐│ account_id │ balance ││ int32 │ int32 │├────────────┼─────────┤│ 1 │ 500 ││ 2 │ 500 ││ 3 │ 200 │└────────────┴─────────┘Транзакция 12 не видит перевод 13 (правило 2), пополнение 11 (правило 1) и строку отменённой 10 (правило 3). Сумма $1200 согласована: перевод не «потерял» деньги.
2. Повторите запрос для транзакции 14, которая стартовала, когда все остальные уже закончились.
Решение
SELECT account_id, balance FROM account_versionsWHERE visible(inserted_by, 14) AND NOT visible(deleted_by, 14)ORDER BY account_id;┌────────────┬─────────┐│ account_id │ balance ││ int32 │ int32 │├────────────┼─────────┤│ 1 │ 600 ││ 2 │ 400 ││ 3 │ 250 │└────────────┴─────────┘Две транзакции читают одну таблицу в одно время, но видят разные согласованные snapshot. Старые версии нужны, пока жива транзакция 12, потом их уберёт GC.
3. Сделайте обработку сообщений идемпотентной: брокер прислал msg-1 дважды, а баланс должен измениться один раз.
Решение
CREATE TABLE ledger (message_id VARCHAR PRIMARY KEY, account_id INTEGER, amount INTEGER);INSERT INTO ledger VALUES ('msg-1', 1, 100) ON CONFLICT DO NOTHING;INSERT INTO ledger VALUES ('msg-2', 1, -30) ON CONFLICT DO NOTHING;INSERT INTO ledger VALUES ('msg-1', 1, 100) ON CONFLICT DO NOTHING; -- повторная доставкаSELECT count(*) AS rows, sum(amount) AS balance FROM ledger WHERE account_id = 1;┌───────┬─────────┐│ rows │ balance ││ int64 │ int128 │├───────┼─────────┤│ 2 │ 70 │└───────┴─────────┘Уникальный ключ message_id отбросил повтор: это та же идея, что таблица обработанных ID для exactly-once.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему авторы считают, что «отменяемость» точнее описывает атомарность в ACID?
- Почему
read committedне спасает от гонки двух прибавлений к счётчику, хотя защищает отdirty write? - Когда
snapshot isolationнужна обязательно, аread committedнедостаточно? - Почему
SELECT FOR UPDATEзащищает отwrite skewв примере с врачами, но не в примере с переговорками? - Когда SSI работает лучше
2PL, а когда хуже? - Почему участник
2PCпосле ответа «да» не может сам отменить транзакцию и чем это опасно для блокировок?
Предыдущая: Sharding. Следующая: Проблемы распределённых систем.