

Designing Data-Intensive Applications, глава 10: Согласованность и консенсус
Главная мысль: самая понятная сильная гарантия для реплицированных данных — это linearizability: система выглядит как одна копия данных. На одном узле её дать легко, но такой узел не переживёт сбой. Отказоустойчивую версию дают алгоритмы консенсуса, и многие задачи (блокировки, уникальность, общий журнал, атомарный commit) сводятся именно к консенсусу.
О чём глава
Заголовок раздела «О чём глава»Глава 9 перечислила, что ломается в распределённых системах. Эта глава отвечает на вопрос, как всё же построить систему, которая работает правильно при таких сбоях. Главный инструмент отказоустойчивости — это репликация. Но копии данных на разных узлах расходятся: чтение может прийти на отстающую реплику, а записи на разных репликах могут конфликтовать.
Есть два подхода к этой проблеме:
| Подход | Идея | Плюс | Минус |
|---|---|---|---|
Eventual consistency | Приложение знает о репликации и само разбирает расхождения и конфликты | Работает при сбоях, офлайн-режим | Приложению сложно |
Сильная согласованность (strong consistency) | Система ведёт себя как один узел | Разработчику просто | Медленнее, часть сбоев приводит к простою |
Первый подход обычен для репликации с несколькими leader и без leader. Если приложение позволяет менять данные офлайн, eventual consistency неизбежна. Если же реплики стоят в дата-центрах с быстрой и надёжной сетью, цена сильной согласованности обычно приемлема. Эта глава разбирает сильную согласованность в трёх темах:
- точное определение сильной согласованности —
linearizability; - генераторы ID и метки времени, которые тесно связаны с согласованностью;
- алгоритмы консенсуса, которые дают
linearizabilityи при этом переживают сбои.
Авторы предупреждают: эти темы известны тем, что их трудно реализовать правильно. Легко построить систему, которая работает, пока сбоев нет, но разваливается при неудачном сочетании сбоев и порядка сообщений, о котором разработчики не подумали. Глава даёт только интуицию, без формальных моделей и доказательств. Для серьёзной работы над консенсусом нужна теория из списка литературы.
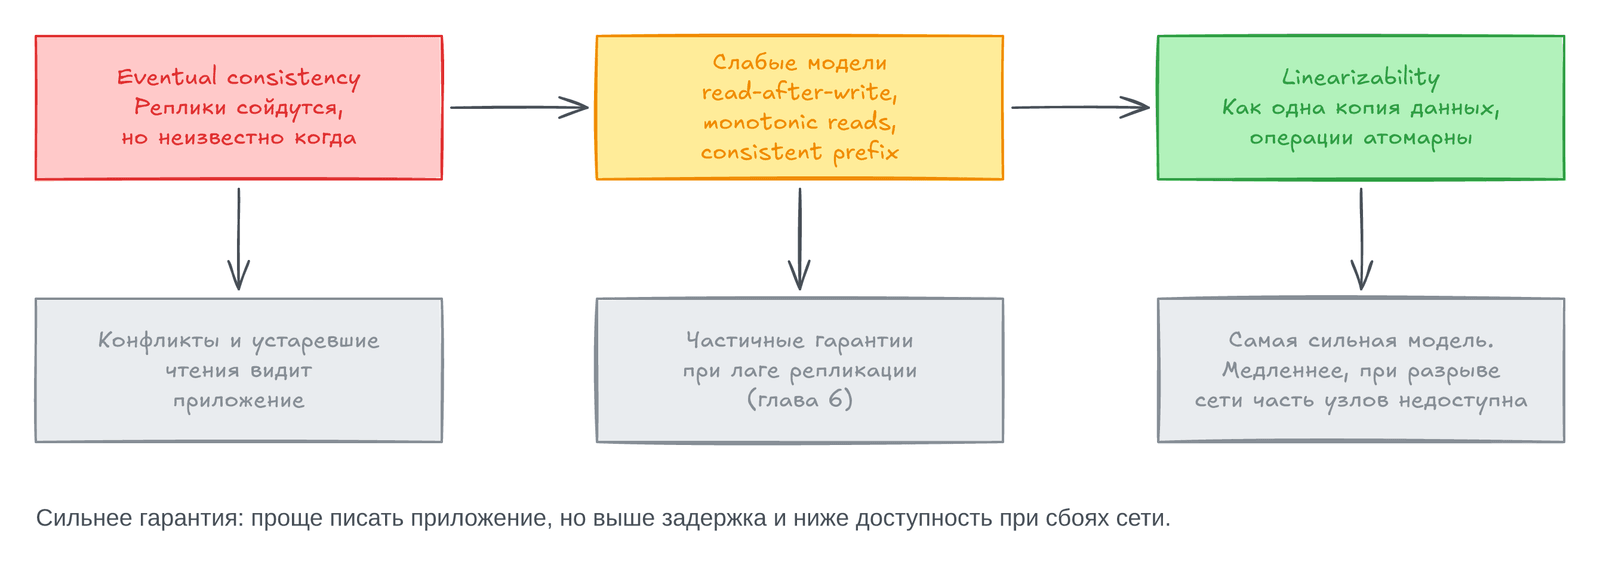
Схему читают слева направо: чем правее модель, тем сильнее гарантия. Нижний ряд показывает, что за неё приходится платить.
Linearizability
Заголовок раздела «Linearizability»Самая простая для пользователя реплицированная база ведёт себя как согласованная база на одном узле. Тогда не надо думать о лаге репликации и конфликтах, а отказоустойчивость остаётся. На этой идее построена linearizability. Её также называют атомарной, сильной, немедленной или внешней согласованностью.
Linearizability — это гарантия, что система выглядит так, будто у неё одна копия данных, и все операции над ней атомарны. Как только один клиент успешно записал значение, все клиенты при чтении должны видеть это значение. Чтение не может вернуть данные из устаревшего кэша или отстающей реплики. Иначе говоря, linearizability — это гарантия свежести (recency).
Авторы показывают нарушение на примере спортивного сайта. Алия и Брайс сидят в одной комнате и следят за матчем на телефонах. Алия обновляет страницу, видит финальный счёт и говорит об этом Брайсу. Брайс обновляет страницу у себя, но его запрос попадает на отстающую реплику, и сайт пишет, что игра ещё идёт. Если бы они нажали кнопку одновременно, разница в ответах не удивила бы. Но Брайс нажал после возгласа Алии, поэтому ждёт результат не старее, чем у неё. Устаревший ответ нарушает linearizability.
Что делает систему linearizable
Заголовок раздела «Что делает систему linearizable»Возьмём один объект x. В теории распределённых систем его называют регистром (register). На практике это один ключ в key-value хранилище, одна строка в таблице или один документ. Клиенты делают с ним операции:
read(x) ⇒ v— клиент прочиталxи получил значениеv;write(x, v) ⇒ r— клиент записал вxзначениеvи получил ответr(okилиerror).
Каждый запрос занимает отрезок времени: от отправки до получения ответа. Из-за задержек в сети клиент не знает, когда именно база выполнила запрос. Он знает только, что это случилось где-то внутри отрезка.
Пусть x сначала равен 0, клиент C пишет 1, а клиенты A и B всё время читают x. Что они могут получить?
- Чтение, которое закончилось до начала записи, обязано вернуть 0.
- Чтение, которое началось после конца записи, обязано вернуть 1.
- Чтение, которое пересекается с записью по времени, может вернуть 0 или 1. Такие операции одновременны (
concurrent) с записью.
Этого мало. Если одновременные чтения возвращают то старое, то новое значение, читатель увидит, как значение «мигает» туда и обратно. Одна копия данных так себя не ведёт. Поэтому нужно ещё одно правило: где-то внутри записи есть момент, когда значение атомарно меняется с 0 на 1. Если чтение одного клиента вернуло 1, все чтения, которые начались после него, тоже должны вернуть 1, даже если запись ещё не закончилась. Это та же ситуация, что с Алией и Брайсом.
Добавим третью операцию — cas(x, v_old, v_new) ⇒ r. CAS (compare-and-set) атомарно ставит x в v_new, только если текущее значение равно v_old. Иначе он ничего не меняет и возвращает ошибку. Для каждой операции можно отметить момент, когда она, по нашему мнению, выполнилась. Если соединить эти отметки по порядку, должна получиться правильная последовательность для регистра: каждое чтение возвращает значение последней записи. Требование linearizability: линия, которая соединяет отметки, всегда идёт вперёд по времени и никогда не идёт назад.
На сложном примере книги видны важные детали:
- Порядок выполнения может отличаться от порядка отправки. B отправил чтение раньше двух записей, но получил значение второй записи. Это допустимо: три запроса одновременны, и чтение могло задержаться в сети.
- Чтение может вернуть новое значение раньше, чем писатель получил
ok. Значит, ответ писателю просто задержался в сети. - Модель не даёт изоляции транзакций: другой клиент может поменять значение между двумя чтениями.
CASзащищает от этого:CASклиента D не прошёл, потому что к моменту выполнения значение уже не было равно ожидаемому. - Последнее чтение B нарушает
linearizability. Оно одновременно сCASклиента C, который меняет 2 на 4, и само по себе могло бы вернуть 2. Но A уже прочитал 4 до начала чтения B, поэтому B не может увидеть более старое значение.
Проверить, что система linearizable, можно, хотя это дорого по вычислениям: записать времена всех запросов и ответов и проверить, выстраиваются ли они в правильный последовательный порядок.
Как у транзакций есть уровни изоляции слабее serializability, так у реплицированных систем есть модели слабее linearizability. Гарантии read-after-write, monotonic reads и consistent prefix из главы 6 — примеры таких моделей. Linearizability включает их все и даёт больше. Это самая сильная из широко используемых моделей согласованности.
Linearizability и serializability
Заголовок раздела «Linearizability и serializability»Эти два слова легко спутать: оба звучат как «можно выстроить в последовательный порядок». Но гарантии разные:
Serializability | Linearizability | |
|---|---|---|
| Что это | Уровень изоляции транзакций | Гарантия для чтений и записей одного регистра |
| Объекты | Транзакция читает и пишет много объектов | Один объект, операции не группируются |
| Порядок | Результат как при каком-то последовательном порядке, он может отличаться от реального | Если операция закончилась до начала другой, вторая видит состояние не старее первой |
| Свежесть | Устаревшие чтения допустимы | Гарантия свежести |
Write skew | Предотвращает | Не предотвращает |
Sequential consistency — это ещё одна, третья модель, но книга её не разбирает. База может давать и serializability, и linearizability. Такое сочетание называют strict serializability или strong one-copy serializability (strong-1SR). Базы на одном узле обычно linearizable. С распределёнными базами на оптимистичных методах вроде SSI всё сложнее. Например, CockroachDB даёт serializability и часть гарантий свежести, но не strict serializability: для неё нужна дорогая координация между транзакциями. Spanner и FoundationDB дают strict serializability. Модель согласованности и уровень изоляции можно выбирать почти независимо друг от друга.
Где нужна linearizability
Заголовок раздела «Где нужна linearizability»Для спортивного счёта задержка в несколько секунд не вредит. Но есть области, где без linearizability система работает неправильно.
Блокировки и выбор leader
Заголовок раздела «Блокировки и выбор leader»При репликации с одним leader надо гарантировать, что leader действительно один, а не несколько (split brain). Один способ выбрать его — lease: каждый узел при старте пытается получить lease, и кто получил, тот и leader. Как бы это ни было устроено, операция должна быть linearizable: два узла не могут получить lease одновременно.
Распределённые lease и выбор leader часто строят на сервисах координации: Apache ZooKeeper и etcd. Они реализуют linearizable операции отказоустойчиво с помощью консенсуса. Детали тонкие (например, fencing из главы 9), поэтому библиотеки вроде Apache Curator дают готовые рецепты поверх ZooKeeper. Строго говоря, ZooKeeper даёт linearizable записи, но чтения могут быть устаревшими: их может обслужить не текущий leader. Etcd с версии 3 по умолчанию даёт linearizable чтения.
Некоторые распределённые базы используют блокировки гораздо мельче. Oracle Real Application Clusters (RAC) держит блокировку на каждую страницу диска, а узлы делят общее хранилище. Эти блокировки лежат на критическом пути транзакций. Поэтому для RAC обычно ставят отдельную сеть между узлами базы.
Ограничения и уникальность
Заголовок раздела «Ограничения и уникальность»Ограничения уникальности встречаются часто: имя пользователя или email однозначно определяют пользователя, а в файловом хранилище не бывает двух файлов с одним путём. Если ограничение надо проверять при записи (двое одновременно создают одно имя, и один из них получает ошибку), нужна linearizability. Регистрацию можно представить как захват блокировки на имя. Она похожа и на атомарный CAS: записать в имя ID пользователя, если имя ещё свободно.
Та же проблема возникает, когда баланс счёта не должен уйти в минус, нельзя продать больше товара, чем лежит на складе, или двое не должны занять одно место в самолёте. Всем этим ограничениям нужно одно свежее значение (баланс, остаток, занятость места), с которым согласны все узлы.
Иногда ограничение можно трактовать мягко. Если рейс перебронирован, пассажира пересаживают на другой рейс и дают компенсацию. Тогда linearizability не нужна, и такие ограничения разбирает глава 13. Но жёсткое ограничение уникальности, как в реляционных базах, требует linearizability. Внешние ключи и ограничения на атрибуты можно реализовать и без неё.
Зависимости между каналами связи
Заголовок раздела «Зависимости между каналами связи»В примере с Алией и Брайсом есть важная деталь. Если бы Алия промолчала, Брайс не узнал бы, что его ответ устарел: он обновил бы страницу через несколько секунд и увидел счёт. Нарушение заметно только из-за второго канала связи — голоса Алии.
В компьютерных системах бывает то же самое. Пусть пользователь загружает видео, а фоновый процесс перекодирует его в низкое качество для медленного интернета. Веб-сервер не кладёт видео в очередь: брокеры рассчитаны на маленькие сообщения, а видео весит мегабайты. Поэтому сервер сначала пишет файл в хранилище, а после записи кладёт в очередь задачу для транскодера.
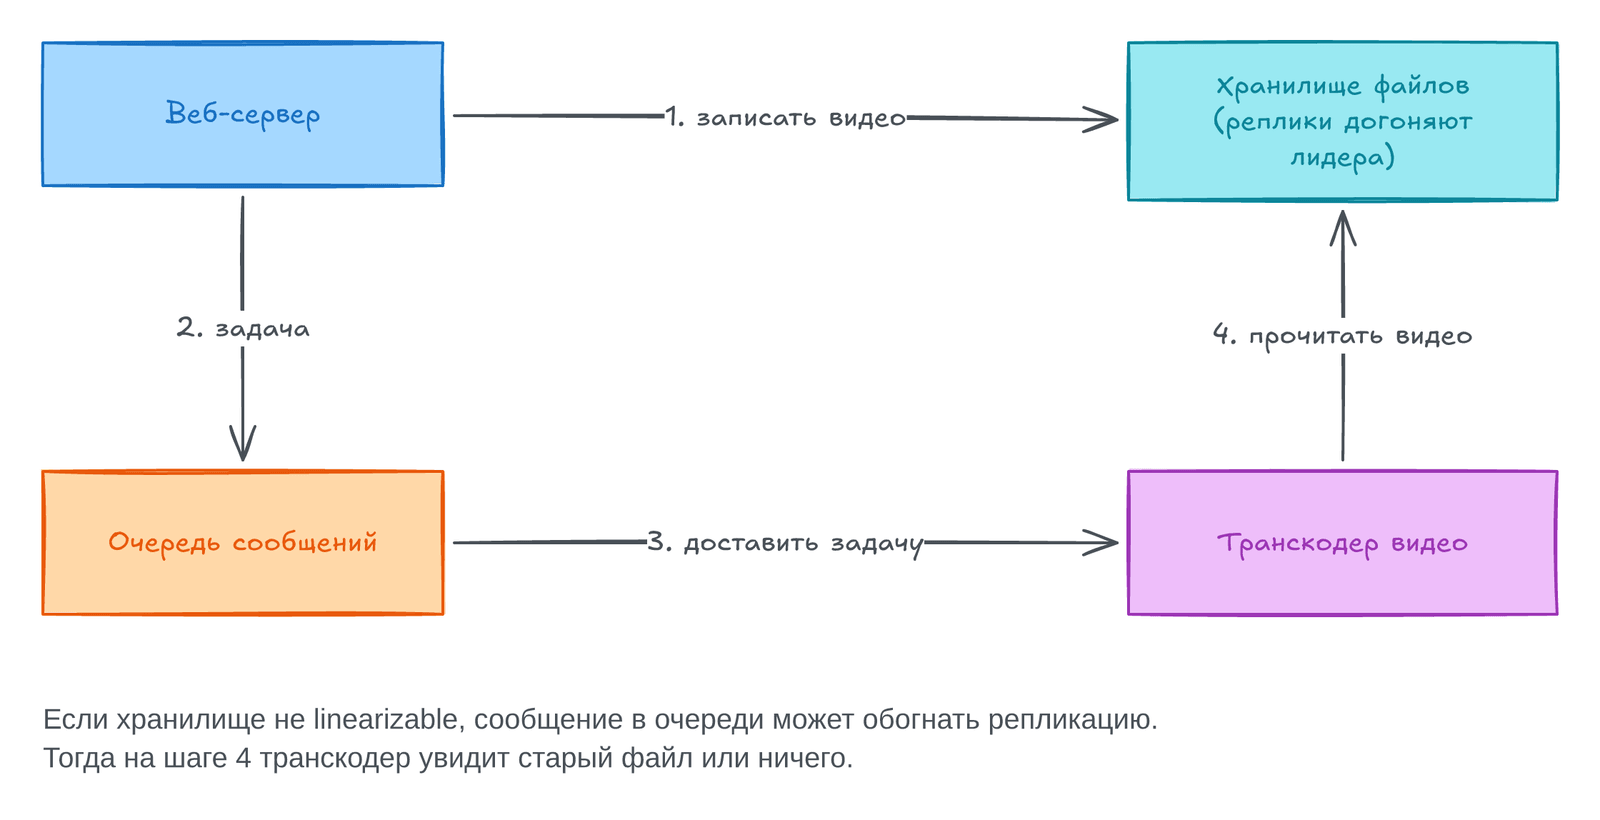
Схема показывает два канала между веб-сервером и транскодером: хранилище и очередь. Если хранилище linearizable, всё работает. Если нет, возникает гонка (race condition): очередь может доставить задачу быстрее, чем хранилище реплицирует файл. Тогда транскодер прочитает старую версию файла или не найдёт его. Если он перекодирует старую версию, оригинал и перекодированное видео навсегда разойдутся.
Похожая гонка бывает с push-уведомлениями. Уведомление приходит быстро, приложение идёт за данными, запрос попадает на отстающую реплику и не видит того, о чём было уведомление. Linearizability — не единственный способ избежать такой гонки, но самый понятный. Если второй канал под вашим контролем (как очередь, но не как голос Алии), можно применить приёмы вроде read-your-writes из главы 6, но это сложнее.
Как реализовать linearizable систему
Заголовок раздела «Как реализовать linearizable систему»Самый простой ответ — правда держать одну копию данных. Но она не переживёт сбой: если узел упал, данные потеряны или недоступны до его возвращения. Поэтому авторы проверяют методы репликации из главы 6:
| Метод репликации | Linearizable? | Почему |
|---|---|---|
С одним leader | Возможно | Да, если все чтения и записи идут на leader. Но узел может ошибочно считать себя leader и нарушить гарантию. При асинхронной репликации failover может потерять подтверждённые записи |
| Алгоритмы консенсуса | Скорее да | Это репликация с одним leader плюс автоматический выбор leader без split brain. ZooKeeper использует Zab, etcd — Raft. Но чтение с узла без проверки, что он ещё leader, может быть устаревшим |
С несколькими leader | Нет | Записи идут на несколько узлов одновременно и реплицируются асинхронно, поэтому возникают конфликты |
Без leader (Dynamo) | Скорее нет | LWW на физических часах (Cassandra, ScyllaDB) почти наверняка не linearizable из-за расхождения часов. Даже кворум не спасает |
Sharding базы с одним leader на каждый shard не мешает linearizability: это гарантия для одного объекта. Транзакции между shard — другая тема (глава 8).
Linearizability и кворумы
Заголовок раздела «Linearizability и кворумы»Кажется, что чтение и запись по кворуму (w + r > n) в стиле Dynamo должны быть linearizable. Но при переменных задержках сети возможна гонка. Пусть x = 0, и писатель шлёт x = 1 на все три реплики (n = 3, w = 3). Клиент A читает две реплики (r = 2) и видит 1 на одной и 0 на другой. Клиент B позже читает другие две реплики и получает 0 с обеих. Условие кворума выполнено, но B начал чтение после того, как A его закончил, и получил более старое значение. Это снова случай Алии и Брайса.
Кворумы Dynamo можно сделать linearizable, но ценой скорости. Читатель должен синхронно выполнить read repair до ответа приложению. Писатель перед записью должен прочитать свежее состояние кворума, узнать последнюю метку времени и взять метку больше неё. Riak не делает синхронный read repair из-за потерь в скорости. Cassandra ждёт read repair при чтении по кворуму, но теряет linearizability из-за физических часов. К тому же так можно сделать только linearizable чтение и запись, но не CAS: для него нужен консенсус. Вывод авторов: безопаснее считать, что система без leader в стиле Dynamo не linearizable даже с кворумами.
Цена linearizability
Заголовок раздела «Цена linearizability»Возьмём базу, реплицированную между двумя регионами. Пусть связь между регионами пропала, а внутри регионов сеть работает, и клиенты видят свой регион. Такая ситуация называется разрывом сети (network partition).
- При репликации с несколькими
leaderкаждый регион продолжает работать. Записи копятся в очереди и уходят в другой регион, когда связь вернётся. - При репликации с одним
leaderон живёт в одном из регионов. Все записи и linearizable чтения должны идти к нему. Клиенты региона сfollowerпри разрыве не могут ни писать, ни читать linearizable. Читать сfollowerможно, но данные могут быть устаревшими. Если приложению нужнаlinearizability, для этих клиентов оно недоступно, пока связь не починят.
Теорема CAP
Заголовок раздела «Теорема CAP»Эта проблема не связана с конкретным способом репликации: она есть у любой linearizable базы. Разрыв бывает не только между регионами, но и в любой ненадёжной сети. Выбор такой:
- CP (согласованная при разрыве сети). Приложению нужна
linearizability. Тогда отрезанные реплики не могут обслуживать запросы: они ждут, пока сеть починят, или возвращают ошибку. В обоих случаях они недоступны. - AP (доступная при разрыве сети). Приложению не нужна
linearizability. Тогда каждая реплика может работать сама, например при несколькихleader. Приложение остаётся доступным, но не linearizable.
Эту мысль называют теоремой CAP. Название дал Эрик Брюэр в 2000 году, хотя разработчики распределённых баз знали этот компромисс с 1970-х. Сначала CAP была правилом без точных определений и должна была начать разговор о компромиссах. Тогда многие распределённые базы давали linearizability на кластере с общим хранилищем. CAP подтолкнула инженеров к системам shared-nothing, которые лучше подходят для больших веб-сервисов. Этот сдвиг дал толчок движению NoSQL: волне новых баз данных в середине 2000-х.
Формальная теорема CAP очень узкая. Она рассматривает одну модель согласованности (linearizability) и один вид сбоя — разрыв сети. По данным Google, разрывы сети дают меньше 8% инцидентов. О задержках сети, мёртвых узлах и других компромиссах теорема ничего не говорит. Поэтому авторы считают, что практической пользы для проектирования у неё мало.
Её пытались обобщить. Принцип PACELC добавляет: при разрыве сети (P) выбираем между доступностью (A) и согласованностью (C), а иначе (E) — между низкой задержкой (L) и согласованностью (C). Но он унаследовал от CAP странные определения согласованности и доступности. Сегодня CAP вытеснили более точные результаты о невозможности, и её интерес в основном исторический.
Бесполезная формулировка CAP
Заголовок раздела «Бесполезная формулировка CAP»CAP часто подают так: согласованность, доступность, работа при разрыве сети — выберите два из трёх. Авторы считают это заблуждением. Разрыв сети — это сбой, его не выбирают: он случится, хотите вы того или нет. Избежать разрывов можно, только если сети нет совсем, то есть реплика одна, но тогда нет и высокой доступности.
Пока сеть работает, система может дать и linearizability, и доступность. Выбирать приходится только при сбое сети. Поэтому точнее формулировка «согласованная или доступная при разрыве сети». Надёжная сеть требует этого выбора реже, но рано или поздно выбор неизбежен.
У деления на CP и AP есть и другие недостатки. Согласованность в теореме — это только linearizability, о слабых моделях она молчит. Формальная доступность в CAP не совпадает с обычным смыслом слова, и многие высокодоступные системы ей не соответствуют. Некоторые системы сознательно не дают ни linearizability, ни такую доступность, то есть они ни CP, ни AP. Вывод авторов: вокруг CAP много путаницы, она не помогает понять системы, поэтому долго на ней задерживаться не стоит.
Linearizability и задержки сети
Заголовок раздела «Linearizability и задержки сети»Linearizability полезна, но на практике её дают немногие системы. Даже оперативная память многоядерного процессора не linearizable. Если поток на одном ядре пишет по адресу, а поток на другом ядре вскоре читает этот адрес, он не обязательно увидит новое значение без барьера памяти (memory barrier). Причина в том, что у каждого ядра свой кэш и буфер записи. Чтение идёт из кэша, а изменения асинхронно уходят в основную память. Кэш намного быстрее памяти, но теперь у данных несколько копий, они обновляются асинхронно, и linearizability пропадает.
CAP здесь ни при чём: внутри одного компьютера связь считают надёжной, и никто не ждёт, что ядро продолжит работать, если его отрезать от остальной машины. От linearizability отказываются ради скорости, а не ради отказоустойчивости. Многие распределённые базы делают то же самое. Linearizable системы медленнее всегда, а не только во время сбоя сети.
Можно ли сделать linearizable хранилище быстрее? Похоже, нет. Аттия и Уэлч доказали: при linearizability время ответа на чтение и запись не меньше, чем неопределённость задержек в сети. В обычных сетях задержки сильно колеблются, поэтому linearizable операции неизбежно медленные. Более быстрого алгоритма нет, а слабые модели могут быть намного быстрее. Для систем, чувствительных к задержке, этот компромисс важен. Глава 13 показывает, как обойтись без linearizability и не потерять корректность.
Генераторы ID и логические часы
Заголовок раздела «Генераторы ID и логические часы»Многим приложениям нужен уникальный ID для каждой новой записи: он станет первичным ключом. В базе на одном узле обычно берут автоинкрементное целое. Оно занимает 64 бита (или 32, если записей точно меньше 4 млрд, но это рискованно). Ещё один плюс: порядок ID совпадает с порядком создания записей. В чате вопрос Алии получает ID 1, а ответ Брайса — больший ID, 3. Поэтому сообщения в порядке роста ID читаются осмысленно.
Генератор ID на одном узле тоже linearizable. Каждый запрос атомарно увеличивает счётчик и возвращает старое значение. Такая операция называется fetch-and-add. Linearizability гарантирует: если сообщение Алии отправлено до того, как Брайс начал писать, ID у Брайса больше. Третий участник чата, Калеб, пишет одновременно с Алией, поэтому ID их сообщений могут идти в любом порядке, лишь бы были уникальны.
В памяти такой генератор сделать просто: процессор умеет атомарно увеличивать счётчик. Чуть сложнее сохранять счётчик на диск, чтобы после перезапуска не выдать дубли. Но главные проблемы другие:
- один узел — единая точка отказа;
- запись в другом регионе ждёт ответа с другой стороны планеты ради одного ID;
- при высоком
throughputзаписей узел становится узким местом.
Поэтому есть распределённые варианты:
| Схема | Как работает | Проблема порядка |
|---|---|---|
ID по shard | Несколько узлов выдают ID: один — чётные, другой — нечётные. В общем случае часть битов ID хранит номер shard | По ID 16 и 17 нельзя понять, что было раньше: их выдали разные узлы, один мог опережать другой |
| Блоки ID | Узел A берёт блок 1–1 000, узел B — блок 1 001–2 000, и каждый выдаёт ID из своего блока сам | Позднее сообщение может получить ID меньше, если его выдал другой узел |
| Случайный UUID (версия 4) | Случайное 128-битное число, генерируется локально без связи | Порядок случайный, по ID не понять, что новее. Занимает больше места |
| Метка времени плюс уникальность | Старшие биты — время по NTP, младшие — номер shard и счётчик или случайное число. Так работают UUID v7, Snowflake от X, ULID, Flake ID в Hazelcast, ObjectID в MongoDB | Порядок только приблизительный |
Все эти схемы дают уникальные ID (по крайней мере, коллизии крайне редки), но порядок у них намного слабее, чем у одного счётчика. Физические часы на разных узлах расходятся. Если раннее событие получило метку от спешащих часов, а позднее — от отстающих, порядок меток не совпадёт с реальным. А если часы прыгают назад, ошибётся даже один узел. Поэтому генераторы на физическом времени вряд ли linearizable. Расхождение можно уменьшить атомными часами или GPS. Но хорошо бы получать уникальные и правильно упорядоченные ID без специального железа.
Логические часы
Заголовок раздела «Логические часы»Часы из главы 9 — это физические часы: устройства, которые измеряют время в секундах и долях секунд. Логические часы (logical clock) — это алгоритм, который считает произошедшие события. Его метка не говорит, который час, но по двум меткам видно, какая раньше. Требования к логическим часам:
- метки компактны (несколько байт) и уникальны;
- любые две метки можно сравнить, то есть порядок полный;
- порядок меток согласован с причинностью: если операция A произошла до B (
happens-before), метка A меньше метки B.
Генератор на одном узле отвечает этим требованиям. Распределённые генераторы из таблицы выше не дают причинного порядка.
Метки Лэмпорта
Заголовок раздела «Метки Лэмпорта»Простой способ получить логические метки, согласованные с причинностью, — часы Лэмпорта (Lamport clock). Лесли Лэмпорт предложил их в 1978 году. Его статья теперь одна из самых цитируемых в области распределённых систем. Важно: часы Лэмпорта дают полный порядок, но не linearizability. Они не гарантируют свежесть значения, а только выдают ID так, что если A случилось до B, то ID A меньше ID B.
У каждого узла есть уникальный ID (на практике, например, случайный UUID) и счётчик операций. Метка Лэмпорта — это пара (счётчик, ID узла). Правила простые:
- создавая метку, узел увеличивает свой счётчик и берёт новое значение;
- увидев чужую метку со счётчиком больше своего, узел поднимает свой счётчик до этого значения.
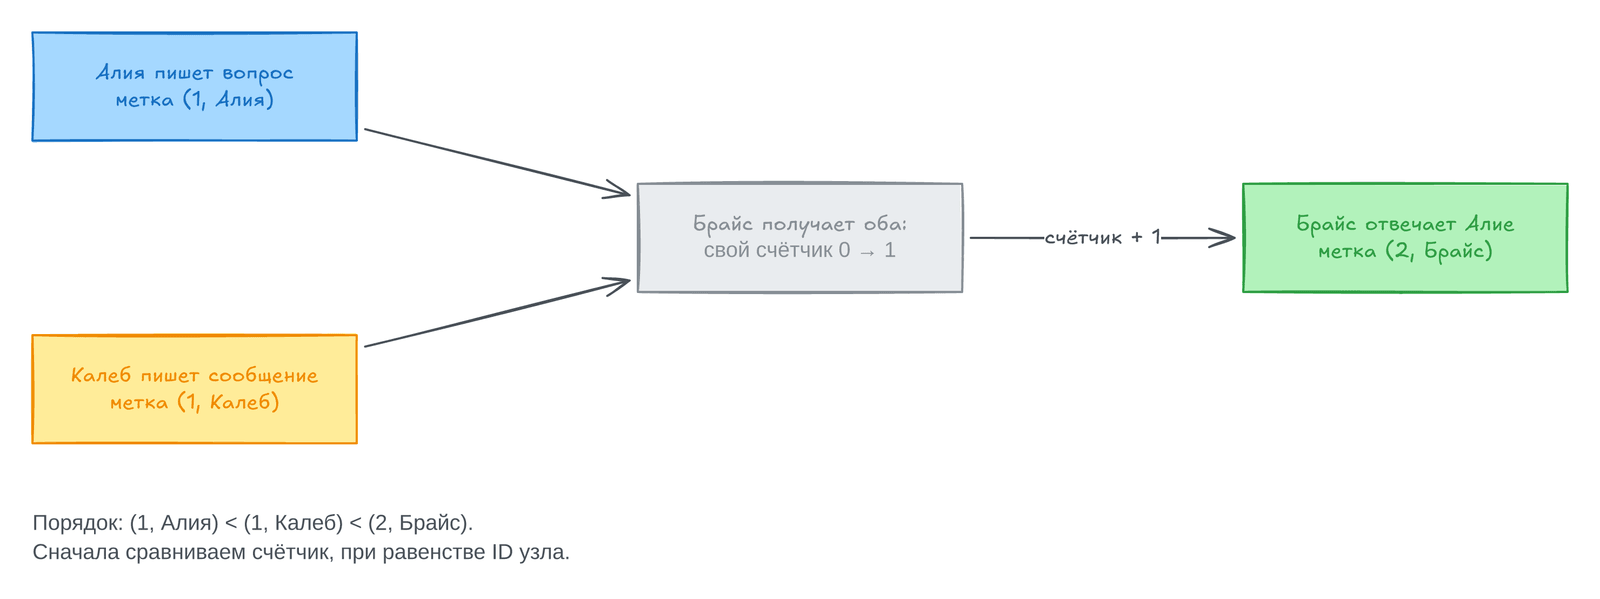
На схеме Алия и Калеб пишут одновременно и не видят сообщений друг друга. Оба начинают с 0, поэтому оба ставят метку 1. Брайс получает оба сообщения и поднимает свой счётчик до 1. Потом он отвечает Алии, увеличивает счётчик и ставит метку 2. Сравнивают метки так: сначала счётчик, а при равенстве — ID узла как строку. Итог: (1, Алия) < (1, Калеб) < (2, Брайс).
Гибридные логические часы
Заголовок раздела «Гибридные логические часы»У меток Лэмпорта два ограничения:
- они не связаны с физическим временем, поэтому по ним не найти, например, все сообщения за определённую дату: время придётся хранить отдельно;
- если два узла не общаются, счётчик одного не влияет на счётчик другого, и события одного момента получают на разных узлах очень разные значения.
Гибридные логические часы (HLC) соединяют плюсы физических часов и порядок часов Лэмпорта. Как физические часы, они считают секунды или микросекунды. Как часы Лэмпорта, они двигают своё значение вперёд, если увидели чужую метку больше своей. Поэтому если у одного узла часы спешат, остальные подтянутся к нему при общении. Кроме того, при выдаче каждой метки значение часов увеличивается на шаг. Так часы идут вперёд монотонно, даже если физические часы прыгнули назад из-за NTP. Из-за этого HLC может немного опережать физическое время, но алгоритм держит это расхождение минимальным.
В итоге метку HLC можно использовать почти как обычное время, но её порядок согласован с happens-before. Специальное железо не нужно, хватает примерно синхронных часов. HLC использует, например, CockroachDB.
Часы Лэмпорта и HLC против векторных часов
Заголовок раздела «Часы Лэмпорта и HLC против векторных часов»Snapshot isolation обычно реализуют через ID транзакций: транзакция видит записи транзакций с меньшим ID и не видит записи с большим. Часы Лэмпорта и HLC хорошо подходят для таких ID, потому что снимок получается согласованным с причинностью.
Но одновременные события эти алгоритмы упорядочивают произвольно. По двум меткам обычно нельзя понять, были ли события одновременны или одно случилось раньше. В примере чата видно, что сообщения Алии и Калеба одновременны: у них одинаковый счётчик. Но при разных счётчиках этого уже не понять.
Если надо определять одновременные записи, нужны векторные часы (vector clock). Они хранят счётчик для каждого узла и все эти счётчики с каждой записью. Если у записи A один счётчик больше, чем у B, а у B другой счётчик больше, чем у A, то записи одновременны (подробно в главе 6). Минус — размер: метка может занимать по одному числу на каждый узел системы.
Linearizable генераторы ID
Заголовок раздела «Linearizable генераторы ID»Часы Лэмпорта и HLC дают полезный порядок, но он слабее, чем у linearizable генератора на одном узле. Linearizability требует: если запрос A закончился до начала запроса B, у B ID больше, даже если A и B никак не общались. Часы Лэмпорта гарантируют только, что новая метка больше всех меток, которые узел видел. Про метки, которых он не видел, они ничего не обещают.
Авторы показывают, к чему это ведёт. Пользователь A хочет показать неловкое фото только друзьям. Его аккаунт публичный. На ноутбуке он делает аккаунт закрытым, а потом с телефона загружает фото. Он ждёт, что фото уже попадёт под новые права. Но настройки аккаунта и фото хранятся в разных базах (или в разных shard), и каждая ставит метки по часам Лэмпорта или HLC. База фото не читала базу аккаунтов, её счётчик мог отставать, и загрузка фото получила метку меньше, чем смена настроек. Теперь посторонний смотрит профиль A, и его чтение через MVCC получает метку между этими двумя. Система решит, что аккаунт в этот момент ещё публичный, и покажет фото.
Варианты исправления есть. База фото могла бы перед записью прочитать статус аккаунта, но такую проверку легко забыть. Если бы A работал с одного устройства, приложение могло бы помнить метку его последней записи, но с ноутбуком и телефоном это сложно. Проще всего взять linearizable генератор ID: он гарантирует, что загрузка фото получит ID больше, чем смена настроек.
Как сделать linearizable генератор ID
Заголовок раздела «Как сделать linearizable генератор ID»Самый простой способ — правда использовать один узел. Ему нужно три вещи: атомарно увеличивать счётчик и выдавать значение, сохранять счётчик на диск (чтобы после перезапуска не было дублей) и реплицировать его для отказоустойчивости с одним leader. Так делают на практике: в TiDB/TiKV это называют timestamp oracle, по образцу Percolator от Google.
Писать на диск и реплицировать на каждый запрос не обязательно. Генератор может сохранить запись о целом блоке ID, а после её сохранения и репликации выдавать ID из блока по порядку. До конца блока он заранее сохраняет следующий. При падении и failover часть ID пропадёт, но дублей и нарушений порядка не будет.
Разделить такой генератор на shard трудно: независимые shard уже не дадут linearizable порядок. Распределить его по регионам тоже трудно, поэтому в географически распределённой базе все запросы ID идут в один регион. Зато работа у генератора простая, и один узел выдерживает большой throughput.
Другой путь — как в Spanner (глава 9). Его часы возвращают не одну метку, а интервал с неопределённостью, и Spanner ждёт, пока этот интервал пройдёт, и только потом отвечает. Если интервал верный (настоящее время всегда внутри него), то запрос, начатый после конца другого, получит большую метку. Так ID linearizable без всякой связи между узлами, даже в разных регионах. Минус в том, что нужна аппаратная и программная поддержка точной синхронизации часов и расчёта интервала.
Ограничения на логических часах
Заголовок раздела «Ограничения на логических часах»Можно ли на логических часах или linearizable генераторе ID построить блокировки и уникальность, как на CAS? Не совсем. Каждый узел, который хочет получить блокировку или занять имя, берёт метку, и побеждает узел с наименьшей меткой. Если часы linearizable, будущие запросы получат метки больше, и победителя никто не обгонит.
Но остаётся вопрос: как узлу узнать, что его метка наименьшая? Для этого надо услышать каждый узел, который мог выдать метку. Если один из них упал или недоступен из-за сети, система встанет: нельзя быть уверенным, что его метка не меньше. Такая система не отказоустойчива. Для отказоустойчивых блокировок, lease и похожих вещей нужно что-то сильнее часов и генераторов ID, а именно консенсус.
Консенсус
Заголовок раздела «Консенсус»Глава уже показала несколько вещей, которые легко сделать на одном узле и трудно сделать отказоустойчиво:
- База linearizable, если все чтения и записи идут на один
leader. Но как сделатьfailoverбезsplit brain? Как узнать, что узел, который считает себяleader, не был смещён, пока стоял на паузе? - Linearizable генератор ID на одном узле — это счётчик с атомарным
fetch-and-add. Что делать, если узел упал? - Атомарный
CASрешает, кто получит блокировку илиlease, и гарантирует уникальность имени файла или пользователя. На одном узле это одна инструкция процессора, но как сделать её отказоустойчивой?
Всё это частные случаи одной задачи — консенсуса (consensus). В классической постановке консенсус — это договорённость нескольких узлов об одном значении. Задача одна из самых важных в распределённых вычислениях и печально известна тем, что её трудно решить правильно: многие системы в прошлом ошибались.
Самые известные алгоритмы — Viewstamped Replication (VSR), Paxos, Raft и Zab. Они похожи, но не одинаковы. Все работают в модели без византийских сбоев: сообщения могут задерживаться и теряться, узлы падают и перезапускаются, но сами узлы честно следуют протоколу. Есть алгоритмы, которые терпят и византийские узлы (обычно меньше трети). Их используют, например, в блокчейнах, но книга их не разбирает.
Невозможность консенсуса
Заголовок раздела «Невозможность консенсуса»Результат FLP (по фамилиям Фишер, Линч и Патерсон) доказывает: ни один алгоритм не может всегда достигать консенсуса, если узел может упасть. Узлы падают всегда, значит, надёжный консенсус невозможен. Но книга дальше обсуждает алгоритмы консенсуса. Противоречия нет по двум причинам:
- FLP говорит не о том, что консенсус недостижим, а о том, что нельзя гарантировать, что алгоритм всегда завершится;
- FLP доказан для детерминированного алгоритма в асинхронной модели, где нет часов и таймаутов. Если алгоритм может по таймауту заподозрить, что узел упал (пусть и ошибочно), консенсус решаем. Хватает даже случайных чисел.
Поэтому FLP важен для теории, но на практике распределённые системы обычно достигают консенсуса.
Многоликий консенсус
Заголовок раздела «Многоликий консенсус»Консенсус можно сформулировать по-разному:
- консенсус об одном значении очень похож на атомарный
CASи годится для блокировок,leaseи уникальности; - журнал, в который можно только дописывать, тоже требует консенсуса. Формально такую задачу называют
total order broadcast. На журнале строятstate machine replication, репликацию сleader,event sourcingи другие шаблоны; - атомарный
fetch-and-addтоже оказывается эквивалентен консенсусу (с оговоркой ниже); - атомарная фиксация транзакции на нескольких базах или
shardтребует, чтобы все участники согласились наcommitилиabort.
Все эти задачи эквивалентны. Алгоритм, который решает одну, можно превратить в решение любой другой. Авторы называют этот вывод глубоким и неожиданным. Именно поэтому столь разные на вид вещи объединяют под словом «консенсус».
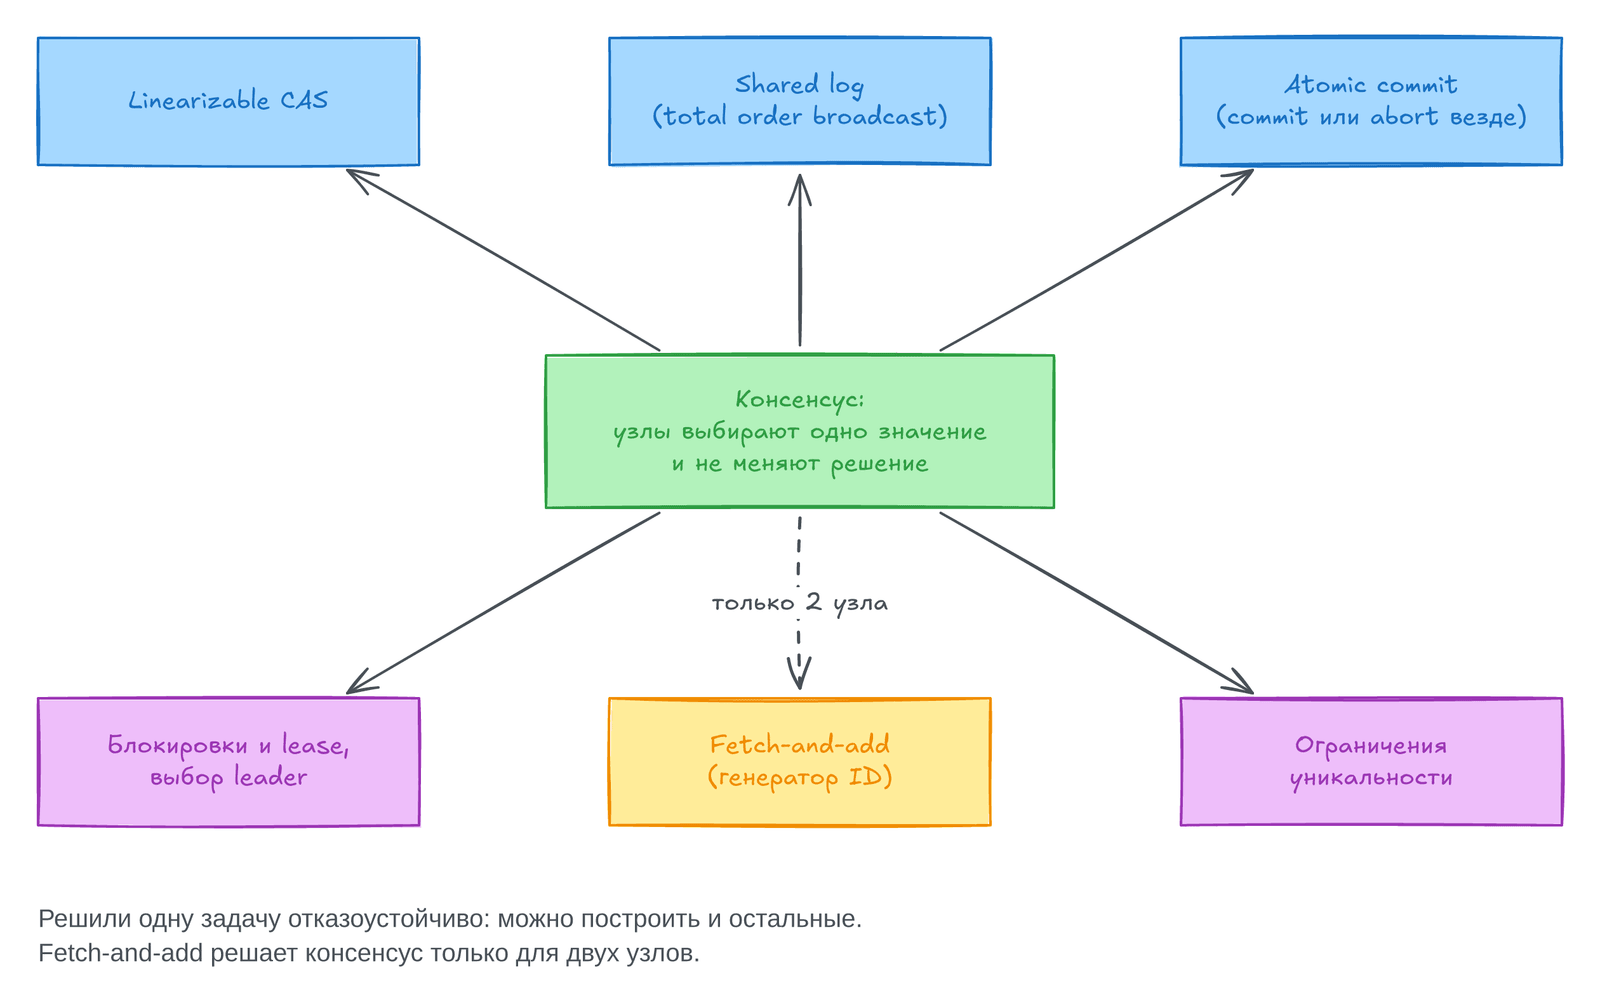
Стрелки на схеме значат «можно построить из консенсуса». Пунктир к fetch-and-add показывает, что он решает консенсус только для двух узлов.
Консенсус об одном значении
Заголовок раздела «Консенсус об одном значении»Договориться об одном значении полезно во многих случаях:
- когда база с одним
leaderстартует илиleaderупал, несколько узлов могут одновременно претендовать на рольleader; так же узлы соревнуются за блокировку илиlease, и консенсус решает, кто победил; - когда несколько человек одновременно бронируют последнее место в самолёте или регистрируют одно имя, консенсус решает, кто успел, если это неясно.
В общем виде узлы предлагают значения, а алгоритм выбирает одно из них. Например, каждый узел предлагает свой ID, и алгоритм решает, кто станет leader, владельцем lease или покупателем места. Алгоритм должен выполнять четыре свойства:
| Свойство | Смысл |
|---|---|
Единогласие (uniform agreement) | Никакие два узла не решают по-разному |
Целостность (integrity) | Узел, который решил, не меняет решение |
Обоснованность (validity) | Если узел решил v, то v кто-то предложил |
Завершение (termination) | Каждый узел, который не упал, в итоге принимает решение |
Чтобы решить много значений, запускают отдельный экземпляр консенсуса на каждое, например по одному на каждое место в театре. Единогласие и целостность задают суть: все решают одинаково и не передумывают. Обоснованность отсекает тривиальные решения: алгоритм, который всегда выбирает null, выполнит первые два свойства, но не это.
Первые три свойства легко выполнить без отказоустойчивости: назначьте один узел «диктатором» и пусть он решает всё. Но если он упадёт, система больше ничего не решит, как репликация с одним leader без failover. Вся трудность — в отказоустойчивости, и её формализует свойство завершения. Алгоритм не может вечно ждать: даже если часть узлов упала, остальные должны прийти к решению. Завершение — это свойство liveness, а остальные три — свойства safety (глава 9).
Упавший узел может вернуться, но алгоритм обязан решать и тогда, когда узел исчез навсегда. Авторы предлагают представить, что дата-центр с узлом засыпало оползнем после землетрясения и узел лежит под девятью метрами грязи. Конечно, если упали все узлы, решать некому. Доказано, что любому алгоритму консенсуса для завершения нужно, чтобы работало большинство узлов. Это большинство и образует кворум. Зато большинство алгоритмов сохраняет свойства safety даже при падении большинства узлов или тяжёлом сбое сети. Большая авария может остановить обработку запросов, но не заставит систему принять противоречивые решения.
CAS как консенсус
Заголовок раздела «CAS как консенсус»CAS проверяет, равно ли текущее значение ожидаемому, и если да, атомарно ставит новое, а если нет — ничего не меняет и возвращает ошибку. Имея отказоустойчивый linearizable CAS, консенсус решить легко. Объект сначала равен null. Каждый узел делает CAS с ожидаемым null и своим значением. Решением становится то значение, которое оказалось в объекте.
И наоборот, имея консенсус, можно сделать CAS. Когда несколько узлов хотят выполнить CAS с одним ожидаемым значением, их новые значения предлагают в консенсус. Объект получает выбранное значение, а остальные CAS возвращают ошибку. CAS с разными ожидаемыми значениями используют разные запуски консенсуса. Значит, CAS и консенсус эквивалентны. Пример CAS в распределённой системе — условная запись в объектное хранилище из главы 6: она проходит, только если объект с этим именем никто не создал и не изменил после последнего чтения.
Общий журнал как консенсус
Заголовок раздела «Общий журнал как консенсус»Журналы уже встречались: журнал репликации, журнал транзакций, write-ahead log. Журнал хранит последовательность записей, и все читатели видят одни записи в одном порядке. Общий журнал (shared log) — это журнал, в который могут просить дописать записи многие узлы. Пример — репликация с одним leader: любой клиент просит leader записать, и тот дописывает запись в журнал, и все follower применяют записи в том же порядке.
Общий журнал умеет две операции: попросить добавить значение и прочитать записи. Его свойства:
| Свойство | Смысл |
|---|---|
Добавление в итоге (eventual append) | Узел, который попросил добавить значение и не упал, в итоге прочитает его в журнале |
Надёжная доставка (reliable delivery) | Записи не теряются: если один узел прочитал запись, её прочитают все живые узлы |
Только дописывание (append-only) | Прочитанная запись неизменна, новые встают только после неё. При повторном чтении узел видит те же записи в том же порядке, даже после перезапуска |
Согласие (agreement) | Если два узла прочитали запись e, до неё они прочитали одну и ту же последовательность записей |
Обоснованность (validity) | Значение в журнале кто-то просил добавить |
Общий журнал реализуют протоколом total order broadcast (его также называют atomic broadcast). Чтобы добавить значение, его «рассылают» протоколом. Когда протокол его «доставляет», значение становится записью журнала.
Имея общий журнал, консенсус решить легко: каждый узел просит добавить своё значение, а решением становится значение первой записи. Все читают журнал в одном порядке, поэтому согласятся, какая запись первая. Обратное построение сложнее, но идея такая:
- Для каждой будущей записи журнала есть слот, и на каждый слот запускают отдельный консенсус.
- Узел, который хочет добавить значение, предлагает его в ещё не решённый слот.
- Когда консенсус решил слот, а все предыдущие слоты уже решены, значение дописывают в журнал. Вместе с ним дописывают все следующие подряд решённые слоты.
- Если значение не выбрали для слота, узел предлагает его снова в более поздний слот.
Значит, консенсус эквивалентен total order broadcast и общему журналу. Репликация с одним leader без failover не выполняет требование liveness: если leader упал, журнал встаёт. Вся трудность, как обычно, в безопасном автоматическом failover.
Fetch-and-add как консенсус
Заголовок раздела «Fetch-and-add как консенсус»Linearizable генератор ID почти решает консенсус, но не до конца. Его строят на fetch-and-add: атомарно увеличить счётчик и вернуть старое значение. Имея CAS, сделать fetch-and-add легко. Читаем счётчик и делаем CAS с прочитанным значением как ожидаемым и значением плюс 1 как новым. Если CAS не прошёл, повторяем. При конкуренции это медленнее настоящего fetch-and-add, но по смыслу то же самое. Раз CAS строится из консенсуса, fetch-and-add тоже.
А наоборот? Пусть счётчик равен 0, и каждый узел, который хочет предложить значение, делает fetch-and-add. Один узел прочитает 0, остальные — большие числа. Пусть узел с 0 победил. Остальные знают, что проиграли, но не знают, кто победил. Победитель мог бы им сообщить, но если он упадёт раньше, остальные застрянут, и консенсус не завершится. Выбрать другого победителя они тоже не могут: узел с 0 может вернуться и законно решить своё значение.
Исключение — когда значения предлагают не больше двух узлов. Тогда они сначала обмениваются значениями, а потом делают fetch-and-add. Узел, который прочитал 0, решает своё значение, а узел, который прочитал 1, решает значение соседа. Поэтому говорят, что у fetch-and-add число консенсуса (consensus number) равно 2. У CAS и общего журнала оно равно бесконечности: они решают консенсус для любого числа узлов.
Атомарная фиксация как консенсус
Заголовок раздела «Атомарная фиксация как консенсус»Глава 8 описала задачу атомарной фиксации (atomic commit): все базы или shard распределённой транзакции должны либо сделать commit, либо abort. Там же был two-phase commit (2PC), координатор которого — единая точка отказа.
Атомарная фиксация похожа на консенсус: узлы тоже должны договориться. Но есть важное отличие. В консенсусе можно выбрать любое предложенное значение, а атомарная фиксация обязана сделать abort, если хоть один участник проголосовал за abort. Её свойства:
| Свойство | Смысл |
|---|---|
| Единогласие | Нельзя, чтобы один узел сделал commit, а другой abort |
| Целостность | Узел не меняет commit на abort и наоборот |
| Обоснованность | Commit возможен, только если все проголосовали за commit. Хоть один голос за abort — abort у всех |
| Нетривиальность | Если все за commit и таймаутов не было, все делают commit |
| Завершение | Каждый живой узел в итоге делает commit или abort |
Обоснованность разрешает commit только при общем согласии. Нетривиальность запрещает алгоритму всегда делать abort, но разрешает abort, если где-то сработал таймаут. Остальные свойства почти такие же, как у консенсуса.
Из консенсуса атомарную фиксацию можно получить так. Каждый узел шлёт свой голос всем остальным. Узел, который получил commit от себя и от всех, предлагает в консенсус commit. Узел, который получил хоть один abort или не дождался голоса, предлагает abort. Каждый узел делает то, что решил консенсус. Если кто-то голосовал за abort, все предложат abort. Если все голосовали за commit, но были таймауты, предложения могут разойтись, и тогда неважно, что выберут, лишь бы все сделали одно и то же.
Обратно: каждый узел, который хочет предложить значение, начинает транзакцию на кворуме узлов. На каждом узле транзакция делает локальный CAS: ставит регистр в предложенное значение, если другая транзакция его ещё не поставила. Если CAS прошёл, узел голосует за commit, иначе за abort. Когда транзакция зафиксирована, её значение и есть решение. А при abort узел повторяет попытку с новой транзакцией. Значит, атомарная фиксация и консенсус тоже эквивалентны.
Консенсус на практике
Заголовок раздела «Консенсус на практике»Итак, консенсус об одном значении, CAS, общий журнал и атомарная фиксация эквивалентны. Но какая формулировка полезнее на практике? Ответ авторов: большинство систем консенсуса дают общий журнал. Raft, VSR и Zab дают его сразу. Paxos решает консенсус об одном значении, но на практике почти все используют расширение Multi-Paxos, которое тоже даёт журнал.
Как используют общий журнал
Заголовок раздела «Как используют общий журнал»Общий журнал хорошо подходит для репликации базы. Если каждая запись журнала — это запись в базу, и каждая реплика применяет одни записи в одном порядке детерминированной логикой, все реплики придут в одно состояние. Это state machine replication, и на нём же основан event sourcing из главы 3. Общие журналы полезны и в потоковой обработке (глава 12).
Также журнал даёт serializable транзакции. Если каждая запись — детерминированная транзакция в виде хранимой процедуры, и все узлы выполняют их в одном порядке, транзакции будут serializable. Базы с sharding и сильной моделью согласованности часто держат отдельный журнал на каждый shard. Это лучше масштабируется, но ограничивает гарантии между shard: согласованные снимки, внешние ключи. Serializable транзакции между shard возможны, но требуют дополнительной координации.
Журнал легко приспособить и к другим формам консенсуса:
- консенсус об одном значении и
CAS: решение — значение, которое первым появилось в журнале; - много отдельных решений (по одному на место в театре): кладём номер места в запись и для каждого места берём первую запись с ним;
- атомарный
fetch-and-add: кладём в запись число, а значение счётчика — сумма всех записей. Простой счётчик записей даётfencing token. В ZooKeeper такой номер называетсяzxid.
От репликации с одним leader к консенсусу
Заголовок раздела «От репликации с одним leader к консенсусу»Консенсус об одном значении прост, если решает один узел-«диктатор», а общий журнал прост, если дописывать может только один leader. Вопрос в том, как пережить падение этого узла. Традиционные базы с одним leader эту задачу не решали: failover делал администратор вручную. Это долгий простой, ведь человек не может реагировать мгновенно, и свойство завершения не выполняется. Консенсус требует, чтобы новый leader выбирался автоматически. (Не у всех алгоритмов консенсуса есть leader, но у распространённых есть.)
Это непросто. Все узлы должны согласиться, кто leader, иначе два узла сочтут себя leader и примут противоречивые решения. Получается замкнутый круг: чтобы выбрать leader, нужен консенсус, а чтобы решить консенсус, нужен leader.
Выход в том, что алгоритмы не требуют единственного leader в каждый момент времени. Они дают гарантию слабее: вводят номер эпохи (epoch number) и гарантируют, что внутри каждой эпохи leader один. В Paxos это ballot number, в VSR — view number, в Raft — term.
- Если узел долго не слышит
leaderи считает его мёртвым, он может начать выборы. Новые выборы получают номер эпохи больше всех прежних. - Если два
leaderиз разных эпох конфликтуют (старый оказался жив), побеждает тот, у кого номер эпохи больше. - Прежде чем дописать запись в журнал,
leaderпроверяет, что нетleaderс большей эпохой. Для этого он собирает голоса кворума, обычно большинства. Узел голосует «за», только если не знает оleaderс большей эпохой.
Так получается два голосования: одно выбирает leader, другое одобряет его предложение о следующей записи. Кворумы этих голосований должны пересекаться: хотя бы один узел, который одобрил запись, участвовал и в последних успешных выборах. Если голосование по записи прошло и не выявило большей эпохи, leader знает, что нового leader не выбрали, и может безопасно дописать запись.
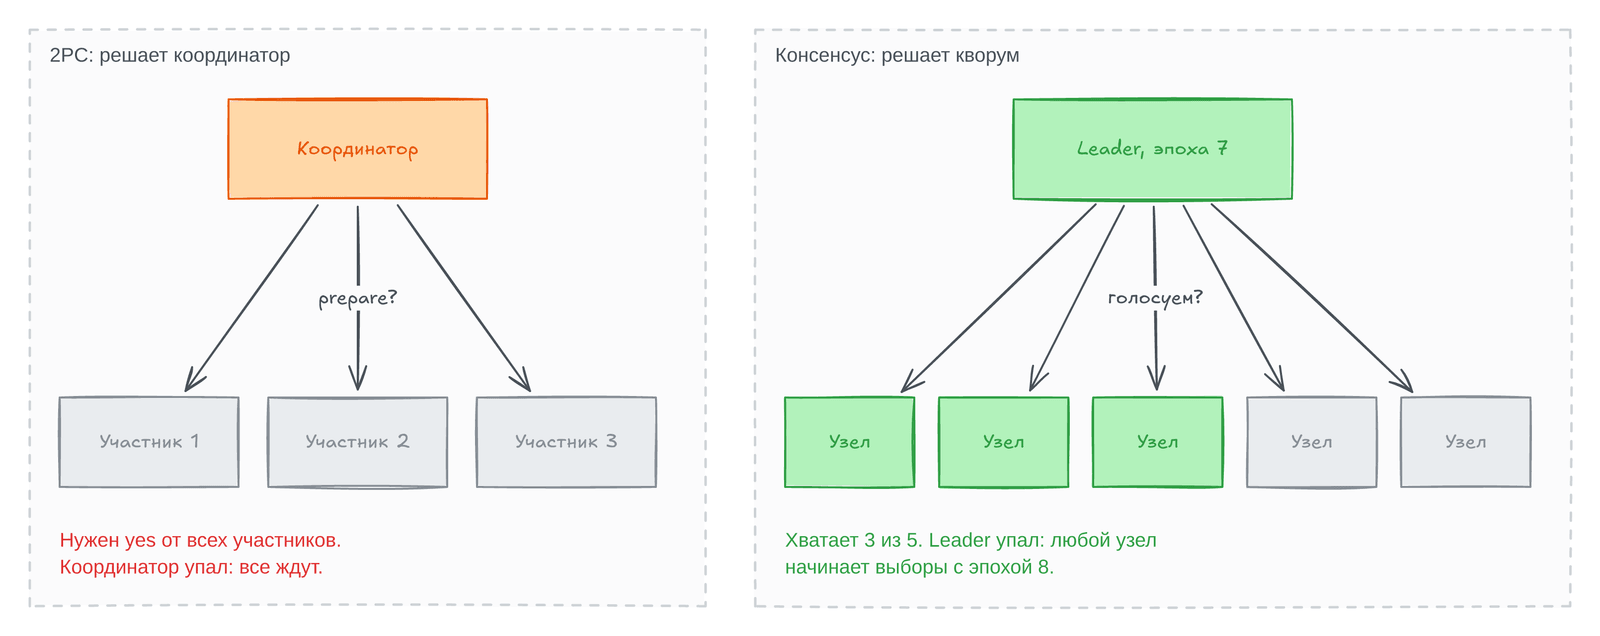
Два раунда голосования внешне похожи на 2PC, но протоколы очень разные. Схема показывает разницу. В консенсусе выборы может начать любой узел, и хватает ответа кворума. В 2PC голоса может собирать только координатор, и для commit ему нужно «да» от каждого участника.
Тонкости консенсуса
Заголовок раздела «Тонкости консенсуса»Эта основа общая для Raft, Multi-Paxos, VSR и Zab: кворум выбирает leader, и каждая запись, которую leader хочет добавить, требует ещё одного голосования кворума. Каждая новая запись синхронно реплицируется на кворум, прежде чем клиент получит подтверждение. Поэтому запись не пропадёт, если leader упадёт.
Но главная трудность — в деталях, и в них алгоритмы расходятся. Например, новый leader обязан сохранить все записи, которые старый leader успел добавить. Raft разрешает стать leader только узлу, чей журнал не отстаёт от журналов большинства follower. Paxos разрешает стать leader любому узлу, но требует сначала догнать журнал у других узлов, а потом уже добавлять свои записи.
Согласованность или доступность при выборе leader. Чтобы строго выполнить свойства общего журнала, новый
leaderдолжен знать все подтверждённые записи, прежде чем обрабатывать записи и linearizable чтения. Еслиleaderстанет узел со старыми данными, он может перезаписать записи старогоleaderи нарушить свойство «только дописывание». Иногда эти свойства сознательно ослабляют, чтобы быстрее восстановиться или восстановиться вообще. Например, в Kafka можно включитьunclean leader election: тогдаleaderможет стать отстающая реплика. А при асинхронной репликации вообще нельзя гарантировать, что хоть одинfollowerсвежий. Без этого требования растут скорость и доступность, но авторы предупреждают: это рискованно, теория консенсуса тут уже не работает. Пока сбоев нет, всё хорошо, но сбои из главы 9 легко приведут к потере или порче данных.
Ещё одна тонкость — записи, которые старый leader предложил до падения, но голосование по ним не закончилось. Детали есть в литературе к главе.
Базе на консенсусе мало превратить записи в записи журнала и реплицировать их на кворум. Чтобы чтения были linearizable, они тоже должны проходить голосование кворума, как запись: так узел проверяет, что он всё ещё leader и знает свежие данные. Так работают linearizable чтения в etcd.
В стандартной форме большинство алгоритмов считает набор узлов фиксированным: узлы падают и возвращаются, но список голосующих задан при создании кластера. На практике узлы надо добавлять и убирать, поэтому алгоритмы расширили функцией смены конфигурации (reconfiguration). Она особенно полезна при добавлении региона или при переезде: сначала добавляют новые узлы, потом убирают старые.
Плюсы и минусы консенсуса
Заголовок раздела «Плюсы и минусы консенсуса»Алгоритмы консенсуса сложны, но это огромный прорыв для распределённых систем. По сути консенсус — это «репликация с одним leader, сделанная правильно»: автоматический failover, без потери подтверждённых данных и без split brain, даже при всех проблемах из главы 9. Авторы предупреждают: система с автоматическим failover без проверенного алгоритма консенсуса скорее всего небезопасна. Проверенный алгоритм не гарантирует корректность всей системы, но это хорошее начало.
Почему же консенсус не используют везде? У него есть цена:
- Нужно строгое большинство: три узла терпят один сбой, пять — два.
- Каждая операция требует связи с кворумом, поэтому добавление узлов не увеличивает
throughput. Наоборот, каждый новый узел замедляет алгоритм. - При разрыве сети работает только часть с большинством, остальные узлы заблокированы.
- Отказы определяют по таймаутам. При сильно меняющихся задержках, особенно между регионами, их трудно настроить. Большой таймаут — долгое восстановление. Маленький — лишние выборы, и система тратит больше времени на выборы
leader, чем на работу. - Некоторые алгоритмы чувствительны к сбоям сети. У Raft есть неприятные пограничные случаи: если вся сеть работает, кроме одной постоянно ненадёжной связи, роль
leaderможет бесконечно прыгать между двумя узлами, и система не продвигается. Для этого в Raft добавили фазуpre-vote. Paxos тоже зависит отleader. Egalitarian Paxos (EPaxos) и его потомки работают безleaderи устойчивее к медленным узлам и плохим соединениям.
Сервисы координации
Заголовок раздела «Сервисы координации»Консенсус нужен любой распределённой базе с linearizable операциями, и многие современные базы реплицируют данные через него. Но особенно заметные его пользователи — сервисы координации: ZooKeeper, etcd и Consul. Внешне они похожи на key-value хранилища, но не рассчитаны на большой поток записей и хранение данных общего назначения.
Их задача — координировать узлы другой распределённой системы. Например, Kubernetes опирается на etcd, а Spark и Flink в режиме высокой доступности — на ZooKeeper. Сервисы координации хранят немного данных, которые целиком помещаются в память (но для долговечности пишутся на диск), и реплицируют их через отказоустойчивый консенсус. Образец для них — сервис блокировок Chubby от Google. Кроме консенсуса, они дают функции, полезные для распределённых систем:
| Функция | Как работает | Нужен ли консенсус |
|---|---|---|
Блокировки и lease | На отказоустойчивом CAS: из нескольких узлов lease получает только один | Да |
Поддержка fencing | Каждая запись журнала получает растущий ID, он служит fencing token: zxid и cversion в ZooKeeper, revision в etcd | Да |
| Обнаружение отказов | Клиент держит долгую сессию и шлёт heartbeat. Короткий обрыв не снимает lease, но если heartbeat нет дольше таймаута, сервис считает клиента мёртвым и снимает lease (в ZooKeeper это ephemeral node) | Нет |
| Уведомления об изменениях | Клиент подписывается на ключи и узнаёт, что другой клиент подключился к кластеру (записал значение) или упал (сессия истекла, ephemeral node исчезли). Опрашивать сервис не нужно | Нет |
Конфигурация в сервисе координации. Параметры вроде таймаутов и размеров пулов потоков иногда хранят в сервисе координации как пары ключ-значение. Процесс читает их при старте и подписывается на изменения. После изменения он сразу берёт новое значение или перезапускается. Консенсус здесь не нужен, но если сервис уже работает, его уведомления удобны. Альтернатива — периодически читать конфигурацию из файла или по URL без специального сервиса.
Распределение работы между узлами
Заголовок раздела «Распределение работы между узлами»Сервис координации полезен, когда из нескольких экземпляров процесса надо выбрать leader или основной экземпляр, а при его падении передать роль другому. Это нужно базам с одним leader, планировщикам задач и похожим системам с состоянием.
Другой случай — ресурс, разделённый на shard (база, потоки сообщений, файловое хранилище, система акторов), где надо решить, какой shard на каком узле. Когда в кластер приходят новые узлы, часть shard переезжает к ним для rebalancing. Когда узлы уходят или падают, их работу берут другие.
Такие задачи решают атомарными операциями, ephemeral node и уведомлениями. При правильной настройке приложение само восстанавливается после сбоев без человека. Это непросто даже с библиотеками вроде Apache Curator, но намного лучше, чем писать алгоритм консенсуса с нуля: там очень легко ошибиться.
Отдельный сервис координации работает на фиксированном небольшом наборе узлов (обычно три или пять), сколько бы узлов ни было в основной системе. Запускать консенсус на тысячах узлов хранилища с тысячами shard было бы очень неэффективно. Гораздо лучше отдать консенсус нескольким узлам сервиса координации.
Данные в сервисе координации меняются медленно. Это сведения вроде «узел с IP 10.1.1.23 — leader для shard 7», и они меняются раз в минуты или часы. Данные, которые меняются тысячи раз в секунду, сюда не кладут. Для них нужна обычная база, а быстро меняющееся внутреннее состояние сервиса можно реплицировать, например, через Apache BookKeeper.
Service discovery
Заголовок раздела «Service discovery»ZooKeeper, etcd и Consul часто используют для service discovery: узнать, по какому IP-адресу доступен нужный сервис. В облаке виртуальные машины постоянно появляются и исчезают, и адреса заранее неизвестны. Поэтому сервис при старте регистрирует свой адрес в реестре, где его найдут другие.
Сервис координации здесь удобен: обнаружение отказов и уведомления помогают следить за экземплярами. А если он уже нужен для lease, блокировок или выбора leader, логично взять его и для service discovery: он и так знает, какой узел должен принимать запросы.
Но консенсус для service discovery часто избыточен. Linearizability тут обычно не нужна, а важнее высокая доступность и скорость: без service discovery встанет всё. Поэтому данные о сервисах лучше кэшировать. Клиент, который не смог подключиться, идёт мимо кэша, повторяет запрос со свежим значением и обновляет кэш. Кэш также обновляют по TTL. Например, service discovery на DNS использует несколько уровней кэша ради скорости и доступности.
Для этого случая в ZooKeeper есть observer. Эти реплики получают журнал и хранят копию данных, но не голосуют в консенсусе. Чтение с observer не linearizable и может быть устаревшим, но остаётся доступным при разрыве сети и увеличивает throughput чтений.
Итоги главы
Заголовок раздела «Итоги главы»Linearizabilityделает реплицированные данные похожими на одну копию с атомарными операциями. Она нужна, когда данные должны быть свежими при чтении или когда надо разрешить гонку, например при создании файлов с одним именем.Linearizabilityпроста для понимания, но медленная, особенно при больших задержках сети. Многие методы репликации её не дают, даже если кажутся сильно согласованными: кворумы в стиле Dynamo,LWW, несколькоleader.- Теорема
CAPверна, но очень узка: при разрыве сети linearizable система теряет доступность. На практике отlinearizabilityотказываются чаще ради скорости, чем ради отказоустойчивости. - Счётчик на одном узле даёт linearizable ID, но не переживает сбой. Распределённые схемы (
shard, блоки, UUID, метки времени) дают уникальные ID без правильного порядка. - Часы Лэмпорта и
HLCдают порядок, согласованный с причинностью, но неlinearizability. Векторные часы ещё и показывают одновременные события, но занимают больше места. - Консенсус в классической форме — это выбор одного значения, с которым согласны все узлы и которое никто не меняет.
- Эквивалентны консенсусу linearizable
CAS, блокировки иlease, ограничения уникальности, общий журнал (total order broadcast) и атомарная фиксация транзакций.Fetch-and-addрешает консенсус только для двух узлов. - Raft и Paxos — это по сути репликация с одним
leaderплюс встроенный автоматический выборleader. Номера эпох и пересекающиеся кворумы не дают потерять подтверждённые записи и попасть вsplit brain. - Каждая запись и каждое linearizable чтение требуют подтверждения кворума. Это дорого, особенно между регионами, но без этого нет сильной согласованности с отказоустойчивостью.
- ZooKeeper и etcd дают блокировки,
lease, обнаружение отказов и уведомления поверх консенсуса. Если задача сводится к консенсусу, лучше взять такой сервис, чем писать свой алгоритм. Если сильная согласованность не нужна, подойдут репликация безleaderили с несколькимиleaderи логические часы.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
Eventual consistency | Реплики когда-нибудь сойдутся, расхождения видит приложение |
Linearizability | Система ведёт себя как одна копия данных, операции атомарны, чтение видит свежее значение |
Strict serializability | Serializability транзакций плюс linearizability |
Регистр (register) | Один объект: ключ, строка, документ |
CAS | Записать новое значение, только если текущее равно ожидаемому |
Fetch-and-add | Атомарно увеличить счётчик и вернуть старое значение |
Split brain | Два узла одновременно считают себя leader |
Теорема CAP | При разрыве сети нельзя иметь и linearizability, и доступность |
| Логические часы | Алгоритм, который считает события; порядок меток согласован с причинностью |
| Метка Лэмпорта | Пара (счётчик, ID узла) |
HLC | Гибридные логические часы: физическое время плюс правило Лэмпорта |
| Векторные часы | Счётчик на каждый узел, видно одновременные события |
| Консенсус | Узлы выбирают одно значение и не меняют решение |
Общий журнал (shared log) | Журнал, в котором все видят одни записи в одном порядке |
Total order broadcast | Протокол, который доставляет все сообщения всем узлам в одном порядке |
| Атомарная фиксация | Все участники транзакции делают commit или все abort |
| Номер эпохи | Term в Raft, ballot в Paxos: внутри эпохи leader один |
| Кворум | Набор узлов, обычно большинство, нужный для решения |
Fencing token | Растущий номер, который отсекает устаревшего владельца lease |
| Сервис координации | ZooKeeper, etcd, Consul: блокировки, lease, отказы и уведомления поверх консенсуса |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Не считайте реплики или кворум в Cassandra и Riak linearizable. Если нужна уникальность или
CAS, берите систему сleaderили консенсусом. - Для
pipelineс несколькими каналами (файлы плюс очередь) проверяйте порядок. Читатель может увидеть сообщение раньше данных. - Не стройте межсистемные транзакции через XA без нужды. Чаще работают журнал и CDC плюс идемпотентная обработка. Это тема главы 12 и главы 13.
- Не пишите свой алгоритм выбора
leader. Используйте ZooKeeper, etcd или Consul. Для кластера берите 3 или 5 узлов. - Следите за зависшими транзакциями и блокировками, если
2PCвсё же используется. Координатор надо реплицировать, а его журнал — бэкапить. - Если ограничения можно нарушить и исправить (возврат, извинение), это проще и дешевле строгих ограничений.
- Не сортируйте события из разных систем по UUID v4 или по времени разных серверов. UUID v7 и Snowflake дают только приблизительный порядок. Если порядок важен, нужен один генератор, общий журнал или
HLC. - Kafka с
unclean leader electionбыстрее восстанавливается, но может потерять данные. Для важныхtopicдержите эту опцию выключенной.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем
linearizabilityотличается отserializability? Может ли база дать одно без другого? - Почему кворум
w + r > nв системе безleaderне гарантируетlinearizability? - Почему авторы считают формулировку
CAP«два из трёх» неверной? Когда выбор между согласованностью и доступностью действительно нужен? - Чем метки Лэмпорта хуже linearizable генератора ID? Разберите пример с закрытым аккаунтом и фото.
- Почему
fetch-and-addрешает консенсус только для двух узлов, аCAS— для любого числа? - Зачем алгоритму консенсуса номер эпохи и пересекающиеся кворумы? Чем его голосование отличается от
2PC?
Предыдущая: Проблемы распределённых систем. Следующая: Пакетная обработка.