

Designing Data-Intensive Applications, глава 2: Нефункциональные требования
Главная мысль: кроме функций, у приложения есть нефункциональные требования: оно должно быть быстрым, надёжным, масштабируемым и простым в сопровождении. Эти свойства описывают числами (перцентилями времени ответа, throughput, целями SLO), иначе о них нельзя договориться.
О чём глава
Заголовок раздела «О чём глава»Функциональные требования говорят, что приложение делает. Нефункциональные говорят, каким оно должно быть: быстрым, надёжным, безопасным, простым в сопровождении. Их редко записывают, но они важны не меньше: приложение, которое невыносимо тормозит или падает, всё равно что не существует. В главе 1 авторы обсуждали компромиссы архитектуры, а здесь вводят словарь для всей книги. Темы главы:
- как измерить производительность;
- что такое надёжность;
- как добавлять ресурсы, когда нагрузка растёт;
- как упростить сопровождение.
Пример: домашняя лента в социальной сети
Заголовок раздела «Пример: домашняя лента в социальной сети»Представим соцсеть в стиле X (бывший Twitter): пользователи пишут посты и подписываются друг на друга. Пусть в день публикуют 500 млн постов, то есть в среднем 5 800 в секунду, а в пике до 150 000. Средний пользователь подписан на 200 человек, и у него 200 подписчиков. Разброс огромный: у большинства лишь несколько подписчиков, а у знаменитостей вроде Барака Обамы больше 100 млн.
Пользователи, посты и подписки
Заголовок раздела «Пользователи, посты и подписки»Данные лежат в реляционной базе в трёх таблицах: users, posts и follows. Главная операция чтения — домашняя лента (home timeline), то есть свежие посты тех, на кого подписан пользователь. Её даёт один SQL-запрос: соединить посты с подписками, отсортировать по времени и взять последние 1000 (наша версия есть в разделе «Код из главы»).
Пусть пост должен дойти до подписчиков за пять секунд. Если клиент просто повторяет запрос каждые пять секунд (polling), то при 10 млн пользователей онлайн это 2 млн запросов в секунду. Каждый запрос ищет посты 200 авторов, так что получается 400 млн выборок в секунду. А для тех, кто подписан на десятки тысяч аккаунтов, запрос ещё тяжелее.
Материализация и обновление лент
Заголовок раздела «Материализация и обновление лент»Лучше сделать иначе: сервер сам отправляет новые посты тем, кто онлайн, а ленту считают заранее и отдают из кэша. Когда кто-то публикует пост, система находит его подписчиков и вставляет пост в ленту каждого, как письмо в почтовые ящики. Цена такая: каждая публикация требует больше работы, потому что ленты — это производные данные и их нужно обновлять. Когда один запрос порождает несколько запросов дальше по цепочке, коэффициент роста называют fan-out.
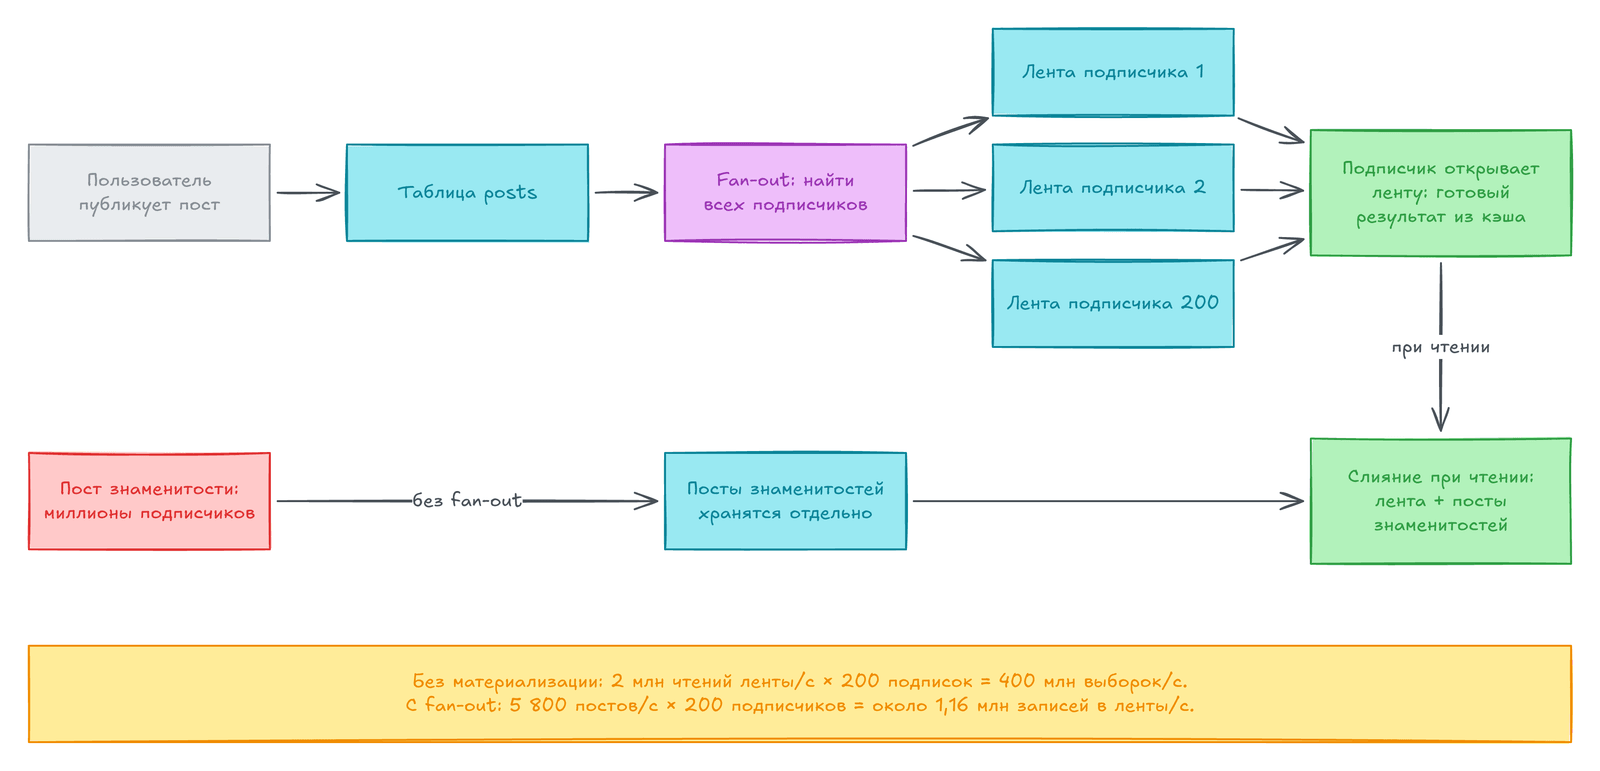
Схема показывает путь поста по лентам подписчиков, а внизу — обходной путь для знаменитостей.
При 5 800 постах в секунду и fan-out, равном 200, нужно около 1,16 млн записей в ленты в секунду. Это много, но намного меньше 400 млн выборок. При всплеске постов доставку можно поставить в очередь: посты появятся чуть позже, а ленты по-прежнему быстро грузятся из кэша.
Заранее посчитанный и поддерживаемый результат запроса называют материализацией, а кэш лент — это materialized view. Он ускоряет чтение, но добавляет работу при записи. Для большинства пользователей запись обходится недорого, но есть два крайних случая:
- Пользователь подписан на множество активных авторов. Всё это он не прочитает, поэтому часть записей в его ленту можно отбросить и показывать выборку.
- Знаменитость публикует пост для миллионов подписчиков. Терять записи здесь нельзя, поэтому посты знаменитостей хранят отдельно и подмешивают в ленту при чтении.
Описание производительности
Заголовок раздела «Описание производительности»Производительность обычно описывают двумя метриками:
- Время ответа (
response time) — сколько прошло от запроса до ответа. В примере это время загрузки ленты. throughput— сколько запросов или данных система обрабатывает в секунду, например постов в секунду. На конкретном железе у него есть предел.
Метрики связаны: с ростом нагрузки растёт время ответа. Причина в очередях: новый запрос ждёт, пока CPU занят предыдущим. Когда throughput подходит к пределу, задержки в очереди растут резко.
Когда перегруженная система не восстанавливается
Заголовок раздела «Когда перегруженная система не восстанавливается»Перегруженная система может попасть в порочный круг. Ответы задерживаются, клиенты не дожидаются их и повторяют запросы, и нагрузка растёт ещё сильнее (retry storm). Такая система может остаться перегруженной, даже когда нагрузка спала. Это метастабильный отказ (metastable failure), он вызывает серьёзные аварии.
Клиент защищается так: увеличивает паузы между повторами со случайным сдвигом (exponential backoff) и временно не обращается к сервису, который недавно падал (circuit breaker, token bucket). Сервер может заранее отклонять часть запросов (load shedding) или просить клиентов замедлиться (backpressure).
Пользователям важнее время ответа, а throughput определяет, сколько нужно серверов и сколько это стоит. Систему называют масштабируемой, если её предельный throughput можно заметно поднять, добавив ресурсы.
Задержка и время ответа
Заголовок раздела «Задержка и время ответа»Книга различает близкие слова так:
- Время ответа — всё, что видит клиент, со всеми задержками.
- Время обработки (
service time) — время, когда сервис активно работает над запросом. - Задержка в очереди (
queueing delay) — ожидание, например свободного CPU или места в сетевом буфере. - Задержка (
latency) — общее слово для времени, когда запрос никто не обрабатывает. Сетевая задержка — время в пути по сети.
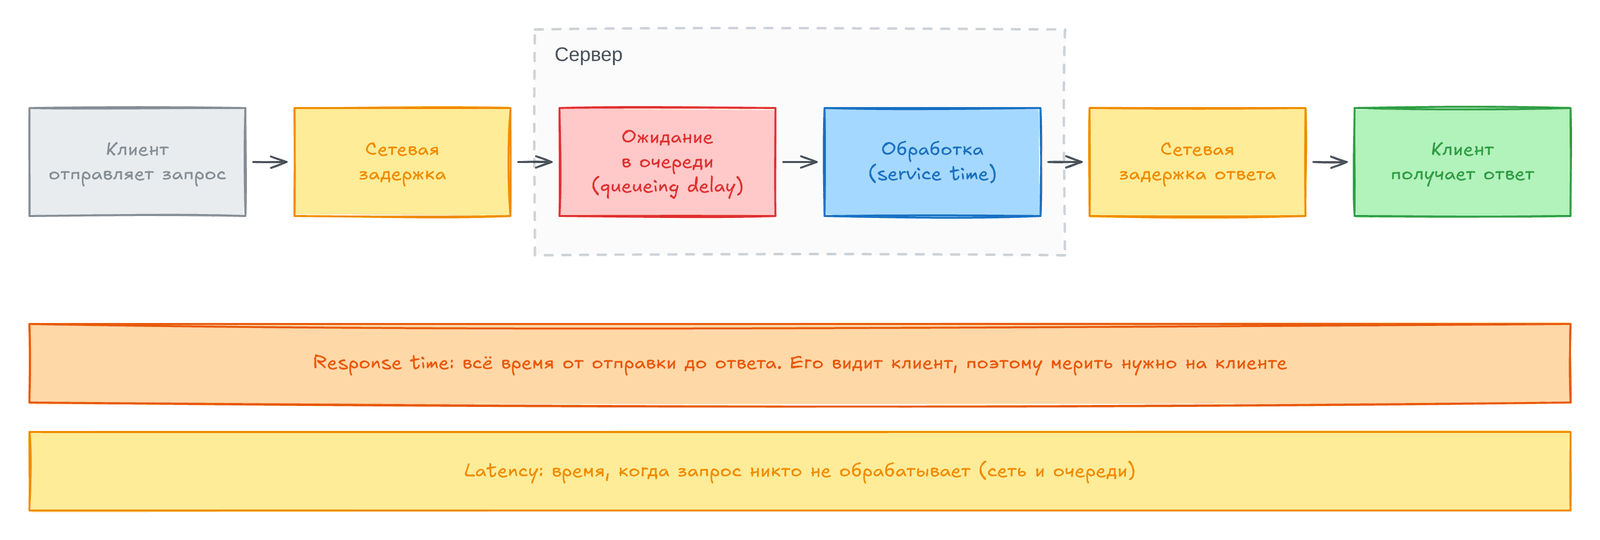
Схема читается слева направо: время ответа — это сумма всех отрезков.
Время ответа меняется даже для одинаковых запросов. Случайные задержки дают переключение контекста, потеря пакета, пауза сборщика мусора, чтение с диска и даже вибрация стойки (подробнее в главе 9). Но больше всего разброса дают очереди. Сервер обрабатывает параллельно лишь несколько запросов, поэтому пара медленных задерживает все следующие (head-of-line blocking). Это ожидание не входит во время обработки, поэтому измерять время ответа нужно на стороне клиента.
Среднее, медиана и перцентили
Заголовок раздела «Среднее, медиана и перцентили»Время ответа — это распределение, а не одно число: большинство запросов быстрые, но бывают сильные выбросы. Разброс сетевой задержки называют jitter.
Среднее помогает оценить пределы throughput, но плохо описывает типичный опыт: по нему не видно, сколько пользователей на самом деле ждали так долго. Лучше перцентили. Если отсортировать времена ответа, середина списка — это медиана, или p50. Медиана 200 ms значит, что половина запросов быстрее 200 ms. Выбросы показывают высокие перцентили p95, p99 и p999. Если p95 равен 1,5 секунды, то 5 запросов из 100 ждут 1,5 секунды или дольше.
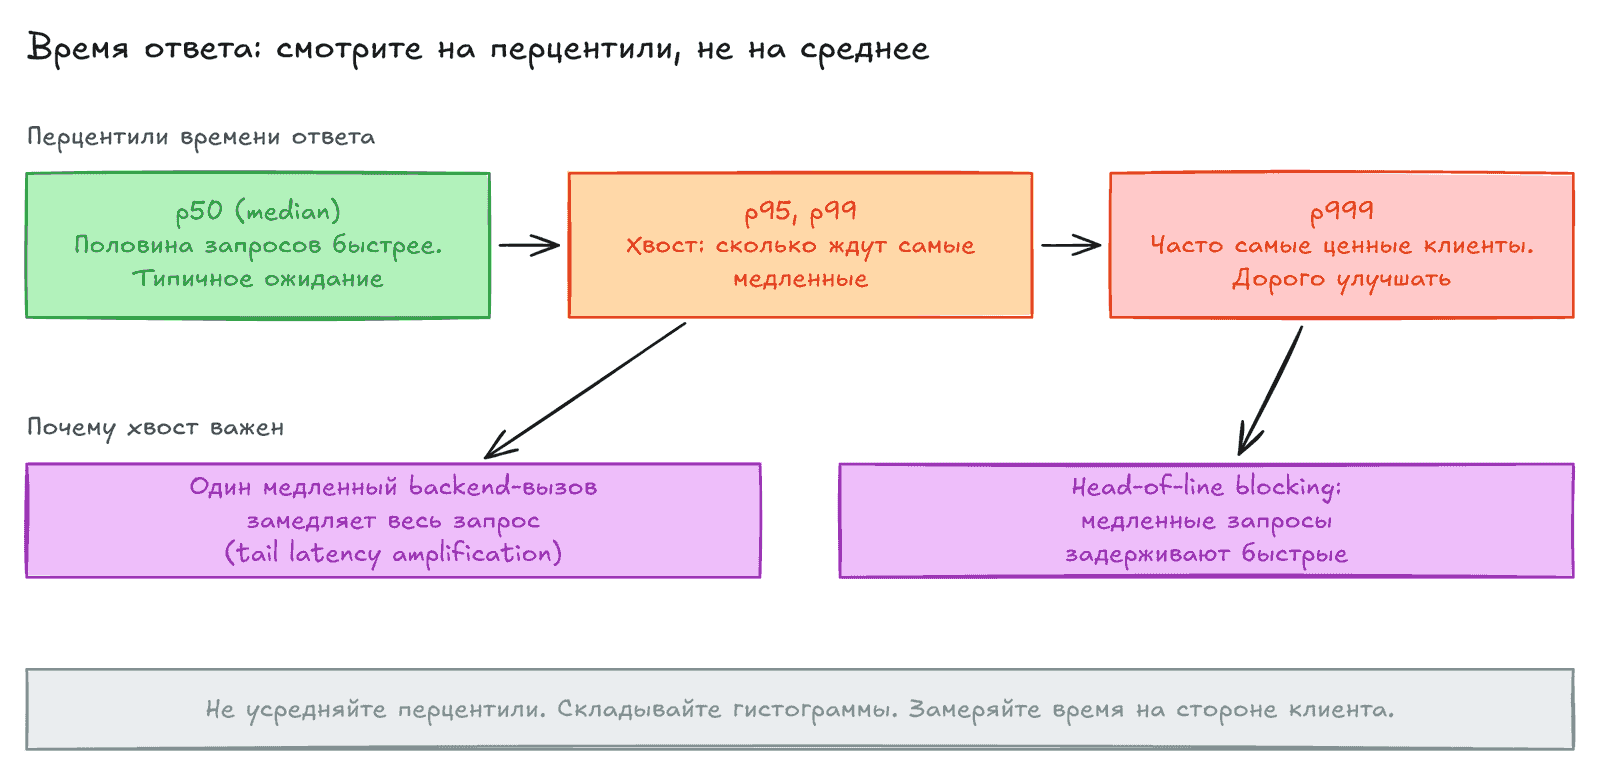
Схема сводит главное: медиана описывает типичное ожидание, а высокие перцентили — хвост.
Высокие перцентили называют tail latency. Amazon задаёт требования к внутренним сервисам по p999, хотя это 1 запрос из 1000. Медленнее всего сайт часто отвечает клиентам с большим объёмом данных, то есть с множеством покупок, а это самые ценные клиенты. Оптимизацию p9999 Amazon счёл слишком дорогой. Снижать очень высокие перцентили трудно: они зависят от случайных событий вне вашего контроля, а польза от снижения мала.
Как время ответа влияет на пользователей
Заголовок раздела «Как время ответа влияет на пользователей»Кажется очевидным, что быстрый сервис лучше для пользователей, но надёжных данных об этом мало, и цифры расходятся:
| Исследование | Результат |
|---|---|
| Google, 2006 | Выдача медленнее на 500 ms (с 400 до 900 ms) — минус 20% трафика и выручки |
| Google, 2009 | +400 ms — всего на 0,6% меньше поисков в день |
| Bing, 2009 | +2 секунды — минус 4,3% выручки от рекламы |
| Akamai | +100 ms — конверсия магазинов падает до 7% |
| Yahoo | Если быстрая выдача опережает медленную на 1,25 секунды и больше, по ней кликают на 20–30% чаще |
Новых данных эти компании не публикуют. В исследовании Akamai есть парадокс: самые быстрые страницы тоже дают низкую конверсию, потому что это часто пустые страницы вроде ошибки 404. Влияние контента и скорости там не разделено, так что выводы, вероятно, ничего не значат. Yahoo, наоборот, учитывал качество выдачи.
Как использовать метрики времени ответа
Заголовок раздела «Как использовать метрики времени ответа»Высокие перцентили особенно важны, когда один запрос пользователя вызывает много backend-сервисов. Даже при параллельных вызовах запрос ждёт самый медленный. Чем больше вызовов, тем выше шанс попасть на медленный: это tail latency amplification.
Пояснение: если медленным оказывается 1% вызовов, а запрос делает 100 параллельных вызовов, медленными окажутся около 63% запросов: 1 − 0,99¹⁰⁰ ≈ 0,63.
Перцентили записывают в SLO и SLA. SLO (service level objective) — это цель, например: медиана меньше 200 ms, p99 меньше 1 секунды, и 99,9% корректных запросов проходят без ошибки. SLA (service level agreement) — договор о том, что будет, если SLO не выполнен, например возврат денег. На практике хорошие метрики доступности выбрать непросто.
Как считать перцентили
Заголовок раздела «Как считать перцентили»Для дашборда перцентили считают постоянно: например, хранят окно времён ответа за 10 минут и раз в минуту считают по нему медиану и перцентили. Проще всего сортировать весь список. Если это дорого, есть библиотеки приближённого расчёта: HdrHistogram, t-digest, OpenHistogram, DDSketch.
Авторы предупреждают: усреднять перцентили (по времени или по машинам) математически бессмысленно. Правильно складывать гистограммы. Пример есть в разделе «Код из главы».
Надёжность и отказоустойчивость
Заголовок раздела «Надёжность и отказоустойчивость»От программы обычно ждут, что она делает то, чего ждёт пользователь, переживает его ошибки, достаточно быстро работает при ожидаемой нагрузке и не пускает посторонних. Если это и есть «работать правильно», то надёжность — это «продолжать работать правильно, даже когда что-то идёт не так». Авторы различают два понятия:
Fault— сбой одной части: сломался диск, упала машина, недоступен внешний сервис.Failure— отказ системы целиком: она не даёт пользователю нужный сервис, то есть не выполняет SLO.
Это одно и то же событие, только на разных уровнях системы. Если система — один диск, его поломка уже failure. Если дисков много, поломка одного — лишь fault, и система переживёт его, если у данных есть копия.
Отказоустойчивость
Заголовок раздела «Отказоустойчивость»Отказоустойчивая (fault-tolerant) система продолжает работать, несмотря на определённые сбои. Часть, сбой которой роняет всю систему, называют единой точкой отказа (single point of failure, SPOF).
Например, во время fan-out может упасть машина, которая обновляет ленты. Тогда её работу должна подхватить другая машина, не потеряв и не задвоив ни одного поста. Это exactly-once semantics, подробно о нём в главе 12.
Отказоустойчивость всегда ограничена: например, система переживёт поломку двух дисков или одного узла из трёх. Если упали все узлы, сделать ничего нельзя. Авторы шутят, что от чёрной дыры, которая проглотит Землю, спас бы только хостинг в космосе, а такой бюджет никто не утвердит.
Полезно даже вызывать сбои нарочно, например случайно убивать процессы (fault injection). Многие критичные баги сидят в плохой обработке ошибок. Если вызывать сбои нарочно, механизмы защиты постоянно проходят проверку. На этом построен chaos engineering. Обычно сбои лучше переживать, чем предотвращать. Исключение — безопасность: утечку данных уже не отменить.
Сбои железа
Заголовок раздела «Сбои железа»Авторы приводят такие оценки:
| Компонент | Как часто ломается |
|---|---|
| HDD | 2–5% в год: в кластере из 10 000 дисков это примерно один отказ в день |
| SSD | 0,5–1% в год. Неисправимые ошибки — примерно раз в год на диск, даже у новых, это чаще, чем у HDD |
| CPU | Примерно у 1 машины из 1000 есть ядро, которое иногда считает неверно, и программа может тихо вернуть неверный результат |
| RAM | Даже с ECC больше 1% машин за год получают неисправимую ошибку, и машина падает |
| Целый ЦОД | Отключение питания, ошибка в сети, пожар, наводнение; солнечная буря может повредить энергосети и кабели |
Блоки питания и RAID-контроллеры тоже ломаются, но реже. В маленькой системе о таком можно не думать, если железо легко заменить. В большой системе сбои железа — часть нормальной работы.
Избыточность против сбоев железа
Заголовок раздела «Избыточность против сбоев железа»Первый ответ — избыточность (redundancy): диски в RAID, два блока питания, батареи и дизель-генераторы в ЦОД. Так машина может работать годами без остановки. Но избыточность хорошо работает, только когда сбои независимы, а на практике они связаны, и целые стойки и ЦОД отказывают чаще, чем хотелось бы.
Поэтому облачные системы меньше заботятся об отдельной машине и переживают потерю узлов на уровне ПО. Облака делятся на зоны доступности (availability zone): ресурсы в одной зоне стоят рядом и чаще отказывают вместе. Техники этой книги рассчитаны на потерю машин, стоек и зон доступности (главы 6 и 10). Бонус для эксплуатации — rolling upgrade: узлы обновляют по одному, без простоя (глава 5). Систему на одном сервере для того же патча пришлось бы остановить.
Ошибки в ПО
Заголовок раздела «Ошибки в ПО»Сбои железа в основном независимы, а ошибки ПО сильно связаны: на многих узлах работает одна программа с одними багами. Поэтому они вызывают больше отказов. Примеры:
- Баг роняет все узлы сразу. 30 июня 2012 года високосная секунда (
leap second) из-за бага в ядре Linux повесила множество Java-приложений. А SSD некоторых моделей из-за бага в прошивке отказывают ровно через 32 768 часов работы. - Процесс съедает общий ресурс: CPU, память, диск, сеть или потоки.
- Сервис, от которого зависит система, тормозит или возвращает испорченные ответы.
- Взаимодействие систем даёт поведение, которого нет при тестах по отдельности (
emergent behavior). - Каскадные отказы: один компонент перегружает другой, а тот роняет третий.
Такие баги часто долго не проявляются, пока не нарушится какое-то допущение программы о среде. Быстрого решения нет, помогают мелочи: продумывать допущения, тестировать, изолировать процессы, разрешать им падать и перезапускаться, избегать retry storm, мониторить систему в production.
Люди и надёжность
Заголовок раздела «Люди и надёжность»Люди не просто следуют правилам: они творчески приспосабливаются, но поэтому и ошибаются. Одно исследование крупных интернет-сервисов показало, что главная причина аварий — изменения конфигурации, а железо виновато лишь в 10–25% случаев.
Обвинять людей вредно. «Человеческая ошибка» — не причина, а симптом проблемы в социотехнической системе, где люди стараются делать свою работу. Снизить вред помогают технические меры:
- тесты, в том числе property testing на случайных входных данных;
- быстрый откат конфигурации и постепенный rollout кода;
- понятный мониторинг и
observability; - интерфейсы, которые подталкивают к правильному действию.
Всё это стоит денег, и компании часто выбирают новые функции вместо тестов. Тогда в предсказуемой ошибке виноват не исполнитель, а приоритеты организации. Поэтому всё больше компаний проводят blameless postmortem: после инцидента люди рассказывают всё без страха наказания, и организация учится. Простым ответам не верьте: «Бобу надо было быть внимательнее» так же бесполезно, как «перепишем backend на Haskell».
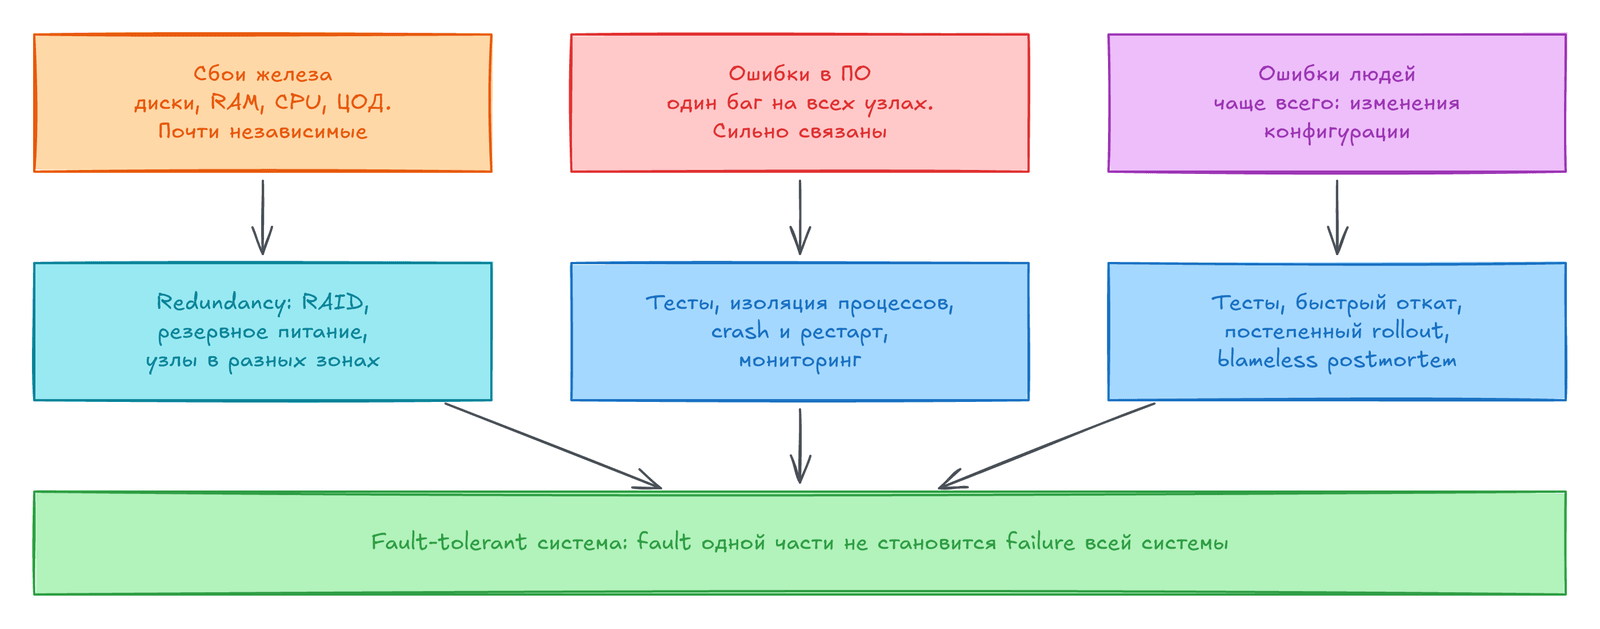
Схема сводит раздел: три источника сбоев, меры против каждого и цель — не дать fault стать failure.
Насколько важна надёжность
Заголовок раздела «Насколько важна надёжность»Надёжность нужна не только атомным станциям. Баги в бизнес-приложениях снижают продуктивность, неверная отчётность несёт юридические риски, а простой магазина стоит выручки и репутации. Короткий простой часто терпим, но безвозвратная потеря данных — катастрофа: представьте родителя, у которого пропали все фото детей.
Самый тяжёлый пример — скандал с системой Horizon британской почты. С 1999 по 2019 год сотни начальников отделений осудили за кражу, потому что программа показывала недостачу, хотя недостачу часто вызывали баги. Позже многие приговоры отменили. Причина этой, вероятно, крупнейшей судебной ошибки в истории Великобритании — норма английского права: компьютер считается исправным, пока не доказано обратное.
Иногда надёжностью жертвуют ради дешёвой разработки, например в прототипе. Но делать это нужно сознательно и помнить о последствиях.
Масштабируемость
Заголовок раздела «Масштабируемость»Система, надёжная сегодня, может не справиться завтра, если нагрузка вырастет: было 10 000 пользователей, стало 100 000. Масштабируемость (scalability) — это способность справляться с ростом нагрузки.
Подходит ли вам совет «вы не Google, просто возьмите реляционную базу», зависит от того, какое приложение вы строите. В стартапе главная цель — простая и гибкая система, которую легко менять, пока вы узнаёте клиентов. Готовиться к гипотетическому масштабу там вредно: в лучшем случае это потерянные усилия, в худшем — негибкий дизайн.
Фразы «X масштабируется» и «Y не масштабируется» ничего не значат. Правильные вопросы такие: как мы справимся, если система вырастет определённым образом? Как добавить ресурсы? Когда мы упрёмся в предел архитектуры? Заниматься техниками масштабирования стоит тогда, когда вы увидели реальные узкие места.
Понять нагрузку
Заголовок раздела «Понять нагрузку»Сначала нужно понять текущую нагрузку. Часто это throughput: запросы в секунду, гигабайты в день, заказы в час. Иногда важен пик, например число пользователей онлайн. Важны и другие статистики: доля чтений и записей, hit rate кэша, число подписчиков на пользователя. Узким местом может быть средний случай, а может быть горстка крайних.
Дальше рост изучают с двух сторон: что будет с производительностью при тех же ресурсах (CPU, память, сеть) и сколько ресурсов добавить, чтобы производительность не изменилась. Обычно цель — выполнить SLA и потратить как можно меньше.
Если вдвое больше ресурсов даёт вдвое больше нагрузки при той же производительности, это линейная масштабируемость (linear scalability). Иногда бывает и лучше, но чаще стоимость растёт быстрее: например, при большом объёме данных одна запись требует больше работы.
Shared-memory, shared-disk и shared-nothing
Заголовок раздела «Shared-memory, shared-disk и shared-nothing»Самый простой путь — более мощная машина (scaling up). Книга сравнивает три архитектуры:
| Архитектура | Как устроена | Главный плюс | Главный минус |
|---|---|---|---|
shared-memory | Одна машина, потоки делят общую RAM | Простота | Машина вдвое мощнее стоит намного больше, чем вдвое и вряд ли вытянет вдвое большую нагрузку |
shared-disk | Свои CPU и RAM, общий массив дисков по сети (NAS, SAN) | Классика on-premise хранилищ данных | Блокировки и конкуренция ограничивают рост |
shared-nothing (scaling out) | У каждого узла свои CPU, RAM и диски, координация через сеть | Может расти линейно, гибко добавлять ресурсы, переживать потерю ЦОД | Нужен sharding (глава 7) и вся сложность распределённых систем (глава 9) |
Некоторые облачные базы разделяют хранение и вычисления: несколько вычислительных узлов работают с одним сервисом хранения. Это похоже на shared-disk, но без старых проблем, потому что хранилище даёт API под нужды базы, а не файловую систему или блочное устройство.
Принципы масштабирования
Заголовок раздела «Принципы масштабирования»Универсальной масштабируемой архитектуры нет. Система на 100 000 запросов в секунду по 1 кБ совсем не похожа на систему на 3 запроса в минуту по 2 ГБ, хотя поток данных у них одинаковый — 100 МБ/с. Архитектура под одну нагрузку вряд ли выдержит десятикратную, поэтому быстрорастущий сервис пересматривают на каждом порядке роста. Планировать дальше чем на порядок вперёд обычно не стоит.
Первый принцип — делить систему на части, которые работают независимо. На нём стоят микросервисы, sharding, потоковая обработка и shared-nothing. Трудность в том, где провести границы. Второй принцип — не усложнять без нужды. Если хватает базы на одной машине, она лучше распределённой. При предсказуемой нагрузке ручное масштабирование даёт меньше сюрпризов, чем autoscaling, а 5 сервисов проще, чем 50.
Простота сопровождения
Заголовок раздела «Простота сопровождения»ПО не изнашивается, но меняются требования и платформа, а баги надо чинить. Большая часть стоимости ПО приходится не на разработку, а на сопровождение: исправления, эксплуатацию, разбор отказов, перенос, новые функции, выплату технического долга.
Особенно тяжело с legacy-системами: их технологии (мейнфреймы, COBOL) знают немногие, а знание о том, почему всё так устроено, ушло вместе с людьми. Поэтому сопровождение — задача не только техническая, но и человеческая. Любая ценная долгоживущая система однажды станет legacy, так что проектировать её нужно с расчётом на сопровождение. В книге разбирают три принципа:
- Удобство эксплуатации (
operability): организации легко поддерживать работу системы. - Простота (
simplicity): новым инженерам легко понять систему. - Способность к развитию (
evolvability): систему легко менять под новые требования.
Operability: удобство эксплуатации
Заголовок раздела «Operability: удобство эксплуатации»Есть мнение, что хорошая эксплуатация обходит недостатки плохого ПО, а хорошее ПО не спасёт плохую эксплуатацию. В системах из тысяч машин без автоматизации не обойтись, но у неё есть обратная сторона. Ручными остаются самые сложные случаи, поэтому нужна более сильная команда. А сломавшуюся автоматику разбирать труднее. Так что больше автоматизации — не всегда лучше.
Система данных помогает эксплуатации, если она:
- даёт метрики для мониторинга и поддерживает
observability; - не зависит от отдельных машин, и машину можно вывести на обслуживание;
- хорошо документирована и понятна («сделаю X — случится Y»);
- предлагает хорошие настройки по умолчанию, которые можно менять;
- сама восстанавливается, но оставляет ручное управление;
- ведёт себя предсказуемо.
Simplicity: управление сложностью
Заголовок раздела «Simplicity: управление сложностью»С ростом проект часто становится запутанным (big ball of mud). Сложность замедляет работу, срывает сроки и повышает риск внести баг: легко пропустить скрытое допущение или неожиданное взаимодействие. Поэтому простота должна быть одной из главных целей.
Но простота субъективна. Одна система прячет сложную реализацию за простым интерфейсом, другая проста внутри, но показывает больше деталей. Какая проще? Сложность делят на существенную (essential complexity), которая заложена в саму задачу, и случайную (accidental complexity), которая идёт от ограничений инструментов. Но граница между ними сдвигается вместе с инструментами.
Лучшее средство против сложности — абстракция. Хорошая абстракция прячет детали за простым фасадом и подходит многим приложениям, поэтому улучшение одного компонента получают все. Например, SQL прячет структуры на диске, параллельные запросы и последствия падений. Книга говорит не о шаблонах проектирования и domain-driven design (DDD), а об абстракциях общего назначения: транзакциях, индексах, журналах событий.
Evolvability: лёгкие изменения
Заголовок раздела «Evolvability: лёгкие изменения»Требования меняются постоянно: появляются новые сценарии, приоритеты, платформы и законы. На уровне процессов к этому помогают Agile, TDD и рефакторинг, а книга ищет такую гибкость на уровне системы данных и называет её evolvability. Слабо связанные простые системы менять легче, чем сильно связанные сложные.
Главный враг изменений — необратимость. Если при переезде на новую базу нельзя вернуться на старую, риск намного выше. Поэтому необратимые шаги делают очень осторожно.
Итоги главы
Заголовок раздела «Итоги главы»- Нефункциональные требования важны так же, как функции.
Materialized viewиfan-outпри записи удешевляют чтение, но добавляют работу при записи.- Пользователям важно время ответа, а
throughputопределяет стоимость ресурсов. - Время ответа — распределение: медиана показывает типичное ожидание, высокие перцентили показывают
tail latency. - Усреднять перцентили нельзя, а складывать гистограммы можно.
- Отказоустойчивая система не даёт
faultодной части статьfailureвсей системы. - Ошибки ПО сильно связаны, поэтому опаснее почти независимых сбоев железа.
- Ошибки людей — симптом проблем организации, их разбирают без поиска виноватых.
- Масштабируемость — ответ на вопрос «как мы справимся с конкретным ростом», а не ярлык.
- Сопровождение упрощают удобная эксплуатация, хорошие абстракции и минимум необратимых шагов.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
fan-out | Во сколько раз растёт число запросов, когда один запрос порождает несколько |
materialized view | Заранее посчитанный и поддерживаемый результат запроса |
Время ответа (response time) | Время от запроса до ответа, как его видит клиент |
Время обработки (service time) | Время активной работы сервиса над запросом |
Задержка (latency) | Время, когда запрос никто не обрабатывает |
throughput | Сколько запросов или данных система обрабатывает в секунду |
head-of-line blocking | Медленные запросы в очереди задерживают быстрые |
Перцентиль (p50, p99) | Порог, быстрее которого отвечает заданная доля запросов |
tail latency | Время ответа на высоких перцентилях |
| SLO / SLA | Цель уровня сервиса / договор о последствиях |
retry storm | Повторы запросов усиливают перегрузку |
fault / failure | Сбой одной части / отказ всей системы |
| SPOF | Часть, сбой которой роняет всю систему |
fault injection | Сбои вызывают нарочно, чтобы проверить защиту |
scaling up / scaling out | Более мощная машина / больше машин |
shared-nothing | У каждого узла свои CPU, RAM и диски |
accidental complexity | Сложность от инструментов, а не от задачи |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Описывайте нагрузку числами: объём данных, частота запусков, доля чтений и записей. Только потом выбирайте архитектуру.
- Для
pipelineи API измеряйтеp95иp99, а не только среднее. Для batch-задач следите заthroughputи за skew (перекос данных). - Планируйте отказы. Делайте задачи
idempotent, чтобы повтор после сбоя не портил данные. Умейте быстро откатить конфигурацию и пересчитать данные. - Не усредняйте перцентили при агрегации метрик. Храните гистограммы.
- Если вы собираете систему из базы, кэша и поискового индекса, вы отвечаете за их согласованность. Решите заранее, кто источник истины и как идёт синхронизация.
- Не стройте масштабируемость заранее без причины. Сначала понятная и простая система.
- Повторы задач в оркестраторе настраивайте с
exponential backoff, иначе сбой источника легко превратится вretry storm.
Код из главы
Заголовок раздела «Код из главы»Код проверен в DuckDB. Полные файлы лежат в scripts/ddia-code/: ch02_timeline.sql и ch02_percentiles.sql.
Лента при чтении и при записи
Заголовок раздела «Лента при чтении и при записи»Сначала создадим маленькую соцсеть: четыре пользователя, подписки и посты.
CREATE TABLE users ASSELECT * FROM (VALUES (1, 'anna'), (2, 'boris'), (3, 'vera'), (4, 'gleb')) t(id, username);
-- anna читает boris и vera; boris читает vera; gleb читает anna; vera читают троеCREATE TABLE follows ASSELECT * FROM (VALUES (1, 2), (1, 3), (2, 3), (4, 1), (4, 3)) t(follower_id, followee_id);
CREATE TABLE posts ASSELECT * FROM (VALUES    (101, 2, TIMESTAMP '2026-11-15 09:00', 'Запустили новый pipeline'),    (102, 3, TIMESTAMP '2026-11-15 09:05', 'p99 вырос до 1,2 с'),    (103, 4, TIMESTAMP '2026-11-15 09:10', 'Ищу курс по SQL'),    (104, 3, TIMESTAMP '2026-11-15 09:20', 'Нашли медленный запрос')) t(id, sender_id, ts, body);
Способ 1, как в книге: считать ленту при каждом чтении. Запрос соединяет посты с подписками и сортирует их по времени.
SELECT p.ts, u.username, p.bodyFROM posts pJOIN follows f ON p.sender_id = f.followee_idJOIN users u ON p.sender_id = u.idWHERE f.follower_id = 1 -- лента пользователя annaORDER BY p.ts DESCLIMIT 1000;┌─────────────────────┬──────────┬──────────────────────────┐│ ts │ username │ body ││ timestamp │ varchar │ varchar │├─────────────────────┼──────────┼──────────────────────────┤│ 2026-11-15 09:20:00 │ vera │ Нашли медленный запрос ││ 2026-11-15 09:05:00 │ vera │ p99 вырос до 1,2 с ││ 2026-11-15 09:00:00 │ boris │ Запустили новый pipeline │└─────────────────────┴──────────┴──────────────────────────┘Способ 2: материализовать ленты заранее. Новый пост vera сразу попадает в ленту каждого её подписчика, а fan-out равен числу таких записей.
CREATE TABLE home_timeline ASSELECT f.follower_id AS owner_id, p.id AS post_id, p.tsFROM posts p JOIN follows f ON p.sender_id = f.followee_id;
-- vera публикует пост: кладём его в ленту каждого подписчикаINSERT INTO posts VALUES (105, 3, TIMESTAMP '2026-11-15 09:30', 'Починили');INSERT INTO home_timelineSELECT f.follower_id, 105, TIMESTAMP '2026-11-15 09:30'FROM follows f WHERE f.followee_id = 3;
-- fan-out = сколько записей в ленты дал один постSELECT count(*) AS fan_out FROM home_timeline WHERE post_id = 105;
-- чтение ленты теперь без JOIN по подпискамSELECT post_id, ts FROM home_timeline WHERE owner_id = 1 ORDER BY ts DESC;┌─────────┐│ fan_out ││ int64 │├─────────┤│ 3 │└─────────┘┌─────────┬─────────────────────┐│ post_id │ ts ││ int32 │ timestamp │├─────────┼─────────────────────┤│ 105 │ 2026-11-15 09:30:00 ││ 104 │ 2026-11-15 09:20:00 ││ 102 │ 2026-11-15 09:05:00 ││ 101 │ 2026-11-15 09:00:00 │└─────────┴─────────────────────┘Один пост дал три записи в ленты, зато чтение стало простым запросом к одной таблице.
Среднее, перцентили и почему их нельзя усреднять
Заголовок раздела «Среднее, перцентили и почему их нельзя усреднять»Здесь 1000 запросов на двух серверах. Почти все быстрые, 1% очень медленных, а сервер b тормозит чаще.
CREATE TABLE requests ASSELECT    i AS id,    CASE WHEN i <= 500 THEN 'a' ELSE 'b' END AS server,    CASE        WHEN i % 100 = 0 THEN 3000                -- 1% очень медленных        WHEN i > 500 AND i % 10 = 0 THEN 900      -- сервер b тормозит чаще        ELSE 80 + (i * 37) % 120                  -- обычные: 80..199 ms    END AS response_msFROM generate_series(1, 1000) g(i);
SELECT    round(avg(response_ms))                  AS mean_ms,    quantile_disc(response_ms, 0.50)         AS p50,    quantile_disc(response_ms, 0.95)         AS p95,    quantile_disc(response_ms, 0.99)         AS p99,    quantile_disc(response_ms, 0.999)        AS p999FROM requests;
-- Усреднять перцентили серверов нельзя: сравните с p95 по всем запросамWITH per_server AS ( SELECT server, quantile_disc(response_ms, 0.95) AS p95 FROM requests GROUP BY server)SELECT (SELECT avg(p95) FROM per_server) AS avg_of_p95, (SELECT quantile_disc(response_ms, 0.95) FROM requests) AS true_p95;┌─────────┬───────┬───────┬───────┬───────┐│ mean_ms │ p50 │ p95 │ p99 │ p999 ││ double │ int64 │ int64 │ int64 │ int64 │├─────────┼───────┼───────┼───────┼───────┤│ 202.0 │ 143 │ 900 │ 900 │ 3000 │└─────────┴───────┴───────┴───────┴───────┘┌────────────┬──────────┐│ avg_of_p95 │ true_p95 ││ double │ int64 │├────────────┼──────────┤│ 547.0 │ 900 │└────────────┴──────────┘Среднее (202 ms) обещает быстрый сервис, хотя каждый двадцатый запрос ждёт 900 ms и дольше. Среднее из p95 двух серверов (547 ms) тоже врёт: настоящий p95 по всем запросам равен 900 ms.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему в примере с соцсетью
fan-outпри записи дешевле, чем сборка ленты при чтении? Когда этот подход ломается? - Чем время ответа отличается от времени обработки? Почему время ответа нужно мерить на стороне клиента?
- Почему среднее время ответа плохо описывает опыт пользователей, и почему Amazon смотрит на
p999, а не наp9999? - Чем
faultотличается отfailure? Зачем нарочно вызывать сбои в отказоустойчивой системе? - Почему ошибки в ПО опаснее сбоев железа, и почему винить человека в аварии бессмысленно?
- Когда
shared-nothingлучше вертикального масштабирования, а когда лучше остаться на одной машине?
Предыдущая: Компромиссы в архитектуре систем данных. Следующая: Модели данных и языки запросов.