

Designing Data-Intensive Applications, глава 6: Репликация
Главная мысль: Репликация хранит копию одних и тех же данных на нескольких машинах. Скопировать неизменные данные легко. Вся трудность в изменениях: в каком порядке их применять, что делать с отставшими репликами и как решать конфликты параллельных записей.
О чём глава
Заголовок раздела «О чём глава»Глава отвечает на вопрос, как держать одни и те же данные на нескольких узлах, связанных сетью, и не потерять их при сбоях. В предыдущей главе шла речь о том, как данные кодируют для передачи. Здесь они уже передаются между репликами. Пока авторы считают, что весь набор данных помещается на одну машину. Деление данных на части разбирает следующая глава.
Темы главы:
- зачем нужна репликация и чем она отличается от резервной копии;
- репликация с одним
leader: синхронная и асинхронная, новыйfollower,failover, форматыreplication log; - проблемы лага репликации и гарантии
read-after-write,monotonic reads,consistent prefix reads; - репликация с несколькими
leader: регионы,sync engine, конфликты записей, CRDT и OT; - репликация без
leader: кворумы,read repair, поиск параллельных записей,version vector.
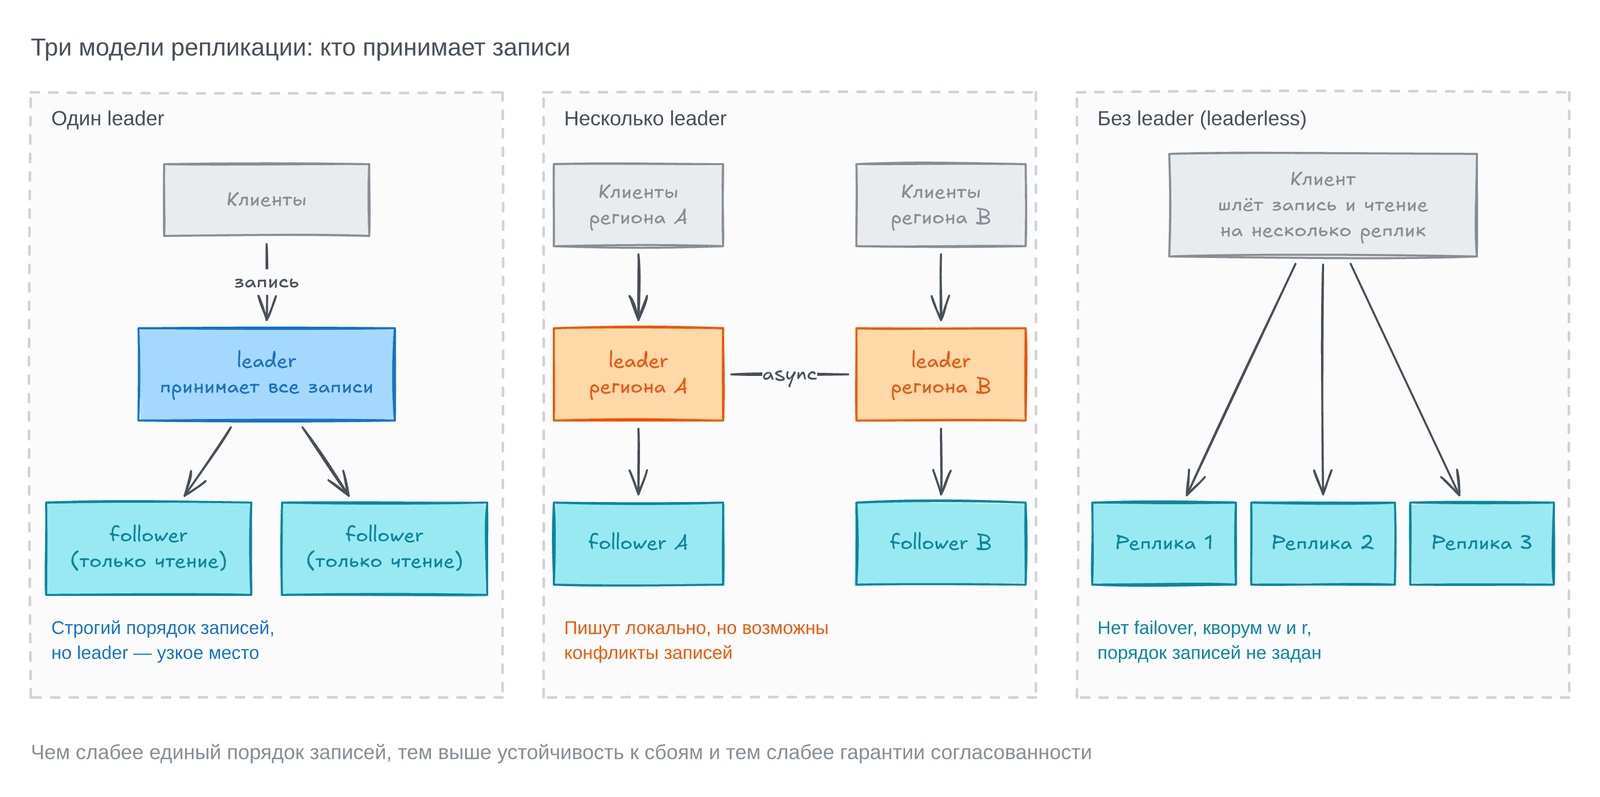
Схема показывает три семейства алгоритмов. Слева все записи идут через один узел. В центре каждый регион пишет в свой leader, а они асинхронно обмениваются изменениями. Справа клиент сам отправляет запрос на несколько равноправных реплик.
Зачем реплицировать данные
Заголовок раздела «Зачем реплицировать данные»Авторы называют три причины держать копии данных на нескольких машинах:
- держать данные географически ближе к пользователям, чтобы уменьшить задержку (
latency); - продолжать работу, когда часть системы сломалась, то есть повысить доступность и долговечность;
- добавить машины, которые обслуживают чтение, и так поднять
throughputчтения.
Неизменные данные достаточно один раз скопировать на каждый узел. Сложность появляется, когда данные меняются. Почти все распределённые базы используют одну из трёх схем: один leader, несколько leader или вовсе без leader. Выбор между синхронной и асинхронной репликацией в базах часто — просто настройка, но принципы у разных реализаций похожи. Они почти не изменились с 1970-х годов, потому что ограничения сети остались прежними.
Резервные копии и репликация
Заголовок раздела «Резервные копии и репликация»Бэкапы нужны и при репликации, потому что у них другая цель. Реплика быстро повторяет записи другого узла, а бэкап хранит старый снимок, чтобы вернуться в прошлое. Если по ошибке удалить данные, удаление дойдёт и до реплик. При этом механизмы дополняют друг друга: бэкап служит первым шагом при запуске нового follower, а архив replication log — частью резервного копирования. Старые снимки дешевле держать в объектном хранилище (object storage), а не на дорогом основном носителе.
Репликация с одним leader
Заголовок раздела «Репликация с одним leader»Узел, который хранит копию базы, называют репликой. Каждую запись должна обработать каждая реплика, иначе копии разойдутся. Самое частое решение называют репликацией с leader (а также primary-backup или active/passive). Она работает так:
- Одну реплику назначают
leader(другие названия:primary,source). Клиенты отправляют все записи на неё.Leaderсначала пишет новые данные в своё локальное хранилище. - Остальные реплики называют
follower(такжеread replica,secondary,hot standby). Каждое изменениеleaderотправляет им в видеreplication log, то есть потока изменений.Followerприменяет записи в том же порядке, в каком их обработалleader. - Читать можно с любой реплики. Но записи принимает только
leader: для клиентаfollowerдоступны только на чтение.
Если база поделена на shard (глава 7), у каждого shard свой leader. Лидеры разных shard могут жить на разных узлах.
Эта схема встроена в PostgreSQL, MySQL, Oracle Data Guard и SQL Server Always On. Её используют MongoDB, DynamoDB и Kafka. На одном leader основаны и алгоритмы консенсуса, например Raft в CockroachDB, TiDB и etcd: они сами выбирают новый leader, если старый упал (глава 10). Старый термин master–slave значит то же самое, но авторы советуют его не использовать.
Синхронная и асинхронная репликация
Заголовок раздела «Синхронная и асинхронная репликация»Пусть пользователь меняет фото профиля. При синхронной репликации leader ждёт, пока follower подтвердит запись, и только потом отвечает пользователю. При асинхронной leader отправляет изменение и не ждёт ответа. Обычно репликация занимает меньше секунды, но гарантии нет: после сбоя, при нагрузке на пределе или проблемах в сети follower может отстать на минуты.
| Режим | Плюс | Минус |
|---|---|---|
| Синхронный | У follower точно есть свежая копия. Если leader упадёт, данные не пропадут | Если follower не отвечает, leader блокирует все записи |
| Асинхронный | Leader пишет, даже если все follower отстали | Если leader упал безвозвратно, неотправленные записи теряются, хотя клиент получил «OK» |
Semi-synchronous | Один follower синхронный, остальные асинхронные: свежая копия есть минимум на двух узлах | Запись всё равно ждёт синхронный follower. Если он недоступен или тормозит, синхронным делают один из асинхронных |
Делать синхронными все follower нельзя: любой упавший узел остановит всю систему. Поэтому «синхронная репликация» обычно значит один синхронный follower. В некоторых системах синхронно обновляется большинство реплик, например три из пяти. Это пример кворума, к нему глава вернётся ниже. Полностью асинхронная схема ослабляет долговечность, но её используют очень широко, особенно когда follower много или они разбросаны по миру.
Новый follower
Заголовок раздела «Новый follower»Просто скопировать файлы на новый узел мало: клиенты всё время пишут, и копия захватит разные части базы в разные моменты, то есть будет несогласованной. Блокировать базу на время копирования тоже плохо. Поэтому follower запускают без простоя:
- Делают согласованный снимок (
snapshot) базыleaderбез блокировки, иногда внешним инструментом вроде Percona XtraBackup. - Копируют снимок на новый узел.
Followerзапрашивает уleaderвсе изменения после снимка. Поэтому снимок привязан к точной позиции вreplication log: в PostgreSQL этоlog sequence number, в MySQL —binlog coordinatesилиGTID.- Обработав накопленное,
followerдогналleaderи дальше получает изменения по мере появления.
Можно также архивировать replication log в объектное хранилище вместе с периодическими снимками. Это хороший способ делать бэкапы, а шаги 1 и 2 сводятся к скачиванию файлов. Так работают WAL-G для PostgreSQL, MySQL и SQL Server и Litestream для SQLite.
Базы поверх объектного хранилища
Заголовок раздела «Базы поверх объектного хранилища»Объектные хранилища (Amazon S3, Google Cloud Storage, Azure Blob Storage) всё чаще обслуживают и живые запросы. Плюсы такие:
- хранилище дешёвое, поэтому редкие данные лежат там, а рабочий набор — в памяти и на SSD;
- оно само реплицирует данные между зонами и регионами с очень высокой долговечностью;
- условная запись (операция вида
compare-and-set) позволяет строить на нём транзакции и выборleader; - данные разных баз в одном хранилище проще интегрировать, особенно в форматах Parquet и Iceberg.
Цена тоже есть. Задержка у объектного хранилища намного выше, чем у локального диска или Amazon EBS. За каждый вызов API берут плату, поэтому операции собирают в пакеты, а это ещё больше увеличивает задержку. Объекты часто неизменяемы, так что запись в середину большого объекта очень дорога. Файлового интерфейса обычно нет. FUSE позволяет подключить bucket как файловую систему, но часто не поддерживает нужные функции POSIX, например запись не по порядку или symlink.
Поэтому одни системы используют многоуровневое хранение (tiered storage): редкие данные в объектном хранилище, частые на SSD или в памяти. Другие пишут WAL в отдельную быструю систему, например Safekeepers в Neon. Самые радикальные переходят на zero-disk architecture (ZDA): все данные хранятся в объектном хранилище, а диски и память служат только кэшем. У узлов нет постоянного состояния, и эксплуатация сильно упрощается. Так устроены совместимые с Kafka WarpStream, Bufstream и Redpanda Serverless, а также почти все облачные хранилища данных (data warehouse).
Когда узлы падают
Заголовок раздела «Когда узлы падают»Узел может упасть внезапно или выключиться по плану, например для обновления ядра. Цель — чтобы система в целом работала, несмотря на сбои отдельных узлов.
Сбой follower: догоняющее восстановление
Заголовок раздела «Сбой follower: догоняющее восстановление»Follower хранит на диске журнал полученных изменений и знает, какую транзакцию обработал последней. После перезапуска он запрашивает у leader всё пропущенное и догоняет его. Но если запись идёт быстро или follower долго отсутствовал, догонять придётся долго, и нагрузка растёт на обоих узлах. Кроме того, leader может удалить журнал, только когда все follower его обработали. Если follower пропал надолго, leader выбирает: рисковать переполнением диска или удалить журнал, и тогда follower придётся восстанавливать из бэкапа.
Сбой leader: failover
Заголовок раздела «Сбой leader: failover»Сбой leader обработать сложнее. Один из follower повышают до нового leader, клиентов перенастраивают на него, а остальные follower начинают читать изменения у него. Этот процесс называют failover. Автоматический failover обычно состоит из трёх шагов:
- Понять, что
leaderупал. Причин много: сбой, отключение питания, проблемы сети. Надёжно узнать, что случилось, нельзя, поэтому системы используютtimeout: узел, который молчит, скажем, 30 секунд, считается мёртвым. - Выбрать новый
leader. Его выбирает большинство оставшихся реплик или назначает узел-контроллер. Лучший кандидат — реплика с самыми свежими изменениями. Договориться о новомleader— задача консенсуса (глава 10). - Перенастроить систему. Клиенты пишут новому
leader, а вернувшийся старыйleaderдолжен статьfollower, а не считать себя главным.
На каждом шаге что-то может пойти не так:
- При асинхронной репликации новый
leaderмог не получить часть записей старого. Чаще всего их просто выбрасывают. Значит, подтверждённые записи на деле не сохранились. - Это особенно опасно, если с базой связаны другие хранилища. В инциденте GitHub новым
leaderстал отстающийfollowerMySQL. Его счётчик автоинкремента отставал, и база повторно выдала уже использованные первичные ключи. Эти ключи жили и в Redis, поэтому часть приватных данных увидели не те пользователи. - При некоторых сбоях (глава 9) два узла считают себя
leader. Этоsplit brain: если оба принимают записи, данные теряются или портятся. Некоторые системы тогда выключают один узел, но при плохом механизме выключаются оба. А к моменту обнаружения данные могут быть уже испорчены. - Трудно выбрать
timeout. Длинный продлевает восстановление. Короткий вызывает лишниеfailoverпри всплеске нагрузки или задержке пакетов, и перегруженной системе становится только хуже.
Защиту от split brain через ограничение старого leader называют fencing (глава 9). Простых решений нет, поэтому часть команд делает failover вручную, даже если база умеет автоматический. Главное — повысить самый свежий follower: при semi-synchronous репликации это тот, кого ждал leader, при асинхронной — тот, у кого больше log sequence number. Потеря долей секунды записей терпима, а отставание на дни приведёт к катастрофе.
Как устроен replication log
Заголовок раздела «Как устроен replication log»Есть несколько способов передавать изменения от leader к follower.
Репликация операторов (statement-based). Leader записывает в журнал каждый выполненный оператор INSERT, UPDATE или DELETE и пересылает его. Каждый follower разбирает и выполняет SQL так, будто его прислал клиент. Звучит разумно, но ломается в нескольких случаях:
- недетерминированные функции вроде
NOW()иRAND()дают на каждой реплике своё значение; - операторы с автоинкрементом или зависящие от данных (
UPDATE … WHERE …) нужно выполнять строго в одном порядке, а это мешает параллельным транзакциям; - побочные эффекты триггеров, хранимых процедур и пользовательских функций могут отличаться на разных репликах.
Эти проблемы можно обойти: например, ещё до отправки подставлять вместо NOW() готовое значение. Выполнять детерминированные операторы в фиксированном порядке — та же идея, что event sourcing из главы 3, её называют state machine replication. MySQL реплицировал операторы до версии 5.1, а теперь при любой недетерминированности переключается на построчную репликацию. VoltDB требует детерминированных транзакций. На практике детерминизм трудно гарантировать, поэтому многие базы выбирают другие способы.
Передача WAL (WAL shipping). В write-ahead log (глава 4) есть всё, чтобы восстановить индексы и таблицы. Значит, тот же журнал можно отправить по сети, и follower соберёт точную копию файлов leader. Так работают PostgreSQL и Oracle. Минус в том, что WAL описывает, какие байты в каких блоках диска поменялись. Репликация жёстко привязана к движку хранения, и на leader и follower обычно нельзя запустить разные версии базы. Это важно для эксплуатации. Если follower может работать на более новой версии, базу обновляют без простоя: сначала follower, затем failover на один из них. С WAL shipping обновление обычно требует простоя.
Логическая (построчная) репликация (logical log). Здесь формат журнала отделён от устройства движка. Для реляционной базы это записи на уровне строк:
- для вставленной строки — новые значения всех столбцов;
- для удалённой — данные, чтобы однозначно найти строку: обычно первичный ключ, а без него старые значения всех столбцов;
- для обновлённой — данные для поиска строки и новые значения всех (или только изменённых) столбцов.
Транзакция, которая меняет несколько строк, даёт несколько таких записей и затем запись о commit. MySQL в режиме построчной репликации ведёт отдельный логический журнал, binlog, в дополнение к WAL. PostgreSQL декодирует физический WAL в события вставки, обновления и удаления строк.
Логический журнал не зависит от движка, поэтому его легче сохранять обратно совместимым. Leader и follower могут работать на разных версиях, и обновление проходит почти без простоя. Ещё его легко разбирать внешним программам. Так содержимое базы отправляют в хранилище данных для аналитики, в отдельные индексы и кэши. Этот приём называют change data capture (CDC), к нему книга вернётся в главе 12.
Проблемы лага репликации
Заголовок раздела «Проблемы лага репликации»Реплицируют не только ради отказоустойчивости, но и ради масштаба и задержки. Если запросы в основном читают, удобно завести много follower и раздавать чтение между ними, в том числе с ближайшей реплики. Такая схема работает только с асинхронной репликацией: синхронная запись на все follower остановится при сбое любого узла.
Но асинхронный follower может вернуть устаревшие данные, и один и тот же запрос к leader и к follower даст разные ответы. Если перестать писать и подождать, follower догонят leader. Поэтому эффект называют eventual consistency — согласованность, которая наступит со временем. Термин стал лозунгом многих NoSQL-проектов, но асинхронные follower реляционной базы ведут себя так же.
Слово «eventually» намеренно расплывчато: предела отставания нет. Задержку между записью на leader и её появлением на follower называют лагом репликации (replication lag). Обычно это доли секунды, но при нагрузке или проблемах в сети лаг растёт до минут. Тогда несогласованность становится реальной проблемой. Авторы разбирают три типичных аномалии.
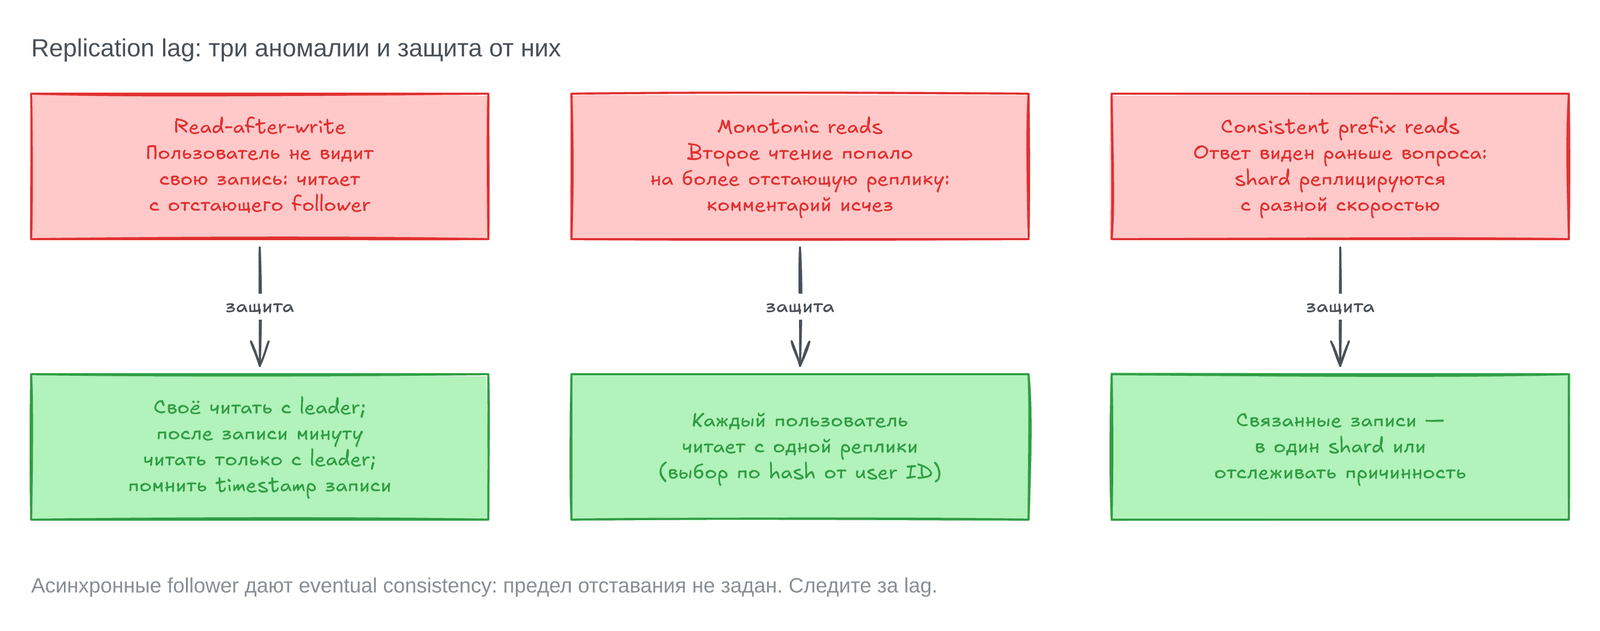
На схеме сверху аномалии, снизу способы защиты. Подробности каждой — в разделах ниже.
Чтение своих записей
Заголовок раздела «Чтение своих записей»Пользователь оставляет комментарий и сразу хочет его увидеть. Запись идёт на leader, а чтение может уйти на follower, куда данные ещё не дошли. Пользователю кажется, что его комментарий потерялся.
Здесь нужна гарантия read-after-write (её также называют read-your-writes): после перезагрузки страницы пользователь всегда видит свои изменения. Про чужие изменения она ничего не обещает. Способы её дать:
- Читать с
leaderто, что пользователь мог изменить. Для этого нужно знать заранее, что могло измениться. Например, профиль в соцсети редактирует только владелец. Простое правило: свой профиль читать сleader, чужие — сfollower. - Ограничить по времени. Если менять можно почти всё, предыдущий способ отправит на
leaderпочти все чтения. Тогда можно минуту после последней записи читать только сleader. Или следить за лагом и не читать сfollower, который отстал больше чем на минуту. - Запомнить timestamp последней записи. Клиент хранит его, а система следит, чтобы реплика для чтения была не старше. Если реплика отстала, чтение уходит на другую или ждёт. Timestamp может быть логическим (например,
log sequence number) или временем системных часов, и тогда критична синхронизация часов (глава 9). - Учесть регионы. Если реплики стоят в разных регионах, запрос, который должен обслужить
leader, надо направить в регион сleader.
Сложнее, если пользователь заходит с ноутбука и телефона. Код на одном устройстве не знает об изменениях на другом, поэтому timestamp последней записи придётся хранить централизованно. К тому же домашний интернет и мобильная сеть могут привести устройства в разные регионы. Если нужно читать с leader, запросы со всех устройств пользователя сначала направляют в один регион.
Регионы и зоны доступности
Заголовок раздела «Регионы и зоны доступности»Регион — это один или несколько дата-центров в одном географическом месте. Каждый дата-центр в регионе называют зоной доступности (availability zone): у него своё здание, питание и охлаждение. Зоны связаны быстрой сетью, и система на нескольких зонах работает почти как на одной. Несколько зон спасают от отказа зоны, но не всего региона. Для этого нужны несколько регионов, а это большая задержка, меньший throughput и больший счёт за сеть.
Монотонное чтение
Заголовок раздела «Монотонное чтение»Вторая аномалия: время идёт назад. Пользователь 2345 дважды выполняет один запрос. Первый раз он попадает на follower с малым лагом и видит свежий комментарий пользователя 1234. Второй раз запрос уходит на сильно отстающий follower, и комментарий исчезает. Так бывает, если каждое обновление страницы попадает на случайный сервер.
Гарантия monotonic reads защищает от этого. Она сильнее eventual consistency, но слабее строгой согласованности: старое значение прочитать можно, но не после более нового. Простой способ — чтобы пользователь всегда читал с одной реплики, выбранной по hash от user ID. Если реплика упадёт, запросы перенаправят на другую.
Согласованный префикс
Заголовок раздела «Согласованный префикс»Третья аномалия нарушает причинность. Мистер Пунс спрашивает: «Как далеко в будущее вы видите, миссис Кейк?» Она отвечает: «Обычно секунд на десять». Третий человек слушает разговор через реплики базы. Слова миссис Кейк доходят до него с малым лагом, а слова мистера Пунса — с большим. Поэтому он услышит ответ раньше вопроса.
Гарантия consistent prefix reads говорит: если записи произошли в некотором порядке, читатель увидит их в том же порядке. Проблема особенно остра в базах, поделённых на shard: разные части базы часто работают независимо, и общего порядка записей нет. Одно решение — писать причинно связанные записи в один shard, но это не всегда эффективно. Другие алгоритмы явно отслеживают причинность, о них ниже в разделе о happens-before.
Решения для лага репликации
Заголовок раздела «Решения для лага репликации»Стоит заранее подумать, что будет, если лаг вырастет до минут или часов. Если это навредит пользователям, нужна более сильная гарантия, например read-after-write. Делать вид, что асинхронная репликация синхронная, — верный путь к проблемам.
Приложение может само читать часть данных с leader, но такой код сложен, и в нём легко ошибиться. Проще выбрать базу с сильной согласованностью, такой как linearizability (глава 10), и с ACID-транзакциями (глава 8). Тогда с базой можно работать почти как с одним узлом. В начале 2010-х сторонники NoSQL утверждали, что эти свойства мешают масштабированию. С тех пор появились базы NewSQL, которые дают и транзакции, и масштаб. И всё же у слабых гарантий есть плюсы: такие системы лучше переносят разрывы сети и дешевле. Им посвящена остальная часть главы.
Репликация с несколькими leader
Заголовок раздела «Репликация с несколькими leader»Главный минус одного leader: если до него нельзя достучаться, писать в базу нельзя. Естественное расширение — разрешить принимать записи нескольким узлам. Это называют репликацией с несколькими leader (multi-leader, active/active). Каждый leader пересылает изменения остальным и одновременно служит follower для них.
Синхронная репликация между leader по сути равна схеме с одним leader: при разрыве сети писать нельзя. Поэтому дальше речь только об асинхронном варианте, где каждый leader принимает записи даже без связи с остальными.
Работа в нескольких регионах
Заголовок раздела «Работа в нескольких регионах»Внутри одного региона несколько leader редко оправданы. Но если реплики стоят в нескольких регионах, это уже разумно. Тогда в каждом регионе свой leader с обычными follower, а между регионами leader обмениваются изменениями. Авторы сравнивают два подхода:
| Свойство | Один leader | Несколько leader |
|---|---|---|
| Скорость | Каждая запись идёт через интернет в регион с leader, это добавляет задержку | Запись обрабатывается в своём регионе, а реплицируется асинхронно. Задержка между регионами скрыта от пользователя |
| Отказ региона | Failover повышает follower в другом регионе | Каждый регион работает сам, репликация догонит, когда регион вернётся |
| Проблемы сети | Очень чувствителен: клиент ждёт ответа через канал между регионами | Переносит лучше: при разрыве каждый leader продолжает принимать записи |
| Согласованность | Может дать сильные гарантии, например serializability (глава 8) | Гарантии намного слабее |
Последний пункт — главный минус. Нельзя гарантировать, что баланс не уйдёт в минус или что имя пользователя уникально: два leader могут принять записи, каждая из которых корректна, а вместе они нарушают ограничение. Это фундаментальное ограничение распределённых систем. Если такие правила нужны, лучше взять один leader.
Несколько leader поддерживают MySQL, Oracle, SQL Server, YugabyteDB, а также дополнения вроде EDB Postgres Distributed и pglogical. Во многих базах эту функцию добавили позже, и плохо работают автоинкремент, триггеры и ограничения целостности. Поэтому такую репликацию часто считают опасной территорией, которой лучше избегать.
Топологии репликации
Заголовок раздела «Топологии репликации»Топология описывает, по каким путям записи идут между узлами. С двумя leader вариант один. С большим числом бывают три схемы:
- все со всеми (
all-to-all): каждыйleaderшлёт записи каждому; - по кругу (
circular): узел получает записи от соседа и пересылает их вместе со своими следующему; - звезда (
star): корневой узел пересылает записи всем остальным; она не связана соstar schema.
В круге и звезде запись проходит через несколько узлов. Чтобы не было бесконечных циклов, запись помечают идентификаторами всех узлов, которые она прошла, и узел игнорирует запись со своим идентификатором. Зато отказ одного узла рвёт поток сообщений, пока топологию не перестроят, обычно вручную. All-to-all надёжнее, потому что у сообщений много путей.
Но и в all-to-all одни каналы быстрее других, и сообщения обгоняют друг друга. Клиент A вставляет строку на leader 1, клиент B обновляет её на leader 3. Leader 2 может получить обновление раньше вставки. Это снова проблема причинности. Timestamp не поможет, потому что часам нельзя доверять (глава 9). Нужны version vector, они разобраны в конце главы. Многие системы этого не умеют, поэтому авторы советуют читать документацию и тщательно тестировать базу.
Sync engine и local-first приложения
Заголовок раздела «Sync engine и local-first приложения»Несколько leader нужны и приложению, которое работает без интернета, например календарю на телефоне и ноутбуке. Каждое устройство держит локальную реплику, которая служит leader, а между устройствами идёт асинхронная синхронизация. Лаг может длиться часы и дни. По сути это схема с регионами, доведённая до крайности: каждое устройство — «регион» с очень ненадёжной сетью.
Совместная работа, offline-first и local-first
Заголовок раздела «Совместная работа, offline-first и local-first»Google Docs, Figma и Linear позволяют работать вместе в реальном времени. Ввод сразу виден в интерфейсе без запроса к серверу, а правки коллег приходят с малой задержкой. Каждая вкладка браузера с открытым файлом — реплика, поэтому это тоже multi-leader, даже без офлайн-режима.
Приложение отслеживает изменения пользователя и отправляет их сразу или сохраняет на потом. Оно же получает чужие изменения, сливает их с локальной копией и разрешает конфликты. Библиотеку для этого называют sync engine. Приложение, которое работает офлайн, называют offline-first. Local-first — это совместное приложение, которое работает даже после того, как разработчик закрыл свои онлайн-сервисы. Для этого нужен открытый протокол синхронизации с разными провайдерами. Пример — Git: синхронизироваться можно через GitHub, GitLab или любой другой хостинг.
Плюсы и минусы sync engine
Заголовок раздела «Плюсы и минусы sync engine»С sync engine состояние хранится на клиенте, а общение с сервером уходит в фон. Плюсы такие:
- интерфейс отвечает намного быстрее, иногда за один кадр, то есть за 16 ms на экране 60 Гц;
- отдельный офлайн-режим не нужен: отсутствие сети — это просто очень большая задержка;
- код фронтенда проще, потому что чтение и запись в локальные данные почти никогда не падают;
- вместе с реактивной моделью программирования легко показывать чужие правки в реальном времени.
Минус: все нужные данные надо заранее скачать на клиент. Файлы одного пользователя скачать можно, а весь каталог интернет-магазина — нет. Первым sync engine была Lotus Notes в 1980-х. Сегодня одни движки используют закрытый бэкенд (Google Firestore, Realm), другие открыты и подходят для local-first (PouchDB/CouchDB, Automerge, Yjs).
Конфликты записей
Заголовок раздела «Конфликты записей»Главная проблема нескольких leader — конфликты параллельных записей. Два пользователя одновременно правят страницу вики: первый меняет заголовок с A на B, второй — с A на C. Каждый leader принимает свою правку, а при репликации обнаруживается конфликт.
Записи называют параллельными (concurrent), если ни одна не «знала» о другой. Совпадение по времени не важно: офлайн-правки могли случиться с большим разрывом. Как база это определяет, разобрано в конце главы. Пока считаем, что конфликт найден.
Избегать конфликтов
Заголовок раздела «Избегать конфликтов»Лучше всего не допускать конфликтов. Если все записи одной строки идут через один leader, конфликта не будет. Для офлайн-клиента это невозможно, а для серверов в нескольких регионах иногда возможно. Например, если пользователь правит только свои данные, его запросы направляют в «домашний» регион. Но подход ломается, когда домашний регион меняют, например при отказе региона. Другой пример: один leader выдаёт только нечётные ID, другой — только чётные, и одинаковых ID не будет.
Last write wins
Заголовок раздела «Last write wins»Проще всего снабдить каждую запись timestamp и оставлять значение с самым большим. При равных timestamp победителя выбирают, сравнивая значения. Это называют last write wins (LWW). Название обманчиво: для параллельных записей «последняя» не определена. На деле одна запись случайно побеждает, а остальные молча выбрасываются, хотя их leader успешно приняли. Реплики сходятся, но ценой потери данных.
LWW безопасен, когда записи только вставляются с уникальным ключом и не меняются. Иначе нужно решить, допустим ли lost update. Ещё одна беда: при использовании системных часов узел, у которого часы спешат, «перебьёт» более позднюю запись. Это решают логические часы (глава 10).
Ручное разрешение конфликтов
Заголовок раздела «Ручное разрешение конфликтов»Можно разрешать конфликт вручную, как merge conflict в Git. Останавливать репликацию до решения человека непрактично, поэтому база хранит все параллельные значения, здесь B и C. Их называют siblings. При чтении база возвращает их все, а приложение сливает их само (например, в «B/C») или спрашивает пользователя. Так работает CouchDB. Проблемы подхода:
- меняется API: заголовок был строкой, а стал набором строк, с которым неудобно работать в коде;
- ручное слияние — большая работа для разработчика и непонятная задача для пользователя;
- автоматическое слияние даёт сюрпризы: корзина Amazon сливала
siblingsобъединением множеств, и удалённый на одном устройстве товар возвращался из другой версии; - если несколько узлов разрешают конфликт параллельно, они могут получить «B/C» и «C/B», а их слияние даст «B/C/C/B».
Автоматическое разрешение конфликтов
Заголовок раздела «Автоматическое разрешение конфликтов»Для многих приложений лучше алгоритм, который сам сливает параллельные записи. Он гарантирует, что реплики с одним набором записей придут к одному состоянию при любом порядке прихода. Eventual consistency с такой гарантией называют strong eventual consistency. LWW — простейший такой алгоритм, а более сложные стараются не терять данные:
- текст: сохраняют все вставки и удаления символов из всех
siblings; - коллекции: тоже отслеживают вставки и удаления, поэтому удалённый товар не вернётся в корзину;
- счётчик: складывают увеличения и уменьшения с каждого
siblingбез двойного счёта; - словарь: значения одного ключа сливают одним из способов выше, разные ключи — независимо.
Возможности не безграничны: если в списке должно быть не больше пяти элементов, лишние придётся выбросить. Но для offline-first и local-first приложений автоматика обычно лучший выбор.
CRDT и operational transformation
Заголовок раздела «CRDT и operational transformation»Автоматическое слияние строят на двух семействах алгоритмов: CRDT (conflict-free replicated datatypes) и OT (operational transformation). Пример: две реплики начинают с текста ice. Одна добавляет в начало n, другая в конец !. Оба алгоритма дают nice!, но разными путями.
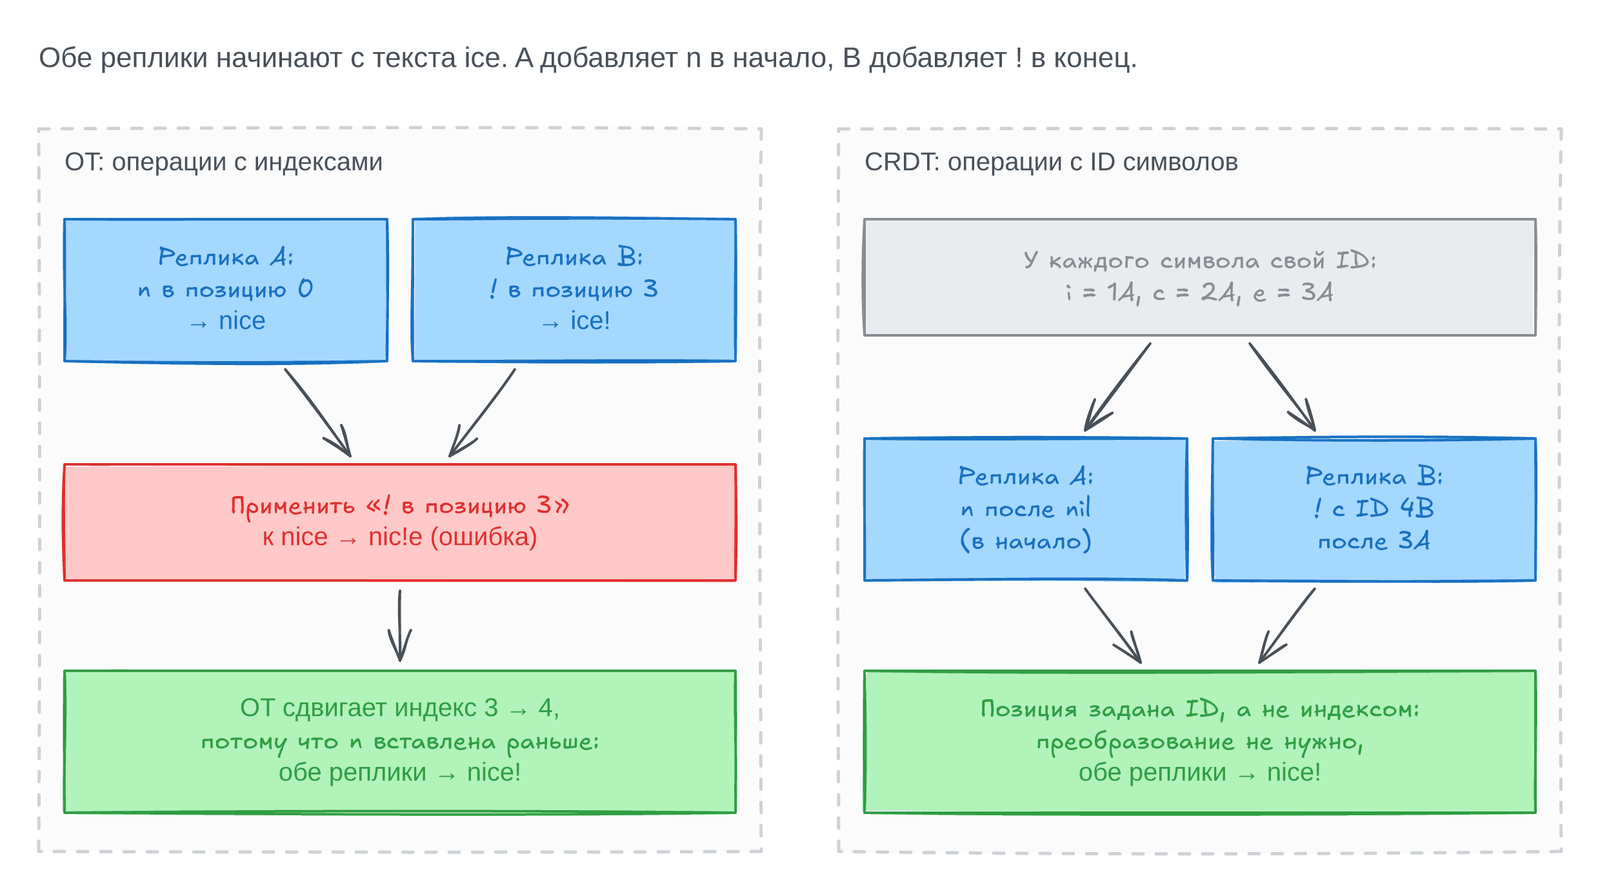
- OT записывает индекс вставки:
nв позицию 0,!в позицию 3. Реплики обмениваются операциями. Вставкуnможно применить как есть. А если применить «!в позицию 3» кnice, получитсяnic!e. Поэтому OT преобразует индекс с учётом уже применённых параллельных операций: вставка!сдвигается на позицию 4. - CRDT даёт каждому символу уникальный неизменяемый ID:
i— 1A,c— 2A и так далее. Операция вставки содержит ID нового символа (для!это 4B) и ID символа, после которого вставлять (3A). Для вставки в начало вместо предыдущего ID указываютnil. Одновременные вставки в одно место упорядочивают по ID. Реплики сходятся без всяких преобразований.
Те же идеи работают и для списков, массивов и словарей. Есть и алгоритмы, которые сочетают плюсы OT и CRDT. OT чаще используют для совместного редактирования текста, например в Google Docs. CRDT встречаются в Redis Enterprise, Riak и Azure Cosmos DB. Sync engine для JSON строят и на CRDT (Automerge, Yjs), и на OT (ShareDB).
Виды конфликтов
Заголовок раздела «Виды конфликтов»Некоторые конфликты очевидны: две записи меняют одно поле на разные значения. Другие заметить труднее. В системе бронирования переговорных каждая бронь — новая строка, и одну комнату нельзя занять дважды на одно время. Даже если приложение проверяет, свободна ли комната, две одновременные проверки увидят её свободной, и обе брони запишутся. Готового ответа нет: к таким конфликтам книга вернётся в главах 8 и 13.
Репликация без leader
Заголовок раздела «Репликация без leader»В схемах с leader именно он задаёт порядок записей. Некоторые системы отказываются от leader и разрешают любой реплике принимать записи. Идея снова вошла в моду после системы Dynamo от Amazon (2007). Riak, Cassandra и ScyllaDB построены по её образцу, поэтому такие базы называют Dynamo-style. Облачная DynamoDB, несмотря на похожее имя, устроена иначе: у неё один leader на основе консенсуса Multi-Paxos. Запись на несколько реплик шлёт сам клиент или узел-координатор. Но координатор, в отличие от leader, не задаёт порядок записей.
Запись, когда узел недоступен
Заголовок раздела «Запись, когда узел недоступен»Пусть в базе три реплики, и одна перезагружается. Без leader failover не нужен: все реплики равны. Клиент (пользователь 1234) шлёт запись на все три реплики параллельно, две её принимают. Если для успеха хватает двух «OK», клиент считает запись успешной. Потом третий узел возвращается, но записей за время простоя на нём нет.
Поэтому чтение тоже отправляют на несколько узлов. Чтобы понять, какой ответ свежее, каждое значение помечают номером версии или timestamp. Клиент берёт значение с самой большой версией, даже если его вернула одна реплика.
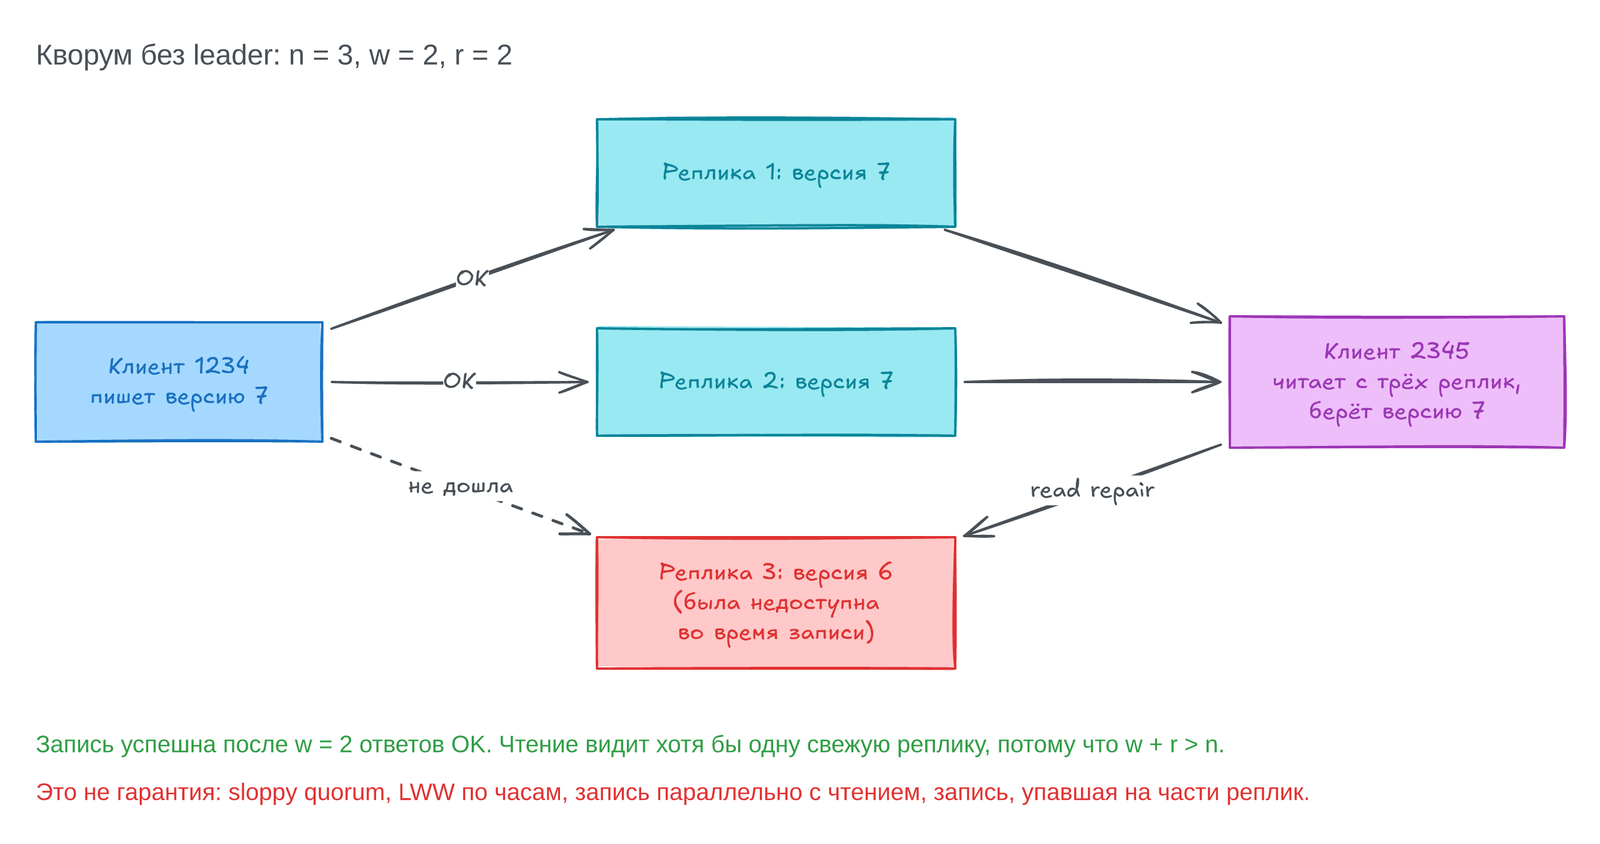
Схема показывает и запись, и чтение. Запись не дошла до реплики 3, но двух «OK» хватило. Читающий клиент увидел на ней версию 6 и сам записал туда версию 7.
Как реплика догоняет пропущенное
Заголовок раздела «Как реплика догоняет пропущенное»Система должна в итоге скопировать все данные на каждую реплику. В Dynamo-style хранилищах для этого есть три механизма:
Read repair. Клиент, читая с нескольких узлов, замечает устаревший ответ: например, версию 6 с реплики 3 и версию 7 с реплик 1 и 2. Он записывает новое значение на устаревшую реплику. Это хорошо работает для часто читаемых значений.Hinted handoff. Пока реплика недоступна, другая хранит за неё записи в виде подсказок (hints). Когда реплика вернётся, ей передают подсказки и удаляют их. Так догоняются и значения, которые никто не читает.Anti-entropy. Фоновый процесс ищет различия между репликами и копирует недостающее. В отличие отreplication log, он копирует записи в произвольном порядке и может сильно запаздывать.
Кворум для чтения и записи
Заголовок раздела «Кворум для чтения и записи»Если каждая успешная запись есть минимум на двух репликах из трёх, при чтении с двух хотя бы одна будет свежей. В общем виде: есть n реплик, запись успешна после подтверждения w узлами, чтение опрашивает минимум r узлов. Пока w + r > n, среди прочитанных узлов есть свежий. Такие чтения и записи называют кворумными, а w и r — минимальным числом «голосов».
Обычно n нечётное (3 или 5), а w = r = (n + 1) / 2 с округлением вверх. При редкой записи и частом чтении можно взять w = n и r = 1: чтение быстрее, но один упавший узел остановит все записи. При n = 3, w = 2, r = 2 система переживает отказ одного узла, при n = 5, w = 3, r = 3 — двух. В кластере может быть больше n узлов, но каждое значение хранится на n из них: так данные делят на shard (глава 7).
Запросы отправляют на все n реплик, а w и r задают, сколько ответов ждать. Если доступно меньше, операция возвращает ошибку. Причина недоступности не важна, важно лишь, вернул ли узел успешный ответ.
Пределы кворумной согласованности
Заголовок раздела «Пределы кворумной согласованности»Кворум не обязан быть большинством: важно лишь, чтобы узлы чтения и записи пересекались хотя бы в одном. Большинство берут потому, что тогда система переживает отказ до n / 2 узлов с округлением вниз. Можно взять и w + r ≤ n. Тогда шанс устаревшего чтения выше, зато задержка ниже, а при разрыве сети больше шансов продолжить работу.
Даже при w + r > n есть пограничные случаи:
- узел с новым значением упал, его восстановили с реплики со старым значением, и реплик с новым значением стало меньше
w; - во время
rebalancing(глава 7) узлы по-разному видят, где лежатnреплик значения, и кворумы чтения и записи перестают пересекаться; - чтение идёт одновременно с записью и может увидеть или не увидеть новое значение; бывает, что одно чтение видит новое значение, а следующее — старое (глава 10);
- запись прошла на части реплик, но меньше чем на
w, например потому что кончились диски; её не откатывают, и последующие чтения могут вернуть или не вернуть это значение; - база выбирает новую запись по системным часам (так делают Cassandra и ScyllaDB), и запись может молча пропасть, если узел с более быстрыми часами записал тот же ключ;
- две параллельные записи на разных репликах применяются в разном порядке, и возникает конфликт, как с несколькими
leader.
Так что кворум лишь выглядит гарантией свежего чтения. Dynamo-style базы рассчитаны на задачи, которым хватает eventual consistency. Параметры w и r меняют вероятность устаревшего чтения, но не дают абсолютной гарантии.
Мониторинг устаревания
Заголовок раздела «Мониторинг устаревания»Даже если приложение терпит устаревшее чтение, сильное отставание должно вызывать алерт. С leader лаг измерить легко: записи применяются в одном порядке, и позиция follower в replication log, вычтенная из позиции leader, и есть лаг. Без leader порядка нет, и мониторить труднее. Число подсказок hinted handoff может служить признаком здоровья, но его трудно толковать. А для эксплуатации важно измерить, сколько на деле длится это «со временем».
Скорость: один leader против leaderless
Заголовок раздела «Скорость: один leader против leaderless»Чтение с leader свежее, но у него три проблемы:
throughputчтения ограничен мощностьюleader;- при отказе
leaderнадо ждатьfailover, и даже быстрыйfailoverпользователи заметят; - если
leaderтормозит от перегрузки, это сразу видят пользователи.
Без leader медленная или упавшая реплика почти не влияет на время ответа: запросы и так идут на несколько реплик, и клиент берёт ответы самых быстрых. Этот приём называют request hedging, он заметно снижает tail latency. Суть в том, что система без leader не различает обычный режим и режим сбоя. Это особенно полезно при gray failure, когда узел не упал, а работает очень медленно. Системе с leader пришлось бы решать, не пора ли делать failover, который сам может навредить.
Но и у систем без leader есть проблемы:
hinted handoffнагружает реплики как раз тогда, когда системе и так тяжело;- чем больше кворум, тем выше шанс наткнуться на медленную реплику, поэтому на практике кворум редко больше 4 из 7 или 5 из 9;
- крупный разрыв сети может не дать собрать кворум. Некоторые базы тогда разрешают писать на любую доступную реплику, даже не из набора для этого ключа. Riak и Dynamo называют это
sloppy quorum, Cassandra и ScyllaDB — уровнемANY. Чтение может не увидеть такую запись, но иногда это лучше ошибки.
Несколько leader переносят разрывы сети ещё лучше, но чтение там может отставать сколько угодно. Кворумы дают компромисс: хорошую отказоустойчивость и высокую вероятность свежего чтения.
Работа в нескольких регионах
Заголовок раздела «Работа в нескольких регионах»Репликация без leader подходит и для нескольких регионов. В Cassandra и ScyllaDB клиент шлёт запись координатору в своём регионе. Тот отправляет её всем репликам своего региона и одной реплике в каждом другом, а та пересылает её остальным репликам своего региона. Так запрос между регионами идёт только один раз. Уровень согласованности задаёт, где нужен кворум: по всем регионам, в каждом регионе или только в своём. Локальный кворум быстрее, но чаще возвращает устаревшие данные. Riak держит n реплик внутри одного региона, а между регионами реплицирует асинхронно, как с несколькими leader.
Поиск параллельных записей
Заголовок раздела «Поиск параллельных записей»Базы без leader тоже допускают параллельные записи в один ключ. Конфликт находят сразу или позже, при read repair, hinted handoff или anti-entropy. Из-за задержек сети и частичных отказов события приходят на узлы в разном порядке. Пусть клиенты A и B одновременно пишут ключ X в три узла:
- узел 1 получает запись A, а запись B до него не доходит из-за сбоя;
- узел 2 получает сначала A, потом B;
- узел 3 получает сначала B, потом A.
Если каждый узел просто перезаписывает значение, узлы разойдутся навсегда: узел 2 считает, что X = B, а остальные — что X = A. Чтобы сойтись, нужен один из способов разрешения конфликтов: LWW (Cassandra, ScyllaDB), ручное разрешение или CRDT (Riak). LWW реализовать легко, но timestamp не говорит, были ли записи параллельны или шли одна за другой. Чтобы разрешать конфликты явно, систему надо научить находить параллельные записи.
Отношение happens-before и параллельность
Заголовок раздела «Отношение happens-before и параллельность»Как понять, параллельны ли две операции? Вставка и обновление строки из примера про топологии не параллельны: B обновляет значение, которое вставил A, значит, операция B построена на A и случилась позже. Говорят, что B причинно зависит от A. А две записи в ключ X параллельны: каждый клиент не знает, что другой тоже пишет этот ключ.
Операция A случилась раньше (happens-before) операции B, если B знает об A, зависит от неё или как-то на ней построена. Две операции параллельны, если ни одна не случилась раньше другой. Значит, вариантов три: A раньше B, B раньше A, или они параллельны. Нужен алгоритм, который это определяет. Если одна операция раньше, поздняя перезаписывает раннюю. Если они параллельны, есть конфликт, который надо разрешить.
Буквальное совпадение по времени не важно, тем более что в распределённой системе его трудно установить из-за часов (глава 9). Эту идею сравнивают с теорией относительности: далёкие события не могут повлиять друг на друга, если свет не успел дойти. В компьютерах операции бывают параллельными, даже если свет успел бы: медленная сеть не дала одной операции узнать о другой.
Как отследить happens-before
Заголовок раздела «Как отследить happens-before»Сначала возьмём базу с одной репликой, а потом обобщим на несколько. Алгоритм такой:
- сервер хранит для каждого ключа номер версии, увеличивает его при каждой записи и хранит вместе со значением;
- при чтении сервер возвращает все
siblings(значения, которые ещё не перезаписаны) и последний номер версии; перед записью клиент обязан прочитать ключ; - при записи клиент передаёт номер версии из прошлого чтения и сливает все полученные значения в одно, например через CRDT. Ответ на запись тоже возвращает все
siblings, так что записи идут цепочкой; - получив запись с номером версии, сервер перезаписывает все значения с этой версией и ниже (клиент их уже слил), но оставляет значения с большей версией: они параллельны новой записи.
Сервер определяет параллельность только по номерам версий и не разбирает само значение, так что значение может быть любой структурой. Номер версии в записи говорит, на каком состоянии она основана. Запись без номера версии параллельна всем остальным: она ничего не перезапишет и просто станет ещё одним sibling.
Пример авторов: два клиента параллельно добавляют товары в одну корзину (если это кажется слишком простым, представьте двух авиадиспетчеров, которые добавляют самолёты в свой сектор). Корзина сначала пуста, клиенты делают пять записей. Наш скрипт повторяет этот пример с другими товарами. Главная часть — метод записи на сервере:
def write(self, value, based_on): # значения с версией <= based_on клиент уже видел и слил в value self.siblings = {v: val for v, val in self.siblings.items() if v > based_on} self.version += 1 self.siblings[self.version] = value return dict(self.siblings), self.versionПолный код: scripts/ddia-code/ch06_cart_versions.py. Вывод: после каждой записи видно, какие siblings остались на сервере.
1. клиент 1 пишет [молоко] на основе v0 -> v1: молоко2. клиент 2 пишет [яйца] на основе v0 -> v1: молоко; v2: яйца3. клиент 1 пишет [молоко, мука] на основе v1 -> v2: яйца; v3: молоко, мука4. клиент 2 пишет [молоко, яйца, ветчина] на основе v2 -> v3: молоко, мука; v4: молоко, яйца, ветчина5. клиент 1 пишет [яйца, молоко, мука, бекон] на основе v3 -> v4: молоко, яйца, ветчина; v5: яйца, молоко, мука, беконНа шаге 2 клиент 2 не знал о молоке, поэтому у сервера два sibling. На шаге 3 клиент 1 пишет на основе версии 1: сервер заменяет v1, но оставляет v2 с яйцами. На шагах 4 и 5 каждый клиент сливает то, что получил, и добавляет свой товар. Клиенты ни разу не видят полностью свежих данных, потому что всё время идёт параллельная операция. Но старые версии в итоге перезаписываются, и ни одна запись не теряется.
Version vectors
Заголовок раздела «Version vectors»В примере была одна реплика. Без leader записи принимают несколько реплик параллельно, и одного номера версии мало. Нужен номер версии на каждую реплику и на каждый ключ. Каждая реплика увеличивает свой номер при записи и помнит номера, которые видела от других. По ним она решает, какие значения перезаписать, а какие оставить как siblings. Набор номеров версий всех реплик называют version vector. Самый интересный вариант — dotted version vector в Riak 2.0, он работает очень похоже на пример с корзиной.
Как и номера версий, version vector база отдаёт клиенту при чтении, а клиент возвращает его при записи. Riak кодирует его строкой и называет causal context. По version vector база отличает перезапись от параллельной записи. Он же делает безопасным чтение с одной реплики и запись в другую: могут появиться siblings, но если их правильно слить, данные не потеряются.
Version vector иногда называют vector clock, хотя это не совсем одно и то же. Разница тонкая, но для сравнения состояний реплик правильная структура — именно version vector.
Итоги главы
Заголовок раздела «Итоги главы»- Репликация служит пяти целям: высокой доступности, долговечности, работе без сети, низкой задержке и масштабированию чтения.
- Бэкапы нужны и при репликации: реплика повторяет удаление, а бэкап позволяет вернуться в прошлое.
- С одним
leaderвсе записи идут через один узел, который рассылает поток измененийfollower; схема популярна, потому что её легко понять и она даёт сильную согласованность. - Асинхронная репликация быстрая, но при
failoverна отстающийfollowerнедавние подтверждённые записи могут потеряться. Failoverопасен: потеря записей,split brainи неудачныйtimeoutпортят данные, поэтому его часто делают вручную.- Логический (построчный)
replication logне зависит от движка, позволяет обновлять базу без простоя и служит основойCDC. - Лаг репликации даёт три аномалии, и от них защищают гарантии
read-after-write,monotonic readsиconsistent prefix reads. - Несколько
leaderи схема безleaderлучше переносят сбои узлов, разрывы сети и всплески задержки, но требуют разрешать конфликты и дают более слабые гарантии. - LWW молча теряет параллельные записи; CRDT и OT сливают их автоматически, а ручное разрешение возвращает
siblingsприложению. - Кворум
w + r > nделает свежее чтение вероятным, но не гарантирует его; параллельные записи находят поversion vector.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Реплика | Узел, который хранит копию данных |
leader / follower | Узел, который принимает записи / узел, который повторяет его изменения и обслуживает чтение |
replication log | Поток изменений от leader к follower |
semi-synchronous | Один follower синхронный, остальные асинхронные |
failover | Замена упавшего leader одним из follower |
split brain | Два узла одновременно считают себя leader |
fencing | Ограничение или выключение старого leader, чтобы избежать split brain |
WAL shipping | Репликация через передачу байтов write-ahead log |
logical log | Журнал изменений на уровне строк, не зависящий от движка хранения |
change data capture (CDC) | Передача изменений базы во внешние системы через логический журнал |
лаг репликации (replication lag) | Насколько follower отстал от leader |
eventual consistency | Реплики сойдутся, если перестать писать; срок не определён |
read-after-write | Пользователь всегда видит свои записи |
monotonic reads | Пользователь не видит более старые данные после более новых |
consistent prefix reads | Записи видны в том порядке, в каком они произошли |
zero-disk architecture | Все данные в объектном хранилище, диски и память только кэш |
sync engine | Библиотека, которая хранит данные на клиенте и синхронизирует их в фоне |
local-first | Совместное приложение, которое работает даже без сервисов разработчика |
last write wins (LWW) | Побеждает запись с большим timestamp, остальные теряются |
siblings | Параллельно записанные версии одного значения |
CRDT / OT | Два семейства алгоритмов автоматического слияния параллельных правок |
strong eventual consistency | Eventual consistency плюс гарантия, что реплики с одинаковым набором записей совпадают |
кворум (w + r > n) | Условие, при котором узлы чтения и записи пересекаются |
read repair / hinted handoff / anti-entropy | Починка устаревших реплик при чтении / передачей подсказок / в фоне |
sloppy quorum | Запись на любые доступные реплики, даже не из набора для ключа |
request hedging | Использовать самые быстрые ответы из нескольких параллельных запросов |
happens-before | Операция B знает об операции A или построена на ней |
version vector | Набор номеров версий по всем репликам для одного ключа |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- CDC строится на
replication log. Читайте логический журнал (binlog, logical decoding в PostgreSQL), а не копируйте таблицы целиком. Храните позицию в журнале, чтобы продолжить после сбоя. - Реплики для аналитики отстают. Не стройте на
followerотчёты, которым нужна точность «прямо сейчас». Измеряйте лаг и настройте алерт. - После
failoverпроверьте данные. Потерянные асинхронные записи и повторно выданные ключи ломаютpipelineи внешние системы. - Не ждите гарантий от
eventual consistency. Если пользователь должен видеть свою запись, читайте сleaderили привяжите сессию к одной реплике. - Остерегайтесь LWW. При параллельных записях данные теряются молча. Для важных данных нужен
mergeили неизменяемые записи с уникальным ключом. - Multi-leader и leaderless: читайте документацию и тестируйте. Проверяйте реальные гарантии на своей версии базы.
- Реплика не заменяет бэкап. Ошибочный
DELETEв источнике сразу дойдёт до всех реплик, поэтому храните снимки и архивWALв объектном хранилище. - Кворум — это вероятность, а не гарантия. Если
pipelineчитает из Cassandra или ScyllaDB, учитывайте, что недавняя запись может быть ещё не видна.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему в базе с «синхронной репликацией» обычно синхронен только один
follower? - Какие риски несёт автоматический
failoverи почему некоторые команды делают его вручную? - Чем логический
replication logудобнееWAL shippingпри обновлении базы и дляCDC? - Какие три аномалии даёт лаг репликации и как защититься от каждой?
- Когда оправдана репликация с несколькими
leaderи почему LWW теряет данные? - Почему условие
w + r > nне гарантирует свежее чтение вDynamo-styleбазе?
Предыдущая: Кодирование данных и изменение схем. Следующая: Sharding.