

Crafting Engineering Strategy, глава 17: Стратегия внедрения LLM
Главная мысль: когда давление большое, а опыта нет, стратегия не обязана угадать будущее. Она ставит дешёвые обратимые эксперименты и проверяет, где LLM реально поможет. Модели в этой главе показывают: самый сильный рычаг лежит не там, где его ищут сначала. Важнее не ускорить работу, а снизить ошибки в продакшене и вернуть ушедших водителей.
О чём глава
Заголовок раздела «О чём глава»После главы 16 тема новая: с 2023 года многие компании боятся отстать из-за LLM, хотя у большинства интеграций эффект поверхностный. Автор разбирает вымышленную компанию Theoretical Ride Sharing: 2 000 сотрудников, 300 инженеров, $400 млн привлечённых денег, $50 млн выручки в год, 200 городов в Северной Америке и Европе. Это сервис поездок вроде Uber, но на больших машинах: новый общественный транспорт.
В главе четыре документа:
- 17–1: стратегия внедрения LLM (политика, диагноз, исследование).
- 17–2:
system modelпути разработчика. - 17–3:
Wardley mapэкосистемы LLM. - 17–4:
system modelводителей: поможет ли LLM увеличить их число.
Чтобы узнать, что делать, читайте сверху вниз; чтобы понять логику — снизу вверх: исследование, диагноз, политика (см. главу 11). Для читаемости шаг operations встроен в политику, а refinement — в диагноз.
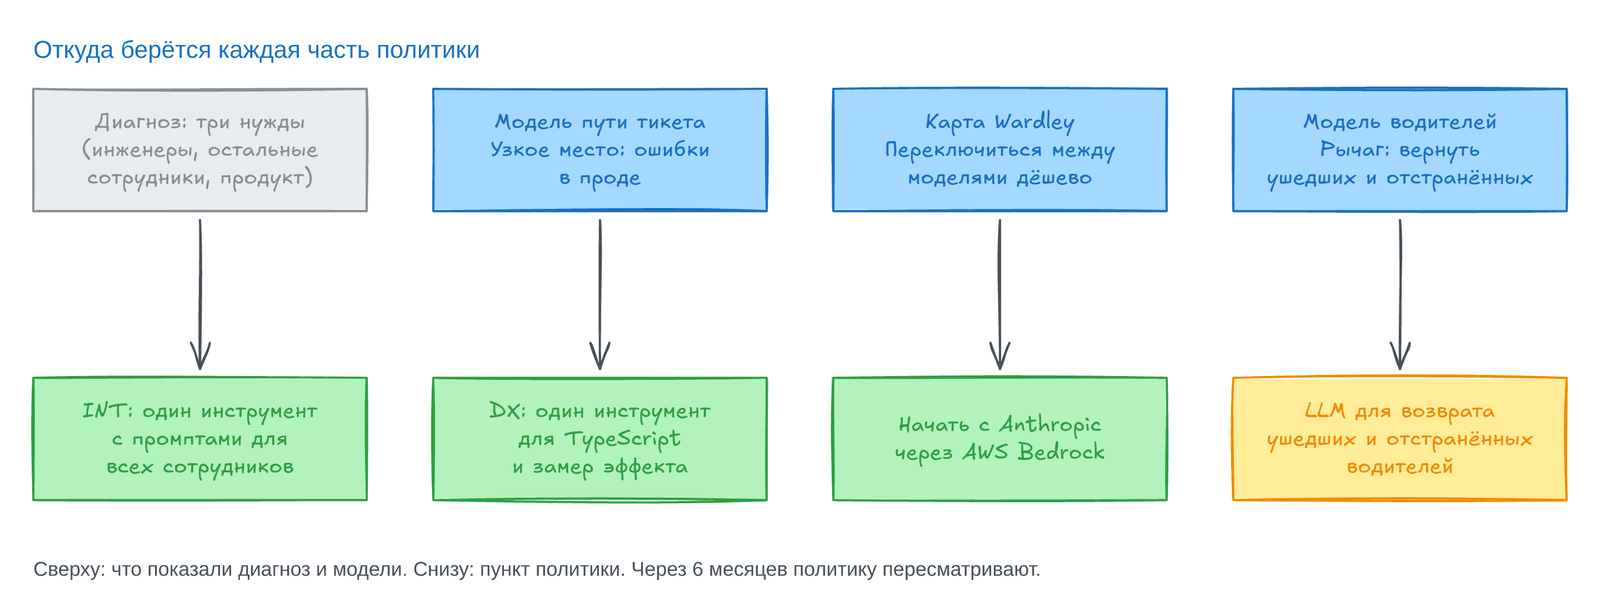
Каждый вывод даёт свой пункт политики. Пятый пункт, пересмотр через шесть месяцев, следует из того, что опыта с LLM мало.
Документ 17–1: как нам внедрять большие языковые модели
Заголовок раздела «Документ 17–1: как нам внедрять большие языковые модели»Политика
Заголовок раздела «Политика»Политика Theoretical Ride Sharing состоит из пяти пунктов. У каждого указан канал, где его обсуждают: так шаг operations встроен прямо в политику.
- Возвращать водителей. Построить процесс на основе LLM, который возвращает ушедших и отстранённых водителей в зрелых рынках. Моделирование показало, что ускорение онбординга почти не меняет число активных водителей, а вот возврат ушедших и отстранённых меняет. О прогрессе докладывают раз в месяц на Exec Weekly Meeting.
- Начать с Anthropic. Использовать модели Anthropic через AWS Bedrock, который уже есть у компании. Качество базовых моделей (foundational models) пока почти не различается, поэтому не нужно держать много реализаций. Исключения рассматривает Machine Learning Review.
- Инструмент для разработчиков. Команда Developer Experience (DX) обязана предложить хотя бы один LLM-инструмент для написания кода на TypeScript, доступный всем инженерам. Он должен помочь решить, увеличивать ли инвестиции в следующем году. Другие инструменты, например GitHub Copilot, DX согласует с руководителями, которые взвешивают скорость обучения, цену вендора и безопасность данных.
- Инструмент для всех сотрудников. Команда Internal Tools (INT) обязана предложить хотя бы один инструмент для произвольных задач (извлечь текст, переписать заметки). Он должен работать с данными клиентов и соблюдать обязательства по их обработке.
- Пересмотр через шесть месяцев. Главная цель сейчас — быстро научиться в незнакомой области, а потом решить, увеличивать ли вложения.
Диагноз
Заголовок раздела «Диагноз»Автор перечисляет проблемы, из которых вытекает политика.
- Три разные нужды. Инструменты для неинженеров (переписать или сократить документ), инструменты для инженеров (умное автодополнение вроде Copilot) и расширения самого продукта (например, извлечение данных из документов при онбординге водителей).
- Что даёт преимущество. Расширения продукта могут отличить компанию от других. Две другие нужды лишь оптимизируют работу. Точки роста такие: возврат ушедших и отстранённых водителей (самый большой рычаг к числу активных); быстрый онбординг с меньшим участием людей (водителей не прибавится, но расходы упадут); быстрая поддержка клиентов.
- Мало опыта. Несмотря на громкие заявления, очень мало компаний используют LLM масштабно, и эта компания тоже не из них. Поэтому крупная необратимая ставка рискованна, а отдача мала: явного преимущества пока не нашёл никто.
- Менять модель или провайдера дёшево. И по деньгам, и по цене интеграции: API у провайдеров во многом совпадают.
- Рынок быстро меняется. Вероятно, провайдеры выпустят ещё одно-два поколения моделей, а потом обучение станет слишком дорогим (следующие версии OpenAI и Anthropic, похоже, обойдутся в $500 млн и больше). Тогда преимущество может сместиться к удобству разработки или к открытым моделям вроде LLaMa.
- Своя базовая модель не нужна. Чтобы догнать общие модели Anthropic или OpenAI, нужно от $3 млн до $100 млн, а у компании $400 млн.
Исследование
Заголовок раздела «Исследование»- Цена обучения. Meta, по слухам, потратила $20–30 млн на LLaMa 2 против примерно $3 млн на LLaMa 1. GPT-4 стоил около $100 млн. Крупные модели в среднем лучше мелких, поэтому свою мелкую обучать смысла мало. Даже с уникальным набором данных лучше взять
fine-tuningилиin-context learning(ICL, примеры кладут прямо в запрос). - Цена использования. Anthropic берёт от $0,25 до $15 за миллион входных токенов, OpenAI от $0,50 до $60. В английском слове около 1,3 токена, так что многое можно сделать за копейки.
- Будет ли рост качества? Спор похож на спор о смерти закона Мура. Тратить на вычисления всё больше вряд ли получится: $1 млрд терпят немногие, $100 млрд трудно представить. Рост могут дать алгоритмы и данные. Уверенно можно сказать лишь одно: качество вырастет вдвое ещё один-два раза за три года, а потом либо продолжит расти, либо упрётся в потолок.
- Привязки к вендору почти нет. Переход с AWS на Azure дорог из-за кастомизации, но с LLM иначе. Большинство компаний пробуют разные модели. Поведение моделей различается и меняется со временем (GPT-3.5, говорят, «обленился»), так что работа с различиями неизбежна даже при одном провайдере. Сложности создают регуляторные требования, например обновление договоров об обработке данных.
- Что делают другие. Большинство зрелых компаний ищут применения за пределами очевидного (Copilot). Stripe много вкладывается во внутреннюю продуктивность, например в проверку сайта клиента при онбординге, но неясно, изменили ли LLM их продукт. Uber тоже применяет LLM внутри, а прорыва для сервисов поездок нет.
Документ 17–2: как LLM повлияют на опыт разработчика
Заголовок раздела «Документ 17–2: как LLM повлияют на опыт разработчика»Модель описана тремя графиками. Базовый показывает равновесие: тикеты открываются, но число закрытых перестаёт расти. Если доля тикетов с ошибкой в проде падает с 25% до 10%, равновесие наступает позже и на более высоком уровне. А если втрое ускорить начало работы и тестирование, число завершённых тикетов почти не меняется.
Главный вывод: систему ограничивают ошибки, найденные в продакшене. Всё остальное мало помогает, а подход, который ускоряет разработку, но повышает долю ошибок в проде, скорее всего вредит. Модель многое упускает.
Моделировать в таблице трудоёмко, поэтому сначала автор рисует эскиз. Пять запасов (stock) — это шаги пути тикета:
- Открытые тикеты.
- В работе (Started Coding).
- Протестированы.
- Задеплоены.
- Закрыты после выхода в прод.
Четыре потока (flow) ведут слева направо. Три исключительных потока идут справа налево: тест нашёл ошибку (тикет возвращается в работу), деплой выявил ошибку (тоже в работу), ошибка найдена в проде (возвращается самый далёкий: открывается как новый тикет).
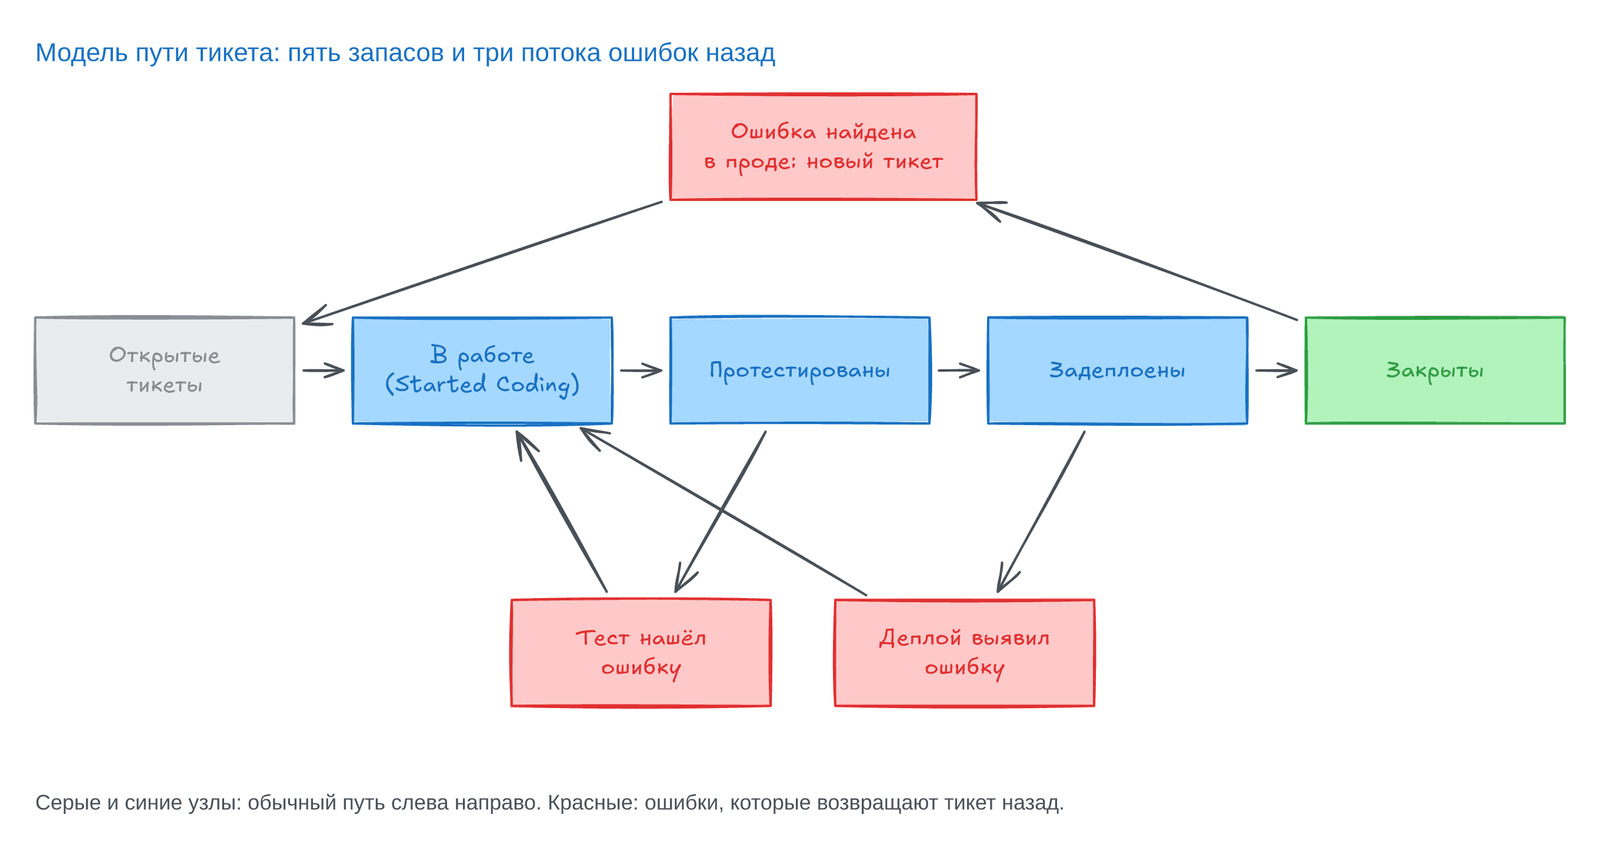
Красные узлы — обратные потоки.
Модель кажется до неловкости простой. Но польза модели в том, что она проясняет мышление, и для группы простая модель делает это лучше: вокруг сложной трудно договориться.
Рассуждение
Заголовок раздела «Рассуждение»Как LLM-инструменты могут показать пользу? Есть три способа.
- Ускорить переход от «в работе» к «протестировано»: меньше времени уходит на реализацию.
- Чаще возвращать тикеты из тестов обратно в работу: более полные тесты находят больше ошибок. Это первый неочевидный вывод: если инструмент работает, время в цикле тестирования вырастет, а ошибок в проде станет меньше. То есть более медленное тестирование может быть успехом, а не провалом. Скептик ждёт обратного: больше ошибок найдут уже после деплоя. В обоих случаях цель измерения ясна: поток «ошибка найдена в проде». А поток «тест нашёл ошибку» мерить как цель не стоит, он скорее вырастет.
- Мерить общее время от начала работы до закрытия тикета, если за первые 90 дней в продакшене ошибок не нашли.
Так даже очень простая модель вскрывает неочевидные выводы и даёт уверенность спорить с интуицией.
Автор строит модель в Google Sheets. Три листа: Model с самой моделью, Charts с графиками и Config с настройками (скорость открытия тикетов, лимит задач в работе, доли ошибок). Первая строка — числа, остальные — формулы. Автор советует один раз смоделировать в таблице ради чувства математики, но для сложных моделей брать другой инструмент (глава 14): ошибки в таблице делают даже умные люди, и найти их трудно.
Модель собирается в два прохода. Сначала потоки слева направо: тикеты открываются с постоянной скоростью, в работу берут не больше MaxConcurrentCodingNum, тестируют не быстрее заданной скорости, всё протестированное уходит в деплой, всё задеплоенное закрывается. Потом потоки справа налево. Каждый из них задан долей: например, 25% закрытых тикетов в каждом раунде оказываются с ошибкой. Тикеты округляют вниз (FLOOR). Тикет, ушедший назад, вычитается из одного запаса и добавляется в другой.
Пояснение: в книге формулы живут в Google Sheets. Здесь та же логика переписана на Python без зависимостей:
ch17_ticket_model.py.
to_start = 0 if started >= max_started else start_rate # лимит задач в работеto_test = min(test_rate, started) # скорость тестированияe_prod = floor(closed * err_prod) # доля закрытых с ошибкойopened += open_rate - to_start + e_prod # ошибка возвращает тикет в началоclosed += to_close - e_prodОпыт с моделью
Заголовок раздела «Опыт с моделью»На базовых настройках число закрытых тикетов быстро упирается в потолок. Затем автор проверяет гипотезы.
| Что меняем | Закрыто на раунде 10 | на 30 | на 100 |
|---|---|---|---|
| База: 25% ошибок в проде | 4 | 4 | 4 |
| 10% ошибок в проде | 7 | 10 | 10 |
| Тестируем втрое быстрее | 4 | 4 | 4 |
| Тестируем и начинаем втрое быстрее | 4 | 7 | 7 |
Это вывод нашего скрипта ch17_ticket_model.py: он повторяет логику книги, но не копирует таблицу автора.
Снижение доли ошибок в проде даёт больше всего. Ускорение тестирования ничего не меняет, потому что узкое место раньше: тикеты медленно берут в работу. Ускорение начала работы автор описывает как «шум без прогресса»; в нашей упрощённой версии оно даёт скромный рост, но всё равно меньше, чем снижение ошибок. Вывод: пока доля ошибок зависит от всего, что мы уже отгрузили, быстрая отгрузка скорости не добавляет. Единственный способ ускориться — снизить поток ошибок из продакшена.
Документ 17–3: карта Wardley экосистемы LLM
Заголовок раздела «Документ 17–3: карта Wardley экосистемы LLM»Как всё устроено сегодня
Заголовок раздела «Как всё устроено сегодня»Если RAG был главным LLM-паттерном 2023 года, то 2024-й можно назвать годом агентов (agents). Новых паттернов будет больше, и чтобы проверять их, компании поддерживают всё больше инфраструктуры, например поисковые индексы для RAG. Поддерживать столько паттернов дорого. Скорее всего, рынок решит эту проблему, когда появятся готовые продукты.
Переход к будущему
Заголовок раздела «Переход к будущему»Автор выделяет два вопроса, от которых зависит развитие.
- Останутся ли платформы для агентов и RAG связанными с провайдерами моделей (OpenAI, Anthropic) или разойдутся и будут продаваться отдельно?
- Что из LLM-фреймворков можно быстро превратить в продукт? Например, запуск
evalsи поддержку агентов легко включить в готовую платформу. RAG кажется простым, но в проде требует обновлений в реальном времени, то есть управления большими поисковыми кластерами.
В карте-прогнозе платформы отделяются от провайдеров, а лицензия на платформу даёт доступ к моделям без отдельных договоров с каждым провайдером. Всё, кроме RAG, уходит в готовую платформу. Пока рынок не придёт к одной конфигурации, будут встречаться любые комбинации.
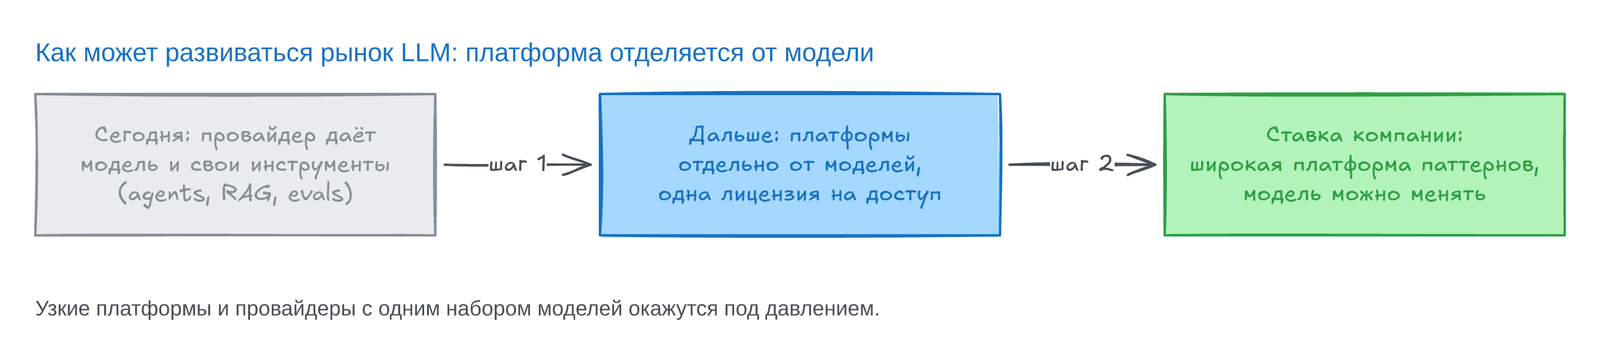
Вывод автора: лучшая ставка продуктовой компании — самая широкая платформа паттернов и явное отделение её от провайдера модели. Трудно придётся и провайдерам моделей (у них только свои модели), и узким платформам (они закрывают часть паттернов). Причина: рынок каждый год вкладывается в новые паттерны, а свои внутренние решения долго держать смогут немногие. Кроме того, зрелость приёмов часто завышают: это «разработка, движимая конференц-докладами».
Пользователи и цепочки ценности
Заголовок раздела «Пользователи и цепочки ценности»Три главных пользователя этой динамики:
- Продуктовые инженеры хотят быстрее и проще выкатывать LLM при постоянных изменениях: новые модели, агенты, внешние решения для поиска в RAG.
- Команда Machine Learning Infrastructure отвечает за эффективное использование механизмов, направляет продуктовые команды и поддерживает общие части, например поисковые индексы.
- Security и Compliance: как безопасно размещать модели и отправлять только разрешённые данные, как отвечать на новые риски ИИ.
Автор для простоты объединил часть команд и пропустил некоторые: Finance тоже хочет знать цену и объём использования, Security и Compliance на деле разные, а ML Infrastructure можно разделить на две. Группировку выбирают под вопрос, который должна прояснить карта.
Документ 17–4: модель онбординга водителей
Заголовок раздела «Документ 17–4: модель онбординга водителей»Очевидная гипотеза: чем быстрее онбординг, тем больше водителей будет со временем. Модель показывает: даже если вдвое ускорить признание заявителей подходящими (Eligible), число активных водителей почти не изменится. Зато возврат ушедших водителей влияет сильно. Например, LLM может сопоставить причину ухода с недавними изменениями продукта и бонусами и написать персональное письмо. Возврат ушедших и возврат отстранённых вместе дают намного больше, чем любой из них отдельно: если одна из долей низкая, система теряет всё больше водителей. Значит, у LLM здесь два настоящих рычага: эти доли возврата.
Модель описывает один город. Запасов семь:
- Население города.
- Подавшие заявку (
Applied). - Подходящие по критериям (
Eligible), например с действующими правами. - Прошедшие онбординг (
Onboarded). - Активные: ездят каждую неделю (
Active). - Ушедшие (
Departed): были активными, но сами перестали ездить, например нашли другую работу. - Отстранённые (
Suspended): были активными, но их убрали с платформы.
Слева направо идут обычные потоки один в один. Исключение — активные: они расходятся в два запаса, ушедших и отстранённых. Справа налево идут три потока: запрос недостающих данных (заявка не может стать Eligible), Re-engage (ушедший возвращается, скажем, из-за бонуса) и Remove suspension (отстранённому разрешили вернуться).
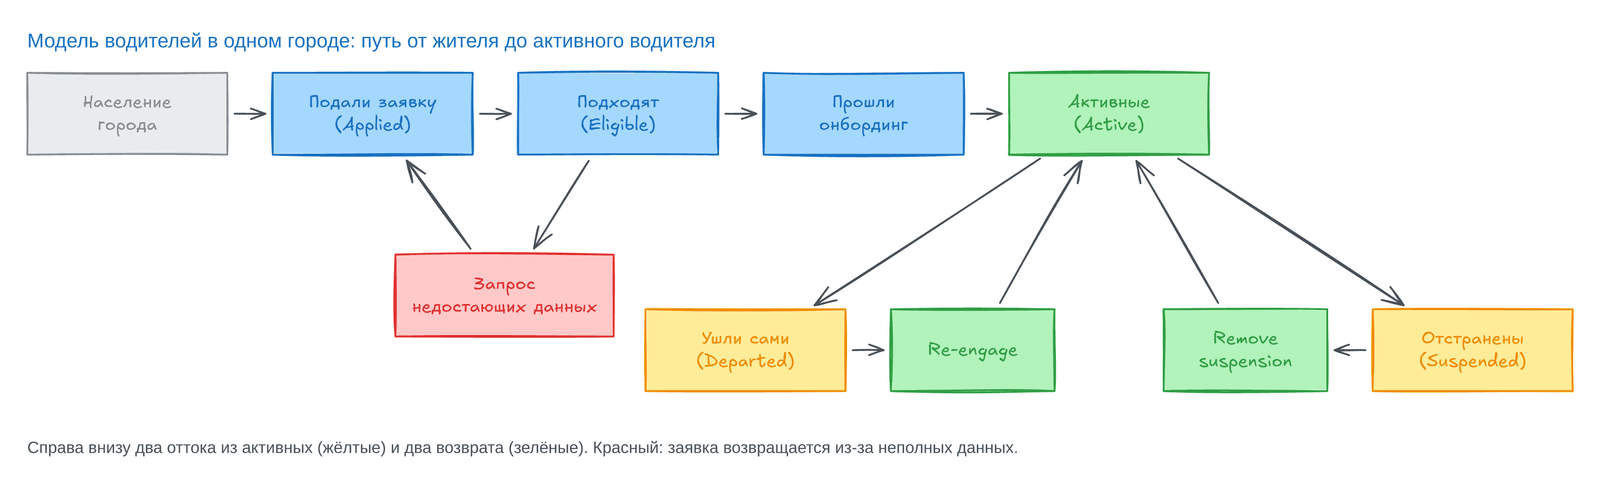
На схеме красный узел показывает возврат заявки из-за неполных данных. Жёлтые узлы — отток из активных, зелёные — возвраты.
Рассуждение
Заголовок раздела «Рассуждение»Какие потоки важнее и где LLM их усилит?
- При бесконечном населении важнее всего приток новых водителей. При конечном онбординг решает на старте работы в городе, а потом возврат ушедших не менее важен.
- LLM может проверять заявки в реальном времени и ловить недостающие данные, уменьшая поток «запрос недостающих данных».
- LLM может писать ушедшим персональные письма о том, какие изменения касаются их причин ухода. Это усилит
Re-engage. - Снимать отстранение LLM лучше не доверять, но модель может отобрать заявки на пересмотр с самым высоким шансом одобрения, чтобы люди смотрели в первую очередь их.
Выбор зависит от допущения: исчерпан ли город. Если все потенциальные водители уже в системе, нужно заниматься только возвратом прежних. Иначе лучше привлекать новых.
Автор использует свою библиотеку lethain/systems: модели в ней пишутся текстом, их легко воспроизвести и поделиться ими.
CityPop(10000)CityPop > AppliedDrivers @ 100AppliedDrivers > EligibleDrivers @ Leak(0.25)EligibleDrivers > AppliedDrivers @ Leak(0.1)EligibleDrivers > OnboardedDrivers @ Leak(0.25)OnboardedDrivers > ActiveDrivers @ Leak(0.5)ActiveDrivers > DepartedDrivers @ Leak(0.1)ActiveDrivers > SuspendedDrivers @ Leak(0.1)DepartedDrivers > ActiveDrivers @ Leak(0.05)SuspendedDrivers > ActiveDrivers @ Leak(0.01)В городе 10 000 жителей. Каждый раунд 100 человек подают заявку, пока жители не кончатся. Запись @ 100 — поток с постоянной скоростью. Запись @ Leak(0.25) значит, что каждый раунд переходит 25% запаса. Потоки справа налево (например, из подходящих обратно в заявки) пишутся так же, как обычные.
Разница между Leak и Conversion важна. @ 0.25 — это сокращение для Conversion(0.25), которое уничтожает непереведённый остаток. Пример: 100 заявок и 100 подходящих. После Leak(0.25) будет 75 заявок и 125 подходящих, после Conversion(0.25) 0 заявок и 125 подходящих. Выбор зависит от того, что вы моделируете.
Пояснение: в нашем
ch17_driver_model.pyтот же код запускается пакетомsystems==0.1.0. Поток с нулевой долей (Leak(0)) пакет не принимает, поэтому такие строки мы просто не пишем.
Опыт с моделью
Заголовок раздела «Опыт с моделью»Базовая модель быстро набирает водителей, а потом замедляется, когда жители кончаются: в книге около 800 активных. Автор меняет по одной доле. Наш прогон на 50-м раунде:
Сценарий активные departed suspended1. База 854 1056 19702. Eligible в 2 раза быстрее (50%) 881 1123 21363. Без потерь на недостающих данных 867 1090 20434. Вернувшихся departed 20% (было 5%) 1059 447 23745. Вернувшихся suspended 2,5% (было 1%) 981 1161 17386. Оба: departed 20%, suspended 2,5% 1240 510 2130Сценарии 2 и 3 почти не меняют число активных: 854 против 881 и 867. Рост доли возвращённых ушедших с 5% до 20% (сценарий 4) и отстранённых с 1% до 2,5% (сценарий 5) заметен. Обе группы копятся в медленно пустеющих запасах, поэтому небольшая доля возврата работает долго. Вместе обе доли (сценарий 6) дают больше, чем любая по отдельности. Значит, инструмент, который быстро находит, кого из отстранённых можно вернуть, может дать больше, чем можно ждать от такого малого потока.
Главная история модели: усилия нужно направить на возврат ушедших и отстранённых. Улучшения в других местах могут снизить операционные расходы, но число активных водителей они не увеличат.
Итоги главы
Заголовок раздела «Итоги главы»- В 2024 году никто не знал, как будут развиваться LLM, опыта почти не было, а давление индустрии было сильным.
- Стратегия в такой ситуации делает обратимые шаги: берёт одного провайдера и пересматривает политику через шесть месяцев.
- Менять провайдера моделей дёшево, поэтому главное не выбрать «правильную» модель, а быстро учиться.
- Модель пути тикета показала: узкое место — ошибки в продакшене. Ускорение разработки без снижения ошибок не даёт прогресса.
- Более медленное тестирование может быть признаком успеха: инструмент ловит больше ошибок до продакшена.
- Карта Wardley предсказывает отделение платформ паттернов от моделей. Лучшая ставка: широкая платформа и сменная модель.
- Модель водителей показала, что ускорение онбординга почти не добавляет активных водителей. Рычаг — возврат ушедших и отстранённых.
- Уточнение (
refinement) помогает найти разумный путь при срочности и неопределённости.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
| Базовая модель (foundational model) | Большая модель, на которой строят остальное: обучение стоит десятки и сотни миллионов долларов |
in-context learning (ICL) | Примеры кладут в запрос, модель не меняется |
RAG | Модель получает найденные документы вместе с запросом |
| Агенты (agents) | Модель сама выбирает шаги для задачи |
evals | Проверки качества модели на своих примерах |
stock и flow | Запас и поток между запасами |
Leak | Поток в systems: переводит долю запаса, остаток остаётся |
Conversion | Поток в systems: переводит долю и уничтожает остаток |
| Ушедшие и отстранённые водители | Ушли сами / убраны с платформы; обе группы можно вернуть |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Прежде чем внедрять LLM в аналитику, найдите показатель, который ограничивает систему. Быстрые отчёты не помогут, если главная потеря в ошибках данных.
- Если LLM пишет SQL или код для
pipeline, мерьте число ошибок, найденных в продакшене, а не скорость написания. - Держите вызов модели за тонким интерфейсом и собирайте свои
evals: так замену провайдера легко проверить.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему в Theoretical Ride Sharing решили начать с одного провайдера, хотя ждут перемен на рынке?
- Почему более долгое тестирование после внедрения LLM-инструмента может быть успехом?
- Что показали три эксперимента с моделью пути тикета? Какой рычаг оказался главным?
- Почему ускорение онбординга водителей почти не меняет число активных водителей?
- В чём разница между
LeakиConversion? Приведите пример с числами. - Какую ставку в экосистеме LLM автор считает лучшей и почему?
Предыдущая: Стратегия миграции сервисов. Следующая: Стратегия при владельце private equity.