

Designing Data-Intensive Applications, глава 1: Компромиссы в архитектуре систем данных
Главная мысль: В архитектуре систем данных нет одного правильного ответа, есть только компромиссы. Глава сравнивает четыре пары подходов: операционные и аналитические системы, облако и свои серверы, распределённую систему и одну машину, интересы бизнеса и права людей. Заодно она вводит термины, на которых держится вся книга.
О чём глава
Заголовок раздела «О чём глава»Это первая глава, общий план книги — на странице обзора. Глава отвечает на вопрос: какие крупные решения определяют архитектуру системы данных и чем платят за каждый вариант. Готовых рецептов авторы не дают: они учат задавать вопросы, которые помогают сравнить подходы.
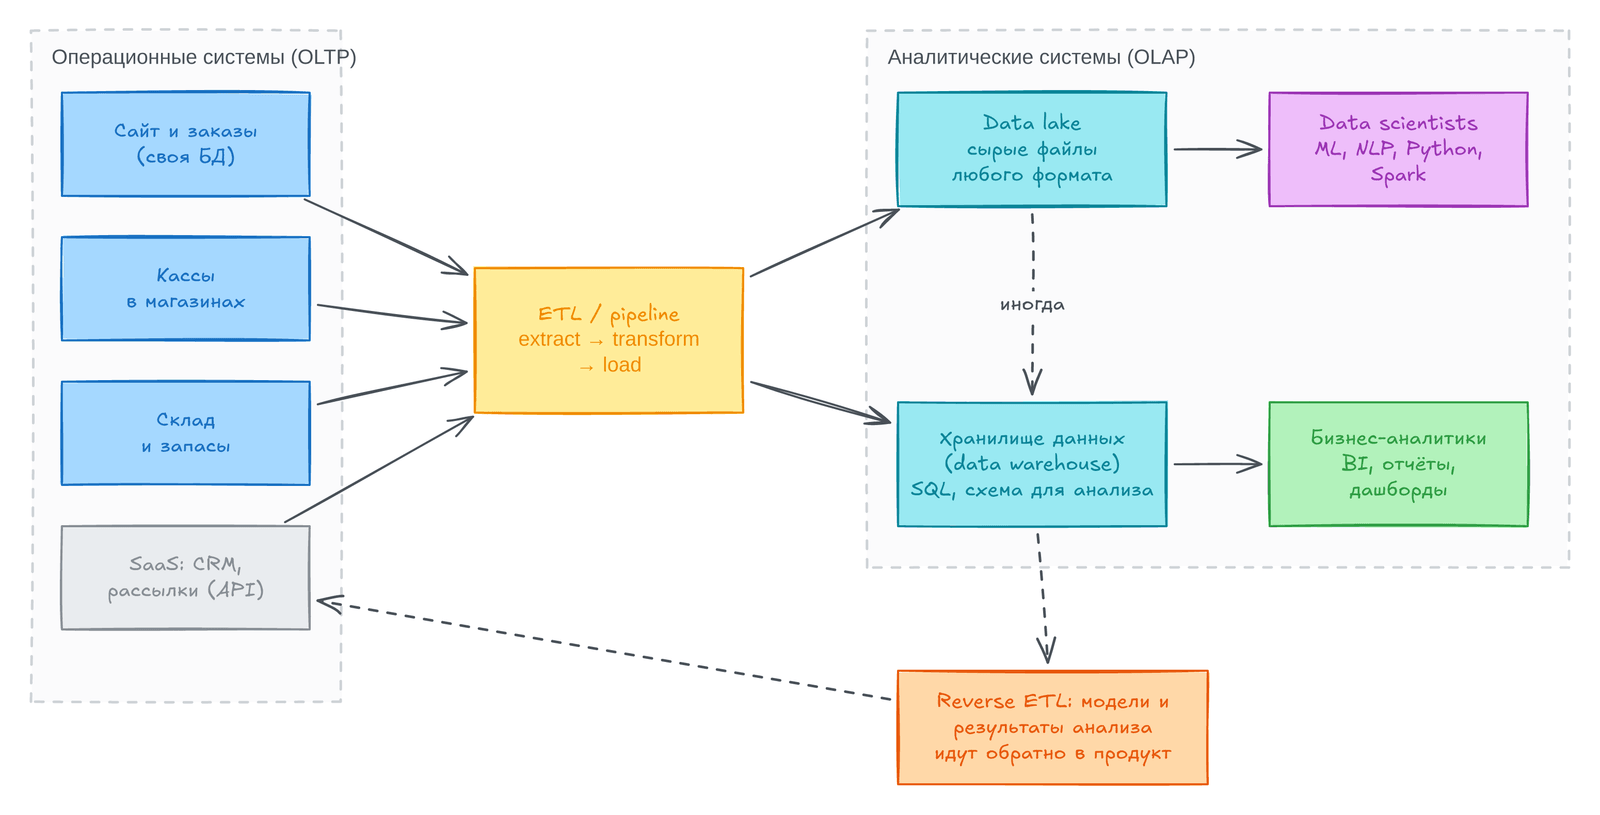
Схема показывает первую половину главы. Слева операционные системы, где данные рождаются, справа аналитические, которые получают копию через ETL. Пунктир снизу — обратный путь результатов в продукт.
Приложения с большим объёмом данных
Заголовок раздела «Приложения с большим объёмом данных»Сегодня веб- и мобильные приложения, SaaS и облачные сервисы хранят данные многих пользователей на общих серверах. Пользователи и читают эти данные, и создают новые, а потом данные нужны ещё и для анализа.
Пока данные помещаются на одну машину, всё просто. Когда растёт объём или число запросов, данные делят между машинами, и проблем становится много. А сложному приложению часто нужна не одна система, а несколько с разными возможностями.
Приложение называют приложением с большим объёмом данных (data-intensive), если главная трудность в нём — данные. В compute-intensive системах главное — распараллелить огромный расчёт. А в приложениях с большим объёмом данных думают, как хранить и обрабатывать много данных, управлять их изменениями, сохранить согласованность при сбоях и параллельной работе и не допустить простоя.
Такие приложения собирают из стандартных блоков: базы данных, кэши, поисковые индексы, потоковая (stream processing) и пакетная (batch processing) обработка.
Обычно разработчик связывает несколько готовых систем кодом приложения. Пока задача совпадает с назначением систем, это легко. Но баз, способов кэширования и индексов много: как выбрать и как понять их компромиссы? Ни один подход не лучше всех, и цель книги — научить задавать вопросы, которые помогают сравнить системы под своё приложение.
Многие идеи пришли из практики больших компаний и государства: раньше только у них было так много данных. Сегодня большие объёмы есть и у стартапов. Ещё одна трудность — люди. Разные команды хотят от одних данных разного и часто не проговаривают свои цели, отсюда споры о «правильном» подходе.
Термины: frontend и backend
Заголовок раздела «Термины: frontend и backend»Книга в основном про backend. Код в браузере называют frontend, а код на сервере, который обрабатывает запросы, — backend. Мобильное приложение похоже на frontend. Главные трудности с данными обычно на backend: frontend работает с данными одного пользователя, а backend — всех.
Backend-сервис отвечает по HTTP или WebSocket, читает и пишет данные в базы, иногда обращается к кэшам и очередям сообщений. Всё это вместе авторы называют инфраструктурой данных. Код приложения часто stateless: обработал запрос и забыл о нём. Поэтому всё, что живёт дольше одного запроса, хранят на клиенте или в инфраструктуре данных.
Операционные и аналитические системы
Заголовок раздела «Операционные и аналитические системы»С данными в компании работают три группы людей. Backend-инженеры строят сервисы, которые читают и обновляют данные по запросам пользователей. Две другие группы используют данные иначе:
- бизнес-аналитики готовят отчёты, которые помогают руководству принимать решения (
BI, business intelligence); - data scientists ищут в данных закономерности или делают функции продукта на ML: рекомендации, оценку рисков, фильтр спама, ранжирование поиска.
Обе группы занимаются аналитикой: смотрят на данные, которые создали пользователи и сервисы, и обычно их не меняют, хотя строят из них производные наборы. Отсюда деление, которое проходит через всю книгу:
- Операционные системы (
operational systems) — этоbackend-сервисы и инфраструктура, где данные создаются. Код приложения здесь и читает, и меняет данные по действиям пользователей. - Аналитические системы (
analytical systems) обслуживают аналитиков и data scientists. Они хранят копию данных из операционных систем только для чтения и настроены под аналитическую обработку.
Пояснение: «операционная система» здесь — не ОС вроде Linux. Так в книге называют системы, которые обслуживают работу продукта: заказы, платежи, профили пользователей.
Эти системы обычно держат отдельно. С развитием этих систем появились две новые роли. Инженеры данных связывают операционные и аналитические системы и отвечают за инфраструктуру данных, а инженеры аналитики (analytics engineers) моделируют и преобразуют данные для аналитиков.
OLTP и OLAP: два способа работать с данными
Заголовок раздела «OLTP и OLAP: два способа работать с данными»Слово «транзакция» пришло из времён, когда запись в базу совпадала со сделкой: продажа, заказ, зарплата. Сейчас так называют группу чтений и записей, которая образует одну логическую единицу (глава 8). Здесь слово значит просто быстрые чтения и записи.
Потом в базах стали хранить и другие данные: посты, ходы в игре, контакты. Но шаблон доступа остался таким же, как при обработке сделок. Операционная система ищет несколько записей по ключу — это точечный запрос (point query) — и вставляет, меняет или удаляет записи по действиям пользователя. Такой интерактивный шаблон назвали OLTP (online transaction processing).
Аналитический запрос, наоборот, просматривает огромное число записей и считает агрегаты: количество, сумму, среднее. Например, аналитик сети супермаркетов спрашивает:
- какая выручка была у каждого магазина в январе;
- какое детское питание чаще всего покупают вместе с подгузниками марки X.
Такие отчёты помогают руководству решать, что делать дальше. Этот шаблон назвали OLAP (online analytical processing). Слово «online» здесь, скорее всего, значит, что аналитики задают системе свои вопросы интерактивно. Граница между OLTP и OLAP не всегда чёткая, но типичные различия такие:
| Свойство | Операционные системы (OLTP) | Аналитические системы (OLAP) |
|---|---|---|
| Как читают | Несколько записей по ключу | Агрегаты по миллионам записей |
| Как пишут | Создают, меняют, удаляют отдельные записи | Массовая загрузка (ETL) или поток событий |
| Пример запроса от программы | Проверить, есть ли у пользователя право на действие | Найти схемы мошенничества |
| Какие запросы | Заранее заданы в коде | Любые, аналитик пишет их сам |
| Сколько запросов | Много маленьких | Мало, но каждый сложный |
| Что отражают данные | Текущее состояние | Историю событий во времени |
| Объём | Гигабайты — терабайты | Терабайты — петабайты |
В OLTP-системе пользователям не дают писать свой SQL: они могли бы прочитать чужие данные или замедлить базу тяжёлым запросом. Поэтому запросы заданы в коде приложения. В аналитической базе пользователь пишет SQL сам или через Tableau, Looker, Microsoft Power BI.
Есть и третий вид систем: аналитика, встроенная в продукт для пользователей (product analytics, real-time analytics) — Pinot, Druid, ClickHouse. Такие системы принимают данные в реальном времени и отвечают с малой задержкой (latency). Классические OLAP-системы, наоборот, грузят данные пакетами и настроены на высокий throughput.
Хранилище данных
Заголовок раздела «Хранилище данных»Сначала одна база обслуживала и транзакции, и аналитику: SQL подходит для обоих. Но с конца 1980-х аналитику стали выносить в отдельную базу — хранилище данных (data warehouse).
У большой компании десятки и сотни OLTP-систем: сайт, кассы, склады, маршруты, кадры. Каждую ведёт своя команда, и системы живут почти независимо. Ходить в них напрямую аналитикам неудобно:
- Данные разбросаны по системам, и их трудно соединить в одном запросе (
data silos). - Схемы, удобные для OLTP, плохо подходят для аналитики (глава 3).
- Аналитические запросы дорогие и замедляют систему для остальных пользователей.
- OLTP-системы могут стоять в закрытой сети по требованиям безопасности.
Хранилище данных — это отдельная база, где аналитики выполняют любые запросы и не мешают OLTP. Внутри оно хранит данные иначе, чем OLTP-база (глава 4).
В хранилище лежит копия данных всех OLTP-систем только для чтения. Данные выгружают дампом или потоком изменений, приводят к удобной схеме, чистят и загружают. Это ETL (extract — transform — load). Если преобразуют уже внутри хранилища, после загрузки, получается ELT.
Источником бывает и внешний SaaS: CRM, рассылки, платежи. Доступа к его базе нет, только API вендора. Если перенести данные к себе, становится возможен анализ, которого API не даёт. Для этого есть готовые коннекторы: Fivetran, Singer, Airbyte.
HTAP (hybrid transactional/analytical processing) обещает OLTP и аналитику в одной системе без ETL. Но многие HTAP-системы внутри состоят из OLTP-системы и отдельной аналитической системы под общим интерфейсом. К тому же у каждого сервиса принято держать свою базу, так что операционных баз сотни, а хранилище одно, чтобы соединять их данные. Поэтому HTAP не заменяет хранилище. Он полезен, когда одному приложению нужно и сканировать много строк, и быстро менять отдельные записи, как при поиске мошенничества.
Разделение операционных и аналитических систем — часть общего тренда: чем больше масштаб, тем сильнее системы специализируются под свою нагрузку.
От хранилища данных к data lake
Заголовок раздела «От хранилища данных к data lake»Хранилище данных с его реляционной моделью и SQL удобно бизнес-аналитикам. Но у data scientists есть задачи, для которых SQL подходит плохо:
- Подготовка данных для ML. Строки и столбцы превращают в числовые признаки (
features). Подбор признаков называютfeature engineering, и для него часто нужен код, который трудно выразить на SQL. - Разбор текста и картинок. Методы NLP и компьютерного зрения извлекают структуру из отзывов и фото: тон автора, темы.
Попытки встроить ML в SQL были, но многие data scientists предпочитают Pandas, scikit-learn, R и Spark (глава 3).
Для них нужен data lake — центральное хранилище копий любых данных, полезных для анализа. Данные приходят туда тоже через ETL, но data lake — это просто файлы без обязательного формата и схемы. Там лежат и таблицы в Avro или Parquet (глава 5), и текст, картинки, видео, показания датчиков. К тому же объектное хранилище под data lake дешевле реляционной базы.
ETL обобщили до pipeline данных. Иногда data lake стал промежуточным шагом между операционными системами и хранилищем данных: в нём лежат сырые данные без приведения к схеме хранилища, и каждый, кто их использует, преобразует их под себя. Это называют принципом суши: «сырые данные лучше».
Что после data lake
Заголовок раздела «Что после data lake»Аналитика стала зрелее, и компании всё больше внимания уделяют управлению и эксплуатации аналитических систем и pipeline данных. Эти практики описывает, например, DataOps Manifesto. Одна причина — управление данными, приватность и законы вроде GDPR и CCPA (глава 14).
Другая причина — данные всё чаще приходят потоками событий (глава 12). Анализ файлов перезапускают, например, раз в день, а потоковая обработка реагирует за секунды, например чтобы заблокировать мошенника.
Результаты аналитики иногда возвращают в операционные системы — это reverse ETL. Например, модель, обученную на аналитических данных, выкатывают в продакшен для рекомендаций с помощью TFX, Kubeflow или MLflow.
System of record и производные данные
Заголовок раздела «System of record и производные данные»Второе важное деление книги — system of record и производные данные (derived data). Оно помогает понять, как данные текут по системе.
System of record, или источник истины (source of truth), хранит эталонную версию данных. Новые данные пишут сначала сюда, и каждый факт хранится один раз, обычно в нормализованном виде. При расхождении с другой системой по определению права system of record.
Производные данные получают обработкой данных из другой системы, и при потере их можно пересоздать. Пример — кэш: нет значения в кэше, идём в базу. Сюда же относятся денормализованные значения, индексы, materialized view и обученные модели.
Как из одного system of record строят кэш, поисковый индекс и хранилище, показывает схема в главе 13.
Производные данные избыточны, но без них часто не получить быстрое чтение. Из одного источника можно сделать несколько наборов, чтобы смотреть на данные с разных сторон.
Аналитические системы обычно производные. В операционных сервисах есть и то, и другое: основные базы — system of record, а индексы и кэши — производные данные. Роль задаёт не инструмент, а то, как вы его используете.
Когда источник меняется, производные данные нужно обновлять, а многие базы рассчитаны на то, что приложение работает только с ними, и не помогают передавать изменения в другие системы. Глава 11 покажет pipeline данных как способ собрать из нескольких систем то, что не умеет ни одна.
Облако или self-hosting
Заголовок раздела «Облако или self-hosting»Первый вопрос для любой задачи: делать самим или купить? Обычное правило: то, что даёт конкурентное преимущество, делайте сами, а рутину отдайте вендору. Процессоры, например, почти никто не производит сам.
С ПО вопросов два: кто его пишет и кто запускает. На одном конце спектра своё ПО, на другом — облачные сервисы и SaaS, которые пишет и запускает вендор.
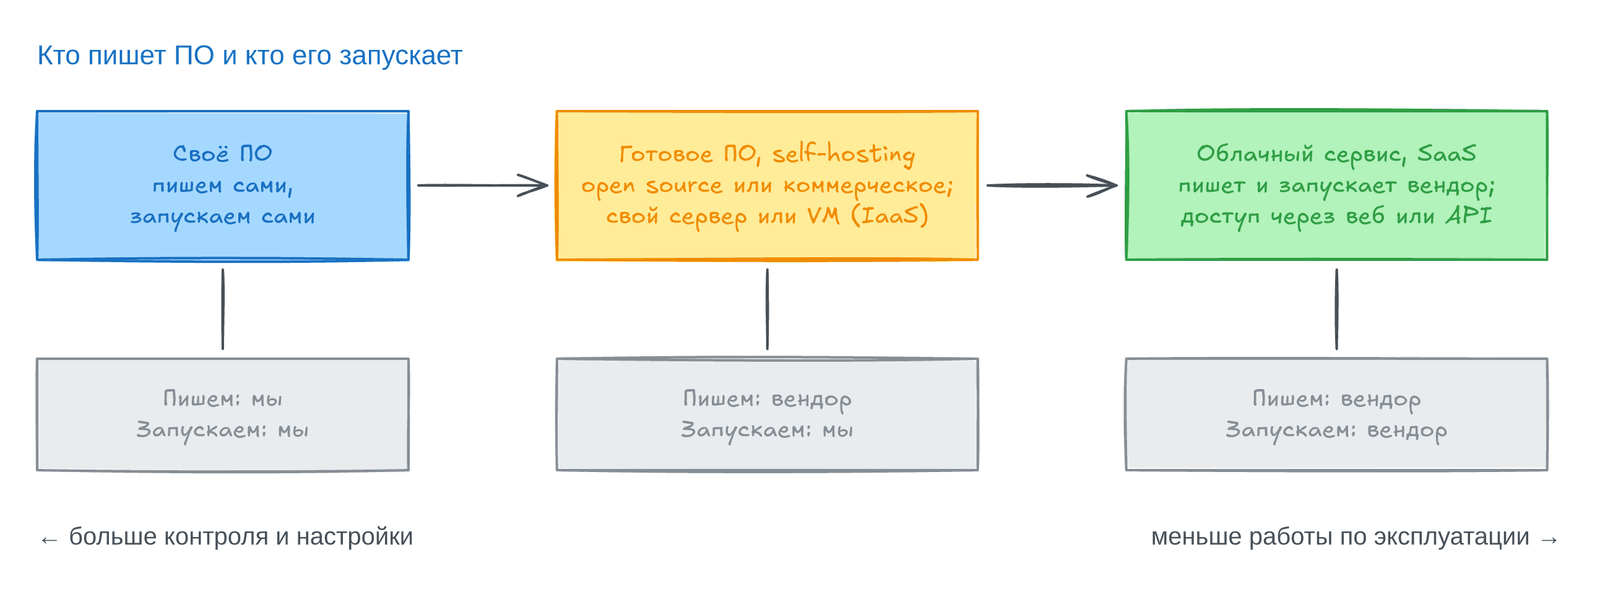
Посередине — готовое ПО, которое вы разворачиваете сами (self-hosting), например MySQL на своём сервере. Сервер может быть своим железом (on premises, даже в арендованной стойке) или VM в облаке (IaaS, infrastructure as a service).
Плюсы и минусы облачных сервисов
Заголовок раздела «Плюсы и минусы облачных сервисов»Облачный сервис — это аутсорсинг эксплуатации провайдеру. Провайдеры обещают экономию и скорость, но выгода зависит от ваших навыков и нагрузки:
| В пользу облака | В пользу своих серверов |
|---|---|
| Систему, которую вы не умеете вести, проще взять как сервис | Если опыт есть, а нагрузка предсказуема, свои машины часто дешевле |
| Провайдер обслуживает много клиентов и накапливает опыт, поэтому сервис может быть лучше | Свою систему можно настроить под свою нагрузку; облачный провайдер этого делать не станет |
| Легко добавить или вернуть ресурсы, если нагрузка сильно меняется | Нет зависимости от вендора |
Облако особенно выгодно при скачущей нагрузке, например в аналитике. Большой запрос требует много ресурсов параллельно, а потом они простаивают. Нагрузку от отчётов по расписанию можно сгладить очередью, а от интерактивных запросов нельзя. Если данных много, облако экономит: лишние ресурсы возвращают провайдеру.
Главный минус облака — у вас нет над ним контроля:
- Нет нужной функции — остаётся просить вендора.
- Сервис упал — остаётся ждать.
- Ошибку или медленную работу трудно разобрать: метрик ОС и логов сервера у вас нет.
- Сервис закрылся, подорожал или изменился — придётся переезжать. Стандартного API часто нет, поэтому переезд дорог: это
vendor lock-in, привязка к поставщику. - Провайдер из другой страны — при конфликте и санкциях можно потерять доступ.
- Безопасность данных доверена провайдеру, а это усложняет выполнение требований о приватности.
Несмотря на риски, новые приложения всё чаще строят в облаке или гибридно. Но свои системы останутся: это и старые системы, и особые требования. Например, биржевым роботам для сверхбыстрых сделок нужен полный контроль над железом.
Cloud native архитектура
Заголовок раздела «Cloud native архитектура»Облако изменило и экономику, и техническое устройство систем. Архитектуру, созданную под облачные сервисы, называют cloud native. Такие системы быстрее на том же железе, быстрее восстанавливаются, быстрее масштабируются и тянут больше данных, чем обычное ПО, запущенное как управляемый сервис.
| Вид | Для своих серверов | Cloud native |
|---|---|---|
| Операционные (OLTP) | MySQL, PostgreSQL, MongoDB | AWS Aurora, Azure SQL DB Hyperscale, Google Cloud Spanner |
| Аналитические (OLAP) | Teradata, ClickHouse, Spark | Snowflake, Google BigQuery, Azure Synapse Analytics |
Слои облачных сервисов
Заголовок раздела «Слои облачных сервисов»Обычное ПО использует простые ресурсы: CPU, память, файловую систему и IP-сеть. В облаке его запускают на VM (IaaS): получить VM быстрее, чем железо, но администрируете её вы.
Cloud native-системы строят сервисы высокого уровня поверх облачных сервисов низкого уровня:
- Объектное хранилище (
object storage) — Amazon S3, Azure Blob Storage, Cloudflare R2 — хранит большие файлы. API у него беднее файловой системы, зато оно само раскладывает данные по многим машинам: место не кончается, а отказ машин не теряет данные. - Сервисы поверх него. Snowflake хранит данные в S3, а поверх Snowflake строят свои сервисы другие компании.
Если задача совпадает со сценарием готовой системы высокого уровня, берите её. Если нет, собирайте свою из компонентов низкого уровня.
Разделение хранения и вычислений
Заголовок раздела «Разделение хранения и вычислений»На обычном сервере диск считают надёжным: что записано на диск, не потеряется. А отказ одного диска переживают с помощью RAID — копий данных на нескольких дисках одной машины.
Локальный диск VM cloud native-системы считают лишь временным кэшем: если VM откажет или её заменят на другую, диск станет недоступен.
Облака предлагают и виртуальные диски (Amazon EBS и аналоги), которые переключают между VM. Это сервис на других машинах, который имитирует блочное устройство. Так можно запустить обычное ПО, но эмуляция стоит накладных расходов, а каждая операция ввода-вывода становится сетевым вызовом.
Поэтому cloud native сервисы опираются на специальные сервисы хранения. S3 рассчитан на файлы от сотен килобайт до гигабайт, а строки базы намного меньше. Поэтому облачные базы держат мелкие значения в отдельном сервисе, а большие блоки — в объектном хранилище (глава 4).
В итоге хранение и вычисления разделены. S3 только хранит файлы, а анализ идёт на других машинах, и данные едут по сети.
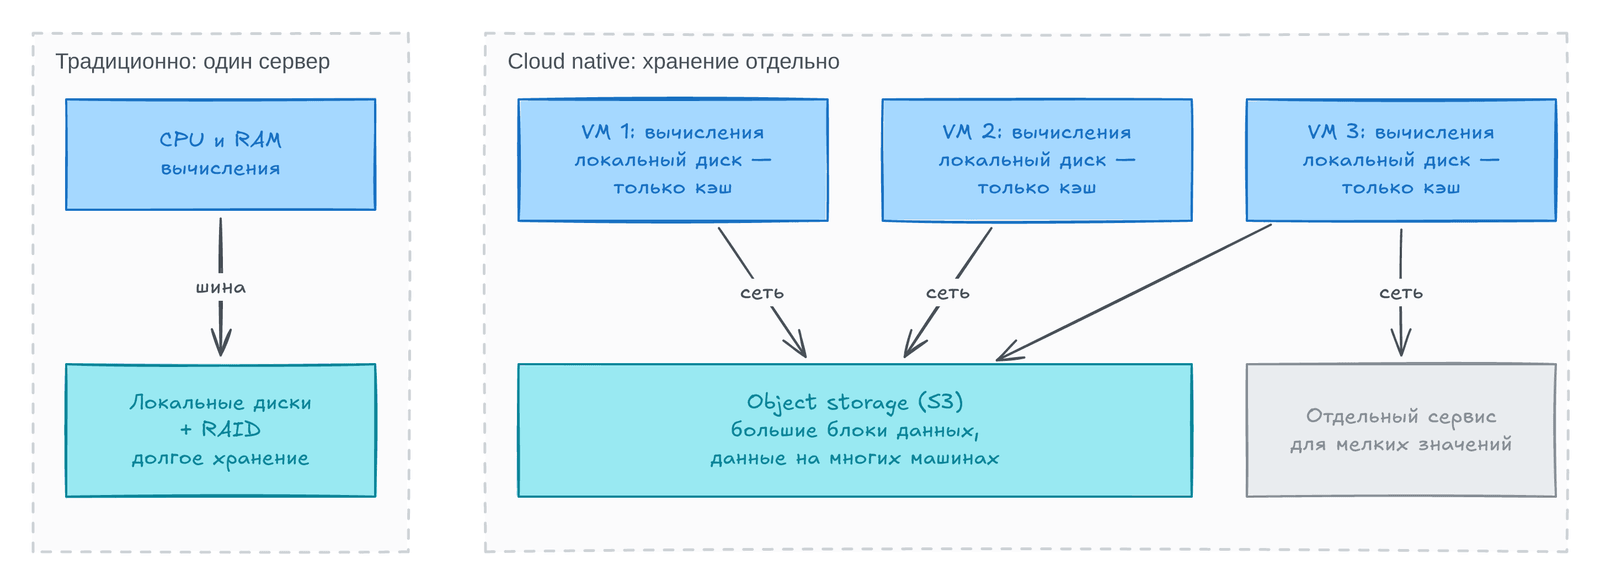
На схеме видно главное отличие: в облаке между вычислениями и данными всегда есть сеть, а VM можно заменить без потери данных.
Ещё одна черта cloud native — multitenancy: один сервис на общем железе обслуживает многих клиентов. Железо используется лучше, но нужно следить, чтобы один клиент не влиял на скорость и безопасность других.
Эксплуатация в эпоху облака
Заголовок раздела «Эксплуатация в эпоху облака»Раньше инфраструктурой занимались DBA и системные администраторы. Философия DevOps объединила разработку и эксплуатацию в одних командах, а SRE — её вариант в Google.
Задача эксплуатации — надёжный сервис и стабильный продакшен. На своих серверах это работа с машинами: планировать мощности, заводить серверы, переносить сервисы, ставить обновления ОС. Облако прячет машины за API: за хранение платят по объёму, без планирования дисков.
Цель не изменилась, но DevOps и SRE делают упор на:
- автоматизацию и повторяемые процессы вместо ручных разовых работ;
- временные VM и сервисы вместо долго живущих серверов;
- частые обновления приложений;
- выводы из инцидентов;
- сохранение знаний о системе в компании, даже когда люди уходят.
Роли разошлись: провайдеры обеспечивают надёжность для множества клиентов, а клиенты тратят на инфраструктуру минимум сил. Но эксплуатация нужна и им: выбрать сервис, связать сервисы, переехать. Планирование мощностей становится финансовым планированием, а оптимизация скорости — оптимизацией затрат. Ещё нужно заранее знать квоты облака.
Трудна и интеграция: сервисов всё больше, а стандартов для их связи нет. Безопасность, мониторинг и поиск причин сбоев облаку тоже не отдать. Облако меняет роль эксплуатации, но не уменьшает её важность.
Распределённые и одноузловые системы
Заголовок раздела «Распределённые и одноузловые системы»Распределённая система — это несколько машин, которые общаются по сети. Каждый процесс в ней называют узлом (node). Причин строить такую систему много:
| Причина | Суть |
|---|---|
| Распределённость по природе | Пользователи на своих устройствах общаются через сеть |
| Запросы между сервисами | Данные хранит один сервис, а обрабатывает другой |
| Отказоустойчивость | Если машина или дата-центр отказали, работу берёт другая машина (глава 6) |
| Масштабируемость | Нагрузка больше, чем тянет одна машина |
| Задержка | Серверы в разных регионах ближе к пользователям |
| Эластичность | В облаке ресурсы растут и уменьшаются вместе с нагрузкой, и вы платите только за то, что используете. Одну машину приходится брать под пиковую нагрузку, даже если она почти простаивает |
| Специальное железо | Хранилищу — много дисков, анализу — CPU и память, ML — GPU |
| Требования закона | Законы о локализации требуют держать данные жителей внутри страны |
| Экологичность | Задачи запускают там и тогда, где много зелёной и дешёвой энергии |
Подробно отказоустойчивость, масштабируемость и задержку разбирает глава 2.
Проблемы распределённых систем
Заголовок раздела «Проблемы распределённых систем»Но любой запрос по сети может не пройти: сеть оборвётся, сервис упадёт, и запрос завершится по таймауту. Получил ли сервис запрос, неизвестно, и повторить его может быть небезопасно (глава 9).
Сетевой вызов намного медленнее вызова функции в том же процессе. Поэтому при больших данных часто выгоднее отправить вычисление к данным. Больше узлов не всегда быстрее: простая однопоточная программа иногда обходит кластер на 100+ ядер.
Искать причины медленной работы в распределённой системе трудно. Для этого нужна observability — сбор данных о работе системы, по которым видны и общие метрики, и отдельные события. Трассировка (OpenTelemetry, Zipkin, Jaeger) показывает, кто кого вызвал и сколько длился вызов.
Если у каждого сервиса своя база, согласованность между ними — задача приложения. Распределённые транзакции (глава 8) в микросервисах почти не используют: они мешают независимости сервисов, и многие базы их не поддерживают.
Поэтому одна машина часто проще и дешевле. Железо стало мощнее и надёжнее, и с базами вроде DuckDB, SQLite и KùzuDB одна машина тянет многие нагрузки (глава 4).
Микросервисы и serverless
Заголовок раздела «Микросервисы и serverless»Обычно систему делят на клиенты и серверы, которые общаются по HTTP (глава 5). Этот подход называли SOA (service-oriented architecture), а сегодня его развитие — микросервисы. У микросервиса одна задача, свой API и одна команда-владелец, и сложное приложение раскладывают на много таких сервисов.
Плюсы такие: сервисы обновляют независимо, каждому дают нужные ресурсы, а за API можно менять реализацию, не ломая клиентов.
Базы между сервисами обычно не делят: общая база сделала бы свою структуру частью API, и менять её стало бы трудно.
Минусы тоже есть. Для теста сервиса нужно поднять все его зависимости. Каждому сервису нужны выкатка, логи, мониторинг и дежурства, и основой для этого стал Kubernetes. API трудно менять: удалённое поле ломает клиентов, и это часто всплывает поздно. Помогают OpenAPI и gRPC (глава 5).
Микросервисы — это прежде всего техническое решение проблемы людей: дать командам работать независимо. Маленькой компании они обычно не нужны, ей лучше сделать приложение как можно проще.
Serverless, или FaaS (function as a service), отдаёт облаку всё управление ресурсами. Провайдер сам выделяет их под входящие запросы, а вы платите только за время работы кода.
Цена — лимиты на время выполнения и среду запуска и медленный первый вызов. Само слово обманчиво: код всё равно работает на сервере. BigQuery и сервисы Kafka тоже зовут себя «serverless», имея в виду автомасштабирование и оплату за использование.
Облачные вычисления и суперкомпьютеры
Заголовок раздела «Облачные вычисления и суперкомпьютеры»Другой способ строить большие системы — HPC (high-performance computing), то есть суперкомпьютеры. Приоритеты у них другие:
| Признак | Суперкомпьютер (HPC) | Облако |
|---|---|---|
| Задачи | Научные расчёты: погода, климат, молекулы | Онлайн-сервисы, которые всегда отвечают пользователям |
| Сбой узла | Остановить всё, починить узел, продолжить с последней контрольной точки (checkpoint) | Останавливать всё нельзя, сервис должен работать |
| Связь узлов | Общая память и RDMA: быстро, но все пользователи доверяют друг другу | Железо делят чужие друг другу компании, нужны изоляция (VM), шифрование, аутентификация |
| Сеть | Особые топологии: многомерные решётки и торы | IP и Ethernet в топологии Clos |
| География | Все узлы рядом | Узлы в разных регионах |
Большие аналитические системы иногда похожи на суперкомпьютеры, поэтому их техники полезно знать. Но книга в основном про сервисы, которые должны работать без перерывов.
Системы данных, закон и общество
Заголовок раздела «Системы данных, закон и общество»На архитектуру влияют не только техника и бизнес. У инженеров есть ответственность и перед обществом.
Особенно это касается данных о людях. С 2018 года GDPR даёт жителям многих стран Европы права на их персональные данные. Похожие законы есть и в других местах, например CCPA в Калифорнии, а EU AI Act ограничивает использование данных в ИИ.
Системы влияют на людей и без законов. Соцсети меняют взгляды избирателей, а автоматические системы решают, кому дать кредит, кого позвать на собеседование и кого подозревать в преступлении. Поэтому каждый инженер отвечает за этику своих решений, и основы права и этики ему нужны так же, как основы распределённых систем.
Закон влияет на основы устройства систем. GDPR даёт право потребовать удалить свои данные (право на забвение). Но многие системы в книге построены на неизменяемых журналах, куда только дописывают. Как удалить запись из такого файла? Как удалить данные из производных наборов, например из обучающей выборки модели?
Готовых правил нет: закон намеренно не называет технологий и задаёт только общие принципы.
Данные хранят, если их ценность выше затрат. Но затраты — не только счёт за S3: это ещё риск утечки, удар по репутации, штрафы и суды.
Государство может потребовать данные у компании. Если данные раскрывают поведение, которое где-то преследуют по закону (авторы приводят примеры с гомосексуальностью и абортами), хранить их опасно для людей. Даже журнал IP-адресов выдаёт примерное место человека.
Поэтому иногда данные лучше не хранить вовсе. Это принцип минимизации данных (Datensparsamkeit). Он идёт против философии «big data» копить всё впрок, но совпадает с GDPR: собирать данные только для явной цели, не использовать для других и не хранить дольше нужного.
Бизнес тоже следит за приватностью и безопасностью. Компании кредитных карт требуют от платёжных компаний стандарт PCI, а покупатели ПО от вендоров — SOC 2. Выполнение обоих проверяют внешние аудиторы.
Нужен баланс между нуждами бизнеса и интересами людей. Подробнее об этике — глава 14.
Итоги главы
Заголовок раздела «Итоги главы»- У многих архитектурных вопросов нет одного правильного ответа, есть варианты с плюсами и минусами, и задача инженера — выбрать лучший компромисс.
- Операционные системы (OLTP) обслуживают пользователей точечными запросами, а аналитические (OLAP) сканируют много данных и считают агрегаты.
- Аналитику выносят в хранилище данных и
data lake, а данные туда приноситETLилиELTиз многих операционных систем. System of recordхранит эталонную версию данных, а производные данные (кэши, индексы, хранилище, модели) можно пересоздать из него.- Облако выгодно при скачущей нагрузке и нехватке опыта, но вы теряете контроль и рискуете получить
vendor lock-in. - Распределённая система нужна для отказоустойчивости, масштаба, задержки и требований закона, но она сложнее и дороже, поэтому не спешите уходить с одной машины.
- Законы о приватности, такие как GDPR, влияют на архитектуру: право на удаление и минимизация данных — инженерные задачи.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
операционная система (operational) | Система, где данные создаются и меняются по действиям пользователей |
OLTP | Шаблон доступа: много маленьких запросов по ключу, чтение и запись отдельных записей |
OLAP | Шаблон доступа: мало сложных запросов, агрегаты по большому числу записей |
хранилище данных (data warehouse) | Отдельная база для аналитики с копией данных многих OLTP-систем |
data lake | Хранилище сырых файлов любого формата для анализа |
ETL / ELT | Выгрузка, преобразование и загрузка данных; в ELT преобразуют после загрузки |
system of record | Источник истины: эталонная версия данных, куда пишут первыми |
производные данные (derived data) | Данные, полученные обработкой других данных; их можно пересоздать |
cloud native | Архитектура, созданная для облака и построенная на облачных сервисах |
vendor lock-in | Привязка к поставщику: уйти от него дорого |
serverless (FaaS) | Код запускается как функции, а ресурсами управляет облако; оплата за время работы |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Прежде чем выбрать инструмент, запишите, кто будет работать с данными и как: OLTP-запросы по ключу или аналитические агрегаты. От этого зависит тип системы.
- Не пускайте тяжёлые аналитические запросы в продакшен-базу. Выносите аналитику в хранилище данных или
data lakeчерезETLилиELT. - Для каждой таблицы знайте, что это:
system of recordили производные данные. Производное можно пересчитать, а источник нужно беречь и резервировать. - Не делайте систему распределённой без причины. DuckDB на одной большой машине иногда обходит кластер на средних объёмах.
- Храните только те персональные данные, для которых есть ясная цель, и заранее продумайте, как удалять их из производных наборов.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему аналитикам неудобно и опасно выполнять запросы прямо в OLTP-базах? Назовите не меньше трёх причин.
- Чем
data lakeотличается от хранилища данных, и почему data scientists часто предпочитаютdata lake? - Почему одна и та же база может быть и
system of record, и системой производных данных? От чего зависит её роль? - В каких случаях облачный сервис выгоднее своих серверов, а в каких дороже? Какие риски даёт облако?
- Когда без распределённой системы не обойтись, а когда лучше остаться на одной машине?
Предыдущая: Обзор книги. Следующая: Нефункциональные требования.